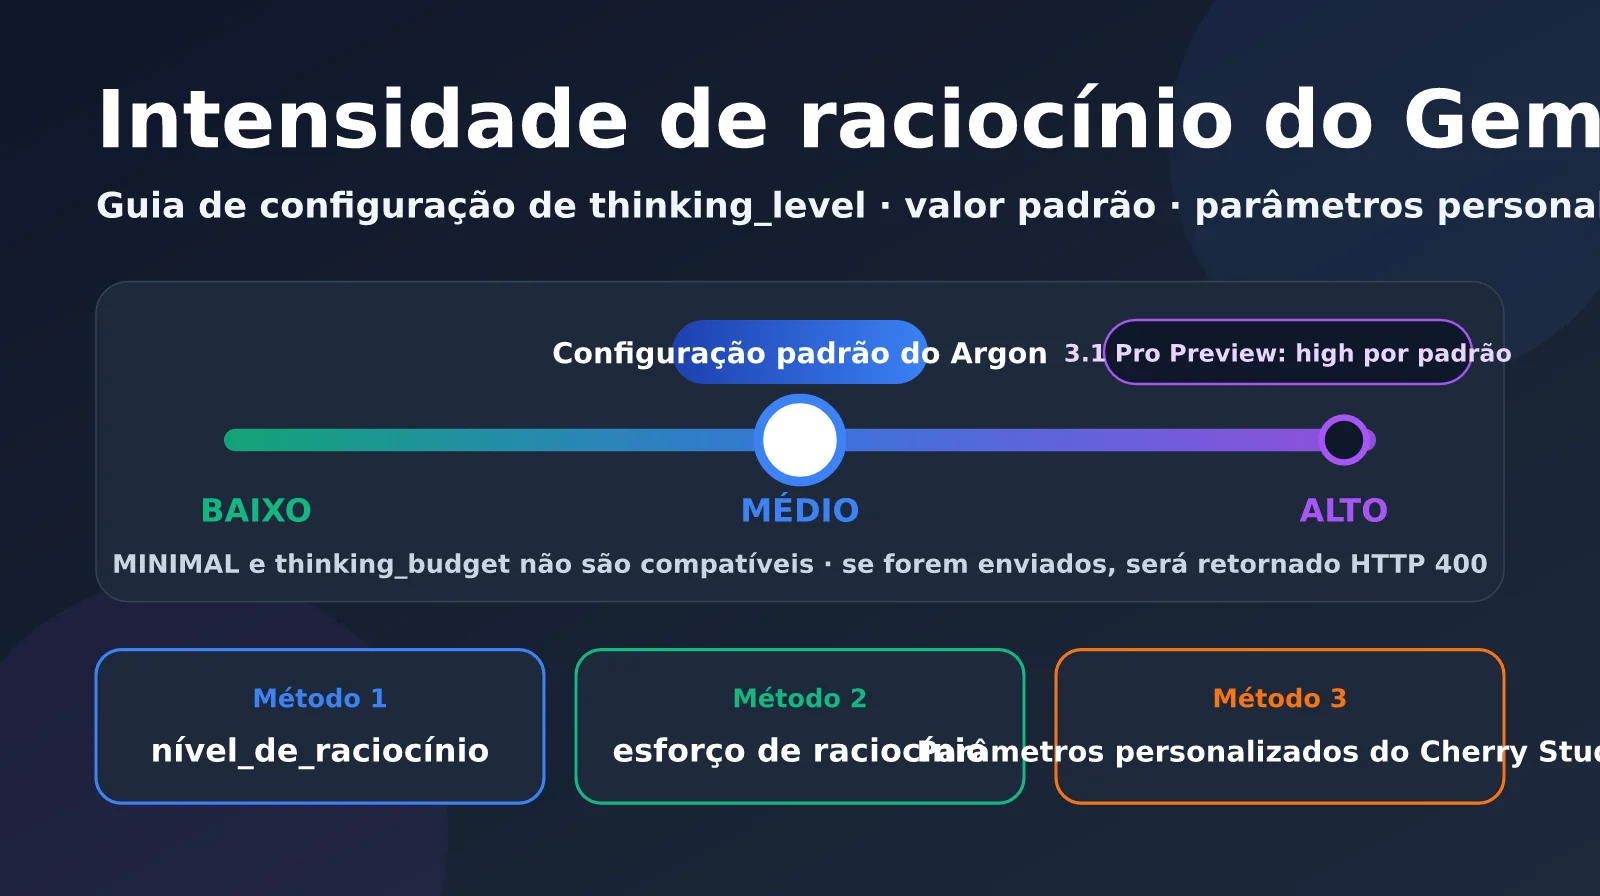
Depois de migrar de gemini-3.1-pro-preview para o Gemini 4 Argon, muitos desenvolvedores perceberam um problema: com o mesmo comando, às vezes o Argon parece “pensar menos”. A causa provável é o valor padrão da intensidade de raciocínio do Gemini 4 Argon. Segundo a documentação oficial do Google, o thinking_level padrão do Gemini 4 Argon é medium, não high. Já o gemini-3.1-pro-preview vem configurado por padrão no nível máximo, high. Se o seu código ou cliente nunca define a intensidade de raciocínio explicitamente, a profundidade de pensamento do modelo diminui silenciosamente após a migração.
O problema fica ainda mais complicado porque clientes de chat populares, como o Cherry Studio, costumam demorar para oferecer suporte aos parâmetros de raciocínio de modelos novos. A opção de intensidade de raciocínio pode simplesmente não aparecer na interface. Neste artigo, explicamos os níveis disponíveis, o valor padrão e o impacto na cobrança do Gemini 4 Argon. Em seguida, mostramos três maneiras de configurar o parâmetro: pela API nativa, por uma interface compatível com OpenAI e pelos parâmetros personalizados do Cherry Studio.
O que você vai aprender: ao terminar este artigo, você saberá configurar a intensidade de raciocínio do Gemini 4 Argon no nível desejado, independentemente da forma de chamada, e evitar problemas de migração como truncamento por max_tokens e erros 400 causados por parâmetros.
Principais informações sobre a intensidade de raciocínio do Gemini 4 Argon
O Gemini 4 Argon usa o parâmetro thinking_level para controlar a intensidade de raciocínio e oferece três níveis: low, medium e high. Em comparação com os modelos anteriores, ele não oferece mais o thinking_budget, que permitia definir a quantidade de tokens, nem o nível minimal. Tentar configurar qualquer um deles resulta diretamente em um erro HTTP 400. A tabela abaixo resume as descrições oficiais dos três níveis no guia para desenvolvedores do Google Cloud.
| Nível de raciocínio | Padrão? | Casos de uso recomendados pelo Google | Características |
|---|---|---|---|
| LOW | Não | Classificação, resumo, extração de metadados | Menor latência e quase nenhum token de raciocínio |
| MEDIUM | ✅ Padrão do gemini-4-argon | Programação em geral, chamadas de ferramentas, perguntas e respostas sobre documentos, compreensão de vídeos | Equilíbrio entre velocidade, custo e precisão |
| HIGH | ✅ Padrão da versão cyber-permissive | Engenharia de software com vários arquivos, provas formais, projeto de arquitetura, busca por vulnerabilidades | Raciocínio mais profundo, com aumento significativo da latência até o primeiro token e do custo |
| MINIMAL | Não compatível | — | Retorna erro HTTP 400 quando configurado |
| thinking_budget | Não compatível | — | Nos modelos anteriores, o valor era convertido silenciosamente; no Argon, retorna erro 400 |
Vale observar que a versão gemini-4-argon-cyber-permissive, destinada a defensores de redes do programa Fairwind, usa HIGH por padrão. Apenas a versão padrão, gemini-4-argon, vem com MEDIUM. Além disso, todas as avaliações do Argon publicadas pelo Google foram feitas no nível máximo de raciocínio. Se você usar o nível padrão medium, o desempenho real pode ficar abaixo do anunciado.
Comparação dos níveis padrão de raciocínio do Gemini 4 Argon e dos modelos anteriores
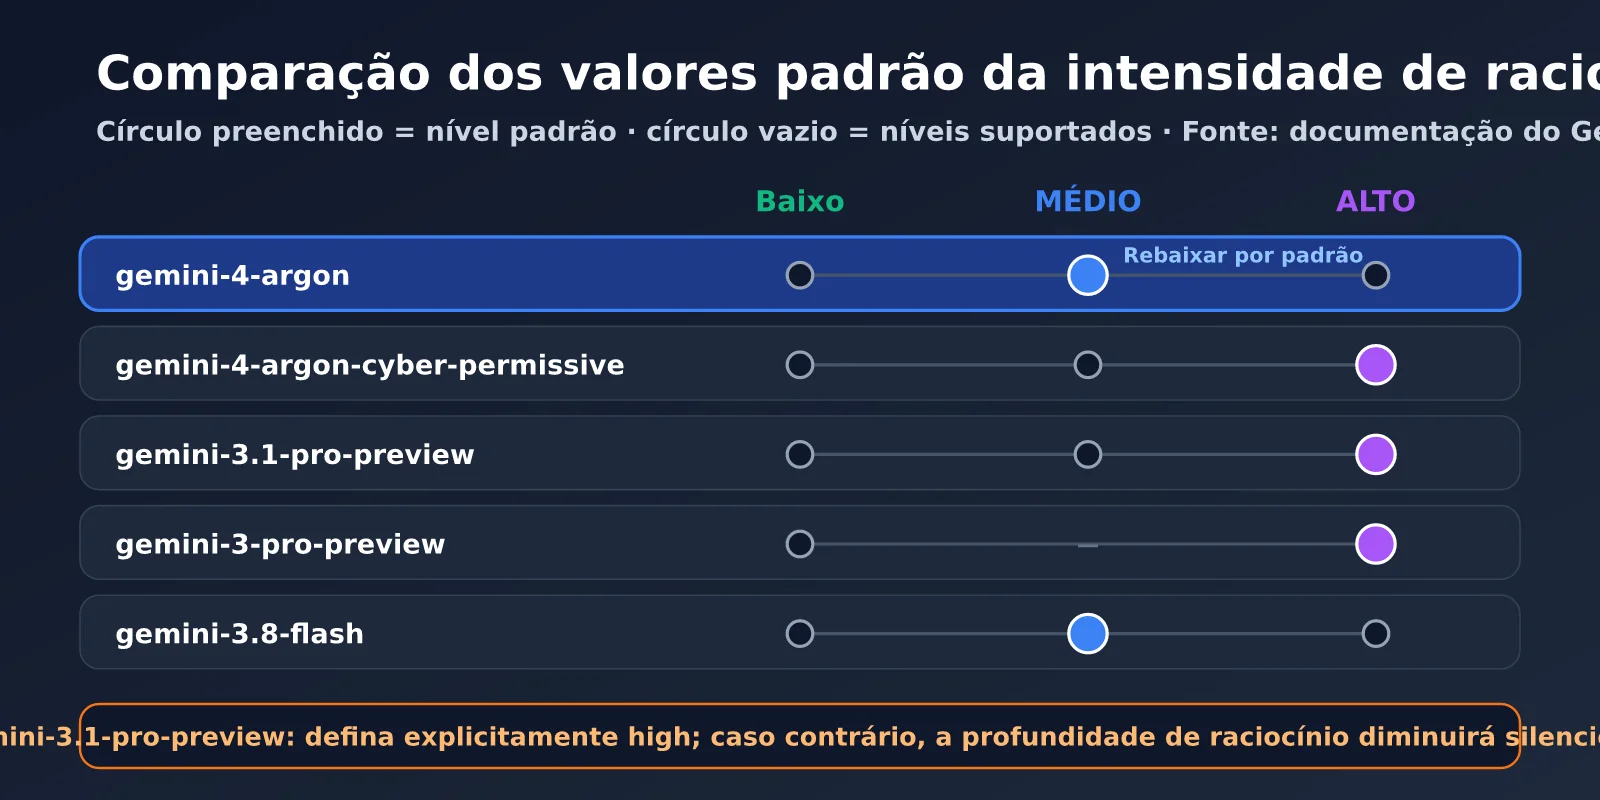
Comparar os níveis padrão do Gemini 4 Argon com os de alguns modelos Gemini recentes ajuda a entender os riscos da migração. Os dados abaixo foram extraídos da documentação oficial sobre raciocínio da API Gemini do Google.
| Modelo | Nível de raciocínio padrão | Níveis compatíveis |
|---|---|---|
| gemini-4-argon | medium | low, medium, high |
| gemini-4-argon-cyber-permissive | high | low, medium, high |
| gemini-3.1-pro-preview | high | low, medium, high |
| gemini-3-pro-preview | high | low, high |
| gemini-3.8-flash | medium | low, medium, high |
| gemini-3-flash-preview | high | minimal, low, medium, high |
Como dá para ver, o Google está reduzindo o nível padrão de raciocínio dos modelos de nova geração de high para medium. Isso acontece tanto com o Gemini 3.8 Flash quanto com o Gemini 4 Argon. Essa mudança reduz a latência e o custo padrão, mas, para quem está acostumado ao “raciocínio máximo por padrão” do 3.1 Pro, é preciso definir explicitamente high ao migrar para o Argon para manter a profundidade de raciocínio anterior.
🎯 Dica para a migração: ao migrar do
gemini-3.1-pro-previewpara o Gemini 4 Argon, defina explicitamente o nível de raciocínio no código e compare a qualidade das respostas dos dois modelos. Com a interface unificada da APIYI apiyi.com, você pode chamar os modelos Gemini antigo e novo ao mesmo tempo para fazer um teste A/B, alterando apenas o parâmetromodel.
Relação entre a intensidade de raciocínio do Gemini 4 Argon e a cobrança
A intensidade de raciocínio não afeta apenas a qualidade das respostas: ela também impacta diretamente a cobrança. Os tokens de raciocínio do Argon são cobrados pelo preço dos tokens de saída: US$ 10 por milhão de tokens durante o período de acesso antecipado e US$ 20 no preço regular. Por padrão, o processo de raciocínio não é exibido integralmente para o usuário. Ou seja, quanto maior o nível, mais você paga por um “raciocínio invisível”.
Em uma estimativa aproximada, considerando o preço de acesso antecipado, uma solicitação no nível high que gere 1.500 tokens de raciocínio custa cerca de US$ 0,015 a mais apenas nessa parte. Com 10 mil chamadas por dia, isso representa aproximadamente US$ 4.500 de custo adicional ao longo de um mês. Esse é também um dos motivos práticos para o Google ter reduzido o nível padrão do Argon para medium: a maioria das solicitações do dia a dia não precisa do raciocínio mais profundo, e o nível high faria muita gente pagar por processamento que não usa. Por isso, o melhor é escolher o nível conforme o tipo de tarefa, em vez de fixar high para tudo.
3 maneiras de configurar o nível de raciocínio do Gemini 4 Argon
Dependendo de como você faz a chamada, há três opções para configurar o nível de raciocínio do Gemini 4 Argon: thinking_level no SDK nativo do Google, reasoning_effort na interface compatível com OpenAI e o envio dos parâmetros nativos do Google por meio de extra_body. Não use as três opções ao mesmo tempo, ou ocorrerá um erro.
| Método de configuração | Local do parâmetro | Valores disponíveis | Cenários de uso |
|---|---|---|---|
| thinking_level nativo | thinking_config.thinking_level |
LOW / MEDIUM / HIGH | Google GenAI SDK, Vertex AI |
| reasoning_effort compatível com OpenAI | reasoning_effort no nível superior do corpo da requisição |
minimal / low / medium / high | OpenAI SDK e vários clientes compatíveis |
Envio por extra_body |
extra_body.google.thinking_config |
low / medium / high | Quando você também precisa ativar opções nativas, como o resumo do raciocínio |
Na interface compatível com OpenAI, reasoning_effort é mapeado para thinking_level do Argon. De acordo com a tabela oficial de mapeamento do Google, minimal e low correspondem a low, medium corresponde a medium e high corresponde a high. Porém, o Argon não reconhece níveis mais altos usados pela OpenAI e pela Anthropic, como xhigh e max. Se você os enviar, a API retornará um erro 400.
Método 1: definir thinking_level no SDK nativo
Com o Google GenAI SDK, basta especificar o nível em ThinkingConfig. Os endpoints do Vertex AI oferecem suporte às regiões global, us e eu.
from google import genai
from google.genai import types

client = genai.Client(enterprise=True, project="YOUR_PROJECT", location="global")

resp = client.models.generate_content(
    model="gemini-4-argon",
    contents="为多生产者单消费者场景设计一个无锁环形缓冲区",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="HIGH"),
        max_output_tokens=32768,
    ),
)
print(resp.text)
Método 2: definir reasoning_effort na interface compatível com OpenAI
Se seu projeto usa o OpenAI SDK, chamar o Argon por meio da interface compatível é a opção que exige menos alterações: basta adicionar o parâmetro reasoning_effort.
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",      # 映射为 thinking_level=high
    max_tokens=32000,             # 必须为思考 token 预留空间
    messages=[{"role": "user", "content": "审查这段并发代码的竞态条件"}],
)
print(resp.choices[0].message.content)
print(resp.usage)
Ver código completo: envio por extra_body e teste comparativo dos três níveis
import time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
PROMPT = "一个 Kubernetes Pod 一直处于 CrashLoopBackOff,请给出系统的排查步骤和命令"


def call_with_effort(level: str):
    """方式二:OpenAI 兼容的 reasoning_effort"""
    start = time.time()
    resp = client.chat.completions.create(
        model="gemini-4-argon",
        reasoning_effort=level,
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
    )
    return resp, time.time() - start


def call_with_extra_body(level: str):
    """方式三:extra_body 透传 Google 原生 thinking_config
    注意:不能与 reasoning_effort 同时使用"""
    return client.chat.completions.create(
        model="gemini-4-argon",
        max_tokens=32000,
        messages=[{"role": "user", "content": PROMPT}],
        extra_body={
            "google": {
                "thinking_config": {
                    "thinking_level": level,
                    "include_thoughts": True,
                }
            }
        },
    )


if __name__ == "__main__":
    for level in ("low", "medium", "high"):
        resp, cost_time = call_with_effort(level)
        u = resp.usage
        print(f"[{level:6}] 耗时 {cost_time:5.1f}s | 输出 {u.completion_tokens} token")
💡 Dica de uso: a interface compatível com OpenAI é a maneira mais simples de integrar o Gemini 4 Argon. Em geral, você quase não precisa alterar o código existente que usa o OpenAI SDK. Para testar, recomendamos obter créditos de avaliação pela APIYI apiyi.com e executar o script comparativo acima para verificar como diferentes níveis de raciocínio afetam suas tarefas mais comuns.
Configurar o nível de raciocínio do Gemini 4 Argon no Cherry Studio
No canto inferior direito do campo de entrada do Cherry Studio há um menu suspenso para o nível de raciocínio. Porém, essa opção só aparece para modelos de raciocínio que o cliente reconhece. De acordo com discussões da comunidade, o Cherry Studio identifica se um modelo é compatível com níveis de raciocínio com base em um catálogo interno, gerado durante a compilação a partir do models.dev e do OpenRouter. Ele não consulta as informações de capacidade retornadas pela interface durante a execução. Por isso, modelos recém-lançados, como o Gemini 4 Argon, podem não aparecer no menu até que o catálogo do cliente seja atualizado. Também pode acontecer de a opção aparecer, mas não funcionar.
Nesse caso, a maneira mais confiável é usar a função de parâmetros personalizados do Cherry Studio. Segundo a documentação oficial, os parâmetros personalizados são incluídos diretamente no corpo da requisição e têm prioridade sobre os parâmetros internos.
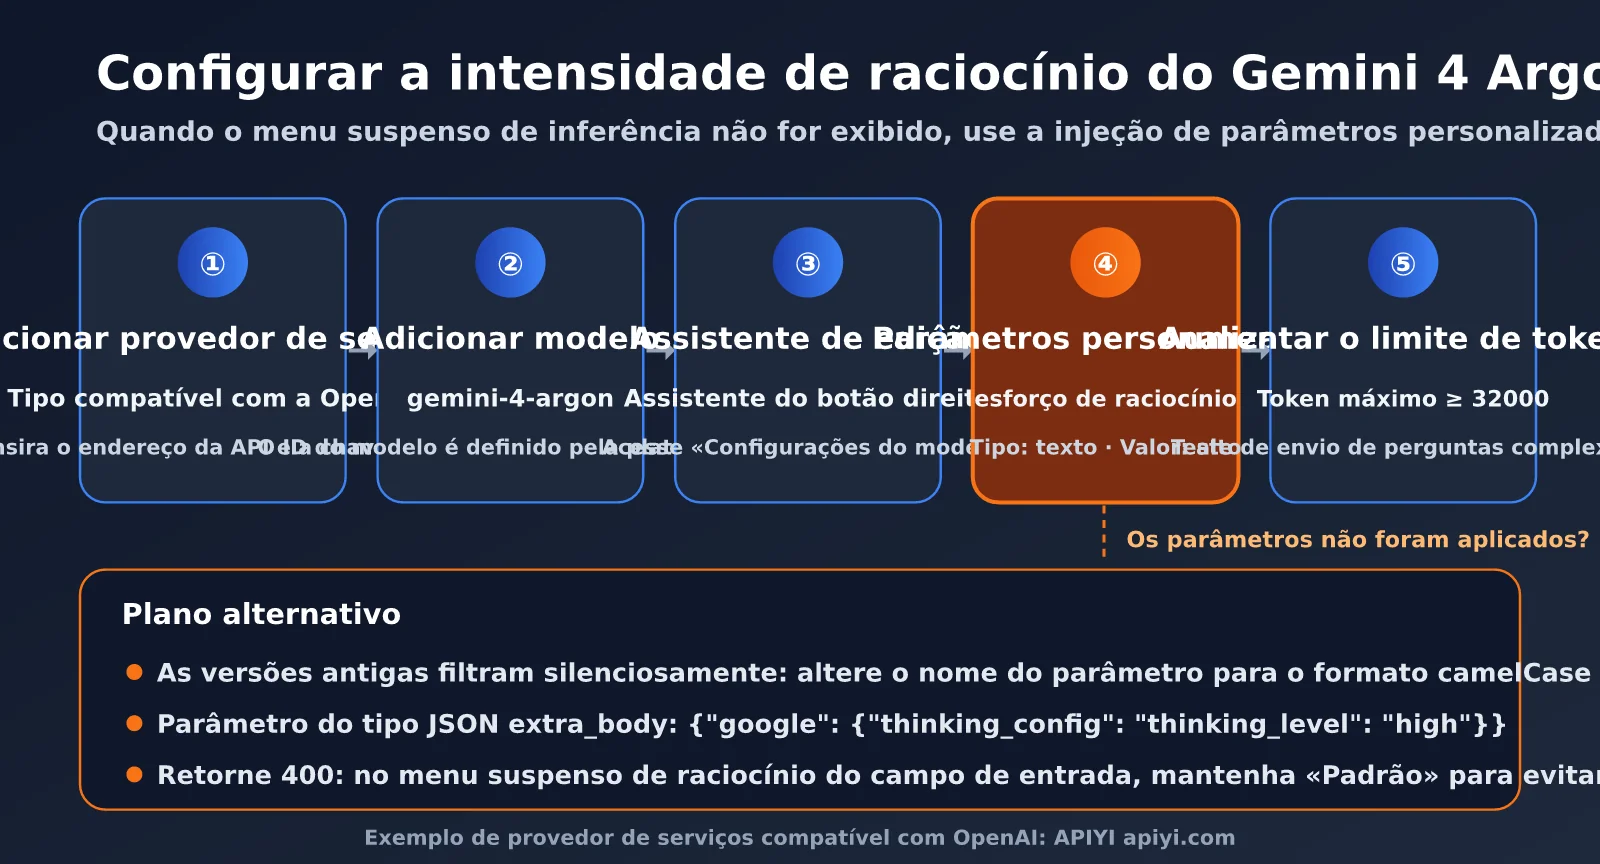
Etapas para configurar parâmetros personalizados no Cherry Studio
Veja o exemplo de um provedor compatível com OpenAI:
- Adicionar um provedor: nas configurações, adicione um provedor compatível com OpenAI e informe o endereço da API e a chave, por exemplo,
https://api.apiyi.comda APIYI. - Adicionar o modelo: adicione ao provedor o ID do modelo
gemini-4-argon. - Acessar as configurações do assistente: na lista de assistentes, clique com o botão direito no assistente desejado e escolha “Editar assistente”. Depois, acesse a aba “Configurações do modelo”.
- Adicionar um parâmetro personalizado: no nome do parâmetro, informe
reasoning_effort; selecione “Texto” como tipo e usehighcomo valor (oulowoumedium). - Aumentar o limite de saída: ative e aumente “Número máximo de tokens”. Recomendamos pelo menos 32000 para reservar espaço para o processo de raciocínio.
- Fazer um teste: envie uma pergunta que exija várias etapas de raciocínio e compare o tempo de resposta e o conteúdo do raciocínio antes e depois da configuração.
Se o nível de raciocínio ainda não funcionar depois de seguir essas etapas, verifique algumas situações comuns:
| Sintoma | Causa possível | Solução |
|---|---|---|
Não há diferença depois de definir reasoning_effort |
Versões antigas filtram esse parâmetro silenciosamente no modo compatível com OpenAI | Atualize para a versão mais recente ou use o nome de parâmetro reasoningEffort |
| O menu suspenso de nível de raciocínio não aparece no campo de entrada | O Argon ainda não foi incluído no catálogo interno de modelos | Use parâmetros personalizados. Usuários avançados podem adicionar informações sobre a capacidade de raciocínio na configuração do modelo |
| A requisição retorna um erro 400 | O cliente enviou níveis incompatíveis com o Argon, como max ou xhigh |
Mantenha o menu suspenso no valor “Padrão” e use parâmetros personalizados para especificar apenas low, medium ou high |
| A configuração interna substitui o parâmetro | A opção de raciocínio do campo de entrada entra em conflito com os parâmetros personalizados | Mantenha o campo de entrada em “Padrão” para não configurar o nível nos dois lugares |
| É preciso enviar parâmetros nativos | Você quer ativar também o resumo do raciocínio | Adicione um parâmetro do tipo JSON chamado extra_body, com o valor {"google": {"thinking_config": {"thinking_level": "high"}}} |
O problema de reasoning_effort ser filtrado silenciosamente foi corrigido no Cherry Studio em março de 2026, por meio de um PR. As versões mais recentes convertem o parâmetro automaticamente para reasoningEffort, usado internamente. Se você estiver usando uma versão antiga, pode informar diretamente o nome em camelCase, reasoningEffort, para evitar o filtro.
A mesma lógica vale para outros clientes de conversa populares, além do Cherry Studio: procure uma opção como “Parâmetros personalizados”, “Corpo adicional da requisição” ou “Parâmetros avançados” e adicione reasoning_effort como campo de nível superior no corpo da requisição. Se o cliente aceitar apenas JSON, use extra_body para enviar o thinking_config nativo. Depois de configurar, compare o tempo de resposta e o consumo de tokens usando a mesma pergunta complexa para confirmar que o parâmetro está funcionando.
🚀 Dica para escolher um cliente: para usar o Gemini 4 Argon no Cherry Studio, recomendamos escolher um provedor compatível com OpenAI, que oferece o envio mais estável de parâmetros. A APIYI apiyi.com fornece uma interface unificada compatível com OpenAI. Basta configurá-la uma vez no Cherry Studio para usar modelos das famílias Gemini, Claude, GPT e outras.
Testes práticos de intensidade de raciocínio do Gemini 4 Argon e dicas para evitar problemas
A intensidade de raciocínio afeta diretamente a latência, o custo e a qualidade das respostas. O blog técnico independente ComputingForGeeks fez uma série de testes comparativos com o Argon em tarefas de operações de TI, e os resultados são bastante úteis.
| Métrica do teste | Padrão (medium) | high | Diferença |
|---|---|---|---|
| Média de tokens de saída | 463 | 1.836 | cerca de 4 vezes |
| Latência média | 5,5 segundos | 15,3 segundos | cerca de 2,8 vezes |
| Primeiro token visível | cerca de 4,3 segundos | 12–13 segundos | primeiro gera cerca de 1.400 tokens de raciocínio |
| Custo de 9 chamadas (preço promocional) | US$ 0,045 | US$ 0,169 | cerca de 3,8 vezes |
| low / medium em comparação com o padrão | Quase iguais | — | Nenhuma gerou tokens de raciocínio em tarefas curtas |
Esses dados mostram duas coisas. Primeiro, em tarefas simples e curtas, low, medium e a configuração padrão são praticamente iguais: nenhuma gera tokens de raciocínio. Só a opção high realmente “pensa a fundo”. Segundo, o custo da opção high é claro: quase 4 vezes maior, com um aumento de cerca de 8 segundos na latência até o primeiro token. Vale lembrar que esse teste cobriu apenas comandos curtos; em tarefas longas e complexas, a opção medium também pode gerar um processo de raciocínio.
4 armadilhas comuns ao configurar a intensidade de raciocínio do Gemini 4 Argon
Com base no guia de migração do Google e em testes da comunidade, estas são algumas das armadilhas mais comuns ao configurar a intensidade de raciocínio do Gemini 4 Argon:
max_tokensmuito baixo pode resultar em uma resposta vazia:max_output_tokensinclui tanto os tokens de raciocínio quanto os tokens da resposta. Em um teste, com a opção high emax_tokensdefinido como 1024, o Argon usou todos os 1.021 tokens para raciocinar e acabou retornando uma string vazia, com o motivo de encerramentoMAX_TOKENS. Ao usar a opção high, reserve pelo menos 16K–32K.- Manter
thinking_budgetcausa um erro direto: ogemini-3.1-pro-previewconverte silenciosamentethinking_budgetem uma opção de nível. Já o Argon retorna diretamente um erro 400. Ao migrar, não se esqueça de remover esse parâmetro. - Parâmetros de amostragem, como
temperature, são ignorados: a documentação do Google informa que o backend do Argon ignora valores personalizados detemperature. Além disso,frequency_penalty,presence_penaltyecandidate_countretornam erro 400. O recomendado é controlar a profundidade do raciocínio pela opção de nível e o formato da resposta comresponse_schema. - Usar
max_tokenspara reduzir custos pode sair pela culatra: segundo a recomendação oficial do Google, para reduzir custos e latência, diminua o nível de raciocínio em vez de reduzirmax_tokens. Caso contrário, a resposta pode ser truncada com facilidade.
📊 Sugestão para escolher o nível: para perguntas do dia a dia e tarefas simples de programação, a opção padrão medium costuma bastar. Deixe high para projetos de arquitetura complexos, refatorações em vários arquivos e demonstrações matemáticas. Você pode comparar o consumo de tokens de diferentes níveis nos registros de chamadas da plataforma APIYI, em apiyi.com, e encontrar o melhor equilíbrio entre qualidade e custo.
Perguntas frequentes
Q1: A intensidade de raciocínio do Gemini 4 Argon vem configurada como high?
Não. A versão padrão, `gemini-4-argon`, vem configurada como medium. A opção `gemini-4-argon-cyber-permissive`, voltada a profissionais de defesa cibernética, é que vem configurada como high. Isso é diferente do `gemini-3.1-pro-preview`, cuja configuração padrão já é a mais alta, high. Para obter a capacidade máxima de raciocínio, é necessário definir explicitamente `thinking_level=”high”` ou `reasoning_effort=”high”`.
Q2: Dá para desativar o raciocínio do Gemini 4 Argon ou configurá-lo como minimal?
Não. O Argon só oferece três níveis: low, medium e high. Definir minimal ou usar `thinking_budget` resulta em um erro HTTP 400. Se você passar `reasoning_effort=”minimal”` pela interface compatível com OpenAI, o valor será convertido para low. Se precisar de latência muito baixa, considere modelos que oferecem o nível minimal, como os da série Gemini 3.x Flash.
Q3: O que fazer se a opção de intensidade de raciocínio não aparecer no Cherry Studio?
Isso acontece porque o catálogo de modelos integrado ao Cherry Studio ainda não inclui o Argon. Você pode adicionar o parâmetro personalizado `reasoning_effort` em “Editar assistente → Configurações do modelo”, selecionar o tipo texto e definir o valor como `high`. Os parâmetros personalizados têm prioridade sobre os parâmetros integrados. Recomendamos usar um provedor compatível com OpenAI, como a APIYI, em apiyi.com, que costuma encaminhar os parâmetros com mais estabilidade.
Q4: Como confirmar se a intensidade de raciocínio está realmente sendo aplicada?
A maneira mais direta é verificar a quantidade de tokens de saída em `usage` e o tempo de resposta: na opção high, tanto os tokens de saída quanto a latência até o primeiro token serão visivelmente maiores do que na opção padrão. No Cherry Studio, também dá para observar se aparece conteúdo de raciocínio. Recomendamos testar a mesma pergunta complexa com a opção padrão e com high e comparar os resultados.
Resumo
A principal conclusão sobre o nível de raciocínio do Gemini 4 Argon é: o padrão é medium, não high. Isso é diferente do gemini-3.1-pro-preview, que usa o nível mais alto como padrão. Durante a migração, se você não definir essa opção explicitamente, a profundidade de raciocínio do modelo vai diminuir um nível sem que você perceba. O Argon só aceita três níveis — low, medium e high — e tanto thinking_budget quanto minimal geram um erro 400. Ao usar o nível high, reserve tokens suficientes para o raciocínio em max_tokens.
Quanto às formas de invocação, o SDK nativo usa thinking_level, enquanto a interface compatível com OpenAI usa reasoning_effort. Em clientes como o Cherry Studio, que ainda não oferecem suporte às opções de raciocínio do Argon, é possível definir parâmetros personalizados. Para tarefas do dia a dia, recomendamos manter o medium padrão; em tarefas complexas, mude para high conforme necessário e escolha o nível com base em testes práticos.
Recomendamos usar a plataforma APIYI apiyi.com para integrar o Gemini 4 Argon por meio da interface compatível com OpenAI. Assim, tanto no código quanto em clientes como o Cherry Studio, você pode ajustar o nível de raciocínio com o parâmetro reasoning_effort.
Referências:
- Documentação do Google Gemini API sobre Thinking: ai.google.dev/gemini-api/docs/thinking
- Documentação do Google Gemini API sobre compatibilidade com OpenAI: ai.google.dev/gemini-api/docs/openai
- Guia para desenvolvedores do Google Cloud sobre o Gemini 4 Argon: docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-argon
- Documentação de configurações do assistente do Cherry Studio: docs.cherryai.com.cn
- Issues #11987 e #19761 do Cherry Studio no GitHub: github.com/CherryHQ/cherry-studio
Autor: APIYI Team | Compartilhamos continuamente práticas de integração e ajuste de parâmetros de Modelos de Linguagem Grande. Para ver mais tutoriais de integração de modelos de IA, acesse APIYI apiyi.com