Nota do autor: a Alphabet revelou que suas APIs de modelos próprios processam quase 32 bilhões de tokens por minuto. Este artigo compara Gemini 4 Argon, 3.8 Flash e 3.5 Flash-Lite com base em preços oficiais, avaliações independentes e simulações de custo, para ajudar você a calcular o “custo total por tarefa aprovada”.
Em 28 de outubro de 2026, Sundar Pichai, CEO da Alphabet, anunciou durante a apresentação dos resultados do terceiro trimestre que as APIs de modelos próprios da empresa processam atualmente quase 32 bilhões de tokens por minuto, um crescimento de mais de 4 vezes em relação ao ano anterior. Esse número mostra o uso geral da API Gemini por desenvolvedores e empresas, e não o desempenho de um modelo específico.
Este não é mais um artigo que recomenda “usar o modelo mais poderoso sem pensar”. Conforme o volume de chamadas aumenta, as questões de custo e escolha do modelo ganham ainda mais importância. Escolher a categoria errada pode multiplicar a conta mensal ou levar a várias tentativas por falta de capacidade, tornando tudo mais caro no fim.
O que você vai aprender: ao final deste artigo, você entenderá as diferenças entre os modelos Gemini Argon, Flash e Flash-Lite em capacidade, preço, velocidade e cenários de uso. O texto também apresenta um método prático de teste para ajudar você a fazer uma escolha inicial para seu negócio.
Crescimento acelerado no uso da Gemini API: informações principais
| Item | Detalhes |
|---|---|
| Data do anúncio | 28 de outubro de 2026 (resultados da Alphabet no 3º trimestre de 2026) |
| Responsável pelo anúncio | Sundar Pichai, CEO da Alphabet |
| Dados principais | A API dos modelos próprios processa quase 32 bilhões de tokens por minuto, um aumento de cerca de 40% em relação ao valor divulgado no trimestre anterior e de mais de quatro vezes em comparação ao ano anterior |
| Principais modelos atuais da API | Gemini 4 Argon, Gemini 3.8 Flash, Gemini 3.5 Flash-Lite |
| Quem é afetado | Todos os desenvolvedores e empresas que criam aplicações com a Gemini Developer API |
O que 32 bilhões de tokens por minuto significam para quem desenvolve com a Gemini API
O aumento no uso mostra que os modelos já estão em produção em larga escala, mas isso não significa que todo projeto precise usar o modelo mais avançado e caro. Na hora de escolher, vale considerar pelo menos a complexidade da tarefa, a qualidade exigida da resposta, o volume de solicitações, a velocidade de resposta, o consumo de tokens, a tolerância do negócio a falhas, a necessidade de uma janela de contexto longa e de invocação de ferramentas, além de possíveis mudanças de preço.
Um detalhe importante: neste artigo, Flash se refere ao Gemini 3.8 Flash, e Flash-Lite, ao Gemini 3.5 Flash-Lite. Não confunda esses modelos com a antiga série Gemini 2.5 Flash. Além disso, por maior que seja o volume global de chamadas, isso não significa que desenvolvedores individuais tenham cotas ilimitadas. Vamos falar dos limites de chamadas mais adiante.
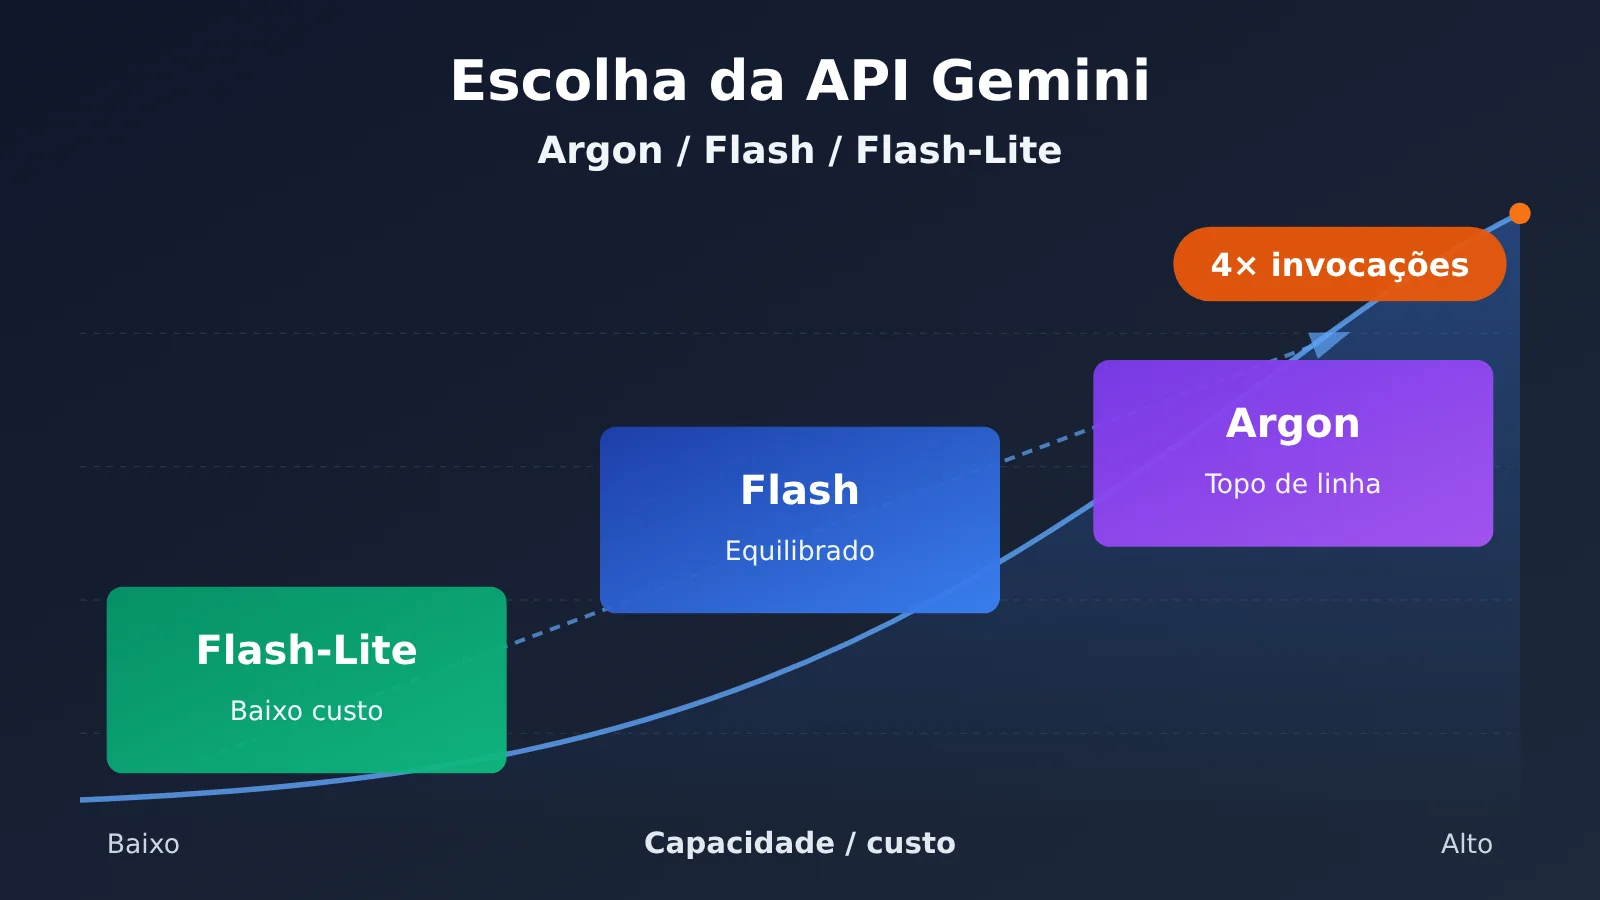
Posicionamento dos três modelos Gemini: Argon, Flash e Flash-Lite
Atualmente, o Google oferece três categorias de modelos para atender a diferentes necessidades de custo e capacidade. A tabela abaixo foi compilada com base nas páginas oficiais de especificações:
| Item | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| ID da API | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| Posicionamento oficial | Modelo de raciocínio principal | Equilíbrio entre eficiência e capacidade | Baixa latência, baixo custo e alto rendimento |
| Contexto | Cerca de 1 milhão de tokens | Entrada de 1048576 tokens | Entrada de 1048576 tokens |
| Limite padrão de saída | 65536 tokens (expansível com um mecanismo de saída longa) | 65536 tokens | 65536 tokens |
| Níveis de raciocínio | low / medium / high, padrão medium | low / medium / high, padrão medium | minimal / low / medium / high, padrão minimal |
| Recursos de ferramentas | Chamadas de função, saída estruturada, Search Grounding, execução de código | Chamadas de função, saída estruturada, execução de código, busca em arquivos, Search Grounding | Saída estruturada, chamadas de função, cache |
| Modalidades de entrada | Texto, imagem, áudio, vídeo, PDF | Texto, imagem, áudio, vídeo, PDF | Texto, imagem, áudio, vídeo, PDF |
| Camada gratuita da API | Não disponível | Camada gratuita limitada | Camada gratuita limitada |
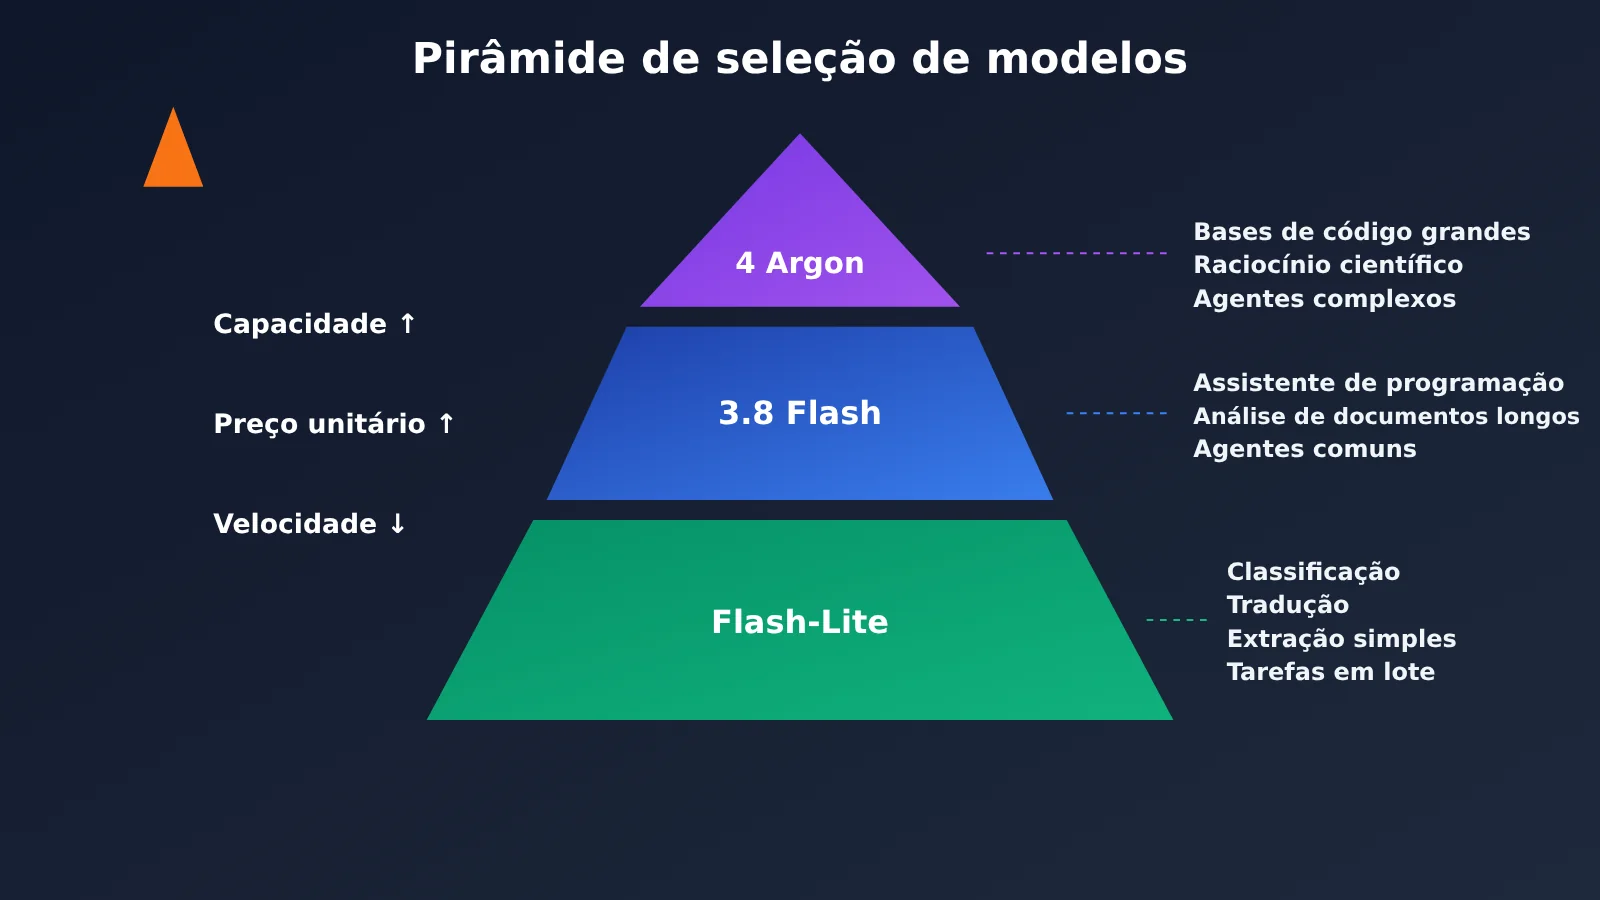
Os limites de capacidade dos três modelos Gemini
O Argon foi lançado oficialmente em 13 de outubro de 2026, com foco em engenharia de software complexa, raciocínio matemático e científico, agentes autônomos com várias etapas e geração de saídas longas. Para usar saídas longas, é necessário combinar um mecanismo específico com a configuração de execução adequada. Isso não significa que toda solicitação possa retornar diretamente 1 milhão de tokens.
O 3.8 Flash tem capacidade de raciocínio e não é uma “versão barata que não pensa”. Ele é indicado para assistentes de programação em tarefas comuns, análise de documentos longos, redação de conteúdo e fluxos de trabalho com agentes para tarefas gerais. O 3.5 Flash-Lite foi lançado em 21 de julho de 2026 e otimizado para classificação, tradução, extração simples, análise de documentos e subtarefas simples dentro de agentes. Ele também consegue lidar com algumas tarefas de programação e raciocínio. A diferença em relação aos modelos mais avançados está principalmente na capacidade, na estabilidade e no custo-benefício em tarefas complexas.
Preços oficiais da Gemini API: faixas de custo de Argon, Flash e Flash-Lite
Veja os preços oficiais do nível pago padrão da Gemini Developer API (em dólares por milhão de tokens). Eles não incluem acréscimos de plataformas terceirizadas, contratos empresariais nem custos de chamadas de ferramentas:
| Modelo | Entrada | Saída | Entrada com acerto de cache | Validade do preço |
|---|---|---|---|---|
| Gemini 4 Argon (atual) | $2.00 | $10.00 | $0.10 | Até 30/11/2026 |
| Gemini 4 Argon (após ajuste) | $4.00 | $20.00 | $0.20 | A partir de 01/12/2026 |
| Gemini 3.8 Flash (atual) | $0.75 | $3.75 | $0.075 | Até 31/12/2026 |
| Gemini 3.8 Flash (após ajuste) | $1.50 | $7.50 | $0.15 | A partir de 01/01/2027 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | Sem data oficial para dobrar o preço |
Pelos preços atuais, o valor de entrada do Argon é cerca de 2,67 vezes o do Flash, o do Flash é 2,5 vezes o do Flash-Lite e o valor de saída do Argon é 4 vezes o do Flash-Lite. Argon e Flash estão com preços promocionais até 30 de novembro e 31 de dezembro de 2026, respectivamente. Depois, os valores dobram. Para calcular o orçamento anual de projetos de longo prazo, é essencial considerar os preços após o ajuste.
Outro detalhe fácil de passar despercebido: o Google inclui os tokens de pensamento interno do modelo na cobrança de saída. A conta não depende apenas do tamanho da resposta visível ao usuário: um nível alto de pensamento pode aumentar bastante o custo de saída. Se a tarefa não exigir uma resposta em tempo real, você pode usar a Batch API. Nela, os preços de entrada e saída dos três modelos são 50% menores que os preços padrão, mas o modo de execução e os limites de fila diferem dos pedidos em tempo real.
Comparativo de benchmarks independentes e velocidade dos três modelos Gemini
Os dados abaixo vêm da plataforma independente de avaliação Artificial Analysis e usam exclusivamente o sistema Intelligence Index v5.0, sem misturar pontuações da versão anterior, v4.x:
| Indicador | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| Índice geral de capacidade v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| Velocidade de saída observada | Mais de 80 tokens/s | Cerca de 120–140 tokens/s | Mais de 400 tokens/s |
| Onde acessar | API oficial do Google, APIYI apiyi.com | API oficial do Google, APIYI | API oficial do Google, APIYI |
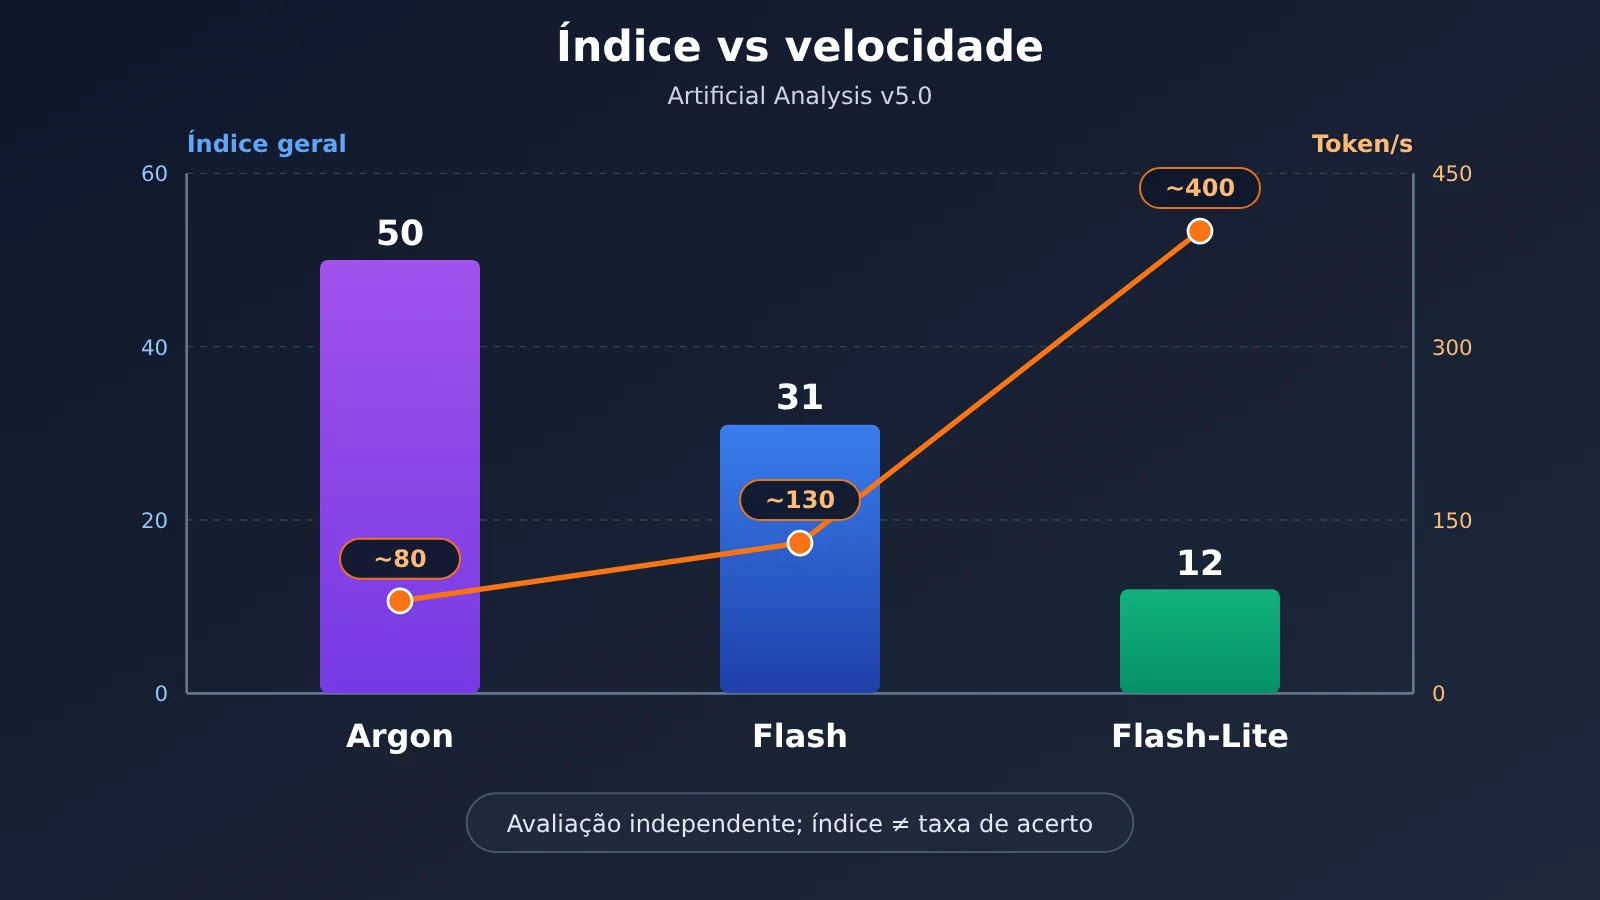
Para interpretar esses dados corretamente, vale observar três pontos:
- O índice não é uma taxa de acerto: 50, 31 e 12 são pontuações do sistema de avaliação e não significam, por exemplo, que o modelo “acertou 50%”.
- A diferença em tarefas complexas é clara: nos benchmarks de programação complexa e automação, o Argon é o mais forte, o Flash fica no meio e o Flash-Lite tem desempenho inferior. Isso não prova, porém, que o Argon seja melhor em toda tarefa simples: para classificação e formatação, por exemplo, os três modelos podem ser suficientes.
- A velocidade não se traduz diretamente em tempo de resposta: a taxa de saída varia conforme as condições do serviço. O tempo real também depende do tempo de raciocínio, da latência até o primeiro token, das chamadas de ferramentas, das filas e das oscilações de rede.
💡 Sobre a comparação: as pontuações de benchmark mostram apenas uma ideia geral das diferenças de capacidade. O resultado nas tarefas do seu negócio é o que realmente importa. Com a APIYI apiyi.com, você pode alternar entre os três modelos Gemini usando a mesma chave API e reproduzir a comparação com suas próprias amostras.
Simulação de custos da API Gemini: quanto varia a fatura entre Argon, Flash e Flash-Lite
Os valores abaixo são exemplos teóricos, não faturas reais. A simulação considera que os tokens de saída já incluem todos os tokens de raciocínio e não contabiliza custos de cache, ferramentas de busca ou novas tentativas. Em todos os casos, são usados os preços padrão de outubro de 2026:
| Cenário | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A: 1.000 chamadas por dia, com 5.000 tokens de entrada / 1.000 de saída por chamada (custo diário) | $20.00 | $7.50 | $4.00 |
| A: mesmo uso por 30 dias consecutivos | Cerca de $600 | Cerca de $225 | Cerca de $120 |
| B: classificação de 100 mil itens, com 1.000 tokens de entrada / 200 de saída por item | $400 | $150 | $80 |
| B usando a Batch API (preço por token reduzido pela metade) | Cerca de $200 | Cerca de $75 | Cerca de $40 |
O cenário B mostra apenas a diferença de preço para o mesmo uso de tokens. Na prática, os modelos variam na quantidade de tokens de raciocínio, no tamanho da saída e no número de novas tentativas. Não dá para presumir que gastar $80 com o Flash-Lite resulte na mesma qualidade que gastar $400 com o Argon. Além disso, quando os preços promocionais do Argon e do Flash terminarem, os valores dessas duas colunas dobrarão.
Análise de impacto: por que não basta olhar o preço por token da API Gemini
Impacto para desenvolvedores
O “preço” de um modelo tem pelo menos três camadas. A primeira é o preço por token. A segunda é a quantidade de tokens realmente consumida pela tarefa, incluindo entrada, saída, raciocínio, repetição de contexto e novas tentativas. A terceira é o custo total para concluir uma tarefa com qualidade aceitável, que também inclui taxa de sucesso, revisão humana, novas tentativas após falhas, tempo de conclusão e prejuízos causados por erros.
Se o Flash-Lite já atende aos padrões do negócio em uma classificação simples, trocar para o Argon é desperdício. Por outro lado, se uma tarefa complexa de programação falha repetidamente no Flash-Lite, mas o Argon consegue concluí-la com menos tentativas, o custo-benefício geral do Argon pode ser maior. Essa é uma hipótese condicional sobre critérios de escolha, não uma conclusão estatística sobre as taxas reais de sucesso dos três modelos.
Os relatos da comunidade também ilustram esse ponto. Um usuário do Reddit usou o Argon High no ambiente OpenCode para fazer engenharia reversa. Uma única execução consumiu cerca de 900 mil tokens, e a tarefa ainda assim não foi concluída. É um teste individual, que não pode ser tratado como média do setor, mas serve de alerta: fluxos de trabalho complexos com agentes podem consumir muitos tokens sem garantia de sucesso. Outro usuário relatou ter atingido rapidamente o limite de uso do Argon em uma assinatura para consumidores. Essa é uma experiência com o produto de assinatura do Gemini e não equivale aos limites da Developer API.
Impacto para o setor
- O uso de modelos em camadas se torna a arquitetura padrão: o Google Cloud já apresentou publicamente a orquestração de múltiplos modelos e o Smart Routing, que reduzem os custos das empresas ao direcionar tarefas para modelos diferentes.
- A avaliação deixa de focar no “preço unitário” e passa a considerar o “custo por tarefa concluída com qualidade aceitável”: quanto maior o volume de invocações, mais importante é usar conjuntos de testes do negócio para orientar a escolha, em vez de se basear em rankings.
- Os ciclos de orçamento ficam mais curtos: com o vencimento gradual dos preços promocionais, as equipes precisam revisar a combinação de modelos e o orçamento a cada trimestre.
Como escolher entre Argon, Flash e Flash-Lite
As recomendações abaixo dependem do cenário: não existe um modelo que seja o melhor em todas as situações.
- Classificação de dados em grande escala (como distribuir 100 mil notícias sobre IA em categorias de lançamentos, atualizações, preços e políticas): comece testando o Flash-Lite. Isso pressupõe que a precisão e a conformidade com o formato atendam às metas nos testes com amostras. Caso contrário, passe para o 3.8 Flash.
- Estruturação de documentos extensos (como transformar relatórios financeiros e documentos técnicos em tabelas de fatos): comece pelo 3.8 Flash. Ele tem capacidade de compreensão superior à do Lite e custa menos que o Argon. Para identificar contradições entre documentos ou resolver problemas de raciocínio difíceis, use o Argon pontualmente.
- Projetos de código complexos (compreensão de grandes bases de código e refatoração em várias etapas): comece pelo Argon. Tanto seu posicionamento oficial quanto seus resultados em benchmarks independentes de programação são mais fortes, mas ainda é preciso validar a taxa de sucesso, a execução de ferramentas e o custo em projetos reais.
- Tradução simples em grandes volumes: comece pelo Flash-Lite. Conteúdos altamente especializados, como textos jurídicos e médicos, exigem verificações adicionais de qualidade. Não os use sem revisão humana só porque o modelo é mais barato.
- Agentes empresariais: não é recomendável usar apenas um modelo. O Flash-Lite pode cuidar da classificação, extração e padronização de formatos; o 3.8 Flash, do planejamento geral e dos fluxos de trabalho com várias etapas; e o Argon, do raciocínio complexo e da investigação de problemas difíceis. Essa é uma estratégia de engenharia recomendada, não uma exigência do Google.
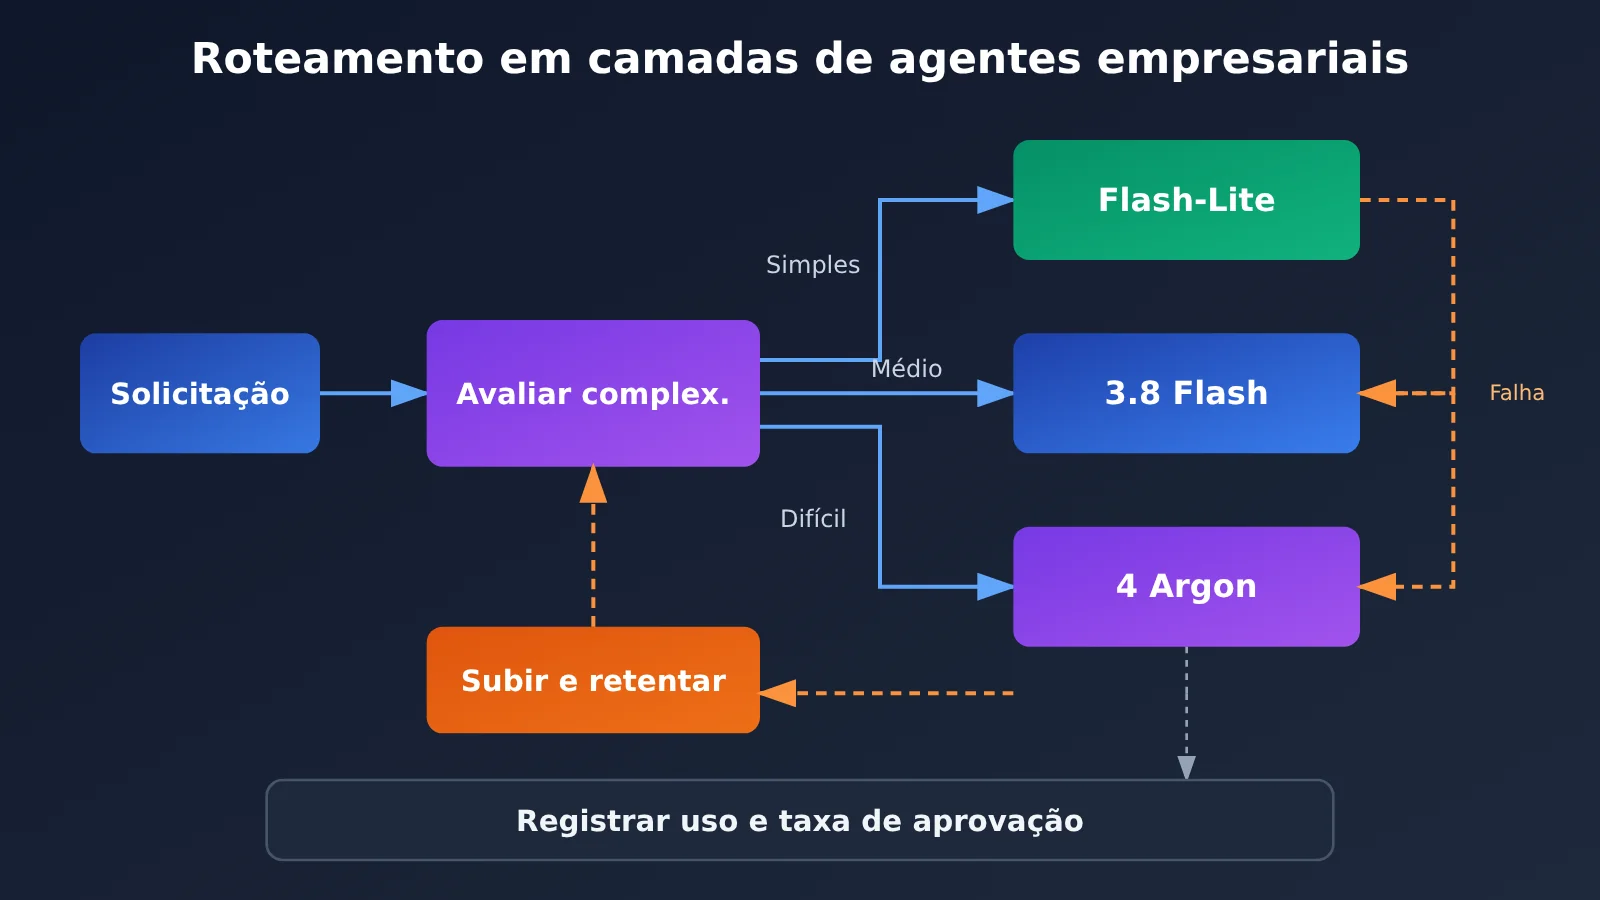
🎯 Dica de escolha: a chave para o roteamento em camadas é poder alternar entre os três modelos a baixo custo. A APIYI apiyi.com oferece uma interface compatível com OpenAI: basta alterar o parâmetro
modelpara trocar de nível. É uma boa opção para começar com testes comparativos em pequena escala.
Guia rápido: como chamar os três modelos Gemini pela API
Exemplo básico
Você pode usar o SDK da OpenAI e trocar o valor de model para alternar entre Argon, Flash e Flash-Lite:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
Ver o código completo de roteamento por níveis e estimativa de custos
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 Comece agora: recomendamos obter primeiro os créditos gratuitos de teste para novos usuários na APIYI, em apiyi.com. Teste os três níveis de modelo com 100 a 300 amostras representativas antes de escolher o nível padrão para produção. Os preços, créditos e recursos de cache de plataformas terceirizadas podem ser diferentes dos oferecidos pela conexão direta com o Google; consulte as regras da plataforma.
Cuidados antes de colocar a Gemini API em produção
- Limites de requisição: a Gemini API aplica limites de RPM, TPM e RPD por projeto, não por chave individual. Ultrapassar qualquer um deles gera um erro.
- Tokens de raciocínio: o preço de saída inclui tokens de raciocínio. Consulte os metadados de uso em vez de estimar o custo pelo tamanho da resposta visível.
- Cache: o Argon suporta apenas cache implícito, não explícito. Flash e Flash-Lite suportam cache, e a cobrança depende da configuração.
- Dados no plano gratuito: dados enviados pelo plano gratuito podem ser usados para melhorar os produtos. Não envie dados empresariais sensíveis por esse plano e confira os termos de serviço antes de entrar em produção.
- Métricas de teste: registre a taxa de sucesso, a precisão factual, a conformidade estrutural, o número de alucinações, as latências média e de cauda, o uso real de tokens, o número de tentativas e o custo por tarefa aprovada. Como os níveis de raciocínio padrão variam, informe no relatório a configuração usada.
Perguntas frequentes sobre a escolha de modelos da Gemini API
Q1: O que são Gemini 4 Argon, 3.8 Flash e 3.5 Flash-Lite?
São os três principais modelos da Gemini API do Google, cada um para uma faixa de uso: o Argon é o modelo de raciocínio mais avançado, o 3.8 Flash equilibra capacidade e eficiência, e o 3.5 Flash-Lite prioriza baixa latência, baixo custo e alto volume de processamento. Os três aceitam cerca de um milhão de tokens como contexto de entrada e geram respostas em texto.
Q2: Quando terminam os preços promocionais do Argon e do Flash?
O preço atual do Argon vale até 30 de novembro de 2026. A partir de 1º de dezembro, os preços de entrada, saída e cache dobram. Já o preço do 3.8 Flash vale até 31 de dezembro de 2026 e dobra em 1º de janeiro de 2027. Até o momento, o Google não informou uma data semelhante para o Flash-Lite.
Q3: Uma pontuação de 50 no Artificial Analysis significa que o modelo acerta 50% das respostas?
Não. Os valores 50, 31 e 12 são pontuações compostas do Intelligence Index v5.0, não percentuais de acerto. Eles ajudam a comparar o desempenho geral dos modelos, mas não podem ser convertidos diretamente na taxa de sucesso do seu caso de uso.
Q4: Como comparar os três modelos Gemini gastando pouco?
Uma opção é usar uma interface compatível com a OpenAI que ofereça suporte a vários modelos. Depois de se cadastrar no APIYI apiyi.com e obter uma chave API e créditos gratuitos, troque o valor de `model` no exemplo deste artigo pelos três IDs de API, um de cada vez. Use o mesmo conjunto de amostras para registrar o consumo e a taxa de respostas aprovadas.
Q5: Vi no Reddit que o limite do Argon acaba depois de poucas rodadas. Isso também acontece na API?
Esse relato se refere ao produto de assinatura do Gemini para consumidores e não equivale aos limites da Developer API. Na API, as cotas dependem do nível de pagamento, do status do projeto e do modelo, e são calculadas em RPM, TPM e RPD. Ao usar uma plataforma agregadora, também é preciso considerar as regras de cota da própria plataforma. No console do APIYI apiyi.com, você pode conferir os modelos disponíveis e as formas de cobrança.
Q6: Quais são as limitações conhecidas de cada modelo?
O Argon tem o maior preço unitário, é o mais lento e não conta com uma camada gratuita padrão. Tarefas complexas com agentes podem consumir muitos tokens. O 3.8 Flash fica bem atrás do Argon nos benchmarks mais difíceis de terminal e programação. Já o Flash-Lite tem desempenho mais fraco em tarefas complexas de programação e automação, e suas traduções em áreas especializadas precisam de revisão humana.
Principais pontos para escolher uma API Gemini
- Contexto da notícia: as APIs dos modelos proprietários do Google processam quase 32 bilhões de tokens por minuto. Esse número representa o crescimento geral, não o desempenho de um único modelo.
- Três categorias: o Argon cuida de raciocínio complexo, o 3.8 Flash é a opção equilibrada para uso geral e o Flash-Lite atende tarefas leves em alto volume.
- Faixas de preço: os preços atuais de entrada são de US$ 2 / US$ 0,75 / US$ 0,30 por milhão de tokens. Os preços do Argon e do Flash dobram após o fim da promoção.
- Como interpretar a avaliação: os valores do índice AA v5.0 são 50 / 31 / 12. Trata-se de um índice, não de uma taxa de acerto; em tarefas simples, a diferença pode nem ser tão grande.
- Custos ocultos: tokens de raciocínio contam como saída. Cache, novas tentativas e taxas de ferramentas também influenciam a conta final.
- Como começar: com a APIYI, em apiyi.com, é possível alternar entre as três categorias usando uma única chave e fazer testes comparativos com 100 a 300 amostras.
Resumo
O aumento expressivo no volume de chamadas à API Gemini mostra que os Modelos de Linguagem Grande já estão sendo usados em produção em larga escala. Mas a questão central na escolha continua a mesma:
- Separe as tarefas por nível: para classificação e tradução, comece pelo Flash-Lite; para estruturação de documentos, teste primeiro o 3.8 Flash; para código complexo e agentes com tarefas difíceis, comece pelo Argon.
- Observe o custo por tarefa concluída com qualidade: o objetivo é otimizar o custo total de cada tarefa que atenda aos requisitos, e não buscar apenas o menor preço por milhão de tokens.
- Fique de olho no fim das promoções: o preço promocional do Argon termina em 30 de novembro, e o do Flash, em 31 de dezembro. Calcule o orçamento com base nos preços após o reajuste.
O que os desenvolvedores realmente precisam não é do modelo mais poderoso ou mais barato em todas as situações, mas de uma combinação de modelos capaz de cumprir as tarefas do negócio de forma consistente e a um custo aceitável. Uma boa opção é usar primeiro os créditos gratuitos da APIYI, em apiyi.com, para comparar as três categorias e depois definir a estratégia de roteamento em produção.
📚 Referências
- Comunicado do CEO no relatório financeiro da Alphabet do 3º trimestre de 2026: fonte do dado de 32 bilhões de tokens por minuto
- Link:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
Descrição: contexto da notícia e divulgação original do crescimento no uso da API
-
Preços oficiais da API Gemini: preços padrão, de cache e Batch dos três modelos
- Link:
ai.google.dev/gemini-api/docs/pricing -
Descrição: inclui o prazo dos preços promocionais e as regras de cobrança dos tokens de raciocínio
-
Documentação das especificações dos modelos Gemini: Argon / 3.8 Flash / 3.5 Flash-Lite
- Link:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
Descrição: contexto, limite de saída, níveis de raciocínio e recursos de ferramentas
-
Comparação de modelos da Artificial Analysis: avaliação independente de terceiros v5.0
- Link:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
Descrição: índice geral, benchmarks específicos e medições de velocidade
-
Limites de chamadas e mecanismo de raciocínio da API Gemini: RPM/TPM/RPD e configurações de raciocínio
- Link:
ai.google.dev/gemini-api/docs/rate-limits -
Descrição: regras de cotas e tokens de raciocínio, leitura essencial antes de colocar em produção
-
Orquestração de múltiplos modelos no Google Cloud: Smart Routing e gestão de custos de agentes
- Link:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - Descrição: abordagem oficial para roteamento em camadas nas empresas
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial do site da APIYI. Para mais informações sobre integração, acesse a documentação em docs.apiyi.com