
Resumo dos testes de redação do GPT, Claude e Kimi: primeiro, o veredito
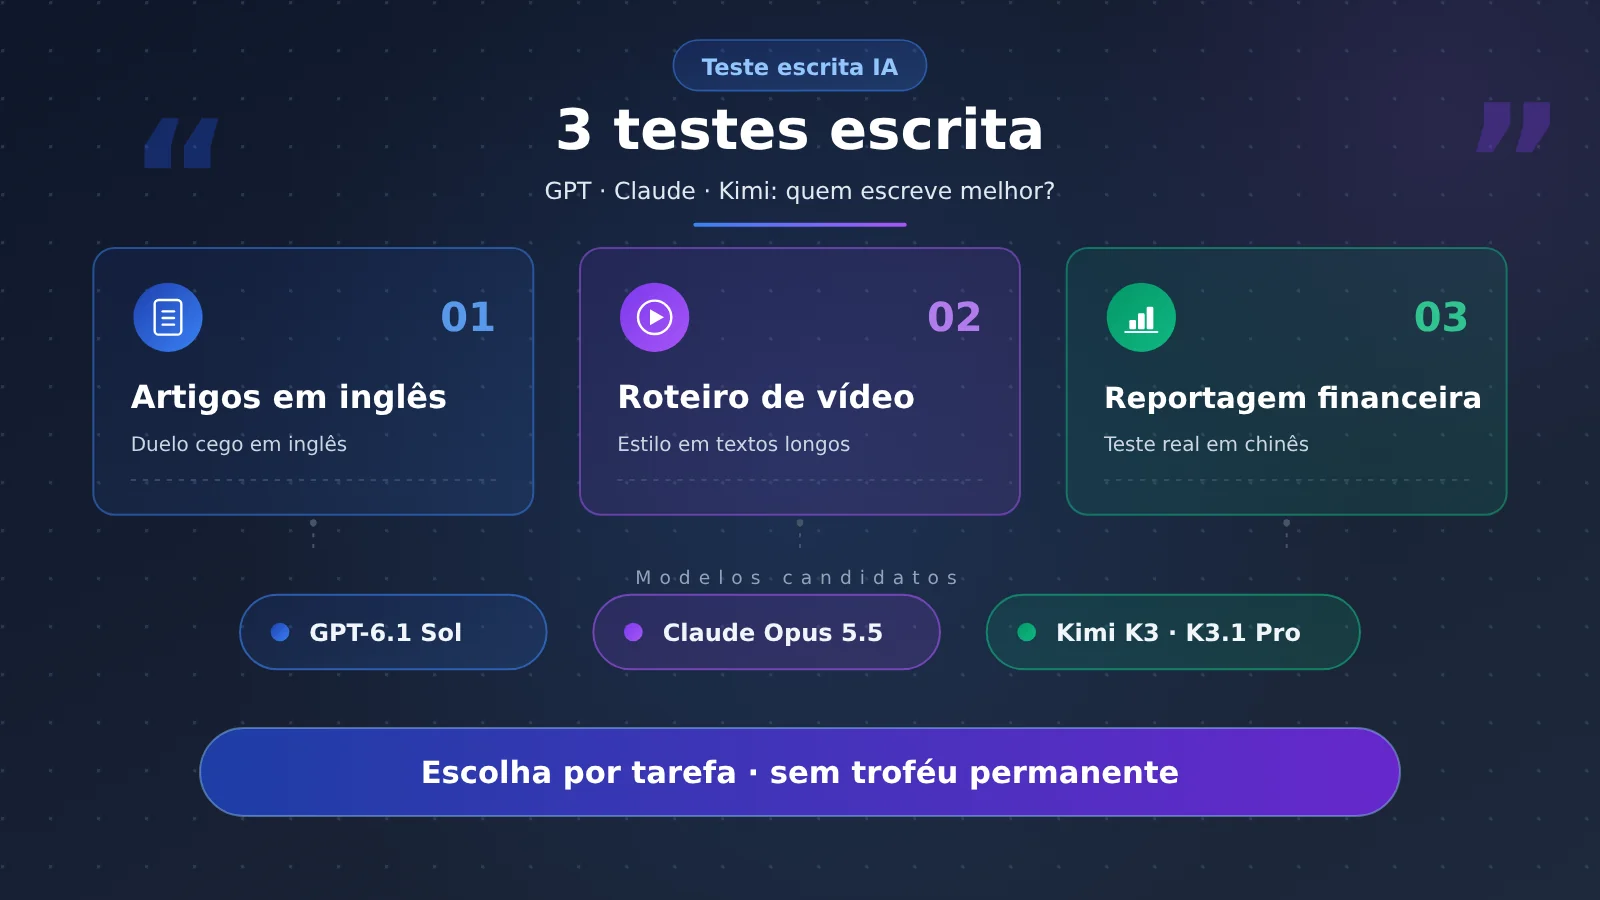
Para artigos em inglês, comece testando o GPT-6.1 Sol; para textos longos que valorizam o estilo, comece testando o Claude Opus 5.5; para explicações de divulgação científica, vale a pena incluir o Kimi K3. O desempenho geral do Kimi K3.1 Pro em inglês também é forte, ficando próximo do GPT no ToneBench.
Os três testes cobrem tarefas, idiomas e métodos de avaliação diferentes. A conclusão mais prática é montar uma lista de candidatos e validar com seus próprios textos, em vez de conceder um troféu permanente às três famílias de modelos.
Dica para começar: é possível invocar os modelos candidatos pela interface unificada do APIYI apiyi.com e comparar os rascunhos iniciais usando o mesmo pacote de materiais. A cota de teste gratuita para novos usuários segue as regras atuais da plataforma.
Teste de escrita GPT, Claude e Kimi: o que vem a seguir?
Este artigo detalha, em sequência, o ranking de escrita em inglês, o teste de roteiros longos para vídeos estilizados e o teste prático de artigos financeiros aprofundados em chinês. No final, apresenta a seleção de cenários, as etapas do teste cego e exemplos de invocação, com foco na qualidade dos textos e no custo de edição humana.
Antes, vamos combinar dois termos: benchmark de escrita é um teste que avalia a saída com base em uma tarefa definida; avaliação cega é a comparação de textos sem revelar a identidade do modelo. A avaliação cega pode ser feita por pessoas ou por modelos; ao ler os resultados, é importante saber quem é o avaliador.
Teste de escrita GPT, Claude e Kimi 1: artigos em inglês, com foco no GPT
O AI Writing Benchmark é um projeto de escrita em inglês mantido por Johannes Eva e declara não receber pagamento de fabricantes de modelos. Este artigo usa os resultados da atualização de 11 de novembro de 2026, consultados em 12 de novembro.
O projeto abrange 115 modelos e registra 131.507 confrontos públicos de avaliação cega. Ele avalia a escrita por meio da comparação de textos anônimos, e os rankings de avaliação por IA e de votação humana são exibidos separadamente.
| Modelo | Pontuação geral em inglês | Critério do resultado |
|---|---|---|
| GPT-6.1 Sol | 95.3 | 1º no ranking geral |
| Claude Opus 5.5 | 92.9 | 2º no ranking geral |
| Kimi K3.1 Pro | 91.9 | 3º no ranking geral |
A pontuação geral agrega vários tipos de tarefa; a pontuação por categoria de tarefa reflete apenas um determinado tipo de tarefa. A pontuação por categoria do GPT-6.1 Sol em artigos, blogs e conteúdo editorial é 98.5, que deve ser registrada separadamente da pontuação geral de 95.3.
Essas são pontuações relativas dentro do próprio benchmark. O projeto define 50 como o ponto em que a probabilidade estimada de vencer o modelo médio atual daquele idioma e categoria é de 50%; os leitores devem observar a posição competitiva, em vez de tratar a pontuação como uma proporção de conteúdo publicável.
Em termos claros: se a tarefa for um blog em inglês ou um artigo editorial, o GPT-6.1 Sol tem bons motivos para entrar na primeira rodada de testes. Já para artigos em chinês, é preciso buscar evidências específicas em chinês.
Outro resultado que merece atenção: Kimi K3 lidera na categoria de explicação e divulgação científica com 94.9. Aqui, quem vence é o K3; já o terceiro lugar no ranking geral é o K3.1 Pro. O nome da versão deve ser guardado junto com a pontuação.
Teste de escrita 2: GPT, Claude e Kimi — no texto longo, o estilo fica com Claude
O ToneBench pede que os modelos leiam um briefing de criação, um pacote de materiais de pesquisa e um guia de estilo, e então gerem um roteiro completo para YouTube. Os modelos não podem ver o roteiro final do autor original, nem acessar a internet ou usar ferramentas externas.
Este artigo usa materiais atualizados em 10 de novembro de 2026. A tarefa é um roteiro longo de vídeo de um criador específico; os materiais fornecidos não listam explicitamente todos os idiomas das tarefas, então aqui a leitura é feita no contexto de roteiro.
O teste inclui 87 modelos e 151 configurações. Cada configuração realiza 10 tarefas, e cada tarefa é gerada 5 vezes de forma independente. No total, são gerados 7.550 roteiros, com 30.200 avaliações feitas por quatro avaliadores de IA.
Ele dá atenção especial à correspondência de estilo, ou seja, se tom, ritmo e forma de expressão se aproximam do criador-alvo. O peso da correspondência de estilo é de 19%; profundidade, precisão e valor do conteúdo, 15%; também avalia coerência e controle de extensão.
A tabela abaixo usa o Writing Score da melhor configuração de cada modelo, além do ranking de modelos listado nos materiais. Claude corresponde a xhigh; os materiais não trazem os nomes das configurações específicas de raciocínio dos outros dois modelos, então isso deve ser completado numa nova rodada de testes.
| Modelo | Ranking do modelo | Writing Score | Custo estimado por roteiro no teste |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85,8 | $1,003 |
| GPT-6.1 Sol | 8 | 82,4 | $0,239 |
| Kimi K3.1 Pro | 9 | 82,5 | $0,251 |
O Writing Score é o indicador que resume o desempenho de escrita nesse teste; já o ranking segue o critério Elo. Portanto, o fato de o Kimi ter 0,1 ponto a mais e ficar uma posição abaixo deve ser entendido como desempenho próximo entre os dois.
Claude lidera nesse conjunto de resultados, com custo estimado no teste cerca de 4,2 vezes o do GPT. Esta é uma estimativa de custo do ToneBench e não deve ser usada diretamente como preço de artigo em outras plataformas.
Para entender o ranking, o melhor é colocar tarefas e avaliações na mesma imagem. Ao refazer os testes com a APIYI apiyi.com, recomendamos manter o registro das configurações e depois voltar ao ranking original para conferir os critérios de comparação.
Os intervalos de confiança do primeiro e do segundo lugar do ToneBench se sobrepõem; remover qualquer um dos roteiros de referência também altera o topo da classificação. O estudo também observou certa preferência de fornecedor nas avaliações, mas, mesmo após excluir as avaliações individuais, Claude continuou em primeiro.
A conclusão central é: para textos longos que exigem absorver materiais e manter a voz do criador, vale a pena testar o Claude primeiro. Esse resultado ajuda a orientar a escolha de candidatos; a magnitude da vantagem ainda precisa ser validada com seus próprios roteiros.
Vale ainda observar que a pontuação individual de Least Slop do GPT-6 Sol pertence a outra versão e a outra métrica, e não pode ser usada para substituir o Writing Score do GPT-6.1 Sol.
GPT, Claude e Kimi no teste de escrita 3: o que observar em uma matéria longa em chinês?
O teste do OmniTools aconteceu entre 26 de outubro e 3 de novembro de 2026, com matérias jornalísticas chinesas de profundidade sobre economia e finanças do PANews. Foram comparados 10 modelos e 26 artigos.
| Modelo | Pontuação cega por IA | Artigos testados | Pontuação de naturalidade |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
Nesse teste, o Claude teve nota geral e naturalidade mais altas. Para matérias longas de economia e finanças em chinês, o Claude Opus 5.5 é o candidato que vale a pena testar primeiro.
Mas a amostra é pequena, o número de artigos por modelo é desigual e o Kimi não participou. Portanto, esse material só acrescenta evidências sobre o cenário em chinês para GPT e Claude; não dá para montar um ranking completo dos três em chinês.
A avaliação foi feita com Claude Opus 5.5 e DeepSeek V4 Pro, com a regra de não avaliar o próprio modelo. O veículo que publicou tem vínculo comercial com serviços de roteamento de API — vale manter essa informação de origem em mente na leitura.
As observações editoriais são outro registro. A taxa de 100% de adoção pela edição do Claude corresponde a apenas 1 de 1 rodada, então serve como estudo de caso; para saber a adoção no longo prazo, ainda são necessários mais textos.
Resumindo em uma frase: aqui há sinais positivos de que o Claude escreve bem matérias longas de economia e finanças em chinês, e o escopo da evidência é exatamente esse cenário.
Teste de escrita de GPT, Claude e Kimi: escolha candidatos por cenário
Colocar os três resultados lado a lado deve formar uma tabela de seleção, e não uma soma de pontuações. O idioma do artigo, a tarefa e o estilo desejado definem quais evidências são relevantes para você.
| Cenário de escrita | Candidato prioritário | Base da escolha |
|---|---|---|
| Blogs em inglês, artigos editoriais | GPT-6.1 Sol | Lidera na categoria de artigos em inglês |
| Roteiros longos de vídeo no estilo de criador de conteúdo | Claude Opus 5.5 | Lidera atualmente no ToneBench |
| Artigo aprofundado de finanças em chinês | Claude Opus 5.5 | Lidera em teste real com pequena amostra em chinês |
| Explicações e divulgação científica em inglês | Kimi K3 | Lidera nas categorias de explicação e divulgação |
| Conteúdo longo baseado em pacote de materiais | Teste cego conjunto dos três | GPT e Kimi estão próximos no ToneBench |
| Plataforma de validação de chamadas | APIYI apiyi.com | Interface unificada facilita a troca de modelos |
Tutoriais técnicos em chinês, apresentações de produtos e outros cenários não estão completamente cobertos pelas três evidências existentes. A abordagem mais segura é testar os candidatos ao mesmo tempo, para ver qual consegue explicar a tecnologia com clareza e apresentar os fatos com precisão.
Teste de escrita de GPT, Claude e Kimi: como fazer sua própria comparação?
Recomenda-se escolher um tema real e fornecer a todos os modelos exatamente os mesmos materiais, planejamento, extensão e permissões de ferramentas. Cada modelo deve gerar pelo menos três vezes de forma independente; depois, oculte os nomes dos modelos e entregue o material à avaliação de editores.
A pontuação pode começar por cinco itens: precisão factual, execução do planejamento, naturalidade da expressão, clareza estrutural e valor do conteúdo. Os pesos são definidos pela tarefa da equipe, e deixe claro que se trata de regras próprias.
Registre também o custo de edição humana: o trabalho necessário para deixar o texto pronto para publicação. O ideal é registrar ao mesmo tempo o tempo de edição, os parágrafos reescritos, os erros factuais e se o texto foi finalmente adotado.
Sugestão de configuração: no APIYI apiyi.com, use uma única chave API para alternar entre modelos, o que reduz o trabalho de integração repetida. Durante o teste, mantenha a versão do modelo, os parâmetros e o uso real de tokens para facilitar a reprodução.
A seguir está um exemplo mínimo de chamada. Coloque o mesmo pacote real de materiais em brief e altere o nome do modelo para gerar um rascunho de comparação; a chave deve ser fornecida com segurança pelo ambiente de execução.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
Este código serve para começar; um teste cego formal ainda deve repetir as gerações, apresentar os resultados de forma anônima e registrar as configurações. Para validar o modelo que lidera na categoria de explicação, é preciso incluir adicionalmente o Kimi K3.
FAQ do teste de escrita GPT, Claude e Kimi
No teste de escrita GPT, Claude e Kimi, qual versão do Kimi devo testar?
Para conteúdo explicativo e de divulgação, priorize o Kimi K3; ao comparar o ranking geral deste artigo com os resultados do ToneBench, use o K3.1 Pro. Antes de chamar via APIYI apiyi.com, confira a lista de modelos e o nome exato do modelo, para não misturar versões.
No teste de escrita GPT, Claude e Kimi, como comparar o custo real?
Compare o “custo por artigo aprovado”: o gasto acumulado com chamadas somado ao esforço de edição. Ao testar na APIYI apiyi.com, registre o uso real e o número de tentativas e recalcule com o preço vigente na época — isso reflete a produção real melhor do que olhar apenas o custo do primeiro rascunho.
Fim do teste de escrita GPT, Claude e Kimi: escolha o modelo que dá menos trabalho de edição
Para artigos em inglês, comece pelo GPT; para textos longos com estilo próprio e análises financeiras profundas em chinês, comece pelo Claude; para conteúdo explicativo e de divulgação, inclua o Kimi. Essa é uma ordem de prioridade para tarefas específicas, não um ranking permanente de toda a família de modelos.
A recomendação é validar os resultados na APIYI apiyi.com usando o mesmo pacote de materiais. No fim, escolha quem executa o planejamento com mais precisão e preserva mais parágrafos aproveitáveis, poupando uma rodada extra de trabalho para o editor.
Materiais de referência para testes de escrita com GPT, Claude e Kimi
-
AI Writing Benchmark: aiwritingbenchmark.com
Ranking geral e por categoria em inglês, com critérios atualizados em 11 de novembro de 2026. -
Towards AI ToneBench: benchmark.towardsai.com/models/
Testes de roteiros para vídeo, ranking de modelos, configurações e estimativas de custo, com base nos dados de 10 de novembro de 2026. -
Teste prático de escrita de textos longos e aprofundados da OmniTools: omnitools.ai/evals/longform-writing
Teste da PANews com matérias financeiras aprofundadas em chinês, realizado de 26 de outubro a 3 de novembro de 2026.
Autor: Equipe de conteúdo técnico da APIYI. Convidamos você a trocar ideias sobre configuração de modelos, métodos de teste cego e experiência editorial no APIYI (apiyi.com).


