Nota do autor: O ranking do Artificial Analysis Search Index de 2026-11-09 mostra que, mantendo fixo um modelo de resposta e trocando apenas a configuração de busca, a pontuação geral pode variar de 33 a 83 pontos. Ainda assim, na escolha da solução é preciso considerar ao mesmo tempo o custo da tarefa, o tempo de execução e os limites da avaliação.
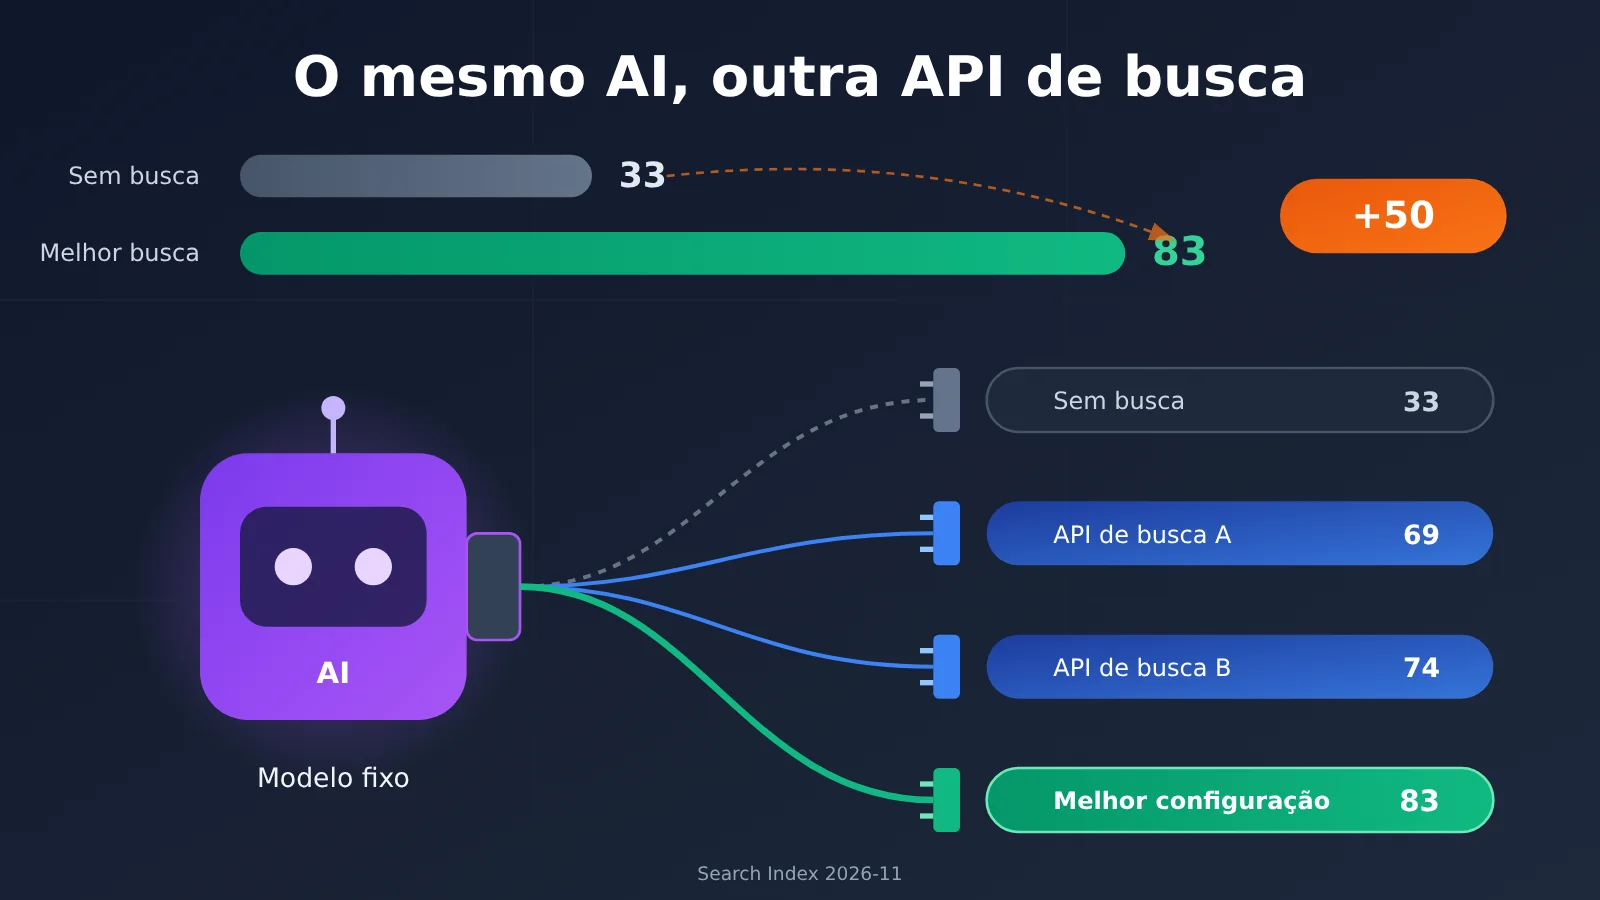
Muitas pessoas, ao construir um Agent, primeiro escolhem o modelo e depois simplesmente conectam uma ferramenta de busca. Para muitas equipes, a busca é apenas um acessório em que “basta ter internet”. O Search Index atualizado pelo Artificial Analysis em 9 de novembro de 2026 traz um resultado diferente: o mesmo modelo, sem busca, marca 33 pontos; com a melhor configuração de API de busca, pode chegar a 83 pontos.
Não é mais uma cópia de ranking em que “cada um tem seus pontos fortes”. Este artigo vai destrinchar como os 83 pontos são calculados e as condições de teste, além de comparar em conjunto qualidade, tempo total da tarefa, custo de busca e custo do modelo. Por fim, explica por cenário em quais decisões esse ranking pode ser usado e onde ele não pode ser aplicado diretamente.
Valor central: depois de ler este artigo, você poderá usar o ranking público para filtrar candidatos de API de busca e, então, fazer uma segunda comparação com base na sua própria tarefa, evitando decidir apenas pela maior pontuação.
Termos essenciais antes de ler o ranking de Search API
Resumo em uma frase: o Search Index compara o desempenho do mesmo modelo sob diferentes configurações de busca, e a diferença entre as pontuações chega a 50 pontos. Mas “pontuação alta” não significa “a melhor opção para você”: é preciso considerar também custo, tempo de resposta e escopo de avaliação.
Antes de ler o ranking, vamos alinhar alguns termos:
- Search Index: pontuação composta, calculada por regras a partir de um benchmark de recuperação definido. Neste artigo, refere-se especificamente ao índice de avaliação de Search API da Artificial Analysis, com nota máxima de 100.
- F1: média harmônica entre precisão e recall. Quando a resposta é “um conjunto de entidades”, essa métrica indica se a resposta está correta e completa.
- Harness: estrutura de teste que organiza a entrada do modelo, a execução das ferramentas e a pontuação das tarefas. O loop de agente usado pela Artificial Analysis chama-se Stirrup.
- Search API: interface que retorna resultados de busca como links, títulos e trechos relevantes para uma consulta, por exemplo Exa, Brave e Perplexity Search API.
- Token: unidade de medida do texto processado pelo modelo. Quanto mais longo o resultado da busca, mais tokens entram no modelo e maior é o custo.
Uma Search API pode fazer o mesmo modelo variar 50 pontos?
A Artificial Analysis lançou o benchmark de Search API em 18 de agosto de 2026. Os dados públicos mais recentes foram atualizados em 9 de novembro de 2026 e cobrem 14 provedores, 26 produtos ou configurações de Search API. O que é avaliado não é o modelo, mas o efeito real de um serviço de busca quando inserido em um agente.
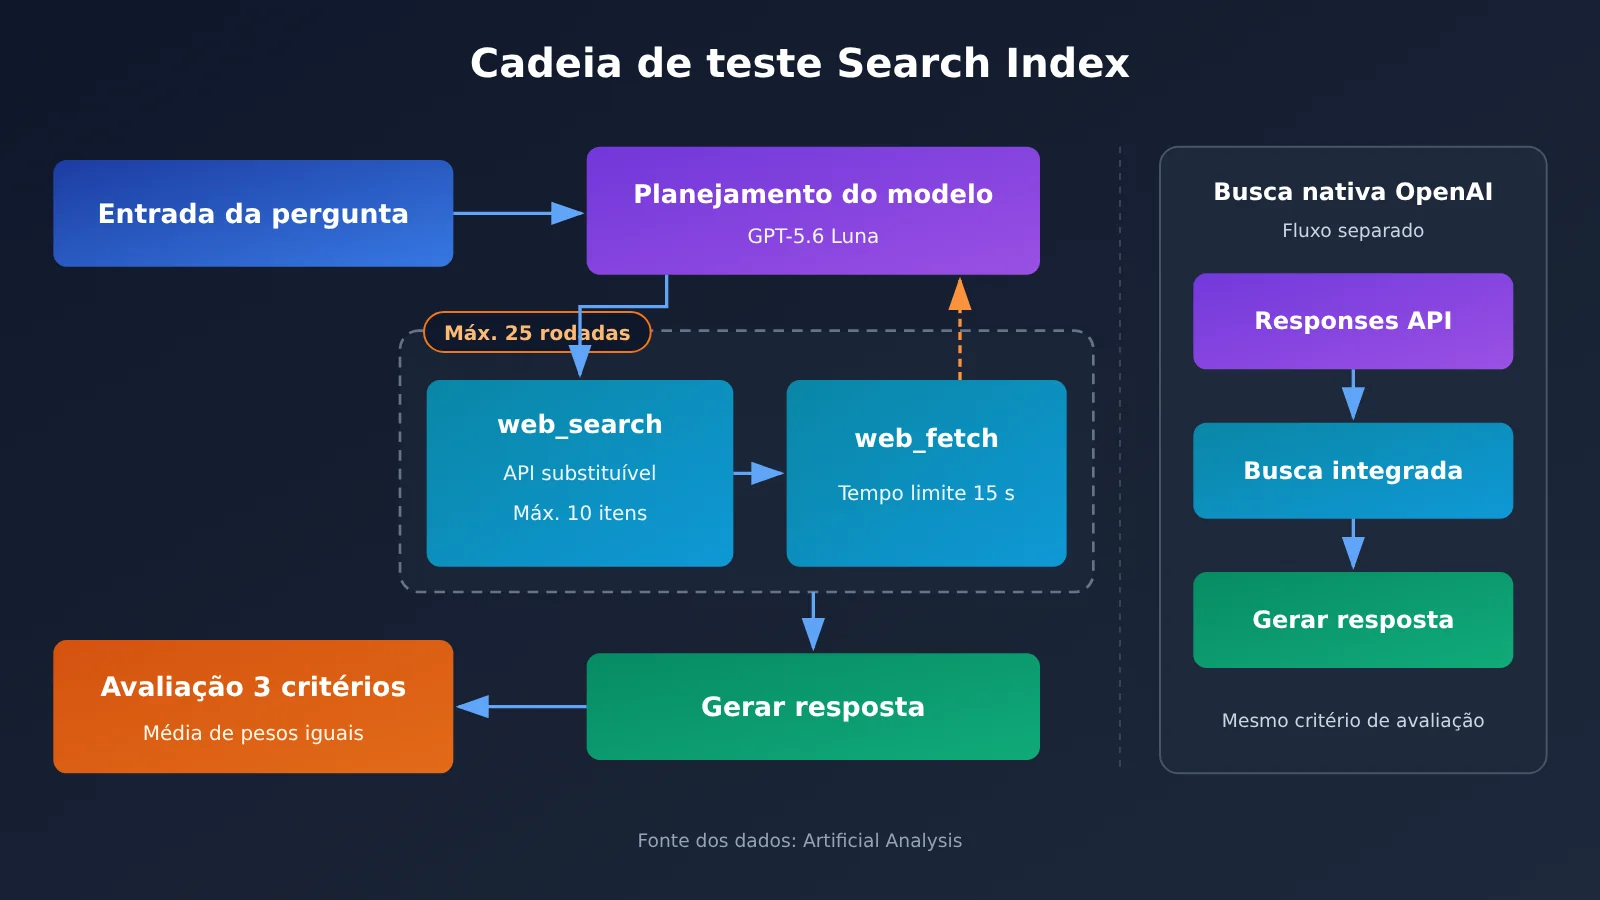
O ponto central do desenho experimental é “controlar as variáveis”. O modelo candidato de resposta é fixo: GPT-5.6 Luna (medium), e a estrutura do agente também não muda — só o serviço de busca é substituído. Nessas condições, a linha de base sem ferramenta de busca fica em 33 pontos, enquanto o Keenable Pro, em primeiro lugar, alcança 83 pontos: uma diferença de 50 pontos no índice. Mesmo entre configurações que usam busca, a variação de 69 pontos do DeepSeek Search Summary até 83 pontos do Keenable Pro chega a 14 pontos.
Há uma exceção que precisa ser explicada à parte: o Web Search nativo da OpenAI funciona de outra maneira. As demais Search APIs independentes rodam no loop externo de agente da Artificial Analysis. Já o Web Search da OpenAI usa o fluxo de ferramenta integrado da Responses API, e a quantidade de buscas e a forma de execução ficam a cargo da própria OpenAI. Por isso, seus 74 pontos servem como referência, mas não podem ser vistos como um experimento de “troca de API” em condições idênticas.
Vale notar também que esses 50 pontos representam o efeito de ampliação por busca dentro de um mesmo sistema de avaliação. Isso não significa que qualquer pessoa, usando qualquer modelo com busca, ganhará 50 pontos percentuais.
Como, afinal, é medido o 83 do Search Index?
As três referências do Search Index e a forma de pontuação
A pontuação final é a média das três referências com pesos iguais, cada uma valendo um terço:
| Referência | Volume de tarefas | Tipo de tarefa | Métrica de avaliação |
|---|---|---|---|
| DeepSearchQA | 900 tarefas | Pesquisa factual complexa, com respostas frequentemente em forma de conjunto | F1 do conjunto de respostas |
| BrowseComp | 200 tarefas | Perguntas e respostas de busca na web de maior dificuldade | Acurácia da resposta exata |
| AA-Omniscience | 600 tarefas | Perguntas e respostas factuais | Acurácia em perguntas factuais |
As três somam 1.700 tarefas no total, mas a pontuação final não é a taxa de acerto calculada juntando as 1.700 questões. Tomando o Keenable Pro como exemplo, as três notas são, na ordem, 88, 87 e 73, com média de cerca de 82,67, que após arredondamento aparece como 83. Ou seja, 83 pontos não significa “taxa de acerto de 83%”.
As condições de teste do Search Index
As configurações-chave divulgadas na metodologia são as seguintes:
| Item do experimento | Configuração real |
|---|---|
| Modelo de resposta candidata / modelo de pontuação | GPT-5.6 Luna (medium) |
| Máximo de rodadas do agente | 25 rodadas, sem limite de chamadas de ferramentas dentro de cada rodada |
| Ferramentas disponíveis | web_search, web_fetch (leitura independente de páginas web) |
| Resultados por busca | no máximo 10 itens |
| Timeout da extração do corpo da página | 15 segundos por página |
| Conteúdo devolvido ao modelo | resposta nativa do provedor |
| Linha de base sem busca | o mesmo modelo, sem usar ferramentas de busca |
Desta tabela dá para tirar duas conclusões. Primeiro, o que volta para o modelo é a “resposta nativa do provedor”. O comprimento dos trechos, a forma de resumo e a organização dos destaques entram todos no contexto do modelo, então a nota reflete não apenas a qualidade do índice de páginas subjacente, mas também a forma como a informação é organizada. Segundo, erros fatais como 429, 5xx ou timeout são repetidos continuamente até darem certo, e esses erros não entram no resultado final. Isso significa que o ranking mede a qualidade “quando o fluxo roda”, e não serve para comprovar a disponibilidade ou a taxa de falhas de cada provedor em ambiente de produção.
Ranking mais recente do Search Index: qual API de busca tem o melhor desempenho?
Na tabela abaixo, a pontuação de qualidade e o BrowseComp vêm do ranking de 2026-11-09. O tempo de execução usa os valores do ranking lidos em 2026-11-13 e se refere ao tempo médio de uma tarefa de teste padrão do início ao fim, não à latência de rede de uma única requisição à API de busca.
| Configuração de busca | Pontuação geral (11-09) | BrowseComp | Tempo médio da tarefa (11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16.6 segundos |
| Keenable Realtime | 82 | 86% | 16.0 segundos |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36.7 segundos |
| Perplexity Search Medium | 80 | 87% | 31.1 segundos |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19.4 segundos |
| Parallel Advanced | 75 | 77% | Não listado nesta atualização de tempo |
| Brave LLM Context | 75 | 77% | Não listado nesta atualização de tempo |
| OpenAI Web Search Medium (fluxo integrado do Responses) | 74 | 74% | 33.1 segundos |
| DeepSeek Search Summary | 69 | 63% | 22.4 segundos |
| Linha de base sem busca | 33 | 17% | — |
Três diferenças típicas no ranking das APIs de busca
Mesma pontuação, velocidades diferentes. Exa Auto e Perplexity Medium têm ambos 80 pontos, mas o tempo total da tarefa é de 36.7 segundos e 31.1 segundos, respectivamente. O Keenable Pro tem pontuação maior, mas o tempo é de apenas cerca de 16.6 segundos. Para agentes que precisam de resposta em tempo real, essa diferença é sentida diretamente pelo usuário.
O BrowseComp não segue totalmente a pontuação geral. O BrowseComp do Perplexity Medium chega a 87%, empatado com o Keenable Pro, mas a pontuação geral é 3 pontos menor. A diferença vem principalmente dos outros dois benchmarks. Se o seu negócio estiver mais voltado para “busca web de problemas difíceis”, vale consultar separadamente a coluna BrowseComp.
Modos diferentes do mesmo fornecedor variam muito. Exa Lite e Exa Auto diferem em apenas 1 ponto, mas o tempo de execução é quase o dobro. Por isso, interprete por modo específico do produto e não combine Exa Lite e Exa Auto em uma única “pontuação Exa”.
💡 Nota sobre os dados: as pontuações acima são resultados de avaliação de terceiros do Artificial Analysis, e os tempos são tempos de tarefa padrão. Se quiser reproduzir uma comparação semelhante nos seus próprios problemas de negócio, você pode fixar um modelo de resposta via APIYI apiyi.com e depois conectar diferentes ferramentas de busca para fazer testes A/B.
A API de busca com maior pontuação é sempre a mais vantajosa?
O Artificial Analysis também divulgou os custos estimados por 1.000 tarefas de benchmark, separando-os em custo de busca e custo do modelo (ranking de 2026-11-09, em USD). A coluna “custo por ponto” foi calculada de forma aproximada pela edição deste artigo como “custo total ÷ pontuação geral”; ela serve apenas como referência comparativa e não é um indicador oficial.
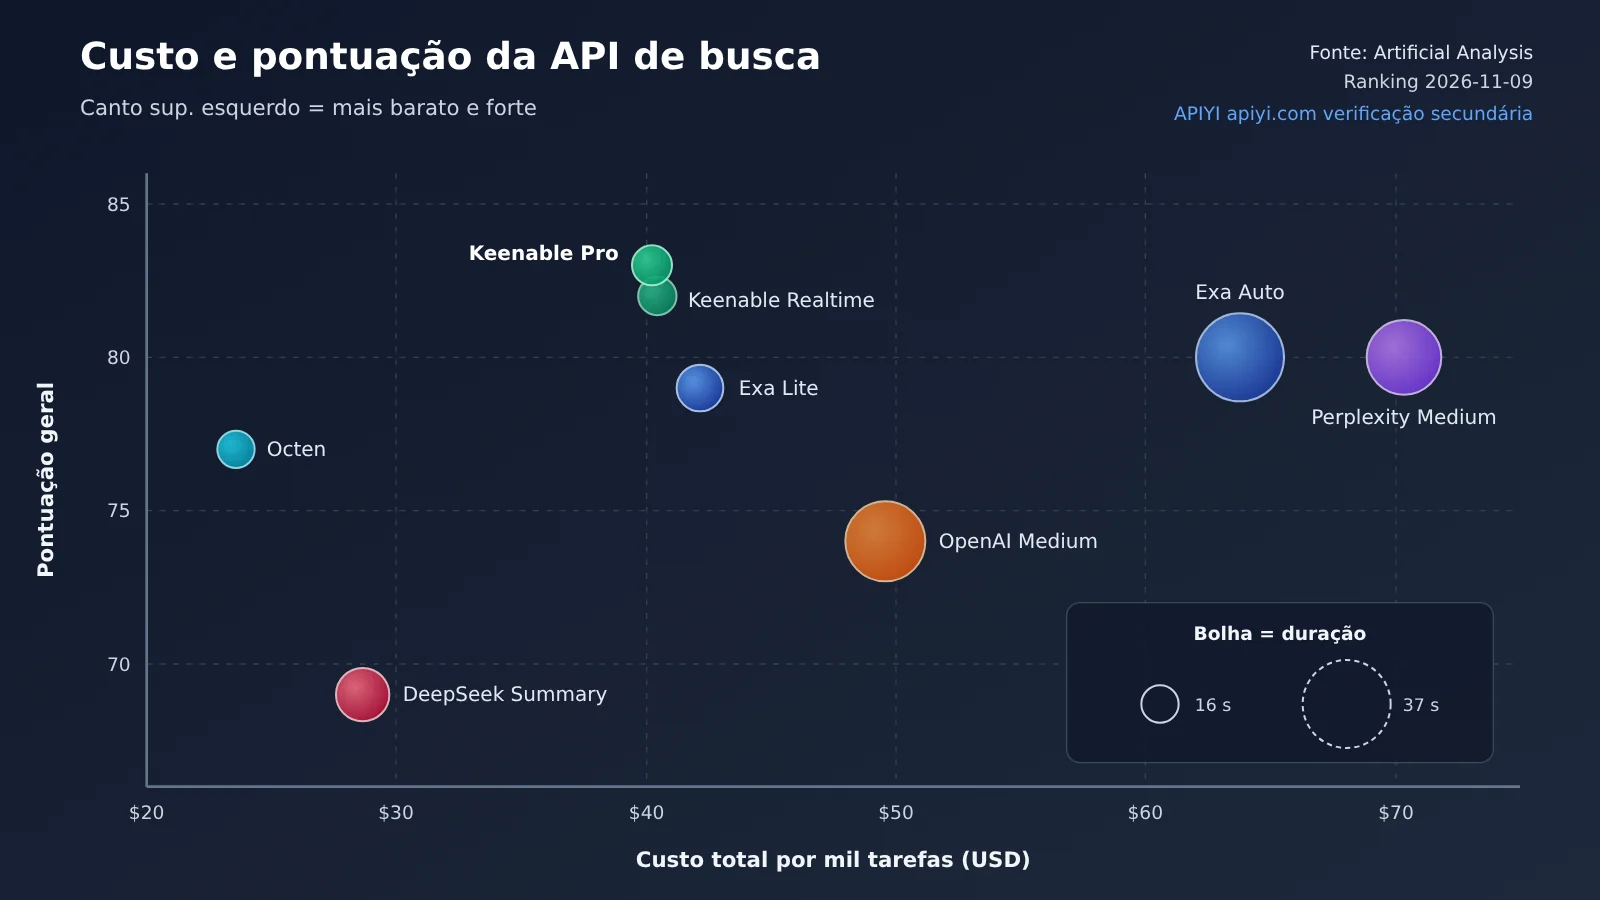
| Configuração de busca | Pontuação de qualidade | Custo de busca + custo do modelo | Custo total/1.000 tarefas | Custo por ponto (estimativa editorial) | Tempo da tarefa (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | aprox. $0.48 | 16.6 s |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | aprox. $0.49 | 16.0 s |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | aprox. $0.80 | 36.7 s |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | aprox. $0.88 | 31.1 s |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | aprox. $0.53 | 19.4 s |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | aprox. $0.31 | 15.6 s |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | aprox. $0.67 | 33.1 s |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | aprox. $0.42 | 22.4 s |
Três conclusões da tabela de custos da API de busca
Nem sempre a maior pontuação é a mais cara. O Keenable Pro lidera com 83 pontos, com cerca de $40.22 por 1.000 tarefas — o equivalente a aproximadamente $0.04 por tarefa — e fica em um nível intermediário da amostra. O Perplexity Medium tem 3 pontos a menos, mas seu custo total é cerca de 75% maior.
Uma diferença de 1 ponto pode representar mais de 30% no custo. O Exa Lite + Highlights tem 79 pontos e custa $42.15/1.000 tarefas; o Exa Auto + Highlights tem 80 pontos e custa $63.77/1.000 tarefas. O primeiro é cerca de 34% mais barato e também tem menor tempo de execução. Segundo a página oficial de preços da Exa (dados até 2026-11-13), o nível Lite custa $4 por 1.000 requisições, e o nível Auto custa $7 por 1.000 requisições. A diferença nos custos de busca no ranking é consistente com essa estrutura de preços.
Custo de busca baixo pode significar custo de modelo mais alto. O DeepSeek Search Summary tem custo de busca de apenas $8.47, mas o custo do modelo chega a $20.19, o mais alto da tabela. O Octen tem o menor custo total, mas seu custo de modelo também é maior que o do Keenable, Exa e Perplexity. Quando os resultados de busca não são suficientemente eficazes, o agente faz mais rodadas de busca e lê mais páginas, e o consumo de tokens aumenta. Por isso, ao calcular custos, devemos usar como unidade o “custo total para concluir uma tarefa”, em vez de olhar apenas para o preço avulso por chamada da API de busca.
Quais escolhas práticas este ranking do Search Index pode orientar?
O Search Index é uma avaliação de recuperação factual de uso geral, com predominância de conteúdo em inglês, e não um benchmark específico para a internet em chinês. A seguir, relacionamos o ranking aos cenários comuns de Agent e indicamos quais cenários podem usá-lo como referência direta e quais exigem testes complementares.
| Cenário de Agent | Métrica mais crítica | Valor de referência do ranking | Candidatos sugeridos |
|---|---|---|---|
| Perguntas e respostas factuais | Taxa de precisão, taxa de citação correta | Alta; pode consultar diretamente o AA-Omniscience | Keenable, Exa Lite, Perplexity |
| Pesquisa complexa com múltiplas fontes | Recuperação multi-hop, recall de conjuntos | Alta; foque em DeepSearchQA e BrowseComp | Keenable Pro, Exa Auto, Perplexity Medium |
| Agent de baixa latência | Tempo total da tarefa, latência P95 | Média; o tempo da tarefa serve apenas como referência | Keenable Realtime, Octen, Exa Lite |
| Recuperação de notícias em chinês | Cobertura de fontes em chinês, acessibilidade de sites nacionais | Baixa; é preciso criar um conjunto de testes próprio em chinês | Inclua Baidu Qianfan, Bocha e Alibaba Cloud Bailian como comparação |
| Recuperação de documentação de programação | Cobertura da documentação oficial, informações de versão | Baixa a média; é preciso retestar com problemas técnicos reais | Exa, Perplexity, Parallel |
Como usar o Search Index para uma segunda comparação de APIs de busca
Uma abordagem mais razoável é tratar o ranking público como uma “ferramenta de triagem inicial” e então fazer uma segunda rodada de comparação com suas próprias tarefas:
- Com base nos três critérios — qualidade, tempo e custo total —, selecione de 3 a 4 configurações candidatas no ranking;
- Prepare de 50 a 100 perguntas do seu próprio negócio, cobrindo fatos simples, notícias recentes, perguntas multi-hop, consultas em chinês e consultas entre idiomas;
- Fixe o mesmo modelo de resposta, o mesmo número máximo de rodadas e a mesma quantidade de resultados, alterando apenas a ferramenta de busca;
- Registre a taxa de precisão, a taxa de citações corretas, o custo total por tarefa, a latência P50/P95, além do número de resultados vazios e de timeouts;
- Faça testes de estresse separados para a estabilidade em produção, porque o ranking já exclui erros fatais após retentativas.
Recomendações para escolher a API de busca e início rápido
🎯 Sugestão de escolha: Se você busca qualidade geral e velocidade, teste primeiro Keenable Pro/Realtime; se é sensível a custo e quer uma qualidade próxima de 80 pontos, vale a pena testar com prioridade Exa Lite + Highlights e Octen; equipes que já usam profundamente o ecossistema OpenAI podem usar diretamente o Web Search integrado, mas precisam aceitar que o processo de execução dele não é controlável. Na prática, recomendamos centralizar as chamadas ao modelo de resposta via APIYI apiyi.com e transformar a ferramenta de busca em um módulo plugável; assim, ao trocar a API de busca, não é preciso alterar o código do lado do modelo.
Exemplo minimalista: o lado do modelo usa uma interface unificada
O código abaixo mantém o modelo de resposta fixo e declara a ferramenta de busca como uma função. A implementação concreta — qual API de busca será usada — pode ser substituída no código local:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI; modelo substituível
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Troque pelo modelo que você quer avaliar
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
Ver código completo: comparação A/B do mesmo modelo com várias APIs de busca
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # Modelo de resposta fixo, mantendo as variáveis de controle
MAX_TURNS = 25          # Limite de turnos igual ao do Search Index

# Funções de adaptação para cada API de busca; implemente conforme a documentação oficial
def search_provider_a(query: str) -> list:
    return []  # Retorna [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 Início rápido: novos usuários podem resgatar créditos gratuitos de teste na APIYI apiyi.com. Primeiro rode o script A/B acima com algumas perguntas de negócio e depois decida qual API de busca incluir no plano oficial.
Perguntas frequentes (FAQ)
Q1: O que é o Search Index?
O Search Index é o índice de avaliação de APIs de busca lançado pelo Artificial Analysis. Ele fixa o modelo de resposta e o framework do Agent, substituindo apenas o serviço de busca, e mede o desempenho da busca pela média de peso igual das três referências DeepSearchQA, BrowseComp e AA-Omniscience, com pontuação máxima de 100.
Q2: Uma nota 83 significa 83% de respostas corretas?
Não. 83 é a média das pontuações das três referências, e os indicadores das três também são diferentes: DeepSearchQA usa F1, e as outras duas usam acurácia. O Keenable Pro marcou 88, 87 e 73 nas três, média de aproximadamente 82.67, exibida como 83.
Q3: De quando são os dados do ranking?
As pontuações de qualidade e os dados de custo vêm da atualização do ranking de 2026-11-09; o tempo total de execução da tarefa usa o valor lido em 2026-11-13. O ranking é atualizado continuamente, então cite a data ao referenciá-lo.
Q4: O tempo de execução no ranking pode ser usado como a velocidade de resposta da API de busca?
Não. O tempo indicado na tabela é o tempo total de uma tarefa padrão, incluindo várias rodadas de busca, leitura de páginas web e inferência do modelo. A latência de uma única requisição HTTP precisa ser medida separadamente, de preferência registrando P50 e P95 ao mesmo tempo.
Q5: Como comparar rapidamente o efeito de diferentes APIs de busca no meu negócio?
Fixe um modelo de resposta e substitua apenas a ferramenta de busca. Você pode usar APIYI apiyi.com para invocar o modelo pela interface compatível com OpenAI, definir o base_url como `https://api.apiyi.com/v1` e aplicar o script A/B deste artigo. Se também quiser ver como o efeito da busca muda depois de trocar de modelo, a mesma Key permite alternar entre modelos como OpenAI, Claude e Gemini.
Q6: Quais são as limitações do Search Index?
São principalmente quatro: ele não é um benchmark dedicado à internet em chinês; o fluxo de execução da busca nativa da OpenAI é diferente das demais configurações; erros como 429, 5xx e timeout, após nova tentativa, não entram no resultado, portanto não refletem a estabilidade em ambiente de produção; os custos são estimados com base nas tarefas de avaliação e podem não bater com a sua fatura real. Para busca de notícias em chinês e documentação técnica de produtos nacionais, recomendo montar um conjunto de teste próprio e validar tudo junto com modelos nacionais via APIYI apiyi.com.
Principais conclusões sobre a seleção de API de busca do Search Index
- A busca é uma variável independente: o mesmo modelo passou de 33 para 83 pontos, e a escolha da API de busca afeta diretamente a qualidade do Agent.
- 83 pontos não é taxa de acerto: é a média com pesos iguais de três benchmarks, com critérios de pontuação distintos.
- O tempo deve ser avaliado na tarefa completa: Keenable leva cerca de 16 segundos e Exa Auto cerca de 37 segundos; nenhum desses valores é a latência de uma única chamada de API.
- O custo precisa ser analisado por partes: uma taxa de busca baixa pode vir acompanhada de um custo alto do modelo; a comparação deve ser feita pelo custo total por tarefa.
- 1 ponto pode representar 34% de diferença: Exa Lite e Auto diferem em apenas 1 ponto, e o primeiro é mais de 30% mais barato.
- O ranking serve apenas para uma triagem inicial: cenários como conteúdo em chinês e documentação de programação exigem uma segunda comparação A/B com suas próprias tarefas.
Resumo
O ponto mais valioso deste ranking do Search Index é que, com o desenho de “mesmo modelo, diferentes ferramentas de busca”, ele isolou e mediu o impacto da qualidade da busca no Agent:
- Qualidade: sem busca, 33 pontos; no máximo, 83 pontos. Mesmo com todas as configurações usando busca, ainda há uma diferença de cerca de 14 pontos entre elas;
- Velocidade: com a mesma pontuação de 80, o tempo total da tarefa pode variar mais de 5 segundos; configurações com pontuação alta também podem ser rápidas;
- Custo: Keenable Pro tem a maior qualidade, com custo intermediário; Exa Lite e Octen se destacam em eficiência de custo; o exemplo do DeepSeek Summary mostra que uma taxa de busca baixa não significa custo total baixo.
Recomenda-se primeiro usar o ranking para selecionar 3–4 candidatos e, depois, fazer um teste A/B com o modelo fixo no seu próprio conjunto de perguntas. A recomendação é usar APIYI apiyi.com para chamar o modelo de resposta de forma unificada, tornar a ferramenta de busca um módulo substituível e decidir a solução final com base em três métricas: qualidade, velocidade e custo.
Referências
- Leaderboard da Artificial Analysis Search API: dados de pontuação de qualidade, custo e tempo
- Link:
artificialanalysis.ai/agents/search-api -
Descrição: principal fonte das pontuações, custos e tempos deste artigo
-
Metodologia de avaliação da Artificial Analysis Search API: configuração dos testes e regras de pontuação
- Link:
artificialanalysis.ai/methodology/search-api -
Descrição: inclui explicações sobre modelos, rodadas, quantidade de resultados, regras de nova tentativa etc.
-
Exa Pricing: preços dos níveis Lite, Auto e outros
- Link:
exa.ai/pricing -
Descrição: útil para entender as diferenças de custo de busca entre os diferentes modos do Exa no leaderboard
-
Anúncio do Exa 3.0: modo Lite e Dynamic Highlights
- Link:
exa.ai/blog/exa-3 -
Descrição: publicado em 2026-10-19, inclui dados de testes internos do fornecedor
-
Documentação do OpenAI Web Search: ferramenta de busca integrada à Responses API
- Link:
developers.openai.com/api/docs/guides/tools-web-search -
Descrição: para entender como a busca nativa da OpenAI é executada e quais são seus parâmetros
-
Preços da Perplexity Search API: níveis Standard e Fast
- Link:
docs.perplexity.ai/docs/getting-started/pricing - Descrição: para entender as regras de cobrança por requisição
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI; há mais materiais de integração disponíveis no centro de documentação docs.apiyi.com