Nota do autor: comparo o Gemini 4 Carbon e o Claude Opus 5.5 em 7 dimensões (especificações, preço, mecanismo de raciocínio, protocolo e pontuações dos model cards oficiais) e termino com uma recomendação de “qual tarefa vai para qual modelo”.
Primeiro, a conclusão: recuperação em contexto longo, raciocínio científico e engenharia de múltiplas etapas e longo prazo ficam com o Gemini 4 Carbon. Operação de computador, automação de desktop e fluxos de trabalho que já rodam sobre o protocolo messages da Anthropic ficam com o Claude Opus 5.5. Nenhum dos dois é “melhor em tudo”. A pergunta certa é qual tipo de trabalho combina mais com cada um.
Esta não é uma análise do tipo “cada um tem seus pontos fortes” para ficar em cima do muro. Todas as pontuações do artigo vêm dos model cards oficiais e da documentação dos fornecedores, e estão marcadas como autorrelatadas pelos próprios fabricantes. Nos preços, listo tanto a tabela oficial quanto a tabela da APIYI em 2026-11-11, para você comparar direto.
Valor central: ao terminar esta comparação entre Gemini 4 Carbon e Claude Opus 5.5, você terá em mãos uma tabela pronta para apoiar a escolha do modelo. Também vai entender por que o Carbon pode ter um preço unitário menor e, mesmo assim, não necessariamente gerar uma fatura menor.
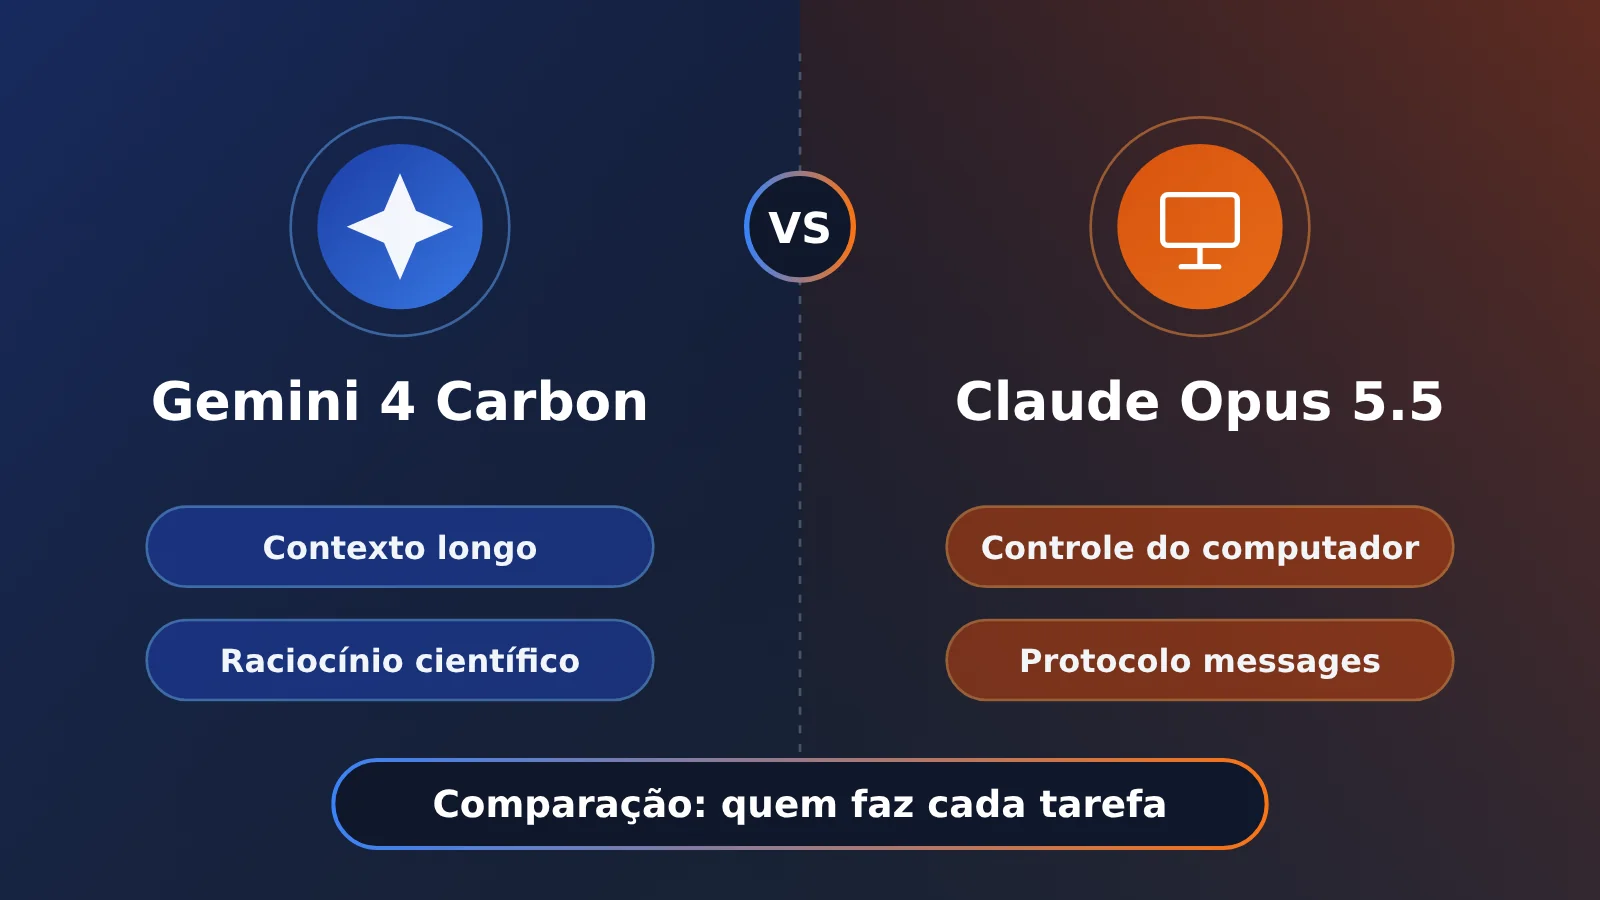
Gemini 4 Carbon vs Claude Opus 5.5: as principais diferenças
Os dois modelos são carros-chefe lançados no segundo semestre de 2026. O Claude Opus 5.5 foi lançado pela Anthropic em 22/09/2026. O Gemini 4 Carbon foi anunciado pela primeira vez em 28/10/2026 e, na época, ficou disponível apenas para equipes de defesa em cibersegurança verificadas pelo Fairwind Program. Só em 10/11/2026 ele chegou à disponibilidade geral (GA) para desenvolvedores pagantes e empresas.
O posicionamento que o Google dá ao Carbon é bem claro: ele é baseado no Gemini 4 Argon e foi feito para tarefas que “vão até o limite da inteligência”, como programação e depuração complexas em vários passos e pesquisa científica aberta. Ele gasta mais thinking tokens do que o Argon, explora cada hipótese até o fim e roda ciclos de verificação mais longos. Já o Opus 5.5 se destaca pelo raciocínio adaptativo, pela saída grande de 128K e pela capacidade de operar o computador. Os dois modelos já estão disponíveis na APIYI (apiyi.com), e dá para alternar entre eles usando a mesma chave.
Comparativo de especificações: Gemini 4 Carbon e Claude Opus 5.5
| Item | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| ID do modelo | gemini-4-carbon |
claude-opus-5-5 |
| Lançamento | Anunciado em 28/10/2026, GA em 10/11/2026 | 22/09/2026 |
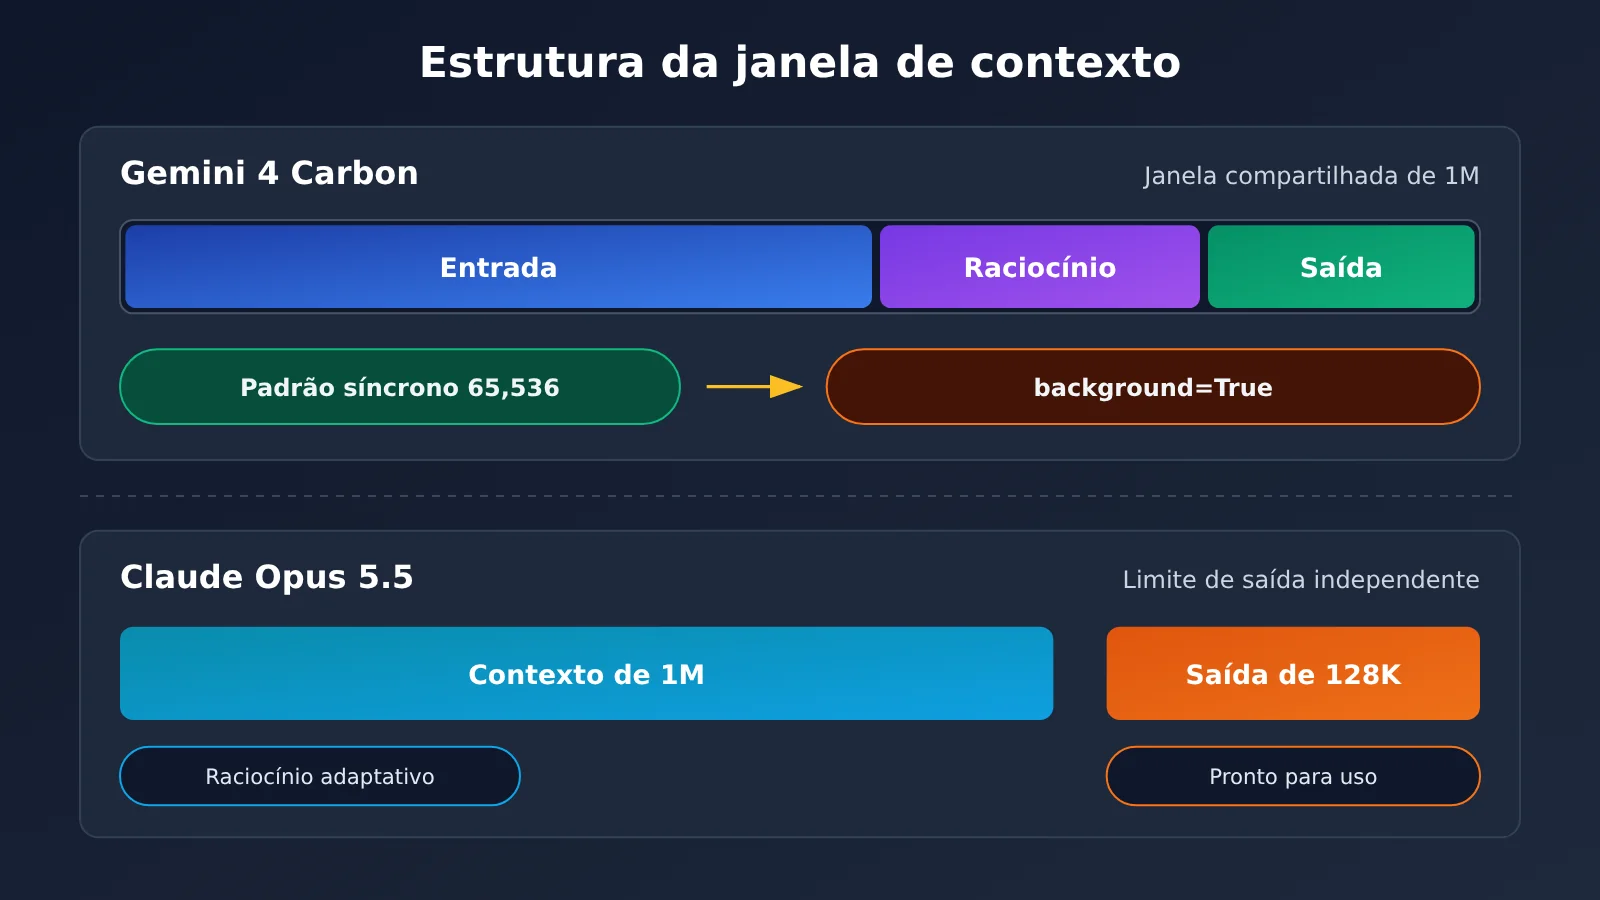
| Contexto | 1M, com entrada, raciocínio e saída compartilhando a mesma janela | 1M |
| Limite de saída | Padrão síncrono de 65.536; o modo em segundo plano permite aumentar, compartilhando o 1M com a entrada | 128K |
| Controle de raciocínio | thinking_level: low / medium / high, padrão medium |
Raciocínio adaptativo que não pode ser desativado, com effort padrão medium |
| Corte de conhecimento | March 2026 (alguns domínios podem ser anteriores) | Corte de conhecimento confiável em June 2026 |
| Modalidades de entrada | Texto, imagem, áudio, vídeo | Conforme a documentação oficial |
| Modalidades de saída | Texto (não gera imagem nem vídeo) | Texto |
Essa tabela tem dois pontos em que é fácil tropeçar. O primeiro é o limite de saída: o 1M do Carbon é uma janela compartilhada, e uma requisição síncrona padrão devolve no máximo 65.536 tokens. Se você precisa de uma saída mais longa, tem que configurar background=True na Interactions API e subir max_output_tokens para mais de 65536, deixando uma folga para o raciocínio. Caso contrário, a resposta pode ser cortada no meio. Os 128K do Opus 5.5, por outro lado, são um limite que você já pode usar direto.
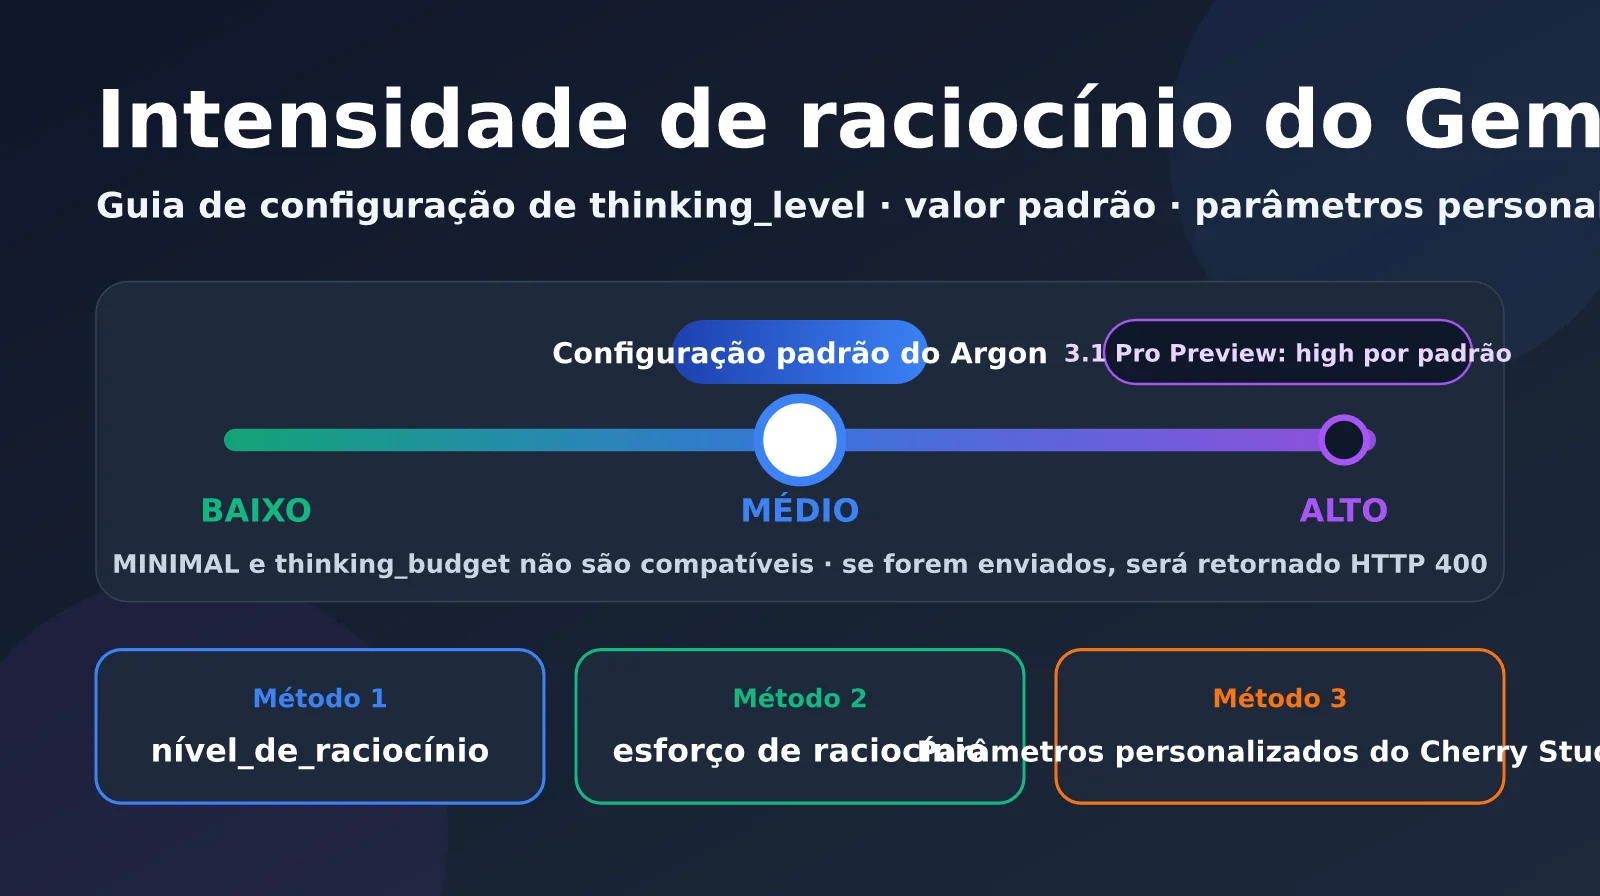
O segundo ponto é o mecanismo de raciocínio. Os três níveis do Carbon podem ser ajustados conforme a tarefa: low serve para classificação, roteamento e extração pontual; medium é o padrão e equilibra velocidade, custo e acertar de primeira; high é indicado para análise de causa raiz em vários arquivos, matemática formal e design de arquitetura nas etapas iniciais. No Opus 5.5, o raciocínio adaptativo não dá para desligar, só dá para ajustar o effort. Se o seu negócio precisa de um modo de baixa latência “sem raciocínio nenhum”, nenhum dos dois modelos é a melhor escolha.
Gemini 4 Carbon vs. Claude Opus 5.5: preço e fatura
Olhando só o preço unitário, o Carbon é claramente mais barato. Mas esse preço baixo no canal oficial é promocional, e o modelo “gasta mais tokens de raciocínio”. Por isso, a diferença de preço unitário não pode ser tratada como diferença na fatura.
Preço oficial vs. preço de tabela do APIYI
Valores em dólares por 1M de tokens. Os preços do APIYI são os do grupo padrão em 2026-11-11, sem desconto.
| Item de preço | Carbon oficial (até 30/11, global) | Carbon oficial (a partir de 01/12, global) | Opus 5.5 oficial | APIYI gemini-4-carbon |
APIYI claude-opus-5-5 |
|---|---|---|---|---|---|
| Entrada | 2 | 4.00 | 4 | 2 | 4 |
| Saída (incluindo raciocínio) | 10 | 20.00 | 20 | 10 | 20 |
| Leitura de cache | 0.10 | 0.20 | 0.20 | 0.10 | 0.20 |
| Escrita de cache | Cache implícito, sem cobrança separada | Igual à coluna anterior | 5 min: 5 / 1 hora: 8 | Sem multiplicador separado para escrita de cache | Equivale a 5 (multiplicador 1.25) |
| Grupos disponíveis | — | — | — | default, svip | ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip |
Alguns detalhes oficiais a mais. Nos endpoints que não são globais, o Carbon custa 2.20 / 0.11 / 11 durante a promoção. O Gemini 4 Carbon Cyber Permissive não tem preço promocional e é cobrado direto a 4 / 0.20 / 20. O Fast mode do Opus 5.5 custa 8 na entrada e 40 na saída, e a inferência exclusiva nos EUA ainda multiplica tudo por 1.1.
Os multiplicadores de cada grupo do APIYI são cobrados à parte. Para o Opus, o grupo ClaudeCode tem multiplicador 0.95, o ClaudeCodeReverse 0.5, o ClaudeOfficial 1.2, e os grupos default e svip 1. O Carbon só tem os grupos default e svip, ambos com multiplicador 1. A recarga usa câmbio fixo de 1:7 e pode ser combinada com bônus de recarga e descontos de grupo. O valor realmente cobrado é o que aparece no console. Modelos e preços valem conforme a lista de modelos em apiyi.com. Se a tabela geral da documentação ainda não mostrar a linha do Carbon, use o console e a API de preços como referência.
Por que diferença de preço unitário não é diferença na fatura
O custo de uma requisição é aproximadamente: tokens de entrada × preço de entrada + (tokens de raciocínio + tokens de resposta) × preço de saída. O preço de saída do Carbon é metade do Opus, mas o Google afirma claramente que ele gasta mais tokens de raciocínio que o Argon para rodar os ciclos de verificação. Na mesma tarefa, basta o total de “raciocínio + resposta” do Carbon passar do dobro do Opus para que a parte de saída fique mais cara.
No canal oficial, a partir de 1º de dezembro o Carbon e o Opus passam a ter exatamente o mesmo preço unitário. A partir daí, quem usar menos tokens terá a fatura menor. A Anthropic também tem seu próprio argumento de economia: ela informa que o Opus 5.5 gasta cerca de 40% menos em tokens que o Opus 5 para fazer o mesmo trabalho. Esse número é autodeclarado pelo fornecedor e não vem de um teste comparando os dois modelos. O mais seguro é rodar um lote das suas próprias tarefas reais em cada um e olhar o valor efetivamente cobrado no console.
O mecanismo de cache também é diferente. O Carbon já vem com cache implícito ativado, e a entrada em cache tem 95% de desconto. O guia do desenvolvedor diz para não criar nem passar cached_content explícito. No Opus, o cache precisa ser escrito, e a escrita de 5 minutos custa 5 dólares, o que compensa em chamadas repetidas com um system prompt longo e fixo.
Gemini 4 Carbon vs. Claude Opus 5.5: notas do model card oficial
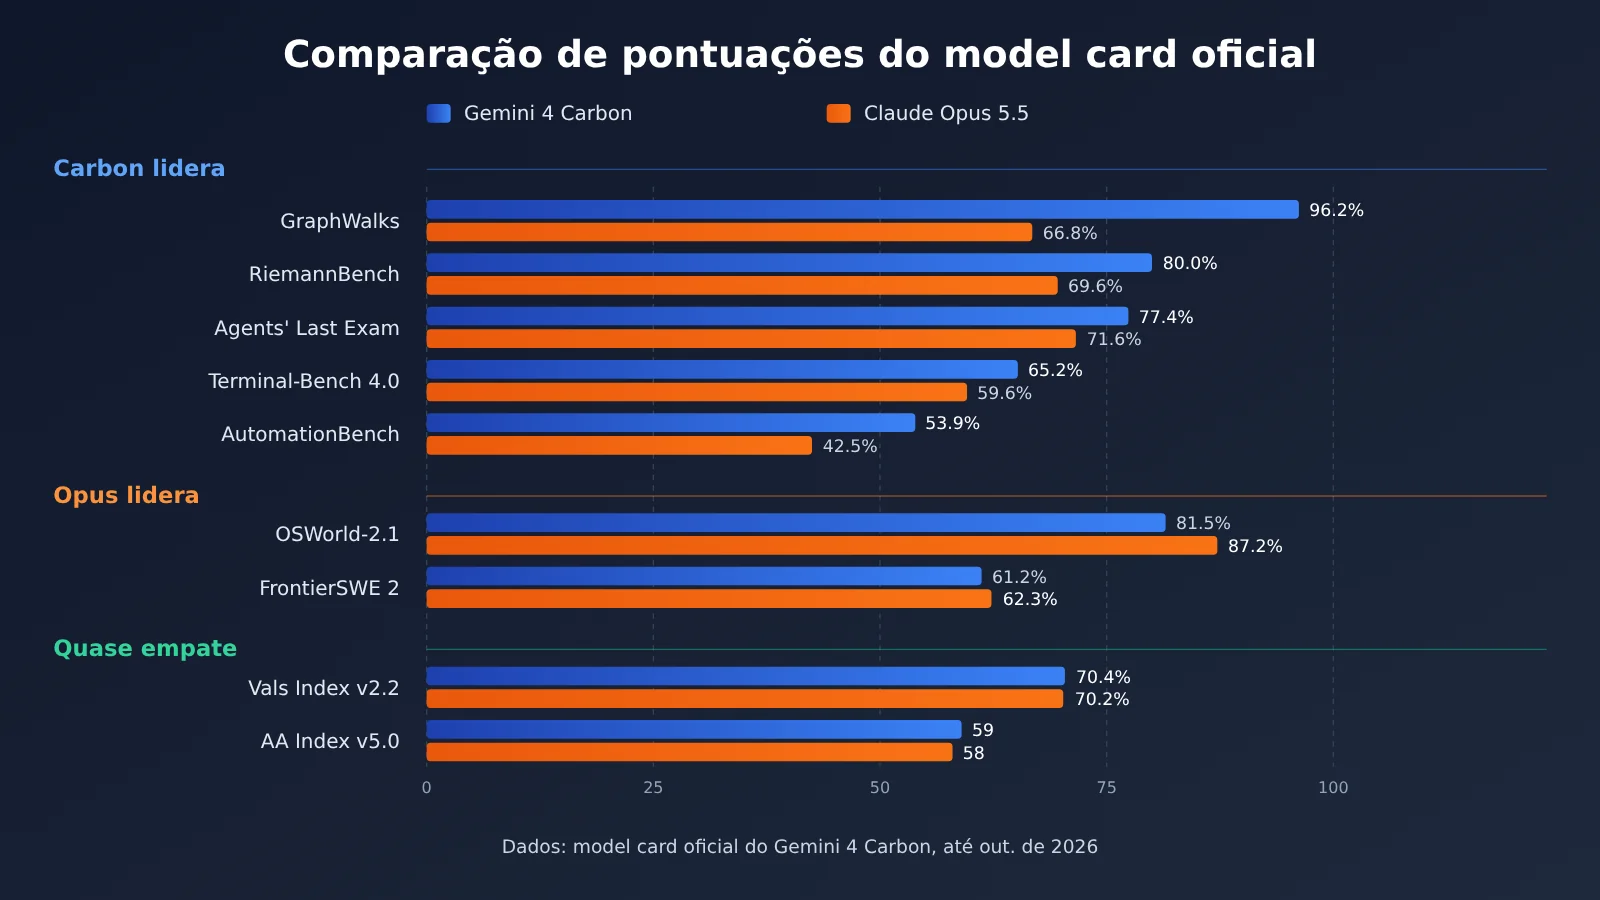
Todos os dados da tabela abaixo vêm do model card oficial do Gemini 4 Carbon, publicado pelo Google, com resultados até outubro de 2026. São números autodeclarados. Os números do Opus 5.5 também foram tirados desse mesmo model card, e não de testes independentes da Anthropic.
| Benchmark (model card oficial) | Gemini 4 Carbon | Claude Opus 5.5 | Conclusão |
|---|---|---|---|
| OSWorld-2.1 subconjunto offline (uso de computador) | 81.5% | 87.2% | Opus mais alto, e também o maior valor da tabela |
| FrontierSWE 2 | 61.2% | 62.3% | Opus um pouco acima; os dois ficam abaixo dos 65.5% do GPT-6 Astra |
| Vals Index v2.2 | 70.4% | 70.2% | Praticamente empatados |
| AA Index v5.0 | 59 | 58 | Praticamente empatados |
| SWE-sweep | 9.6% | 3.6% | Carbon mais alto |
| Terminal-Bench 4.0 (AA) | 65.2% | 59.6% | Carbon mais alto |
| Agents’ Last Exam v1.1 | 77.4% | 71.6% | Carbon mais alto |
| AutomationBench (Zapier) | 53.9% | 42.5% | Carbon mais alto |
| GraphWalks 256k–1M BFS (F1) | 96.2% | 66.8% | Carbon bem mais alto (contexto longo) |
| RiemannBench | 80.0% | 69.6% | Carbon mais alto (raciocínio científico) |
| Terminal-Bench-Science 0.1 (AA) | 64.8% | 59.0% | Carbon mais alto |
| Chartography | 72.5% | 66.3% | Carbon mais alto |
Essa tabela mostra três coisas. Primeiro, contexto longo e raciocínio científico são onde o Carbon abre a maior vantagem, e no GraphWalks a diferença chega perto de 30 pontos percentuais. Se a sua tarefa exige busca em vários saltos dentro de centenas de milhares de tokens de material, esse é o número mais relevante para você.
Segundo, uso de computador é o território do Opus 5.5. No subconjunto offline do OSWorld-2.1, o Opus fica cerca de 6 pontos percentuais acima do Carbon. Se você trabalha com agentes de desktop, operação de navegador ou automação de GUI, o Carbon não é o primeiro colocado nesse quesito.
Terceiro, em tarefas de engenharia de software com repositórios públicos, nenhum dos dois lidera. No FrontierSWE 2, o GPT-6 Astra tem a maior nota, o Opus vem em segundo e o Carbon em terceiro, com diferenças pequenas. No SWE-sweep, os 9.6% do Carbon superam os 3.6% do Opus, mas o valor absoluto é muito baixo e praticamente empata com os 9.5% do Astra, então não dá para interpretar isso como uma vantagem de ordem de grandeza.
O model card traz ainda três resultados de segurança cibernética (CWE-bench, ExploitGym e SEC-bench Pro), mas eles foram obtidos pelo caminho do Fairwind Program, e o comunicado de lançamento de 28 de outubro também informa que a avaliação foi feita sem guardrails. A API paga não oferece essa mesma capacidade por padrão, então não vale usar esses três números como base para escolher um modelo para programação no dia a dia.
Cenários recomendados: Gemini 4 Carbon vs. Claude Opus 5.5
Quando escolher o Gemini 4 Carbon
- Busca e síntese em materiais muito longos: bases de regulamentos, repositórios de código inteiros, perguntas multi-hop sobre pesquisas extensas. Aqui dá para aproveitar bem a janela compartilhada de 1M e a vantagem no GraphWalks.
- Raciocínio científico e matemática formal: o modelo lidera no RiemannBench e no Terminal-Bench-Science. Vale configurar
thinking_levelcomo high, para que ele verifique tudo com calma. - Engenharia de longo prazo em várias etapas e auditoria de arquitetura: o Google recomenda que, no /swarm do Antigravity, o Carbon fique com os papéis que exigem o raciocínio mais profundo, como arquitetura, coordenação e auditoria, enquanto as fatias de implementação em paralelo vão para o
gemini-4-argonou ogemini-3.8-flash. - Documentos multimodais: aceita texto, imagem, áudio e vídeo como entrada e tem uma pontuação mais alta no Chartography, o que o torna ideal para analisar relatórios cheios de gráficos.
Quando escolher o Claude Opus 5.5
- Uso de computador e agentes de desktop: tem a maior pontuação na tabela do OSWorld-2.1, então é a primeira opção para automação de GUI.
- Fluxos de trabalho que já usam Claude Code / protocolo messages: não precisa mudar o protocolo, basta trocar o ID do modelo.
- Saídas únicas muito longas: o limite de 128K de saída pode ser usado diretamente, sem precisar migrar para o modo em segundo plano como no Carbon.
- Conhecimento mais recente: o corte de conhecimento confiável é junho de 2026, três meses depois do março de 2026 do Carbon.
Quando nenhum dos dois é a melhor escolha
Para desenvolvimento de funcionalidades no dia a dia e programação interativa, o Google recomenda continuar com o Gemini 4 Argon. O preço unitário é o mesmo do Carbon, mas ele gasta menos tokens e responde mais rápido. Se você já usa a Responses API e precisa de 1,05M de contexto e raciocínio no nível max, vale considerar o GPT-6 Astra. Só que o preço de tabela dele é cerca de 5 vezes o preço promocional do Carbon (10/50 contra 2/10), e passa a ter acréscimo escalonado quando a entrada ultrapassa 272K.
Gemini 4 Carbon vs. Claude Opus 5.5: como integrar cada um
A diferença de protocolo costuma dar mais trabalho de engenharia do que a diferença de pontuação nos benchmarks. O Opus 5.5 usa nativamente o protocolo Anthropic messages. Já o Carbon usa o protocolo nativo do Gemini ou o chat completions compatível com OpenAI, e não o Anthropic messages.
| Aspecto da integração | Gemini 4 Carbon | Claude Opus 5.5 |
|---|---|---|
| Protocolo nativo | Gemini nativo (/v1beta) | Anthropic messages |
| Endpoints no APIYI | gemini, openai (/v1/chat/completions) | anthropic (messages), openai (chat) |
| Parâmetros de raciocínio | thinking_level; thinking_budget está obsoleto |
effort; o raciocínio não pode ser desativado |
| Parâmetros de amostragem | temperature, top_p e top_k personalizados são ignorados e geram um aviso | Configure conforme a documentação da Anthropic |
| Timeout recomendado | Problemas difíceis podem levar alguns minutos; configure o timeout do cliente para no mínimo 15–20 minutos, ou use background=True |
Configuração normal para tarefas longas |
Alternando rapidamente pela interface compatível com OpenAI
Se você quer testar os dois modelos com o mesmo código, o jeito mais simples é usar a interface compatível com OpenAI. Os passos são:
- No console, crie uma chave API e escolha o grupo default ou svip (os dois grupos cobrem os dois modelos).
- No SDK da OpenAI, defina
base_urlcomohttps://api.apiyi.com/v1e coloque a sua chave emapi_key. - Ao chamar o chat completions, defina
modelcomogemini-4-carbonouclaude-opus-5-5, mantendo a estrutura de messages igual. - Ao testar o Carbon, remova parâmetros de amostragem como temperature e aumente o timeout do cliente para mais de 15 minutos.
- Compare no console o uso de tokens e a cobrança real de cada um, em vez de olhar só o preço unitário.
Se o seu projeto já está integrado com o Claude Code ou com o SDK da Anthropic, o Opus 5.5 pode continuar usando o endpoint messages. Caso precise de um grupo específico para o Claude Code, escolha ClaudeCode ou ClaudeOfficial.
🚀 Dica para começar: use primeiro a interface compatível com OpenAI do APIYI (apiyi.com) e envie o mesmo conjunto de tarefas reais para os dois modelos, comparando a qualidade das respostas e a cobrança no console. Depois de definir qual modelo fica com o quê, decida se vale voltar o Opus para o protocolo nativo messages.
Gemini 4 Carbon vs Claude Opus 5.5: recomendação de decisão
Vamos condensar tudo o que vimos até aqui em uma única tabela de decisão:
| Sua tarefa principal | Recomendação | Principal justificativa |
|---|---|---|
| Recuperação em contexto longo (escala de 1M) e síntese multi-hop | Gemini 4 Carbon | GraphWalks 96,2% contra 66,8% (model card oficial) |
| Raciocínio científico e matemática formal | Gemini 4 Carbon | Lidera no RiemannBench e no Terminal-Bench-Science |
| Uso do computador, agentes de desktop/navegador | Claude Opus 5.5 | OSWorld-2.1: 87,2% contra 81,5% |
| Já tem workflows com messages / Claude Code | Claude Opus 5.5 | Protocolo nativo, saída de até 128K |
| Engenharia de software em repositórios públicos | Os dois ficam próximos; vale considerar o Astra | No FrontierSWE 2, o Astra tem a maior pontuação e o Opus fica um pouco acima do Carbon |
| Desenvolvimento do dia a dia, programação interativa | Gemini 4 Argon | Mesmo preço do Carbon, gasta menos tokens e é mais rápido |
| Trabalho de conhecimento em geral | Qualquer um dos dois; escolha pelo custo | Vals Index 70,4% contra 70,2%, praticamente empatados |
💡 Dica de escolha: a maioria das equipes não precisa escolher só um. Dá para fazer o roteamento por tipo de tarefa: requisições de contexto longo e de pesquisa científica vão para o Carbon, enquanto operações de GUI e workflows com messages vão para o Opus. Os dois modelos estão nos grupos default e svip do APIYI (apiyi.com), então, na hora de rotear, basta trocar o campo
model.
Mais um ponto de atenção: as capacidades específicas de cibersegurança defensiva passam pelo Fairwind Program. Trocar o nome do modelo para gemini-4-carbon não significa que você passou a ter a versão Cyber Permissive. Além disso, nos canais oficiais, o Cyber Permissive não se aplica ao preço promocional de 2 dólares.
Perguntas frequentes (FAQ)
Q1: Gemini 4 Carbon ou Claude Opus 5.5: qual é mais forte?
Nenhum dos dois é melhor em tudo. Segundo os model cards oficiais (até outubro de 2026), o Carbon se sai melhor em contexto longo, raciocínio científico e tarefas de terminal; o Opus 5.5 leva vantagem no OSWorld (uso de computador) e no FrontierSWE 2. No Vals Index e no AA Index, os dois ficam praticamente empatados.
Q2: O preço do Carbon é metade do Opus. Isso significa que ele sempre sai mais barato?
Nem sempre. O Carbon consome mais tokens de raciocínio, e esses tokens são cobrados pelo preço de saída. O preço promocional de US$ 2 no canal oficial vale só até 30/11/2026; a partir de 1º de dezembro, o preço fica igual ao do Opus. O que vale mesmo é a cobrança real de uma mesma tarefa rodada nos dois modelos.
Q3: Quando os dois modelos estão disponíveis via API?
O Opus 5.5 foi lançado em 22/09/2026. O Carbon foi anunciado em 28/10/2026, inicialmente só para os defensores do Fairwind; a partir de 10/11/2026, a Gemini API entrou em GA, aberta a desenvolvedores pagantes e empresas. Para usuários gratuitos e de planos básicos, não há data oficial.
Q4: Dá para chamar o Carbon pelo protocolo messages da Anthropic?
Não. O Carbon funciona com o protocolo nativo do Gemini ou com o chat completions compatível com OpenAI. Se o seu código é baseado no SDK da Anthropic, para integrar o Carbon você precisa migrar para o SDK da OpenAI ou o do Gemini. Já o Opus 5.5 suporta os dois endpoints, messages e chat.
Q5: Como comparar rapidamente os dois modelos no meu próprio caso de uso?
Cadastre-se na APIYI (apiyi.com), crie uma chave no grupo default e use o SDK da OpenAI apontando para a interface `/v1`. Depois, rode o mesmo lote de tarefas trocando o `model` entre `gemini-4-carbon` e `claude-opus-5-5`. Novos usuários ganham créditos gratuitos para teste, o suficiente para uma comparação em pequena escala.
Q6: Por que a saída do Carbon é cortada?
O limite padrão de saída em requisições síncronas é de 65.536 tokens, e os tokens de raciocínio também entram nesse orçamento. Se precisar de saídas mais longas, na Interactions API você pode definir `background=True` e aumentar o `max_output_tokens`, deixando uma folga para o raciocínio.
Q7: Quais são as limitações conhecidas de cada modelo?
O model card do Carbon menciona alucinações, resistência a jailbreak ainda em melhoria, lentidão ou timeouts ocasionais e maior consumo de tokens nos níveis altos de raciocínio. O corte de conhecimento também é mais antigo (março de 2026). No Opus 5.5, o raciocínio não pode ser desligado, o que não ajuda em cenários de baixa latência; além disso, ele fica abaixo do Carbon nos benchmarks de contexto longo e de ciência do model card.
Gemini 4 Carbon vs. Claude Opus 5.5: Principais Conclusões
- Contexto longo e raciocínio científico: escolha o Carbon. Em itens do model card oficial como GraphWalks e RiemannBench, a vantagem é clara.
- Operação de computador: escolha o Opus 5.5. No subconjunto offline do OSWorld-2.1, ele atinge 87,2%, a maior pontuação da tabela.
- Engenharia de software: os dois ficam próximos. No FrontierSWE 2, o Opus fica um pouco na frente e o Astra tem a maior pontuação. No SWE-sweep, o Carbon leva a melhor.
- Preço unitário não é o mesmo que a fatura final. O Carbon gasta mais tokens de raciocínio, e o preço promocional oficial só vale até 30 de novembro.
- O protocolo define o custo de adaptação. O Opus usa a API messages; o Carbon usa a interface nativa do Gemini ou a compatível com OpenAI.
- Saída e raciocínio funcionam de formas diferentes. O Opus oferece saída de até 128K e não permite desligar o raciocínio. O Carbon tem saída padrão de 65.536 tokens e três níveis de
thinking_level.
Resumo
Na comparação entre Gemini 4 Carbon e Claude Opus 5.5, a questão central não é quem ganha, e sim como dividir o trabalho:
- O Carbon cuida do “pensamento mais profundo”: contexto longo, raciocínio científico, arquitetura e auditoria. O preço a pagar são mais tokens de raciocínio.
- O Opus 5.5 cuida do “colocar a mão na massa” e da compatibilidade: operação de computador, fluxos de trabalho com messages e saída grande de 128K.
- A fatura depende do consumo real: durante a promoção, o preço unitário do Carbon sai na frente, mas o valor final cobrado depende do total de tokens.
Minha sugestão é fazer primeiro um teste de roteamento em pequena escala, por tipo de tarefa, e só depois decidir qual será o modelo principal. Pelo APIYI (apiyi.com), dá para chamar os dois modelos com uma única chave, com cobrança por uso, o que facilita comparar e alternar entre eles.
📚 Referências
- Blog do Google – Anúncio de disponibilidade do Gemini 4 Carbon: aberto a desenvolvedores pagos em 10/11/2026
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Descrição: escopo da liberação e as avaliações oficiais autodeclaradas adicionadas em novembro
-
Model card oficial do Gemini 4 Carbon: resultados de benchmark até outubro de 2026
- Link:
deepmind.google/models/model-cards/gemini-4-carbon/ -
Descrição: fonte de todas as pontuações citadas neste artigo, incluindo as limitações conhecidas
-
Guia do desenvolvedor do Gemini 4 Carbon: thinking_level, janela compartilhada de 1M e observações para migração
- Link:
aistudio.google.com/learn/gemini-4-carbon-developer-guide -
Descrição: modo background, timeout e configuração de cache implícito
-
Preços de modelos do Google Cloud: preço promocional do Carbon e preço padrão a partir de 1º de dezembro
- Link:
cloud.google.com/model-garden/pricing -
Descrição: preços dos endpoints globais e não globais
-
Documentação oficial do Claude Opus 5.5: especificações, mecanismo de raciocínio e preços
- Link:
platform.claude.com/docs/en/models/opus-5-5/overview -
Descrição: saída de 128K, data de corte de conhecimento e preço de escrita em cache
-
Tabela geral de modelos do APIYI: modelos da plataforma e preços de tabela padrão
- Link:
docs.apiyi.com/models -
Descrição: se ainda não tiver sido atualizada, vale o que aparece no console
-
Interface de preços do APIYI: multiplicadores em tempo real e informações de grupo
- Link:
api.apiyi.com/api/pricing - Descrição: fonte dos dados dos preços de tabela de 11/11/2026 usados neste artigo
Autor: Equipe técnica do APIYI
Troca de experiências técnicas: fale com a gente pela página inicial do APIYI; mais materiais na central de documentação em docs.apiyi.com