Nota do autor: este artigo usa dois sistemas de avaliação, o índice composto AA e o MKA (avaliação de tarefas profissionais), para comparar desempenho, tempo de execução e custo do Gemini 4 Carbon, do Claude Fable 5.2 e do GPT-6 Astra. Também explica em que configurações os testes foram feitos e até onde vão as conclusões estatísticas.
Antes de ler: 7 termos usados na comparação entre os três modelos
- MKA (Multimodal Knowledge Agent): benchmark que avalia tarefas profissionais multimodais. Ele testa se o modelo consegue ler documentos complexos, como plantas, digitalizações e imagens, e entregar um resultado profissional completo.
- Climb WSR: taxa de atendimento ponderada calculada só sobre os itens de avaliação com maior poder de discriminação. Serve para separar os modelos de ponta entre si.
- Regression WSR: métrica ponderada que mede se os requisitos básicos foram cumpridos. Funciona como a nota de corte de uma entrega profissional.
- Nível de raciocínio: configuração de intensidade de raciocínio que o modelo pode usar. Por exemplo, LOW, MEDIUM e HIGH no Carbon, e configurações como Max e Xhigh no Fable e no Astra, conforme aparecem no ranking.
- Custo por tarefa: soma do custo de todas as invocações do modelo necessárias para concluir uma tarefa específica. Não é o preço fixo de uma única requisição de API.
- Leitura de cache: forma de reaproveitar conteúdo de entrada já armazenado em cache, cobrado a um preço unitário menor.
- Significância estatística: indicador de que a diferença de pontuação entre dois modelos tem evidência estatística suficiente. Se a diferença não atinge um nível significativo, não dá para tratá-la como vitória ou derrota certa.
Hoje já é difícil explicar a disputa entre os modelos de ponta com um único ranking geral. Este artigo compara o Gemini 4 Carbon, o Claude Fable 5.2 e o GPT-6 Astra em três dimensões: capacidade geral, entrega profissional e custo por tarefa. No final, dá recomendações de escolha por tipo de tarefa.
Isto não é uma leitura de ranking que mistura todas as notas numa classificação só. O índice composto e o MKA são dois sistemas de avaliação diferentes, e aqui eu os analiso separadamente. Também deixo claro quais diferenças têm respaldo estatístico e quais não têm evidência suficiente.
Valor central: ao terminar a leitura, você vai saber qual modelo priorizar conforme as exigências da sua tarefa em qualidade, velocidade e custo.
一、Gemini 4 Carbon、Claude Fable 5.2 e GPT-6 Astra entram na mesma arena
Essa rodada de competição aconteceu num intervalo de tempo bem curto. O Google anunciou o Gemini 4 Carbon pela primeira vez em 28 de outubro de 2026, e a Anthropic lançou o Claude Fable 5.2 em 9 de novembro. Em 10 de novembro, o Carbon foi liberado oficialmente para desenvolvedores, empresas e consumidores. No mesmo dia, o Google DeepMind e a Artificial Analysis lançaram a avaliação MKA. Em 11 de novembro, o Artificial Analysis Intelligence Index v5.0.1 foi atualizado e passou a incluir o Fable 5.2.
O posicionamento público dos três modelos é bem diferente. O Carbon é construído sobre o Gemini 4 Argon e mira Agents de longo prazo, engenharia de software complexa e pesquisa científica, com suporte a entradas de texto, imagem, áudio e vídeo. O Fable 5.2 usa Adaptive Thinking, tem janela de contexto de 1M de tokens e saída máxima de 128K tokens. O GPT-6 Astra aparece nas duas avaliações citadas neste artigo e costuma ser usado como referência de eficiência.
| Dimensão | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra | Avaliação atual |
|---|---|---|---|---|
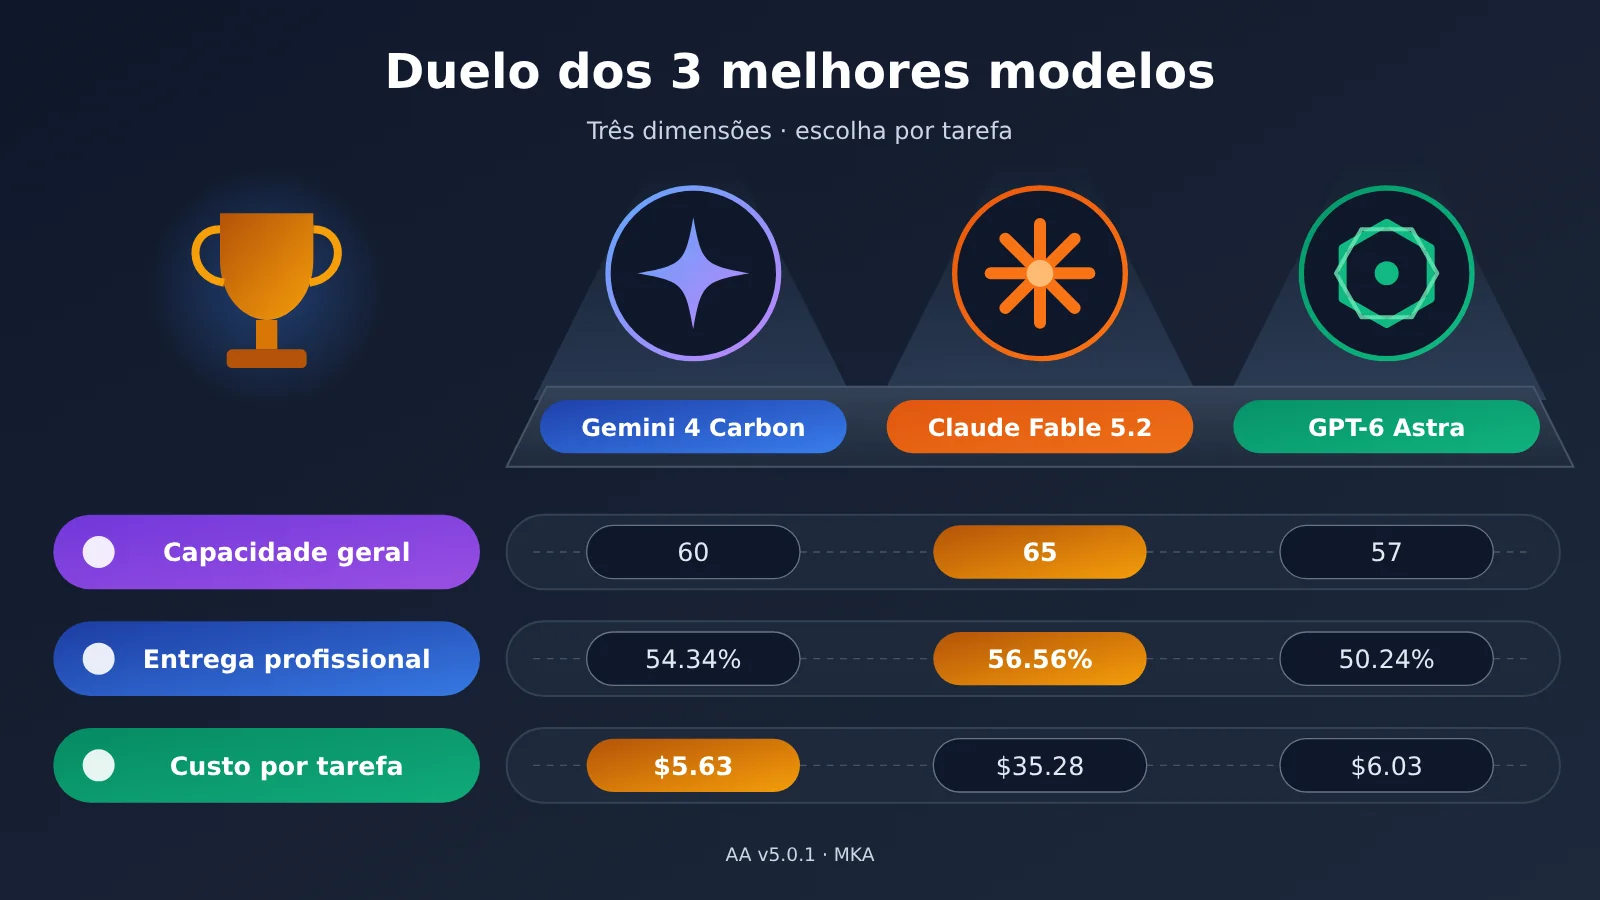
| Capacidade geral (AA v5.0.1) | 65 (Max) | 60 (High) | 57 (Max) | Fable na frente |
| Entrega profissional (MKA Climb-WSR) | 56,56% | 54,34% | 50,24% | Fable e Carbon próximos, ambos à frente do Astra |
| Custo por tarefa (MKA, tabela 4) | $35.28 | $5.63 | $6.03 | Carbon é o mais barato |
| Tempo de execução (MKA, tabela 4) | 83,2 minutos | 29,2 minutos | 18,5 minutos | Astra é o mais rápido |
| Consumo de tokens (MKA, tabela 4) | 40,48M | 7,05M | 2,43M | Astra é o mais econômico |
A coluna “Avaliação atual” vale apenas para cada indicador isolado. Nenhum dos modelos fica em primeiro lugar em todas as dimensões.
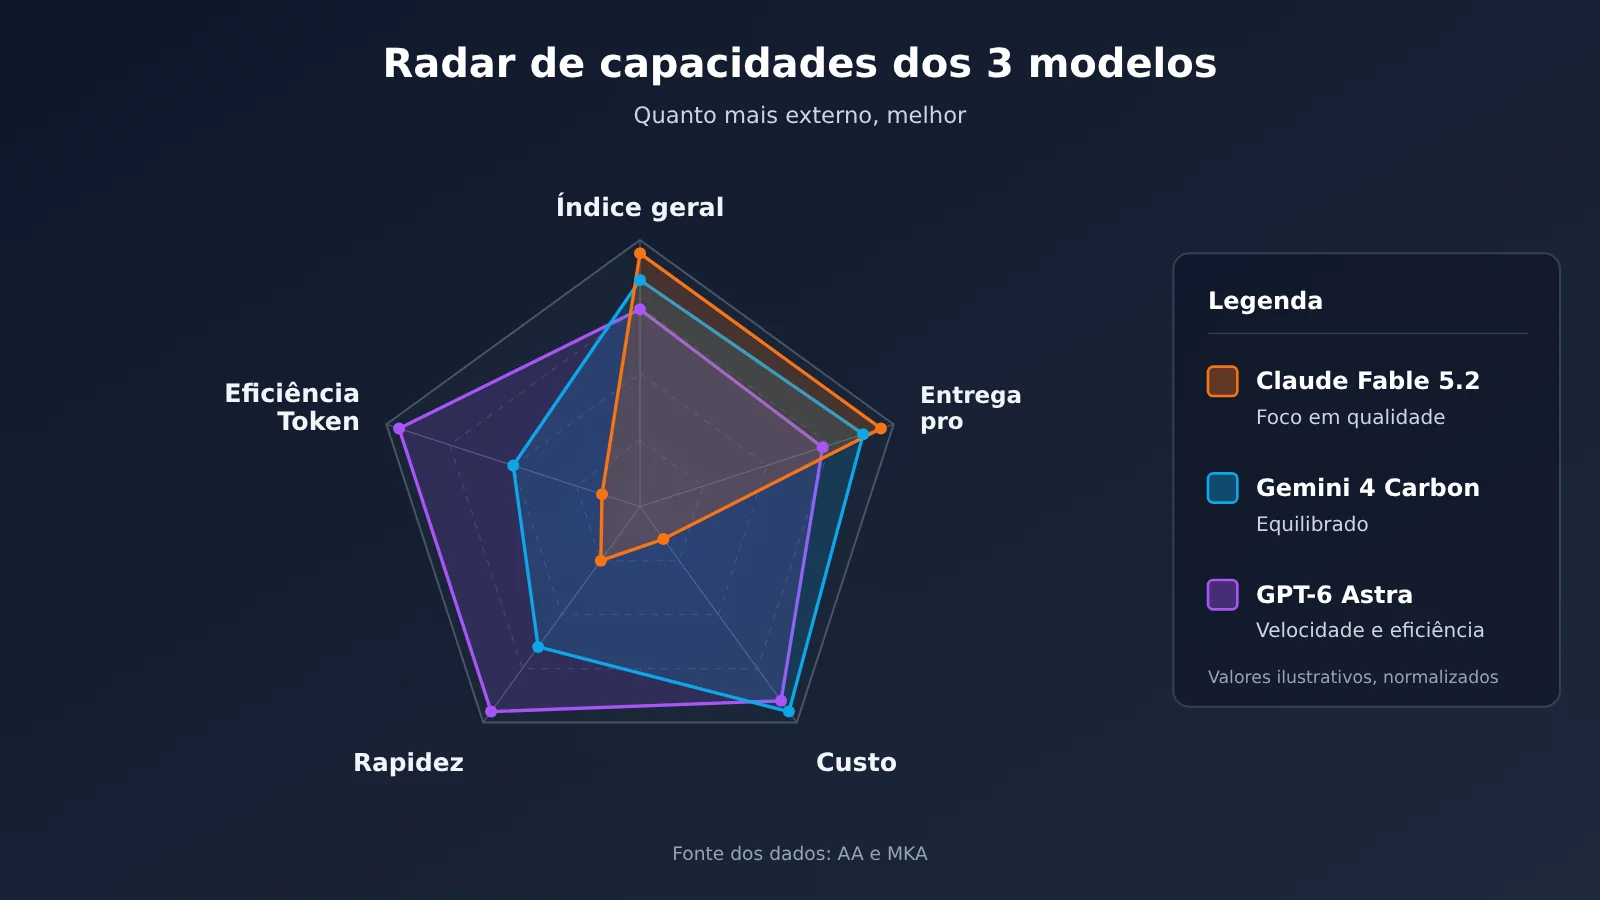
📊 Sobre os dados: os números da tabela vêm de fontes diferentes: o snapshot do ranking da AA e o artigo técnico do MKA. As duas metodologias não são conversíveis entre si. Se você quiser validar no seu próprio cenário de negócio, dá para usar o APIYI (apiyi.com) e rodar um teste comparativo em pequena escala com o mesmo comando, observando como os três modelos se comportam sob uma carga real.
Dois: Ranking geral da AA: Claude Fable 5.2 lidera por enquanto, com o Gemini 4 Carbon logo atrás
O Artificial Analysis Intelligence Index v5.0.1 é composto por 9 avaliações: AA-Briefcase v1.1, AutomationBench-AA, Terminal-Bench 4.0, FrontierCode 2.0, AA-Omniscience v1.1, GDP.pdf, HLE-Diamond, CritPt v2 e Terminal-Bench-Science 0.1. Elas cobrem trabalho de conhecimento, automação, código, raciocínio científico e confiabilidade factual. A pergunta que esse índice responde é: “qual é a força geral do modelo?”
| Configuração do modelo | AA Index v5.0.1 | Custo por tarefa de avaliação | Tempo por tarefa |
|---|---|---|---|
| Claude Fable 5.2 Max | 65 | $26.54 | 44,4 minutos |
| Gemini 4 Carbon High | 60 | $7.76 | 24,9 minutos |
| GPT-6 Astra Max | 57 | $6.24 | 23,0 minutos |
Vale ficar de olho nas diferenças de configuração nessa tabela. Os três modelos usam os níveis Max, High e Max, respectivamente, e o orçamento de raciocínio não é o mesmo entre eles. Por isso, o resultado não pode ser lido como uma comparação pura de capacidade em condições iguais. Além disso, o mesmo modelo muda de pontuação quando troca de nível: no Fable 5.2, tanto o Xhigh quanto o High marcam 62 pontos; no Carbon, o Medium fica com 58 e o Low com 54.
Os dados dos níveis internos do Carbon merecem uma análise à parte. Na medição da AA, o Medium tem custo por tarefa de $6.59, que acaba sendo menor do que os $7.19 do Low. O High, apesar de ter a maior pontuação, chega a 67,54 segundos de latência até o primeiro Token da resposta. Ou seja, subir o nível de raciocínio nem sempre traz um ganho proporcional. Os $7.76 da tabela são o custo médio das tarefas da AA, calculado com base no preço padrão do Carbon de $4/$20, e não o preço de uma requisição comum.
Três: Entrega profissional no MKA — a capacidade dos três modelos de realmente concluir o trabalho
O índice AA mede a força geral, enquanto o MKA mede se o modelo consegue concluir trabalhos profissionais reais. Estas são as configurações descritas no artigo técnico do MKA:
- São 200 tarefas reais e privadas, cobrindo 10 setores e 83 profissões. Cada tarefa equivale a cerca de 3 a 8 horas de trabalho de um profissional.
- Cada tarefa tem cerca de 70 critérios de avaliação ponderados. Em 88% das tarefas, é preciso gerar arquivos independentes, como Word, Excel, PPT, PDF, HTML ou imagens.
- Todos os modelos rodam no mesmo Stirrup Agent Harness, com o mesmo ambiente de ferramentas e um orçamento unificado de 250 turnos. Cada tarefa é executada uma única vez.
| Modelo | Climb-WSR | Overall WSR | Regression-WSR |
|---|---|---|---|
| Claude Fable 5.2 | 56,56% | 73,26% | 95,71% |
| Gemini 4 Carbon | 54,34% | 71,89% | 96,36% |
| GPT-6 Astra | 50,24% | 69,34% | 95,17% |
Cada uma das três métricas tem um significado próprio. O Regression-WSR reflete o cumprimento dos requisitos básicos: os três ficam acima de 95%, com o Carbon um pouco à frente. O Climb-WSR conta apenas os itens de alta dificuldade e é o principal critério para separar os modelos de ponta. O Overall WSR é a taxa geral de atendimento ponderada, considerando todos os itens. Nenhum desses números é taxa de acerto em perguntas e respostas comuns, e eles também não podem ser comparados diretamente com os 65, 60 e 57 do índice AA.
Significância estatística entre Claude Fable 5.2 e Gemini 4 Carbon
A significância estatística é o ponto que mais exige atenção ao interpretar o MKA. Estes são os dados do artigo:
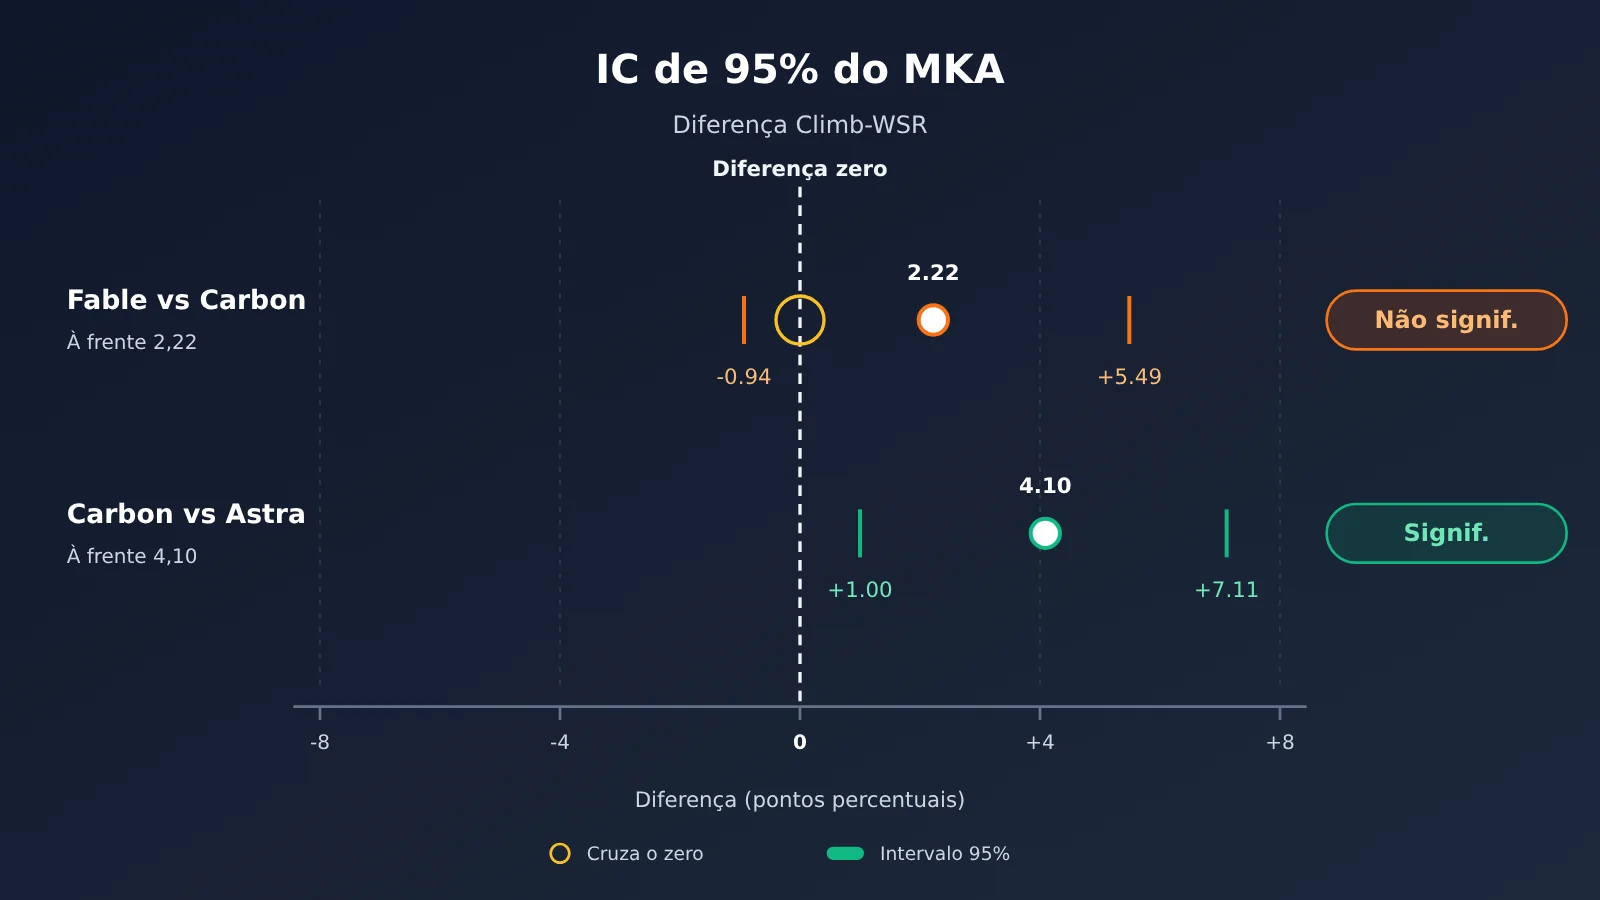
- Fable vs. Carbon: vantagem de 2,22 pontos percentuais, com intervalo de confiança de 95% de -0,94 a +5,49. O intervalo atravessa o zero, então a diferença não atinge significância estatística.
- Carbon vs. Astra: vantagem de 4,10 pontos percentuais, com intervalo de confiança de 95% de +1,00 a +7,11. O intervalo fica inteiramente acima de zero, então a diferença é estatisticamente significativa.
Portanto, o jeito correto de dizer é: no MKA, o Fable 5.2 e o Carbon estão em um patamar parecido, e as evidências atuais não bastam para afirmar que o Fable supera claramente o Carbon. A conclusão do artigo é que os dois modelos estão significativamente à frente do Astra.
Quatro: comparação de custo por tarefa — quanto cada um dos três modelos gasta para fazer a mesma coisa
A Tabela 4 do artigo do MKA traz o consumo médio de recursos por tarefa. O custo de API foi estimado com base nos preços de tabela de cada fornecedor, levando em conta a cobrança de cache de comandos.
| Média por tarefa | Claude Fable 5.2 | Gemini 4 Carbon | GPT-6 Astra |
|---|---|---|---|
| Total de tokens | 40,48M | 7,05M | 2,43M |
| Tokens de saída | 378,9K | 129,5K | 42,0K |
| Rodadas do Agent | 128,8 | 46,6 | 29,0 |
| Tempo de execução | 83,2 minutos | 29,2 minutos | 18,5 minutos |
| Custo por tarefa | $35,28 | $5,63 | $6,03 |
Dá para tirar três conclusões dessa tabela:
- O Fable é quem investe mais recursos: o total de tokens é 5,74 vezes o do Carbon, e o tempo de execução é cerca de 2,85 vezes maior. Os resultados de alta qualidade dele vêm de muitas rodadas de exploração e de um volume grande de chamadas.
- O Carbon tem o melhor custo-benefício: o custo por tarefa é cerca de um sexto do Fable, e o Climb-WSR fica só 2,22 pontos percentuais abaixo, uma diferença que não é significativa.
- O Astra é o mais rápido e o que menos gasta tokens: tem o menor tempo de execução e o menor consumo de tokens, mas o custo por tarefa ainda fica um pouco acima do Carbon, e o Climb-WSR também fica bem atrás.
Preço por token, consumo de tokens e conta da tarefa: qual é a diferença?
Esses três conceitos costumam ser confundidos. No preço por token, o Fable 5.2 cobra $8 por milhão de tokens de entrada e $40 por milhão de saída. O Carbon tem um preço de lançamento de $2/$10 até 30 de novembro, e a partir de 1º de dezembro passa a $4/$20. Só que preço unitário baixo não significa conta baixa. O Astra consome só cerca de um terço dos tokens do Carbon, mas o custo por tarefa dele é um pouco maior, o que mostra que a estrutura de preços de cada modelo e a taxa de acerto no cache influenciam o valor final.
A leitura de cache é uma variável que muita gente ignora em cenários de Agent. A cada rodada, o Agent reenvia uma grande quantidade de contexto. No caso do Carbon, o preço de entrada em cache é cerca de 5% do preço de entrada normal. O total de tokens do Fable chega a 40,48M, e boa parte disso é contexto lido repetidamente, então a forma de cobrança afeta diretamente a conta. Além disso, os tokens de raciocínio do Carbon entram na cobrança de saída, e, ao usar Grounding, as requisições de busca são cobradas à parte.
Os dados de custo vêm de três critérios diferentes e precisam ser citados separadamente: a Tabela 4 do artigo do MKA (Carbon $5,63, Fable $35,28), o ranking dinâmico do MKA (Carbon $6,29, Fable $31,97) e o custo por tarefa do índice AA ($7,76 e $26,54). O escopo estatístico de cada um é diferente, então não dá para misturá-los.
Cinco: onde aparece a vantagem multimodal do Gemini 4 Carbon
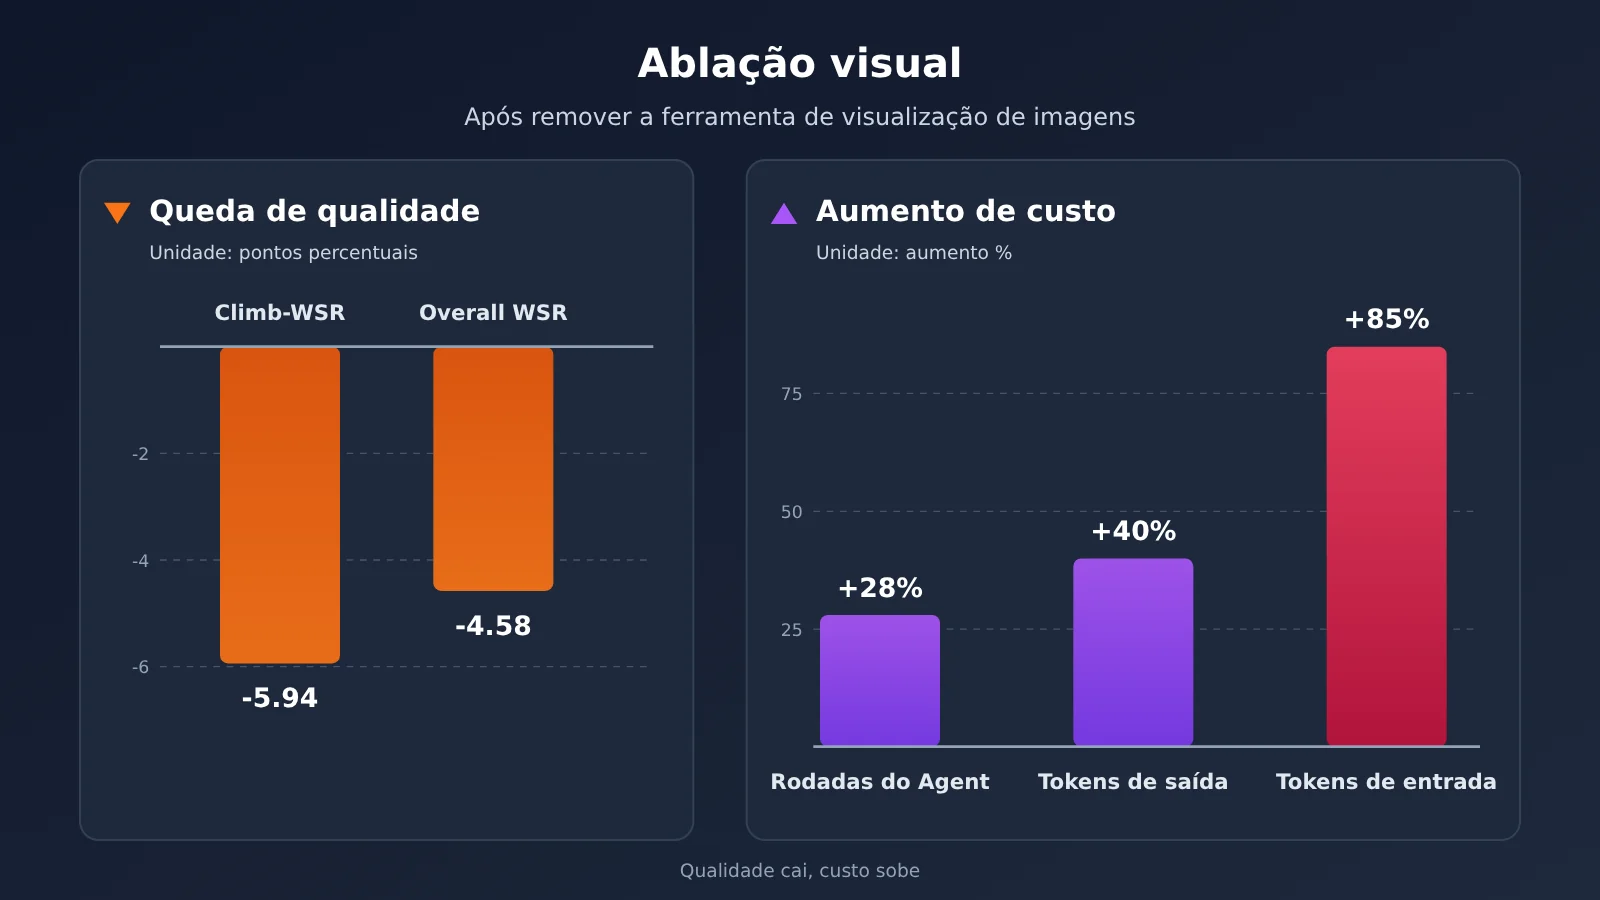
O artigo do MKA fez um estudo de ablação: removeram do Carbon a ferramenta de visualização de imagens view_image e deixaram o modelo trabalhar apenas com OCR, execução de código e métodos tradicionais de visão computacional. Os resultados foram estes:
- O Climb-WSR caiu 5,94 pontos percentuais, e o Overall WSR caiu 4,58 pontos percentuais.
- O número de turnos do Agent aumentou 28%, os Tokens de saída aumentaram 40% e os Tokens de entrada aumentaram 85%.
- O modelo tentou compensar com imagens ASCII, Unicode Braille e OpenCV, mas em fotos reais e imagens médicas ainda falhava com facilidade.
Esses números mostram que, no trabalho profissional, a compreensão visual dificilmente pode ser substituída por extração de texto. As relações espaciais de uma planta de arquitetura, a localização de uma lesão em um exame de imagem, a codificação visual de um gráfico: quase tudo isso se perde depois do OCR. O modelo acaba escrevendo código sem parar para tentar adivinhar o conteúdo da imagem, e o resultado é qualidade menor e custo maior.
Os resultados por setor no ranking do MKA seguem a mesma linha. O Carbon lidera na área de saúde e se destaca nas entregas baseadas em imagem, junto com o Argon. O Fable 5.2 lidera em software e dados, engenharia, logística e mapas, negócios e finanças, e leva vantagem em tipos de entrega como PDF, Word e planilhas (Spreadsheet). Nenhum modelo lidera nos 10 setores ao mesmo tempo, e Word e arquivos de texto puro continuam sendo os tipos de entrega mais difíceis: nenhum modelo passou de 52% nessas duas categorias.
Seis: Cenários recomendados — onde Gemini 4 Carbon, Claude Fable 5.2 e GPT-6 Astra funcionam melhor
Quando escolher o Claude Fable 5.2
- Entregas profissionais complexas, em que a qualidade do resultado é prioridade máxima: por exemplo, relatórios de análise financeira, projetos de engenharia e projetos de software e dados. Nessas tarefas, um erro custa caro, então vale aceitar um tempo de execução maior e uma fatura mais alta.
- Entregas centradas em documentos do Office: saídas em PDF, Word e planilhas são um ponto forte do Fable no MKA.
Quando escolher o Gemini 4 Carbon
- Trabalho complexo com Agents que precisa equilibrar qualidade e custo: no MKA, o Carbon chegou a um nível estatisticamente próximo ao do Fable com cerca de um sexto do custo.
- Tarefas que dependem de compreensão visual: por exemplo, interpretação de plantas e desenhos técnicos, análise auxiliar de imagens médicas e entregas baseadas em imagens. Recomendo começar com o nível de raciocínio MEDIUM, que, nos testes de confiabilidade factual do AA, inventa respostas com menos frequência.
Quando escolher o GPT-6 Astra
- Pipelines que valorizam velocidade de execução: no MKA, ele teve o menor tempo de execução e o menor número de rodadas de Agent, o que o torna ideal para tarefas que exigem feedback rápido.
- Cenários sensíveis ao orçamento de Tokens ou à pressão sobre a janela de contexto: o Astra tem o menor consumo total de Tokens, mas é preciso aceitar uma diferença na qualidade das entregas profissionais.
| Tipo de tarefa | Modelo preferido | Modelo alternativo | Principal justificativa | Forma de acesso |
|---|---|---|---|---|
| Relatórios profissionais de alto valor | Claude Fable 5.2 | Gemini 4 Carbon | Maiores pontuações no AA e no MKA | API oficial, APIYI |
| Tarefas complexas de Agent em lote | Gemini 4 Carbon | Claude Fable 5.2 | Qualidade próxima, com custo cerca de seis vezes menor | API oficial, APIYI |
| Análise de plantas e imagens | Gemini 4 Carbon | Claude Fable 5.2 | Evidências de ablação visual, liderança na área médica | API oficial, APIYI |
| Pipelines de execução rápida | GPT-6 Astra | Gemini 4 Carbon | Menor tempo de execução e menor consumo de Tokens | API oficial, APIYI |
7. Como testar os três modelos na prática com uma interface unificada
Rankings públicos servem só como ponto de partida. No fim, o que importa é como o modelo se sai nas suas próprias tarefas. O exemplo abaixo usa a interface compatível com OpenAI: basta trocar o parâmetro model para chamar modelos diferentes com o mesmo código:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "用三点概括这份季度财报摘要的主要风险。"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # Registra o uso de tokens, para estimar o custo depois
Ver o código completo do teste comparativo dos três modelos
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Os nomes dos modelos seguem a lista de modelos da plataforma; GPT-6 Astra é só um nome de exemplo aqui
MODELS = ["claude-fable-5-2", "gemini-4-carbon", "gpt-6-astra"]

# Preço unitário (dólares por milhão de tokens): preencha conforme o canal real
# Exemplo: Fable 5.2 com preço de tabela oficial; Carbon com preço de lançamento válido até 30 de novembro
PRICES = {
    "claude-fable-5-2": {"input": 8.0, "output": 40.0},
    "gemini-4-carbon": {"input": 2.0, "output": 10.0},
    "gpt-6-astra": None,  # Preencha por conta própria
}

def build_messages(task, image_url=None):
    content = [{"type": "text", "text": task}]
    if image_url:
        content.append({"type": "image_url", "image_url": {"url": image_url}})
    return [{"role": "user", "content": content}]

def run_once(model, messages):
    start = time.time()
    resp = client.chat.completions.create(model=model, messages=messages)
    elapsed = time.time() - start
    usage = resp.usage
    cost = None
    price = PRICES.get(model)
    if price and usage:
        # Estimativa aproximada: não diferencia leitura de cache; tokens de raciocínio normalmente entram na saída
        cost = (usage.prompt_tokens * price["input"]
                + usage.completion_tokens * price["output"]) / 1_000_000
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "est_cost_usd": round(cost, 4) if cost is not None else None,
        "answer": resp.choices[0].message.content[:200],
    }

if __name__ == "__main__":
    task = "根据这张户型图,列出各房间面积估算和三条改造建议。"
    msgs = build_messages(task, image_url="https://example.com/floor-plan.png")
    for m in MODELS:
        try:
            print(run_once(m, msgs))
        except Exception as e:
            print(m, "调用失败:", e)
Esse código mede uma única chamada. Em tarefas reais de Agent, o custo precisa somar todas as rodadas, que é o que chamamos aqui de custo da tarefa. Além disso, o Carbon não suporta thinking_budget: se você enviar esse parâmetro, recebe um HTTP 400. Parâmetros de amostragem como temperature também são ignorados, então o nível de raciocínio deve ser definido da forma descrita na documentação da plataforma.
🚀 Dica para começar rápido: o ideal é pegar primeiro o crédito gratuito de teste para novos usuários no apiyi.com (APIYI) e rodar o script comparativo acima com 5 a 10 amostras reais do seu negócio. Registre tempo, tokens e nota de qualidade, e só depois decida qual será o modelo principal. A plataforma usa a mesma chave API para acessar OpenAI, Claude, Gemini e outros modelos populares, com cobrança por uso, e trocar de modelo exige mudar só um parâmetro.
Recomendações de decisão: como escolher entre os três modelos
Na hora de escolher, vale primeiro definir qual é a restrição mais importante da sua tarefa e só depois olhar a métrica correspondente:
- Qualidade é restrição rígida: use o Climb-WSR do MKA como principal referência e escolha entre o Fable 5.2 e o Carbon. Como a diferença entre os dois não é significativa, o ideal é validar com as suas próprias amostras.
- Orçamento é restrição rígida: olhe o custo por tarefa na Tabela 4 do MKA, e não o preço por Token. Nesse quesito, o Carbon tem uma vantagem clara.
- Tempo de resposta é restrição rígida: olhe o tempo de execução e o número de rodadas do Agent. O Astra é o mais rápido, mas é preciso aceitar a conclusão de que ele fica bem atrás em qualidade de entrega profissional.
💡 Dica de escolha: dá para se inspirar na abordagem do Google /swarm: coloque o modelo mais forte nas etapas de planejamento e revisão, e o modelo rápido na execução em lote. Com a interface unificada da APIYI (apiyi.com), você pode atribuir modelos diferentes a cada papel de Agent dentro do mesmo projeto, sem precisar manter vários SDKs.
Perguntas frequentes (FAQ)
Q1: Qual é o posicionamento de cada um: Gemini 4 Carbon, Claude Fable 5.2 e GPT-6 Astra?
Os três são modelos de raciocínio de ponta do segundo semestre de 2026. O Fable 5.2 lidera em qualidade geral e em entregas profissionais. O Carbon é mais equilibrado entre qualidade, capacidade multimodal e custo por tarefa. O ponto forte do Astra é a velocidade de execução e a eficiência no uso de Tokens.
Q2: No MKA, o Fable 5.2 está 2,22 pontos percentuais à frente do Carbon. Isso prova que o Fable é mais forte?
Não. O intervalo de confiança de 95% dessa diferença vai de -0,94 a +5,49, ou seja, cruza o zero e não atinge significância estatística. O jeito mais correto de dizer é que os dois estão em um patamar parecido, e ambos ficam bem à frente do Astra.
Q3: Dá para comparar os 65 pontos do índice AA com os 56,56% do MKA?
Não dá. O índice AA é uma pontuação composta de 9 avaliações, e cada modelo usa um nível de raciocínio diferente. Já o MKA é a taxa de satisfação ponderada em entregas profissionais, medida com um Harness unificado. O objeto avaliado e a forma de pontuar são diferentes, então não existe conversão entre os dois.
Q4: O preço por Token do Carbon é um quarto do preço do Fable. O custo por tarefa também é um quarto?
Nem sempre. No período de lançamento, o preço unitário do Carbon realmente é 25% do preço do Fable 5.2, e a partir de 1º de dezembro passa a ser 50%. Mas a fatura real depende do consumo de Tokens, dos Tokens de raciocínio, dos acertos de cache e das chamadas de ferramentas. Na Tabela 4 do MKA, o custo por tarefa dos dois difere em cerca de seis vezes, porque o Carbon também consome muito menos Tokens.
Q5: Como validar os três modelos por conta própria gastando pouco?
Eu recomendo usar uma interface agregadora que suporte vários modelos:
1. Crie uma conta no APIYI (apiyi.com) para obter sua chave API e créditos gratuitos de teste;
2. Defina o base_url do código deste artigo como `https://api.apiyi.com/v1`;
3. Rode uma comparação com arquivos e tarefas reais do seu negócio e registre qualidade, tempo de execução e uso de Tokens.
Q6: O GPT-6 Astra é o que mais economiza Tokens. Por que o custo por tarefa não é o menor?
Gastar menos Tokens não significa fatura menor. Cada modelo tem uma estrutura de preços diferente para entrada, saída e cache, e o custo final é a soma do consumo multiplicado pelo preço correspondente. Na Tabela 4 do MKA, o Astra usa cerca de um terço dos Tokens do Carbon, mas o custo fica um pouco mais alto.
Q7: Quais são as limitações dessas conclusões de avaliação?
No MKA, cada tarefa foi executada apenas uma vez, e o Judge foi o GPT-6 Luna Medium, com 96% de concordância com os revisores especialistas. O ranking do AA é um retrato dinâmico, e quando o preço do Carbon mudar em 1º de dezembro, o custo calculado pelo preço padrão também vai mudar. Se você precisa acompanhar custos no longo prazo, dá para consultar o detalhamento de uso no APIYI (apiyi.com), onde é possível somar o gasto real por modelo e montar seus próprios dados de custo.
Pontos-chave da comparação entre os três modelos
- Capacidade geral: no AA v5.0.1, o Fable 5.2 Max marcou 65 pontos, à frente do Carbon High (60) e do Astra Max (57).
- Entrega profissional: no MKA, a diferença entre Fable e Carbon não é significativa, e os dois ficam bem à frente do Astra.
- Custo por tarefa: pelo critério da Tabela 4 do artigo, o Carbon custa US$ 5,63 por tarefa, cerca de um sexto do custo do Fable.
- Velocidade e eficiência: o Astra leva 18,5 minutos por tarefa e consome 2,43M de tokens, o que o torna o melhor em velocidade e eficiência de tokens.
- Valor multimodal: sem a ferramenta de visualização de imagens, a qualidade do Carbon cai e o consumo de tokens de entrada aumenta 85%.
- Limites dos critérios: preço por token, consumo de tokens e custo da tarefa são três conceitos diferentes.
- Como começar: pelo APIYI (apiyi.com), você consegue fazer testes comparativos em pequena escala com os três modelos usando uma única chave.
Conclusão: nenhuma métrica isolada define o melhor modelo
Voltando à pergunta do início: o que diferencia esses três modelos de ponta é principalmente o equilíbrio que cada um faz entre qualidade, velocidade e custo:
- Claude Fable 5.2: lidera tanto no índice geral quanto na entrega profissional, mas tem o maior tempo de execução e o maior custo por tarefa.
- Gemini 4 Carbon: tem qualidade de entrega profissional estatisticamente próxima à do Fable, o menor custo por tarefa, e sua compreensão visual é o grande diferencial.
- GPT-6 Astra: é o mais rápido e o que gasta menos tokens, mas a qualidade da entrega profissional fica bem atrás dos outros dois.
Capacidade geral, qualidade da tarefa, velocidade de resposta e custo por tarefa precisam ser avaliados separadamente. Em vez de olhar só a posição no ranking, o mais confiável é fazer um teste comparativo com as suas próprias tarefas. Recomendamos validar rapidamente o desempenho dos três modelos no seu caso de uso pelo APIYI (apiyi.com), que oferece crédito gratuito para testes e uma interface unificada para vários modelos.
📚 Referências
- Artigo técnico do MKA: MKA: Evaluating Multimodal Knowledge Agents on end-to-end professional tasks
- Link:
storage.googleapis.com/deepmind-media/papers/mka_tech_paper.pdf -
Descrição: dados originais do WSR dos três modelos, intervalos de confiança, custos da Tabela 4 e experimento de ablação visual
-
Ranking de modelos do Artificial Analysis: Intelligence Index v5.0.1
- Link:
artificialanalysis.ai/leaderboards/models -
Descrição: snapshot dinâmico com pontuação geral, custo por tarefa e tempo de execução
-
Ranking de avaliação do MKA: classificação de agentes de conhecimento multimodal
- Link:
artificialanalysis.ai/zh/evaluations/mka -
Descrição: resultados detalhados dos modelos líderes do setor e por tipo de arquivo entregue
-
Model card do Gemini 4 Carbon: material oficial do Google DeepMind
- Link:
deepmind.google/models/model-cards/gemini-4-carbon -
Descrição: modalidades, janela de contexto, níveis de raciocínio e limitações conhecidas
-
Página de preços da Gemini API: preço padrão, preço com cache e preço Batch do Carbon
- Link:
ai.google.dev/gemini-api/docs/pricing -
Descrição: preço de lançamento e ajuste de preços a partir de 1º de dezembro
-
Documentação da API do Claude Fable 5.2: descrição oficial do modelo pela Anthropic
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: janela de contexto, saída máxima, preço por token e Fast Mode
Autor: equipe técnica da APIYI
Troca de experiências: fale com a gente na página inicial do site da APIYI; para mais materiais de integração, acesse a central de documentação em docs.apiyi.com