Nota del autor: a partir de una serie de pruebas de réplica del sitio web oficial de Agrumea Farm, comparamos Gemini 4 Carbon, Claude Opus 5.5 y GPT-6 Astra en tres dimensiones (fidelidad del diseño, requisitos de interacción, tiempo empleado y coste equivalente en API), y proponemos cómo elegir según el escenario y cómo repetir la prueba por tu cuenta.
Si le das la misma web de marca a tres de los mejores modelos para que la repliquen, ¿cuánto cambia el resultado? El 11 de noviembre de 2026, el autor de evaluaciones independiente Pat Simmons (AI for Mortals) publicó una serie de pruebas. Pidió a Gemini 4 Carbon, Claude Opus 5.5 y GPT-6 Astra que replicaran el sitio web de la marca alimentaria italiana Agrumea Farm, y publicó los resultados, las capturas de pantalla, las indicaciones, los tiempos de ejecución y el coste equivalente en API.
No es un análisis tibio del tipo «cada uno tiene sus virtudes». En esta tarea, el ganador de cada dimensión está claro: Carbon tuvo el menor coste, Astra tardó menos y Opus recibió una mejor valoración de calidad por parte del autor de la evaluación. Eso sí, conviene aclarar que cada modelo se ejecutó una sola vez, y que las herramientas y las fechas de prueba también fueron distintas, así que estos resultados no se pueden extrapolar sin más a un ranking para todos los escenarios de desarrollo web.
Valor principal: al terminar este artículo sabrás en qué destaca cada uno de estos tres flujos de trabajo «modelo + herramienta» en cuanto a resultado, velocidad y coste, y podrás aplicar el método que se describe aquí para volver a validarlo en tus propios proyectos.
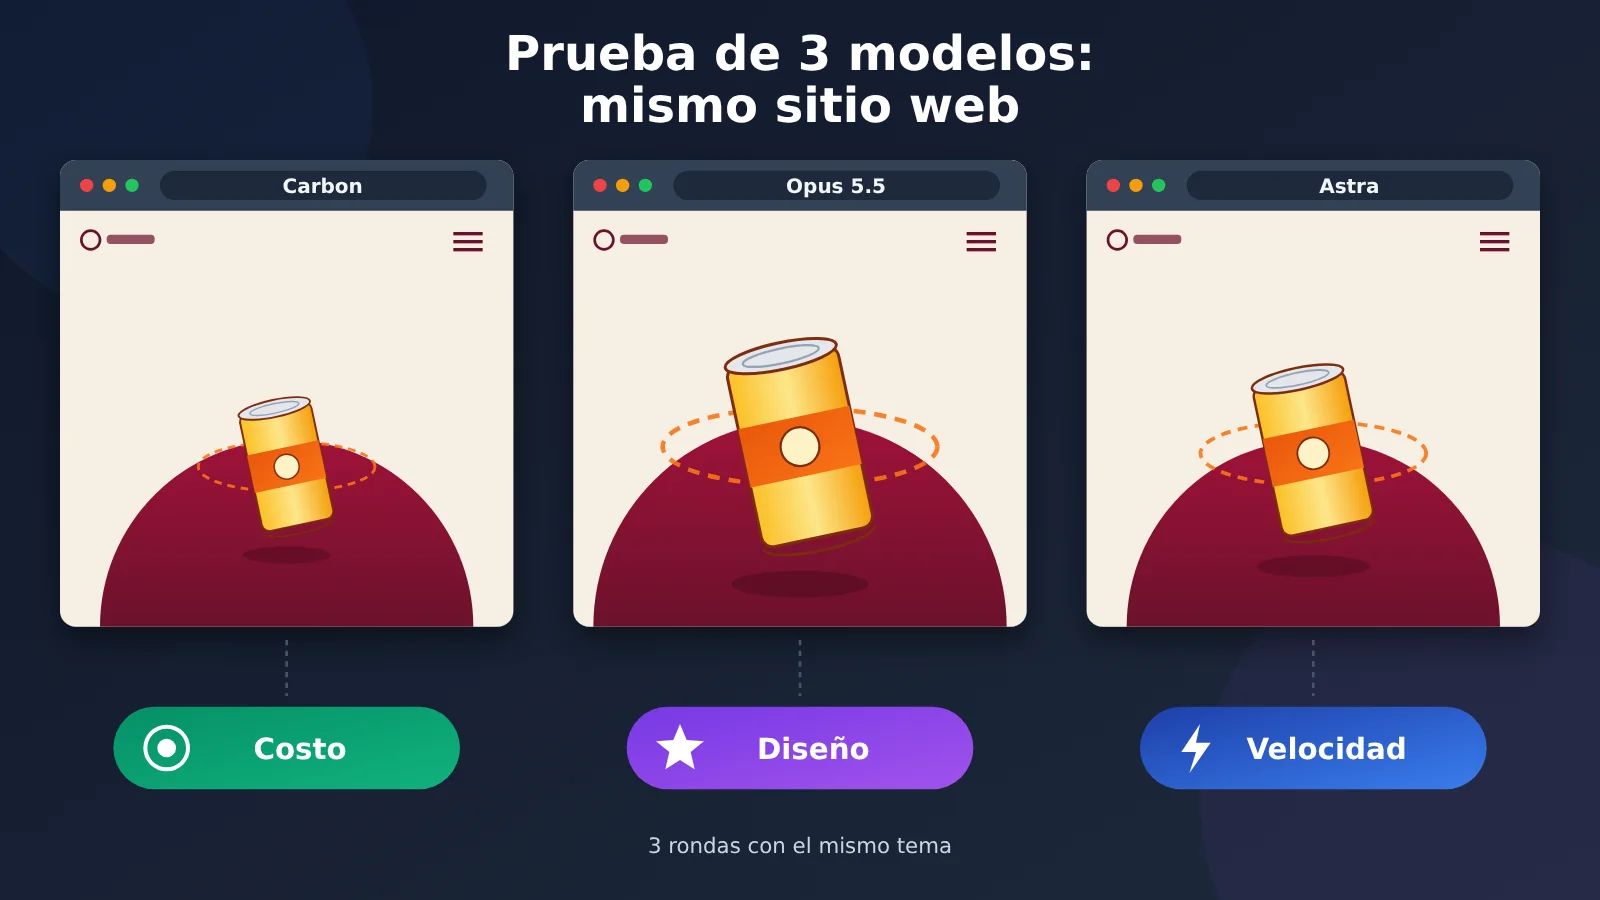
Primero, cómo era el sitio original: así se hizo la prueba de réplica con el mismo tema para Carbon, Opus y Astra
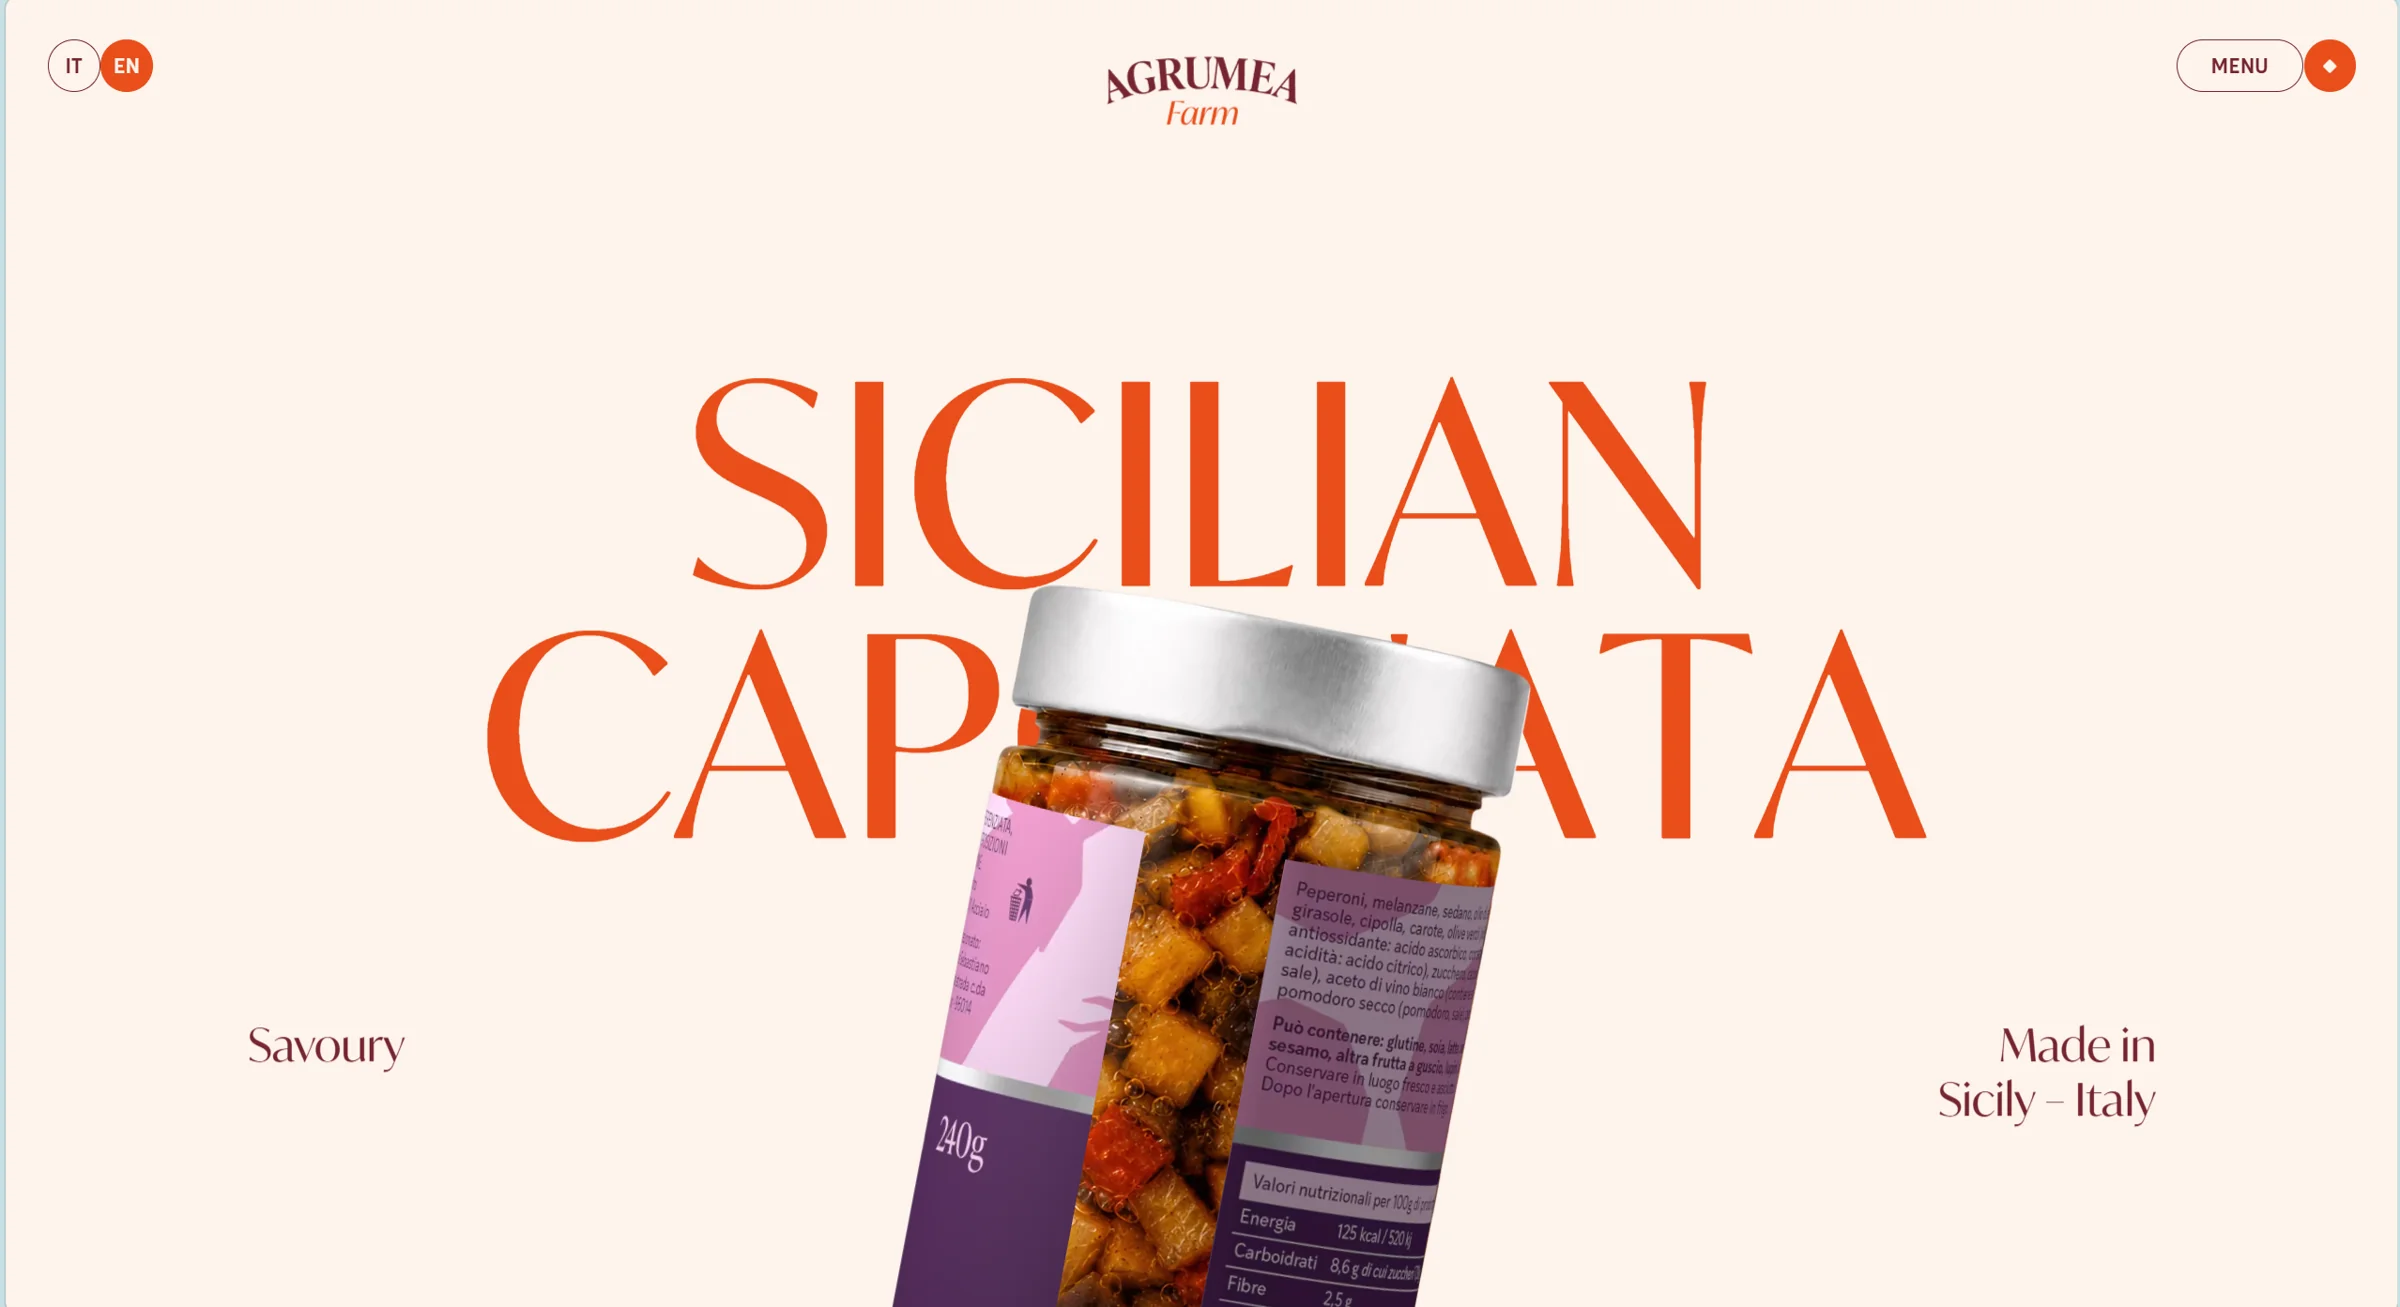
Antes de ver los resultados, conviene entender las condiciones de la prueba. Su valor está en que usa «el mismo sitio, la misma indicación y el mismo objetivo de desarrollo», pero lo que compara es el flujo de trabajo completo, no el modelo aislado en un laboratorio.
| Elemento de la prueba | Configuración concreta | Efecto en las conclusiones |
|---|---|---|
| Objeto de prueba | Sitio oficial de Agrumea Farm (versión en inglés) | Se compara la capacidad de reproducir un diseño, no el gusto estético original |
| Requisitos de la tarea | Reproducir la estructura de la página, el estilo visual, el carrusel 3D de latas, el desplazamiento y el arrastre, la animación de carga, las animaciones al pasar el cursor y las transiciones de página | Además de la captura estática, la interacción también cuenta como indicador de calidad |
| Tamaños de revisión | Escritorio 1440×900, móvil 390×844 | Obliga a tener en cuenta también el diseño responsivo |
| Método de verificación | Leer los estilos desde el navegador y hacer validación visual, asegurando que el sitio funcione | La capacidad de autoverificación en el navegador influye en el resultado final |
| Entorno de herramientas | Carbon con Google Antigravity, Opus con Claude Code y Astra con Codex, todos con razonamiento alto | El resultado es producto del modelo y de la cadena de herramientas combinados |
| Ejecuciones y fechas | Una sola ejecución por modelo; Opus y Astra el 6 de noviembre, Carbon del 10 al 11 de noviembre | Hay variabilidad de una sola corrida y diferencias de entorno |
Tres premisas clave de la prueba de Carbon, Opus y Astra
La primera premisa es que se trata de «replicar», no de «diseñar libremente». Los tres modelos tenían que mantener el lenguaje de diseño de la marca original, así que lo que se compara es la fidelidad, el detalle y el grado de acabado. Si lo que necesitas es crear una identidad visual original desde cero, esta prueba solo te sirve como referencia.
La segunda premisa es el criterio de costes. Todos los importes del texto son equivalentes en API, calculados por el autor de la evaluación a partir de los precios de los modelos y los registros de uso; no son cargos reales de una suscripción. Si ejecutas la misma tarea con una herramienta de pago mensual, la factura tendrá una forma completamente distinta.
La tercera premisa es que en la evaluación en realidad hay cuatro modelos. El autor incluyó además a Claude Fable 5.2, que se llevó el primer puesto en la valoración subjetiva. Por eso, cuando más adelante se hable del «segundo, tercer y cuarto puesto», se trata de la clasificación de los cuatro modelos.
Nota sobre las imágenes: las tres capturas de la pantalla de inicio de las obras que aparecen en este artículo provienen de AI for Mortals / Pat Simmons, publicadas el 2026-11-11, y corresponden a las réplicas de Gemini 4 Carbon, Claude Opus 5.5 y GPT-6 Astra, respectivamente.
Primera ronda: ¿quién reproduce mejor el diseño web, Carbon, Opus o Astra?
Empecemos por lo visual. A juzgar por las capturas públicas de la primera pantalla, los tres trabajos captan los elementos clave del sitio original: fondo blanco hueso, latas de comida flotando, un fondo curvo color vino tinto, texto naranja que rodea el producto, y en la parte superior el logotipo de la marca, el cambio de idioma y el botón de menú. Es decir, ninguno entregó una página de plantilla que se desvíe del original; las diferencias están en las proporciones, la jerarquía y los detalles.
De arriba abajo, las imágenes siguientes corresponden a los trabajos de opus5.5, astra y carbon.
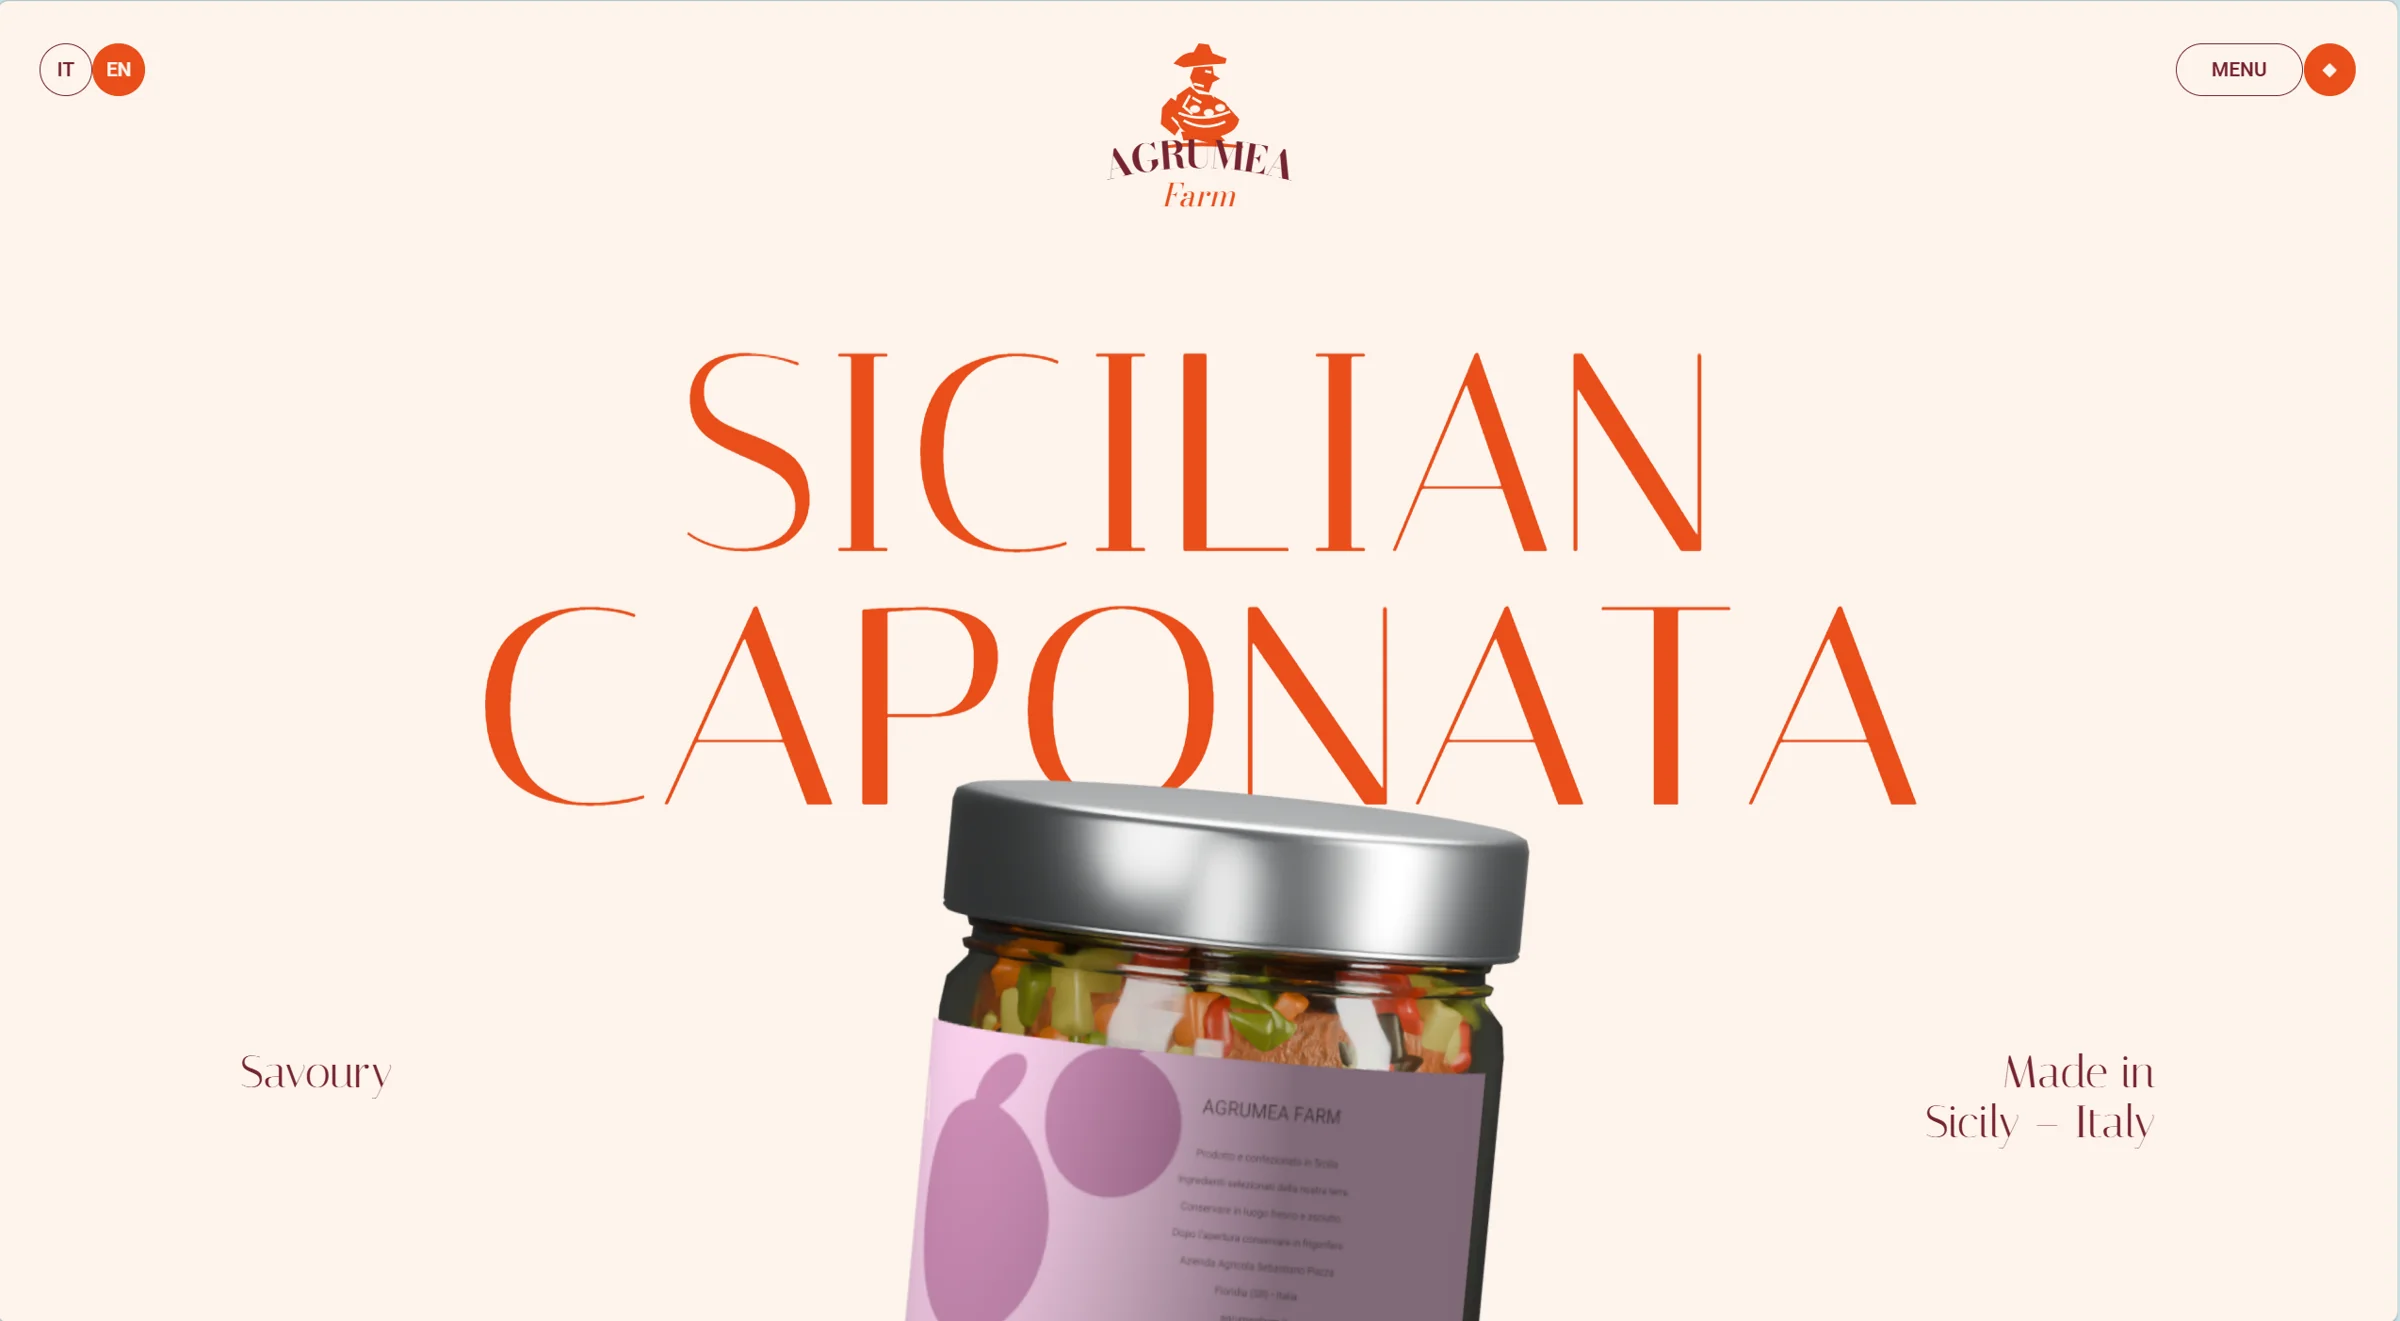
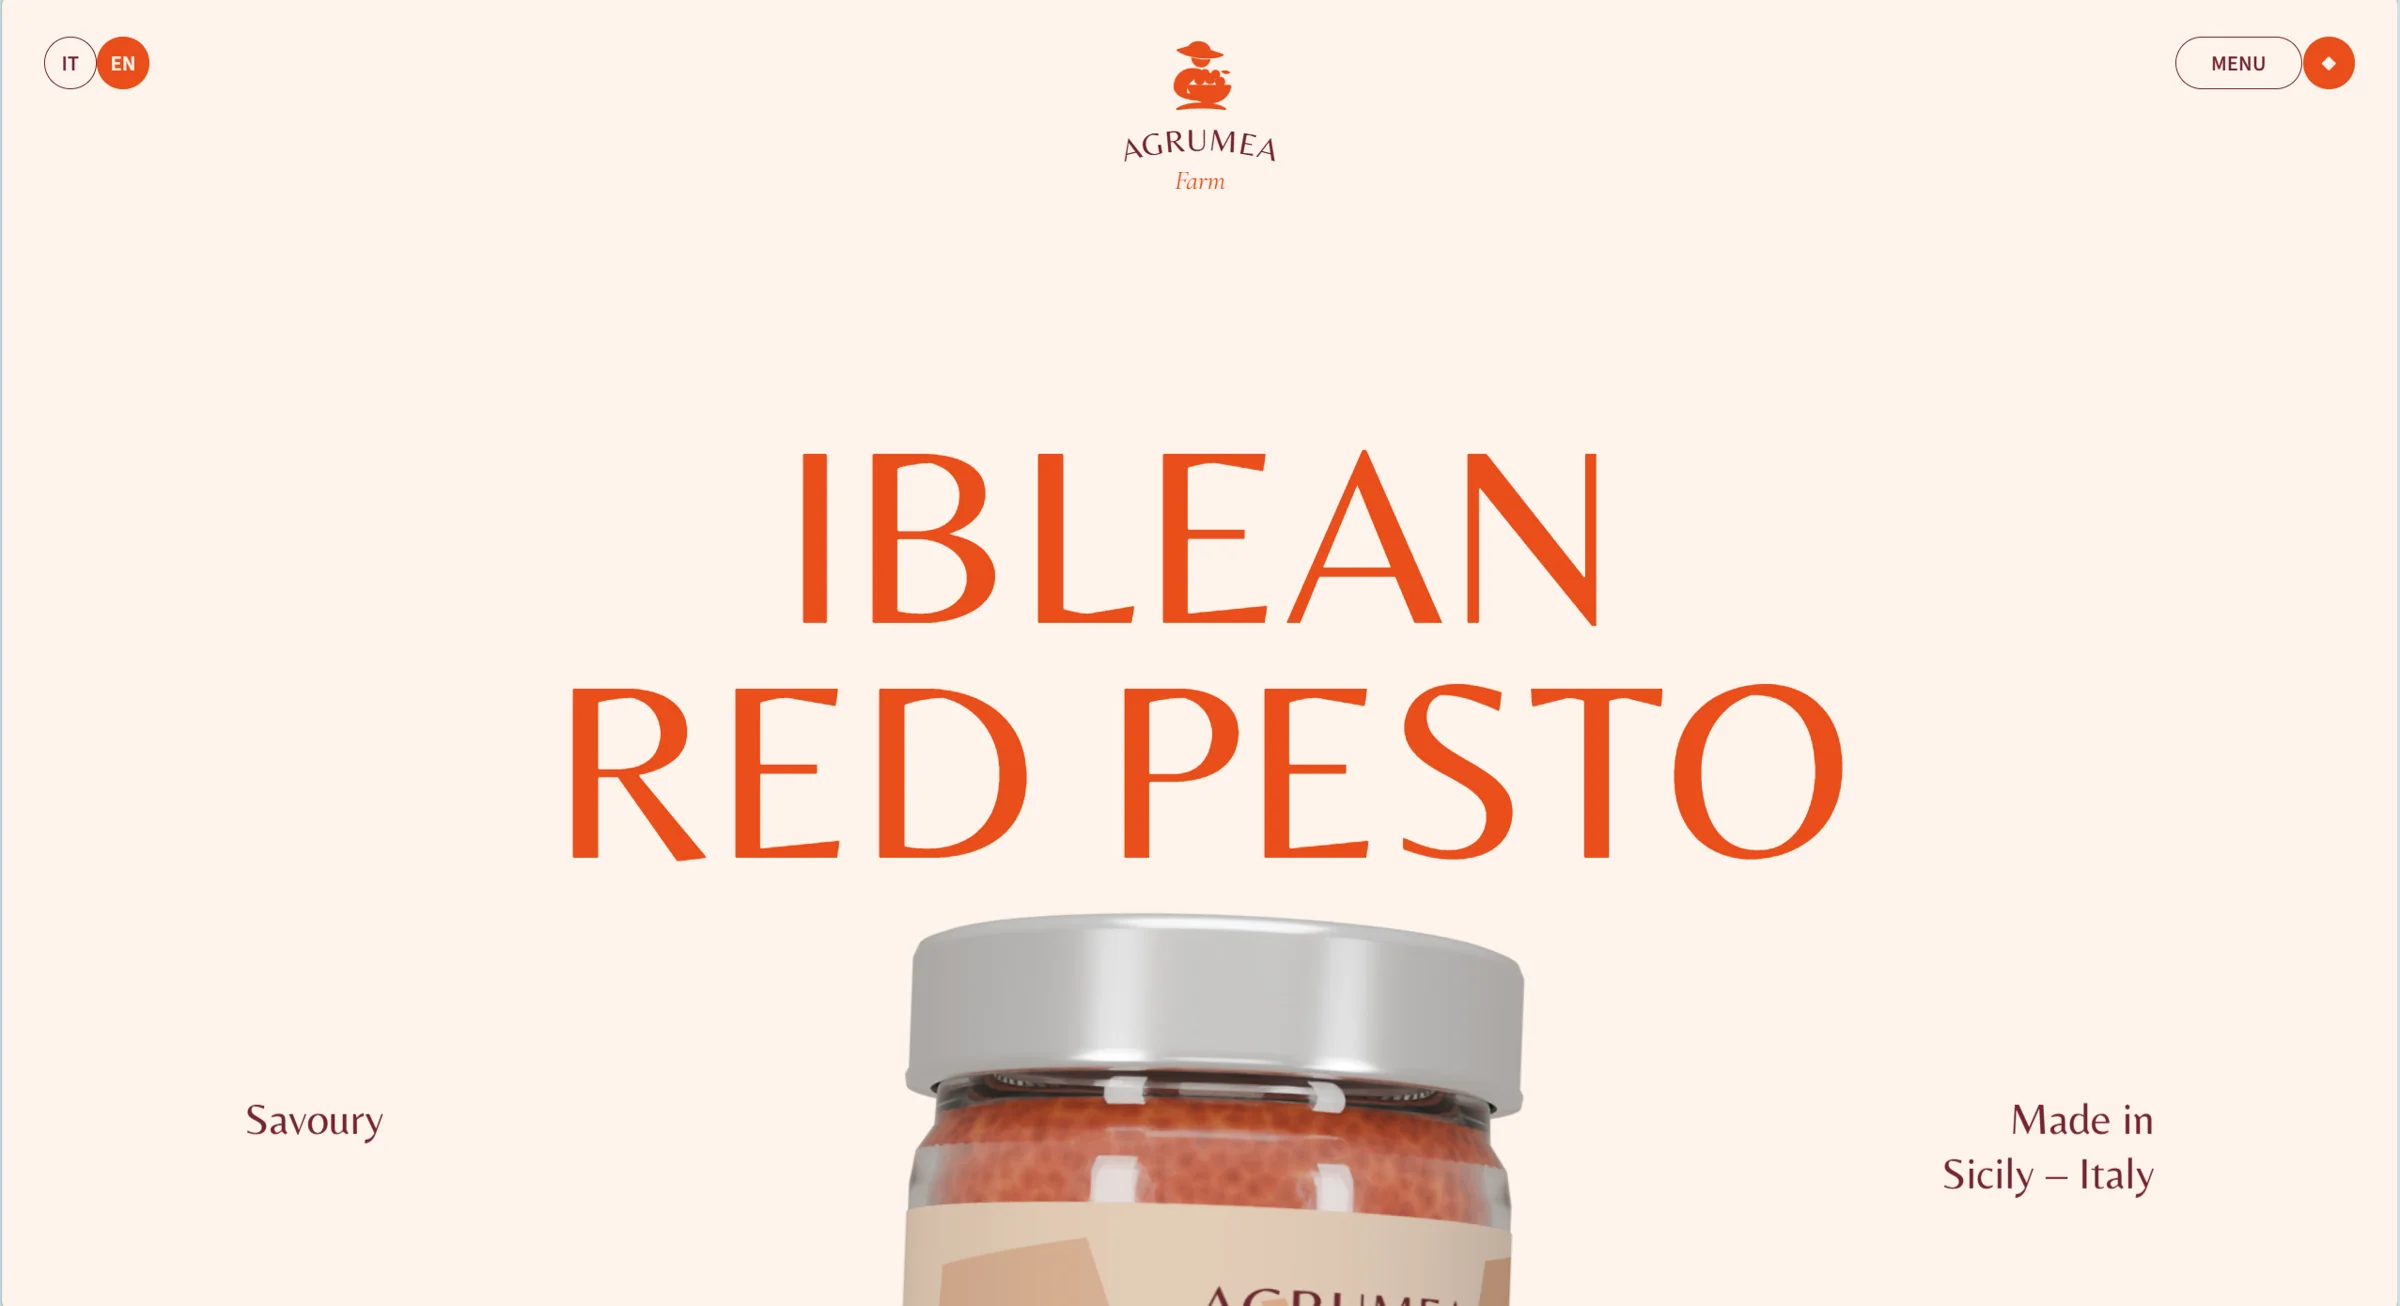
| Aspecto observado | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Composición de la primera pantalla | Mucho espacio en blanco, aspecto despejado | Producto principal más grande, gran impacto visual | Distribución completa, aspecto más compacto |
| Proporción de la lata | La lata central es relativamente pequeña | La lata destaca y es el centro visual absoluto | Centro visual bien definido |
| Fondo y jerarquía | Fondo curvo reproducido | La superposición entre la lata y la curva del fondo resalta más | Jerarquía completa |
| Etiquetas y texto | Algunos detalles de etiquetas y texto son más débiles | Etiquetas y tipografía más ricas | La etiqueta de la lata tiene decoraciones gráficas notorias |
| Ranking subjetivo del autor (cuatro modelos) | 4.º | 2.º | 3.º |
Por qué Opus convence más en la reproducción del diseño
Primero conviene separar dos tipos de información: las primeras cuatro filas de la tabla son observaciones visuales sobre las capturas públicas, y solo la última fila es el ranking subjetivo del autor de la evaluación. De los tres modelos indicados, el autor quedó más satisfecho con Opus, luego con Astra y por último con Carbon.
Según las capturas, la ventaja de Opus está sobre todo en la «relación entre lo principal y lo secundario» propia de la web de una marca. En la primera pantalla de una marca de alimentos, el protagonista es el producto: Opus hace la lata más grande, la superpone claramente a la curva vino tinto, creando una sensación de profundidad, y además el texto de la etiqueta se ve más nítido. La composición despejada de Carbon no es un error en sí misma, pero la lata es pequeña y algunos detalles del texto quedan débiles, lo que le pasa factura cuando el criterio es la fidelidad de la reproducción.
Astra queda a medio camino entre los dos. Su composición está completa, el centro visual está bien definido y la etiqueta de la lata tiene un buen toque decorativo, aunque el conjunto resulta más compacto. En una tarea de réplica, «parecerse al sitio original» importa más que «verse bien», y eso explica por qué los tres trabajos no son malos, pero aun así hay una clara diferencia en el ranking.
Segunda ronda: por qué no basta con las capturas para evaluar la interacción de Carbon, Opus y Astra
La gran diferencia entre un sitio web y un diseño estático es que el sitio tiene que «moverse». La tarea original pedía expresamente reproducir el carrusel 3D de latas de producto, las interacciones de desplazamiento y arrastre, la animación de carga, las animaciones al pasar el cursor y las transiciones entre páginas. Todo esto apenas se aprecia en una captura estática, pero define directamente la experiencia del usuario cuando abre el sitio.
Por eso, las capturas solo sirven para juzgar el diseño y los detalles visuales, no para demostrar que la interacción está completamente implementada. Si quieres saber si la lata 3D se arrastra con fluidez, si la respuesta al pasar el cursor se siente natural o si en móvil se descuadra algo, tienes que abrir las tres páginas públicas de los resultados y probarlas tú mismo. Este artículo no trata las capturas como resultados de una prueba de interacción, ni inventa puntuaciones de interacción que el autor original no proporcionó.
Esta ronda también deja clara la diferencia entre el desarrollo web y la generación de imágenes estáticas. Un modelo puede dibujar una primera pantalla preciosa, pero convertir en código ejecutable un carrusel 3D, animaciones guiadas por el scroll y un diseño responsive implica además resolver el orden de carga, el rendimiento y el comportamiento en distintos tamaños de pantalla. La evaluación exigía «leer los estilos con el navegador y hacer una verificación visual» precisamente para pasar de «terminado» a «funcionando».
En un proyecto real, puedes revisar un sitio generado por IA siguiendo este orden:
- Abre primero la página en dos tamaños, 1440×900 y 390×844, y comprueba que el diseño no se desborda ni se superpone.
- Activa uno por uno el arrastre, el scroll, el hover y los cambios de página, y observa si las animaciones van a trompicones o directamente fallan.
- Abre la consola del navegador y busca errores, recursos que no se cargan o animaciones en bucle infinito.
- Por último, compara pantalla por pantalla con el sitio original o el diseño, y anota las diferencias visuales.
Tercera ronda: ¿cuánta diferencia hay en costo y tiempo entre Carbon, Opus y Astra?
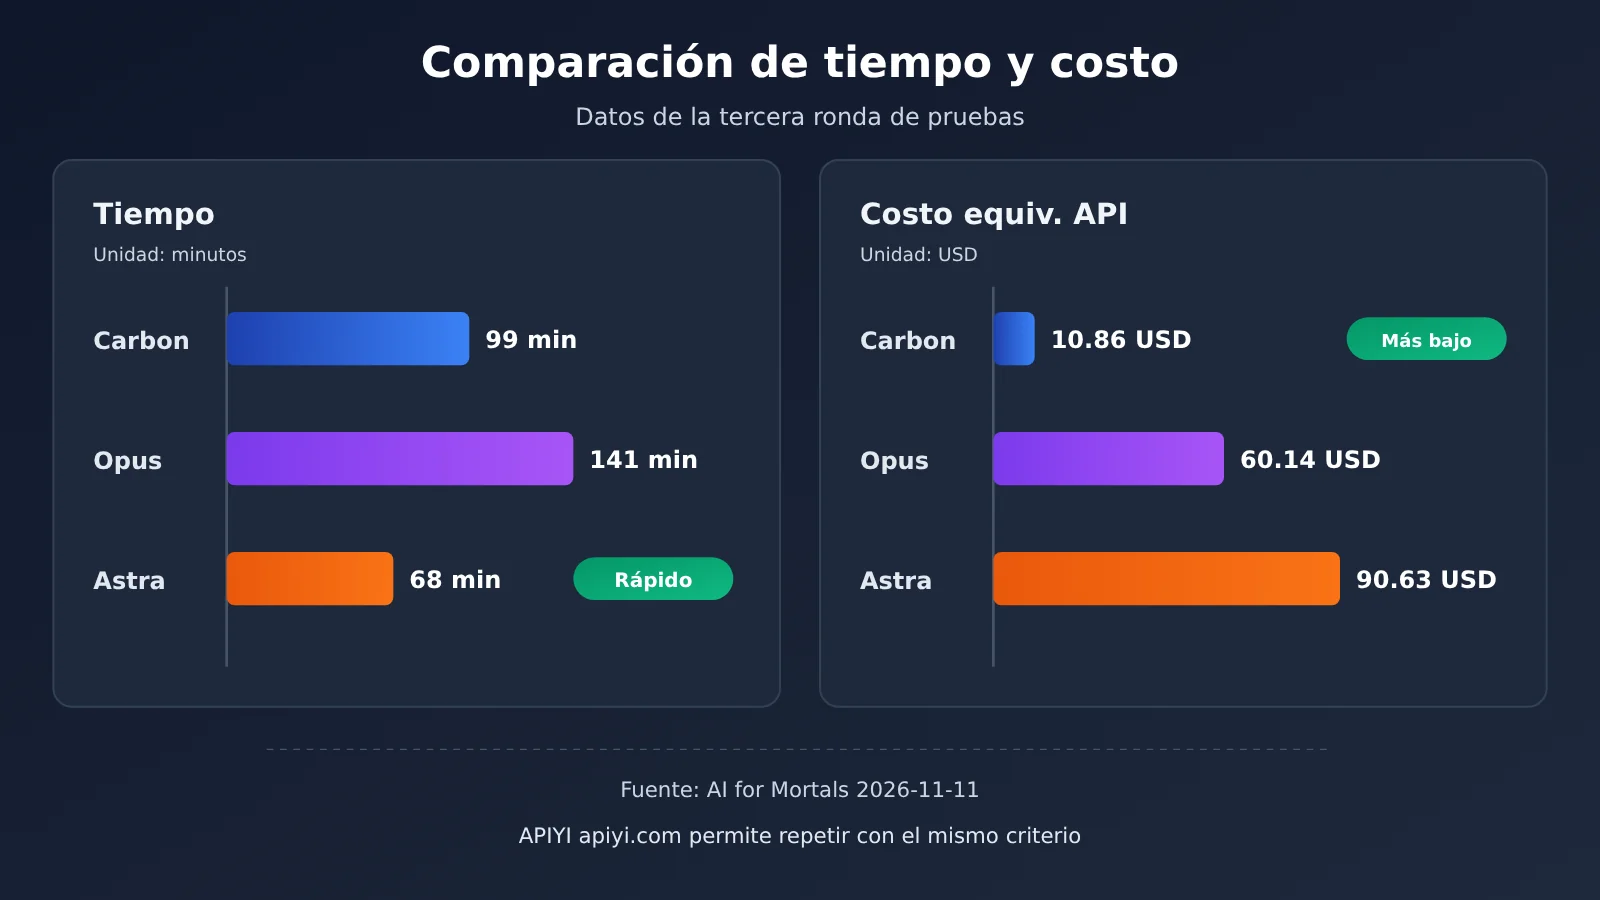
Esta ronda es la que mejor refleja las diferencias entre los tres flujos de trabajo. Todos los datos provienen de la evaluación original, y los costos son equivalentes a precios de API.
| Métrica | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Tiempo | 99 minutos | 141 minutos | 68 minutos (el más rápido) |
| Costo equivalente en API | 10.86 dólares (el más bajo) | 60.14 dólares | 90.63 dólares |
| Tokens de entrada | 27.7 millones | 197.9 millones | 70.4 millones |
| Tokens de salida | 430 000 | 483 000 | 211 000 |
| Costo equivalente por minuto (estimado) | ≈ 0.11 dólares | ≈ 0.43 dólares | ≈ 1.33 dólares |
| Posición según el autor (de cuatro modelos) | 4.º | 2.º | 3.º |
Análisis a fondo de los datos de costo de Carbon, Opus y Astra
El costo equivalente en API de Carbon es aproximadamente el 18 % del de Opus y el 12 % del de Astra. Si tu forma de trabajar implica muchos ensayos y errores e iteraciones constantes, esa diferencia se va acumulando a lo largo de varias rondas. Astra tardó 68 minutos, menos de la mitad que Opus, así que encaja bien en escenarios donde la velocidad de entrega es crítica. Opus fue el más lento y quedó en un punto intermedio de costo, pero a cambio produjo el trabajo que más satisfizo al autor de los tres.
Hay un detalle de la tabla que pasa fácilmente desapercibido: en los tres modelos, los tokens de entrada superan por mucho a los de salida. Según los datos de la tabla, la proporción entrada/salida es de unos 64:1 en Carbon, 410:1 en Opus y 334:1 en Astra. Esto tiene que ver con cómo funciona el desarrollo con agentes: en cada ronda el modelo vuelve a leer el código, los estilos, el estado de la página y demás contexto, y el código que realmente «escribe» es solo una parte pequeña. Que Opus llegue casi a los 200 millones de tokens de entrada indica que hizo muchísimas idas y vueltas de contexto durante esta tarea.
Otro punto que conviene notar es que la cantidad de tokens y el costo no son proporcionales. Los tokens de entrada de Astra son solo un tercio de los de Opus, y aun así su costo equivalente es mayor. Esto demuestra que el precio unitario, la facturación de caché y otros factores también pesan mucho. Al evaluar costos, no basta con mirar quién usó menos tokens: hay que calcularlos según las reglas de facturación reales de cada modelo. Este artículo no entra en los precios unitarios concretos; para esas cifras, consulta la página oficial de precios de cada proveedor.
Por qué Carbon, Opus y Astra dan resultados distintos con la misma indicación
Que la misma indicación produzca tres resultados distintos no se debe solo al modelo. En esta serie de pruebas, cada modelo se ejecutó en su propia herramienta de desarrollo, así que el resultado final dependió de la capacidad del modelo, la forma de invocar herramientas, el mecanismo de autoverificación en el navegador y la gestión del contexto.
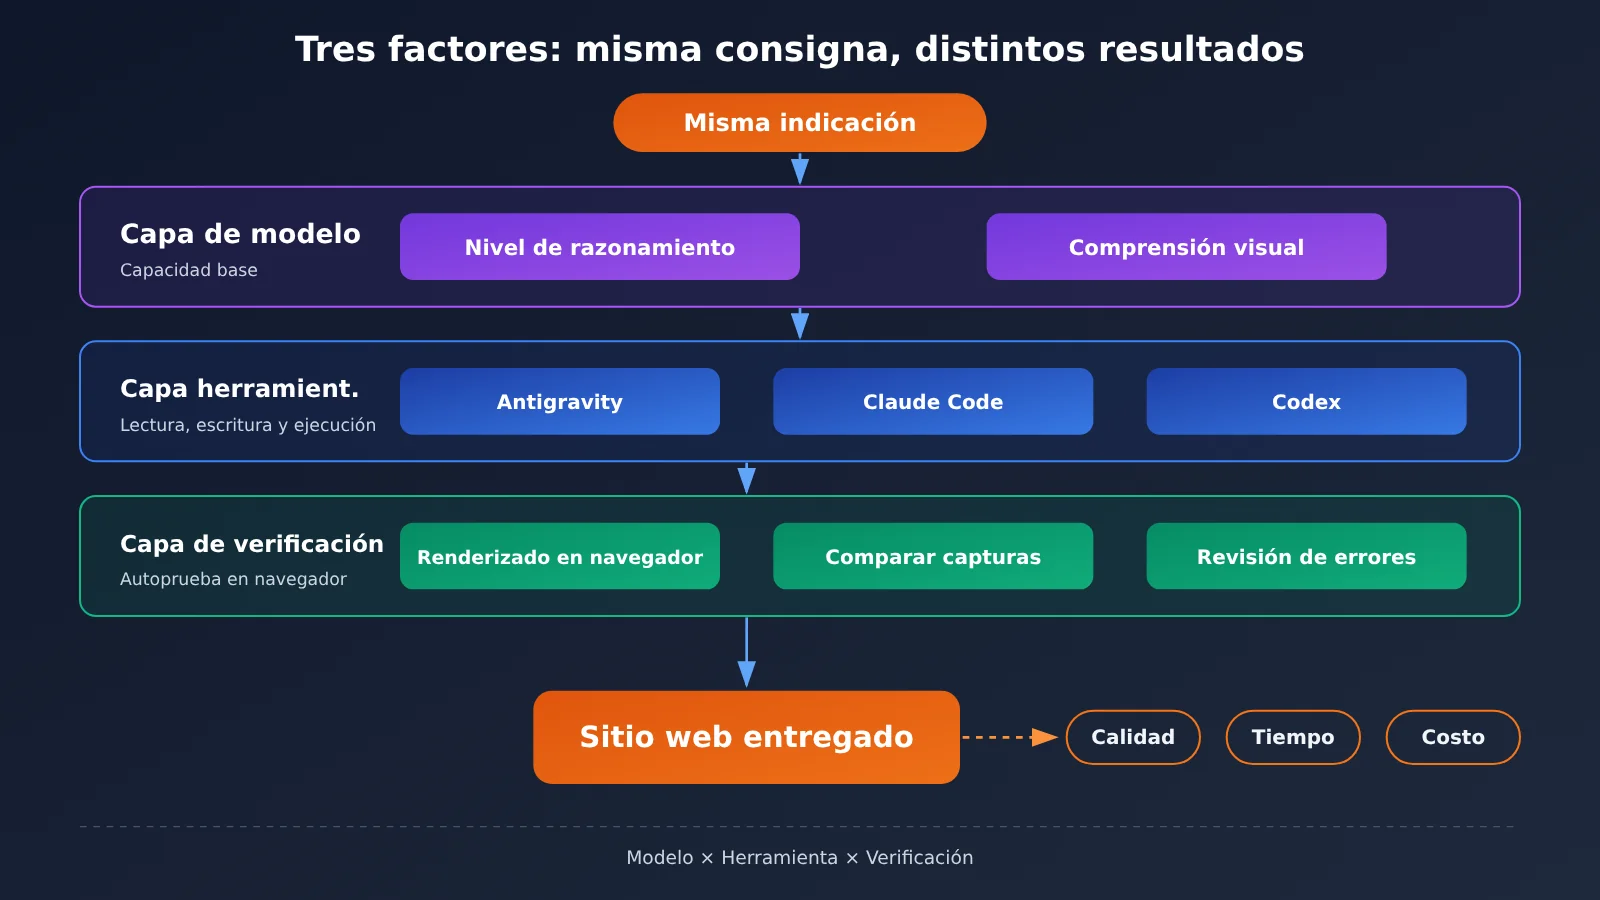
Según la documentación oficial, cada una de las tres empresas pone el énfasis en un aspecto distinto del desarrollo web:
- Google (Carbon + Antigravity): destaca el diseño frontend, la verificación en el navegador, los efectos dinámicos, el contenido 3D complejo y el desarrollo con múltiples agentes. Entre sus casos oficiales están el rediseño de Google Merchandise Store con solo dos indicaciones y una experiencia interactiva en 3D hecha con Three.js.
- OpenAI (Astra + Codex): en la presentación oficial de Astra se subraya la capacidad para desarrollar sitios web, aplicaciones y juegos, además de un flujo de trabajo que ejecuta comprobaciones de calidad del frontend después de generar el código.
- Anthropic (Opus + Claude Code): la documentación oficial no incluye una comparación con la misma tarea. Sin embargo, en una prueba de Proofyard/Woofocus del 24 de octubre de 2026, Opus 5.5 completó el diseño inicial y las modificaciones de la página de inicio de un estudio de muebles, con un costo de 4,34 dólares según los precios de la API. Esa prueba no es una comparación directa con Carbon y Astra de este artículo.
Cómo interpretar los datos de los rankings de Carbon, Opus y Astra
Además de la prueba individual, podemos consultar rankings que agregan varias tareas. Todos los datos de la tabla indican su fecha de recopilación. Las puntuaciones Elo dependen del método de prueba de cada plataforma, por lo que no se pueden comparar directamente entre rankings.
| Ranking (fecha) | Tipo de prueba | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| Arena WebDev (2026-11-10) | Votación en enfrentamientos de desarrollo web | 1814 (Max) | 1764 (Max) | 1768 (High, clasificación preliminar) |
| DesignArena, ranking agentic general (2026-11-11) | Frontend, full-stack, juegos, móvil, documentos de oficina, etc. | 1440 (High), 1.º | 1385 (Max), 3.º | 1291, 7.º |
Opus lidera en ambos rankings, lo que coincide con el orden subjetivo del autor en esta prueba de réplica. En el ranking WebDev, Carbon queda muy cerca de Astra, pero en el ranking general de DesignArena, que abarca más áreas, aparece bastante más abajo. Esto indica que el «desarrollo de una página web individual» y las «tareas complejas de diseño con agentes» son dimensiones de capacidad diferentes, así que conviene elegir el modelo según el tipo de tarea que vayas a hacer.
Cómo volver a probar Carbon, Opus y Astra por tu cuenta con la API
La prueba puntual de otra persona solo sirve como punto de partida. Lo más fiable es ejecutar los modelos con tus propias tareas. El siguiente ejemplo usa una interfaz compatible con OpenAI para enviar la misma indicación a varios modelos, uno tras otro, y registrar el tiempo de respuesta y el consumo de tokens. Ten en cuenta que así solo se mide la fase en la que el modelo genera código directamente. No incluye las múltiples rondas de invocación de herramientas ni la autoverificación en el navegador que hacían Antigravity, Claude Code y Codex en la evaluación original.
Ejemplo mínimo
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

resp = client.chat.completions.create(
    model="your-model-id",  # Usa el nombre real que aparezca en la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "输出一个单文件 HTML 食品品牌官网首屏,米白背景、居中悬浮产品罐头、酒红色弧形背景"}]
)
print(resp.choices[0].message.content[:500])
print(resp.usage)  # Consulta los tokens de entrada y salida
Ver el script completo de repetición de la misma prueba con varios modelos
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una sola clave para invocar modelos de varios proveedores
)

# El ID del modelo debe coincidir con la lista de modelos de la plataforma; el precio es en "dólares / millón de tokens", rellénalo según la página oficial de precios
MODELS = {
    "model-a": {"input_price": 0.0, "output_price": 0.0},
    "model-b": {"input_price": 0.0, "output_price": 0.0},
    "model-c": {"input_price": 0.0, "output_price": 0.0},
}

PROMPT = """请复刻一个食品品牌官网首屏,输出单文件 HTML:
1. 米白色背景,中央悬浮产品罐头,酒红色弧形背景,橙色环绕文字;
2. 顶部包含品牌标志、语言切换和菜单按钮;
3. 罐头支持鼠标拖动旋转,悬停时有缩放反馈;
4. 同时适配 1440x900 和 390x844 两种尺寸。
只输出完整代码。"""

def run(model: str, price: dict) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": PROMPT}],
    )
    elapsed = time.time() - start
    usage = resp.usage
    cost = (usage.prompt_tokens * price["input_price"]
            + usage.completion_tokens * price["output_price"]) / 1_000_000
    html = resp.choices[0].message.content
    with open(f"{model}.html", "w", encoding="utf-8") as f:
        f.write(html)
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "input_tokens": usage.prompt_tokens,
        "output_tokens": usage.completion_tokens,
        "api_equivalent_cost": round(cost, 4),
    }

if __name__ == "__main__":
    for name, price in MODELS.items():
        try:
            print(run(name, price))
        except Exception as e:
            print(name, "调用失败:", e)
Cuando termine el script, tendrás un archivo HTML por cada modelo. Después, sigue la lista de cuatro pasos de la segunda ronda y revisa en el navegador, uno por uno, el diseño, la interacción y los errores de consola; luego combina esos resultados con el tiempo de respuesta y el coste equivalente para sacar conclusiones. Para reducir la variación de una sola ejecución, te recomendamos correr cada modelo al menos tres veces.
🚀 Recomendación para empezar rápido: cuando haces comparativas con el mismo prompt, lo más engorroso suele ser pedir claves por separado a cada proveedor y adaptar distintos SDK. Te sugerimos hacerlo a través de APIYI (apiyi.com): con una sola clave API puedes invocar OpenAI, Claude, Gemini y otros modelos principales, con una interfaz compatible con OpenAI. Además, los usuarios nuevos tienen crédito de prueba gratuito, ideal para validar el flujo de comparación con una muestra pequeña.
Recomendaciones por escenario y consejos de decisión: Carbon, Opus y Astra
Combinando esta prueba con los datos de los rankings, se puede hacer una primera selección según el objetivo de desarrollo. En la columna «Fundamento» de la tabla siguiente intentamos indicar el tipo de fuente, para que puedas valorar cuánto peso darle a cada dato.
| Objetivo de desarrollo | Primera opción | Fundamento | Cómo validarlo |
|---|---|---|---|
| Sensible al costo de invocación, con mucha exploración e iteración | Gemini 4 Carbon | Costo equivalente en API más bajo de esta prueba (datos medidos) | Comparar el costo acumulado en varias rondas de tareas pequeñas |
| Prioriza la fidelidad visual, las interacciones complejas y un acabado alto | Claude Opus 5.5 | Mejor de los tres según la valoración subjetiva del autor; lidera en ambos rankings | Revisión pantalla por pantalla de la fidelidad y validación de las interacciones |
| Prioriza la velocidad de entrega y la eficiencia de ejecución | GPT-6 Astra | Menor tiempo de esta prueba (datos medidos) | Cronometrar la misma tarea + validación de calidad |
| No sabes cuál elegir y quieres hacerte una idea inicial | Repetir la prueba con los tres usando una muestra pequeña y la misma tarea | Una sola prueba no basta para sacar conclusiones | Comparación por lotes con la interfaz unificada de APIYI (apiyi.com) |
Cuándo elegir Carbon
- Fase de exploración de prototipos: cuando necesitas probar rápido varias propuestas de página, un costo bajo por ejecución significa que puedes lanzar más rondas.
- Proyectos personales o equipos con presupuesto limitado: siempre que la calidad sea aceptable, a largo plazo la diferencia en el gasto de invocación se nota mucho.
- Desarrollo principal + revisión humana: genera la primera versión con Carbon y deja que una persona u otro modelo haga la revisión final.
Cuándo elegir Opus
- Webs corporativas de marca y landing pages de marketing: si se exige mucha fidelidad visual y cuidado en los detalles, el costo de rehacer el trabajo supera al de la invocación.
- Páginas con interacciones complejas: cuando hay muchas visualizaciones 3D, arrastres o animaciones controladas por el scroll, importa más el nivel de acabado final.
Cuándo elegir Astra
- Plazos de entrega ajustados: necesitas una página completa y funcional en poco tiempo.
- Importancia del proceso de QA del frontend: el fabricante destaca la revisión de calidad posterior a la generación, así que encaja bien si quieres delegar la fase de validación en el flujo de trabajo.
💡 Consejo para elegir: esta prueba ofrece una observación comparativa de un flujo de trabajo real, no un ranking absoluto. El criterio final debería ser este: con tus propias tareas, cuál de las opciones funcionó de verdad y cuánto dinero y tiempo costó. Te recomendamos hacer una repetición a pequeña escala con la misma indicación a través de APIYI (apiyi.com) y, después, decidir cuál será tu modelo principal.
Preguntas frecuentes (FAQ)
Q1: ¿Qué se compara exactamente en la prueba de Carbon, Opus y Astra con el mismo sitio web?
Se compara la capacidad de tres flujos de trabajo «modelo + herramienta de desarrollo» para replicar el sitio oficial de Agrumea Farm: estructura de la página, estilo visual, carrusel 3D de latas, desplazamiento y arrastre, animaciones de carga y hover, transiciones entre páginas y diseño responsive. Mide la fidelidad al diseño original, no el gusto estético propio.
Q2: ¿Por qué Carbon es el más barato pero el autor de la evaluación lo coloca en último lugar?
El costo y la calidad son dos dimensiones independientes. Carbon usa menos tokens de entrada y tiene el costo equivalente más bajo, pero en las capturas se ve que sus latas son algo pequeñas y algunos detalles del texto quedan flojos, así que con el criterio de «fidelidad» no sale bien parado. Que sea barato no significa que sea malo; simplemente, en esta tarea de réplica, el autor valoró más el nivel de acabado de Opus.
Q3: ¿Cuándo se hizo esta prueba? ¿Puede quedarse desactualizada?
La evaluación se publicó el 11 de noviembre de 2026. Las pruebas de Opus y Astra se completaron el 6 de noviembre, y la de Carbon entre el 10 y el 11 de noviembre, justo cuando Carbon amplió su acceso el 10 de noviembre. Los modelos y las herramientas evolucionan muy rápido, así que conviene tomar las conclusiones como una referencia del momento actual.
Q4: ¿Qué diferencia hay entre el costo equivalente por API y el costo de suscripción?
El costo equivalente por API es una estimación basada en el uso de tokens y en el precio unitario de la API; refleja el consumo real del modelo. La suscripción es un precio mensual fijo, que se calcula según la cuota y las reglas de renovación. Para una misma tarea, una herramienta con suscripción mensual puede consumir solo parte de la cuota, mientras que la invocación por uso genera directamente una factura. Al elegir, conviene calcularlo según tu forma real de facturación.
Q5: ¿Cómo comparar rápidamente con una API el resultado en desarrollo web de estos tres tipos de modelos?
Puedes seguir el script de repetición de la prueba de este artículo:
1. Regístrate en APIYI (apiyi.com) y obtén tu clave API y la cuota de prueba gratuita.
2. Configura `base_url` como `https://api.apiyi.com/v1` y confirma en la lista de modelos de la plataforma los nombres de los modelos que quieres comparar.
3. Llama a cada modelo con la misma indicación, registra el tiempo y el uso de tokens, y luego revisa en el navegador las páginas generadas.
Q6: ¿Se puede reproducir el resultado de la evaluación original con una sola llamada a la API?
No del todo. La evaluación original se ejecutó en Antigravity, Claude Code y Codex, con varias rondas de lectura y escritura de archivos y autoverificación en el navegador, y en todos los casos tardó más de una hora. Una sola llamada mide únicamente la capacidad del modelo para generar código directamente, y sirve como filtro inicial; para acercarse a la prueba original hace falta montar un flujo de agente con verificación en el navegador.
Q7: ¿Qué limitaciones tiene esta prueba?
Principalmente tres: cada modelo se ejecutó una sola vez, así que hay margen de azar; las herramientas y las fechas de prueba son distintas en cada caso, por lo que no se puede aislar el modelo en sí; y el ranking proviene de la valoración subjetiva del autor. Además, las capturas estáticas no demuestran que la interacción esté completamente implementada. Por eso sirve como caso de referencia, pero no debe tomarse directamente como un ranking general.
Carbon, Opus y Astra: puntos clave (Key Takeaways)
- Naturaleza de la prueba: se ejecutó una vez cada uno de los tres flujos de trabajo sobre la misma tarea de replicar una web oficial. Es una observación comparativa en un escenario real.
- Fidelidad del diseño: el autor valora más a Opus, después a Astra, y deja a Carbon en último lugar.
- Velocidad: Astra fue la más rápida, con 68 minutos, aproximadamente la mitad que Opus.
- Coste: el coste equivalente de Carbon fue de 10,86 USD, cerca del 18 % del de Opus y el 12 % del de Astra.
- Estructura del coste: el desarrollo con agentes consume sobre todo tokens de entrada, así que el precio unitario y las reglas de caché también determinan la factura.
- Rankings de referencia: Opus lidera tanto en Arena WebDev como en la clasificación general de DesignArena, aunque cada ranking usa criterios distintos.
- Cómo empezar: con APIYI (apiyi.com) puedes repetir la misma tarea en pequeña escala con una sola clave y decidir después cuál será tu modelo principal.
Conclusión
Tras comparar Carbon, Opus y Astra construyendo el mismo sitio web, hay tres conclusiones principales:
- Resultado: en esta tarea de replicación, el trabajo de Opus recibió la mejor valoración del autor de la evaluación, con un producto principal y una jerarquía visual más destacados.
- Velocidad: Astra terminó la tarea en solo 68 minutos, lo que la hace ideal para proyectos con plazos de entrega ajustados.
- Coste: el coste equivalente en API de Carbon es muy inferior al de los otros dos, así que encaja bien en iteraciones frecuentes y en escenarios sensibles al presupuesto.
Los tres modelos ya son capaces de desarrollar páginas web de alta calidad; la diferencia está en el equilibrio entre fidelidad visual, implementación de la interacción, tiempo y coste. En lugar de preguntarte cuál es el mejor en términos absolutos, conviene definir con claridad tu objetivo de desarrollo y probarlos tú mismo con la misma tarea. Te recomendamos usar APIYI (apiyi.com) para repetir la prueba con varios modelos a través de una interfaz unificada, y basar tu elección final en los resultados que realmente funcionen y en lo que hayas gastado.
📚 Referencias
- Gemini 4 Carbon: No-Hype Full Review & Testing: reseña de Pat Simmons / AI for Mortals en la que se replica el mismo sitio web con cada modelo, 2026-11-11
- Enlace:
aiformortals.co/blog/gemini-4-carbon-review -
Nota: fuente principal de la configuración de las pruebas, los tiempos, los tokens y los costes equivalentes en API que aparecen en este artículo
-
Las tres páginas de las réplicas: trabajos públicos de Carbon, Opus 5.5 y Astra
- Enlaces:
aiformortals.co/builds/agrumea-clone-gemini-4-carbon,aiformortals.co/builds/agrumea-clone-opus-5-5,aiformortals.co/builds/agrumea-clone-gpt-6-astra -
Nota: puedes comprobar los efectos de interacción directamente en el navegador
-
Sitio oficial de Agrumea Farm: el sitio original usado como objeto de prueba
- Enlace:
agrumeafarm.it/en -
Nota: sirve para comparar el grado de fidelidad de las réplicas
-
Clasificación Arena WebDev: ranking de votaciones en enfrentamientos de desarrollo web
- Enlace:
arena.ai/leaderboard/code/webdev -
Nota: el artículo cita los datos del 2026-11-10
-
Clasificación DesignArena: ranking agéntico integral de diseño
- Enlace:
designarena.ai/leaderboard -
Nota: el artículo cita los datos del 2026-11-11, que abarcan varios tipos de tareas de diseño
-
Blog oficial de Google: anuncio de disponibilidad abierta de Gemini 4 Carbon
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ -
Nota: posicionamiento oficial de Carbon en diseño frontend y verificación en el navegador
-
Presentación oficial de OpenAI: GPT-6 Astra
- Enlace:
openai.com/index/gpt-6-astra/ -
Nota: descripción de los flujos de trabajo de Astra para desarrollo web y QA frontend
-
Prueba de Woofocus: comparativa de diseño web con distintos modelos Claude, 2026-10-24
- Enlace:
app.woofocus.com/blog/best-claude-model-for-web-design - Nota: referencia complementaria sobre las tareas de diseño y modificación de Opus 5.5; no es una comparación directa entre los tres modelos
Autor: equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos desde la página de inicio de APIYI; encontrarás más material de integración en el centro de documentación docs.apiyi.com