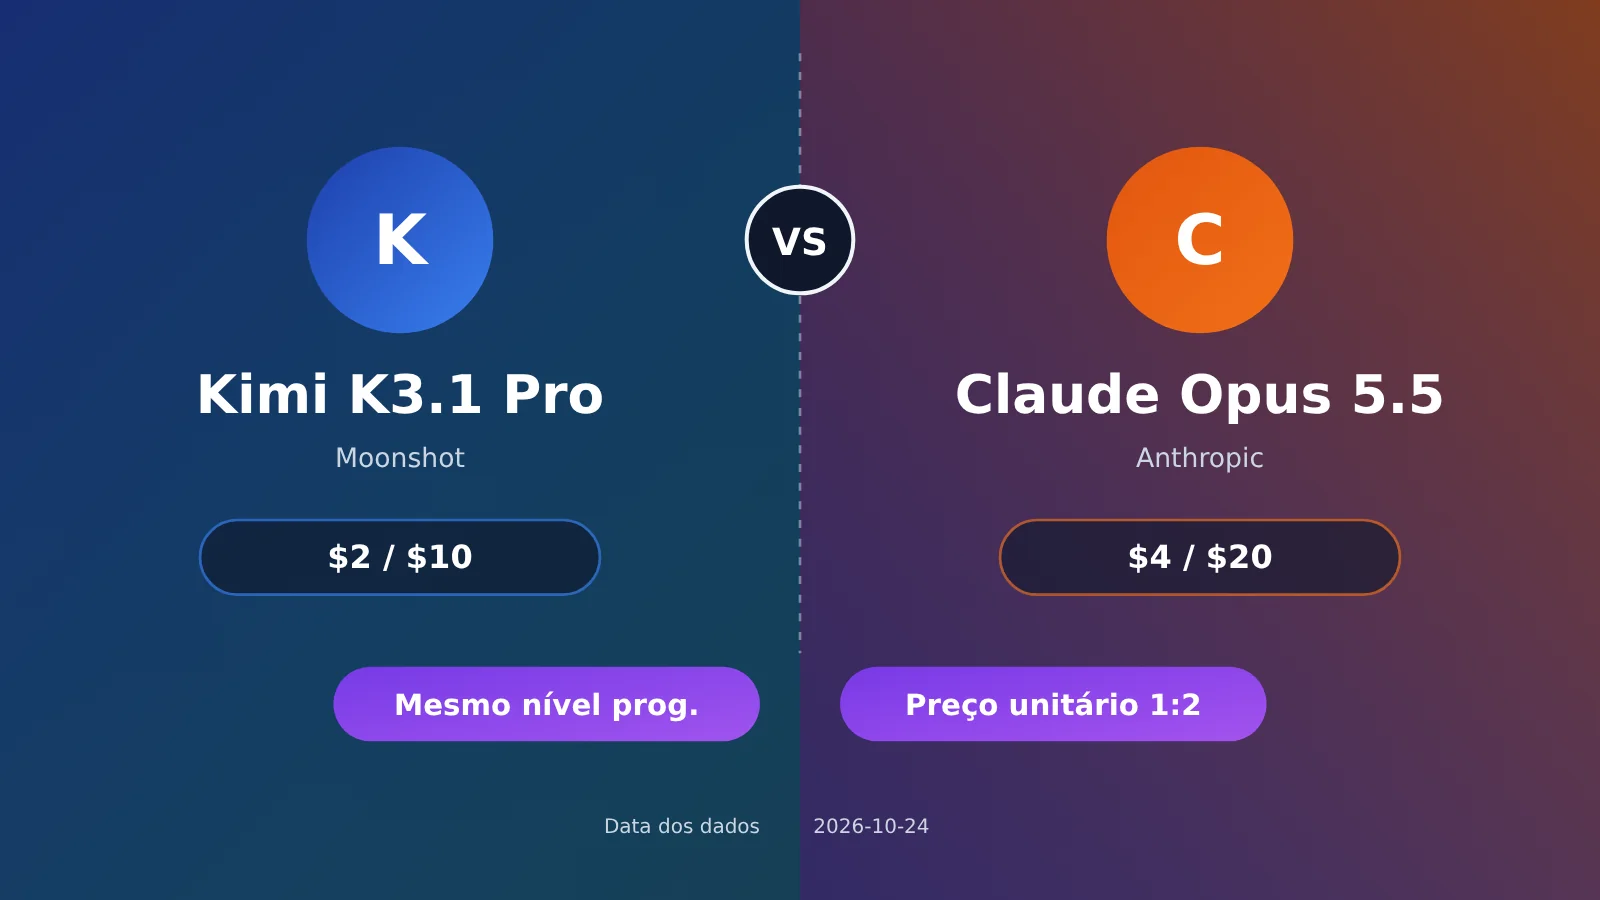
Em resumo: Kimi K3.1 Pro e Claude Opus 5.5 estão no mesmo nível em programação. Nos resultados do Terminal-Bench 4.0 divulgados pela própria Moonshot, o K3.1 Pro marcou 65,7%, enquanto o Opus 5.5 chegou a 66,4% — uma diferença de cerca de 0,7 ponto percentual. Já na avaliação de terceiros da Artificial Analysis, considerando apenas o Terminal-Bench 4.0, o K3.1 Pro ficou em primeiro lugar. Em termos de preço, os valores por token de entrada e de saída do K3.1 Pro são exatamente metade dos cobrados pelo Opus 5.5 (US$ 2/US$ 10 contra US$ 4/US$ 20), mas o preço por tokens em cache é igual nos dois. Como o K3.1 Pro leva mais tempo para pensar, no entanto, as estimativas de terceiros indicam que o custo real por tarefa não chega a ser metade.
Todas as informações a seguir indicam a fonte e estão divididas em três categorias: dados divulgados pela própria empresa (blog da Moonshot e documentação oficial da Kimi e da Anthropic), dados de terceiros (Artificial Analysis, chamada de AA daqui em diante) e não verificados (não há dados públicos no momento; só é possível fazer uma avaliação indicativa). Neste artigo, “token” pode ser entendido como a unidade de texto usada para calcular o custo do modelo. Cada caractere chinês corresponde, em média, a pouco mais de 1 token. Todos os preços são apresentados em dólares por milhão de tokens.
Este artigo não vai dizer que um modelo “dá uma surra” no outro. Cada modelo tem seus pontos fortes e fracos. Vamos comparar os dados usando os mesmos critérios e, em seguida, recomendar qual escolher para diferentes situações.
O principal benefício: ao terminar a leitura, você vai saber se deve usar o Kimi K3.1 Pro ou o Claude Opus 5.5 para suas tarefas, além de entender a diferença real de custo entre os dois.
1. Principais diferenças entre Kimi K3.1 Pro e Claude Opus 5.5
Para começar, veja uma tabela com as diferenças mais importantes. Nas próximas seções, vamos analisar cada uma delas em detalhes. A coluna “Nível da fonte” indica de onde veio cada dado, para você poder conferir por conta própria.
| Critério de comparação | Kimi K3.1 Pro | Claude Opus 5.5 | Nível da fonte |
|---|---|---|---|
| Terminal-Bench 4.0 (dados oficiais) | 65,7% | 66,4% | Divulgado pela própria empresa (blog da Moonshot) |
| Terminal-Bench 4.0 (dados da AA) | 67%, maior resultado entre os modelos avaliados pela AA | Não informado nas fontes consultadas | Terceiros (AA) |
| Preço por tokens de entrada/saída | US$ 2 / US$ 10 | US$ 4 / US$ 20 | Preços oficiais |
| Preço para tokens em cache | US$ 0,20 | US$ 0,20 | Preços oficiais |
| Tamanho da janela de contexto | 1.048.576 tokens | Até 1 milhão, dependendo do modelo | Documentação oficial |
| É possível desativar o modo de raciocínio? | Não; só dá para ajustar a intensidade | Consulte a documentação da Anthropic | Documentação oficial / não verificado |
| Pesos abertos | Compromisso de disponibilizá-los até 04/11/2026 | Não são abertos | Divulgado pela própria empresa |
“Janela de contexto” é a quantidade total de conteúdo que o modelo consegue processar de uma só vez. Ambos têm janelas na faixa de 1 milhão de tokens, o que permite inserir praticamente todo o código de um repositório de médio porte de uma vez. Por isso, esse critério não costuma ser decisivo na hora de escolher entre eles.
2. Comparação de preços entre Kimi K3.1 Pro e Claude Opus 5.5: preços lado a lado em 5 categorias
Antes, vamos explicar dois termos de cobrança. Acerto de cache: quando você envia repetidamente o mesmo trecho inicial (como um comando de sistema ou um resumo de um repositório de código), o provedor do modelo o armazena e cobra um valor bem menor quando ele é lido novamente. Gravação em cache: é o valor cobrado na primeira vez que esse conteúdo é armazenado. O preço varia conforme o período de armazenamento: 5 minutos ou 1 hora.
| Modelo | Entrada | Saída | Acerto de cache | Gravação em cache por 5 minutos | Gravação em cache por 1 hora |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (referência) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
Sobre os preços: dados coletados em 24/10/2026. Valores em dólares por milhão de tokens, sem impostos. Fontes: tabelas oficiais de preços da Kimi e da Anthropic.
2.1 Diferença de preço: entrada e saída custam 2 vezes mais; acerto de cache custa o mesmo
Nos preços de entrada e saída, o Opus 5.5 custa exatamente o dobro do K3.1 Pro. Já o preço por acerto de cache é igual nos dois: $0.20. Na gravação em cache, a Kimi sai mais em conta: $2 contra $5 no período de 5 minutos e $4 contra $8 no de 1 hora.
Usando o Claude Sonnet 5.5 como referência, dá para ver que os preços de entrada e saída são exatamente iguais aos do K3.1 Pro, enquanto o preço por acerto de cache é metade ($0.10). Portanto, se você está procurando uma opção de ponta mais barata, o concorrente direto do Kimi é, na verdade, o Sonnet 5.5 — não apenas o Opus 5.5.
2.2 As duas empresas oferecem uma versão de alta velocidade
As duas empresas oferecem versões mais rápidas e mais caras. Na hora de comparar as opções, confira se está usando a versão certa:
kimi-k3.1-pro-highspeed: $4 / $20, acerto de cache por $0.20, gravação em cache por 5 minutos por $4 e por 1 hora por $8 (preços oficiais)- Modo Fast do Claude Opus 5.5: $8 / $40, disponível para toda a janela de contexto, inclusive para trechos acima de 200 mil tokens (preços oficiais)
Como dá para ver, os preços de entrada e saída da versão de alta velocidade da Kimi são iguais aos do Opus 5.5 padrão, mas a gravação em cache por 5 minutos ainda custa menos.
3. Kimi K3.1 Pro vs. Claude Opus 5.5 em programação: duas métricas para analisar separadamente
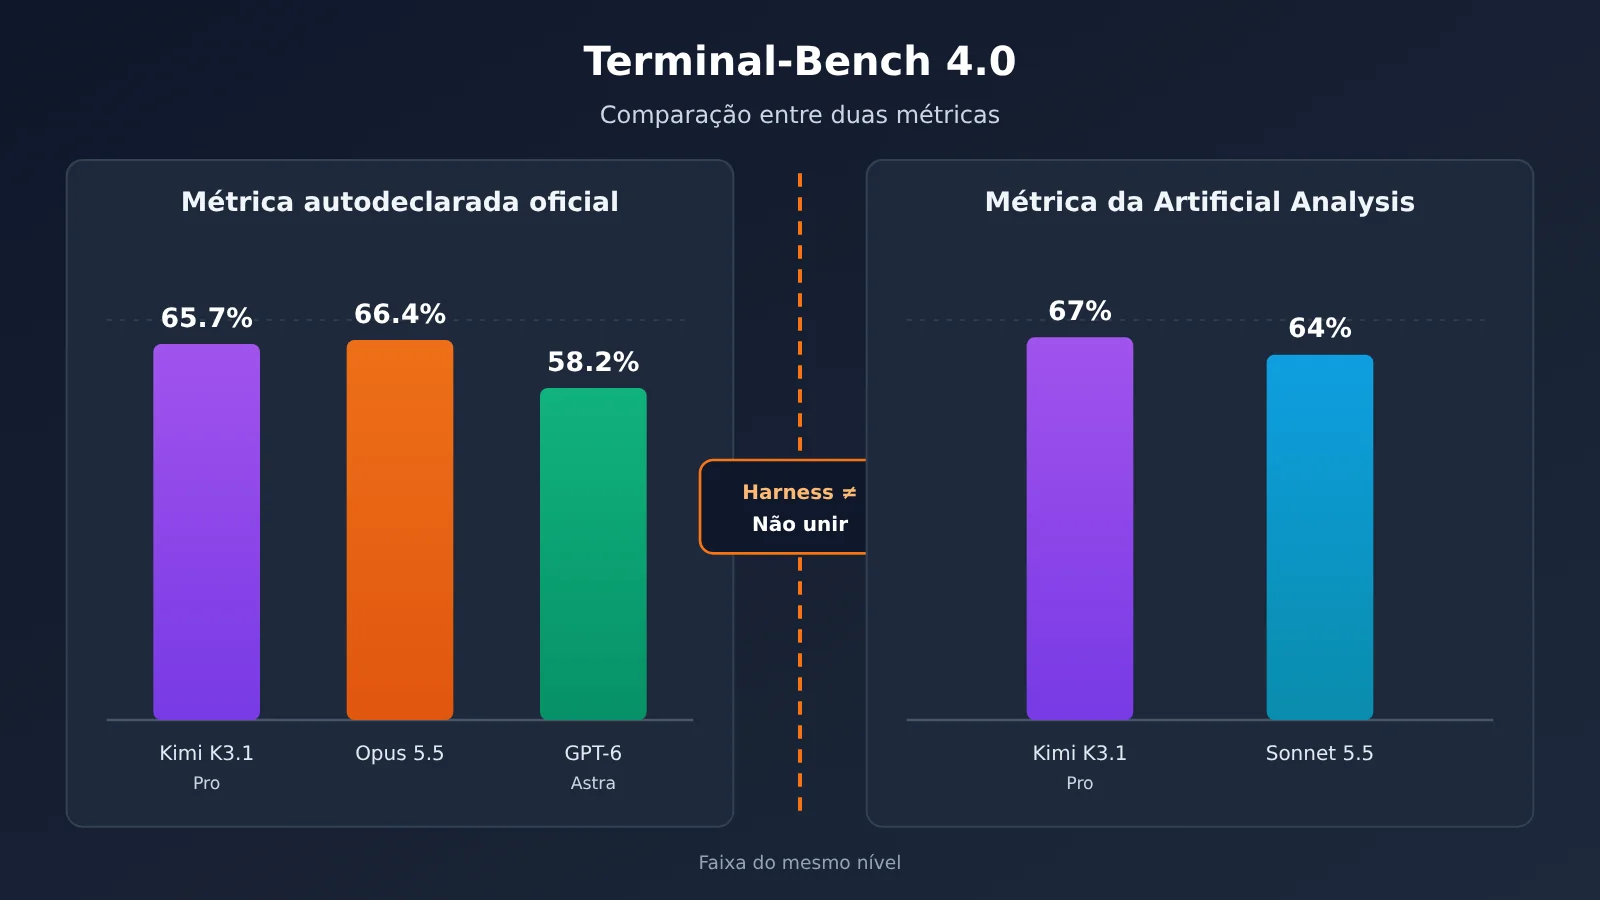
O Terminal-Bench 4.0 é um conjunto de testes que avalia a execução de tarefas reais no terminal, como instalar dependências, corrigir bugs e executar scripts. Para passar, é preciso chegar ao resultado correto. As duas tabelas abaixo vêm de instituições diferentes; por isso, os números não podem ser comparados entre si.
3.1 Métricas divulgadas pela própria empresa (blog da Moonshot)
| Item de teste | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD (reconstrução 3D com código CAD gerado a partir de múltiplas vistas) | 92.7% (com ferramentas) | 96.2% | — |
Nas condições do teste, reasoning_effort foi definido como max (ou seja, a intensidade de raciocínio foi ajustada para o nível máximo), e o K3.1 Pro foi executado com o harness do Claude Code. No blog, a própria Moonshot descreve o resultado como “um pouco abaixo do Claude Opus 5.5”.
3.2 Dados de terceiros (Artificial Analysis, 2026-10-23)
| Item de teste | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (índice geral de inteligência) | 55 (4º lugar) | 58 | 56 |
| Terminal-Bench 4.0 | 67% (maior resultado geral) | Não consta nas referências | 64% |
| GDPval-AA (Elo) | 1846 (3º lugar) | 1866 | — |
| AA-Omniscience (confiabilidade do conhecimento) | índice 30, taxa de alucinação de 44% | Não consta nas referências | — |
O índice geral do Opus 5.5 foi medido na condição “max with fallback”. O Muse Wonder Full, que aparece no mesmo ranking, também marcou 56 pontos. Elo é um algoritmo parecido com o sistema de pontuação do xadrez, que calcula os resultados a partir de comparações entre pares. Quanto maior a pontuação, melhor. A taxa de alucinação pode ser entendida, de forma simples, como a proporção de vezes em que o modelo inventa uma resposta quando não sabe responder. Os 44% do K3.1 Pro nesse quesito merecem atenção.
3.3 Por que não dá para misturar os resultados das duas metodologias
Os resultados do K3.1 Pro no Terminal-Bench 4.0 foram de 65,7% na metodologia oficial e 67% na da AA, mas os testes usaram harnesses diferentes. O harness pode ser entendido como o “programa que envolve o modelo durante a prova”: ele determina quais ferramentas o modelo pode usar, como lê e grava arquivos e quanto tempo tem antes de atingir o limite. Se essa estrutura muda, a pontuação do mesmo modelo também pode mudar.
Por isso, não dá para dizer: “O K3.1 Pro fez 67% na AA, mais do que os 66,4% do Opus na metodologia oficial”. A leitura correta é: na metodologia oficial, o K3.1 Pro ficou 0,7 ponto percentual abaixo; na metodologia da AA, teve o maior resultado entre os modelos avaliados pela instituição. As duas conclusões são válidas dentro de suas respectivas metodologias. Juntas, elas só indicam que os dois modelos estão em uma faixa de desempenho semelhante.
3.4 O que uma diferença de 1 ponto na pontuação significa no desenvolvimento do dia a dia
O Terminal-Bench 4.0 usa uma avaliação rigorosa por tarefa: o resultado é aprovado ou reprovado. Um ponto percentual equivale, aproximadamente, a acertar ou errar uma tarefa a mais a cada cem. Essas diferenças costumam aparecer em tarefas raras, como as que envolvem ferramentas pouco usadas ou configurações de ambiente específicas. No dia a dia, ao criar endpoints, alterar código de negócio ou adicionar testes unitários, é difícil perceber uma diferença tão pequena.
O que realmente afeta a experiência de desenvolvimento são duas diferenças de “personalidade”. A primeira é o estilo de raciocínio: o K3.1 Pro está sempre no modo de raciocínio, e a AA observou que as respostas dele são mais longas em cada tarefa (fonte terceirizada). A segunda é o hábito de usar ferramentas — por exemplo, com que frequência o modelo executa comandos e se tende a ler os arquivos antes de modificá-los. No momento, não há dados públicos confiáveis para fazer uma comparação nesse aspecto (não verificado). O ideal é testar alguns casos reais no seu próprio repositório.
4. Vantagens e desvantagens do Kimi K3.1 Pro e do Claude Opus 5.5
Vantagens do Kimi K3.1 Pro (documentação oficial):
- Os preços de entrada e saída são metade dos do Opus 5.5, e a gravação em cache também custa menos.
- Janela de contexto de 1.048.576 tokens; o valor padrão de
max_completion_tokensé 131072, com máximo de 1048576. - Compatível com os formatos de API da OpenAI e da Anthropic. A recomendação oficial é usá-lo em agentes de programação como Kimi Code, Codex e Claude Code.
- Oferece saída estruturada, chamada de ferramentas e continuação com
partial. Clientes da API podem optar pela retenção zero de dados, e a empresa promete disponibilizar os pesos completos até 2026-11-04.
Limitações do Kimi K3.1 Pro (documentação oficial + fontes terceirizadas):
- Não é possível desativar o raciocínio.
reasoning_effortsó pode ser definido comolow,highoumax; o padrão émax. temperatureé fixo em 1.0 etop_p, em 0.95. Não é possível enviar outros valores para esses parâmetros.- A entrada de imagens não aceita URLs públicas: só é possível enviar imagens codificadas em base64 (convertidas em uma longa sequência de texto) ou usar
ms://file-id. - A AA mediu uma taxa de alucinação de 44%, e as respostas tendem a ser longas mesmo em tarefas individuais.
Vantagens do Claude Opus 5.5: fica à frente tanto nos benchmarks oficiais quanto no índice geral da AA. No BenchCAD, lidera por cerca de 3,5 pontos percentuais, e também tem uma pontuação maior no GDPval-AA. Oferece cache de uma hora e o modo Fast, permitindo ajustar o equilíbrio entre velocidade e custo conforme a necessidade. Sua principal limitação é o preço: entrada e saída custam o dobro do K3.1 Pro, e o modo Fast dobra esse valor novamente.
5. Kimi K3.1 Pro vs Claude Opus 5.5: qual escolher para 6 tipos de tarefa
“Agent” é um aplicativo de modelo capaz de planejar etapas por conta própria, usar ferramentas e executar tarefas em várias rodadas — por exemplo, um assistente de programação que altera o código automaticamente e depois roda os testes.
| Tipo de tarefa | Recomendação | Conclusão em uma frase |
|---|---|---|
| Tarefas offline em grande escala | Kimi K3.1 Pro | Custa metade do preço, e a gravação em cache também é mais barata. A economia é mais evidente em tarefas em lote. |
| Agent de programação com várias rodadas | Os dois servem; vale fazer testes práticos | Os resultados em benchmarks estão no mesmo nível. A escolha depende principalmente de como o comprimento do raciocínio e o uso de ferramentas se encaixam no seu repositório. |
| Geração de código 3D / CAD | Claude Opus 5.5 | Segundo dados divulgados pela própria empresa, o resultado no BenchCAD é de 96,2% contra 92,7%; o Opus 5.5 é mais consistente. |
| Compreensão de imagens | Escolha conforme a forma de integração | O K3.1 Pro aceita imagens, mas não permite enviar diretamente um URL público. Não há dados comparáveis sobre a capacidade de imagem dos dois modelos (não verificado). |
| Cenários empresariais com requisitos de estabilidade e conformidade | Tendência para Claude Opus 5.5; considere o Kimi se precisar de controle de dados | O Opus 5.5 tem um índice geral mais alto. O Kimi oferece retenção zero de dados e deve disponibilizar os pesos em breve. |
| Cenários de baixa latência que exigem desativar o raciocínio | Claude | Não é possível desativar o raciocínio no K3.1 Pro. Para as configurações de raciocínio do Claude, consulte a documentação da Anthropic. Também vale considerar o modo Fast. |
6. Kimi K3.1 Pro vs. Claude Opus 5.5: fazendo as contas — metade do preço por token não significa metade do custo
Vamos fazer uma conta simples: a mesma solicitação, com 50 mil tokens de entrada e 5 mil tokens de saída.
- Kimi K3.1 Pro: 50 mil × US$ 2 ÷ 1 milhão + 5 mil × US$ 10 ÷ 1 milhão = US$ 0,10 + US$ 0,05 = US$ 0,15
- Claude Opus 5.5: 50 mil × US$ 4 ÷ 1 milhão + 5 mil × US$ 20 ÷ 1 milhão = US$ 0,20 + US$ 0,10 = US$ 0,30
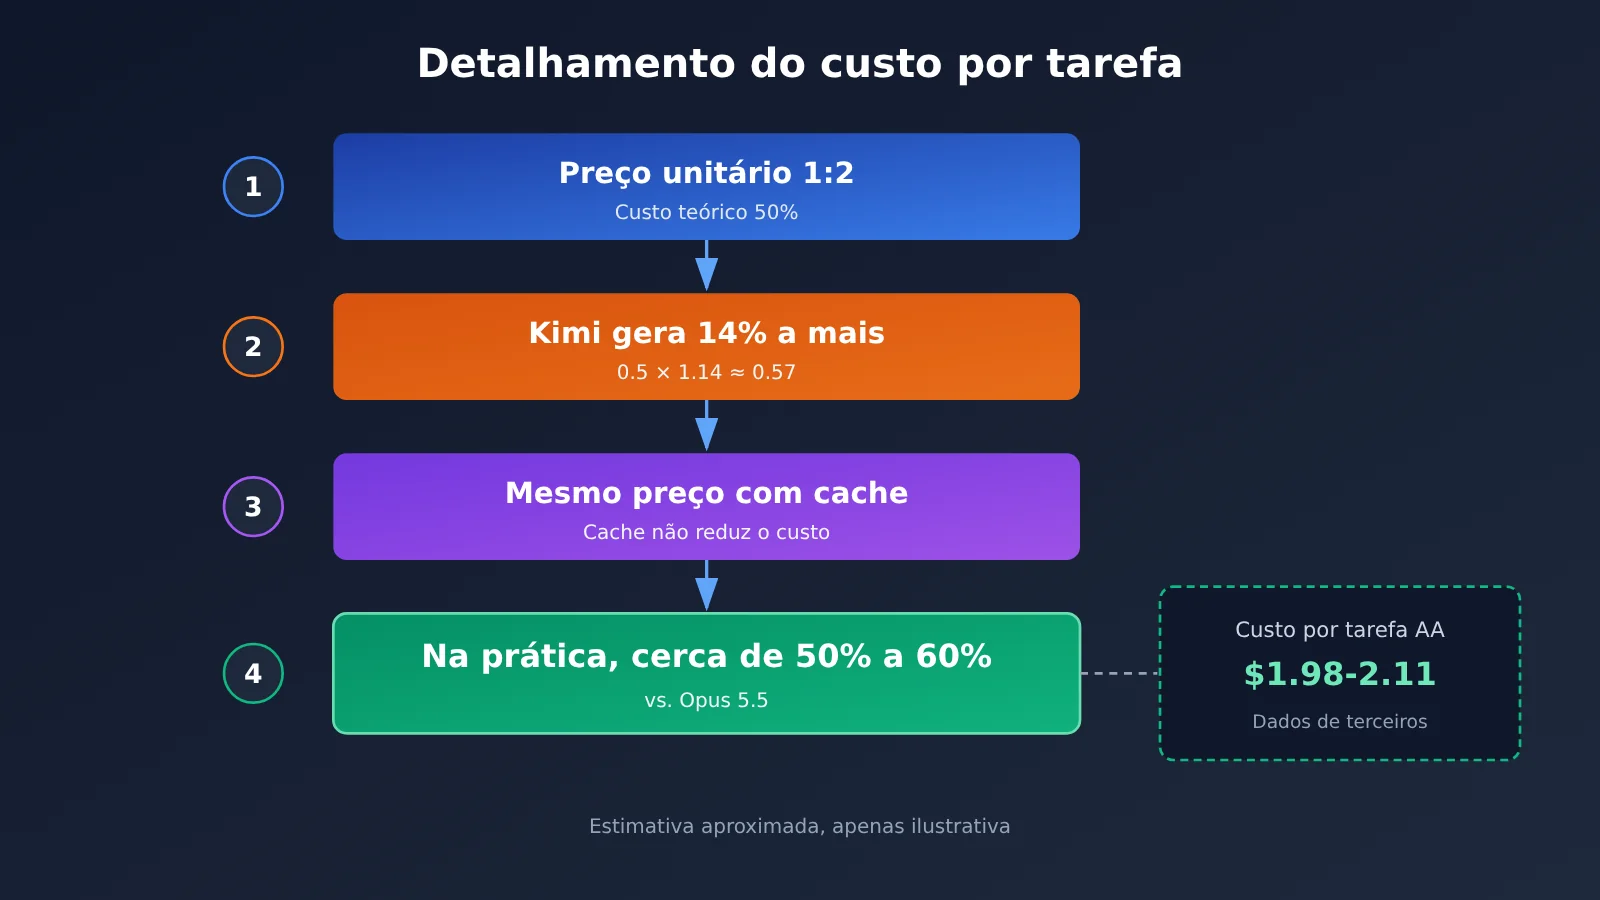
Pelo preço por token, o Kimi custa exatamente a metade. Mas essa conta parte de uma premissa: os dois modelos geram saídas do mesmo tamanho. Na prática, não é bem assim. Segundo os dados da AA, o Kimi gera cerca de 14% mais tokens por tarefa, com uma média de aproximadamente 55 mil tokens de saída por tarefa e custo de cerca de US$ 1,98 por tarefa (US$ 2,11 na página do modelo) (fonte de terceiros). A conclusão da AA é que, embora o preço por token do Kimi seja metade do Opus 5.5, suas respostas tendem a ser mais prolixas. Por isso, o custo real por tarefa não chega a ser metade.
Fazendo uma estimativa aproximada (não verificada; serve apenas como exemplo): como o custo de tarefas de agentes de programação vem principalmente da saída, se o Kimi gerar 14% mais tokens, o gasto com a saída será cerca de 1,14 × 0,5 ≈ 57% do gasto com o Opus 5.5. Isso representa uma economia de pouco mais de 40%, não de 50%. Ainda assim, é uma economia considerável — só não conte com metade do custo ao planejar o orçamento.
7. Como usar Kimi K3.1 Pro e Claude Opus 5.5 na China
Desenvolvedores na China que integram diretamente as APIs oficiais no exterior costumam enfrentar problemas com pagamentos e conexão de rede. A APIYI (apiyi.com) é uma plataforma que reúne APIs de vários modelos. Com uma única chave API, você pode acessar diferentes modelos. A interface é compatível com o formato OpenAI, e a cobrança é feita por uso. Na verificação de 24/10/2026, os preços de claude-opus-5-5 na plataforma eram de US$ 4 para entrada, US$ 20 para saída e US$ 0,2 para leitura de cache. Já claude-sonnet-5-5 custava US$ 2 / US$ 10 / US$ 0,1. Ambos seguem os mesmos preços oficiais da Anthropic. Os modelos da linha Kimi disponíveis atualmente são:
kimi-k3: US$ 3 / US$ 15, com leitura de cache a US$ 0,3kimi-k2.7-code: US$ 0,95 / US$ 3,99kimi-k2.6: US$ 0,6 / US$ 2,4kimi-k2.5: US$ 0,6 / US$ 3,15
Naquele dia, kimi-k3.1-pro ainda não estava na lista. Consulte a lista de modelos da APIYI para ver o nome e o preço desse modelo na plataforma. Vamos disponibilizá-lo em breve. Para integrar:
- Formato compatível com OpenAI: defina
base_urlcomohttps://api.apiyi.com/v1 - Formato Anthropic: defina o endereço base como
https://api.apiyi.com - Agentes de programação, como o Claude Code, geralmente usam o formato Anthropic; SDKs comuns usam o formato OpenAI
Sugestão para começar rapidamente: você pode usar primeiro os créditos gratuitos para novos usuários da APIYI em apiyi.com e testar
claude-opus-5-5eclaude-sonnet-5-5com algumas tarefas reais no seu próprio repositório, usando os resultados como referência para comparação. Consulte a lista de modelos da plataforma para conferir os modelos e preços. Vamos disponibilizar o Kimi K3.1 Pro em breve; quando ele estiver disponível, basta trocar o nome do modelo para fazer a comparação.
8. Kimi K3.1 Pro vs. Claude Opus 5.5: recomendações para decidir
Se você tem um grande volume de tarefas, precisa controlar o orçamento e aceita deixar o modelo pensando o tempo todo, o Kimi K3.1 Pro oferece um custo-benefício melhor. Se a prioridade é a estabilidade geral, você precisa gerar conteúdo 3D/CAD ou quer desativar o modo de raciocínio para reduzir a latência, os modelos da Claude — Opus 5.5 ou Sonnet 5.5 — são mais adequados. Para agentes de programação que trabalham em várias etapas, os dois têm resultados semelhantes nos benchmarks. Em vez de se basear nas classificações, vale mais a pena testar cada um com seu próprio repositório durante uma semana.
Há ainda uma opção que pode passar despercebida: se o principal motivo para considerar o Kimi é o preço “pela metade”, o Claude Sonnet 5.5 tem exatamente os mesmos preços por token de entrada e saída, custa menos quando há acerto de cache e tem um índice geral AA ligeiramente superior. Vale incluí-lo na lista de opções.
Perguntas frequentes
P1: Qual é a diferença entre Kimi K3.1 Pro e Claude Opus 5.5 em programação?
Segundo os dados divulgados pela Moonshot, o K3.1 Pro fica 0,7 ponto percentual atrás no Terminal-Bench 4.0 (65,7% contra 66,4%). Já nos testes de terceiros da AA, o K3.1 Pro teve a maior pontuação entre todos os modelos avaliados no Terminal-Bench 4.0. Os dois estão no mesmo patamar, com uma diferença estimada de aproximadamente 1 a 3 pontos percentuais.
P2: A diferença de preço é de quantas vezes?
O preço por token de entrada e de saída é duas vezes maior no Opus. O preço por acerto de cache é igual para os dois (US$ 0,20), mas a gravação no cache custa menos no Kimi. Como o Kimi gera respostas mais longas, o custo real por tarefa deve ficar em torno de 50% a 60% do custo do Opus 5.5 (estimativa).
P3: Por que os 65,7% oficiais são diferentes dos 67% da AA?
Os testes usam harnesses diferentes. O teste oficial usa o harness do Claude Code. As pontuações obtidas com metodologias diferentes só podem ser comparadas dentro de cada teste, não diretamente entre si.
P4: Dá para desativar o modo de raciocínio do Kimi K3.1 Pro?
Não. Só é possível reduzir `reasoning_effort` para `low`; `temperature` e `top_p` também têm valores fixos. Para cenários que exigem latência muito baixa, recomendamos considerar os modelos da Claude.
P5: Como comparar os dois modelos na China usando a mesma chamada de API?
Você pode usar o mesmo Key pela APIYI apiyi.com para chamar `claude-opus-5-5`. Basta definir `base_url` como `https://api.apiyi.com/v1`. O nome e o preço do modelo Kimi K3.1 Pro devem ser conferidos na lista de modelos da plataforma. Vamos disponibilizá-lo em breve; enquanto isso, você pode usar `kimi-k3` para uma comparação inicial.
P6: Para quem está começando, qual modelo vale mais a pena para praticar?
Recomendamos começar pelo Claude Sonnet 5.5 para estabelecer uma linha de base. O preço por token é igual ao do K3.1 Pro. Ao se cadastrar na APIYI apiyi.com, você recebe créditos gratuitos para testes. Consulte a lista de modelos da plataforma para ver os modelos e preços disponíveis. Vamos disponibilizar o K3.1 Pro em breve; depois do lançamento, você poderá comparar os modelos diretamente, alterando apenas o nome.
Kimi K3.1 Pro vs. Claude Opus 5.5: principais conclusões
- Mesmo nível em programação: segundo os dados oficiais, o K3.1 Pro fica 0,7 ponto percentual abaixo; nos testes da AA, o K3.1 Pro alcança a maior pontuação no Terminal-Bench 4.0
- Preço por token na proporção de 1:2: US$ 2/US$ 10 contra US$ 4/US$ 20; o preço com cache também é o mesmo para os dois: US$ 0,20
- O custo não cai pela metade: o Kimi gera cerca de 14% mais tokens por tarefa; nos testes da AA, o custo por tarefa fica entre US$ 1,98 e US$ 2,11
- Não misture metodologias: os 65,7% oficiais e os 67% da AA foram medidos com harnesses diferentes
- Pontos fortes do Opus: lidera nos índices gerais, no BenchCAD e no GDPval-AA
- Limitações do Kimi: não dá para desativar o modo de pensamento, não aceita imagens por URL pública e tem taxa de alucinação de 44%
- Como começar: você pode testar primeiro a série Claude na APIYI, em apiyi.com. Os modelos disponíveis e os preços do K3.1 Pro serão confirmados na lista da plataforma; vamos disponibilizá-lo em breve
Resumo
A comparação entre o Kimi K3.1 Pro e o Claude Opus 5.5 pode ser resumida em três pontos:
- Capacidade: os dois estão no mesmo nível em programação e recursos de Agent. A diferença nas pontuações fica dentro da margem de erro dos testes e das diferenças de metodologia
- Preço: o preço por token tem exatamente o dobro de diferença, mas o Kimi pensa por mais tempo; na prática, a economia fica em pouco mais de 40%
- Qual escolher: para tarefas em lote e cenários em que o orçamento é importante, considere primeiro o Kimi. Para 3D/CAD, baixa latência e cenários que exigem maior estabilidade geral, prefira o Claude
A forma mais confiável de decidir é testar com as suas próprias tarefas. Você pode começar usando a série Claude na APIYI, em apiyi.com, para estabelecer uma referência. Os modelos disponíveis e os preços podem ser consultados na lista de modelos da plataforma. Vamos disponibilizar o Kimi K3.1 Pro em breve; quando ele estiver disponível, basta trocar o nome do modelo para comparar.
Referências
- Blog oficial da Moonshot e documentação da API Kimi: resultados do K3.1 Pro, limites de parâmetros e preços
- Link:
platform.moonshot.cn/docs -
Observação: resultados divulgados pela própria empresa para Terminal-Bench 4.0 e BenchCAD, além de informações sobre parâmetros
-
Preços oficiais da Anthropic: cinco faixas de preço do Claude Opus 5.5 / Sonnet 5.5
- Link:
anthropic.com/pricing -
Observação: inclui o modo Fast e a faixa de cache de 1 hora
-
Artificial Analysis: índice comparativo de terceiros e custo por tarefa
- Link:
artificialanalysis.ai -
Observação: dados de 23/10/2026, incluindo Terminal-Bench 4.0, GDPval-AA e AA-Omniscience
-
Lista de modelos da APIYI: modelos e preços da plataforma
- Link:
docs.apiyi.com/models - Observação: conferido em 24/10/2026; consulte a lista em tempo real para ver os dados atualizados
Autor: Equipe técnica da APIYI
Converse com a equipe técnica: para mais informações, acesse o centro de documentação em docs.apiyi.com. Consulte a lista de modelos da plataforma para ver os modelos e preços atualizados. Vamos disponibilizar o Kimi K3.1 Pro em breve.