Nota do autor: comparo o Gemini 4 Argon com o Carbon em esforço de raciocínio, velocidade de resposta e custo por tarefa, para ajudar você a escolher o modelo de acordo com a dificuldade do trabalho.
O Google lançou o Gemini 4 Argon em 13 de outubro de 2026, apresentou o Gemini 4 Carbon pela primeira vez em 28 de outubro e abriu o Carbon oficialmente para desenvolvedores, empresas e consumidores em 10 de novembro. A primeira pergunta de muita gente foi: o Carbon é um upgrade que substitui o Argon? Neste artigo, comparo os dois modelos em 5 dimensões: esforço de raciocínio, latência de resposta, custo por tarefa, cenários de uso e níveis de raciocínio.
Não é uma análise do tipo “quanto mais potente, melhor”. A documentação oficial do Google para desenvolvedores já deixa claro que o Argon continua sendo a escolha recomendada para a maior parte do trabalho de engenharia e de conhecimento, enquanto o Carbon é voltado para tarefas que exigem raciocínio mais profundo e ciclos de verificação mais longos. Uso a documentação oficial do Google como base principal, e os dados de terceiros vêm sempre com a versão do benchmark e o nível de raciocínio indicados.
O que você leva daqui: ao terminar a leitura, você vai saber quais tarefas deixar com o Argon, quais valem o Carbon e como usar o Thinking Level para controlar qualidade, velocidade e custo.
7 termos para entender antes de comparar Gemini 4 Argon e Carbon
Quando você compara dois modelos de raciocínio, alguns conceitos se misturam com facilidade. Vale separá-los primeiro, para não interpretar os dados errado mais adiante:
- Nível de raciocínio (Thinking Level): configuração que controla quanto esforço de reflexão o modelo investe. O Carbon oferece três níveis: LOW, MEDIUM e HIGH.
- Tokens de raciocínio: tokens gerados enquanto o modelo raciocina, cobrados como tokens de saída.
- Custo da tarefa: o custo de todas as invocações do modelo necessárias para concluir uma tarefa, que não é o mesmo que o custo de uma única requisição.
- Latência de raciocínio: o tempo entre o modelo receber a requisição e produzir o resultado. Neste artigo, o foco é a latência até o primeiro token da resposta.
- Leitura de cache: forma de cobrança para reaproveitar um contexto de entrada já existente, com preço bem menor que o da entrada comum.
- Agente (Agent): agente capaz de executar tarefas de vários passos por meio de ferramentas, por exemplo escrever código, rodar testes e depois corrigir os problemas.
- Benchmark: método que avalia e compara modelos com um conjunto fixo de tarefas. As conclusões valem apenas para a configuração de teste usada.
Por que o Google lançou o Gemini 4 Argon e o Carbon ao mesmo tempo
De acordo com o model card do Carbon, publicado pelo Google DeepMind, o Gemini 4 Carbon é construído sobre o Gemini 4 Argon. Ou seja, os dois compartilham a mesma base, e o Carbon é uma versão reforçada para raciocínio de alta dificuldade, engenharia de software complexa, fluxos de trabalho de agentes de longa duração, pesquisa científica e defesa em cibersegurança. Um ponto de atenção: o Google não divulgou a quantidade de parâmetros do Carbon, nem as diferenças de arquitetura interna de computação entre os dois. Portanto, afirmações do tipo “o Carbon é X vezes maior que o Argon” não têm base nenhuma.
Se o Carbon é mais forte, por que ele não substitui o Argon de vez? Porque os dois resolvem tipos diferentes de trabalho. No desenvolvimento de funcionalidades do dia a dia e em alterações de código com interação frequente, o que pesa mais é a velocidade de resposta e o consumo de tokens a cada rodada. Já em tarefas como projeto de arquitetura, investigação de causa raiz entre subsistemas e provas científicas, o importante é o modelo conseguir levantar hipóteses, verificá-las e corrigi-las repetidas vezes. A recomendação do Google na documentação para desenvolvedores também fala em divisão de trabalho, não em substituição: o Argon cuida da maior parte da engenharia cotidiana, e o Carbon assume as tarefas de raciocínio mais difíceis e de ciclo mais longo.
Essa divisão aparece até nos produtos do próprio Google. Na prévia multiagente /swarm do Antigravity, o Google sugere que o Carbon fique com o projeto geral da arquitetura, a coordenação das tarefas e a revisão de segurança, enquanto a implementação de código convencional e as alterações paralelas em arquivos ficam com modelos mais rápidos e leves. No lado do consumidor é parecido: os benefícios de modelo da assinatura Google AI Pro são principalmente do Argon, e só a assinatura Ultra inclui o Carbon.
Gemini 4 Argon e Carbon: a diferença central está no esforço de raciocínio por turno
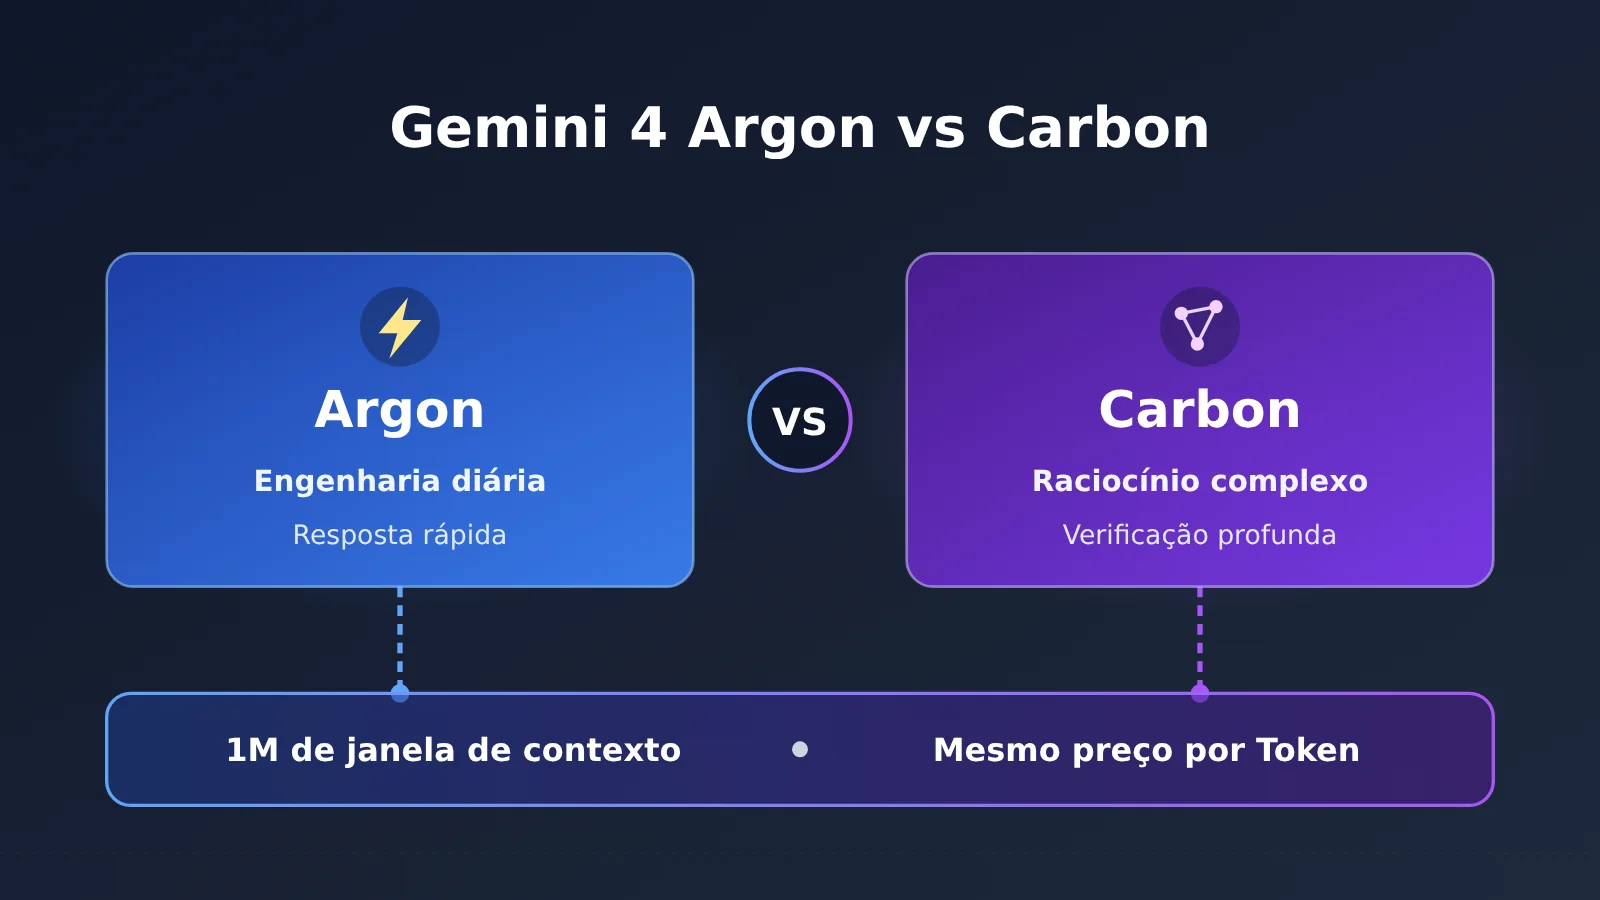
O Google deu a explicação mais direta na seção “Choosing between Carbon and Argon” do guia para desenvolvedores do Carbon. O Carbon gasta mais tokens de raciocínio a cada turno, para explorar e verificar o próprio trabalho com mais profundidade. Já o Argon responde mais rápido e consome menos tokens por turno, o que combina melhor com programação interativa e desenvolvimento de funcionalidades do dia a dia. Os dois compartilham uma janela de contexto unificada de 1M tokens (1.048.576 tokens, com entrada e saída dividindo o mesmo espaço), usam as mesmas ferramentas integradas e cobram o mesmo preço por token.
| Dimensão | Gemini 4 Argon | Gemini 4 Carbon | Mais indicado |
|---|---|---|---|
| Posicionamento | Modelo de raciocínio geral, de alto desempenho e eficiente | Modelo de raciocínio mais profundo para tarefas complexas | Depende da tarefa |
| Tokens de raciocínio por turno | Relativamente poucos | Usa mais a cada turno | Argon gasta menos |
| Velocidade de resposta | Mais rápido | Mais lento em tarefas complexas | Argon |
| Desenvolvimento interativo | Mais adequado | Pode ser usado em tarefas de alta dificuldade | Argon |
| Desenvolvimento de funcionalidades do dia a dia | Recomendado | Em geral desnecessário | Argon |
| Design de arquitetura e investigação de causa raiz | Dá conta | Mais indicado para casos extremamente complexos e investigações profundas | Carbon |
| Provas científicas e auditorias de segurança | Dá conta / suporta | Mais indicado para raciocínio e verificação complexos | Carbon |
| Contexto e preço por token | Contexto compartilhado de 1M, mesmo preço | Contexto compartilhado de 1M, mesmo preço | Empate |
A tabela deixa claro que a linha divisória entre o Gemini 4 Argon e o Carbon não é “dá ou não dá para fazer”, e sim “vale ou não a pena pensar mais”. O Argon também consegue cuidar de design de arquitetura e investigação de causa raiz. Só que, quando o problema fica complexo a ponto de exigir várias rodadas de hipóteses e verificações, o Carbon topa investir mais tokens de raciocínio para chegar a um resultado mais confiável.
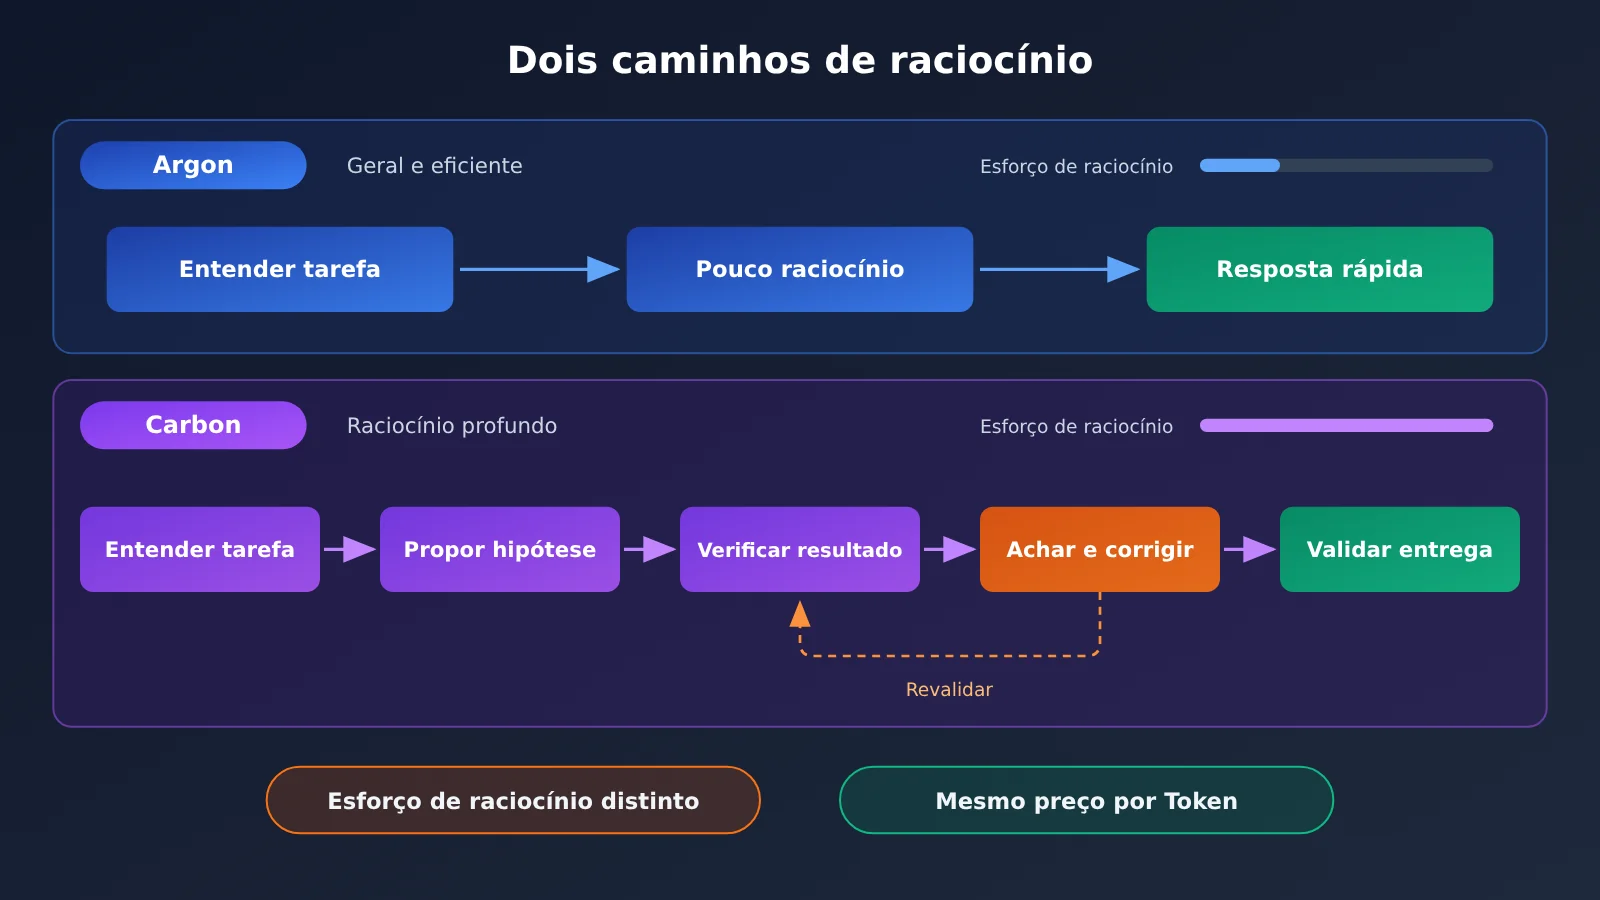
O jeito de trabalhar do Carbon lembra mais um ciclo de execução completo: entender o objetivo e as restrições, quebrar a tarefa em partes, montar um plano, chamar ferramentas, checar resultados intermediários, identificar erros, corrigir e verificar de novo, até entregar. Esse ciclo dá a ele vantagem em tarefas de longa duração, e também explica por que a espera pela primeira resposta é maior.
Comparação independente de benchmarks entre Gemini 4 Argon e Carbon
As afirmações oficiais precisam de dados independentes para serem validadas. A Artificial Analysis oferece, no Intelligence Index v5.0.1, uma página de comparação direta entre Carbon e Argon. Todos os dados abaixo são resultados com a configuração de raciocínio High.
| Métrica (AA v5.0.1, raciocínio High) | Carbon High | Argon High | Diferença |
|---|---|---|---|
| Índice de capacidade geral | 60 | 50 | Carbon +10 |
| AutomationBench-AA | 77,8% | 77,5% | Praticamente empatados |
| Terminal-Bench 4.0 | 65,2% | 57,1% | Carbon na frente |
| FrontierCode 2.0 | 40,6% | 25,7% | Carbon bem à frente |
| AA-Omniscience (pontuação de confiabilidade do conhecimento) | 54 | 46 | Carbon na frente |
| HLE-Diamond | 69,1% | 56,7% | Carbon na frente |
| Custo por tarefa | $7.76 | $9.95 | Carbon mais barato |
| Tempo por tarefa | 25,6 minutos | 28,9 minutos | Carbon mais rápido |
| Latência até o primeiro token da resposta | cerca de 68 s | cerca de 37 s | Argon mais rápido |
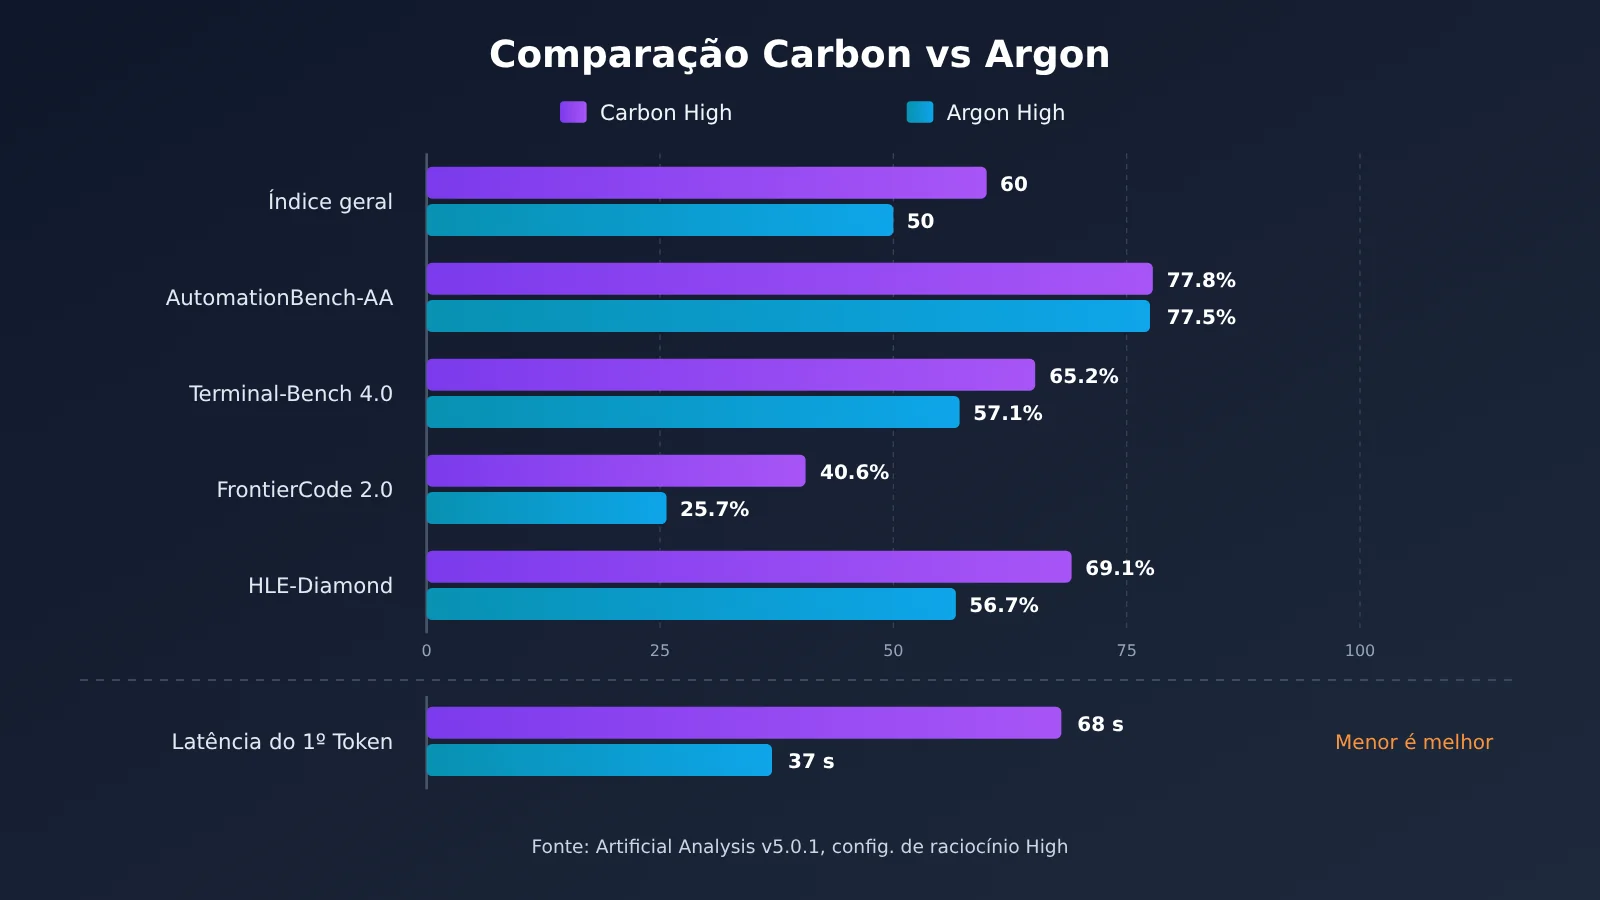
Algumas conclusões que merecem atenção:
- A maior diferença está em engenharia complexa e raciocínio complexo: no FrontierCode 2.0 a vantagem é de quase 15 pontos percentuais, no HLE-Diamond é de cerca de 12 pontos e no Terminal-Bench 4.0 é de cerca de 8 pontos.
- Em tarefas de automação convencionais, a diferença é mínima: no AutomationBench-AA são apenas 0,3 ponto percentual, o que mostra que, para tarefas automatizadas baseadas em fluxos, o Argon já dá conta do recado.
- A confiabilidade do conhecimento melhorou: 54 contra 46 no AA-Omniscience. O Agentic Honesty Benchmark, que aparece no model card do Google, também mostra 92% para o Carbon e 70% para o Argon.
- O Argon responde bem mais rápido na primeira resposta: cerca de 37 segundos contra cerca de 68 segundos. Esse é o custo direto do raciocínio extra que o Carbon faz.
O model card oficial do Google (avaliação datada de outubro de 2026, em geral com Pass@1 e usando o nível de raciocínio mais alto disponível) aponta na mesma direção: no SWE-sweep, Carbon tem 9,6% e Argon 4,3%; no GraphWalks (256k–1M, BFS F1), Carbon tem 96,2% e Argon 84,2%; no Terminal-Bench Science 0.1, Carbon tem 64,8% e Argon 52,9%. O model card oficial e a Artificial Analysis usam sistemas de avaliação diferentes e foram medidos em momentos distintos, então não vale misturar os dois num mesmo ranking. Além disso, a página do modelo Carbon mostra um tempo por tarefa de 24,9 minutos no modo High, um pouco diferente dos 25,6 minutos da página de comparação. Nesta comparação, usamos os dados da página de comparação.
Os resultados de benchmark também não são tudo. No MKA, a avaliação de trabalho de conhecimento multimodal lançada em conjunto pelo Google DeepMind e pela Artificial Analysis, nenhum modelo lidera nos 10 setores: o Argon lidera em ciências e o Carbon lidera em saúde. Isso lembra que, mesmo com uma pontuação geral mais alta, o Carbon não necessariamente supera o Argon em todas as áreas específicas.
💡 Nota sobre a comparação: benchmarks só mostram o desempenho em um conjunto fixo de tarefas. Para saber se o seu caso de uso realmente precisa do Carbon, o jeito mais confiável é rodar os dois modelos nas suas próprias tarefas. Pelo APIYI (apiyi.com), você usa a mesma chave API e o mesmo código compatível com OpenAI para alternar entre os dois modelos, o que facilita fazer testes comparativos em pequena escala.
Por que o Gemini 4 Carbon gasta mais tokens por rodada, mas não necessariamente custa mais
Este é o ponto mais fácil de interpretar errado. O Gemini 4 Argon e o Carbon têm o mesmo preço por token: até 30 de novembro de 2026, o preço de lançamento é de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída; a partir de 1º de dezembro, passa para US$ 4 e US$ 20; e a entrada em cache tem 95% de desconto sobre o preço de entrada. Os tokens de raciocínio entram na conta dos tokens de saída, então, como o Carbon “pensa mais” a cada rodada, a fatura de uma única rodada costuma ser maior.
Só que o custo de uma tarefa não é o custo de uma rodada. Na comparação da configuração High no Artificial Analysis v5.0.1, o Carbon custa US$ 7,76 por tarefa e o Argon, US$ 9,95. Ou seja, o Carbon sai cerca de 22% mais barato e ainda termina uns 3 minutos mais rápido. Uma explicação plausível é que o custo de uma tarefa completa depende de quantas rodadas foram necessárias, de quantos desvios o modelo fez no caminho e de quantas vezes precisou refazer o trabalho. Se o Carbon pensa mais no começo e erra menos, sobram menos tentativas e correções depois.
| Configuração (AA v5.0.1) | Nota geral | Custo por tarefa | Tempo por tarefa | Latência da primeira resposta |
|---|---|---|---|---|
| Carbon Low | 54 | $7.19 | 22,3 minutos | 12,37 s |
| Carbon Medium | 58 | $6.59 | 23,3 minutos | 23,16 s |
| Carbon High | 60 | $7.76 | 24,9 minutos | 67,54 s |
| Argon High | 50 | $9.95 | 28,9 minutos | cerca de 37 s |
Esses dados trazem outra coisa contraintuitiva: o custo por tarefa do Carbon Medium é menor que o do Low. Quanto mais baixo o nível de raciocínio, mais barata é cada rodada, mas pode ser preciso fazer mais rodadas para concluir a tarefa. Mesmo assim, vale ficar de olho nos limites dessa comparação:
- Esses custos são o custo médio por tarefa nesse sistema de avaliação, calculado com o preço padrão de US$ 4/20, e não o preço de uma requisição de API comum. Se você estimar pelo preço de lançamento, o custo para o mesmo consumo de tokens cai para aproximadamente a metade.
- Tempos como os 24,9 minutos são tempos ponderados de tarefas de avaliação de agentes. Isso não quer dizer que uma pergunta comum vai demorar 25 minutos para ser respondida.
- A conclusão vale apenas para o conjunto de tarefas do AA Index. Se as suas tarefas são simples e se resolvem em uma ou duas rodadas, a vantagem por rodada do Argon (ou de um nível de raciocínio mais baixo) vai aparecer direto numa fatura menor.
💰 Dica de custo: ao avaliar modelos, registre o “total de tokens e o tempo total para concluir uma tarefa”, em vez de comparar só o preço unitário. O APIYI (apiyi.com) cobra por uso, e o console mostra o detalhamento de consumo de cada invocação, o que ajuda a calcular o custo real de tarefa do Argon e do Carbon no seu negócio.
Quando escolher o Gemini 4 Argon e quando escolher o Carbon
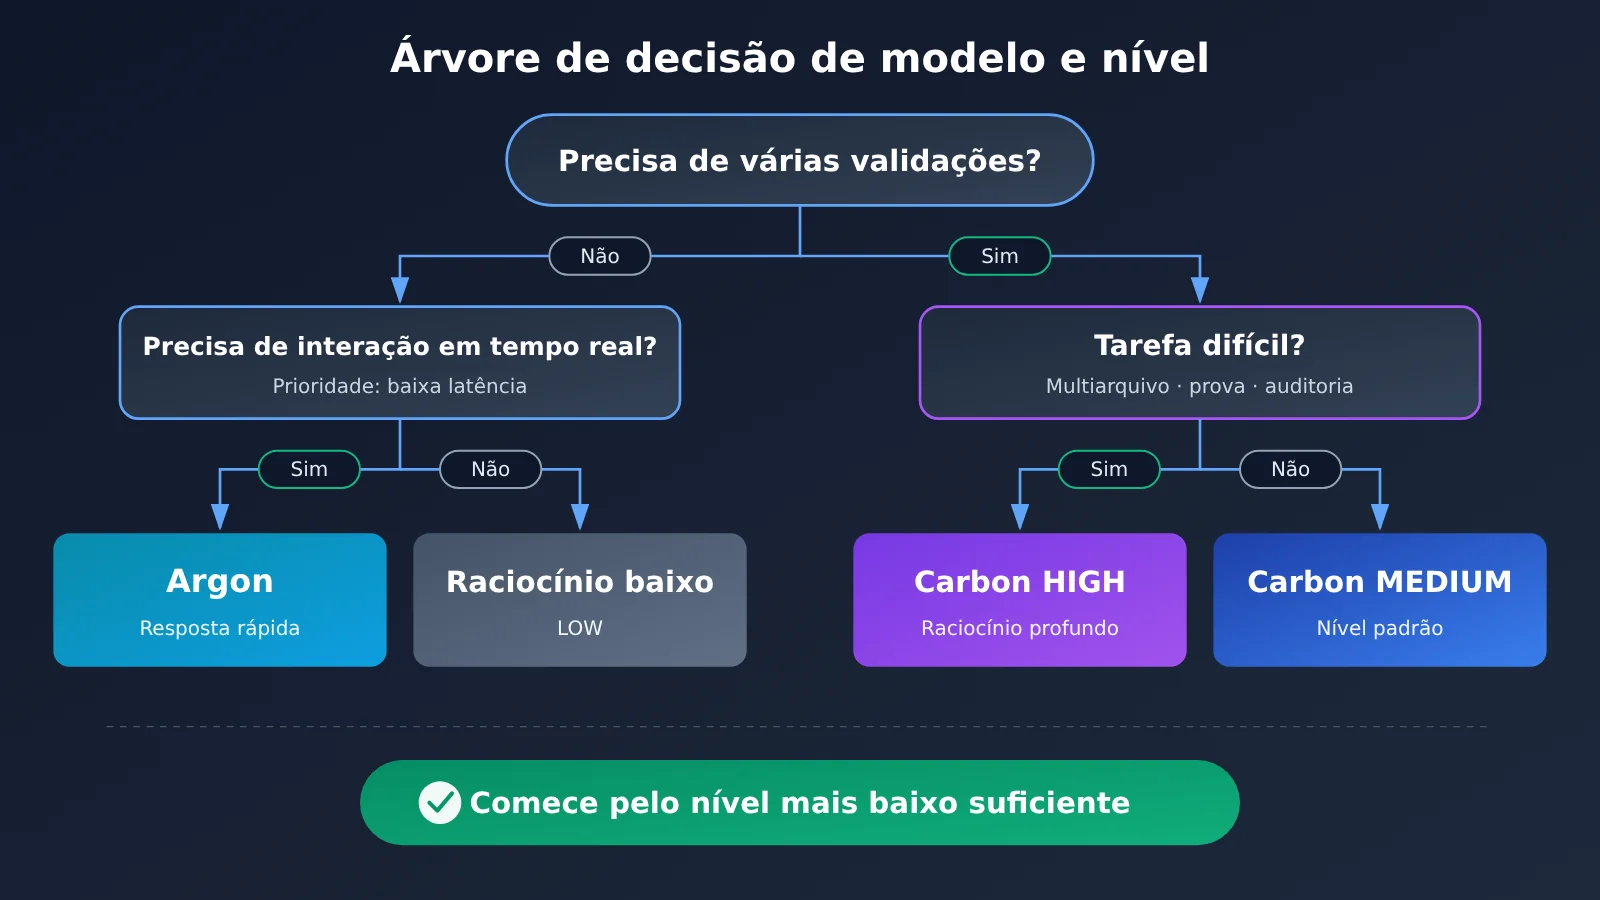
Juntando o posicionamento oficial do Google com os dados acima, dá para dividir as tarefas por nível de dificuldade. O princípio central é: primeiro pergunte se a tarefa vale um raciocínio mais profundo e só depois decida qual modelo e qual nível usar.
| Tipo de tarefa | Modelo recomendado | Nível recomendado | Motivo |
|---|---|---|---|
| Desenvolvimento de funcionalidades do dia a dia, alterações comuns de código | Argon | Padrão ou médio | Resposta rápida, custo baixo por rodada, ideal para interações frequentes |
| Programação interativa, assistência em tempo real na IDE | Argon | Médio | Latência da primeira resposta bem menor |
| Projetos complexos com vários arquivos, design de arquitetura | Carbon | HIGH | Diferença nítida no FrontierCode e no Terminal-Bench |
| Investigação profunda de causa raiz entre subsistemas | Carbon | MEDIUM / HIGH | Exige explorar várias hipóteses e verificar repetidamente |
| Raciocínio científico difícil, provas formais | Carbon | HIGH | O Google lista provas formais como um uso de nível HIGH |
| Auditoria de segurança, descoberta de vulnerabilidades | Carbon | HIGH | O posicionamento oficial é mais voltado para auditorias complexas |
| Classificação simples, resumos, extração de metadados | Nível de raciocínio baixo | LOW | Sensível a custo, não precisa de raciocínio profundo |
Cenários para escolher o Gemini 4 Argon
- Trabalho de desenvolvimento com interação frequente: escrever uma função, ajustar um estilo, completar testes. Esperar 37 segundos ou 68 segundos faz uma diferença enorme na sensação de uso.
- Trabalho de conhecimento comum e fluxos automatizados: no AutomationBench-AA os dois ficam praticamente empatados, então não faz sentido pagar mais por uma diferença que não existe.
- Trabalho de conhecimento na área científica: na avaliação MKA, o Argon lidera na área científica, então vale testá-lo primeiro.
Cenários para escolher o Gemini 4 Carbon
- Tarefas de Agent de longa duração rodando em segundo plano: aqui a latência da primeira resposta importa pouco, e o que pesa é acertar de primeira.
- Engenharia complexa e decisões de arquitetura: migrações com vários arquivos, refatoração de sistemas, auditorias de código complexas.
- Tarefas que exigem resultados verificáveis: raciocínio científico, auditoria de segurança, relatórios de análise que precisam de autoverificação.
Os primeiros feedbacks da comunidade confirmam essa divisão. No Hacker News e no Reddit, há desenvolvedores dizendo que o Carbon encontra problemas que outros modelos deixam passar, e também quem reclame que a espera pela primeira resposta é longa demais e que a cota é consumida rápido. Um usuário do Reddit migrou, com o Carbon Medium, uma biblioteca de 230 arquivos num projeto em Go e conseguiu rodar de primeira. Mas o próprio autor avisa que a amostra tem só 4 etapas e não é um experimento controlado, então serve apenas como um caso de referência.
Como usar o Thinking Level para controlar qualidade, velocidade e custo do Gemini 4 Carbon
O Carbon oferece três níveis de raciocínio: LOW, MEDIUM e HIGH. O modelo público gemini-4-carbon usa MEDIUM por padrão. A divisão de usos recomendada oficialmente é esta: LOW para classificação, resumo e extração de metadados; MEDIUM para código do dia a dia, chamadas de ferramentas, perguntas e respostas sobre documentos e compreensão de vídeo; HIGH para engenharia de software com vários arquivos, design de arquitetura, provas formais e descoberta de vulnerabilidades.
O MEDIUM como padrão tem seus motivos. No AA v5.0.1, o Carbon Medium atingiu pontuação geral de 58, apenas 2 pontos abaixo do High, com o menor custo por tarefa e uma latência até a primeira resposta cerca de um terço da do High. No teste de confiabilidade factual AA-Omniscience, a proporção de respostas inventadas do Medium foi de 4,2%, abaixo dos 11,4% do High e dos 20,0% do Low (essa é uma métrica de um teste específico, não uma taxa geral de alucinação). O Google também recomenda que os desenvolvedores testem os diferentes níveis e escolham o menor nível que atenda aos requisitos de qualidade, em vez de usar HIGH sempre, sem critério.
Na hora de fazer as chamadas, há algumas limitações técnicas do Carbon para ficar de olho: o parâmetro thinking_budget não é suportado e, se você usá-lo, receberá um erro HTTP 400; o nível MINIMAL não existe; temperature, top_p e top_k são ignorados; não há suporte para Context Caching explícito, mas, quando o prefixo comum do comando chega a 4096 tokens ou mais, o cache implícito automático pode ser acionado.
Exemplo mínimo
Abaixo, chamamos o Gemini 4 Carbon pela interface compatível com a OpenAI, com pouco mais de 10 linhas de código:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # O ID do modelo deve seguir a lista de modelos da plataforma
    messages=[{"role": "user", "content": "分析这段服务超时日志的可能根因"}]
)
print(response.choices[0].message.content)
Ver o código completo: roteando entre Argon e Carbon pela dificuldade da tarefa
import time
import openai
from typing import Literal

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Os nomes dos modelos são apenas exemplos; use os IDs reais da lista de modelos da plataforma
ARGON_MODEL = "gemini-4-argon"
CARBON_MODEL = "gemini-4-carbon"

Difficulty = Literal["simple", "daily", "complex", "extreme"]

def route(difficulty: Difficulty) -> tuple[str, str]:
    """Retorna (modelo, nível de raciocínio) de acordo com a dificuldade da tarefa"""
    if difficulty == "simple":
        return CARBON_MODEL, "low"      # Classificação, resumo, extração de metadados
    if difficulty == "daily":
        return ARGON_MODEL, "medium"    # Desenvolvimento do dia a dia, interações frequentes
    if difficulty == "complex":
        return CARBON_MODEL, "medium"   # Investigação de causa raiz, tarefas comuns de Agent
    return CARBON_MODEL, "high"         # Engenharia com vários arquivos, provas, auditoria de segurança

def run_task(prompt: str, difficulty: Difficulty) -> dict:
    model, effort = route(difficulty)
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        # O mapeamento do parâmetro de nível de raciocínio deve seguir a documentação da plataforma;
        # o Carbon não suporta thinking_budget, e enviá-lo gera erro 400
        reasoning_effort=effort,
    )
    usage = resp.usage
    return {
        "model": model,
        "effort": effort,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,  # Inclui os tokens de raciocínio
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    result = run_task("为订单服务设计分库分表迁移方案,并列出验证步骤", "extreme")
    print(result["model"], result["effort"], result["seconds"], "s")
    print("输出 Token:", result["completion_tokens"])
🚀 Dica para começar rápido: o ideal é se cadastrar na APIYI (apiyi.com) e pegar a cota gratuita de testes. Depois, use a função de roteamento acima para mandar o mesmo conjunto de tarefas reais para o Argon e para os diferentes níveis do Carbon, registrando o tempo de resposta e o
completion_tokens. Uma única chave API resolve toda a comparação, sem precisar integrar vários SDKs diferentes.
Recomendações de decisão entre Gemini 4 Argon e Carbon
Se você só puder guardar uma regra: use o Argon por padrão e só suba para o Carbon quando a tarefa realmente merecer um raciocínio mais profundo. Na prática, dá para colocar isso em prática em três passos:
- Defina regras de roteamento: com base na tabela de cenários acima, divida as tarefas em quatro categorias: simples, cotidianas, complexas e extremamente difíceis. As cotidianas vão para o Argon por padrão.
- Faça um teste comparativo em pequena escala: escolha de 10 a 20 tarefas reais de cada categoria e compare a taxa de aprovação, o total de tokens e o tempo total de cada nível do Argon e do Carbon.
- Escolha o nível pelo custo da tarefa: fique com o nível mais baixo que atinja o padrão de qualidade que você precisa e refaça os testes de tempos em tempos, porque modelos, preços e rankings podem ser atualizados.
Em sistemas com vários Agents, você também pode seguir a ideia do /swarm do Google: o Carbon cuida do planejamento, da coordenação e da revisão, enquanto o Argon (ou um modelo ainda mais leve) fica com a execução em lote. Assim você aproveita o raciocínio profundo do Carbon sem fazer todas as etapas pagarem o preço da latência dele.
💡 Dica de escolha: os dois modelos têm o mesmo preço por token, então o que realmente faz diferença é a estrutura das suas tarefas. Recomendamos integrar o Argon e o Carbon ao mesmo tempo pelo APIYI (apiyi.com), usando a interface compatível com a OpenAI, e alternar entre eles por roteamento no código. Assim, quando você precisar ajustar a estratégia, não será necessário mexer no código de negócio.
Perguntas frequentes (FAQ)
P1: Qual é a relação entre o Gemini 4 Argon e o Carbon?
De acordo com o model card do Google DeepMind, o Gemini 4 Carbon foi construído em cima do Gemini 4 Argon. Os dois fazem parte da mesma série de modelos de raciocínio do Gemini 4 e compartilham uma janela de contexto de 1M de tokens e as mesmas ferramentas integradas. O Carbon gasta mais tokens de raciocínio a cada rodada para explorar e verificar, enquanto o Argon dá mais ênfase à velocidade de resposta e à eficiência por rodada. O Google não divulgou as diferenças de parâmetros nem de arquitetura entre eles.
P2: O Carbon vai substituir o Argon por completo?
Não. O Google deixa claro que o Argon continua sendo a escolha ideal para a maioria das tarefas de engenharia e de trabalho com conhecimento, e que o Carbon é indicado para tarefas mais difíceis e de duração mais longa. Pelos números, o Argon segue competitivo em muitos cenários: no AutomationBench-AA os dois ficam praticamente empatados, e no MKA o Argon lidera na área científica.
P3: Os dois modelos têm o mesmo preço? Quando o preço muda?
A documentação para desenvolvedores do Google mostra que os dois usam o mesmo preço por token. O preço de lançamento é de US$ 2 / US$ 10 por milhão de tokens de entrada/saída, válido até 30 de novembro de 2026. A partir de 1º de dezembro, o valor passa a ser US$ 4 / US$ 20. Os tokens de raciocínio entram na cobrança de saída, então preço unitário igual não significa custo igual por tarefa.
P4: O Carbon demora para dar a primeira resposta. Serve para aplicativos de chat?
Não é muito indicado para cenários que exigem resposta em tempo real. No AA v5.0.1, a latência até o primeiro token da resposta é de cerca de 68 segundos no Carbon High, cerca de 37 segundos no Argon High e cerca de 12 segundos no Carbon Low. Para interações em tempo real, use o Argon; o Carbon se encaixa melhor em análises complexas em segundo plano e em tarefas de agentes de longa duração.
P5: Como comparar o Argon e o Carbon rapidamente via API?
Recomendo usar uma plataforma agregadora de API com suporte a vários modelos:
1. Acesse o APIYI (apiyi.com), crie uma conta e pegue sua chave API e o crédito gratuito para testes;
2. Defina o `base_url` do seu código como `https://api.apiyi.com/v1`;
3. Altere apenas o parâmetro `model` para alternar entre os dois modelos e, em seguida, combine com os níveis de raciocínio para fazer a comparação.
P6: Dá para usar o Carbon sem a assinatura Google AI Ultra?
Dá, sim. A assinatura Ultra define apenas se, no lado do consumidor (Gemini App etc.), você pode escolher o Carbon diretamente; o AI Pro inclui principalmente o Argon. Quem desenvolve pode chamar o Carbon pela camada paga da Gemini API, sem precisar comprar o Ultra. Vale lembrar que a API oficial do Google para o Carbon não tem camada gratuita.
P7: Quais são as limitações conhecidas do Carbon?
O model card informa que o modelo ainda pode alucinar, que níveis altos de raciocínio podem consumir muitos tokens, que as respostas podem ser lentas ou estourar o tempo limite, que o corte de conhecimento é março de 2026 e que a proteção contra Prompt Injection ainda precisa melhorar. Além disso, o `thinking_budget` não é suportado e os parâmetros de amostragem são ignorados, então vale revisar o código antigo ao migrar.
Pontos-chave sobre Gemini 4 Argon e Carbon (Key Takeaways)
- Relação entre os dois: o Carbon é construído em cima do Argon, e os dois se complementam na divisão de tarefas. Um não é a versão “mais fraca” ou “mais forte” do outro.
- Principal diferença: o Carbon pensa mais a cada rodada e verifica melhor o resultado; o Argon responde mais rápido e gasta menos por rodada.
- Desempenho em benchmark: na configuração High do AA v5.0.1, o Carbon soma 60 pontos no geral e o Argon, 50.
- A verdade sobre custo: o preço unitário é o mesmo, e nas tarefas do AA o Carbon High acaba saindo mais barato por tarefa do que o Argon High.
- Como escolher o nível: o Carbon usa MEDIUM por padrão. Escolha entre LOW/MEDIUM/HIGH seguindo o princípio do “menor nível que dá conta do recado”.
- Como começar: com o APIYI (apiyi.com), você testa os dois modelos usando um único código compatível com OpenAI.
Resumo
A diferença entre o Gemini 4 Argon e o Carbon pode ser resumida em três pontos:
- Investimento em raciocínio diferente: o Argon cuida da eficiência, enquanto o Carbon usa mais tokens de raciocínio para levar o raciocínio complexo ao limite.
- Latência e custo precisam ser analisados separadamente: a primeira resposta do Carbon é mais lenta, mas, em certas avaliações, o custo da tarefa completa pode ser menor.
- O critério de escolha é a dificuldade da tarefa: no dia a dia de engenharia, comece pelo Argon; deixe para o Carbon os projetos mais complexos, o raciocínio científico e as auditorias de segurança.
Não mande todas as requisições para o nível máximo de raciocínio. O segredo para equilibrar qualidade, velocidade e custo é testar suas tarefas reais e descobrir o “nível suficiente” para cada tipo de trabalho. Recomendamos validar rapidamente o desempenho dos dois modelos no seu caso de uso pelo APIYI (apiyi.com), que oferece cobrança por uso e uma interface unificada para vários modelos.
📚 Referências
- Gemini 4 Carbon Model Card: model card oficial do Google DeepMind
- Link:
deepmind.google/models/model-cards/gemini-4-carbon -
Descrição: o Carbon é construído sobre o Argon; traz especificações de contexto, avaliações oficiais e limitações conhecidas
-
Choosing between Carbon and Argon: documentação para desenvolvedores do Google AI Studio
- Link:
aistudio.google.com/docs/whats-new-gemini-4-carbon -
Descrição: diferenças de posicionamento oficial entre os dois modelos e recomendações para escolher o Thinking Level
-
Gemini 4 Carbon Developer Guide: guia para desenvolvedores do Google Cloud
- Link:
docs.cloud.google.cn/gemini-enterprise-agent-platform/models/guides/gemini-4-carbon -
Descrição: níveis de raciocínio, limitações de parâmetros da API e notas sobre decodificação longa
-
Preços da Gemini API: Google AI for Developers
- Link:
ai.google.dev/gemini-api/docs/pricing -
Descrição: preço de lançamento, reajuste de dezembro, cache e regras de cobrança de tokens de raciocínio
-
Gemini 4 Carbon vs Gemini 4 Argon: página de comparação da Artificial Analysis
- Link:
artificialanalysis.ai/zh/models/comparisons/gemini-4-carbon-vs-gemini-4-argon -
Descrição: comparação de capacidade, custo e latência na configuração High do AA Index v5.0.1
-
Avaliação MKA de trabalho de conhecimento multimodal: Artificial Analysis
- Link:
artificialanalysis.ai/zh/evaluations/mka - Descrição: modelos líderes por setor e dados de custo por tarefa
Autor: equipe técnica da APIYI
Troca de ideias: fale com a gente na página inicial do site da APIYI. Para mais materiais sobre integração de modelos, acesse a central de documentação em docs.apiyi.com