Muitos desenvolvedores têm relatado recentemente uma experiência “contraintuitiva”: o claude-opus-5-5 não parece lento em nada e, em muitas tarefas, termina antes até do claude-sonnet-5-5. Se o modelo flagship é mais rápido e mais capaz, será que o Sonnet ficou apenas com o atrativo de “custar metade”? A resposta não é tão simples. Neste artigo, vamos usar 6 conjuntos de dados públicos para detalhar as diferenças reais entre claude-sonnet-5-5 e claude-opus-5-5, com foco em uma questão mais prática: em cenários de Agent corporativo com entrada e saída de conteúdo longo, como distribuir e combinar o trabalho entre os dois modelos.
Valor principal: ao terminar este artigo, você vai entender a verdadeira razão de o Opus ser “rápido”, quais são as vantagens concretas do Sonnet além do preço e uma arquitetura de Agent com dois modelos, Opus + Sonnet, pronta para implementar.
Visão rápida dos principais parâmetros de claude-sonnet-5-5 e claude-opus-5-5
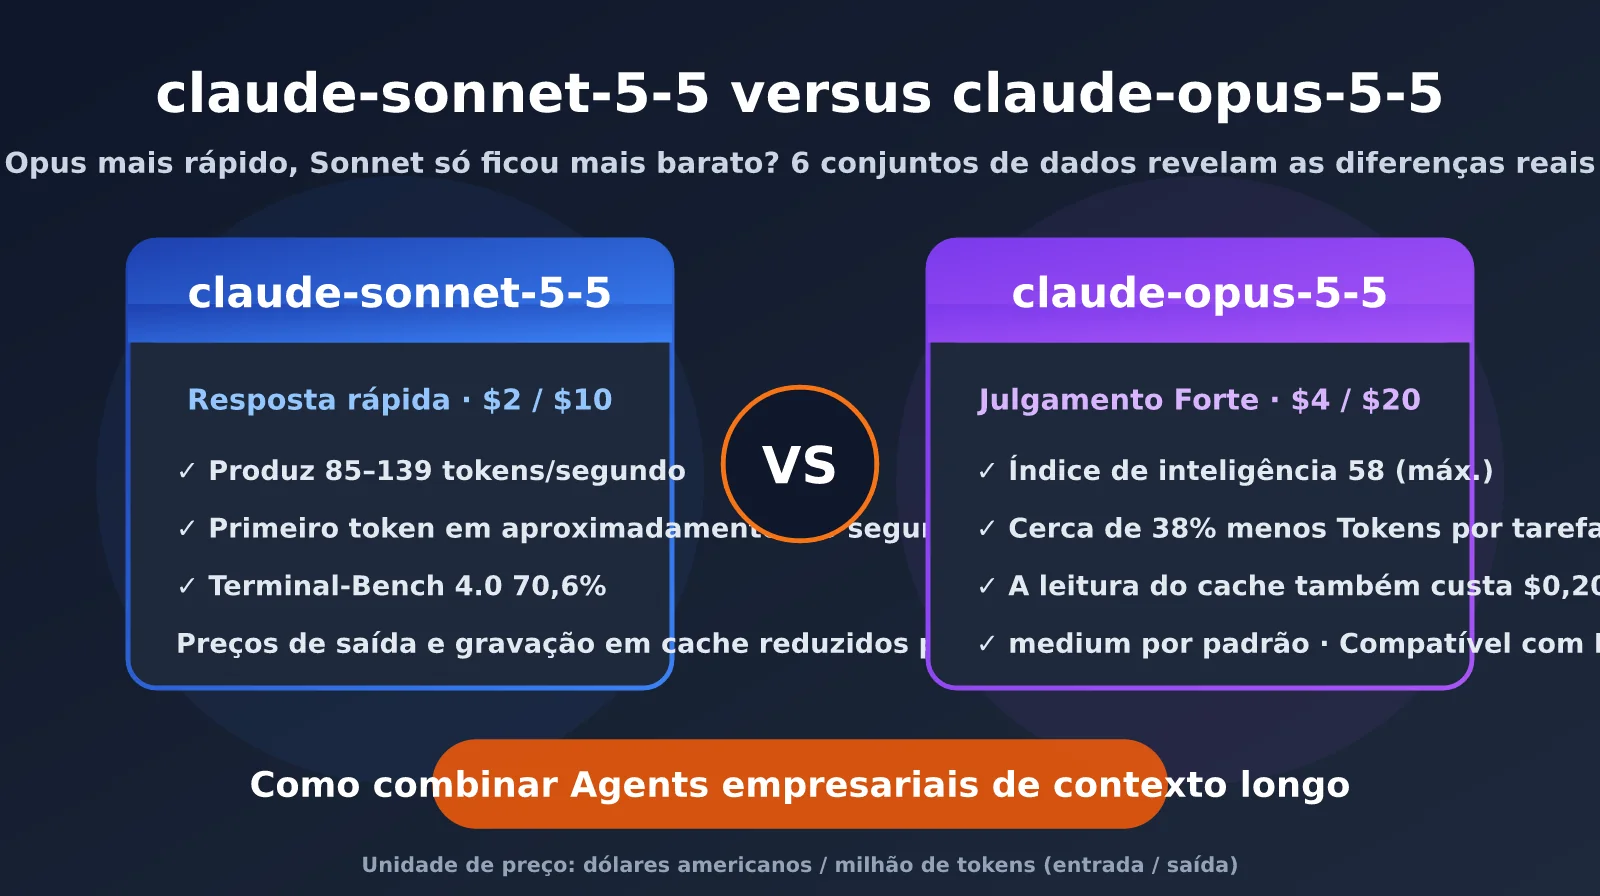
O claude-opus-5-5 foi lançado em 22 de setembro de 2026, e o claude-sonnet-5-5, em 28 de setembro de 2026. Ambos fazem parte da família Claude 5.5. A mudança mais relevante desta geração é que o Opus ficou mais barato: o preço de tabela caiu 20%, de $5/$25 no Opus 5 para $4/$20. A leitura de cache caiu ainda mais, de $0,50 para $0,20, ficando exatamente igual à do Sonnet. O Sonnet 5.5 manteve o preço de $2/$10, e a empresa afirma que seu custo por tarefa é até cerca de 30% menor que o da geração anterior.
| Parâmetro | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| Data de lançamento | 2026-09-28 | 2026-09-22 |
| Preço de entrada / saída | $2 / $10 | $4 / $20 |
| Leitura de cache | $0,20 | $0,20 (5% do preço-base de entrada) |
| Gravação em cache de 5 minutos | $2,50 | $5 |
| Preço Batch | $1 / $5 | $2 / $10 |
| Janela de contexto | 1 milhão de tokens, sem sobretaxa para contexto longo | 1 milhão de tokens, sem sobretaxa para contexto longo |
| Saída máxima | 128K (300K na versão beta do Batch) | 128K (300K na versão beta do Batch) |
| Nível de raciocínio padrão da API | high | medium |
| Modo Fast | Não suportado | Suportado, cerca de 2,5× mais velocidade de saída, $8 / $40 |
| Plataformas disponíveis | APIYI apiyi.com, API oficial da Anthropic | APIYI apiyi.com, API oficial da Anthropic |
A tabela esconde dois detalhes que afetam diretamente a experiência. Primeiro, os níveis de raciocínio padrão são diferentes: o Opus usa medium por padrão, enquanto a API do Sonnet usa high. Esse é o principal motivo de muita gente perceber o Opus como mais rápido. Segundo, o preço de leitura de cache é igual. Isso significa que, em cenários de Agent que reutilizam muito contexto longo, a diferença no custo de entrada entre os dois modelos diminui bastante.
🎯 Sugestão de teste: ao comparar os dois modelos, defina explicitamente o mesmo nível de raciocínio; caso contrário, a conclusão pode ficar bastante distorcida. Recomendamos usar a APIYI apiyi.com com a mesma chave para chamar
claude-sonnet-5-5eclaude-opus-5-5, alterando apenas os parâmetrosmodelereasoning_effortpara realizar um teste comparativo.
Por que o claude-opus-5-5 parece até mais rápido que o claude-sonnet-5-5
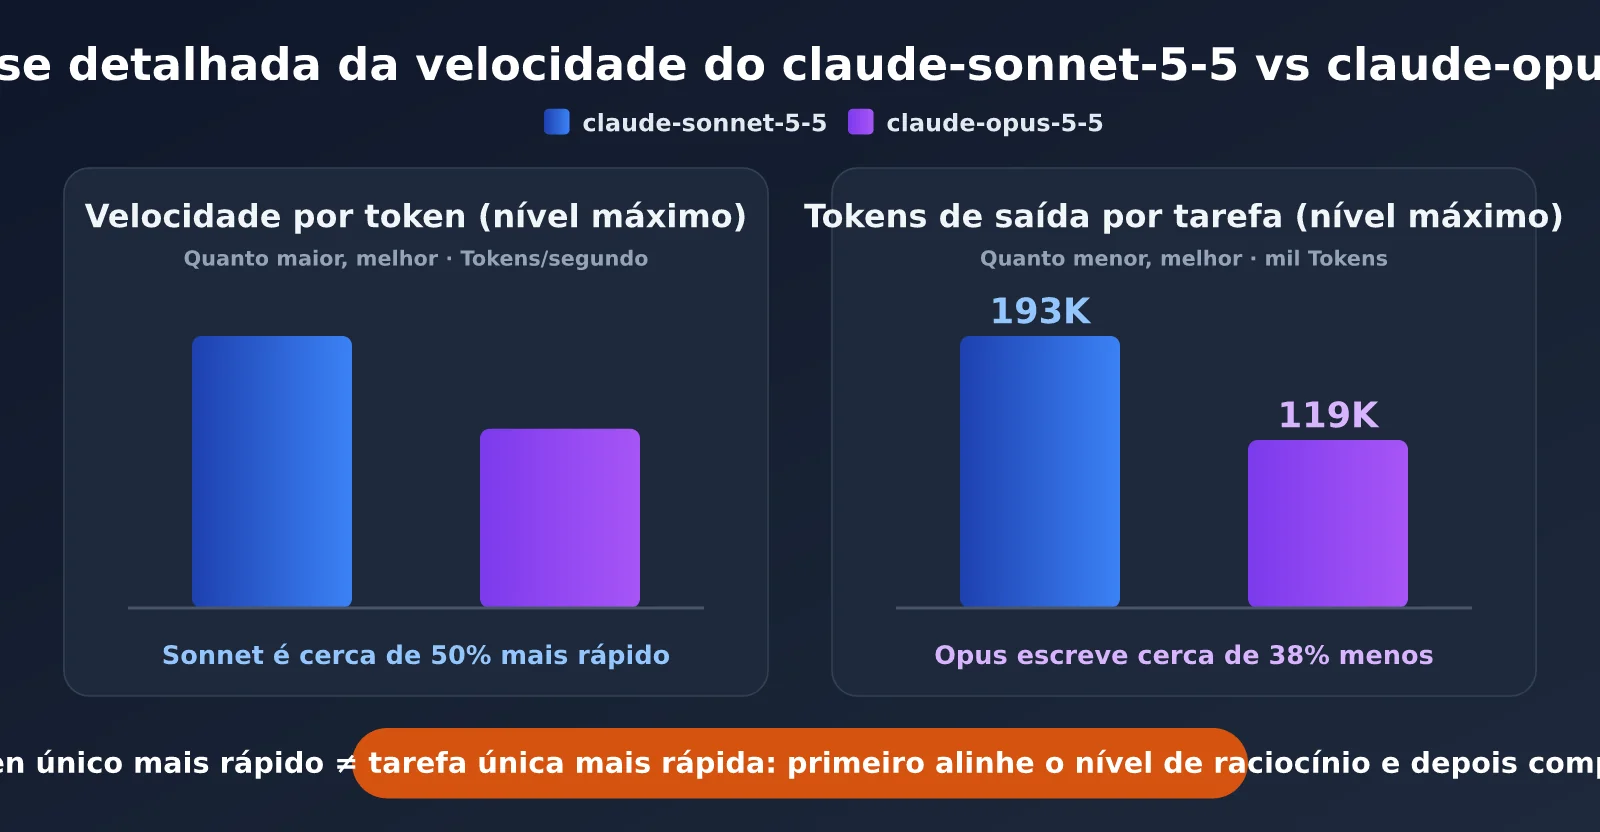
Considerando apenas a velocidade de geração, o claude-sonnet-5-5 é claramente mais rápido. As medições da Artificial Analysis mostram que o Sonnet 5.5 gera de 85 a 139 tokens por segundo em diferentes níveis de raciocínio, enquanto o Opus 5.5 fica entre 74 e 93 tokens por segundo. A própria Anthropic classifica a latência do Sonnet como “rápida” e a do Opus como “média”. Então, de onde vem a sensação de que o “Opus é mais rápido”? Há três motivos principais.
Motivo 1: os níveis padrão são diferentes — o Sonnet raciocina um nível a mais por padrão
O Opus 5.5 reduziu o nível padrão da API de high, usado na geração anterior, para medium. Segundo a empresa, o nível medium já alcança ou supera o desempenho do Opus 5 em high. Já a API do Sonnet 5.5 continua usando high por padrão, e o modo de raciocínio não pode ser desativado.
Testes independentes descobriram que, no nível high, o Sonnet gera aproximadamente o dobro de tokens em relação ao medium, sem uma melhoria clara de qualidade. Portanto, se você invocar os dois com os parâmetros padrão, o Sonnet estará efetivamente “pensando um nível a mais” e, naturalmente, levará mais tempo.
Motivo 2: o Opus tem maior eficiência de tokens
No teste de índice de inteligência da Artificial Analysis, o Sonnet 5.5 no nível max gerou, em média, cerca de 193 mil tokens por tarefa — o maior valor já medido pela instituição. O Opus 5.5 no mesmo nível gerou cerca de 119 mil tokens.
Ser mais rápido por token não significa necessariamente terminar uma tarefa antes. O Sonnet pode gerar cerca de 50% mais tokens por segundo, mas, se precisar escrever 60% mais conteúdo, o tempo de ponta a ponta pode acabar empatando com o Opus ou até ficando maior.
Motivo 3: o Opus tem acesso exclusivo ao modo Fast
O Opus 5.5 oferece o modo Fast, atualmente em prévia de pesquisa. Ele usa uma configuração de inferência mais veloz para o mesmo modelo e pode elevar a velocidade de geração em até 2,5 vezes, com preços de US$ 8/US$ 40.
Se você ativou o modo Fast para o Opus na sua ferramenta de programação, a impressão de que “o Opus é muito rápido” fica ainda mais forte. Vale observar que o modo Fast aumenta apenas a quantidade de tokens gerados por segundo: ele não melhora a latência até o primeiro token. Além disso, o cache de comandos não é compartilhado entre as velocidades padrão e Fast.
| Métrica de velocidade | claude-sonnet-5-5 | claude-opus-5-5 | Observação |
|---|---|---|---|
| Velocidade de saída (tokens/s) | 85–139 | 74–93 | O Sonnet é mais rápido por token |
| Tokens gerados por tarefa (nível max) | Cerca de 193 mil | Cerca de 119 mil | O Opus usa menos tokens |
| Latência até o primeiro token (níveis baixos) | Cerca de 1,3 s (medium) |
Cerca de 14,3 s (low) |
O Sonnet responde antes |
| Classificação oficial de latência | Rápida | Média | Segundo a página de modelos da Anthropic |
| Tempo em tarefas reais de programação (terceiros) | 29 min 27 s | 44 min 50 s | O Sonnet é cerca de 1,5 vez mais rápido |
A conclusão é: com os parâmetros padrão, o Opus pode terminar mais rápido, mas, ao colocar os dois nos níveis adequados, o Sonnet ainda tem uma vantagem clara em velocidade de resposta. Isso é especialmente importante na latência até o primeiro token: no nível medium, o Sonnet começa a responder em cerca de 1,3 segundo, algo essencial para Agents interativos voltados ao usuário.
O claude-sonnet-5-5 só tem vantagem de preço? Dados de comparação de capacidades
Começando por um dado que pode surpreender: no nível max, o Sonnet não é mais barato que o Opus. Para executar toda a suíte do índice de inteligência da Artificial Analysis, o Sonnet 5.5 (max) custou cerca de US$ 8.977, enquanto o Opus 5.5 (max) custou aproximadamente US$ 8.708. O Opus saiu ligeiramente mais barato e ainda obteve uma pontuação maior: 58 contra 56.
O motivo é justamente a eficiência de tokens mencionada antes. Portanto, se você usar o Sonnet exclusivamente no nível max, ele pode nem ter vantagem de preço.
Então, onde está o valor do Sonnet? A tabela abaixo mostra as pontuações dos dois no índice de inteligência por nível de raciocínio e deixa mais claro como utilizá-lo corretamente:
| Nível de raciocínio | Índice de inteligência do claude-sonnet-5-5 | Índice de inteligência do claude-opus-5-5 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
Em inteligência geral, o Opus lidera em todos os níveis equivalentes. Sua vantagem também é mais evidente em índices de precisão factual — 66% contra 54% no AA-Omniscience — e em áreas especializadas, como direito, finanças e estratégia.
Mas o Sonnet tem vantagens objetivas que o Opus não consegue substituir:
- Programação com Agents de terminal: no Terminal-Bench 4.0, o Sonnet (
max) alcança 70,6%, acima dos 66,4% do Opus (xhigh). Porém, no mesmo nívelxhigh, o Opus ainda lidera por 66,4% contra 61,5%; o Sonnet precisa operar no máximo para ultrapassá-lo. - Latência de resposta: tanto a latência até o primeiro token quanto a velocidade de saída por segundo são claramente melhores, o que o torna adequado para cenários de interface com interação em tempo real e saída por streaming.
- Entrada sem cache e gravação de cache: os preços unitários são metade dos cobrados pelo Opus, o que favorece tarefas pontuais com entradas longas, como documentos novos a cada solicitação.
- Saídas longas e processamento em lote: o preço de saída é US$ 10 contra US$ 20, e no Batch é US$ 5 contra US$ 10. Em geração massiva de relatórios e documentos longos, a vantagem de custo é diretamente o dobro.
- Execução com alta concorrência: no posicionamento oficial da Anthropic, o Sonnet é o parceiro mais rápido e barato do Opus, ideal para executar em paralelo muitas subtarefas bem definidas como sub-Agents.
Em outros benchmarks públicos, o Opus lidera por cerca de 2 pontos no CursorBench 4.0 (57,8% contra 55,5%), no FrontierCode 1.1 (54,4% contra 52,1%) e no OSWorld 2.1 (81,8% contra 80,1%). Já no ProgramBench, um teste consolidado por terceiros de reconstrução de programas com contexto longo, o Opus atinge 91,2%, enquanto o Sonnet fica em 79,7% — uma diferença bem maior.
Isso mostra que quanto mais a tarefa exige julgamentos precisos dentro de uma janela de contexto extremamente longa, maior é a vantagem do Opus.
💡 Dica de escolha: o uso ideal do Sonnet é entre os níveis
mediumexhigh, tratando-o como um “executor”. Já o Opus é mais indicado como “tomador de decisões”, começando pelo nívelmedium. Para validar a diferença no seu próprio negócio, execute a mesma tarefa com documentos longos em ambos usando a APIYI apiyi.com e compare a qualidade dos resultados com o custo real.
O custo real de Agents empresariais com contexto longo
A carga típica de um Agent empresarial envolve, na entrada, contratos, repositórios de código ou bases de conhecimento com centenas de milhares de Tokens; na saída, relatórios extensos, reescritas em lote ou código para múltiplos arquivos. Como os dois modelos suportam 1 milhão de Tokens de contexto sem cobrança adicional para contexto longo, o que realmente determina o custo é a taxa de acerto do cache e o volume de saída. A seguir, estimamos alguns cenários comuns com base nos preços oficiais (para o Sonnet, considera-se 1,6 vez mais Tokens de saída que o Opus, refletindo a diferença de eficiência de Tokens entre ambos no nível max):
| Cenário | Composição da carga | claude-sonnet-5-5 | claude-opus-5-5 | Relação de custo |
|---|---|---|---|---|
| Perguntas em múltiplas rodadas com contexto longo | 500 mil Tokens de contexto, 95% de acerto no cache, 25 mil novos Tokens gravados | Cerca de US$ 0,28 (12 mil Tokens de saída) | Cerca de US$ 0,37 (7,5 mil Tokens de saída) | 1 : 1,3 |
| Primeiro carregamento de documento longo | 500 mil Tokens gravados no cache de 5 minutos + 10 mil Tokens de saída | Cerca de US$ 1,35 | Cerca de US$ 2,70 | 1 : 2 |
| Geração de relatório extenso | 50 mil Tokens de entrada + 50 mil Tokens de saída (mesmo volume de saída) | Cerca de US$ 0,60 | Cerca de US$ 1,20 | 1 : 2 |
| Geração em lote offline | Modo Batch, 100 mil Tokens de entrada e saída cada | Cerca de US$ 0,60 | Cerca de US$ 1,20 | 1 : 2 |
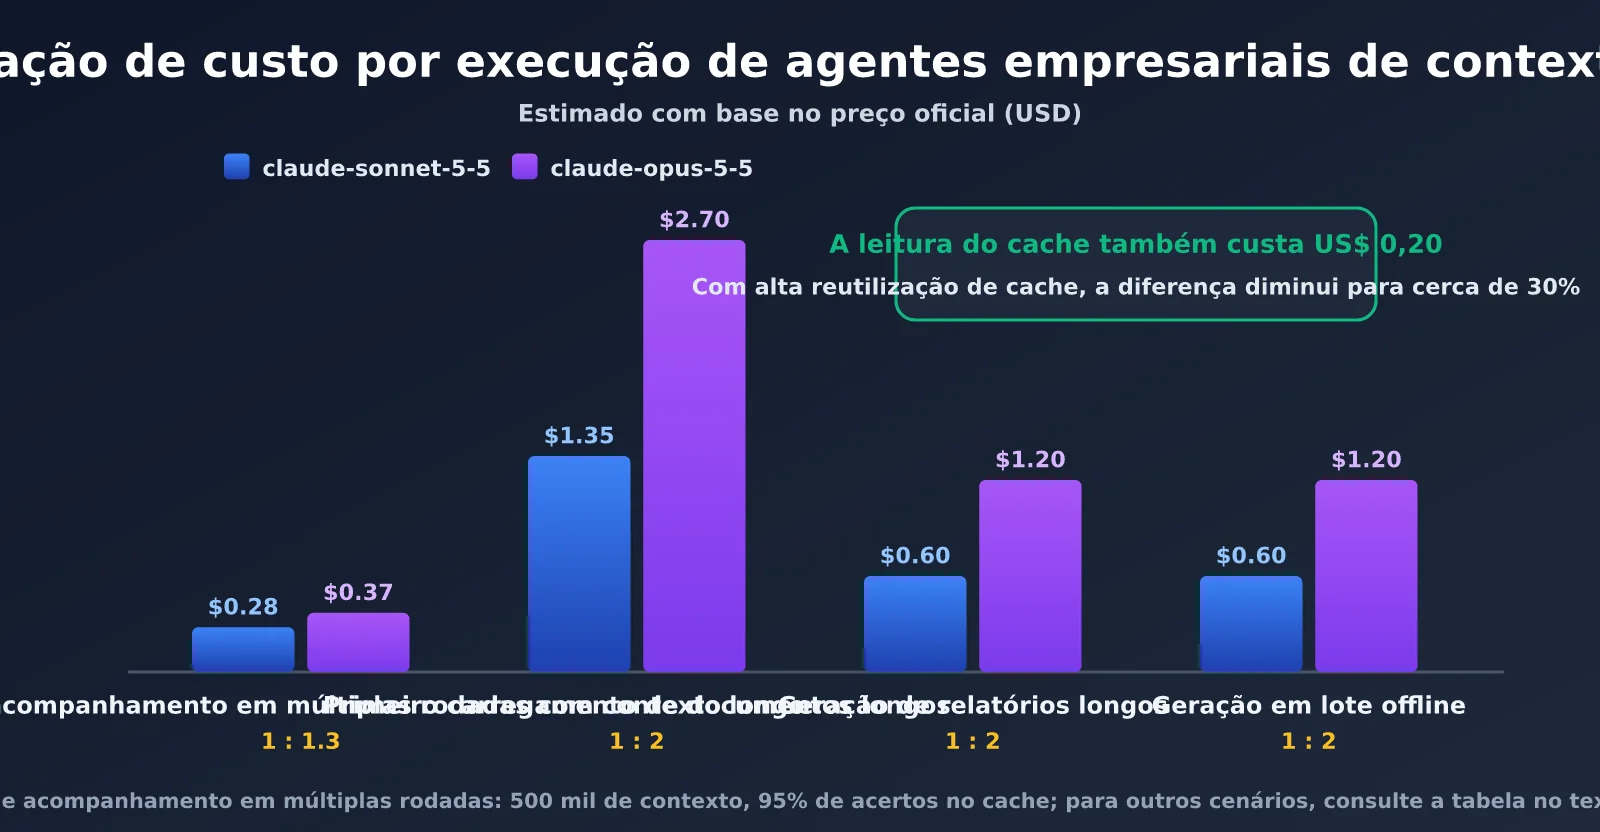
Esta tabela revela um padrão importante: em perguntas de múltiplas rodadas com “entrada longa + alto acerto no cache + saída curta”, o Opus custa apenas cerca de 30% a mais que o Sonnet. Isso acontece porque a leitura do cache, que representa a maior parte do custo, tem o mesmo preço nos dois modelos, enquanto o Opus ainda economiza Tokens de saída. Já nos cenários de “primeiro carregamento de documentos novos” e “geração com saída longa”, a vantagem de custo do Sonnet volta a ser de metade do preço. Em outras palavras, o Opus é indicado para “reler repetidamente o mesmo material extenso e fazer julgamentos”, enquanto o Sonnet funciona melhor para “absorver material novo de uma vez” ou “gerar grandes volumes de conteúdo”.
Há outro detalhe que pode gerar custos inesperados: o cache de comandos não pode ser compartilhado entre modelos. Se o Opus ler uma vez o mesmo documento de 500 mil Tokens e depois o Sonnet também o ler, será necessário pagar separadamente duas gravações no cache. Portanto, o ponto central de uma arquitetura com dois modelos é manter o contexto longo “residente” em apenas um deles e enviar ao outro somente resumos enxutos das tarefas.
Combinação recomendada de claude-sonnet-5-5 e claude-opus-5-5
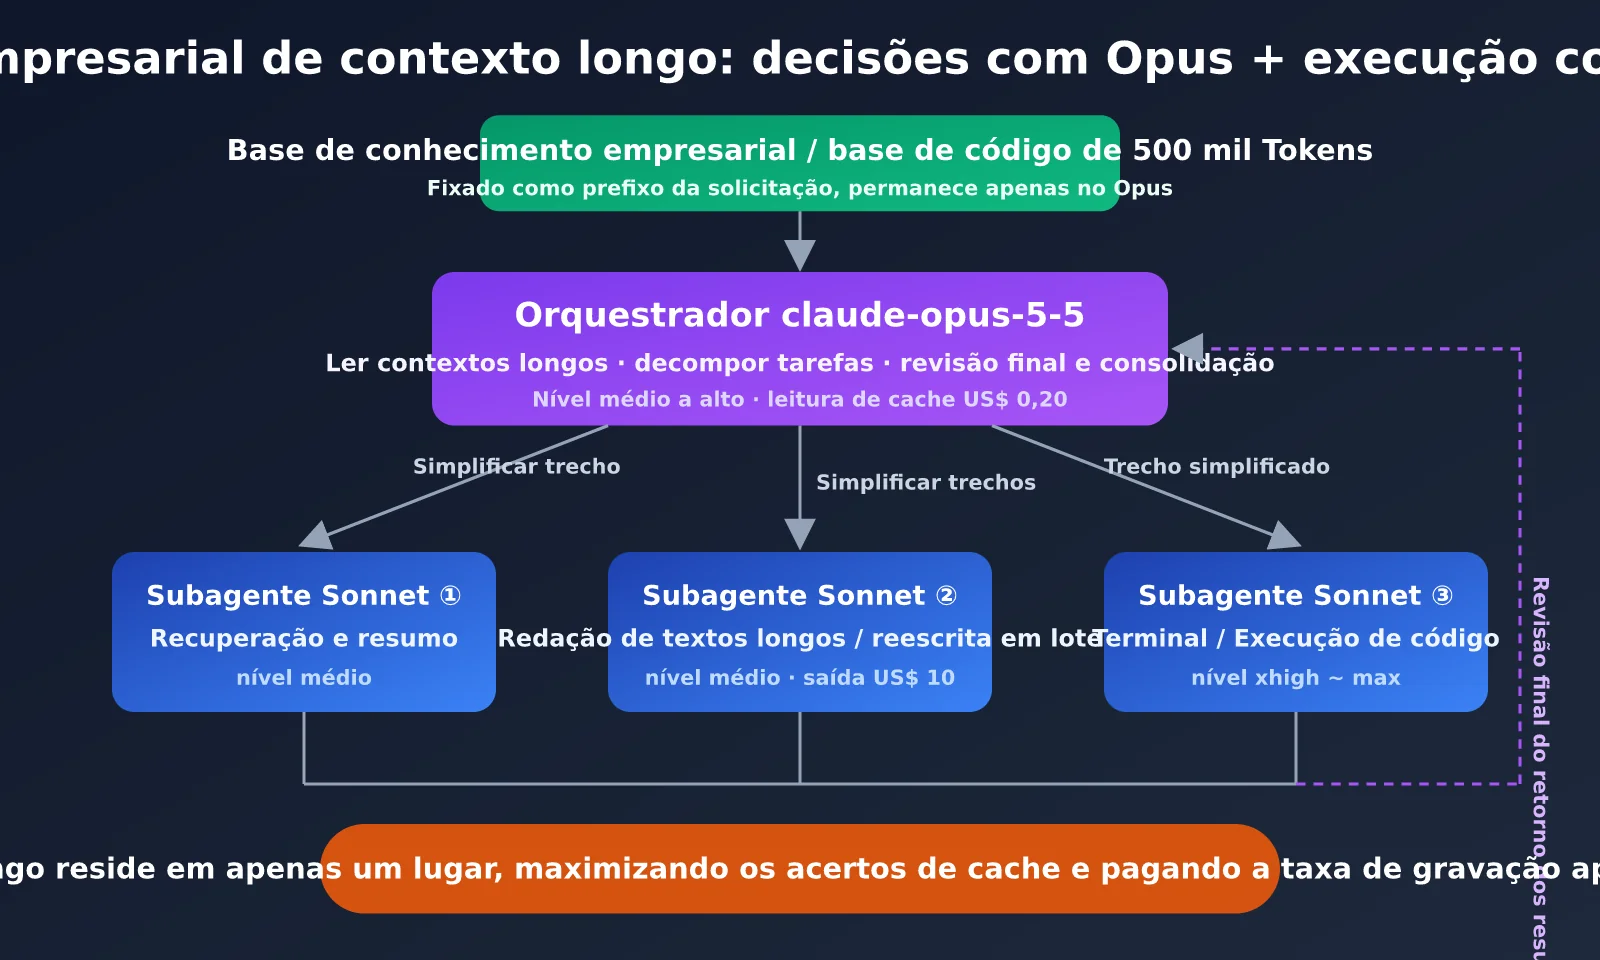
Com base nesses dados, recomendamos que Agents empresariais para conteúdo longo adotem uma arquitetura em camadas de “Opus decide, Sonnet executa”. Conforme o modelo que mantém o contexto longo, há dois padrões possíveis.
Padrão 1: Opus orquestra + sub-Agents Sonnet em paralelo
Ideal para cenários que exigem julgamentos complexos sobre materiais extensos, como revisão de contratos, migração de código entre repositórios e due diligence. O Opus mantém todo o contexto longo, com acertos recorrentes no cache, e fica responsável por compreender o panorama geral, dividir as tarefas e distribuí-las entre vários sub-Agents Sonnet. Cada Sonnet recebe apenas o trecho relevante e instruções claras, executando em paralelo rapidamente no nível medium. Por fim, o Opus consolida os resultados e faz a revisão final. Nesse padrão, o cache caro de contexto longo é pago uma única vez, enquanto o Sonnet produz grandes blocos de texto aproveitando o preço de saída pela metade.
Padrão 2: Sonnet no atendimento + Opus como escalonamento de contingência
Ideal para cenários interativos e de alto volume, como perguntas e respostas sobre a base de conhecimento corporativa, Agents de atendimento ou assistentes internos de TI. O Sonnet mantém o contexto longo e entrega a primeira resposta em cerca de 1 segundo no nível medium. Quando encontra uma solicitação com baixa confiança, que envolve decisões de conformidade ou que gera insatisfação explícita do usuário, ele encaminha ao Opus uma versão resumida da pergunta junto dos trechos essenciais. A maior parte do tráfego é processada pelo Sonnet com baixo custo, e apenas os poucos casos mais difíceis acionam o Opus.
| Papel do Agent | Modelo recomendado | Nível recomendado | Motivo |
|---|---|---|---|
| Orquestrador / planejador | claude-opus-5-5 | medium ~ high | Maior inteligência geral e precisão factual, com boa eficiência de Tokens |
| Análise de contexto longo e revisão final | claude-opus-5-5 | high ~ xhigh | Vantagem clara em julgamentos precisos com contexto longo |
| Redação longa / reescrita em lote | claude-sonnet-5-5 | medium | Preço de saída pela metade e geração mais rápida por segundo |
| Sub-Agent para terminal / execução de código | claude-sonnet-5-5 | xhigh ~ max | Melhor desempenho no nível máximo do Terminal-Bench |
| Atendimento conversacional em tempo real | claude-sonnet-5-5 | medium | Latência do primeiro Token de cerca de 1,3 segundo |
| Processamento em lote offline | claude-sonnet-5-5 | medium | Batch a US$ 1/US$ 5, com suporte a saídas longas de 300 mil Tokens |
Implementando orquestração com Opus + execução com Sonnet na mesma interface
Abaixo está um exemplo mínimo do padrão 1. Ele usa uma interface compatível com OpenAI, e ambos os modelos compartilham a mesma chave API:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "Leia o contrato completo abaixo e divida-o em 3 subtarefas independentes de revisão, uma por linha:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"Conclua a subtarefa e apresente a análise de revisão:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "Consolide e faça a revisão final das análises abaixo, gerando o relatório final:\n" + "\n".join(drafts), effort="high")
Expandir para ver: exemplo completo com sub-Agents paralelos e prefixo fixo de contexto longo
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. Mantenha o documento longo fixo no prefixo system, apenas no Opus, para facilitar acertos no cache em múltiplas rodadas
    base = [{"role": "system", "content": "Você é um orquestrador de análise de documentos empresariais. Este é o material completo:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"Objetivo:{goal}\nDivida em no máximo 5 subtarefas. Inclua em cada uma os trechos originais necessários e separe-as com ---."}])

    # 2. Cada sub-Agent Sonnet recebe somente os trechos resumidos e executa em paralelo
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"Conclua de forma independente a seguinte subtarefa e apresente uma conclusão estruturada:\n{t}"}])
        for t in tasks])

    # 3. Volte ao Opus para a revisão final, reutilizando o mesmo prefixo de contexto longo
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"Verifique se as conclusões das subtarefas abaixo estão consistentes com o texto original. Corrija eventuais erros e gere o relatório final:\n{merged}"}],
        effort="high")
    print("Uso de Tokens na revisão final:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "Identificar riscos de pagamento, inadimplência e propriedade intelectual no contrato"))
🚀 Comece rápido: contas oficiais da Claude têm requisitos mais rígidos quanto à região de cadastro e à forma de pagamento, e equipes empresariais frequentemente encontram obstáculos já na ativação. Você pode se cadastrar na APIYI em apiyi.com para obter créditos de teste e usar uma única chave API para chamar tanto
claude-opus-5-5quantoclaude-sonnet-5-5. Assim, você valida primeiro a arquitetura de dois modelos acima antes de avaliar o custo em escala.
Recomendações de decisão: claude-sonnet-5-5 vs claude-opus-5-5
Resumindo a análise anterior em 4 princípios práticos:
- Defina o nível antes de comparar os modelos: use Sonnet em medium~xhigh e Opus em medium~high, evitando o desperdício de Tokens causado pelo padrão high do Sonnet.
- Delegue contextos longos com alta reutilização de cache ao Opus: a leitura de cache tem o mesmo preço, e o Opus custa apenas cerca de 30% a mais, entregando maior precisão e menos retrabalho.
- Use o Sonnet para carregar materiais novos e gerar respostas longas: os preços de escrita em cache e de saída são metade dos do Opus; em tarefas offline, combine isso com o desconto de 50% do Batch.
- Mantenha o contexto longo em apenas um lugar: o cache não pode ser compartilhado entre modelos. Envie apenas trechos resumidos aos subagentes para evitar pagar repetidamente pela escrita em cache.
Quanto ao modo Fast do Opus, ele serve para cenários extremamente sensíveis ao tempo de resposta individual e com orçamento folgado. Mas ele dobra o preço e não compartilha cache. Para a maioria dos agentes empresariais, atribuir interações em tempo real ao Sonnet no nível medium costuma ser mais vantajoso do que ativar o Fast no Opus.
Perguntas frequentes
Q1: claude-opus-5-5 já é muito rápido. Ainda vale usar o claude-sonnet-5-5?
Vale. A velocidade do Opus vem principalmente de seu nível padrão mais baixo e de uma maior eficiência de Tokens. Ainda assim, o Sonnet continua claramente à frente em velocidade de saída por segundo e latência até o primeiro Token, além de custar metade no preço de saída. Para cenários como redação de textos longos, conversas em tempo real e subagentes paralelos, o Sonnet ainda é o executor mais indicado.
Q2: o claude-sonnet-5-5 no nível max pode substituir o Opus?
Em tarefas específicas, como programação no terminal, sim: o Sonnet (max) obteve até uma pontuação maior que o Opus no Terminal-Bench 4.0. Mas seu índice geral de inteligência ainda fica 2 pontos abaixo e, no nível max, o Sonnet consome mais Tokens. O custo total acaba ficando igual ou até um pouco maior que o do Opus. Se você precisa da qualidade máxima, usar o Opus diretamente costuma compensar mais.
Q3: como um Agent empresarial de documentos longos pode controlar os custos dos dois modelos?
O ponto central é aumentar a taxa de acerto do cache: mantenha documentos longos fixos no prefixo da solicitação e deixe apenas um modelo com o contexto completo. Os subagentes devem receber somente trechos resumidos. Recomendamos fazer as invocações pela APIYI apiyi.com e observar o uso de Tokens de cache retornado, ajustando gradualmente a estrutura do prefixo. Em geral, a taxa de acerto do cache é a alavanca mais eficaz para reduzir custos.
Q4: o que observar ao migrar do Sonnet 5 ou Opus 5 para o 5.5?
Os dois modelos 5.5 têm mudanças incompatíveis na API: o modo de raciocínio não pode ser desativado; chamadas obrigatórias de ferramentas (tool_choice definido como any ou tool) retornam erro 400; e as ferramentas antigas de operação de computador também precisam ser atualizadas. Antes de migrar, execute os casos de regressão em ambiente de testes e compare em paralelo as diferenças de saída entre os modelos novos e antigos antes de direcionar o tráfego de produção.
Resumo
Comparar claude-sonnet-5-5 com claude-opus-5-5 não é tão simples quanto dizer que “o mais caro é melhor e o mais barato é pior”. Após a redução de preço do Opus 5.5, a leitura de cache passou a custar o mesmo que no Sonnet, e o nível medium padrão já oferece alta eficiência. Ele se destaca de forma ampla em decisões precisas com contextos longos e inteligência geral. Já o Sonnet 5.5 tem vantagens difíceis de substituir em velocidade de resposta, custo de saída, programação no terminal e execução com alta concorrência. Portanto, o Sonnet não se resume à vantagem de preço — seus pontos fortes aparecem quando é usado no nível e na função certos.
Para Agents corporativos que lidam com grandes volumes de entrada e saída de conteúdo, a combinação mais adequada é “Opus decide, Sonnet executa”: o Opus mantém o contexto longo e cuida do planejamento e da revisão final; o Sonnet trabalha em paralelo no nível medium para redigir e executar tarefas; a parte offline fica com o Batch. Na prática, você pode começar fixando os níveis e executando testes comparativos, depois dividir os Agents conforme a tabela de papéis deste artigo e, por fim, otimizar continuamente os custos com base em dois indicadores: taxa de acerto de cache e Tokens de saída.
Se quiser validar rapidamente essa estratégia de dois modelos, recomendamos usar a APIYI apiyi.com para chamar claude-opus-5-5 e claude-sonnet-5-5 de forma unificada. A interface da plataforma é compatível com o formato OpenAI, e uma única chave permite alternar livremente entre os dois modelos — ideal para testes de seleção e orquestração multimodelo em ambientes de produção.
Referências:
– Documentação de preços da Anthropic: platform.claude.com/docs/en/about-claude/pricing
– Documentação do modo Fast da Anthropic: platform.claude.com/docs/en/build-with-claude/fast-mode
– Comparativo entre Sonnet 5.5 e Opus 5.5 da Artificial Analysis: artificialanalysis.ai
– Análise do lançamento do Opus 5.5 pela Digital Applied: digitalapplied.com
– Comparativos Sonnet 5.5 vs Opus 5.5 da Kingy AI e Emergent: kingy.ai、emergent.sh
Sobre o autor: equipe técnica da APIYI, especializada em integração de APIs de Modelos de Linguagem Grandes e práticas de engenharia. Entre em contato pela APIYI apiyi.com para trocar experiências sobre orquestração de Agents e otimização de custos com claude-opus-5-5 e claude-sonnet-5-5.