Nota do autor: depois que celulares e navegadores passaram a sintetizar voz localmente, ainda vale manter uma API de voz na nuvem? Este artigo ajuda você a decidir com base em 4 dimensões: offline, privacidade, qualidade de áudio e textos longos, e escolha de modelo específico com cobrança unificada.
Cada vez mais sistemas de celular e navegadores conseguem ler texto em voz alta direto no dispositivo. Por isso, com a voz no dispositivo já funcionando, ainda vale manter a API de voz na nuvem? Essa pergunta virou inevitável para quem desenvolve produtos de voz. Tem gente defendendo migrar tudo para o local e economizar nas chamadas, e tem quem tema que as vozes locais não sustentem um produto de verdade.
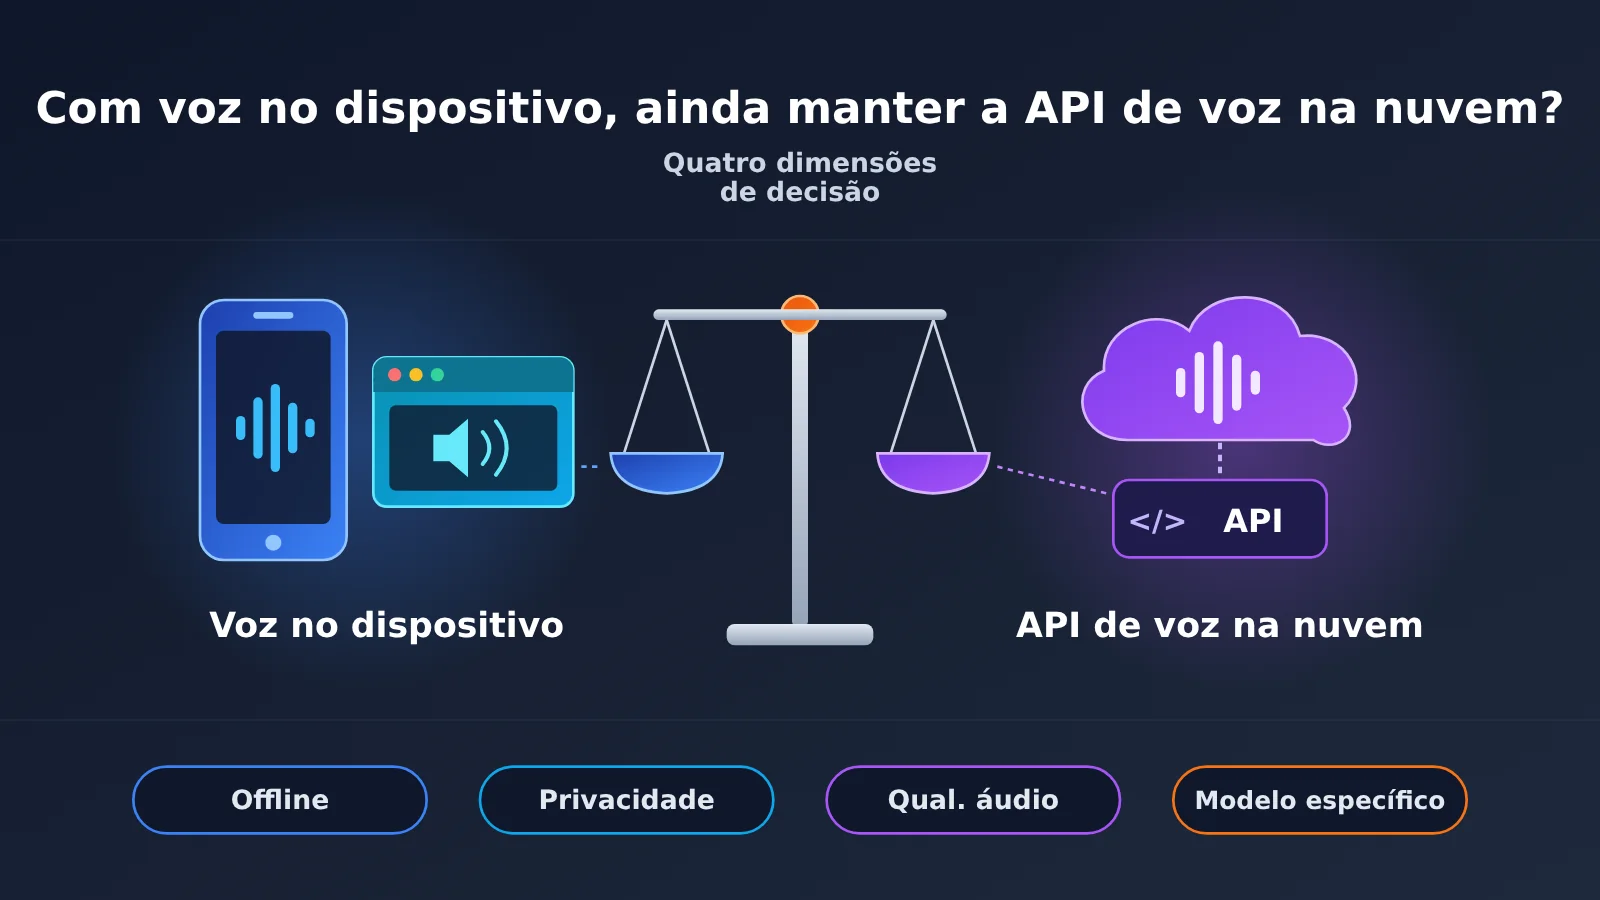
Não é uma escolha de “ou isso ou aquilo”. O dispositivo e a nuvem têm limites diferentes, e a decisão depende de quatro coisas: se o seu produto precisa funcionar offline, o quanto a privacidade importa, qual qualidade de áudio e que tamanho de texto você precisa suportar, e se é obrigatório usar um modelo específico.
Valor central: ao terminar a leitura, você vai conseguir avaliar, dimensão por dimensão, como dividir o trabalho entre dispositivo e nuvem no seu produto, sem precisar escolher um lado só.
Voz no dispositivo chegou: resumo das informações principais
Vamos separar o que já dá para confirmar do que ainda não se sabe. A direção geral da voz no dispositivo é clara, mas faltam números públicos e comparáveis de latência e qualidade de áudio para cada modelo local. Por isso, este artigo não faz suposições e marca esses pontos como desconhecidos.
| Item | Detalhes |
|---|---|
| O que mudou | O sistema do celular e o navegador já conseguem fazer a conversão de texto em fala localmente, sem conexão com a internet |
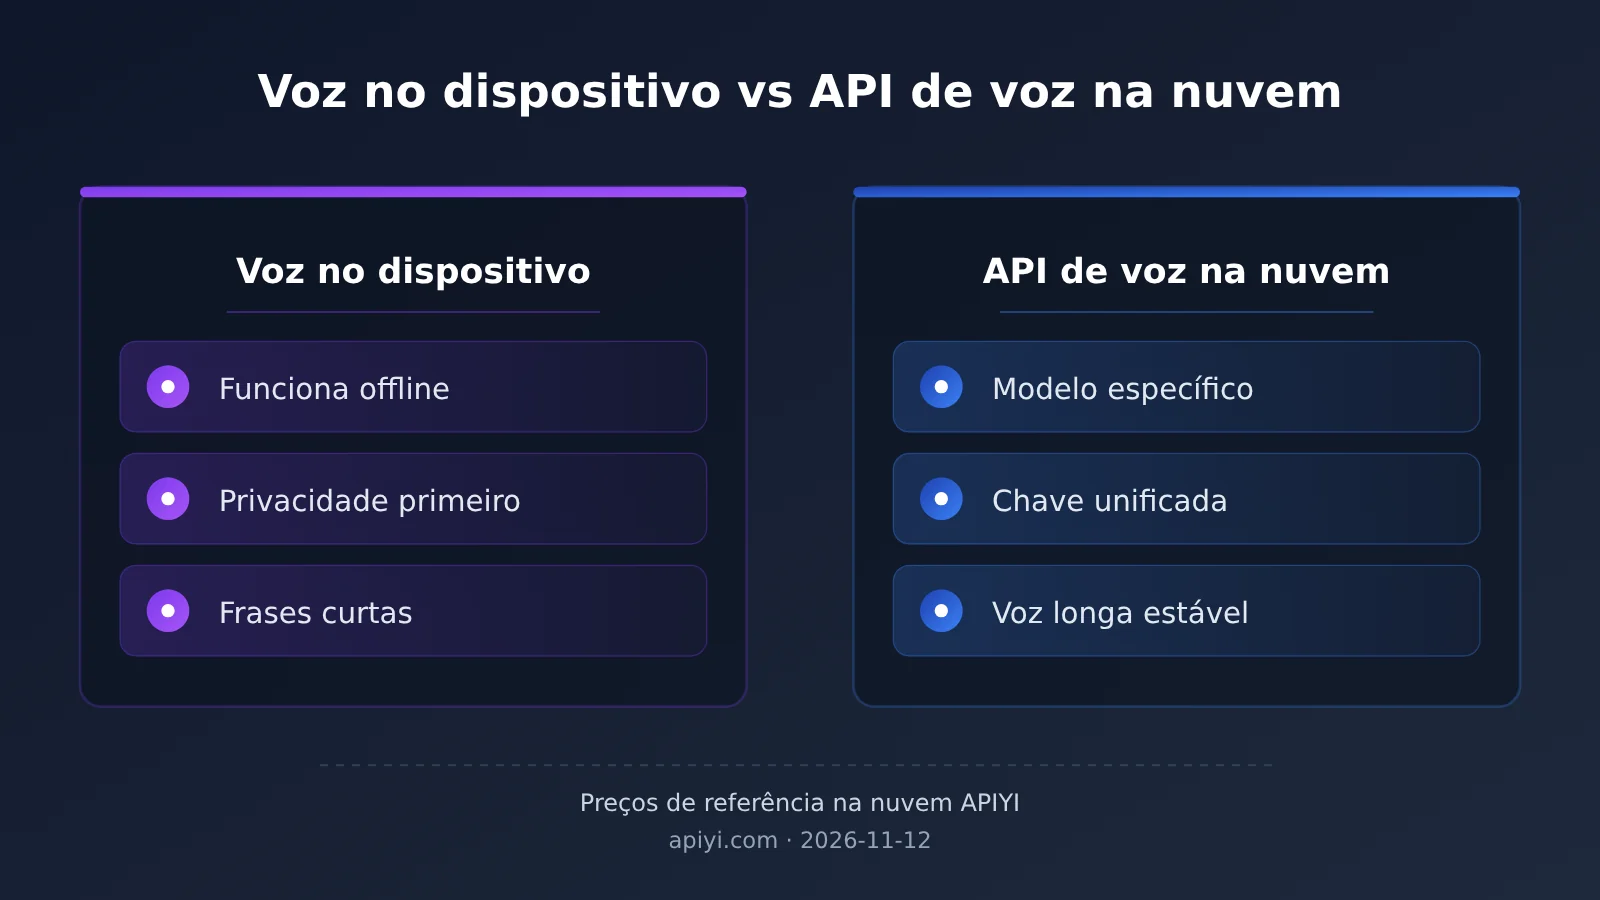
| Pontos fortes do on-device | Funciona offline, os dados não saem do dispositivo, ideal para avisos curtos |
| Pontos desconhecidos do on-device | Não há dados públicos unificados de latência nem notas de qualidade de áudio para cada solução, então tratamos como desconhecidos |
| Pontos fortes da nuvem | Dá para escolher o modelo específico, usar a mesma chave API dos modelos de texto e ter mais estabilidade em áudios longos |
| Modelos disponíveis na nuvem | Em 12/11/2026, a tabela de preços da APIYI ainda lista tts-1, tts-1-hd, gpt-realtime-2.1 e gpt-realtime-2.1-mini |
| Quem é afetado | Equipes de produto que trabalham com avisos por voz, assistentes de voz e conversas de voz em tempo real |
O que a voz no dispositivo faz e o que não garante
O benefício mais direto da voz no dispositivo é “falar mesmo sem internet”. Avisos de navegação, apoio à leitura e sons curtos dentro de apps são cenários com frases curtas e uso frequente, e a síntese local dá conta do recado. Ela ainda elimina uma ida e volta pela rede. Como os dados ficam no aparelho, a pressão de conformidade também cai bastante em produtos que lidam com textos sensíveis, como saúde e finanças.
Só que as vozes e a qualidade que a voz no dispositivo entrega dependem do aparelho do usuário. O mesmo produto pode soar totalmente diferente em celulares de marcas e versões de sistema distintas, e é difícil para o desenvolvedor garantir uma experiência consistente. Quanto um modelo local é mais lento ou tem qualidade de áudio pior do que a nuvem, ainda não existem números públicos confiáveis. Na hora de decidir, o melhor é testar com uma amostra dos dispositivos reais do seu produto.
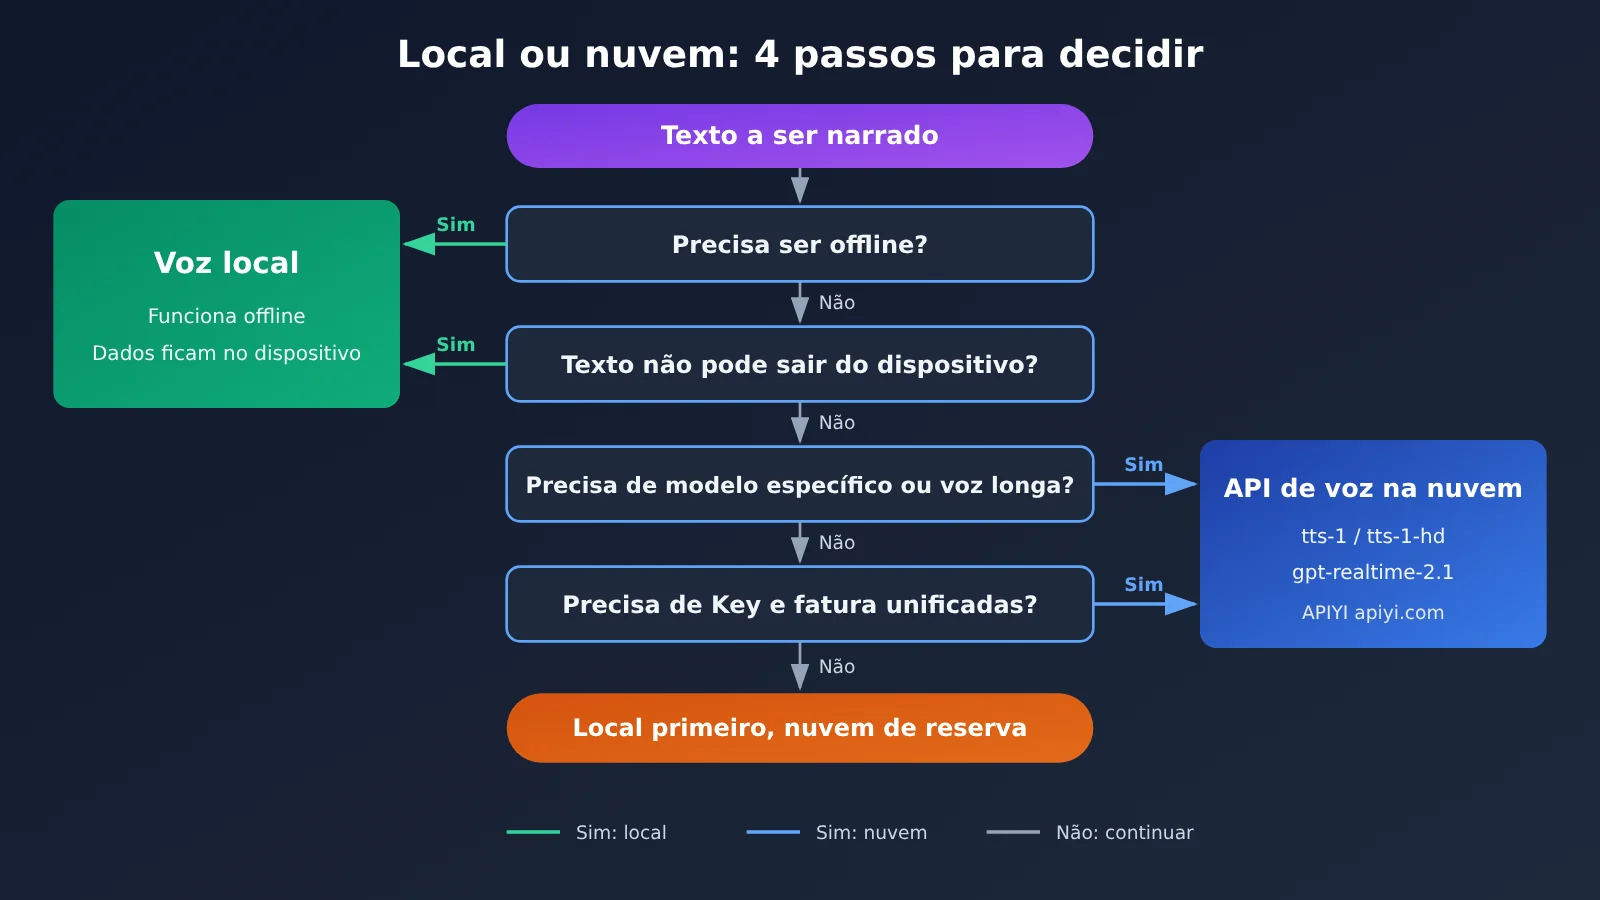
Como dividir o trabalho entre voz no dispositivo e API de voz na nuvem
Em vez de ficar discutindo se vale a pena manter a nuvem, é mais produtivo quebrar a questão em 4 dimensões. A tabela abaixo mostra, para cada dimensão, qual lado costuma ser mais adequado e qual pergunta você deve se fazer na hora de decidir.
| Dimensão | Mais adequada para voz no dispositivo | Mais adequada para API de voz na nuvem | Pergunta para se fazer |
|---|---|---|---|
| Offline | Ambientes sem rede ou com rede fraca, onde o produto precisa falar mesmo assim | Usuários quase sempre online | Se a conexão cair, o produto ainda precisa continuar falando? |
| Privacidade | Texto sensível, que não pode sair do dispositivo | Texto que pode ser enviado para processamento | Alguma exigência de conformidade proíbe que os dados saiam do terminal? |
| Qualidade de áudio e voz longa | Frases curtas, sons de aviso, pouca exigência quanto ao timbre | Leitura de textos longos, alta exigência de consistência de timbre | Dá para aceitar que cada dispositivo leia com uma voz diferente? |
| Modelo específico e cobrança unificada | Não há essa necessidade | É preciso fixar o modelo e usar a mesma chave que os modelos de texto | Você precisa fixar um modelo específico, como tts-1-hd ou gpt-realtime-2.1? |
Offline e privacidade: o território da voz no dispositivo
Se o seu produto costuma ser usado no metrô, em regiões montanhosas ou dentro de aviões, o modo offline é um requisito obrigatório, e a voz no dispositivo deve assumir a maior parte das locuções. Da mesma forma, se a regra do negócio diz que o texto digitado pelo usuário não pode ser enviado para fora, a voz no dispositivo é praticamente a única opção. Nessas duas dimensões, a API de voz na nuvem funciona mais como um “reforço quando há conexão” do que como peça principal.
Qualidade, voz longa e modelo específico: o território da API de voz na nuvem
Quando o produto precisa de um timbre de marca padronizado, de leitura estável de artigos longos ou de conversas por voz em tempo real, fica muito difícil substituir a nuvem. Na nuvem, você pode escolher o modelo de forma explícita: por exemplo, usar o tts-1 para as locuções do dia a dia, o tts-1-hd quando quiser mais qualidade de áudio, e o gpt-realtime-2.1 ou o gpt-realtime-2.1-mini para as conversas em tempo real. Assim, todos os usuários ouvem a saída do mesmo modelo.
Outro ponto que costuma passar batido é o gerenciamento de cobrança e de chaves. Além da voz, a maioria dos produtos também chama Modelos de Linguagem Grandes de texto para compreensão, resumo ou geração de diálogo. Se voz e texto usam a mesma chave e a mesma fatura, a operação e a conciliação das contas ficam bem mais simples.
Como integrar a API de voz na nuvem: mantenha um canal estável
Mesmo que você decida priorizar o processamento no dispositivo, vale a pena manter um canal na nuvem como plano B e como reforço. A APIYI usa uma interface compatível com a OpenAI, então a integração é praticamente igual a chamar o SDK oficial: basta trocar o base_url.
Os passos de integração resumem-se assim:
- Inicializar o cliente:
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Chamar a síntese de voz:
client.audio.speech.create(model="tts-1", voice="alloy", input="您的订单已发货") - Se precisar de qualidade de áudio melhor, troque o model por
tts-1-hde mantenha os demais parâmetros iguais - O modelo de texto também aponta para
https://api.apiyi.com/v1, então voz e texto usam a mesma chave API
A conexão para conversas de voz em tempo real (série gpt-realtime-2.1) é diferente de uma requisição HTTP comum. Os parâmetros exatos de integração estão na central de documentação da APIYI, que é a referência oficial.
| Modelo | Tipo | Uso típico | Plataforma disponível |
|---|---|---|---|
| tts-1 | Texto para voz | Avisos de rotina, leitura de notificações | APIYI apiyi.com |
| tts-1-hd | Texto para voz (alta qualidade) | Leitura de textos longos, voz de marca | APIYI |
| gpt-realtime-2.1 | Conversa de voz em tempo real | Assistentes de voz, interação em tempo real | APIYI |
| gpt-realtime-2.1-mini | Conversa de voz em tempo real (leve) | Cenários em tempo real mais sensíveis a custo | APIYI |
🚀 Comece rápido: se você está avaliando se vale a pena manter a voz na nuvem, cadastre-se na APIYI (apiyi.com) e use a cota de teste gratuita para novos usuários. Passe o mesmo trecho de texto para o tts-1 e para o tts-1-hd e compare com a leitura local do dispositivo. Assim dá para ver se a diferença justifica pagar por isso.
Impacto da voz on-device: uma análise
Impacto para os desenvolvedores
- A arquitetura deixa de ser uma escolha única e vira híbrida: o módulo de voz precisa de uma camada de roteamento, que decide entre on-device e nuvem com base no estado da rede, na sensibilidade do texto e no tamanho do texto
- O custo de teste sobe: o resultado on-device depende do aparelho do usuário, então é preciso amostrar diferentes modelos de dispositivo e navegadores, enquanto a saída na nuvem é relativamente consistente
- A lógica de fallback passa a ser indispensável: se a nuvem falhar, faz-se o rebaixamento para o on-device; se o on-device não estiver disponível, volta-se para a nuvem. Os dois caminhos servem de backup um para o outro
Impacto na arquitetura do produto
A forma mais comum de implementar uma arquitetura híbrida é definir, para cada tipo de tarefa de voz, um canal padrão e um canal de rebaixamento. A tabela abaixo pode servir direto como ponto de partida para o design.
| Tarefa de voz | Canal padrão | Canal de rebaixamento | Motivo |
|---|---|---|---|
| Avisos curtos, orientações de navegação | Voz on-device | tts-1 na nuvem | Frases curtas funcionam bem localmente, e o modo offline precisa estar disponível |
| Leitura de texto sensível | Voz on-device | Sem rebaixamento para a nuvem | Os dados não podem sair do dispositivo |
| Artigos longos, conteúdo em áudio | tts-1-hd na nuvem | Voz on-device | Timbre consistente e mais estabilidade em áudios longos |
| Conversa de voz em tempo real | gpt-realtime-2.1 na nuvem | gpt-realtime-2.1-mini | É preciso especificar o modelo, e a interação em tempo real depende da nuvem |
Impacto no cálculo de custos
A voz on-device não é cobrada por invocação, e esse é o motivo pelo qual muitas equipes querem migrar toda a voz para o dispositivo. Mas vale ficar atento: o que se economiza em tarifas de invocação pode virar custo de adaptação e de testes, além da perda de usuários por causa da experiência pior em aparelhos de entrada. Uma abordagem mais sensata é migrar para o on-device apenas as frases curtas de alta frequência e deixar na nuvem as tarefas sensíveis à qualidade. Assim, o volume de invocações na nuvem cai naturalmente, sem prejudicar a experiência no que é crítico.
Perguntas frequentes (FAQ)
P1: Já temos voz no dispositivo. Dá para desligar a API de voz na nuvem de vez?
Para a maioria dos produtos, não recomendamos desligar de vez. A voz no dispositivo resolve o uso offline e a privacidade, mas a escolha de modelos específicos, a estabilidade em áudios longos e a consistência de timbre ainda dependem da nuvem. O caminho mais seguro é usar o dispositivo como solução principal e a nuvem como plano B e reforço.
P2: Qual é a diferença de qualidade de áudio e latência entre a voz no dispositivo e a API de voz na nuvem?
Hoje não existe um número de avaliação pública unificado que possamos citar, e o desempenho de cada solução no dispositivo também varia conforme o aparelho. Por isso, tratamos essa diferença como desconhecida. O ideal é fazer uma amostragem de escuta nos aparelhos mais usados pelo seu público e comparar com a saída de tts-1 e tts-1-hd na nuvem.
P3: Até agora, quais modelos de voz ainda podem ser chamados na nuvem?
Em 12/11/2026, a tabela de preços da APIYI ainda oferece tts-1 e tts-1-hd, além de gpt-realtime-2.1 e gpt-realtime-2.1-mini para voz em tempo real. A lista de modelos pode mudar a qualquer momento, então vale sempre conferir a tabela de preços atualizada da plataforma.
P4: Como usar uma única chave para chamar modelos de voz e de texto?
Basta gerar uma chave API em apiyi.com (APIYI) e definir o base_url como `https://api.apiyi.com/v1`. Síntese de voz, voz em tempo real e modelos de texto como GPT, Claude e Gemini passam todos pela mesma porta de entrada, e a cobrança também fica unificada, o que facilita a conciliação por uso.
P5: Na arquitetura híbrida, o que fazer quando a chamada na nuvem falha?
Adicione uma camada de fallback no roteamento de voz: se a requisição na nuvem der timeout ou erro, frases curtas e não sensíveis podem voltar para a leitura no dispositivo, e em áudios longos dá para pedir que o usuário tente novamente mais tarde. Em cenários de conversa em tempo real, você pode alternar entre gpt-realtime-2.1 e gpt-realtime-2.1-mini.
Pontos-chave: voz no dispositivo vs. API de voz na nuvem
- Não é uma escolha excludente: a voz no dispositivo e a API de voz na nuvem têm papéis diferentes, e cada tarefa vai para o canal mais adequado
- No dispositivo: offline e privacidade: funciona sem internet e os dados não saem do aparelho, ideal para frases curtas e sons de aviso
- Na nuvem: qualidade e consistência: áudios longos, timbre de marca e conversa em tempo real ainda dependem dos modelos na nuvem
- Modelo específico só pela nuvem: para travar o tts-1-hd ou o gpt-realtime-2.1, o caminho é a API
- Desempenho no dispositivo é incógnita: onde não há números públicos, vale o que você medir em amostras no seu próprio aparelho
- Chave única, menos manutenção: com a APIYI (apiyi.com), os modelos de voz e de texto compartilham a mesma chave API e a mesma fatura
Resumo
Se a voz no dispositivo já está disponível, ainda vale manter a API de voz na nuvem? Depende de 4 critérios:
- Offline: tarefas que precisam funcionar sem internet ficam com a voz no dispositivo
- Privacidade: tarefas em que o texto não pode sair do aparelho usam somente o dispositivo
- Qualidade de áudio e áudios longos: tarefas que exigem consistência e estabilidade ficam na nuvem
- Modelo específico e fatura unificada: se você precisa travar um modelo e compartilhar a mesma chave com os modelos de texto, continue usando a API na nuvem
A conclusão é clara: o dispositivo resolve offline e privacidade, enquanto modelo específico e fatura unificada continuam na nuvem. Minha sugestão é migrar primeiro as frases curtas de alta frequência para o dispositivo e manter na nuvem os áudios longos e a conversa em tempo real. Pela APIYI (apiyi.com), você chama as séries tts-1, tts-1-hd e gpt-realtime-2.1 de forma unificada e pode validar o resultado com o crédito gratuito de teste antes de decidir a proporção de cada canal.
📚 Referências
- Central de Documentação da APIYI: instruções de síntese de voz e acesso a voz em tempo real
- Link:
docs.apiyi.com -
Descrição: consulte os parâmetros de invocação e as formas de integração de modelos como tts-1 e gpt-realtime-2.1
-
Central de Ajuda da APIYI: tutoriais de uso da plataforma e perguntas frequentes
- Link:
help.apiyi.com - Descrição: ótima para quem está fazendo a primeira integração, com informações sobre como solicitar a chave API, cobrança e lista de modelos
Autor: Equipe técnica da APIYI
Troca de experiências técnicas: fale com a gente na página inicial do site da APIYI, apiyi.com. Para mais materiais, acesse a Central de Documentação em docs.apiyi.com