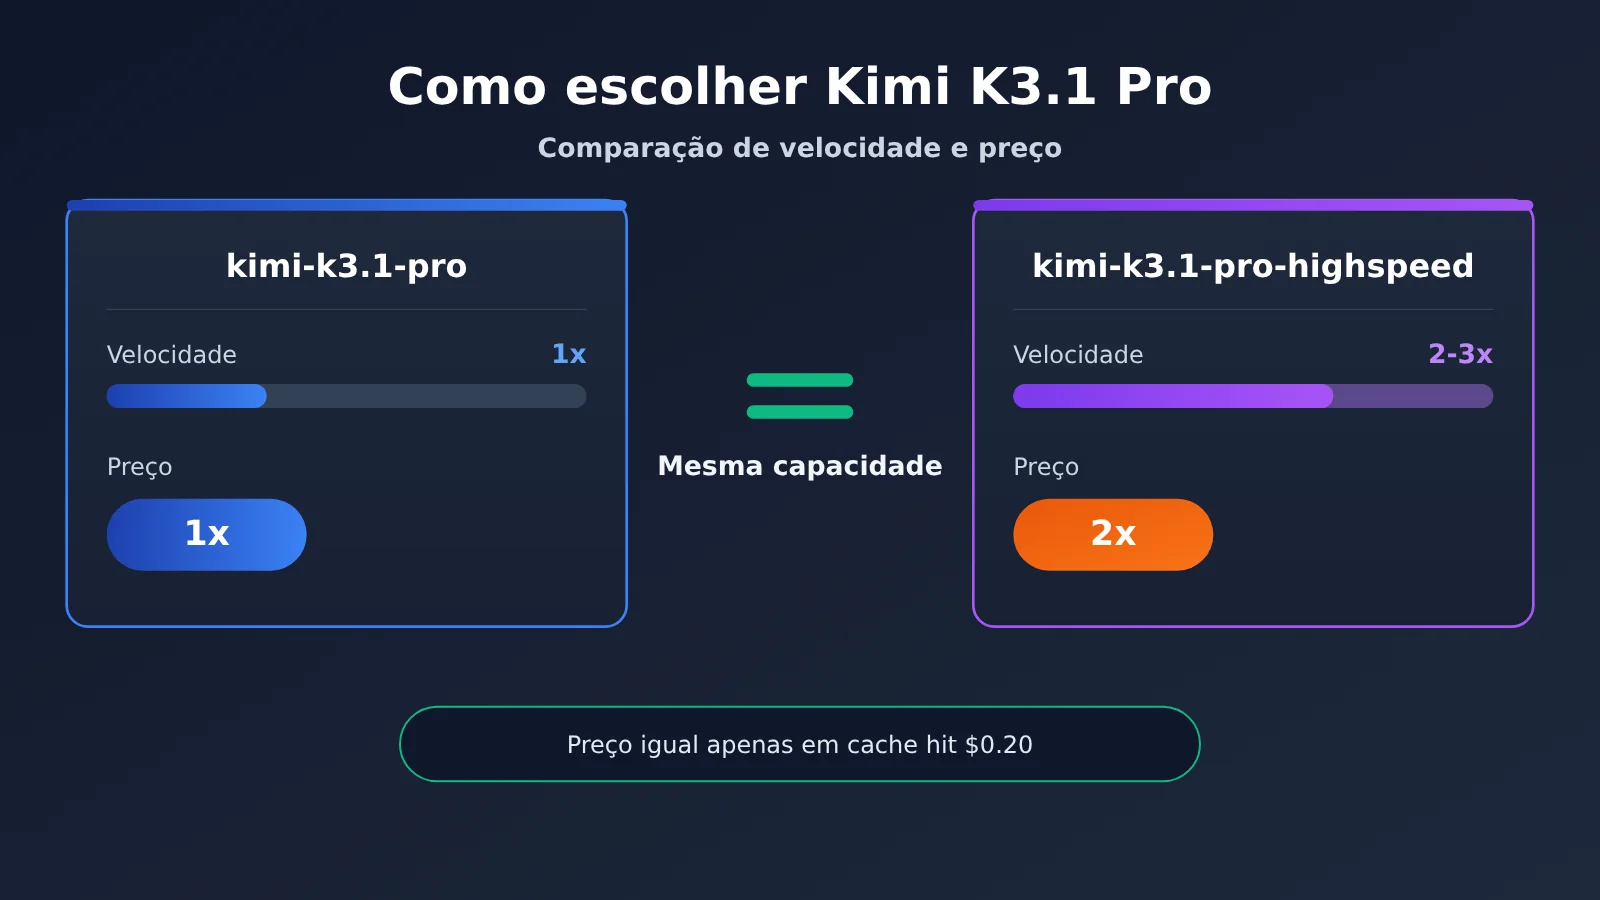
Kimi K3.1 Pro e a versão Highspeed têm as mesmas capacidades. O que a Highspeed oferece a mais é velocidade: segundo a Moonshot, ela é de 2 a 3 vezes mais rápida. Em compensação, os preços praticamente dobram em todas as faixas — só o preço para acerto de cache continua igual: US$ 0,20 nas duas versões. Por isso, se você fica olhando para a tela enquanto espera o resultado, faz sentido escolher a Highspeed. Para tarefas em lote que rodam em segundo plano, a versão padrão tende a ser a melhor opção.
A conclusão acima se apoia em três fontes: o blog oficial da Moonshot afirma que os dois modelos têm “same capabilities”; a página oficial de preços lista cinco valores por unidade; e a documentação oficial do Kimi Code informa que a Highspeed consome aproximadamente o dobro da cota. A seguir, cada informação será identificada como “informação oficial”, “fonte de terceiros” ou “não verificada”. Quando não houver dados, vou dizer isso diretamente, sem inventar estimativas como se fossem resultados de testes.
Este artigo não compara qual modelo é mais inteligente. Como os dois têm as mesmas capacidades, a questão é outra: vale a pena pagar o dobro para receber um resultado da mesma qualidade mais rápido?
O que você vai encontrar aqui: uma tabela com preços em cinco faixas, um método para converter tempo de espera em dinheiro, dois cálculos que você pode conferir por conta própria e uma tabela com recomendações para seis tipos de cenário.
1. Principais diferenças entre Kimi K3.1 Pro e Highspeed: mesmas capacidades, só mudam a velocidade e o preço
Vamos começar pelo panorama geral. A tabela abaixo reúne os aspectos que podem ser comparados entre os dois modelos. A última coluna indica a categoria da fonte de cada informação. A janela de contexto é o volume total de texto que o modelo consegue “ver” de uma vez, medido em tokens. Token é a unidade básica usada para calcular custos e processamento do modelo — pense nele, de forma aproximada, como um fragmento de palavra.
| Critério de comparação | kimi-k3.1-pro (versão padrão) | kimi-k3.1-pro-highspeed | Categoria da fonte |
|---|---|---|---|
| Capacidade do modelo | Referência | Igual à versão padrão | Informação divulgada oficialmente |
| Tamanho da janela de contexto | 1.048.576 tokens | 1.048.576 tokens | Informação divulgada oficialmente |
| Velocidade de geração | Referência | Segundo a empresa, de 2 a 3 vezes mais rápido | Informação divulgada oficialmente, sem dados detalhados |
| Preço por unidade | Referência | 2 vezes maior, exceto quando há acerto de cache | Preços oficiais |
| Requisito para usar o Kimi Code | Assinatura Plus ou superior (janela de contexto de 1 milhão exige Pro ou superior) | Assinatura Pro ou superior | Documentação oficial |
| Consumo da cota no Kimi Code | Referência | Cerca de 2 vezes maior | Documentação oficial |
| Canais oficiais disponíveis | kimi.ai, Kimi Work, Kimi Code, Kimi API | Os mesmos | Blog oficial |
A tabela mostra algo simples: além da velocidade, do preço e dos requisitos da assinatura, não há outras diferenças entre os dois modelos. Escolher o modelo errado não afeta os resultados — só faz você gastar mais dinheiro ou mais tempo.
1.1 Comparação de preços entre Kimi K3.1 Pro e Highspeed (as cinco faixas)
Os preços abaixo foram coletados em 24/10/2026, em dólares por milhão de tokens, sem impostos. A fonte é a tabela oficial de preços. Antes, vamos explicar alguns itens de cobrança. “Entrada” é o conteúdo que você envia ao modelo; “saída” é o conteúdo que o modelo gera. “Cache” se refere a um mesmo trecho de prefixo — por exemplo, o código de um projeto que você envia repetidamente — armazenado temporariamente pela plataforma. Quando esse prefixo aparece de novo em uma solicitação, ele é reutilizado, o que chamamos de “acerto de cache” e é cobrado por um preço menor. Na primeira vez que o conteúdo é armazenado no cache, há uma cobrança de “gravação”, com duas opções de retenção: 5 minutos e 1 hora.
| Item de cobrança | kimi-k3.1-pro | kimi-k3.1-pro-highspeed | Multiplicador |
|---|---|---|---|
| Entrada (sem acerto de cache) | $2.00 | $4.00 | 2 vezes |
| Saída | $10.00 | $20.00 | 2 vezes |
| Entrada com acerto de cache | $0.20 | $0.20 | Igual, único item sem aumento |
| Gravação no cache (5 minutos) | $2.00 | $4.00 | 2 vezes |
| Gravação no cache (1 hora) | $4.00 | $8.00 | 2 vezes |
Os registros públicos do desenvolvedor independente Simon Willison também confirmam isso: o Highspeed custa o dobro, mas o preço da entrada com acerto de cache é igual ao da versão padrão. Esse detalhe afeta os cálculos a seguir. Se a maior parte da entrada das suas solicitações tiver acerto de cache, o custo total efetivo do Highspeed será menor do que o dobro, porque o maior componente de entrada não fica mais caro.
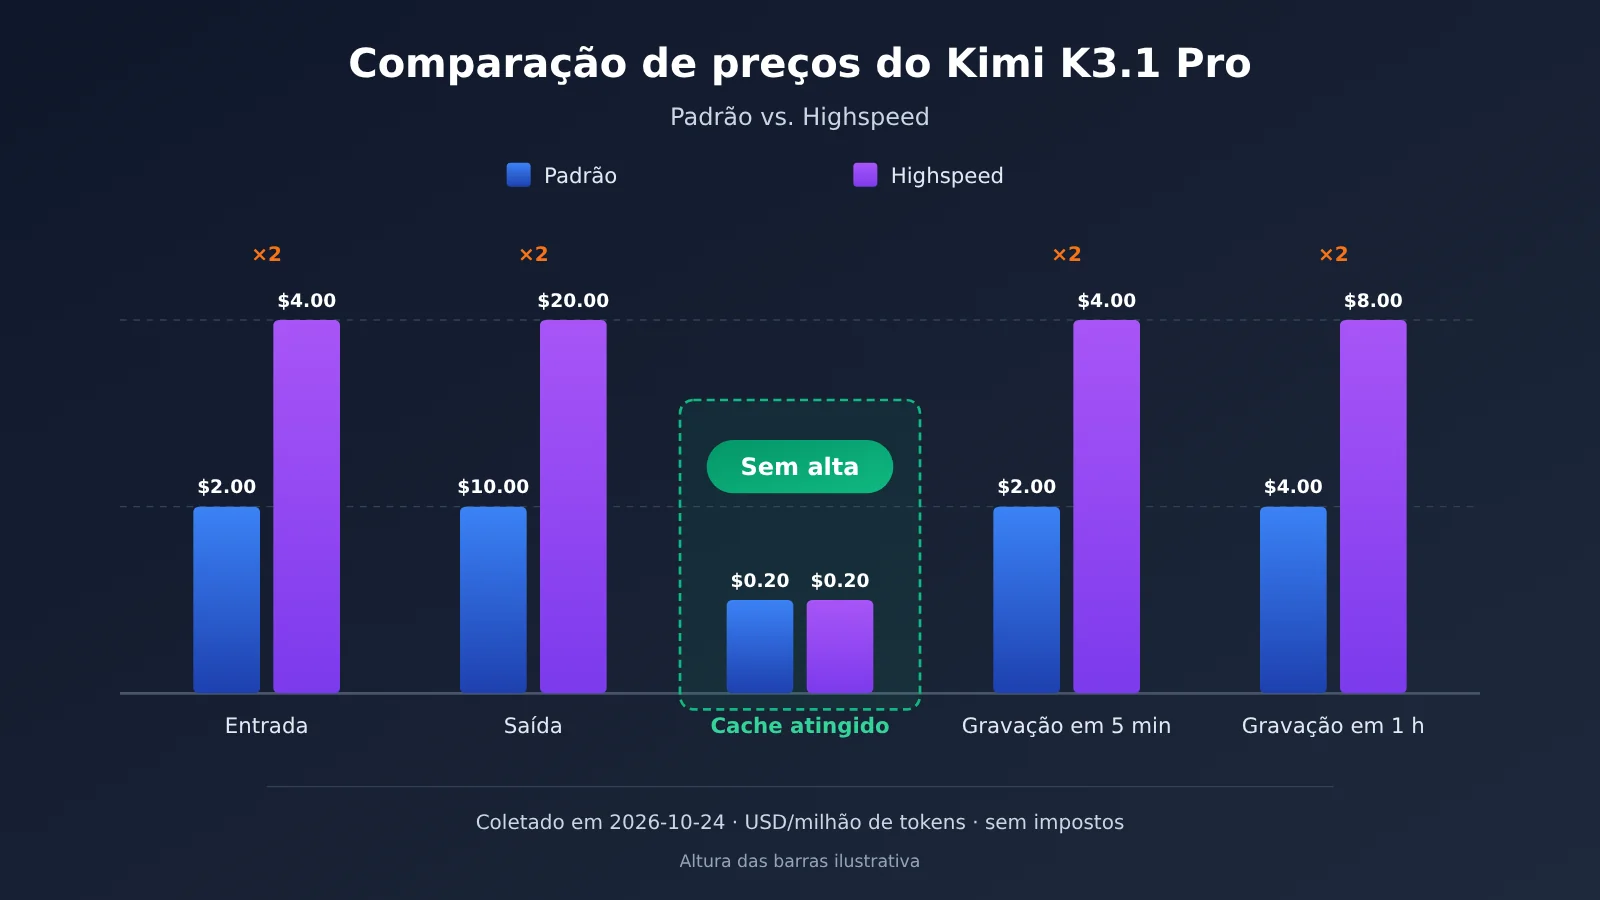
Observação sobre os preços: os valores do gráfico e da tabela acima são os preços oficiais. Se você fizer chamadas pela APIYI apiyi.com, consulte a lista de modelos da plataforma para ver os nomes e preços disponíveis. Esses dois modelos ainda estão em processo de integração à plataforma; vamos disponibilizá-los o quanto antes.
2. Qual é a diferença de velocidade do Kimi K3.1 Pro Highspeed?
Vamos ser sinceros: há pouquíssimos dados de velocidade disponíveis no momento. A documentação oficial informa apenas uma faixa de multiplicação; terceiros testaram somente a versão padrão. Nenhum benchmark público mediu quantos tokens por segundo o Highspeed gera. Tokens por segundo indica quantos tokens o modelo consegue produzir a cada segundo. Quanto maior o valor, menos tempo você espera pela resposta completa.
| Item | Valor | Classificação da fonte | Observações |
|---|---|---|---|
| Velocidade do Highspeed em relação à versão padrão | 2 a 3 vezes a da versão padrão | Informação divulgada pela própria empresa | As condições de teste e os dados detalhados não foram divulgados |
| Velocidade de saída da versão padrão | 80,7 tokens por segundo | Terceiros (Artificial Analysis) | Corresponde à faixa 2 de uma escala de quatro níveis |
| Velocidade de saída do Highspeed | Não disponível | Não verificada | Terceiros ainda não fizeram uma medição independente |
| Média de tokens gerados por tarefa pela versão padrão | Cerca de 55 mil tokens | Terceiros (Artificial Analysis) | Refere-se às tarefas do teste Intelligence Index |
| Custo por tarefa da versão padrão | Cerca de US$ 1,98 (US$ 2,11 na página do modelo) | Terceiros (Artificial Analysis) | Idem |
Portanto, não há uma resposta confiável, por enquanto, para a pergunta “quantos tokens por segundo o Highspeed gera?”. Artigos que apresentam um número específico ou estão usando medições próprias — cujas condições de teste precisam ser avaliadas — ou chegaram ao valor multiplicando os 80,7 tokens por 2 ou 3. Não vamos apresentar um número assim. Em vez disso, vamos mostrar como avaliar a velocidade sem depender de dados de benchmark.
2.1 Como escolher entre as versões do Kimi K3.1 Pro: transforme o tempo de espera em dinheiro
A velocidade, por si só, não tem valor. O que importa é “quanto tempo alguém deixa de esperar por causa dela”. Se ninguém estiver esperando, não faz diferença o quanto o modelo é mais rápido. A avaliação pode ser feita em quatro etapas:
- Estime o tempo de espera por solicitação: tokens gerados ÷ velocidade. Por exemplo, usando a velocidade de 80,7 tokens por segundo da versão padrão e uma saída de 1.500 tokens, o conteúdo visível leva cerca de 19 segundos para ser gerado. Lembre-se de que os dois modelos mantêm o raciocínio ativado, e esse processo também leva tempo. A espera real será maior e dependerá da tarefa.
- Estime quanto tempo o Highspeed pode economizar: com base na faixa oficial de 2 a 3 vezes, a mesma saída levaria cerca de 6 a 10 segundos, economizando aproximadamente 10 segundos por solicitação. Isso é uma estimativa, não uma medição: valide com as suas próprias solicitações.
- Multiplique pela frequência e pelo valor da hora: com 100 interações por dia e 10 segundos economizados por interação, você ganha cerca de 17 minutos. Multiplique esse tempo pelo custo da sua hora ou da hora da equipe.
- Compare com o valor extra: use o método da seção 3 para calcular quanto a mais o Highspeed custa por dia. Se o valor do tempo economizado superar esse custo adicional, vale a pena.
Há um erro comum que você deve evitar: ser 3 vezes mais rápido não significa aumentar a produtividade em 3 vezes. A saída do modelo é apenas uma etapa do fluxo de trabalho. O tempo que você leva para ler o código, pensar, fazer alterações e executar testes não diminui por isso. O que você economiza são apenas aqueles segundos esperando o modelo. Por isso, na etapa 3, use o tempo real de espera, em vez de multiplicar a produtividade diretamente pelo fator de velocidade.
3. Fazendo as contas: Kimi K3.1 Pro e Highspeed
Os dois cálculos abaixo usam os preços oficiais. As fórmulas estão detalhadas para você refazer as contas com a sua própria quantidade de tokens.
3.1 Cenário A: 20 sessões interativas de edição de código
Configuração: cada solicitação recebe 30.000 tokens, dos quais 25.000 são contexto do repositório enviado repetidamente e 5.000 são conteúdo novo. Cada resposta tem 1.500 tokens. São 20 solicitações consecutivas, com menos de 5 minutos entre elas, então o cache permanece válido.
Versão padrão:
- Primeira solicitação: entrada
30000 × $2 / 1 milhão = $0.06; 25.000 tokens são gravados no cache, e essa parte custa25000 × $2 / 1 milhão = $0.05 - Cada acerto de cache nas solicitações seguintes:
25000 × $0.2 / 1 milhão = $0.005 - Conteúdo novo por solicitação:
5000 × $2 / 1 milhão = $0.01 - Saída por solicitação:
1500 × $10 / 1 milhão = $0.015 - Total por solicitação:
$0.005 + $0.01 + $0.015 = $0.03
Highspeed:
- O preço para acertos de cache não muda: continua em
$0.005 - O preço do conteúdo novo dobra:
5000 × $4 / 1 milhão = $0.02 - O preço da saída dobra:
1500 × $20 / 1 milhão = $0.03 - Total por solicitação:
$0.005 + $0.02 + $0.03 = $0.055, ou cerca de $0.06
Somando o custo único da gravação inicial no cache, o total das 20 solicitações fica em cerca de $0.66 na versão padrão e $1.26 no Highspeed. Considerando o custo por solicitação, o Highspeed sai aproximadamente 1,8 vez mais caro que a versão padrão — menos que o dobro exato, porque o preço dos acertos de cache não aumenta. Conclusão: custa cerca de uma vez mais, mas, conforme o multiplicador oficial, reduz o tempo de espera em mais da metade. Os cerca de $0.60 adicionais compram alguns minutos a menos de espera ao longo das 20 solicitações, o que vale a pena para a maioria dos desenvolvedores.
3.2 Cenário B: processamento em lote de 1.000 solicitações offline
Configuração: cada solicitação recebe 8.000 tokens e gera 600 tokens de saída. São 1.000 execuções, sem prefixos que possam ser reutilizados entre elas, então não há como aproveitar o cache.
- Versão padrão por solicitação:
(8000 × $2 + 600 × $10) / 1 milhão = $0.016 + $0.006 = $0.022; para 1.000 execuções,$22 - Highspeed por solicitação:
(8000 × $4 + 600 × $20) / 1 milhão = $0.032 + $0.012 = $0.044; para 1.000 execuções,$44
Conclusão: é dinheiro jogado fora. Ninguém está esperando por cada resultado, e o tempo total de execução costuma depender da concorrência e da fila. Pagar $22 a mais não traz nenhum benefício perceptível.
| Item do cálculo | Cenário A: edição interativa de código | Cenário B: processamento em lote offline |
|---|---|---|
| Número de solicitações | 20 | 1.000 |
| É possível acertar o cache? | Sim, reutiliza 25.000 tokens | Não |
| Custo total da versão padrão | Cerca de $0.66 | $22 |
| Custo total do Highspeed | Cerca de $1.26 | $44 |
| Multiplicador real do preço | Cerca de 1,8–1,9 vez | 2 vezes |
| Alguém está esperando? | Sim | Não |
| Conclusão | Custa cerca de uma vez mais e reduz a espera em mais da metade; vale a pena | É dinheiro jogado fora; escolha a versão padrão |
4. Quando escolher Kimi K3.1 Pro ou Highspeed
Aplicando os critérios acima a situações comuns, chegamos diretamente à tabela a seguir. Há apenas dois fatores a considerar: alguém está esperando? É possível aproveitar o cache?
| Cenário | Recomendação | Motivo |
|---|---|---|
| Programação interativa | Highspeed | Alguém está acompanhando as alterações na tela e o contexto do repositório pode ser encontrado no cache. Na prática, o custo adicional fica abaixo de 2 vezes. |
| Agent conversacional | Highspeed | As várias rodadas de solicitações curtas e chamadas de ferramentas fazem com que o tempo de espera de cada rodada se acumule e fique perceptível. |
| Demonstrações e transmissões ao vivo | Highspeed | O público está assistindo. Respostas lentas prejudicam diretamente a experiência ao vivo, e a diferença de custo em dezenas de chamadas é insignificante. |
| Limpeza de dados em lote | Versão padrão | Ninguém está esperando o resultado de cada item. A velocidade não agrega valor, então o dobro do preço vira apenas custo. |
| Avaliação offline | Versão padrão | A avaliação considera apenas a qualidade dos resultados. Como as duas versões têm as mesmas capacidades, a velocidade não altera a pontuação. |
| Tarefas agendadas | Versão padrão | Como são executadas à noite ou em segundo plano, terminar alguns minutos antes não faz diferença. O custo é um fator importante. |
Se um produto atende aos dois tipos de cenário, também é possível usar as versões em conjunto: as solicitações de interação direta dos usuários no primeiro plano podem usar kimi-k3.1-pro-highspeed, enquanto resumos, arquivamento e processamento em lote em segundo plano podem usar kimi-k3.1-pro. Os dois modelos têm as mesmas capacidades, então não é preciso alterar o comando ao trocar o nome do modelo.
5. A terceira variável para acelerar o Kimi K3.1 Pro: reasoning_effort e a cota do Kimi Code
Antes de decidir pagar mais, vale testar uma opção gratuita para ganhar velocidade. Os dois modelos estão sempre no modo de raciocínio: antes de responder, eles fazem uma etapa interna de análise. O tempo de raciocínio é controlado pelo parâmetro reasoning_effort, que indica até que ponto o modelo deve pensar. Quanto mais baixo o nível, menos tempo ele leva para pensar e mais rápido entrega o resultado. Veja o que diz a documentação oficial:
reasoning_effort: aceita três níveis —low,highemax— e o padrão émax- Para ganhar velocidade, você pode primeiro reduzir o modelo padrão para
low. Se a velocidade for suficiente e a qualidade continuar aceitável, não será necessário pagar o dobro pelo Highspeed - Reduzir o nível pode diminuir a profundidade do raciocínio em tarefas complexas: é uma troca de qualidade por velocidade. Já o Highspeed troca dinheiro por velocidade sem afetar a qualidade. O custo de cada opção é diferente
- Também dá para combinar as duas opções: Highspeed com
lowé indicado para situações em que a latência é prioridade e a tarefa não é muito complexa
Outro detalhe fácil de ignorar está no Kimi Code. O Kimi Code é a ferramenta de programação da Moonshot, e o uso é contabilizado com base na cota da assinatura. De acordo com a documentação oficial do Kimi Code:
- O
k3.1-proexige uma assinatura Plus ou superior. Para usar a janela de contexto de 1M, é necessária uma assinatura Pro ou superior - O
k3.1-pro-highspeedexige uma assinatura Pro ou superior - A versão Highspeed consome cerca de 2 vezes mais cota. Com a mesma cota da assinatura, você consegue fazer aproximadamente metade do trabalho usando o Highspeed
Ao chamar a API, também fique atento a alguns parâmetros fixos. A documentação oficial exige que eles sejam omitidos da requisição; não os envie manualmente:
temperatureé fixo em1.0top_pé fixo em0.95né fixo em1presence_penaltyefrequency_penaltysão fixos em0max_completion_tokenstem padrão de131072e máximo de1048576
6. Além da API oficial: como usar o Kimi K3.1 Pro com mais facilidade via APIYI
A API oficial é compatível com os formatos da OpenAI e da Anthropic, incluindo as interfaces Chat Completions, Responses e Messages. “Compatível com a OpenAI” significa que você pode aproveitar quase todo o código que já usa com o SDK da OpenAI: basta trocar o endereço e a chave API e ajustar o nome do modelo.
Desenvolvedores no Brasil podem usar o APIYI apiyi.com para chamar modelos de vários provedores com uma única chave API e pagar conforme o uso. Novos usuários recebem uma cota grátis para testes. Veja como fazer a integração:
- Formato OpenAI: defina
base_urlcomohttps://api.apiyi.com/v1 - Formato Anthropic: defina o endereço base como
https://api.apiyi.com - Em
model, informe o nome correspondente na lista de modelos da plataforma
Vale lembrar que, na consulta realizada em 24/10/2026, a lista de modelos do APIYI já incluía modelos da série Kimi como kimi-k2.5, kimi-k2.6, kimi-k2.7-code e kimi-k3, mas kimi-k3.1-pro e kimi-k3.1-pro-highspeed ainda não estavam disponíveis. Os nomes e preços desses modelos na plataforma devem ser conferidos na lista de modelos. Vamos disponibilizar esse modelo em breve. Enquanto isso, você pode usar um dos modelos Kimi disponíveis para testar o fluxo de chamadas e a estratégia de cache. Quando o novo modelo estiver disponível, basta trocar o nome.
7. Recomendações para escolher entre Kimi K3.1 Pro e Highspeed
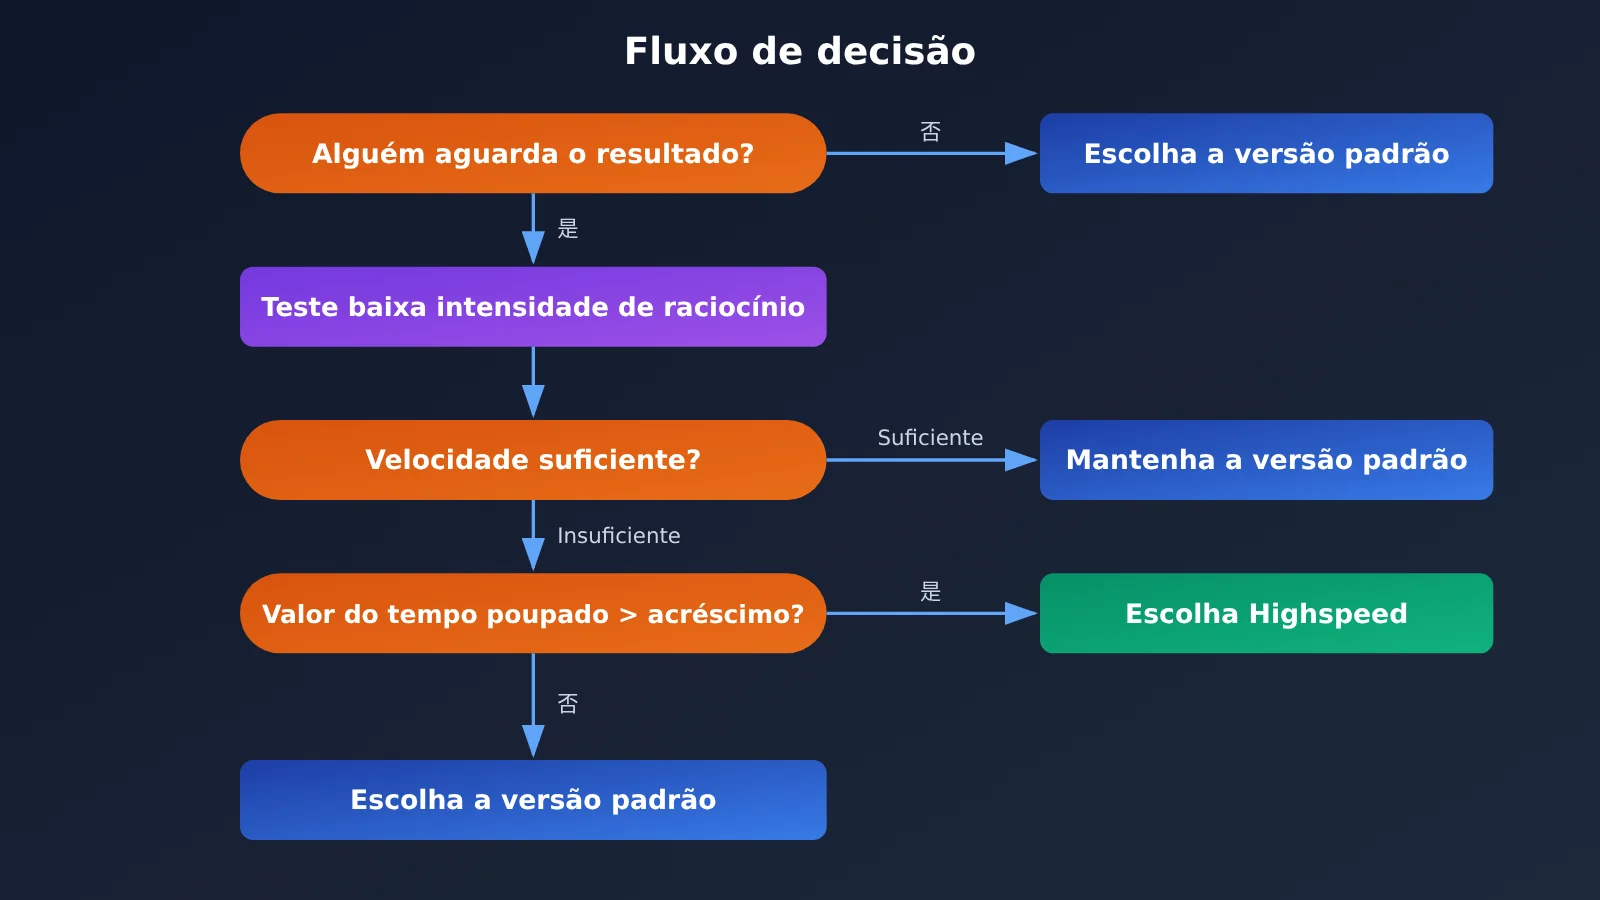
Recomendação: primeiro, pergunte: “Tem alguém esperando?”. Se não, escolha a versão padrão. Se sim, reduza
reasoning_effortparalowe faça um teste. Se ainda achar lento, mude para Highspeed. Para saber se vale a pena, use o método da seção 2 para converter o tempo de espera economizado em dinheiro e compare o resultado com a diferença de preço calculada na seção 3. Recomendamos fazer uma comparação em pequena escala com suas próprias solicitações reais na APIYI (apiyi.com). Os modelos disponíveis e os preços da série K3.1 Pro estarão na lista de modelos da plataforma. Lançaremos este modelo o quanto antes.
Alguns princípios que você já pode colocar em prática:
- Use a versão padrão por padrão e deixe o Highspeed como uma opção para quando precisar, em vez de usá-lo como configuração padrão
- Quanto mais prefixos você reutilizar, mais vantajoso será o Highspeed, porque o preço dos acertos de cache não dobra
- Se a equipe usar as duas versões, direcione o tráfego conforme a finalidade: interações com usuários no Highspeed; tarefas em segundo plano na versão padrão
- Ao usar o Highspeed no Kimi Code, leve a cota em conta: ele consome cerca de 2 vezes mais
Perguntas frequentes (FAQ)
Q1: O que é o Kimi K3.1 Pro Highspeed?
É uma versão de alta velocidade lançada junto com o Kimi K3.1 Pro pela Moonshot, com o nome de modelo `kimi-k3.1-pro-highspeed`. Segundo a empresa, ele é de 2 a 3 vezes mais rápido que o K3.1 Pro, tem as mesmas capacidades e conta com a mesma janela de contexto, de 1.048.576 tokens.
Q2: O Highspeed tem resultados piores ou melhores que a versão padrão?
Segundo a descrição oficial, as duas versões têm as mesmas capacidades. Portanto, não é o caso de “ficar mais burro por ser mais rápido” nem de “ficar mais inteligente por ser mais caro”. O que realmente afeta a qualidade das respostas é o nível de `reasoning_effort`, não a versão escolhida.
Q3: Afinal, quanto mais rápido é o Highspeed? Há dados específicos de tokens por segundo?
A empresa informou apenas o intervalo de “2 a 3 vezes mais rápido”, sem divulgar dados detalhados. A análise de terceiros da Artificial Analysis mediu a velocidade de saída da versão padrão em 80,7 tokens por segundo, mas não testou o Highspeed separadamente. O valor específico do Highspeed ainda não foi verificado; recomendamos testar com suas próprias solicitações.
Q4: Por que o Highspeed pode não custar exatamente o dobro na prática?
Porque o preço de entrada para tokens com acerto de cache é de US$ 0,20 por milhão de tokens nas duas versões. Se uma solicitação tiver muitos prefixos repetidos que possam ser encontrados no cache, essa parte não terá custo adicional, e o custo total ficará abaixo do dobro. No cenário A deste artigo, uma solicitação custa cerca de 1,8 vez o valor da versão padrão.
Q5: Como usar o Kimi K3.1 Pro e o Highspeed no Brasil?
Você pode usar a API oficial da Kimi ou fazer chamadas pela interface compatível com OpenAI do serviço proxy de API da APIYI, apiyi.com. Basta alterar o `base_url` para `https://api.apiyi.com/v1`. Os nomes dos modelos e os preços dos dois modelos na APIYI seguem a lista de modelos da plataforma. A integração ainda está em andamento, e disponibilizaremos esse modelo em breve.
Q6: Quais são as limitações conhecidas da série Kimi K3.1 Pro?
– Os dois modelos mantêm o modo de raciocínio sempre ativado. Não é possível desativar completamente a inferência; só dá para ajustar o nível com `reasoning_effort`.
– Parâmetros como `temperature` e `top_p` são fixos e devem ser omitidos da solicitação. Não é possível controlar o estilo ajustando os parâmetros de amostragem.
– No Kimi Code, o Highspeed exige uma assinatura Pro ou superior e consome aproximadamente o dobro da cota.
– A empresa informou que disponibilizará os pesos completos até 04/11/2026, mas eles ainda não foram publicados.
Principais conclusões sobre Kimi K3.1 Pro e Highspeed
- Mesma capacidade: com o Highspeed, você paga apenas por mais velocidade, não por respostas melhores.
- Preço dobrado: os preços de entrada, saída e das duas faixas de gravação em cache são 2 vezes maiores. Só o preço de leitura do cache continua em US$ 0,20.
- Poucos dados de velocidade: segundo a divulgação oficial, o Highspeed é 2 a 3 vezes mais rápido. Testes de terceiros mediram apenas a versão padrão, com 80,7 tokens por segundo.
- A decisão depende do tempo de espera: converta o tempo que as pessoas passam esperando em dinheiro e compare com a diferença de preço. Não confunda o múltiplo de velocidade com o de eficiência.
- Highspeed para interações: é uma boa opção para programação interativa, agentes conversacionais e demonstrações ao vivo.
- Versão padrão para processamento em lote: usar o Highspeed para limpeza de dados em lote, avaliações offline e tarefas agendadas é só pagar a mais sem necessidade.
- Reduza o nível antes de gastar mais: definir
reasoning_effortcomolowé uma opção gratuita para acelerar as respostas.
Resumo
Para escolher entre Kimi K3.1 Pro e Highspeed, há três pontos principais:
- As duas versões têm a mesma capacidade: escolher uma ou outra não afeta a qualidade das respostas. A diferença está apenas na velocidade, no preço e nos requisitos de assinatura.
- Há uma exceção no aumento de preço: quatro das cinco tarifas dobram, mas o preço de leitura do cache não muda. Quanto mais prefixos você reutilizar, menor será o aumento efetivo de preço do Highspeed.
- Só vale a pena quando alguém está esperando: em interações, o Highspeed troca um gasto aproximadamente duas vezes maior por uma espera mais da metade menor. Em tarefas em lote, ele apenas aumenta o custo.
Na prática, recomendamos começar com a versão padrão e reasoning_effort=low. Faça um teste e, se a velocidade ainda não for suficiente, mude para o Highspeed. Use a fórmula da seção 3 com a sua própria contagem de tokens para conferir os custos. Para acessar a série Kimi K3.1 Pro pela APIYI (apiyi.com), consulte a lista de modelos da plataforma para verificar os nomes e preços. Lançaremos esse modelo em breve.
Referências
- Site oficial e blog da Kimi: anúncio de lançamento do K3.1 Pro e do Highspeed, descrição dos recursos e dos canais disponíveis
- Link:
kimi.ai -
Observação: fonte da afirmação oficial de que o modelo é “2 a 3 vezes mais rápido, com os mesmos recursos”
-
Artificial Analysis: medições independentes de velocidade e custo dos modelos
- Link:
artificialanalysis.ai -
Observação: fonte dos dados sobre a velocidade de 80,7 tokens por segundo da versão padrão, o volume de saída por tarefa e os custos
-
Blog de Simon Willison: registros públicos de um desenvolvedor
- Link:
simonwillison.net -
Observação: confirma que o Highspeed custa o dobro e que o preço para acertos de cache é igual ao da versão padrão
-
Lista de modelos da APIYI: modelos disponíveis e preços na plataforma
- Link:
docs.apiyi.com/models - Observação: disponibilidade da série Kimi na plataforma verificada em 24/10/2026
Autor: equipe técnica da APIYI
Converse com a equipe técnica: para acessar mais materiais de integração, consulte a central de documentação em docs.apiyi.com. Os modelos da série Kimi K3.1 Pro disponíveis na plataforma e seus preços podem ser consultados na lista de modelos. Lançaremos esse modelo em breve.