作者-Hinweis: Anhand eines Nachbau-Tests der Agrumea-Farm-Website vergleicht dieser Beitrag Gemini 4 Carbon, Claude Opus 5.5 und GPT-6 Astra in drei Dimensionen: Designtreue, Interaktionsanforderungen sowie Dauer und API-Äquivalenzkosten. Dazu gibt es eine Auswahlhilfe nach Einsatzszenario und eine Anleitung, wie Sie den Test selbst wiederholen.
Was passiert, wenn man dieselbe Marken-Website drei Top-Modellen zum Nachbauen gibt? Wie groß sind die Unterschiede? Am 11. November 2026 hat der unabhängige Testautor Pat Simmons (AI for Mortals) dazu eine Testreihe veröffentlicht. Er ließ Gemini 4 Carbon, Claude Opus 5.5 und GPT-6 Astra die Website der italienischen Lebensmittelmarke Agrumea Farm nachbauen. Veröffentlicht hat er die Ergebnisse, Screenshots, Eingabeaufforderungen, Laufzeiten und die API-Äquivalenzkosten.
Das ist keine Analyse nach dem Motto „jeder hat seine Stärken“. Bei dieser Aufgabe gibt es in allen drei Dimensionen klare Sieger: Carbon war am günstigsten, Astra am schnellsten, und Opus bekam vom Testautor die beste Qualitätsbewertung. Wichtig zur Einordnung: Jedes Modell wurde nur einmal ausgeführt, außerdem unterschieden sich Tool-Umgebung und Testdatum. Die Ergebnisse lassen sich deshalb nicht einfach als Ranking auf alle Webentwicklungs-Szenarien übertragen.
Der Nutzen für Sie: Nach der Lektüre wissen Sie, wo die drei „Modell + Tool“-Workflows bei Ergebnis, Geschwindigkeit und Kosten jeweils stark sind. Mit der hier beschriebenen Methode können Sie das Ganze außerdem in Ihrem eigenen Projekt nachprüfen.
Zuerst die Originalseite: So lief der Replikationstest mit Carbon, Opus und Astra ab
Erst die Testbedingungen, dann die Ergebnisse. Der Wert dieser Testreihe liegt darin, dass dieselbe Website, dieselbe Eingabeaufforderung und dasselbe Entwicklungsziel galten. Verglichen wird aber der gesamte Workflow – nicht das Modell isoliert im Labor.
| Testfaktor | Konkrete Einstellung | Einfluss auf die Schlussfolgerung |
|---|---|---|
| Testobjekt | Website von Agrumea Farm (englische Version) | Verglichen wird die Fähigkeit zur Designnachbildung, nicht das eigene ästhetische Gespür |
| Aufgabe | Seitenstruktur, visuellen Stil, 3D-Dosenkarussell, Scrollen und Ziehen, Ladeanimation, Hover-Animationen und Seitenübergänge nachbauen | Neben dem statischen Screenshot zählt auch die Interaktion als Qualitätsmerkmal |
| Prüfgrößen | Desktop 1440×900, Mobilgerät 390×844 | Responsives Layout muss ebenfalls berücksichtigt werden |
| Verifikation | Styles im Browser auslesen und visuell prüfen, damit die Website lauffähig ist | Die Fähigkeit zur Selbstkontrolle im Browser beeinflusst das Endergebnis |
| Toolumgebung | Carbon mit Google Antigravity, Opus mit Claude Code, Astra mit Codex, jeweils mit hoher Reasoning-Einstellung | Das Ergebnis entsteht aus dem Zusammenspiel von Modell und Toolchain |
| Durchläufe und Datum | Pro Modell nur 1 Durchlauf; Opus und Astra am 6. November, Carbon vom 10. bis 11. November | Einzelne Ausreißer und Umgebungsunterschiede sind möglich |
Drei wichtige Voraussetzungen für den Test von Carbon, Opus und Astra
Die erste Voraussetzung: Es geht um eine Replikation, nicht um freies Design. Alle drei Modelle sollten die Designsprache der Originalmarke übernehmen. Verglichen werden also vor allem Detailtreue, Feinheiten und Fertigstellungsgrad. Wenn Sie ein originelles Visual-Konzept von Grund auf entwickeln wollen, taugt dieser Test nur als grobe Orientierung.
Die zweite Voraussetzung betrifft die Kosten. Alle genannten Beträge hat der Autor des Tests anhand der Modellpreise und der Nutzungsprotokolle berechnet. Es sind API-äquivalente Kosten, keine tatsächlichen Abbuchungen aus einem Abo. Wenn Sie dieselbe Aufgabe mit einem Flatrate-Tool ausführen, sieht die Abrechnung völlig anders aus.
Die dritte Voraussetzung: Im Test traten eigentlich vier Modelle an. Der Autor hat zusätzlich Claude Fable 5.2 aufgenommen, das den ersten Platz in der subjektiven Wertung belegt hat. Wenn weiter unten vom „2., 3. und 4. Platz“ die Rede ist, bezieht sich das daher auf das Ranking mit vier Modellen.
Bildhinweis: Die drei in diesem Artikel gezeigten Screenshots der Startseiten stammen von AI for Mortals / Pat Simmons, veröffentlicht am 11.11.2026. Sie gehören jeweils zu den Nachbauten von Gemini 4 Carbon, Claude Opus 5.5 und GPT-6 Astra.
Erste Runde: Wer setzt das Webdesign besser um – Carbon, Opus oder Astra?
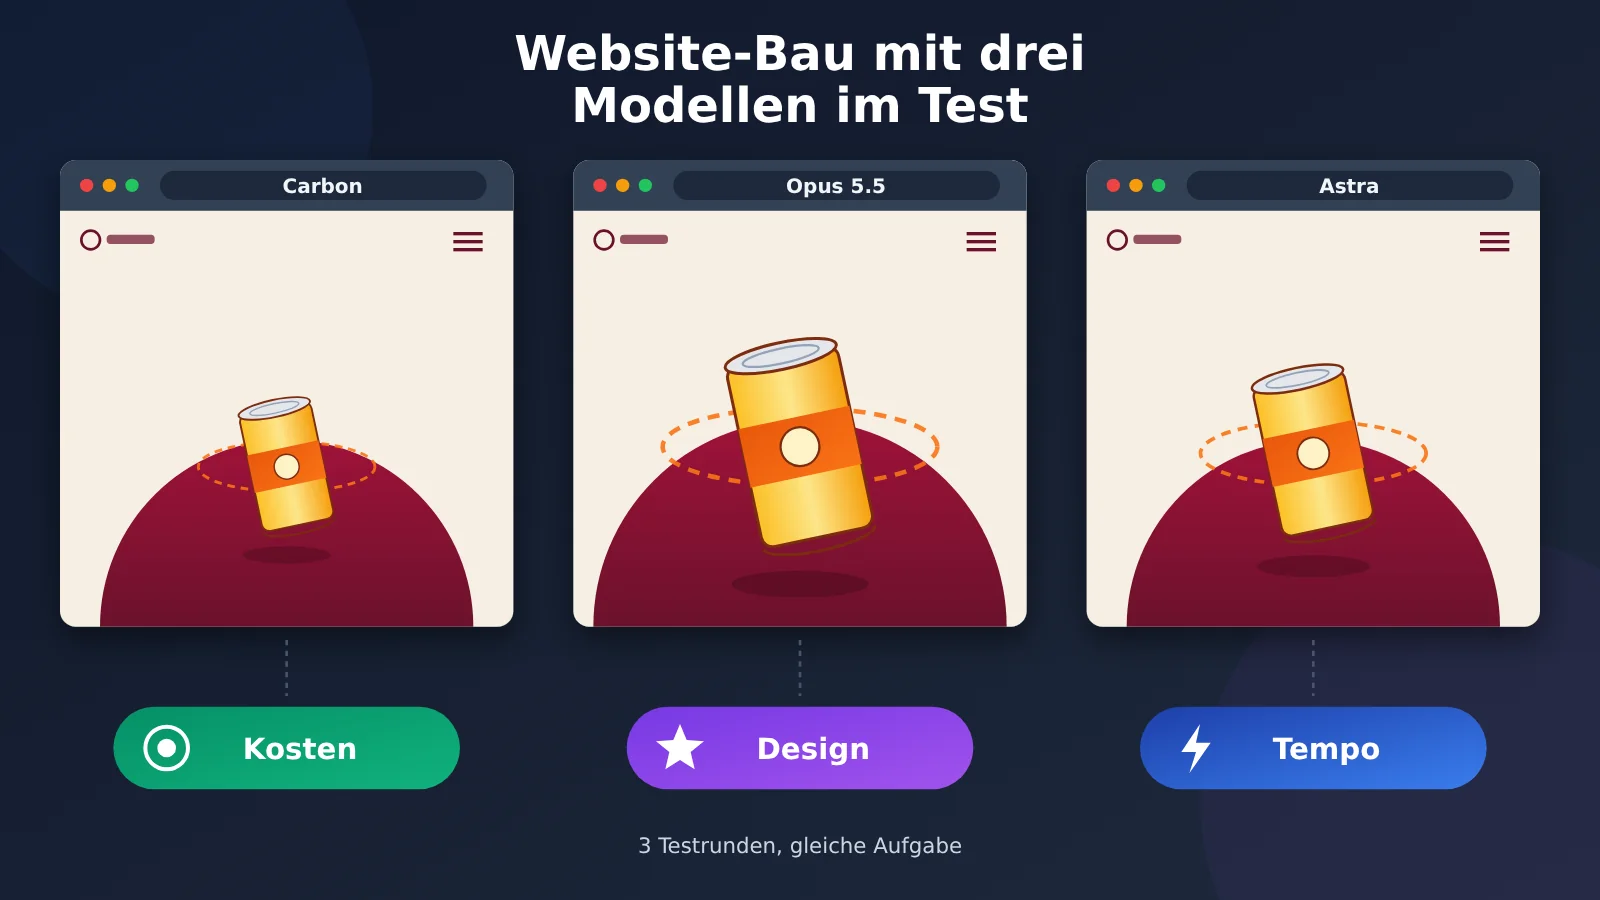
Zuerst der Blick aufs Bild. Nach den öffentlich verfügbaren Screenshots des ersten Bildschirmbereichs (Above the Fold) haben alle drei Arbeiten die Kernelemente der Originalseite erfasst: den cremeweißen Hintergrund, die schwebende Konservendose, den weinroten, gebogenen Hintergrund, den orangefarbenen Kreistext sowie oben das Markenlogo, den Sprachwechsler und den Menü-Button. Keines der Modelle hat also eine völlig danebenliegende Vorlagenseite abgeliefert. Die Unterschiede liegen in den Proportionen, in der Ebenenstaffelung und in den Details.
Die Bilder zeigen von oben nach unten die Ergebnisse von Opus 5.5, Astra und Carbon.
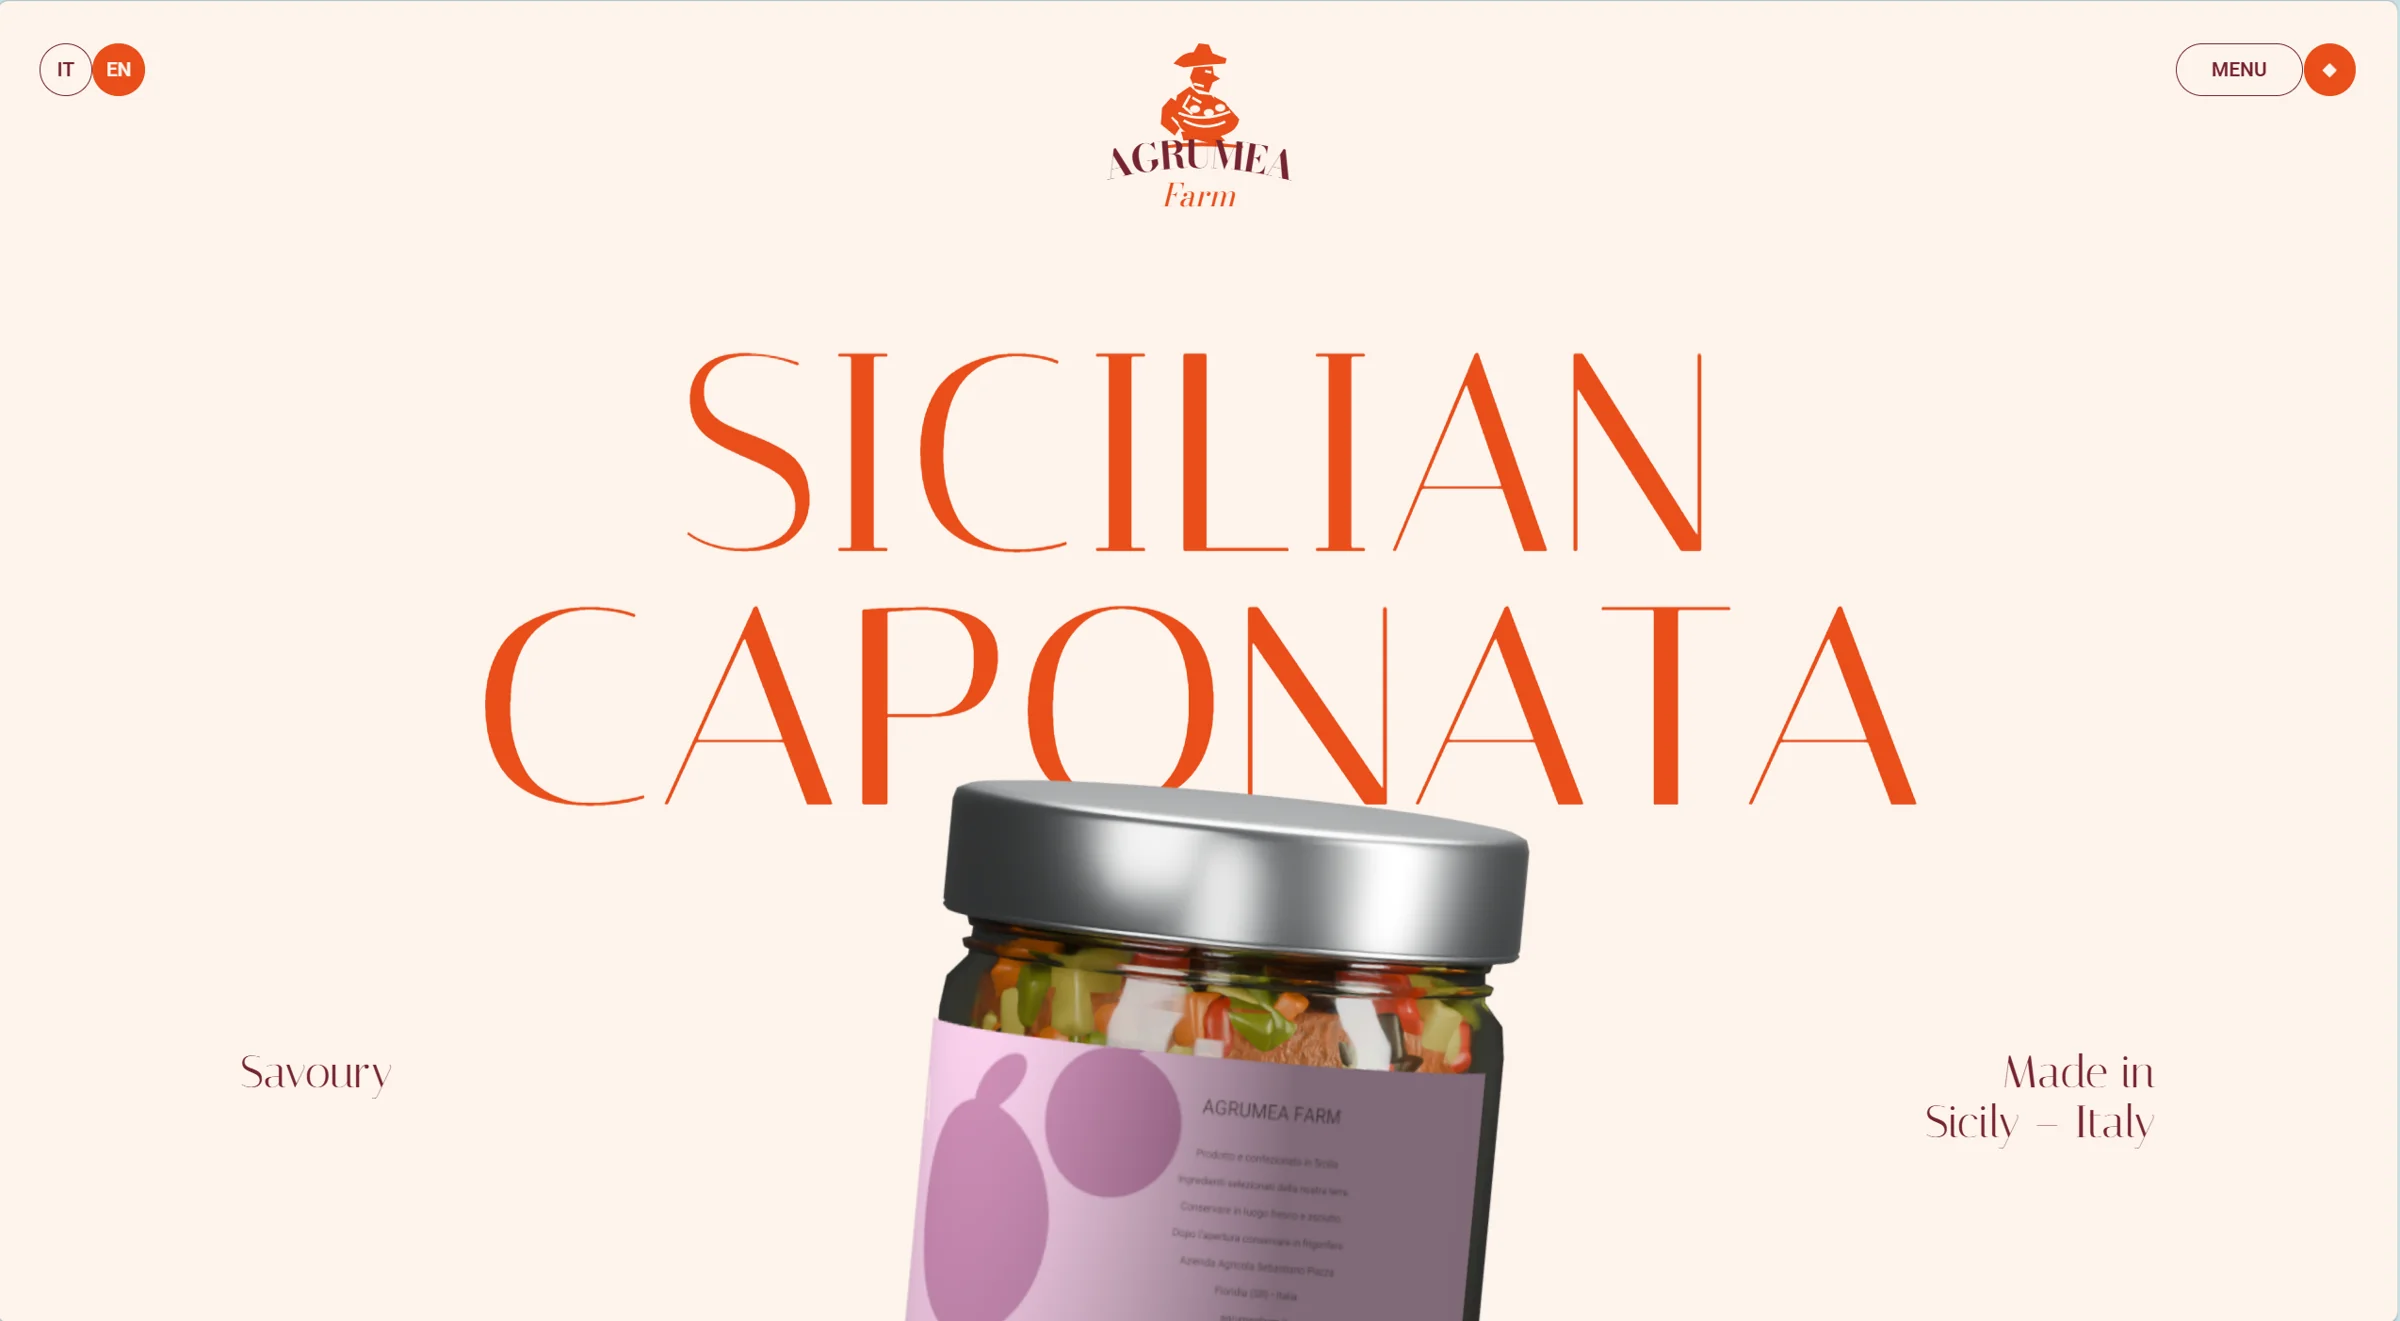
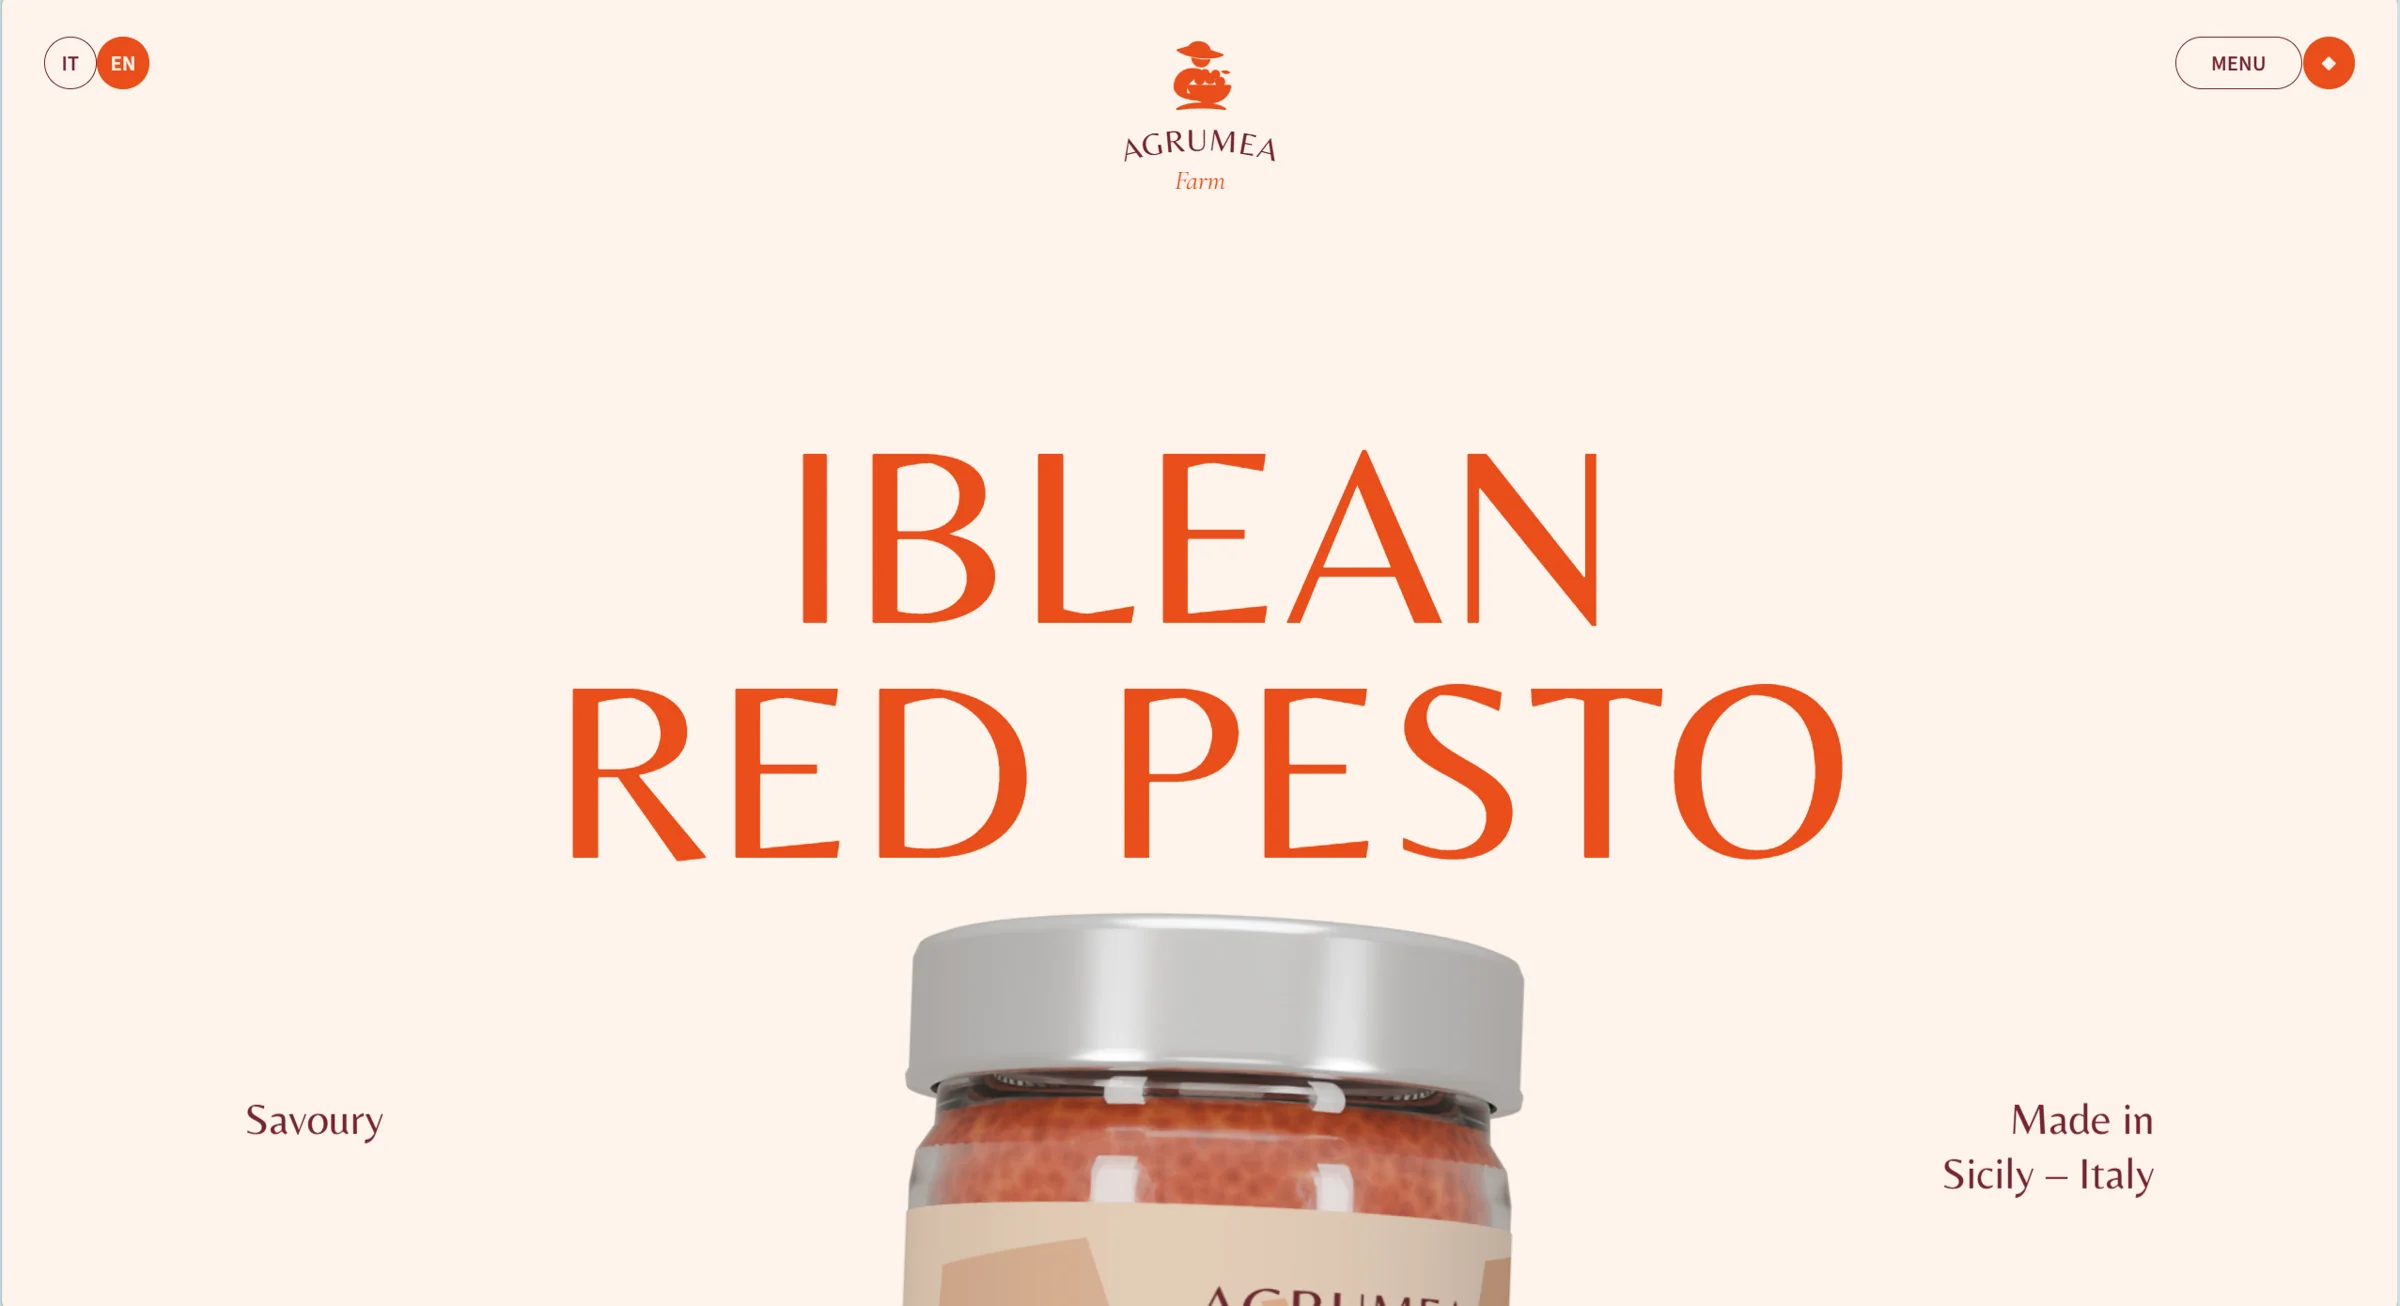
| Beobachtungskriterium | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Komposition des ersten Bildschirms | Viel Weißraum, insgesamt luftig | Größeres Produkt im Mittelpunkt, starke visuelle Wirkung | Vollständige Anordnung, insgesamt eher kompakt |
| Proportion der Dose | Die Dose in der Mitte wirkt relativ klein | Dose sticht hervor und ist das klare visuelle Zentrum | Klares visuelles Zentrum |
| Hintergrund und Ebenen | Gebogener Hintergrund wurde umgesetzt | Überlagerung von Dose und Hintergrundkurve besonders markant | Vollständige Ebenenstaffelung |
| Etiketten und Text | Manche Etiketten- und Textdetails eher schwach | Etiketten und Schriften abwechslungsreicher | Dosenetikett mit deutlicher grafischer Verzierung |
| Subjektives Ranking des Autors (vier Modelle) | Platz 4 | Platz 2 | Platz 3 |
Warum Opus bei der Design-Nachbildung mehr überzeugt
Zunächst müssen zwei Arten von Informationen getrennt werden: Die ersten vier Zeilen der Tabelle sind visuelle Beobachtungen anhand öffentlicher Screenshots, erst die letzte Zeile enthält das subjektive Ranking des Testautors. Von den drei vorgegebenen Modellen ist der Autor mit Opus am zufriedensten, danach folgt Astra, zuletzt Carbon.
Auf den Screenshots liegt die Stärke von Opus vor allem in der „Gewichtung der Elemente auf einer Markenwebsite“. Im ersten Bildschirmbereich einer Website für eine Lebensmittelmarke steht das Produkt im Mittelpunkt. Opus stellt die Dose größer dar und lässt sie sich deutlich vor der weinroten Kurve überlagern, außerdem ist die Schrift auf dem Etikett klarer. Das luftige Layout von Carbon ist an sich nicht falsch, aber die Dose wirkt eher klein und einige Textdetails sind schwächer ausgeprägt – beim Bewertungskriterium „Originaltreue“ ist das ein Nachteil.
Astra liegt in der Leistung zwischen beiden. Die Komposition ist vollständig, das visuelle Zentrum klar erkennbar, und das Dosenetikett wirkt dekorativer, insgesamt ist alles nur etwas kompakter. Bei einer Nachbau-Aufgabe zählt „Sieht es aus wie die Originalseite?“ mehr als „Sieht es gut aus?“. Das erklärt auch, warum alle drei Ergebnisse gut sind und die Platzierungen trotzdem deutlich auseinanderliegen.
Runde 2: Warum man die Interaktionen von Carbon, Opus und Astra nicht nur anhand von Screenshots beurteilen kann
Der größte Unterschied zwischen einer Website und einem Designentwurf ist, dass sie sich „bewegen“ muss. Die ursprüngliche Aufgabe verlangte ausdrücklich den Nachbau eines 3D-Produktkarussells mit Dosen, Scroll- und Drag-Interaktionen, Ladeanimationen, Hover-Animationen und Seitenübergängen. Diese Fähigkeiten sind auf statischen Screenshots kaum zu erkennen, bestimmen aber direkt das Nutzungserlebnis, sobald man die Website öffnet.
Screenshots belegen deshalb nur Layout und visuelle Details, nicht aber, dass die Interaktion vollständig umgesetzt ist. Ob sich die 3D-Dose flüssig ziehen lässt, das Hover-Feedback natürlich wirkt und auf Mobilgeräten nichts verrutscht, lässt sich nur beurteilen, wenn man die drei öffentlichen Projektseiten tatsächlich bedient. In diesem Artikel werden Screenshots daher nicht als Ergebnis eines Interaktionstests behandelt, und ich ergänze auch keine Interaktionsbewertung, die der ursprüngliche Autor nicht angegeben hat.
Diese Runde zeigt außerdem den Unterschied zwischen Webentwicklung und statischer Bilderzeugung. Ein Modell kann einen schönen ersten Bildschirmbereich zeichnen. Aber 3D-Karussell, scrollgesteuerte Animationen und responsives Layout müssen alle in lauffähigen Code gegossen werden, und dabei sind Ladereihenfolge, Performance und das Verhalten bei verschiedenen Bildschirmgrößen zu berücksichtigen. Die Vorgabe, „Stile im Browser auszulesen und visuell zu prüfen“, soll genau dafür sorgen, dass aus „fertig geschrieben“ ein „läuft wirklich“ wird.
In echten Projekten können Sie eine KI-generierte Website in folgender Reihenfolge prüfen:
- Öffnen Sie die Seite zuerst in zwei Größen, 1440×900 und 390×844, und stellen Sie sicher, dass das Layout weder überläuft noch sich überlappt.
- Lösen Sie nacheinander Ziehen, Scrollen, Hovern und Seitenwechsel aus und beobachten Sie, ob Animationen ruckeln oder nicht funktionieren.
- Öffnen Sie die Browser-Konsole und prüfen Sie, ob Fehlermeldungen, fehlgeschlagene Ressourcenladevorgänge oder endlos laufende Animationen auftreten.
- Vergleichen Sie zum Schluss Bildschirm für Bildschirm mit der Originalseite oder dem Designentwurf und halten Sie die visuellen Abweichungen fest.
Runde 3: Wie weit liegen Carbon, Opus und Astra bei Kosten und Dauer auseinander?
In dieser Runde zeigen sich die Unterschiede zwischen den drei Workflows am deutlichsten. Alle Daten stammen aus der ursprünglichen Auswertung, die Kosten sind API-Äquivalenzkosten.
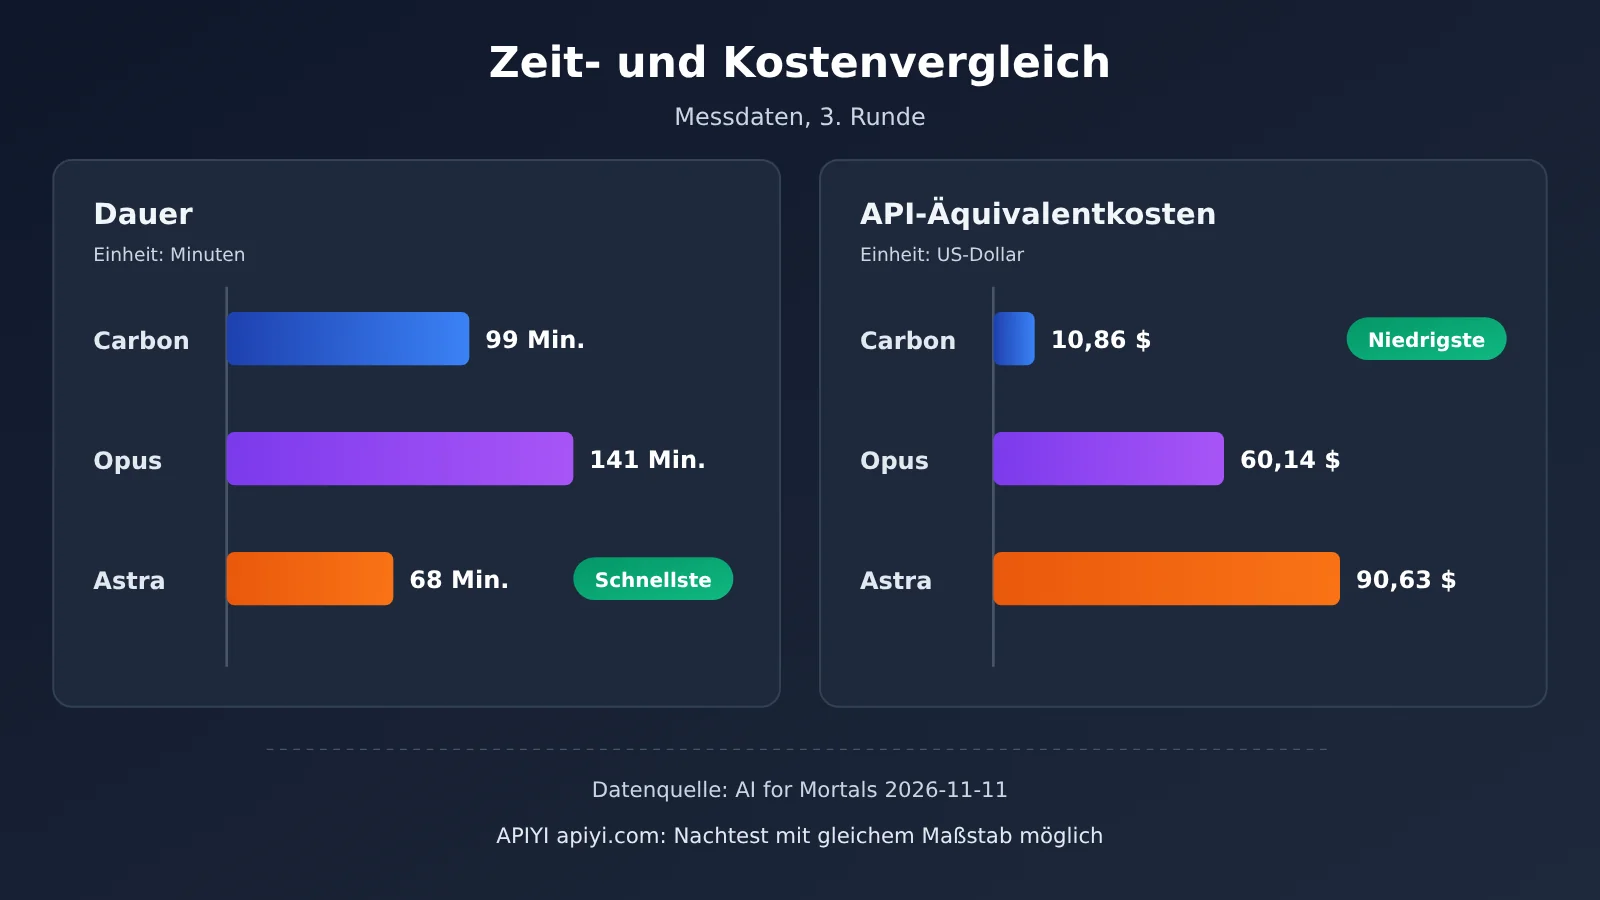
| Kennzahl | Gemini 4 Carbon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Dauer | 99 Minuten | 141 Minuten | 68 Minuten (am schnellsten) |
| API-Äquivalenzkosten | 10,86 US-Dollar (am günstigsten) | 60,14 US-Dollar | 90,63 US-Dollar |
| Eingabe-Token | 27,7 Mio. | 197,9 Mio. | 70,4 Mio. |
| Ausgabe-Token | 430.000 | 483.000 | 211.000 |
| Äquivalenzkosten pro Minute (berechnet) | ca. 0,11 US-Dollar | ca. 0,43 US-Dollar | ca. 1,33 US-Dollar |
| Subjektive Platzierung des Autors (vier Modelle) | Platz 4 | Platz 2 | Platz 3 |
Die Kostendaten von Carbon, Opus und Astra im Detail
Die API-Äquivalenzkosten von Carbon liegen bei etwa 18 % von Opus und 12 % von Astra. Wer viel ausprobiert und ständig iteriert, spürt diesen Abstand über mehrere Aufgabenrunden hinweg immer stärker. Astra braucht mit 68 Minuten weniger als die Hälfte der Zeit von Opus und eignet sich daher, wenn es auf schnelle Lieferung ankommt. Opus braucht am längsten und liegt bei den Kosten in der Mitte, liefert dafür aber das Ergebnis, mit dem der Autor unter den dreien am zufriedensten war.
In der Tabelle fällt etwas auf, das man leicht übersieht: Bei allen dreien liegen die Eingabe-Token weit über den Ausgabe-Token. Nach den Tabellenwerten beträgt das Verhältnis von Eingabe zu Ausgabe bei Carbon etwa 64:1, bei Opus etwa 410:1 und bei Astra etwa 334:1. Das liegt an der Arbeitsweise agentenbasierter Entwicklung: In jeder Runde liest das Modell Code, Styles, Seitenzustand und anderen Kontext neu ein, und nur ein kleiner Teil entfällt auf den tatsächlich „geschriebenen“ Code. Mit einer Eingabemenge von fast 200 Millionen Token hat Opus in dieser Aufgabe besonders viel Kontext hin und her geschickt.
Bemerkenswert ist außerdem, dass Token-Menge und Kosten nicht proportional zueinander sind. Astra hat nur etwa ein Drittel der Eingabe-Token von Opus, kommt aber auf höhere Äquivalenzkosten. Preis pro Token, Cache-Abrechnung und ähnliche Faktoren spielen also ebenfalls eine große Rolle. Bei der Kostenbewertung reicht es nicht, nur zu schauen, wer weniger Token verbraucht; man muss nach den tatsächlichen Abrechnungsregeln des jeweiligen Modells rechnen. Konkrete Einzelpreise führt dieser Artikel nicht auf. Maßgeblich sind die offiziellen Preisseiten der Anbieter.
Warum Carbon, Opus und Astra bei gleicher Eingabeaufforderung unterschiedliche Ergebnisse liefern
Dieselbe Eingabeaufforderung führt zu drei verschiedenen Ergebnissen, und das liegt nicht nur an den Modellen selbst. In diesem Test läuft jedes Modell in seiner eigenen Entwicklungsumgebung. Das Endergebnis entsteht also aus dem Zusammenspiel von Modellfähigkeiten, Art der Tool-Aufrufe, Selbstkontrolle im Browser und Kontextverwaltung.
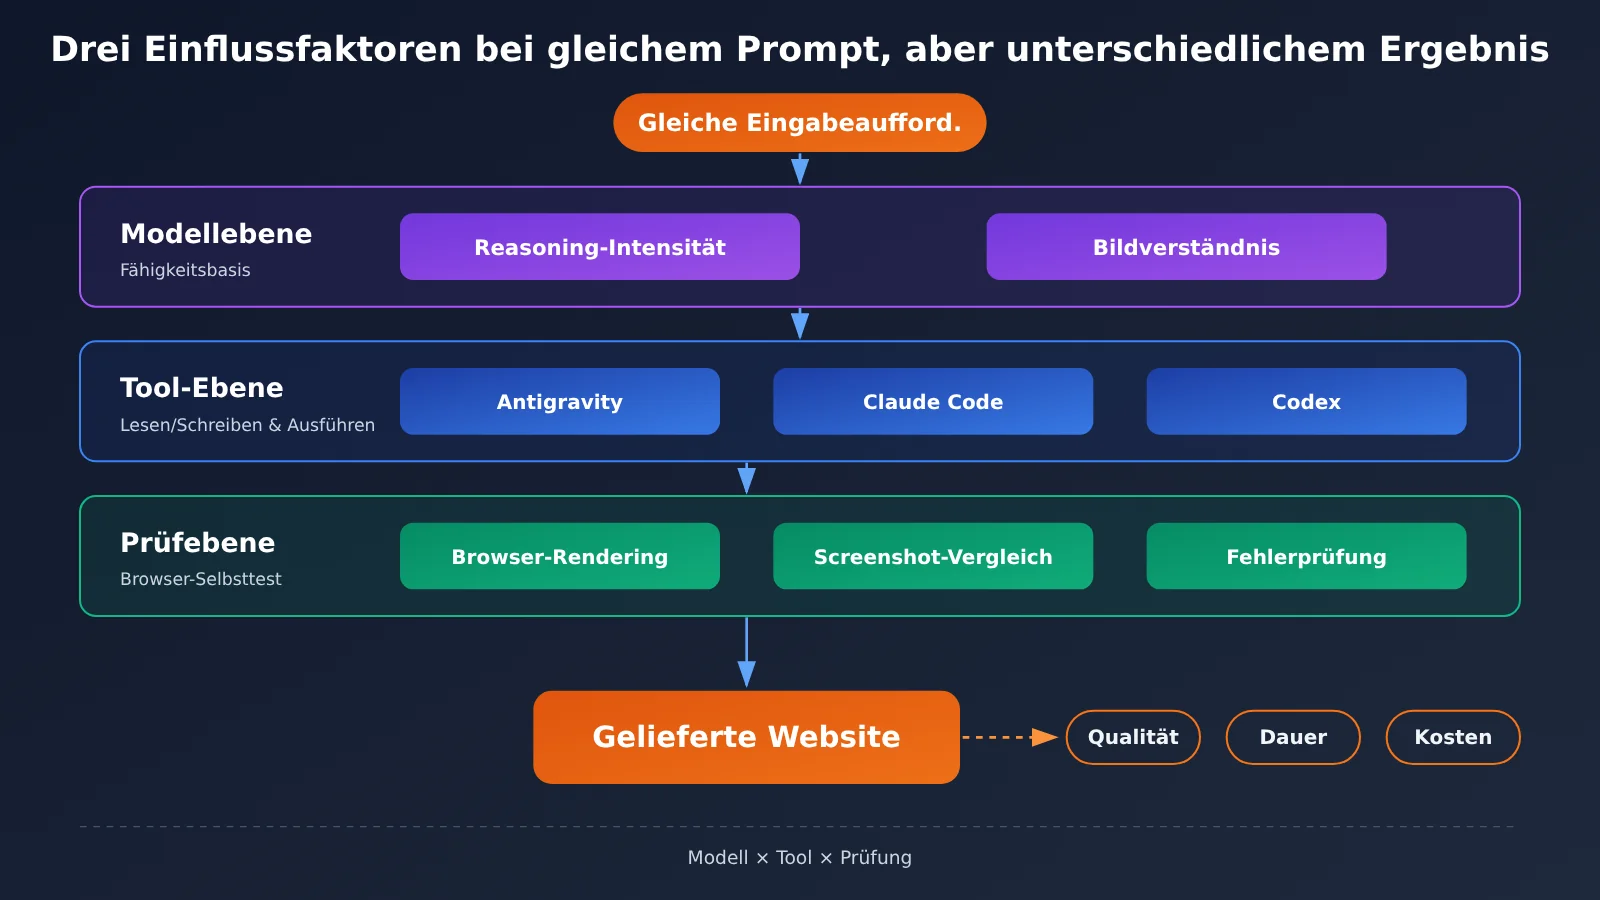
Laut offiziellen Quellen setzen die drei Anbieter bei der Webentwicklung unterschiedliche Schwerpunkte:
- Google (Carbon + Antigravity): Betont werden Frontend-Design, Browser-Verifikation, dynamische Effekte, komplexe 3D-Inhalte und Multi-Agent-Entwicklung. Zu den offiziellen Beispielen gehören das Redesign des Google Merchandise Store mit nur zwei Eingabeaufforderungen und ein interaktives 3D-Erlebnis mit Three.js.
- OpenAI (Astra + Codex): In der offiziellen Vorstellung von Astra stehen die Entwicklung von Websites, Apps und Spielen im Vordergrund. Dazu kommt ein Workflow, der nach der Generierung Qualitätsprüfungen für das Frontend ausführt.
- Anthropic (Opus + Claude Code): Offizielle Quellen liefern keinen Vergleich mit derselben Aufgabe. Allerdings haben Proofyard/Woofocus in einem Test vom 24. Oktober 2026 mit Opus 5.5 den ersten Entwurf und die Überarbeitung der Startseite eines Möbelstudios umgesetzt. Nach API-Preisen kostete das 4,34 US-Dollar. Dieser Test ist kein direkter Vergleich mit Carbon und Astra aus diesem Artikel.
Wie man die Ranglisten für Carbon, Opus und Astra liest
Neben dem einzelnen Praxistest lohnt sich ein Blick auf Ranglisten, die Ergebnisse aus vielen Aufgaben zusammenfassen. Alle Daten in der folgenden Tabelle sind mit dem Erhebungsdatum versehen. Die Elo-Werte hängen von der Testmethodik der jeweiligen Plattform ab und lassen sich daher nicht plattformübergreifend vergleichen.
| Rangliste (Datum) | Testtyp | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| Arena WebDev (2026-11-10) | Abstimmung in Head-to-Head-Duellen zur Webentwicklung | 1814 (Max) | 1764 (Max) | 1768 (High, vorläufiges Ranking) |
| DesignArena, Gesamtwertung Agentic (2026-11-11) | Frontend, Full-Stack, Spiele, Mobile, Office-Dokumente usw. | 1440 (High), Platz 1 | 1385 (Max), Platz 3 | 1291, Platz 7 |
In beiden Ranglisten liegt Opus vorn. Das deckt sich mit der subjektiven Reihenfolge des Autors im Nachbau-Test. Carbon liegt in der WebDev-Rangliste sehr nah an Astra, landet aber in der breiter angelegten DesignArena-Gesamtwertung weiter hinten. Das zeigt: „Entwicklung einzelner Webseiten“ und „komplexe Agent-Designaufgaben“ sind verschiedene Fähigkeitsdimensionen. Bei der Modellauswahl sollte man sich daher am eigenen Aufgabentyp orientieren.
So testen Sie Carbon, Opus und Astra selbst per API nach
Einzelne Tests anderer sind höchstens ein Ausgangspunkt. Am verlässlichsten ist es, die Modelle an den eigenen Aufgaben auszuprobieren. Das folgende Beispiel schickt über eine OpenAI-kompatible Schnittstelle dieselbe Eingabeaufforderung nacheinander an mehrere Modelle und protokolliert dabei Laufzeit und Token-Verbrauch. Beachten Sie: Gemessen wird nur der Schritt, in dem das Modell den Code direkt erzeugt. Die mehrstufigen Tool-Aufrufe und die Browser-Selbstprüfung, wie sie in der ursprünglichen Evaluation mit Antigravity, Claude Code und Codex stattfanden, sind nicht enthalten.
Minimalbeispiel
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="your-model-id",  # Maßgeblich ist der tatsächliche Name in der Modellliste der Plattform
    messages=[{"role": "user", "content": "输出一个单文件 HTML 食品品牌官网首屏,米白背景、居中悬浮产品罐头、酒红色弧形背景"}]
)
print(resp.choices[0].message.content[:500])
print(resp.usage)  # Eingabe- und Ausgabe-Tokens anzeigen
Vollständiges Skript für den erneuten Test mehrerer Modelle mit derselben Aufgabe anzeigen
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Mit einem Schlüssel Modelle mehrerer Anbieter aufrufen
)

# Maßgeblich sind die Modell-IDs aus der Modellliste der Plattform; Preiseinheit ist „US-Dollar / Million Tokens“, bitte gemäß der offiziellen Preisseite eintragen
MODELS = {
    "model-a": {"input_price": 0.0, "output_price": 0.0},
    "model-b": {"input_price": 0.0, "output_price": 0.0},
    "model-c": {"input_price": 0.0, "output_price": 0.0},
}

PROMPT = """请复刻一个食品品牌官网首屏,输出单文件 HTML:
1. 米白色背景,中央悬浮产品罐头,酒红色弧形背景,橙色环绕文字;
2. 顶部包含品牌标志、语言切换和菜单按钮;
3. 罐头支持鼠标拖动旋转,悬停时有缩放反馈;
4. 同时适配 1440x900 和 390x844 两种尺寸。
只输出完整代码。"""

def run(model: str, price: dict) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": PROMPT}],
    )
    elapsed = time.time() - start
    usage = resp.usage
    cost = (usage.prompt_tokens * price["input_price"]
            + usage.completion_tokens * price["output_price"]) / 1_000_000
    html = resp.choices[0].message.content
    with open(f"{model}.html", "w", encoding="utf-8") as f:
        f.write(html)
    return {
        "model": model,
        "seconds": round(elapsed, 1),
        "input_tokens": usage.prompt_tokens,
        "output_tokens": usage.completion_tokens,
        "api_equivalent_cost": round(cost, 4),
    }

if __name__ == "__main__":
    for name, price in MODELS.items():
        try:
            print(run(name, price))
        except Exception as e:
            print(name, "调用失败:", e)
Nach dem Durchlauf des Skripts liegt für jedes Modell eine HTML-Datei vor. Prüfen Sie dann anhand der Vier-Schritte-Checkliste aus der zweiten Runde im Browser nacheinander Layout, Interaktion und Fehlermeldungen in der Konsole, und beziehen Sie anschließend Dauer und äquivalente Kosten in Ihre Bewertung ein. Um Ausreißer einzelner Läufe zu reduzieren, empfiehlt es sich, jedes Modell mindestens dreimal laufen zu lassen.
🚀 Tipp für den schnellen Einstieg: Bei Vergleichen mit derselben Aufgabe ist meist am lästigsten, sich bei mehreren Anbietern einzeln einen Schlüssel zu besorgen und unterschiedliche SDKs anzupassen. Erledigen Sie das am besten über APIYI (apiyi.com): Mit einem einzigen API-Schlüssel rufen Sie gängige Modelle von OpenAI, Claude, Gemini und anderen auf, die Schnittstelle ist OpenAI-kompatibel, und neue Nutzer erhalten ein kostenloses Testkontingent – ideal, um den Vergleichsablauf zunächst mit einer kleinen Stichprobe durchzuspielen.
Carbon, Opus, Astra: Einsatzszenarien und Entscheidungshilfe
Auf Basis dieses Tests und der Ranglistendaten lässt sich nach Entwicklungsziel eine erste Vorauswahl treffen. In der Spalte „Grundlage“ steht jeweils, woher die Information stammt – so können Sie besser einschätzen, wie belastbar sie ist.
| Entwicklungsziel | Erste Wahl | Grundlage | Empfohlene Überprüfung |
|---|---|---|---|
| Kostensensibel, viel Exploration und viele Iterationen | Gemini 4 Carbon | Niedrigste API-Äquivalenzkosten in diesem Test (gemessene Daten) | Kumulierte Kosten über mehrere kleine Aufgaben vergleichen |
| Wert auf visuelle Umsetzung, komplexe Interaktionen und hohen Fertigstellungsgrad | Claude Opus 5.5 | Vom Autor subjektiv als bester der drei bewertet, in beiden Ranglisten vorn | Bildschirm für Bildschirm auf Detailtreue und Interaktion prüfen |
| Wert auf Geschwindigkeit und effiziente Ausführung | GPT-6 Astra | Kürzeste Dauer in diesem Test (gemessene Daten) | Gleiche Aufgabe mit Zeitmessung und Qualitätsabnahme |
| Unsicher, welches Modell passt, erst mal einen Überblick gewinnen | Alle drei mit derselben kleinen Stichprobe erneut testen | Ein einzelner Test reicht für ein Fazit nicht aus | Über die einheitliche Schnittstelle von APIYI (apiyi.com) im Batch vergleichen |
Wann Carbon die richtige Wahl ist
- Prototyping-Phase: Sie wollen schnell mehrere Seitenvarianten ausprobieren. Niedrige Kosten pro Durchlauf bedeuten, dass Sie öfter iterieren können.
- Private Projekte oder Teams mit knappem Budget: Bei akzeptabler Qualität wird der Kostenunterschied über längere Zeit deutlich spürbar.
- Hauptentwicklung mit menschlicher Kontrolle: Carbon liefert die erste Version, anschließend übernimmt ein Mensch oder ein anderes Modell die Schlussprüfung.
Wann Opus die richtige Wahl ist
- Markenwebsites und Marketing-Landingpages: Bei hohen Ansprüchen an visuelle Umsetzung und Details sind Nacharbeiten teurer als die Modellaufrufe selbst.
- Seiten mit komplexen Interaktionen: Bei 3D-Darstellungen, Drag-Interaktionen und scrollgesteuerten Animationen zählt vor allem der endgültige Fertigstellungsgrad.
Wann Astra die richtige Wahl ist
- Enger Zeitplan: Sie brauchen in kurzer Zeit eine lauffähige, vollständige Seite.
- Wert auf Frontend-QA-Prozesse: Der Hersteller betont die Qualitätsprüfung nach der Generierung – das passt gut, wenn Sie die Abnahme in den Workflow verlagern möchten.
💡 Empfehlung: Dieser Test liefert eine vergleichende Beobachtung an einem realen Workflow, keine absolute Rangfolge. Entscheidend ist am Ende, welche Lösung bei Ihrer eigenen, identischen Aufgabe tatsächlich funktioniert hat – und wie viel Geld und Zeit sie gekostet hat. Wir empfehlen, über APIYI (apiyi.com) mit derselben Eingabeaufforderung einen kleinen Gegentest durchzuführen und erst dann das Hauptmodell festzulegen.
Häufig gestellte Fragen (FAQ)
Q1: Was wird beim Website-Test mit identischer Aufgabe für Carbon, Opus und Astra eigentlich verglichen?
Verglichen wird, wie gut drei Workflows aus „Modell + Entwicklungstool“ die offizielle Website von Agrumea Farm nachbauen können. Dazu gehören Seitenstruktur, visueller Stil, das 3D-Dosenkarussell, Scrollen und Ziehen, Lade- und Hover-Animationen, Seitenübergänge und das responsive Layout. Gemessen wird die Designtreue, nicht der originelle Geschmack.
Q2: Warum ist Carbon am günstigsten, landet im Ranking des Testautors aber ganz hinten?
Kosten und Qualität sind zwei voneinander unabhängige Dimensionen. Carbon verbraucht die wenigsten Eingabe-Token und hat die niedrigsten äquivalenten Kosten. Auf den Screenshots fallen die Dosen jedoch eher klein aus, und manche Textdetails wirken schwächer. Beim Kriterium „Treue zur Vorlage“ punktet Carbon deshalb nicht. Günstig heißt nicht schlecht, aber bei dieser Nachbauaufgabe legt der Autor mehr Wert auf den Fertigstellungsgrad von Opus.
Q3: Wann wurden die Tests durchgeführt? Veralten die Ergebnisse schnell?
Die Auswertung wurde am 11. November 2026 veröffentlicht. Die Tests von Opus und Astra waren am 6. November abgeschlossen, der Test von Carbon lief vom 10. bis 11. November – passend zur erweiterten Freigabe von Carbon am 10. November. Modelle und Tools entwickeln sich schnell weiter, deshalb sollten Sie die Ergebnisse als Momentaufnahme betrachten.
Q4: Worin unterscheiden sich die API-äquivalenten Kosten von den Abo-Gebühren?
Die API-äquivalenten Kosten werden anhand des Token-Verbrauchs und der API-Preise geschätzt und zeigen den tatsächlichen Ressourcenverbrauch des Modells. Abo-Gebühren sind monatliche Pauschalpreise, die sich nach Kontingent und Erneuerungsregeln richten. Bei derselben Aufgabe verbraucht ein Tool mit Monatspauschale womöglich nur einen Teil des Kontingents, während beim nutzungsbasierten Modellaufruf direkt eine Rechnung entsteht. Bei der Auswahl sollten Sie also immer von Ihrem eigenen Abrechnungsmodell ausgehen.
Q5: Wie vergleiche ich per API schnell die Webentwicklungsleistung dieser drei Modelltypen?
Sie können sich am Testskript in diesem Artikel orientieren:
1. Registrieren Sie sich bei APIYI (apiyi.com) und holen Sie sich Ihren API-Schlüssel samt kostenlosem Testkontingent.
2. Setzen Sie `base_url` auf `https://api.apiyi.com/v1` und prüfen Sie in der Modellliste der Plattform die Namen der Modelle, die Sie vergleichen möchten.
3. Rufen Sie die Modelle nacheinander mit derselben Eingabeaufforderung auf, notieren Sie Dauer und Token-Verbrauch und prüfen Sie die generierten Seiten anschließend im Browser.
Q6: Lässt sich der ursprüngliche Test mit einem einzelnen API-Aufruf reproduzieren?
Nicht vollständig. Der ursprüngliche Test lief in Antigravity, Claude Code und Codex. Dabei gab es mehrere Runden mit Dateilesen und -schreiben sowie Selbstkontrollen im Browser, und jeder Durchlauf dauerte über eine Stunde. Ein einzelner Aufruf prüft nur, wie gut ein Modell direkt Code erzeugt, und eignet sich daher für eine erste Vorauswahl. Wer dem Originaltest näherkommen will, braucht einen Agent-Workflow mit Browser-Verifikation.
Q7: Welche Einschränkungen hat dieser Test?
Vor allem drei: Jedes Modell wurde nur einmal ausgeführt, Zufallseffekte sind also möglich. Die Tool-Umgebungen und Testdaten unterscheiden sich, sodass sich die Leistung der Modelle selbst nicht isolieren lässt. Und das Ranking beruht auf der subjektiven Einschätzung des Autors. Außerdem können statische Screenshots nicht belegen, ob die Interaktionen vollständig umgesetzt sind. Der Test taugt daher als Referenzbeispiel, nicht als allgemeingültiges Ranking.
Carbon, Opus, Astra – die wichtigsten Erkenntnisse (Key Takeaways)
- Art des Tests: Dieselbe Aufgabe (eine Website nachbauen), drei Workflows, jeweils ein Durchlauf. Das ist ein Vergleich unter realistischen Bedingungen, kein kontrollierter Labortest.
- Designumsetzung: Der Autor findet Opus am überzeugendsten, danach Astra. Carbon landet auf dem letzten Platz.
- Geschwindigkeit: Astra war mit 68 Minuten am schnellsten und brauchte damit etwa halb so lange wie Opus.
- Kosten: Carbon kommt auf äquivalente Kosten von 10,86 US-Dollar. Das sind rund 18 % der Kosten von Opus und 12 % der Kosten von Astra.
- Kostenstruktur: Bei der Agent-Entwicklung dominieren die Input-Token. Einzelpreise und Cache-Regeln bestimmen deshalb maßgeblich die Rechnung.
- Ranglisten als Orientierung: Opus liegt sowohl bei Arena WebDev als auch im DesignArena-Gesamtranking vorn. Die Ranglisten messen jedoch jeweils nach eigenen Kriterien.
- Einstieg: Mit nur einem Key über APIYI (apiyi.com) lässt sich dieselbe Aufgabe mit kleiner Stichprobe erneut testen, bevor Sie sich für ein Hauptmodell entscheiden.
Fazit
Der Vergleich von Carbon, Opus und Astra beim Bau derselben Website führt zu drei zentralen Ergebnissen:
- Ergebnis: Bei dieser Nachbauaufgabe bewertete der Autor das Werk von Opus am besten. Das Produkt steht stärker im Mittelpunkt, und die visuelle Hierarchie ist klarer.
- Geschwindigkeit: Astra schaffte die Aufgabe in nur 68 Minuten und eignet sich damit für Projekte mit knappem Lieferzeitraum.
- Kosten: Die API-äquivalenten Kosten von Carbon liegen weit unter denen der beiden anderen. Das passt gut zu häufigen Iterationen und Szenarien mit knappem Budget.
Alle drei Modelle können hochwertige Webentwicklung leisten. Unterschiede gibt es vor allem bei der Abwägung zwischen visueller Umsetzung, Umsetzung der Interaktionen, Zeitaufwand und Kosten. Statt zu fragen, welches Modell absolut das beste ist, sollten Sie lieber Ihr eigenes Entwicklungsziel klären und die Aufgabe selbst durchlaufen lassen. Wir empfehlen, die Modelle über die einheitliche Schnittstelle von APIYI (apiyi.com) nebeneinander zu testen. Entscheiden Sie anhand der tatsächlich fertiggestellten Ergebnisse und der angefallenen Kosten.
📚 Referenzen
- Gemini 4 Carbon: No-Hype Full Review & Testing: Nachbau-Review derselben Website von Pat Simmons / AI for Mortals, 11.11.2026
- Link:
aiformortals.co/blog/gemini-4-carbon-review -
Hinweis: Hauptquelle für den Testaufbau, die Laufzeiten, die Token-Zahlen und die API-Äquivalenzkosten in diesem Artikel
-
Die drei Nachbau-Seiten: Die öffentlichen Arbeiten von Carbon, Opus 5.5 und Astra
- Link:
aiformortals.co/builds/agrumea-clone-gemini-4-carbon,aiformortals.co/builds/agrumea-clone-opus-5-5,aiformortals.co/builds/agrumea-clone-gpt-6-astra -
Hinweis: Die Interaktionseffekte lassen sich direkt im Browser selbst prüfen
-
Agrumea Farm Website: Die Originalseite, die für den Test nachgebaut wurde
- Link:
agrumeafarm.it/en -
Hinweis: Zum Abgleich, wie originalgetreu die Nachbauten sind
-
Arena-WebDev-Rangliste: Rangliste für Webentwicklung auf Basis von Duell-Abstimmungen
- Link:
arena.ai/leaderboard/code/webdev -
Hinweis: Der Artikel verwendet die Daten vom 10.11.2026
-
DesignArena-Rangliste: Übergreifende Agentic-Design-Rangliste
- Link:
designarena.ai/leaderboard -
Hinweis: Der Artikel verwendet die Daten vom 11.11.2026, die verschiedene Designaufgaben abdecken
-
Offizieller Google-Blog: Ankündigung zur Verfügbarkeit von Gemini 4 Carbon
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ -
Hinweis: Die offizielle Positionierung von Carbon bei Frontend-Design und Browser-Verifikation
-
Offizielle OpenAI-Vorstellung: GPT-6 Astra
- Link:
openai.com/index/gpt-6-astra/ -
Hinweis: Beschreibung der Workflows von Astra für Webentwicklung und Frontend-QA
-
Woofocus-Test: Vergleich verschiedener Claude-Modelle beim Webdesign, 24.10.2026
- Link:
app.woofocus.com/blog/best-claude-model-for-web-design - Hinweis: Ergänzende Referenz zu Design- und Änderungsaufgaben von Opus 5.5, kein direkter Vergleich der drei Modelle
Autor: APIYI-Technikteam
Austausch: Melden Sie sich gerne über die Startseite von APIYI bei uns. Weitere Anbindungsinformationen finden Sie im Dokumentationscenter unter docs.apiyi.com