작성자 노트: Artificial Analysis Search Index의 2026-11-09 리더보드에 따르면, 응답 모델 하나를 고정하고 검색 구성만 바꿨을 때 종합 점수가 33점에서 83점까지 달라질 수 있어요. 다만 모델을 고를 때는 작업 비용, 소요 시간, 평가 범위도 함께 봐야 해요.
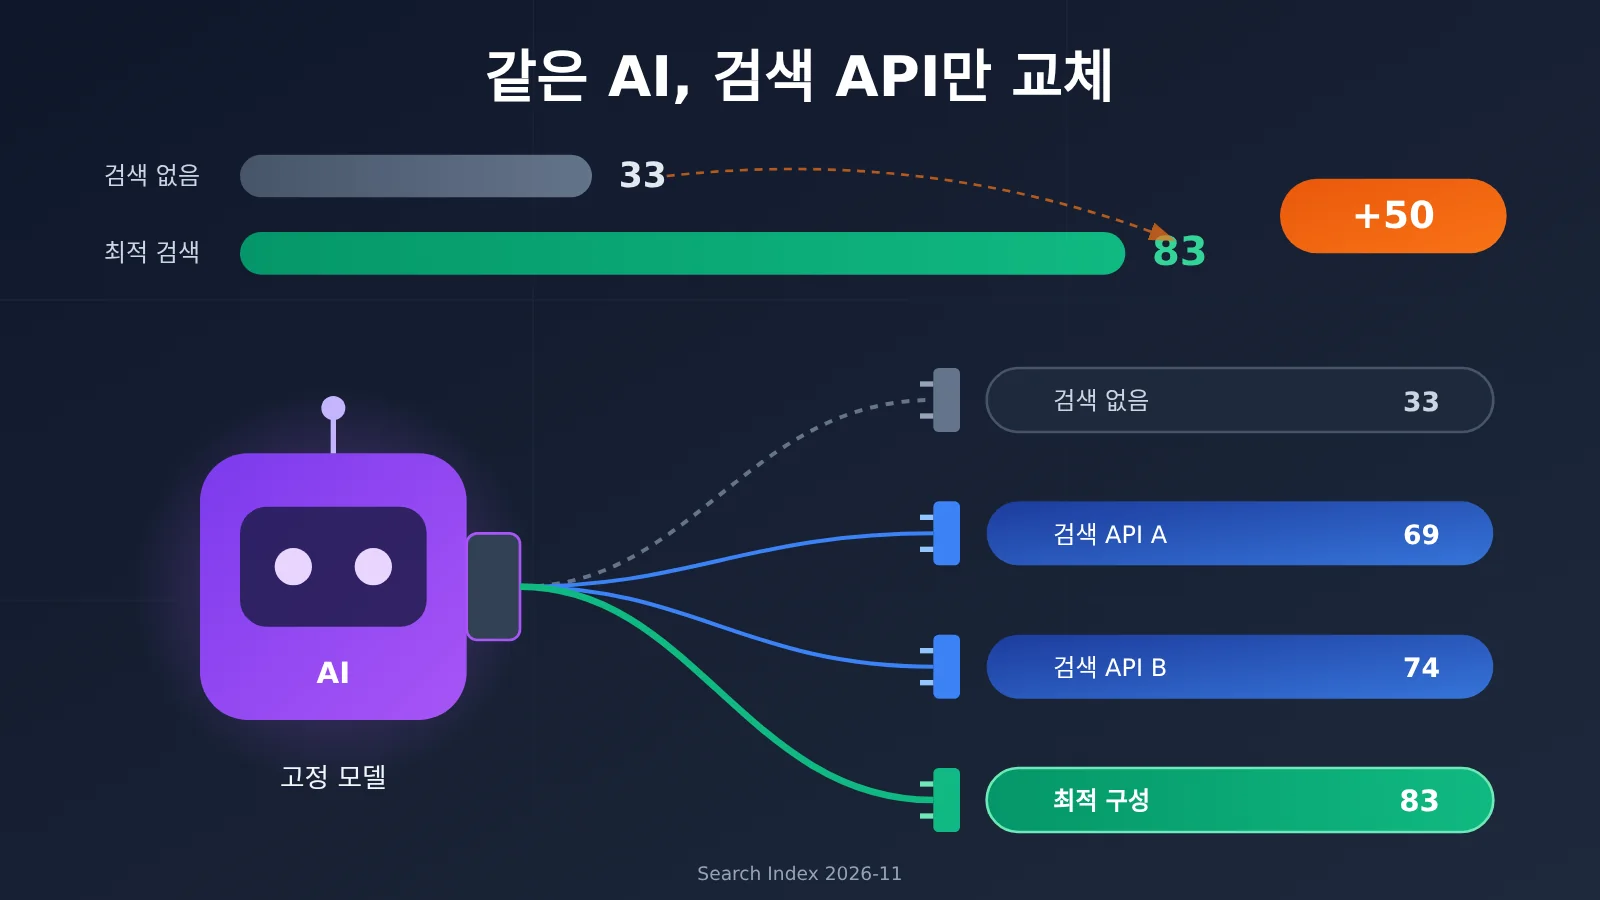
많은 분이 에이전트를 만들 때 모델을 먼저 고르고, 그다음 검색 도구를 슬쩍 붙여요. 적지 않은 팀이 검색을 ‘인터넷만 되면 되는’ 부품 정도로 생각하죠. 그런데 Artificial Analysis가 2026년 11월 9일에 업데이트한 Search Index는 다른 결과를 보여줬어요: 같은 모델이 검색을 연결하지 않았을 때는 33점인데, 가장 좋은 검색 API 구성을 적용하면 83점까지 올라가요.
이건 ‘각자 잘하는 게 다르다’는 흔한 리더보드 복사본이 아니에요. 이 글에서는 83점이 어떻게 계산됐는지와 테스트 조건을 풀어서 설명하고, 품질, 전체 작업 소요 시간, 검색 비용과 모델 비용을 함께 비교할게요. 마지막으로 이 리더보드가 어떤 의사결정에 쓸 수 있는지, 어디에는 그대로 적용하면 안 되는지를 상황별로 짚어볼게요.
핵심 가치: 이 글을 다 읽고 나면 공개 리더보드로 검색 API 후보를 추릴 수 있고, 자기 작업에 맞춰 2차 비교를 해볼 수 있어요. 최고 점수만 보고 결정하는 일을 피할 수 있죠.
검색 API 리더보드를 읽기 전에 알아야 할 용어
한 줄 요약: Search Index는 같은 모델이 서로 다른 검색 설정에서 보이는 성능을 비교하며, 점수 차이는 최대 50점까지 벌어져요. 하지만 “점수가 높다”가 “당신에게 가장 잘 맞는다”는 뜻은 아니에요. 비용, 소요 시간, 평가 범위도 함께 봐야 해요.
리더보드를 읽기 전에, 아래 용어부터 정리하고 갈게요.
- Search Index: 지정된 검색 벤치마크를 규칙에 따라 집계한 종합 점수예요. 이 글에서는 Artificial Analysis의 검색 API 평가 지수를 가리키며, 만점은 100점이에요.
- F1: 정밀도와 재현율의 조화평균이에요. 정답이 “엔터티 묶음”일 때, 답이 얼마나 정확하고 빠짐없는지를 측정하는 데 써요.
- Harness: 모델 입력, 도구 실행, 작업 채점을 구성하는 테스트 프레임워크예요. Artificial Analysis가 사용하는 에이전트 루프의 이름은 Stirrup이에요.
- Search API: 쿼리에 따라 웹 링크, 제목, 관련 스니펫 같은 검색 결과를 반환하는 인터페이스예요. 예를 들면 Exa, Brave, Perplexity Search API가 있어요.
- Token: 모델이 텍스트를 처리하는 계량 단위예요. 검색 결과가 길어질수록 모델에 들어가는 토큰이 많아지고, 모델 비용도 높아져요.
검색 API 하나로 같은 AI가 50점이나 차이 난다고?
Artificial Analysis는 2026년 8월 18일 검색 API 벤치마크를 선보였어요. 최신 공개 데이터는 2026년 11월 9일에 업데이트되었고, 14개 서비스 제공자와 26개 Search API 제품 또는 설정을 포함해요. 이 벤치마크가 평가하는 건 모델이 아니라, 검색 서비스를 에이전트에 넣은 뒤의 실제 효과예요.
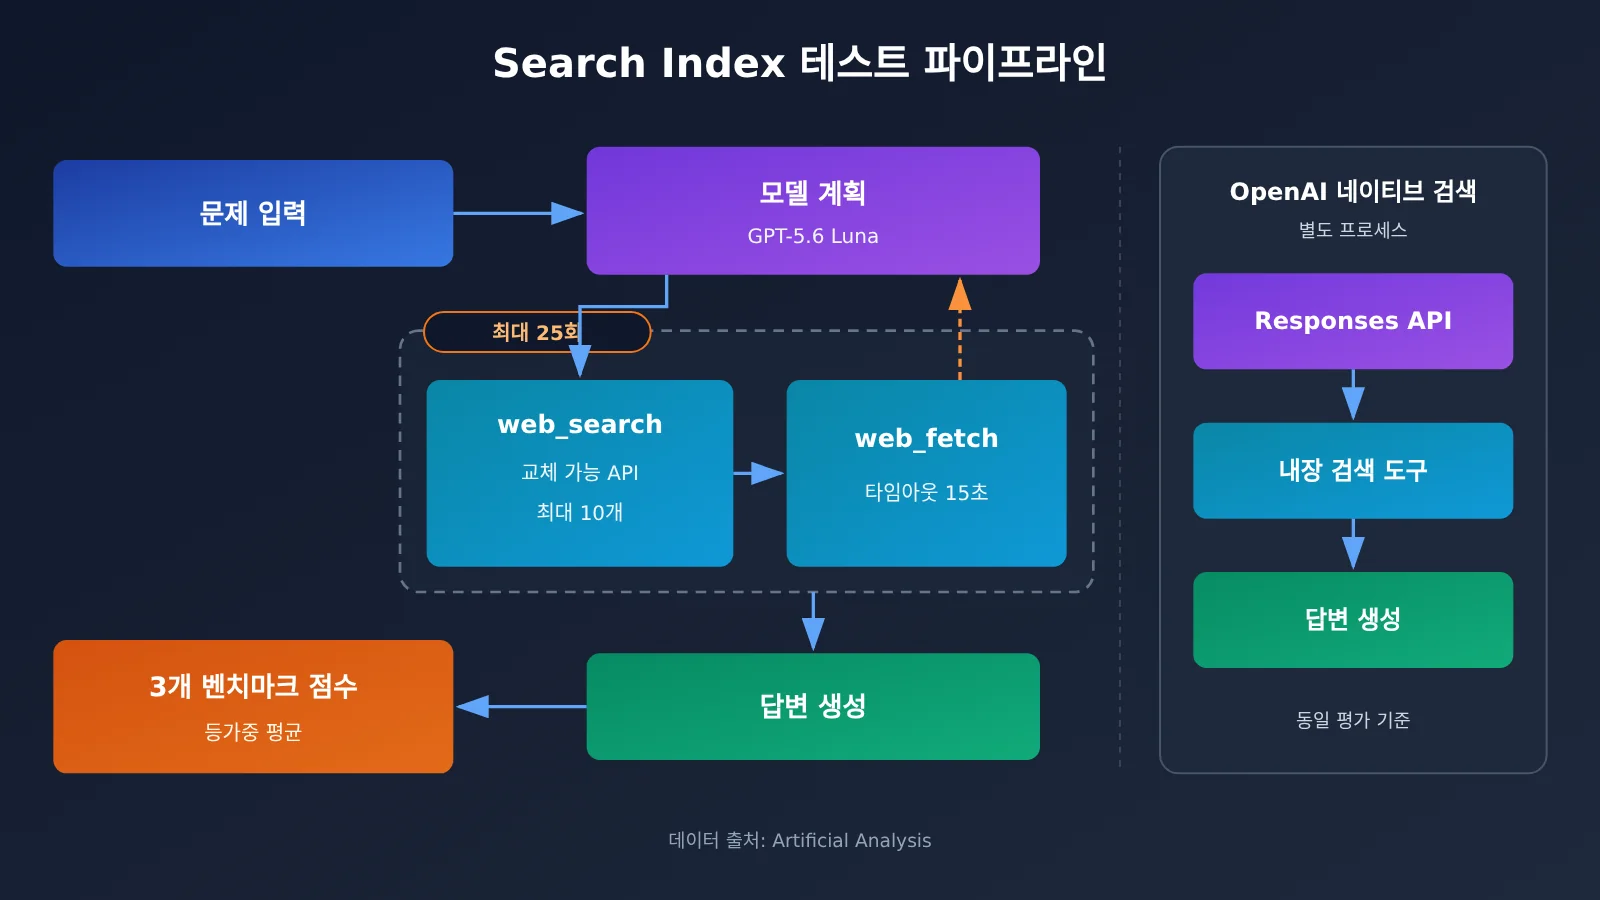
실험 설계의 핵심은 “변수 통제”예요. 답변 후보 모델은 GPT-5.6 Luna(medium)로 고정하고, 에이전트 프레임워크도 그대로 둔 채 검색 서비스만 바꿔요. 이 조건에서 검색 도구를 쓰지 않은 베이스라인은 33점에 그쳤고, 1위인 Keenable Pro는 83점에 도달해 50점 차이가 났어요. 검색을 연결한 설정들 사이에서도 DeepSeek Search Summary의 69점부터 Keenable Pro의 83점까지 14점 차이가 있어요.
예외가 하나 있는데, 따로 짚고 넘어가야 해요: OpenAI 네이티브 Web Search는 작동 방식이 달라요. 다른 독립 Search API는 모두 Artificial Analysis의 외부 에이전트 루프에서 실행돼요. 반면 OpenAI Web Search는 Responses API의 내장 도구 흐름을 사용하고, 검색 횟수와 실행 방식은 OpenAI가 직접 결정해요. 그래서 74점은 참고 자료로 쓸 수 있지만, 완전히 동일한 조건에서 이뤄진 “API 교체” 실험으로 보기는 어려워요.
또 하나 기억해 둘 점은, 이 50점이 같은 평가 체계 안에서의 검색 증강 효과라는 사실이에요. 누구든 어떤 모델이든 검색만 연결하면 50퍼센트 포인트가 오른다는 뜻은 아니에요.
Search Index의 83점은 대체 어떻게 측정된 걸까요?
Search Index의 세 가지 벤치마크와 채점 방식
종합 점수는 세 가지 벤치마크의 동일 가중 평균으로, 각각 3분의 1씩 차지해요:
| 벤치마크 | 과제 규모 | 과제 유형 | 평가 지표 |
|---|---|---|---|
| DeepSearchQA | 900개 | 복잡한 사실 조사, 정답이 집합인 경우가 많음 | 답변 집합 F1 |
| BrowseComp | 200개 | 난이도가 높은 웹 검색 질의응답 | 정확 답변 정확도 |
| AA-Omniscience | 600개 | 사실 질의응답 | 사실 질의응답 정확도 |
세 항목을 합치면 1,700개 과제이지만, 종합 점수는 1,700문제를 한데 모아 정답률을 계산한 값이 아니에요. Keenable Pro를 예로 들면 세 항목 점수가 차례로 88, 87, 73이고, 평균은 약 82.67이라 반올림해서 83으로 표시돼요. 즉 83점은 “정답률 83%”와 같지 않아요.
Search Index의 테스트 조건
방법론에서 공개한 핵심 설정은 다음과 같아요:
| 실험 항목 | 실제 설정 |
|---|---|
| 후보 답변 모델 / 채점 모델 | GPT-5.6 Luna(medium) |
| 최대 에이전트 라운드 | 25라운드, 라운드 내 도구 호출 횟수 제한 없음 |
| 사용 가능 도구 | web_search, web_fetch(독립 웹페이지 읽기) |
| 검색 결과 수 | 회당 최대 10개 |
| 본문 크롤링 타임아웃 | 페이지당 15초 |
| 모델에 반환되는 내용 | 서비스 제공자의 원본 응답 내용 |
| 검색 없는 기준선 | 동일 모델, 검색 도구 미사용 |
이 표에서 두 가지를 알 수 있어요. 첫째, 모델에 돌려주는 것은 “서비스 제공자의 원본 응답”이에요. 스니펫 길이, 요약 방식, 하이라이트 구성이 모두 모델 컨텍스트로 들어가기 때문에, 점수는 기저 웹 인덱스 품질만이 아니라 정보가 조직되는 방식까지 반영해요. 둘째, 429나 5xx, 타임아웃 같은 치명적 오류는 성공할 때까지 계속 재시도되고, 이 오류들은 최종 결과에 포함되지 않아요. 이는 곧 이 순위표가 “정상 작동했을 때”의 품질을 재는 것이지, 각 서비스의 프로덕션 환경 가용성이나 장애율을 증명하는 자료는 아니라는 뜻이에요.
최신 Search Index 순위: 검색 API, 어디가 가장 뛰어날까?
아래 표에서 품질 점수와 BrowseComp는 2026-11-09 기준 순위표에서 가져왔어요. 소요 시간은 2026-11-13에 읽어온 순위표 값으로, 표준 테스트 작업이 시작부터 끝날 때까지 걸리는 평균 시간을 뜻해요. 검색 API 단일 요청의 네트워크 지연 시간이 아니에요.
| 검색 구성 | 종합 점수(11-09) | BrowseComp | 평균 작업 소요 시간(11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16.6초 |
| Keenable Realtime | 82 | 86% | 16.0초 |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36.7초 |
| Perplexity Search Medium | 80 | 87% | 31.1초 |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19.4초 |
| Parallel Advanced | 75 | 77% | 이번 소요 시간 업데이트에 미기재 |
| Brave LLM Context | 75 | 77% | 이번 소요 시간 업데이트에 미기재 |
| OpenAI Web Search Medium(Responses 내장 흐름) | 74 | 74% | 33.1초 |
| DeepSeek Search Summary | 69 | 63% | 22.4초 |
| 검색 없음 베이스라인 | 33 | 17% | — |
검색 API 순위에서 드러나는 세 가지 전형적인 차이
같은 점수, 다른 속도. Exa Auto와 Perplexity Medium은 모두 80점이지만, 전체 작업 소요 시간은 각각 36.7초와 31.1초예요. Keenable Pro는 점수가 더 높은데도 소요 시간은 16.6초 정도밖에 안 돼요. 실시간 응답이 필요한 Agent 입장에서는 이런 차이를 사용자가 곧바로 체감하게 돼요.
BrowseComp가 종합 점수를 그대로 따라가지는 않아요. Perplexity Medium의 BrowseComp는 87%로 Keenable Pro와 어깨를 나란히 하지만, 종합 점수는 3점 낮아요. 차이는 주로 나머지 두 벤치마크에서 갈려요. 여러분의 업무가 “난도 높은 웹 문서 검색”에 더 가깝다면 BrowseComp 열만 따로 참고하면 돼요.
같은 업체의 다른 모드도 차이가 커요. Exa Lite와 Exa Auto는 1점 차이인데, 소요 시간은 거의 두 배 차이가 나요. 그래서 제품별 모드를 따로따로 해석해야 하고, Exa Lite와 Exa Auto를 하나의 “Exa 점수”로 합치면 안 돼요.
💡 데이터 안내: 위 점수는 Artificial Analysis 제3자 평가 결과이고, 소요 시간은 표준 작업 소요 시간이에요. 여러분의 실제 업무 문제에서 비슷한 비교를 재현하고 싶다면 APIYI apiyi.com을 통해 응답 모델을 하나로 고정한 뒤, 서로 다른 검색 도구를 각각 연결해 A/B 테스트를 해보세요.
검색 API 최고 점수가 가장 경제적인가요?
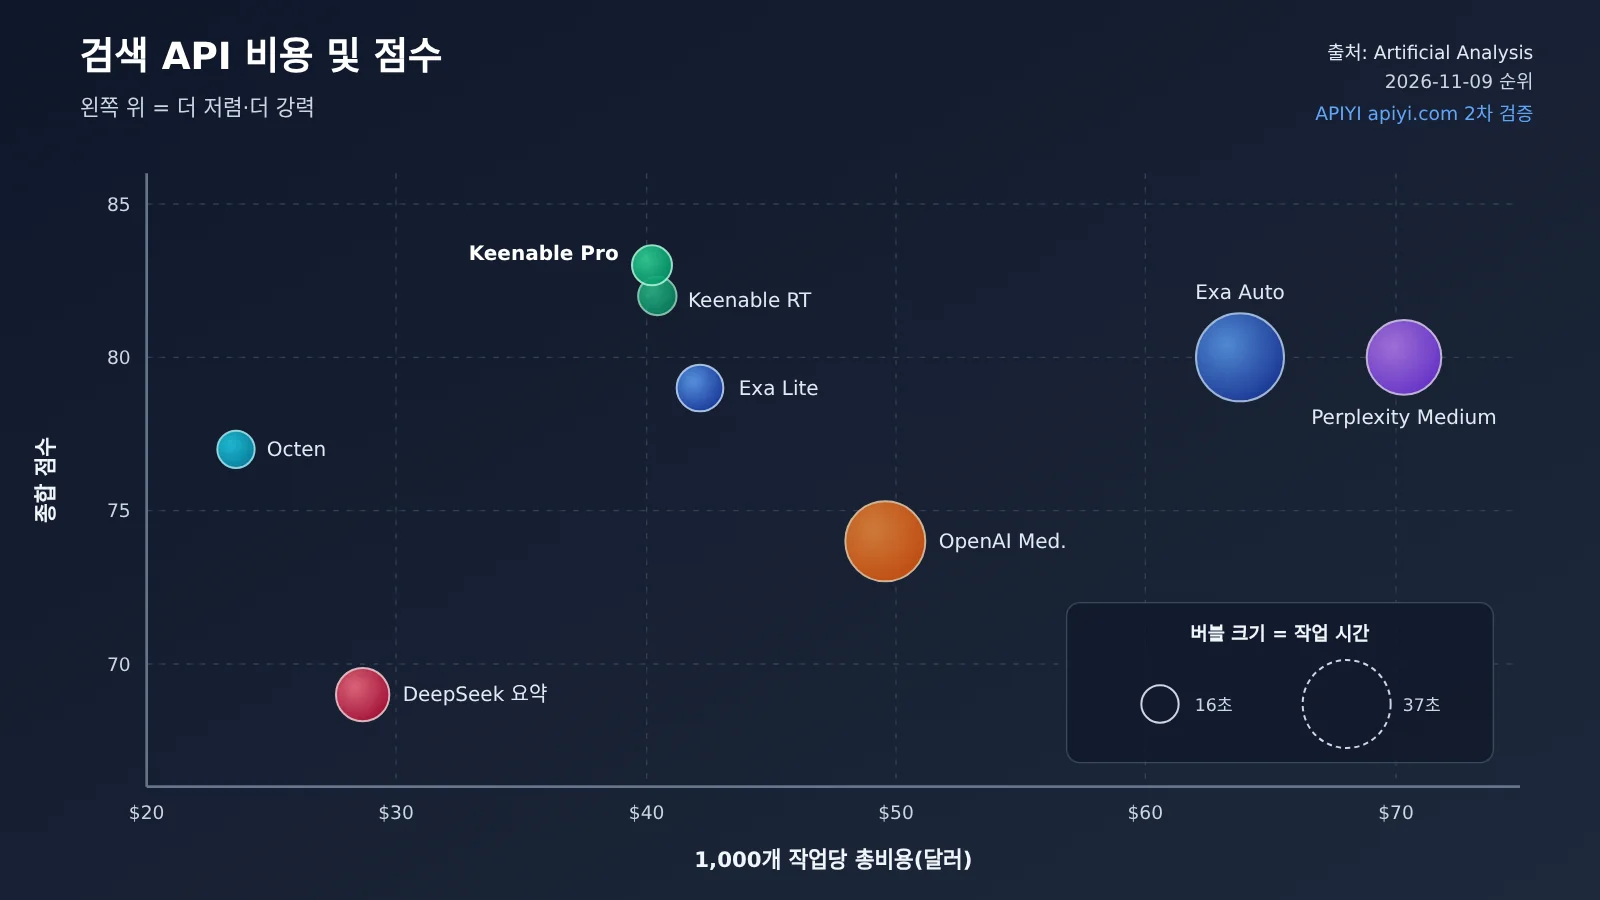
Artificial Analysis는 1,000개 벤치마크 작업당 예상 비용도 공개하는데, 검색 비용과 모델 비용으로 나눠서 보여줍니다(2026-11-09 리더보드 기준, 달러). ‘점수당 비용’ 열은 본문 편집자가 ‘총비용 ÷ 종합점수’로 대략 계산한 것으로, 가로 비교용 참고 자료일 뿐 공식 지표는 아닙니다.
| 검색 구성 | 품질 점수 | 검색 비용 + 모델 비용 | 총비용/1,000개 작업 | 점수당 비용(편집자 산출) | 작업 소요 시간(11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | 약 $0.48 | 16.6초 |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | 약 $0.49 | 16.0초 |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | 약 $0.80 | 36.7초 |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | 약 $0.88 | 31.1초 |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | 약 $0.53 | 19.4초 |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | 약 $0.31 | 15.6초 |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | 약 $0.67 | 33.1초 |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | 약 $0.42 | 22.4초 |
검색 API 비용표에서 나온 세 가지 결론
최고 점수가 반드시 가장 비싼 것은 아닙니다. Keenable Pro는 83점으로 1위를 차지하며, 1,000개 작업당 약 $40.22로 작업 하나당 약 $0.04에 해당하는데, 샘플 안에서는 중간 수준입니다. Perplexity Medium은 점수가 3점 낮은데도 총비용은 약 75% 더 높습니다.
1점 차이에 비용은 30% 넘게 차이 날 수 있습니다. Exa Lite + Highlights는 79점, $42.15/1,000개 작업이고, Exa Auto + Highlights는 80점, $63.77/1,000개 작업으로, 전자가 약 34% 더 저렴하고 소요 시간도 더 짧습니다. Exa 공식 가격 페이지(2026-11-13 기준 자료)를 참고하면 Lite 등급은 1,000회 요청당 $4, Auto 등급은 1,000회 요청당 $7입니다. 리더보드에서 검색 비용의 차이는 이런 가격 구조와 일치합니다.
검색 비용이 낮으면 모델 비용은 오히려 더 높을 수 있습니다. DeepSeek Search Summary의 검색 비용은 $8.47에 불과하지만 모델 비용은 $20.19로 표에서 가장 높습니다. Octen은 총비용이 가장 낮지만 모델 비용은 Keenable, Exa, Perplexity보다 높습니다. 검색 결과가 충분히 효과적이지 않으면 에이전트가 검색을 더 여러 번 하고 페이지를 더 여러 개 읽게 되면서 토큰 소비가 늘어납니다. 그래서 비용을 계산할 때는 ‘작업 하나를 완료하는 총비용’을 단위로 삼아야 하며, 검색 API의 1회 호출 가격만 봐서는 안 됩니다.
이 Search Index 순위표는 어떤 실제 선택에 도움을 줄까요?
Search Index는 영어 중심의 범용 사실 검색 평가이며, 중국어 인터넷에 특화된 벤치마크는 아니에요. 아래에서는 이를 일반적인 에이전트 시나리오와 연결해, 어떤 시나리오는 바로 참고할 수 있고 어떤 시나리오는 추가 테스트가 필요한지 표시해볼게요.
| 에이전트 시나리오 | 가장 중요한 지표 | 순위표 참고 가치 | 권장 후보 |
|---|---|---|---|
| 사실형 질의응답 | 정확도, 인용 정확도 | 높음, AA-Omniscience를 바로 참고 가능 | Keenable, Exa Lite, Perplexity |
| 복잡한 다중 출처 리서치 | 멀티홉 검색, 집합 리콜 | 높음, DeepSearchQA와 BrowseComp를 중점적으로 확인 | Keenable Pro, Exa Auto, Perplexity Medium |
| 저지연 에이전트 | 전체 작업 소요 시간, P95 지연 | 중간, 작업 소요 시간은 참고용으로만 활용 | Keenable Realtime, Octen, Exa Lite |
| 중국어 정보 검색 | 중국어 출처 커버리지, 중국 내 사이트 접근성 | 낮음, 중국어 테스트 세트를 직접 구축해야 함 | 바이두 첸판, 보차, 알리윈 바이롄을 대조군으로 추가 |
| 프로그래밍 문서 검색 | 공식 문서 커버리지, 버전 정보 | 낮음~중간, 실제 기술 질문으로 재테스트 필요 | Exa, Perplexity, Parallel |
Search Index로 검색 API를 2차 비교하는 방법
더 합리적인 방법은 공개 순위표를 ‘1차 필터링 도구’로 삼고, 자신의 작업으로 2차 비교를 진행하는 거예요.
- 품질, 소요 시간, 총비용 세 가지 기준으로 순위표에서 후보 구성 3~4개를 골라요.
- 간단한 사실, 최근 뉴스, 멀티홉 질문, 중국어 및 교차 언어 쿼리를 아우르는 자체 비즈니스 질문 50~100개를 준비해요.
- 동일한 답변 모델, 같은 최대 라운드 수와 결과 수를 고정하고 검색 도구만 교체해요.
- 정확도, 인용 정확도, 작업당 총비용, P50/P95 소요 시간, 빈 결과 및 타임아웃 횟수를 기록해요.
- 순위표는 재시도 후의 치명적 오류를 이미 제외했으므로, 운영 환경의 안정성은 별도로 부하 테스트를 진행해요.
검색 API 선정 가이드와 빠른 시작
🎯 선택 가이드: 종합적인 품질과 속도를 원한다면 Keenable Pro/Realtime을 먼저 테스트해 보세요. 비용에 민감하면서 80점에 가까운 품질을 원한다면 Exa Lite + Highlights와 Octen을 중점적으로 테스트해 볼 만해요. 이미 OpenAI 생태계를 깊게 쓰고 있는 팀은 내장 Web Search를 바로 사용해도 되지만, 실행 흐름을 제어할 수 없다는 점은 감수해야 해요. 실제로 도입할 때는 APIYI apiyi.com을 통해 응답 모델을 통합 호출하고, 검색 도구는 교체 가능한 플러그인 모듈로 만드는 걸 권장해요. 그래야 검색 API를 바꿀 때 모델 쪽 코드를 손대지 않아도 돼요.
미니멀 예제: 모델 쪽은 통합 인터페이스로
아래 코드는 응답 모델을 고정하고 검색 도구를 함수로 선언해요. 실제 구현을 어떤 Search API가 담당하는지는 로컬 코드에서 갈아끼우기만 하면 됩니다:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 모델 교체 가능
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 평가할 모델로 바꾸세요
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
전체 코드 보기: 동일 모델로 여러 검색 API A/B 비교
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # 응답 모델 고정, 통제 변수 유지
MAX_TURNS = 25          # Search Index와 동일한 최대 턴 수

# 각 검색 API용 어댑터 함수, 공식 문서를 보고 직접 구현하세요
def search_provider_a(query: str) -> list:
    return []  # [{"title":..., "url":..., "snippet":...}] 형태로 반환

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 빠르게 시작하기: 신규 사용자는 APIYI apiyi.com에서 무료 테스트 크레딧을 받을 수 있어요. 소량의 실제 업무 질문으로 위 A/B 스크립트를 먼저 돌려보고, 어떤 검색 API를 최종안에 넣을지 결정하세요.
자주 묻는 질문 (FAQ)
Q1: Search Index란 무엇인가요?
Search Index는 Artificial Analysis가 선보인 검색 API 평가 지수예요. 답변 모델과 Agent 프레임워크는 고정한 채 검색 서비스만 교체하고, DeepSearchQA, BrowseComp, AA-Omniscience 세 가지 벤치마크의 동일 가중 평균 점수로 검색 성능을 측정해요. 만점은 100점이에요.
Q2: 83점은 정답률 83%를 뜻하나요?
아니요. 83은 세 벤치마크 점수의 평균일 뿐이고, 세 지표의 성격도 서로 달라요. DeepSearchQA는 F1을 쓰고, 나머지 두 항목은 정확률을 써요. Keenable Pro의 세 항목 점수는 각각 88, 87, 73이며 평균은 약 82.67이라 83으로 표시된 거예요.
Q3: 리더보드 데이터는 언제 기준인가요?
품질 점수와 비용 데이터는 2026-11-09 리더보드 업데이트 기준이고, 전체 작업 소요 시간은 2026-11-13에 읽은 값을 사용했어요. 리더보드는 계속 갱신되니 인용할 때는 날짜를 함께 밝혀 주세요.
Q4: 리더보드의 소요 시간을 검색 API의 응답 속도로 봐도 되나요?
안 돼요. 표에 나온 소요 시간은 표준 작업 하나의 전체 소요 시간으로, 여러 차례의 검색과 웹페이지 읽기, 모델 추론까지 모두 포함한 값이에요. 단일 HTTP 지연은 따로 측정해야 하고, 가능하면 P50과 P95를 함께 기록하는 게 좋아요.
Q5: 제 업무에서 여러 검색 API의 효과를 빠르게 비교하려면 어떻게 하나요?
답변 모델 하나를 고정하고 검색 도구만 바꿔 보세요. APIYI apiyi.com을 통해 OpenAI 호환 인터페이스로 모델을 호출할 수 있는데, base_url을 `https://api.apiyi.com/v1`로 설정한 뒤 이 글의 A/B 스크립트를 그대로 적용하면 돼요. 모델을 바꾼 뒤 검색 효과 변화까지 보고 싶다면, 같은 Key로 OpenAI, Claude, Gemini 등의 모델을 전환할 수 있어요.
Q6: Search Index에는 어떤 한계가 있나요?
크게 네 가지예요. 첫째, 중국어 인터넷에 특화된 벤치마크가 아니에요. 둘째, OpenAI 네이티브 검색의 실행 흐름이 다른 구성과 달라요. 셋째, 429, 5xx, 타임아웃 같은 오류는 재시도 후 결과에 포함되지 않아서 실제 운영 환경의 안정성을 반영하지 못해요. 넷째, 비용은 평가 작업을 기준으로 추산한 값이라 실제 청구서와 다를 수 있어요. 중국어 뉴스나 국산 기술 문서 검색이라면 별도의 테스트 세트를 만들고, APIYI apiyi.com을 통해 국산 모델과 함께 검증해 보시길 권해요.
Search Index 검색 API 선택 핵심 요약
- 검색은 독립 변수입니다: 동일한 모델이 33점에서 83점으로 향상됐는데, 검색 API 선택이 Agent 품질에 직접 영향을 줍니다.
- 83점은 정확도가 아닙니다: 세 가지 벤치마크의 동일 가중 평균이며, 채점 기준이 각기 다릅니다.
- 소요 시간은 전체 작업 기준입니다: Keenable은 약 16초, Exa Auto는 약 37초로, 둘 다 단일 API 지연 시간이 아닙니다.
- 비용은 나눠서 봐야 합니다: 검색 비용이 낮은 대신 모델 비용이 높을 수 있으니, 단일 작업 총비용으로 비교해야 합니다.
- 1점 차이가 34% 차이일 수 있습니다: Exa Lite와 Auto는 단 1점 차이인데, 전자가 약 30% 이상 저렴합니다.
- 리더보드는 1차 스크리닝 용도입니다: 중국어, 프로그래밍 문서 같은 시나리오는 자체 작업으로 2차 A/B 비교가 필요합니다.
요약
이 Search Index 리더보드에서 가장 가치 있는 부분은 “동일 모델, 다른 검색 도구” 설계로 검색 품질이 Agent에 미치는 영향을 따로 측정했다는 점입니다:
- 품질: 검색 없음 33점, 최고 83점입니다. 모두 검색을 연결해도 구성 간에 약 14점 차이가 납니다.
- 속도: 같은 80점이라도 전체 작업 소요 시간이 5초 이상 차이 날 수 있고, 고득점 구성도 빠를 수 있습니다.
- 비용: Keenable Pro는 품질이 가장 높고 비용은 중간 수준이며, Exa Lite와 Octen은 비용 효율 면에서 뛰어납니다. DeepSeek Summary 사례는 낮은 검색 비용이 낮은 총비용을 의미하지 않는다는 것을 보여줍니다.
먼저 리더보드로 3–4개의 후보를 선정한 뒤, 자체 질문 세트에서 모델을 고정하고 A/B 테스트를 하는 것을 권장합니다. APIYI(apiyi.com)를 통해 답변 모델을 통일해서 호출하고, 검색 도구는 교체 가능한 모듈로 만들어 품질, 속도, 비용 세 가지 데이터로 최종 방안을 결정하시길 권합니다.
참고 자료
- Artificial Analysis Search API 리더보드: 품질 점수, 비용 및 소요 시간 데이터
- 링크:
artificialanalysis.ai/agents/search-api -
설명: 본문의 점수, 비용, 소요 시간의 주요 출처
-
Artificial Analysis Search API 평가 방법: 테스트 구성 및 채점 규칙
- 링크:
artificialanalysis.ai/methodology/search-api -
설명: 모델, 라운드, 결과 개수, 재시도 규칙 등의 설명 포함
-
Exa Pricing: Lite, Auto 등 티어별 가격
- 링크:
exa.ai/pricing -
설명: 리더보드에서 Exa 모드별 검색 비용 차이를 이해하는 데 활용
-
Exa 3.0 공지: Lite 모드 및 Dynamic Highlights
- 링크:
exa.ai/blog/exa-3 -
설명: 2026-10-19 발표, 벤더 자체 측정 데이터 포함
-
OpenAI Web Search 문서: Responses API 내장 검색 도구
- 링크:
developers.openai.com/api/docs/guides/tools-web-search -
설명: OpenAI 네이티브 검색의 실행 방식과 파라미터 이해
-
Perplexity Search API 가격: Standard 및 Fast 티어
- 링크:
docs.perplexity.ai/docs/getting-started/pricing - 설명: 요청당 과금 규칙 이해
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 첫 페이지에서 문의해 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.