작성자 주석: 구글은 2026-11-12에 Gemini 4 Hydrogen을 발표했습니다. 이 글은 공식 모델 카드의 10개 항목 비교표, Gemini 3.8 Flash 대비 개선된 점, 사양과 표준 등급 가격을 정리하고, 항목별로 수치 기준을 명확히 밝힙니다.
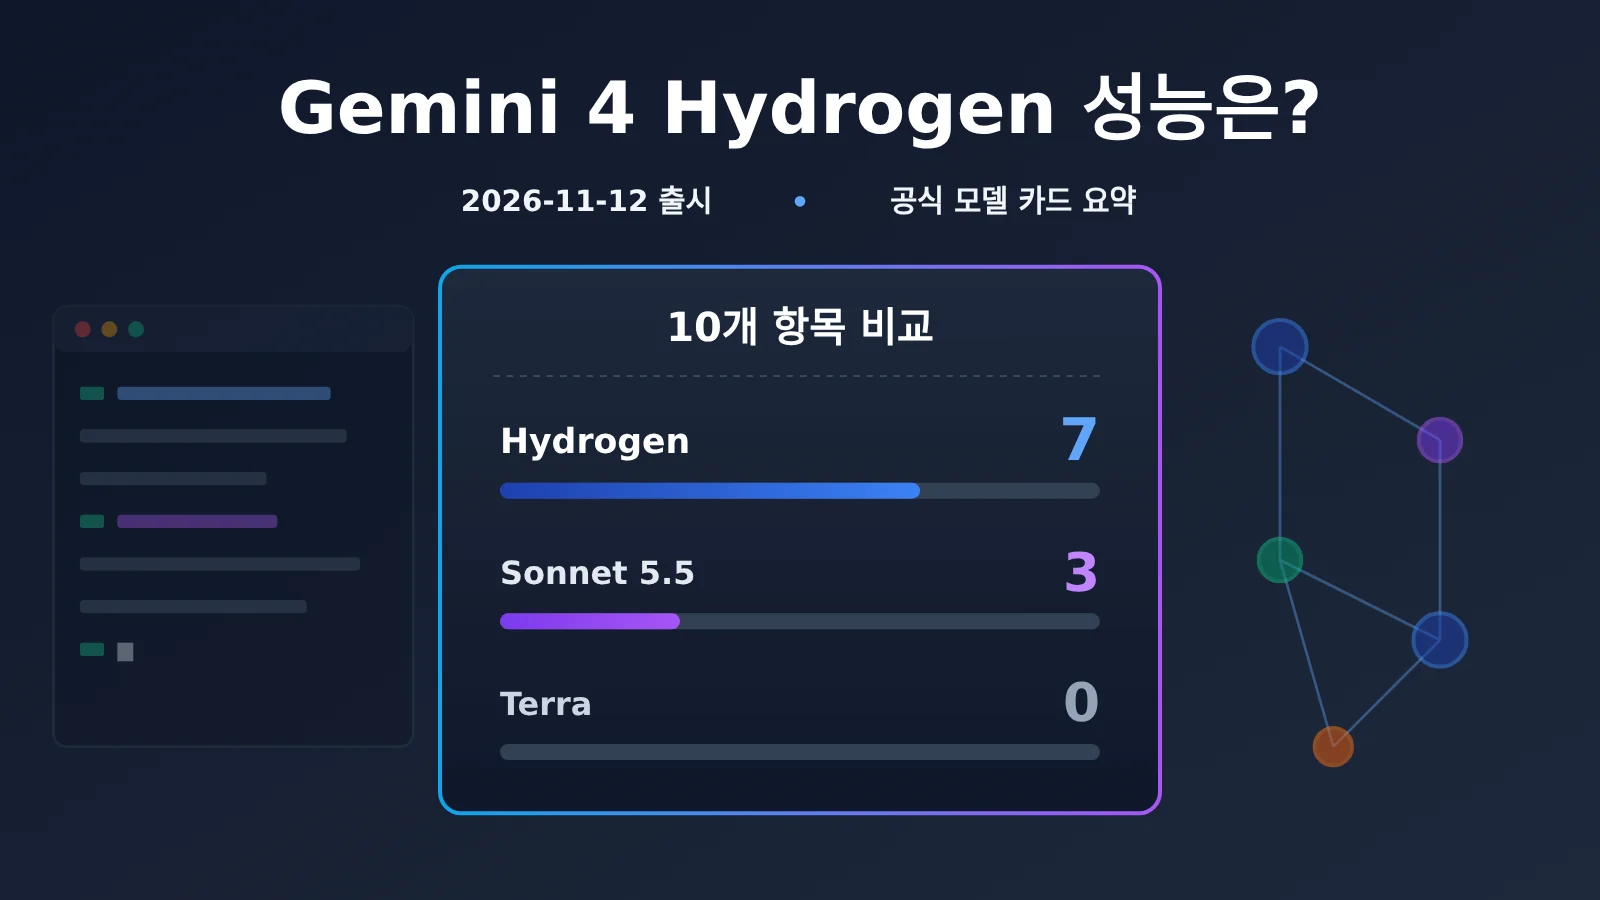
구글은 2026-11-12에 Gemini 4 Hydrogen을 공식 발표했으며, 모델 ID는 gemini-4-hydrogen입니다. 이 모델의 포지셔닝은 더 빠른 일상 코딩과 각종 에이전트 실행이고, Carbon이나 Argon처럼 가장 어려운 장기 추론을 담당하는 모델은 아닙니다. 공식 글로벌 표준 등급 가격은 입력 $1.50, 출력 $7.50(백만 토큰당)입니다. DeepMind 모델 카드의 10개 항목 비교표에서는 7개 항목에서 최고 점수를 기록했습니다.
이건 발표 전 코드명에 관한 소문이 아닙니다. 구글 블로그, 개발자 뉴스레터, DeepMind 모델 카드가 모두 이미 공개됐고, AI Studio 체험 링크도 gemini-4-hydrogen이라는 ID를 사용합니다. 참고로 이 글에서 인용한 점수는 전부 공식 자체 보고 또는 공식 모델 카드 집계에서 나온 것이며, APIYI의 재측정 결과가 아니에요.
핵심 가치: 이 글을 다 읽고 나면 Gemini 4 Hydrogen이 어떤 작업에서 앞서고, 어떤 작업에서 Claude Sonnet 5.5에 뒤지는지, 그리고 이 수치들을 어떻게 읽어야 하는지 알게 될 거예요.
Gemini 4 Hydrogen 핵심 정보 한눈에 보기
먼저 기본 사실부터 살펴볼게요. 아래 표의 정보는 Google 블로그, 개발자 뉴스레터, DeepMind 모델 카드(2026년 11월 게시)에서 가져왔고, 확인 날짜는 2026-11-13이에요.
| 정보 항목 | Gemini 4 Hydrogen 상세 |
|---|---|
| 출시 시점 | 2026-11-12, 당일부터 전 세계로 배포 |
| 출시 주체 | Google / Google DeepMind |
| 모델 ID | gemini-4-hydrogen |
| 출처 | 모델 카드에 “adapted from Gemini 4 Carbon”이라고 명시돼 있어요. 즉, Carbon에서 파생된 모델이에요. |
| 공식 포지셔닝 | 일상 코딩, 에이전트 실행; 단독으로 사용할 수 있고, 멀티 모델 워크플로에서 실행 엔진 역할도 할 수 있어요 |
| 사고 레벨 | low, medium, high(기본값), xhigh의 네 단계 |
| 지식 컷오프 | 2026년 3월, 일부 분야는 더 오래된 정보일 수 있어요 |
| 공식 채널 | AI Studio 모든 티어, Gemini API, Android Studio, Gemini for business, Gemini App, Google Search |
Google은 Gemini 4 패밀리의 역할 분담을 비교적 분명하게 설명해요: Carbon과 Argon은 가장 어려운 장기 추론을 담당하고, Hydrogen은 더 빠른 일상 작업을 담당해요. 따라서 Hydrogen과 Carbon을 “같은 등급 모델의 구버전·신버전”처럼 비교하는 건 적절하지 않아요. Carbon과의 관계는 같은 기반 위에서 역할을 나눈 두 갈래에 더 가까워요.
사용 채널 측면에서는 유료 Google AI Pro / Ultra 사용자가 Google Antigravity에서도 Hydrogen을 쓸 수 있어요. Sheets는 Pro / Ultra와 조건을 충족하는 기업 구독부터 우선 개방돼요. AI Studio는 공식적으로 모든 티어에서 사용 가능하다고 확인됐지만, 무료 티어의 구체적인 한도는 이번에 확인하지 못했으므로 여기서는 다루지 않을게요.
Gemini 4 Hydrogen의 네 단계 사고
네 단계 사고는 Hydrogen을 쓸 때 중요한 포인트예요. 공식 설명에 따르면 단계 간 품질, 지연 시간, 비용은 매끄럽게 증가하며, 개발자는 필요한 추론 깊이에 대해서만 비용을 지불할 수 있어요. 기본 단계는 high라서 이 점이 청구서에 직접 영향을 줘요. 가격 부분은 뒤에서 다시 다룰게요.
Gemini 4 Hydrogen 공식 10개 항목 비교표
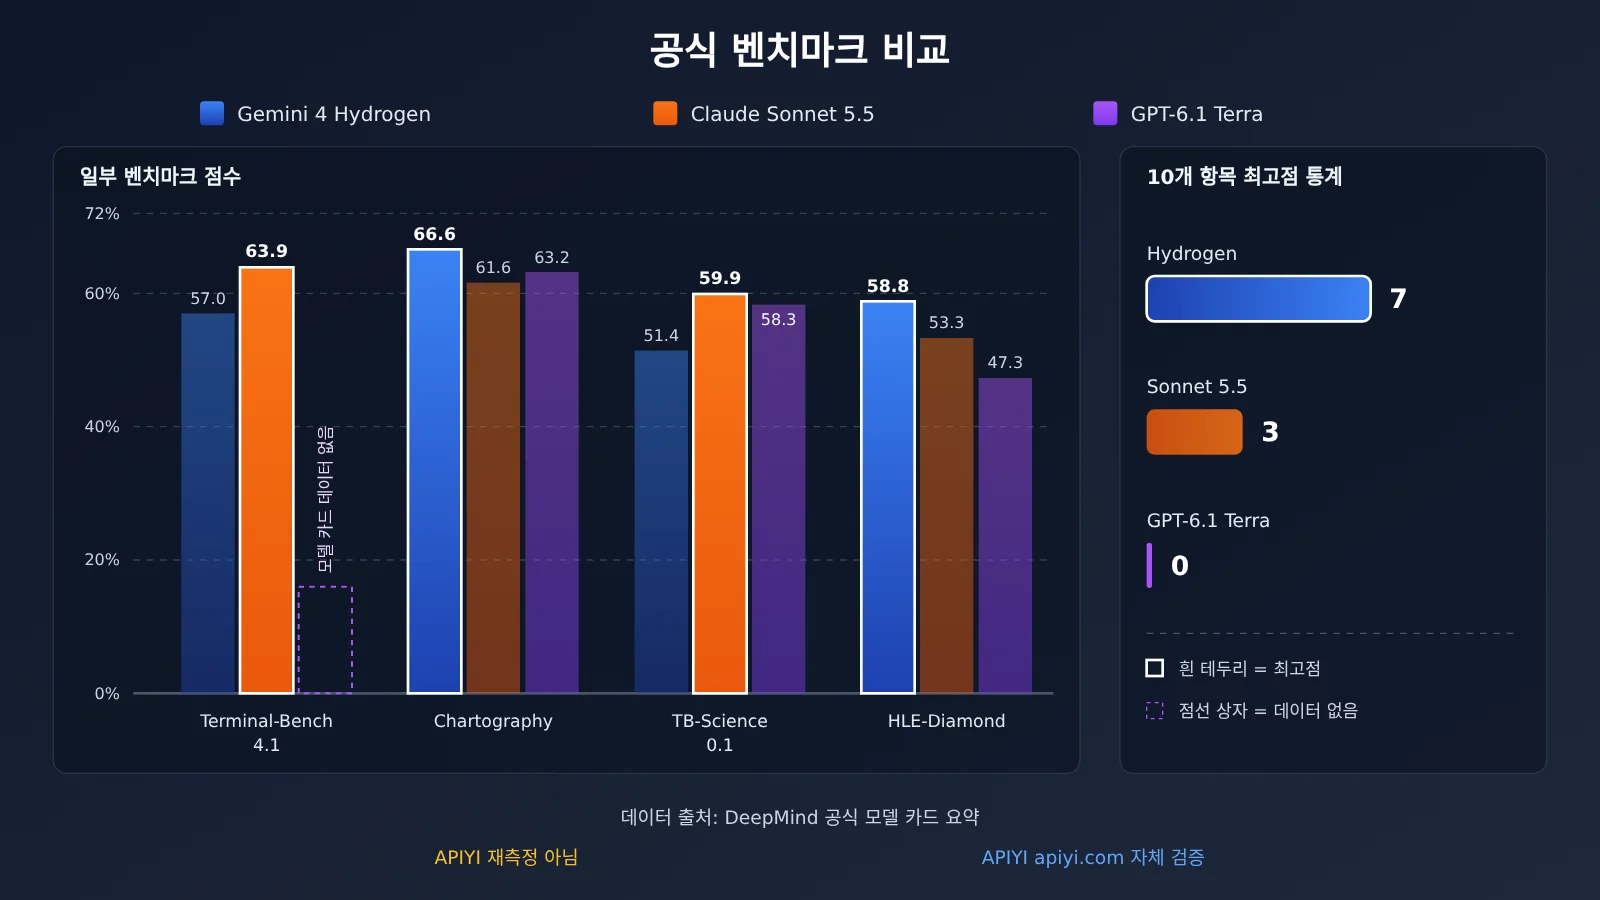
이것이 이 글의 가장 핵심적인 부분이에요. DeepMind 모델 카드에서 10개 항목 벤치마크 비교표를 제공했는데, 비교에 참여한 모델은 Gemini 4 Hydrogen, Claude Sonnet 5.5, GPT-6.1 Terra예요.
| 벤치마크 | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | 최고 |
|---|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1(치팅 보정) | 57.0% | 63.9% | 데이터 없음 | Sonnet |
| Agents’ Last Exam v1.1 | 71.6% | 60.4% | 69.8% | Hydrogen |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% | Hydrogen |
| Vending-Bench 2(계정 잔액, 달러) | 14549 | 11165 | 9107 | Hydrogen |
| OSWorld-2.1(오프라인 서브셋) | 77.6% | 83.9% | 74.2% | Sonnet |
| MKA(Climb WSR 정확도) | 53.4% | 52.0% | 43.8% | Hydrogen |
| Chartography | 66.6% | 61.6% | 63.2% | Hydrogen |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% | Sonnet |
| HLE-Diamond | 58.8% | 53.3% | 47.3% | Hydrogen |
집계 결과는 Hydrogen이 7개 항목에서 최고였고, Sonnet 5.5는 Terminal-Bench 4.1, OSWorld-2.1 컴퓨터 조작, Terminal-Bench-Science 세 항목에서 최고를 차지했어요. GPT-6.1 Terra는 점수가 있는 칸에서 1위를 차지하지 못했어요.
여기서 특히 주의할 점이 두 가지 있어요. 첫째, Terra는 Terminal-Bench 4.1 칸이 비어 있는데, 모델 카드가 숫자를 제시하지 않았기 때문에 이를 두고 “Terra의 터미널 능력이 더 나쁘다”고 해석하면 안 돼요. 둘째, “10개 중 7개 승리”가 전면적인 우위를 뜻하지는 않아요. Hydrogen은 터미널과 컴퓨터 조작처럼 에이전트 실행과 밀접하게 관련된 두 작업 유형에서는 여전히 Sonnet 5.5에 뒤처져요.
이 Gemini 4 Hydrogen 비교표를 읽는 방법
모델 카드의 방법 설명이 이 표를 어디까지 읽을 수 있는지를 결정해요. Hydrogen의 점수는 별도 표기가 없는 한 모두 최고 사고 단계, pass@1, 단일 시도, Gemini API를 통해 실행한 결과예요. Sonnet 5.5와 GPT-6.1 Terra는 기본적으로 각자 공개된 최대 사고 또는 추론 단계를 사용했고, 공개 결과가 없을 때는 확보 가능한 최선의 결과를 사용했어요.
다시 말해, 이건 같은 날, 같은 스크립트로 세 모델을 다시 실행한 결과가 아니에요. 특히 SWE-sweep 항목이 확실한데, 경쟁 모델 점수는 공개 리더보드에서 가져온 것이지, 구글이 동일한 스캐폴딩으로 재측정한 게 아니에요. 그래서 이 표는 대략적인 강약 방향을 판단하는 데 적합하고, 각 퍼센트포인트 차이를 정밀한 결론으로 삼기에는 적합하지 않아요.
또한 표의 Hydrogen 점수는 최고 사고 단계의 성적이고, 기본 단계는 high예요. 프로덕션 환경에서 기본 단계를 쓴다면 실제 성능이 표의 숫자와 차이가 있을 수 있으니, 이 점은 여러분의 작업에서 직접 검증해 보는 게 좋아요.
Gemini 4 Hydrogen이 Gemini 3.8 Flash보다 나아진 점
Gemini 3.8 Flash를 쓰고 있는 개발자라면, 이 절이 가로 비교표보다 더 참고가 될 수 있어요. 아래 수치는 모두 구글이 자체 발표한 값이에요.
| 항목 | Gemini 3.8 Flash | Gemini 4 Hydrogen | 설명 |
|---|---|---|---|
| 작업 완료 속도(기본 high) | 기준 | 2.5배 빠름 | 구글 자체 발표 |
| Terminal-Bench 4.1 | 18.2% | 57% | 세 배 이상 |
| 허위 주장 생성 | 기준 | 5배 이상 감소 | 구글 자체 발표 |
| 도구 실패 / 검색 결과 없음 시 | — | 더 능동적으로 우회 | 구글 정성적 설명 |
| 파트너 조기 테스트 속도 | 기준 | 2~2.8배 빠름 | 차트, SQL, 데이터 집약 워크플로 |
| 파트너 조기 테스트 토큰 사용량 | 기준 | 12%~23% 감소 | 구글 전언, 공개 리더보드 아님 |
터미널 작업 성공률이 18.2%에서 57%로 뛴 것은 이번 발표에서 가장 눈에 띄는 변화예요. Hydrogen이 “소형 모델이 실제로 커맨드라인 작업을 수행할 수 있는가”라는 문제에서 실사용이 가능한 기준선을 넘어섰다는 뜻이죠. 다만 가로 비교표에 다시 놓고 보면, 57%는 여전히 Sonnet 5.5의 63.9%보다 낮아요.
파트너 조기 테스트 데이터는 따로 봐야 해요. 구글이 전언한 파트너 결과일 뿐 공개 리더보드가 아니고, 적용 시나리오도 복잡한 차트, SQL, 데이터 집약 워크플로에 집중되어 있어서 모든 비즈니스로 일반화될 수는 없어요.
Gemini 4 Hydrogen의 기타 공식 자체 발표 성적
10개 항목 표 외에도 블로그와 모델 카드에는 몇 가지 성적이 더 실려 있는데, 역시 구글 자체 발표예요.
- Artificial Analysis Intelligence Index: 기본 high 등급이 51, Argon이 50, xhigh 등급은 54에 도달했어요. 구글이 AA 수치를 인용한 것이죠. Carbon은 AA Index v5에서 59점을 발표한 적이 있지만, 이번 공지에서는 Hydrogen이 같은 버전의 지수를 썼는지 밝히지 않아서 두 값을 그대로 빼서 비교하는 건 적절하지 않아요.
- Agent Arena: 개방형 에이전트 작업에서 5위.
- Vals Tax Agent Bench: 52.3%, 구글은 종합 1위라고 밝혔어요.
- Vals Legal Research Bench: 55.8%, 구글은 공동 1위라고 밝혔어요.
- HLE-Diamond: 58.8%, 구글은 동급 선도라고 밝혔어요.
Gemini 4 Hydrogen의 다중 모델 워크플로에서의 역할
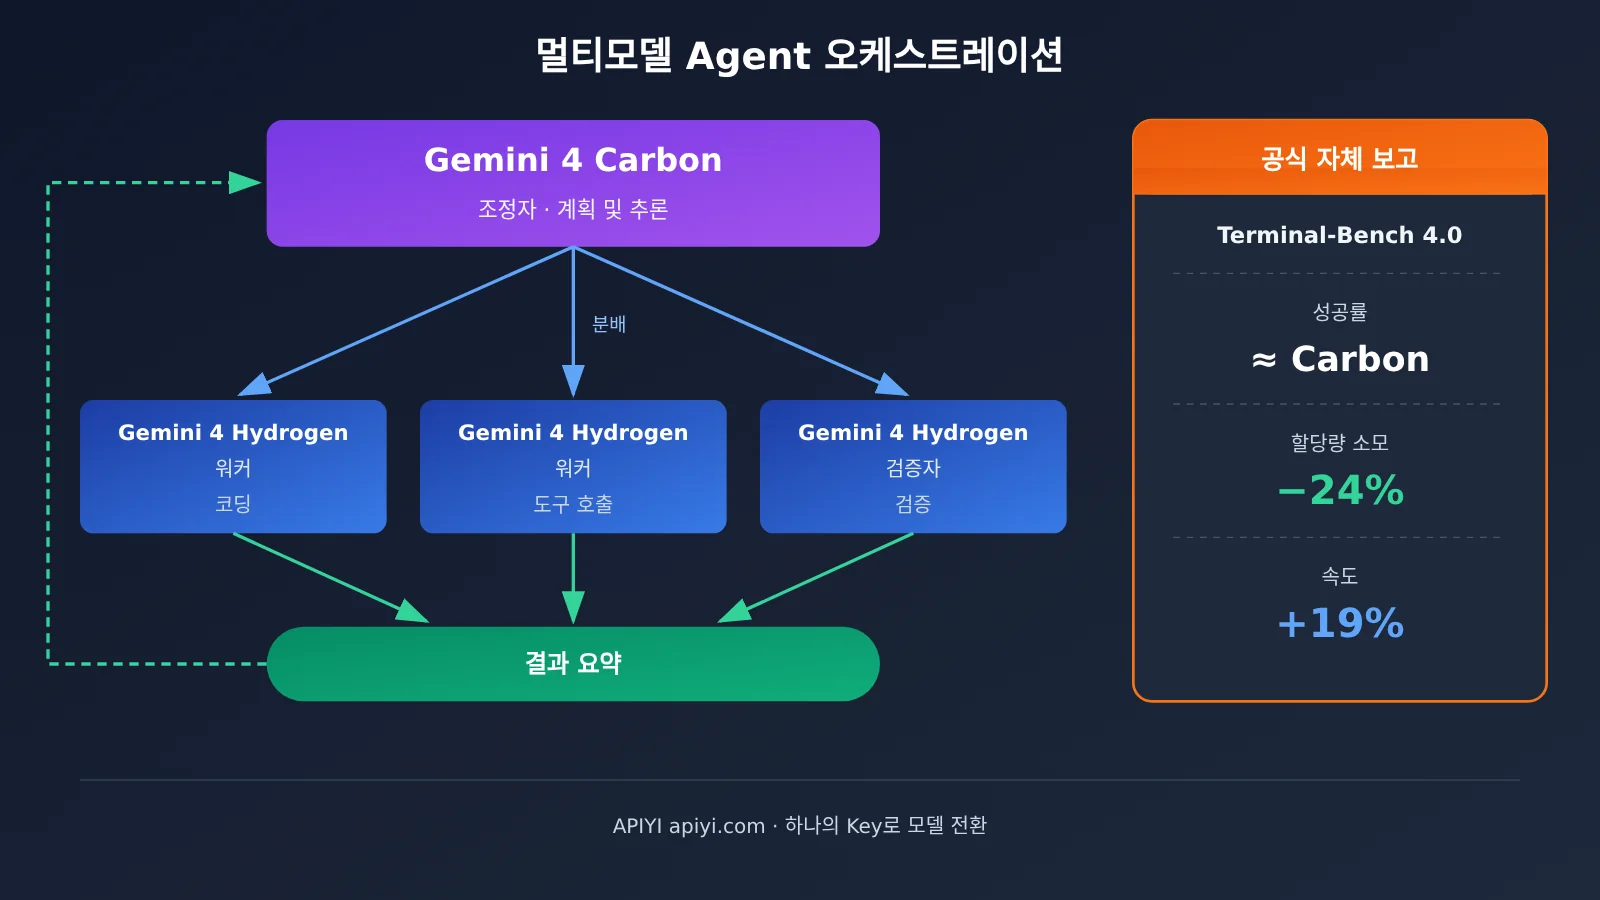
구글은 조합 사용법에 대한 데이터도 함께 내놨어요. Antigravity Orchestrator에서 시스템이 Carbon과 Hydrogen 사이를 전환하며, Terminal-Bench 4.0 작업 성공률은 순수 Carbon에 가까우면서 평균 24% 적은 할당량을 쓰고 19% 더 빨랐다고 해요. 병렬 모드에서는 Carbon이 조정자 역할을, Hydrogen이 워커나 검증자 역할을 맡아요.
이 데이터는 구글이 Hydrogen을 어떤 의도로 설계했는지 잘 보여줘요. Carbon을 대체하려는 게 아니라, 대량의 구체적 실행을 떠안고 비싼 추론은 정말 필요한 단계에 남겨 두려는 것이죠.
Gemini 4 Hydrogen 사양과 가격
컨텍스트 윈도우: 모델 카드와 블로그의 서로 다른 설명
컨텍스트 윈도우 항목은 모델 카드와 블로그의 설명이 완전히 일치하지 않아요. 여기서는 두 설명을 나란히 정리해 볼게요.
- 모델 카드:
combined input-output token context window of up to 1M, 즉 입력과 출력을 합쳐 최대 100만 토큰이에요. 동기 호출에서는 기본적으로 최대 6.4만 토큰을 출력하고, 백그라운드 long decode에서는 최대 100만 토큰을 출력해요. - 블로그: 네이티브 100만 토큰 입력, 출력은 최대 100만 토큰이에요.
실제 개발에서는 모델 카드의 더 보수적인 “합계 윈도우” 기준으로 예산을 잡는 편이 좋아요. 동기 호출의 기본 출력 상한인 6.4만 토큰도 함께 유의하세요. 초장문 출력은 백그라운드 long decode로 처리해야 해요. 입력 모달리티 측면에서 Hydrogen은 텍스트, 이미지, 오디오, 비디오를 지원해요.
Gemini 4 Hydrogen 공식 표준 티어 가격
블로그에서는 전체 100만 토큰 윈도우에 단일 가격이 적용된다고 설명해요. 아래 표는 Google Cloud 가격 페이지(2026-11-13 조회)에서 가져왔으며, 표준 티어만 나열했고 단위는 미국 달러/100만 토큰이에요.
| 과금 항목 | 글로벌 표준 티어 | 비글로벌 |
|---|---|---|
| 입력(텍스트, 이미지, 비디오, 오디오) | $1.50 | $1.65 |
| 캐시 읽기 | $0.075 | $0.0825 |
| 출력(응답과 추론 합계) | $7.50 | $8.25 |
| 캐시 쓰기 | 정가 $1.875, 2027-01-12부터 과금 | — |
간과하기 쉬운 점이 하나 있어요. 출력 가격은 응답과 추론을 합쳐서 계산해요. Hydrogen의 기본 사고 수준은 high라서 출력 청구서에는 사고 토큰이 포함돼요. 모델 카드에서도 더 높은 사고 수준은 토큰을 더 많이 소모할 수 있다고 알려줘요. 간단한 작업이라면 low 또는 medium으로 낮춰 비용을 조절하는 것도 고려해 볼 수 있어요.
오늘 Gemini 4 Hydrogen은 어디서 호출할까요
공식 채널을 보면 Google AI Studio와 Gemini API는 당일 이미 사용 가능했어요. APIYI 쪽에서는 2026-11-13에 docs.apiyi.com/models 문서 총표, 모델 페이지, 그리고 api.apiyi.com/api/pricing 가격 인터페이스를 확인했는데, 모두 gemini-4-hydrogen이 없었어요. 모델 페이지는 404를 반환했고, 가격 인터페이스의 당일 282개 모델 중 hydrogen을 검색해도 결과가 없었어요. 아직 출시되지 않았고, 최대한 빨리 이 모델을 출시할 예정이에요. 모델과 가격은 플랫폼 모델 목록을 기준으로 해주세요.
Hydrogen이 출시되기 전에 APIYI apiyi.com에서는 이미 10개 항목 표에 있는 두 경쟁 모델과 Hydrogen의 ‘모체’인 Carbon을 호출할 수 있어요. 먼저 비교 프로세스를 구축하기에 적합해요:
| 모델 ID | 입력 | 출력 | 캐시 읽기 | 엔드포인트 | 사용 가능 플랫폼 |
|---|---|---|---|---|---|
gemini-4-carbon |
$2 | $10 | $0.1 | chat, gemini | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | chat, messages | APIYI |
gpt-6.1-terra |
$1 | $5 | $0.05 | responses(권장), chat | APIYI |
Carbon 가격에 대해 한 가지 더 보충할게요. APIYI 문서에 따르면 $2 / $10은 구글의 한정 가격으로 2026-11-30까지 유효해요. 2026-12-01부터는 공식 가격에 따라 $4 / $20으로 조정되고, 캐시 읽기는 $0.10이에요.
연동 방식은 OpenAI 호환 인터페이스예요. base_url을 https://api.apiyi.com/v1로 설정하고, 모델 필드에 gemini-4-carbon, claude-sonnet-5-5, 또는 gpt-6.1-terra를 입력하면 돼요. Hydrogen이 출시된 후에는 모델 필드만 gemini-4-hydrogen으로 바꾸면, 같은 코드로 위 10개 항목 표에 있는 작업 유형을 재현할 수 있어요.
🎯 기술 제안: 공식 모델 카드의 상대 모델 점수는 각사의 공개 결과를 인용한 것이라, 여러분의 업무 시나리오와 반드시 일치하지는 않아요. 먼저 APIYI apiyi.com을 통해 같은 배치의 실제 작업으로 Sonnet 5.5와 Terra를 비교하고, Hydrogen이 출시되면 한 열을 추가해 여러분만의 승패 표를 만들어 보세요.
Gemini 4 Hydrogen 영향 분석
개발자에게 미치는 영향
- 에이전트 실행 계층에 선택지가 하나 더 생겼어요: AutomationBench-AA, Agents’ Last Exam, Vending-Bench 2 같은 에이전트 작업에서 Hydrogen의 공식 성적이 앞서요. 워크플로의 많은 실행 단계를 담당하기에 적합해요.
- 터미널과 컴퓨터 조작은 여전히 평가가 필요해요: Terminal-Bench 4.1과 OSWorld-2.1에서는 Sonnet 5.5가 앞서요. 핵심 시나리오가 CLI 에이전트나 데스크톱 자동화라면 “7개 항목에서 이겼다”는 결과만 보고 판단해서는 안 돼요.
- 3.8 Flash 사용자는 이전을 검토해볼 만해요: 속도, 터미널 성공률, 허위 생성률 모두 공식 자체 보고 기준 뚜렷하게 개선됐지만, 자신의 데이터로 확인해야 해요.
- 비용은 사고 단계에 따라 달라져요: 기본 high 단계는 사고 토큰을 출력에 포함하므로, 단계 선택이 곧 비용을 결정해요.
모델 역할 분담 구도에 미치는 영향
Hydrogen의 출시는 “조정자 + 실행자”라는 계층적 활용을 한층 강화했어요. Orchestrator의 공식 데이터에 따르면, 저렴한 모델로 실행하고 비싼 모델로 계획을 세우면 비슷한 성공률로 비용을 절약할 수 있어요. 이는 멀티모델 오케스트레이션이 실험적 방법에서 벤더의 공식 권장 방식으로 바뀌고 있다는 뜻이며, 여러 모델을 한 번에 전환할 수 있는 연동 계층도 점점 더 중요해질 거예요.
Gemini 4 Hydrogen의 알려진 한계
약점도 피하지 않고 짚어볼게요. 모델 카드에 명시된 제한 사항은 다음과 같아요.
- 여전히 환각을 일으킬 수 있고, 느려지거나 타임아웃될 수 있으며, 더 높은 사고 단계에서는 토큰을 더 많이 사용할 수 있어요. 지식 컷오프는 2026년 3월이에요.
- 안전 자동 평가에서는 3.8 Flash 대비 두 항목이 악화됐어요. 거부 어조는 -0.65%p, 거부하지 않아야 할 때 거부 응답을 하는 비율은 5.57%p 상승했어요(이 수치는 낮을수록 좋아요).
- 프런티어 안전 측면에서 Argon 대비 획기적인 능력 도약은 없었어요. CBRN과 사이버 보안 모두 CCL에는 도달하지 못했지만 경고 임계값에는 도달했어요. 이는 “관련 위험이 없다”는 뜻이 아니에요. 전체 안전 보고서는 곧 공개한다고 공식적으로 밝혔어요.
긍정적인 지표도 있어요: 에이전트의 경계를 넘는 행동이 최대 81% 감소했고, 내부 정직성 평가는 96.7%, Gray Swan 간접 프롬프트 인젝션 저항력은 2.3배 이상 향상됐으며, HealthBench Pro의 불필요한 거부율은 0.4% 미만이에요. 이 역시 모두 공식 자체 보고 수치예요.
자주 묻는 질문 FAQ
Q1: Gemini 4 Hydrogen은 어떤 모델인가요?
구글이 2026-11-12에 발표한 Gemini 4 패밀리의 일원으로, 모델 ID는 `gemini-4-hydrogen`이며, Gemini 4 Carbon에서 파생되어 더 빠른 일상 코딩과 에이전트 실행 모델로 자리매김했습니다. 가장 어려운 장기 추론은 Carbon과 Argon이 담당합니다.
Q2: Gemini 4 Hydrogen과 Claude Sonnet 5.5 중 누가 더 강한가요?
공식 모델 카드의 10개 항목 표를 보면 Hydrogen이 7개 항목에서 이기고, Sonnet 5.5가 3개 항목에서 이깁니다. Sonnet의 강점은 터미널 작업, 컴퓨터 조작, 과학 터미널에 집중되어 있어요. 경쟁 모델의 점수는 각 사가 공개한 최대 사고 단계 결과이며, 동일한 스크립트로 다시 실행한 것이 아닙니다. APIYI apiyi.com을 통해 여러분의 작업으로 직접 비교 테스트를 해보시길 권장합니다.
Q3: “10개 중 7개 승리”는 제3자가 측정한 결과인가요?
아닙니다. DeepMind 모델 카드에 담긴 공식 요약이며, Hydrogen은 최고 사고 단계에서 pass@1 단일 시도로 측정한 결과예요. APIYI의 재측정 결과도 아니므로 공식 자체 보고 데이터로 봐야 합니다.
Q4: Gemini 4 Hydrogen은 어떤 상황에 적합한가요?
공식 성적이 비교적 좋은 상황은 다음과 같습니다: 다단계 자동화 워크플로(AutomationBench-AA), 차트 이해(Chartography), 멀티모달 지식 에이전트(MKA), 그리고 다중 모델 프로세스에서의 worker 또는 verifier 역할이에요. 명령줄 에이전트와 데스크톱 조작은 Sonnet 5.5도 함께 평가해 보시길 권장합니다.
Q5: 지금 APIYI를 통해 Gemini 4 Hydrogen을 호출할 수 있나요?
2026-11-13 기준으로 아직 상품이 등록되지 않았습니다. 이 모델은 최대한 빨리 등록할 예정이며, 모델명과 가격은 플랫폼의 모델 목록을 기준으로 합니다. 현재 APIYI apiyi.com에서 `gemini-4-carbon`, `claude-sonnet-5-5`, `gpt-6.1-terra`를 호출할 수 있어요. `base_url`은 `https://api.apiyi.com/v1`을 사용해서 먼저 비교 프로세스를 구축해 보세요.
Q6: Gemini 4 Hydrogen의 출력이 예상보다 비쌀 수 있는 이유는 무엇인가요?
공식 출력 가격 $7.50은 응답과 추론을 합산해 청구하는 방식이고, 기본 사고 단계가 high라서 사고 토큰이 출력 청구서에 포함됩니다. 간단한 작업은 low 또는 medium 단계로 전환해 비용을 제어할 수 있어요.
Gemini 4 Hydrogen 핵심 요점
- 포지셔닝이 명확해요: 2026-11-12에 출시됐고, 일상 코딩과 에이전트 실행을 겨냥하며 Carbon에서 파생됐어요.
- 공식 표 10개 항목 중 7개 승리: Sonnet 5.5가 터미널, 컴퓨터 조작, 과학 터미널 3개 항목에서 이겼고, Terra는 1위 항목이 없어요.
- 기준을 구분해야 해요: 점수는 공식 자체 보고이고, 경쟁 모델은 각 사가 공개한 최대 사고(thinking) 단계를 적용한 값이며, 동일 스크립트로 다시 돌린 결과가 아니에요.
- 3.8 Flash 대비 큰 도약: 2.5배 빨라졌고, Terminal-Bench 4.1이 18.2%에서 57%로 올랐어요.
- 표준 티어 가격: 글로벌 기준 입력 $1.50, 출력 $7.50이며, 출력에는 사고 토큰이 포함돼요.
- 컨텍스트 윈도우는 두 가지 설명: 모델 카드는 합계 100만, 블로그는 입력 100만·출력 최대 100만이라고 밝혔어요.
- 호출 현황: APIYI에는 아직 등록되지 않았고, 우선 apiyi.com에서 Carbon, Sonnet, Terra로 비교 환경을 구성할 수 있어요.
정리
Gemini 4 Hydrogen의 핵심 요점은 이래요.
- 에이전트 실행에서 강해요: 공식 10개 항목 표에서 7개를 이겼고, 자동화, 에이전트 시험, 차트, HLE-Diamond에서 모두 앞서요.
- 터미널과 컴퓨터 조작에서는 약해요: Terminal-Bench 4.1, OSWorld-2.1, 과학 터미널 세 항목에서 Claude Sonnet 5.5에 뒤져요.
- 숫자는 기준에 맞춰 읽어야 해요: 전부 공식 자체 보고 또는 모델 카드 집계이고, 경쟁 모델 점수는 공개된 결과에서 가져온 것으로 같은 조건에서 다시 돌린 게 아니에요.
에이전트 워크플로를 운영하고 있다면 Hydrogen은 후보 목록에 올려볼 만해요. 특히 멀티모델 흐름의 실행 계층으로 잘 맞아요. 다만 최종 판단은 결국 본인의 작업 결과를 기준으로 해야 해요. APIYI apiyi.com에서 기존 Carbon, Sonnet 5.5, Terra로 먼저 베이스라인을 세워두고, Hydrogen이 등록되면 바로 추가 측정하면 돼요.
📚 참고 자료
- Google 블로그: Introducing Gemini 4 Hydrogen: 출시 공지 및 포지셔닝 설명
- 링크:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
설명: 공식 포지셔닝, AA Index, 3.8 Flash 대비 향상된 점
-
Google 개발자 소식: Build with Gemini 4 Hydrogen: 개발자 연동 정보
- 링크:
blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-hydrogen -
설명: 사용 가능한 채널 및 개발자 관련 설명
-
DeepMind 모델 카드: Gemini 4 Hydrogen: 사양, 10개 항목 비교표, 안전성 평가
- 링크:
deepmind.google/models/model-cards/gemini-4-hydrogen -
설명: 본문의 10개 항목 표와 제한 사항 설명의 주요 출처
-
DeepMind 평가 방법 설명: 비교표의 방법론 기준
- 링크:
deepmind.google/models/evals-methodology/gemini-4-hydrogen -
설명: 사고(thinking) 등급, pass@1, 경쟁 모델 점수 출처
-
Google Cloud 가격 페이지: 표준 등급 가격
- 링크:
cloud.google.com/vertex-ai/generative-ai/pricing - 설명: 글로벌 및 비글로벌 표준 등급 단가, 캐시 쓰기 적용 날짜
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 첫 페이지에서 문의하실 수 있으며, 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.