요약: GPT-6.2의 멀티턴 Responses API 호출에서 초기 입력을 수정하면 캐시 적중이 줄어들 수 있고, 일부 추론 항목이 재사용 자격을 잃을 수도 있어요. 개발자는 append-only 컨텍스트 구조로 바꾸고, 쌍을 이루는 사용량 로그로 비용 차이를 찾아낼 수 있어요.
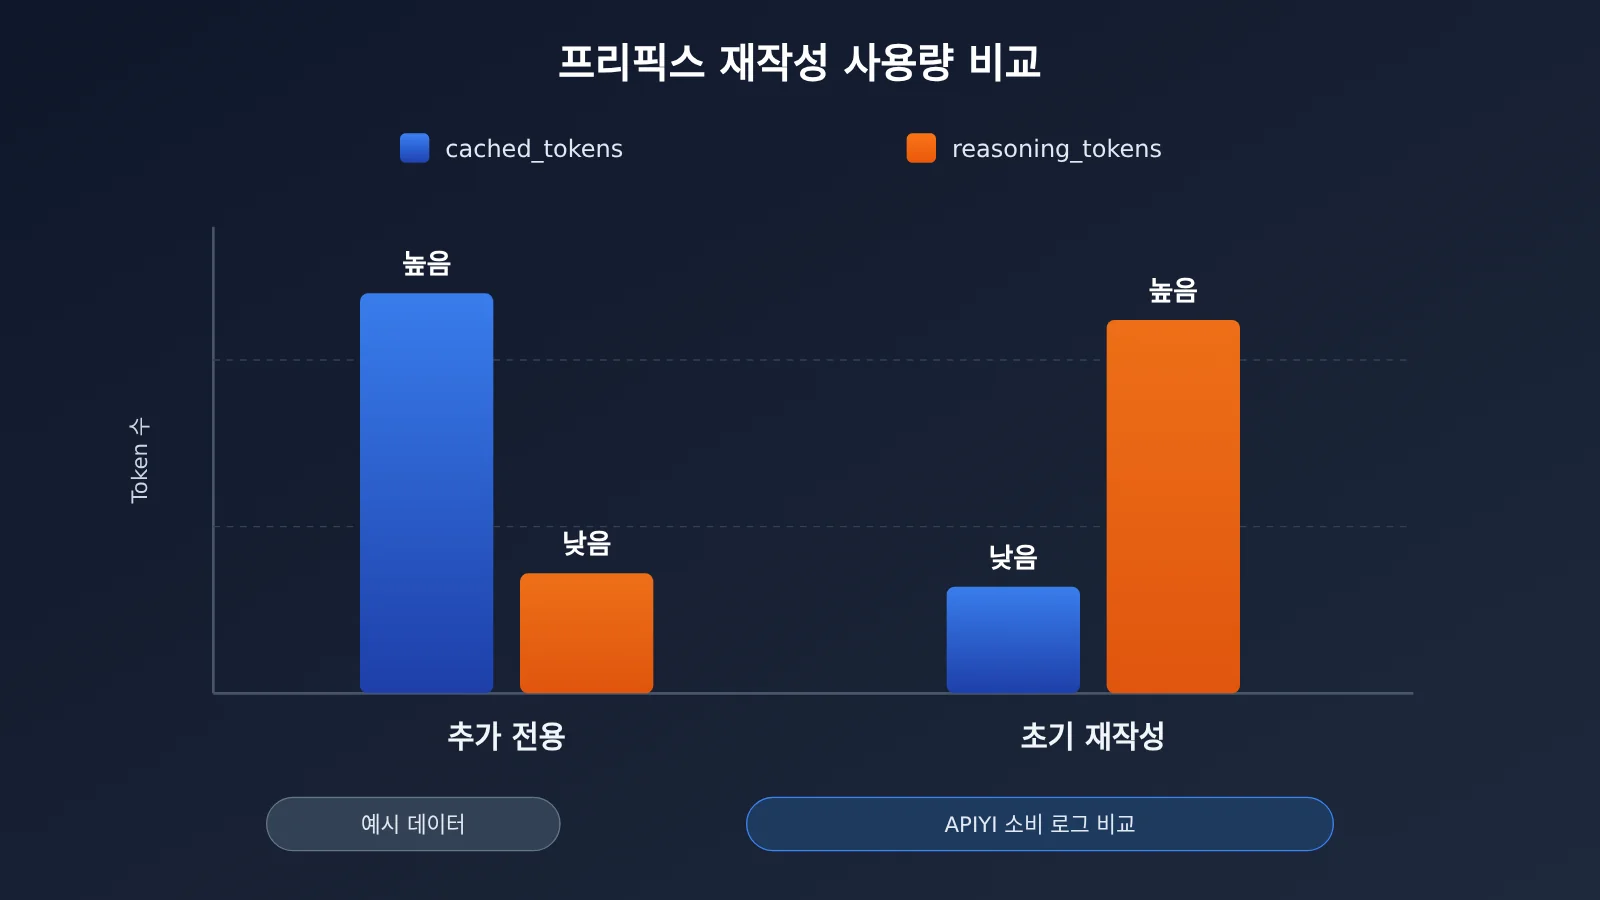
결론부터 말씀드릴게요. 청구 금액이 오르는 이유는 보통 하나가 아니에요. 두 군데에서 동시에 발생할 수 있죠. 첫째, 입력 프리픽스가 변경되면 캐시 읽기가 줄어들고, 원래 캐시 가격으로 과금되던 입력이 일반 입력 가격으로 청구될 수 있어요. 둘째, GPT-6.2가 prefix_mismatch 때문에 초기 추론 항목을 제거하면 모델이 다시 추론해야 해서 추가 추론 비용이 발생할 수 있어요. 이 두 항목이 실제로 나타나는지, 각각 얼마를 차지하는지는 모델 버전, 변경 위치, 실제 usage에 따라 달라져요. 아래 계산 예시는 비용 분해 방법을 보여주기 위한 것일 뿐, 실제 청구서를 뜻하지 않아요. APIYI(apiyi.com)를 통해 호출한다면 직접 관리하는 input 이력으로 대조군을 만들고, 사용 로그를 기준으로 정산하는 걸 권장해요.
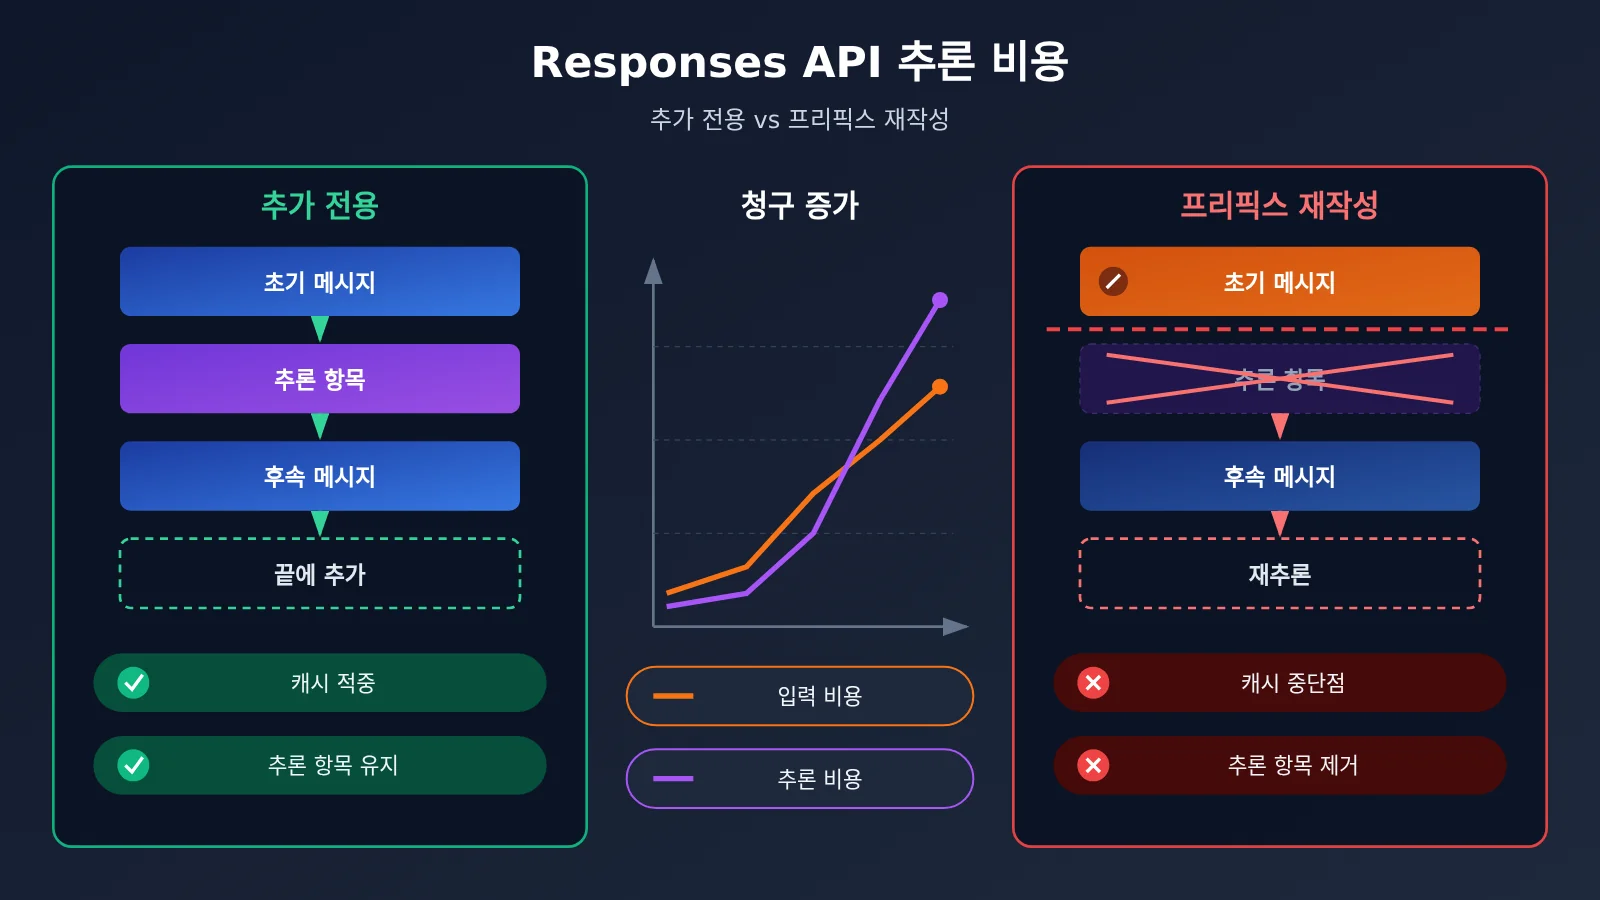
OpenAI Responses API 추론 비용 지식 지도
아래 표는 글 전체 네 개 절의 내용과 상호 관계, 읽기 순서를 정리했어요. 1절은 비용이 어디서 발생하는지 설명하고, 2절은 어떤 작업이 이를 유발하는지 알려주며, 3절은 측정 방법을 제시하고, 4절은 측정한 숫자를 금액으로 환산해 개선안을 제시해요.
| 번호 | 답하는 질문 | 다음 절에 제공하는 것 | 읽고 나서 할 수 있는 일 |
|---|---|---|---|
| 1 | 비용이 오르는 지점 | 두 가지 관찰 지점: 캐시 읽기, 새 출력 | usage에서 관련 필드의 의미 이해하기 |
| 2 | 어떤 편집 작업이 유발하는가 | 점검해야 할 코드 위치 목록 | 자신의 컨텍스트 유지 방식에 위험이 있는지 판단하기 |
| 3 | 변화를 어떻게 격리할 수 있는가 | 비교 가능한 쌍 데이터 세트 | 대조 실험으로 문제 존재 여부 확인하기 |
| 4 | 얼마나 차이가 나고, 어떻게 바꿀까 | 비용 분해 공식과 세 가지 개선 | 차액을 추정하고, 요청 ID로 실제 과금 확인하기 |
이미 프리픽스 수정이 있다고 확인했다면 3절부터 바로 읽어도 돼요. 1절과 2절은 점검할 때 참고 자료로 활용할 수 있어요.
알아두기: Responses API 추론 비용 관련 용어
| 용어 | 간단한 설명 |
|---|---|
| Responses API | OpenAI가 모델 응답, 추론, 도구 호출을 통합 처리하는 데 사용하는 인터페이스 |
| 입력 프리픽스 | 다중 턴 요청의 시작 부분에서 동일한 순서를 유지하는 초기 입력 내용 및 구성 |
| 캐시 적중 | 이번 요청이 이미 처리된 입력 토큰을 재사용한 것, 해당 부분은 캐시 읽기 가격으로 청구됨 |
| 추론 항목 | 추론 모델 응답에 포함된 구조화 항목의 한 종류로, 호환되는 후속 요청에서 재사용 가능 |
prefix_mismatch |
GPT-6.2 관련 진단의 원인 값 중 하나로, 이전 프리픽스가 변경되어 추론 항목이 제거되었음을 의미 |
| 추가 전용 | 기존 내용과 순서는 유지하고 끝에만 후속 이벤트를 추가하는 이력 유지 방식 |
reasoning_tokens |
출력 사용량 내 추론 하위 항목으로, 추론 소비를 관찰하는 데 사용 |
x-request-id |
응답 헤더의 요청 식별자로, 클라이언트 응답과 제공자 로그를 연결하는 데 사용 |
1. Responses API의 추론 비용이 두 곳에서 늘어나는 이유
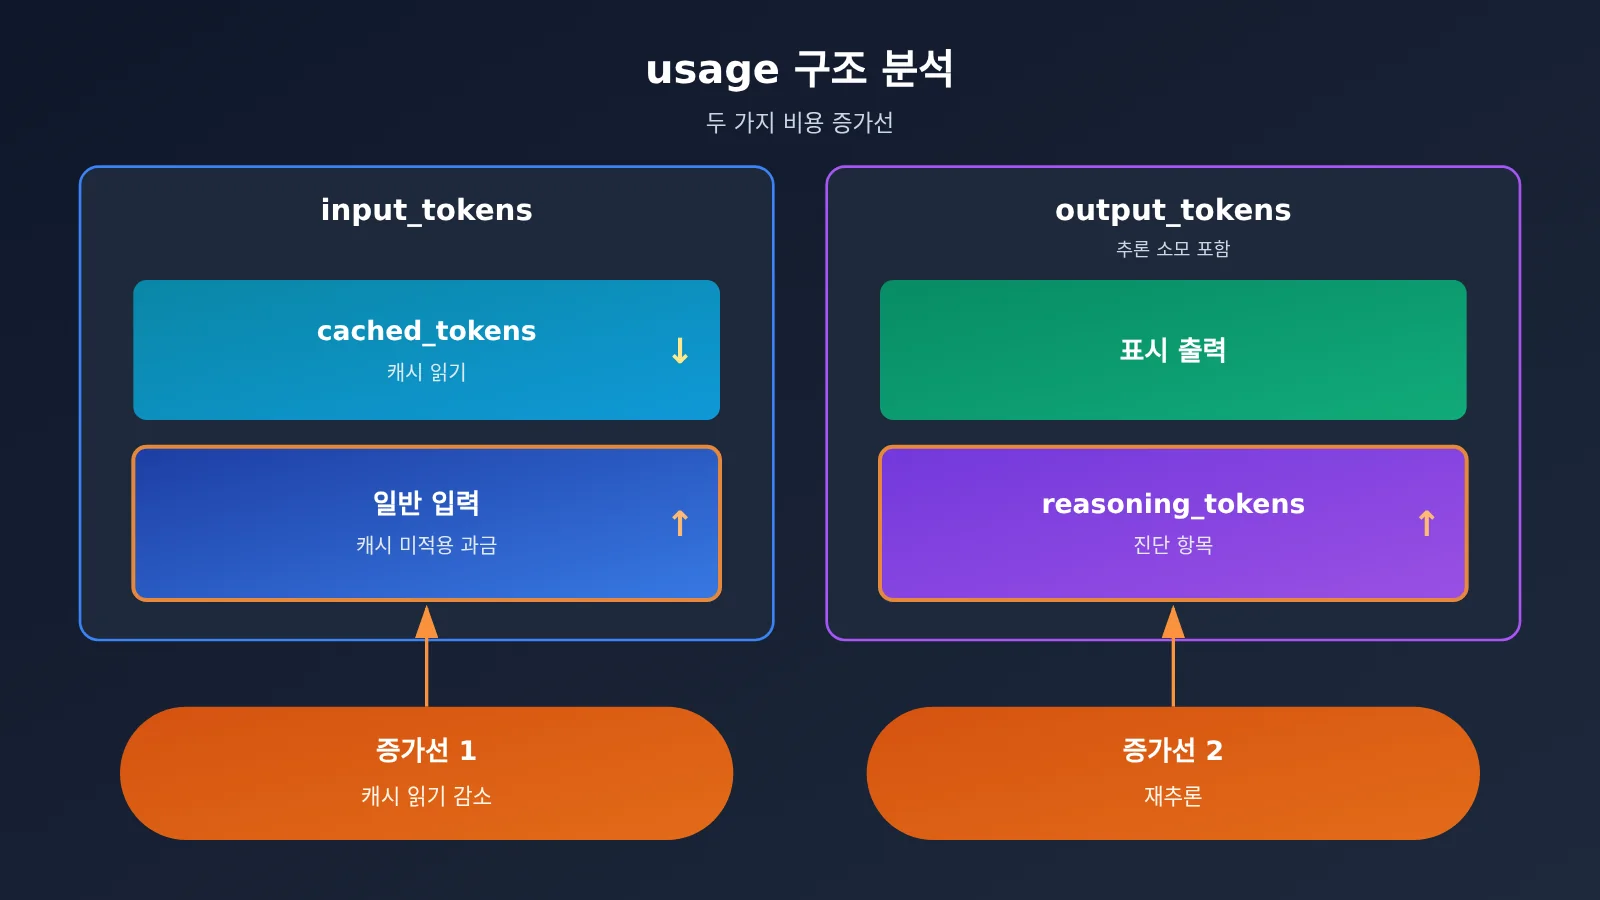
1.1 첫 번째 경로: 캐시 읽기 감소
OpenAI의 《Prompt caching》 설명에 따르면, 프롬프트 캐시는 요청 시작 부분부터 일치 여부를 확인해요. 초반의 어느 한 구간이 바뀌면 그 변경 지점 이후 부분은 더 이상 캐시 읽기로 청구할 수 없고, 일반 입력 가격으로 청구돼요. APIYI 전체 가격표의 gpt-6.2-sol 짧은 컨텍스트 기준 가격을 예로 들면, 일반 입력은 100만 토큰당 2달러, 캐시 읽기는 0.10달러로 두 가격이 20배 차이 나요.
이 비용 변화에는 usage에서 대응하는 필드가 있어요. input_tokens 총량은 거의 그대로일 수 있지만, 그 안의 cached_tokens는 줄어들 수 있어요. 총 입력량만 보면 이 문제를 발견할 수 없고, 캐시 읽기량을 따로 기록해야 해요.
1.2 두 번째 경로: 추론 항목이 재사용 자격을 잃은 뒤의 새 출력
OpenAI는 2026-11-17 API Changelog에서 “초기 이력을 편집하면 prefix_mismatch를 이유로 추론 항목이 제거된다”는 동작을 GPT-6.2부터 적용되는 동작으로 표시했어요. 추론 항목이 제거되면 모델은 이후 턴에서 이전 추론 내용을 볼 수 없어서 다시 추론해야 할 수 있고, 따라서 추가 추론 비용이 발생할 수 있어요.
이 경로는 출력 측에 반영되어 reasoning_tokens와 총 출력이 늘어나는 모습으로 나타나요. 캐시 읽기 감소와 동시에 나타날 수 있지만 usage에서는 서로 독립된 필드라서, 문제를 살필 때는 따로 봐야 해요.
1.3 output_tokens와 reasoning_tokens의 포함 관계
OpenAI의 《Counting tokens》에 따르면, output_tokens에는 이미 추론 소비가 포함되어 있고, output_tokens_details.reasoning_tokens는 그중 진단용 하위 항목일 뿐이에요. 비용을 계산할 때는 output_tokens에 출력 단가를 곱하면 돼요. 여기에 reasoning_tokens를 한 번 더 더하면 중복 계산이 돼요.
2. 어떤 프리픽스 편집 동작이 추론 비용 상승을 유발할까
2.1 prefix_mismatch를 유발하는 흔한 작업
OpenAI의 《Keep the prefix unchanged》와 《Reasoning models》 설명에 따르면, 다음 작업은 프리픽스를 다시 쓰는 것에 해당하며 GPT-6.2에서 추론 항목이 제거될 수 있어요:
| 작업 | 대표적인 코드 상황 | 위험 |
|---|---|---|
| 오래된 메시지 재작성 | 사용자 2번째 턴의 표현을 나중에 고치거나, 오래된 메시지에 타임스탬프를 덧붙임 | 프리픽스 재작성 |
| 오래된 도구 결과 수정 | 토큰을 아끼려고 초기 도구가 반환한 JSON을 줄임 | 프리픽스 재작성(줄이는 것도 재작성으로 간주) |
| 관련 추론 항목 앞에 내용 삽입 | 새로 검색한 자료를 대화 기록 중간에 삽입 | 프리픽스 재작성 |
| 항목을 통째로 삭제하고 나머지는 그대로 | 오래된 메시지 하나를 완전히 삭제 | 해당 제거 사유는 발생하지 않지만 캐시 적중량은 여전히 달라질 수 있음 |
| 추론 항목 뒤에 추가 | 시간 순서대로 새 메시지 추가 | 해당 제거 사유는 발생하지 않음 |
“오래된 도구 출력을 줄이는 것”은 토큰을 절약하는 것처럼 보이지만, 이는 재작성에 해당해요. 항목을 완전히 삭제하고 나머지 항목이 그대로일 때만 prefix_mismatch가 발생하지 않아요. 그렇더라도 캐시의 매칭 시작점이 달라질 수 있으므로, 캐시 읽기량은 여전히 실제로 측정해야 해요.
2.2 버전, 추론 단계, 모델 패밀리 전환의 차이
이런 변화들은 따로 판단해야 해요:
- 버전 차이: OpenAI는
prefix_mismatch로 인한 추론 항목 제거가 GPT-6.2부터의 동작이라고 분명히 밝히고 있어요. GPT-6.1 Sol은reasoning.context: all_turns를 지원해서 호환되는 기록이 있으면 이전 추론을 렌더링할 수 있어요. 6.1에서 6.2로 마이그레이션할 때는 기존의 컨텍스트 유지 방식을 다시 검증해야 해요. - 추론 단계: 두 세대의 Sol 모두
low,medium,high,xhigh,max다섯 단계를 제공하며, 6.2 Sol은none을 거부해요. 서드파티 글인 OrcaRouter가 정리한 방법은 요청 사이에reasoning.effort를 직접 수정하는 대신,input에configuration_update항목을 추가하는 것이에요. 이 글은 또 이런 항목이 포함된 기록은 자동으로 잘리며/responses/compact에서 거부된다고 지적해요. 이 방식을 도입하기 전에는 OpenAI 공식 문서를 기준으로 삼으세요. - 모델 패밀리 전환과 다운그레이드: OpenAI 설명에 따르면 모델 패밀리를 바꾸거나 성능이 낮은 모델로 전환하는 것도 기존 추론 항목을 제거할 수 있어요. 이는
prefix_mismatch와 원인이 다르므로, 통계를 낼 때는 따로 분류해야 해요.
2.3 GPT-6.2 최상위 instructions의 위치와 과금
OpenAI의 《Using GPT-6.2》 설명에 따르면, GPT-6.2의 최상위 instructions는 input 뒤에 추가되며 캐시되지 않은 입력으로 과금돼요. 그래서 현재 턴의 임시 개발자 프롬프트를 넣기에는 적합하지만, 장기간 변하지 않는 긴 시스템 설정을 넣기에는 적합하지 않아요.
장기간 재사용할 지시는 첫 번째 developer 메시지로 input에 넣어 캐시되게 해야 해요. 장기 지시를 조정해야 한다면 대화 기록 끝에 새 developer 메시지를 추가하고, 첫 번째 메시지를 다시 고치지 마세요.
3. 대조 요청으로 Responses API 추론 비용 변화 분리하기
3.1 대조군 설계
모델, 추론 단계, 도구 정의, 입력량은 고정하고, 오직 히스토리 유지 방식이라는 변수 하나만 바꿔요. A 그룹은 추가만 하고, B 그룹은 초기에 한 곳의 내용을 재작성해요. 두 그룹은 각각 여러 라운드를 실행하고 동일한 작업 세트를 사용해요.
매 요청은 아래 표에 따라 통일되게 기록해요. 작업 품질은 사람이 직접 또는 평가 스크립트로 점수를 매겨야 해요. 비용이 줄어든다고 해서 결과가 나빠지는 것을 대가로 삼아서는 안 되니까요.
| 필드 | 출처 | 용도 |
|---|---|---|
| 그룹 | 직접 정의 | 추가 전용 그룹과 재작성 그룹 구분 |
cached_tokens |
usage.input_tokens_details |
첫 번째 지표 관찰 |
reasoning_tokens |
usage.output_tokens_details |
두 번째 지표 관찰 |
output_tokens |
usage |
출력 비용 계산 |
| 지연 시간 | 클라이언트 측 타이밍 | 추론이 늘면 보통 소요 시간도 길어짐 |
| 작업 품질 | 사람 또는 평가 점수 | 품질을 비용과 맞바꾼 경우 배제 |
x-request-id |
응답 헤더 | 대사(대조 확인) |
3.2 추가 전용 호출 예시
아래 코드는 input 히스토리를 직접 관리하면서 매 라운드마다 끝에만 덧붙이고, 사용량과 요청 ID를 로그에 기록해요:
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # 전체 세션 동안 고정, 라운드 사이에 변경하지 않음

# 안정 프리픽스: 재사용 가능한 지시는 input 첫 번째 항목에 두고 이후에는 수정하지 않음
history = [{"role": "developer", "content": "你是代码审查助手,回答简洁。"}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # 대상 그룹이 실제로 반환되는지는 먼저 확인해야 해요
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # 추가 전용: 이번 라운드 출력(추론 항목 포함)을 그대로 히스토리 끝에 다시 넣어요
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
재작성 그룹은 같은 함수를 재사용해요: N번째 라운드 전에 history[1]의 내용을 수정하고 variant를 "early_rewrite"로 설정하면 되고, 나머지 파라미터는 그대로 두면 돼요.
🚀 빠른 시작: 대조군을 구성할 때는 APIYI apiyi.com을 통해 동일한 API 키로
gpt-6.1-sol과gpt-6.2-sol을 전환할 수 있어요. 같은 로그 구조 안에서 버전 차이가 캐시와 추론 사용량에 미치는 영향을 비교해 볼 수 있답니다.
3.3 공식 직결 시의 보조 진단
OpenAI를 직결로 사용할 때는 prompt_cache_options.comparison_response_id를 이전 응답 ID 중 하나로 설정한 뒤, 반환되는 진단 사유와 캐시 토큰 수를 읽을 수 있어요. 응답의 input_transformations에는 어떤 추론 항목이 제거되었고 그 이유가 무엇인지 나열되는데, 여기서 prefix_mismatch는 ID를 기준으로 이전 응답 출력의 추론 항목과 대응시킬 수 있어요.
# OpenAI 공식 직결 전용
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
이 진단에는 두 가지 한계가 있어요. 캐시 진단은 최선 노력 원칙에 따라 첫 번째 차이만 보고하며, 모델이 보존된 추론을 실제로 재사용했는지는 확인할 수 없어요. “추론 항목이 제거되었다”는 알려주지만 “그로 인해 얼마나 더 썼는지”는 알려주지 못하죠. 비용은 여전히 3.1절의 쌍별 사용량을 함께 봐야 판단할 수 있어요.
3.4 APIYI를 통해 호출할 때의 주의사항
OpenAI 직결은 previous_response_id로 세션 상태를 이어갈 수 있어요. APIYI의 Responses API 네이티브 호출 가이드(docs.apiyi.com) 본문에서는 이 체이닝 방식이 동작하지 않는다고 설명하지만, 같은 페이지 FAQ에는 2026-09-02 실측 기준 사용 가능하다고 기록되어 있어요. 두 설명이 서로 다르므로, 더 안전한 기준선은 3.2절의 작성 방식과 동일하게 input 히스토리를 직접 관리하는 것이에요.
상태 이어가기, 암호화된 추론 항목의 회신, 그리고 위에서 언급한 진단 필드는 실제 동작이 토큰 그룹에 따라 달라질 수 있으므로 대상 그룹에서 별도로 검증해야 해요. 진단 필드를 사용할 수 없다 하더라도, 쌍별 사용량 로그는 여전히 판단 근거로 활용할 수 있어요.
4. 숫자로 Responses API 추론 비용 분해하고 개선 사항 적용하기
4.1 추정에 사용한 표시 가격
아래는 APIYI apiyi.com 가격 총표에 나와 있는 숏 컨텍스트 기본 표시 가격이에요(2026-11-20 15:17 베이징 시간 기준 업데이트, 단위는 달러/백만 Token). 실제 과금은 모델이 속한 토큰 그룹과 충전 비용에 따라 달라지기 때문에 각각 따로 확인해야 해요.
| APIYI 모델 ID | 일반 입력 | 캐시 읽기 | 출력 |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
롱 컨텍스트는 별도로 계산해야 해요. gpt-6.2-sol은 입력이 272,000 Token을 넘으면 APIYI 현재 총표에 적힌 입력 가격이 $3인데, OpenAI 공식 Standard 모델 페이지에는 $4로 나와 있어요. gpt-6.1-sol의 롱 컨텍스트 입력 가격은 양쪽 모두 $4예요. 롱 컨텍스트 구간의 캐시 가격과 출력 가격은 각 채널의 실시간 과금 규칙에 맞춰 확인해 주세요.
4.2 두 번 요청의 비용 분해 계산 예시
가정 조건은 이래요: 짧은 컨텍스트, APIYI Sol 기본 표시 가격, 두 요청의 입력이 모두 12,000 Token, 별도로 표기된 캐시 쓰기 없음, 도구 비용 없음. 아래 숫자는 전부 가정일 뿐 실측 데이터가 아니에요.
| 항목 | 프리픽스 유지 | 프리픽스 재작성 |
|---|---|---|
| 캐시 읽기 | 9,000 × $0.10/M = $0.0009 | 3,000 × $0.10/M = $0.0003 |
| 일반 입력 | 3,000 × $2/M = $0.0060 | 9,000 × $2/M = $0.0180 |
| 총 출력 | 1,000 × $10/M = $0.0100 | 1,600 × $10/M = $0.0160 |
| 합계 | $0.0169 | $0.0343 |
두 번의 차이는 $0.0174이고, 이걸 두 부분으로 나눌 수 있어요. $0.0114는 6,000개의 입력 Token이 캐시 가격에서 일반 입력 가격으로 바뀐 데서 나온 값, 즉 6,000 × ($2 − $0.10) / 1,000,000이고, $0.0060은 추가로 발생한 600개의 총 출력 Token에서 나온 값이에요. 이 두 부분은 각각 1절의 두 축에 대응해요. 실제 차액은 여러분의 usage를 기준으로 확인해야 해요. 별도로 표기된 캐시 쓰기가 있다면 일반 입력, 캐시 읽기, 캐시 쓰기라는 세 가지 상호 배타적 범주로 나눠 각각 계산해야 해요.
4.3 요청 ID로 대조하기
추정한 뒤에는 실제 과금을 확인해요. APIYI apiyi.com의 소비 로그에서 응답 헤더의 x-request-id로 해당 type=2 기록을 찾고, quota ÷ 500,000으로 실제 과금된 달러 금액을 환산해요. 모델, 토큰 그룹, 호출 시간대, 그리고 해당 요청의 입력·출력 사용량도 함께 기록해 두세요.
현재 APIYI에서 같은 그룹, 같은 작업에 대한 프리픽스 대조 청구서는 공개되어 있지 않아요. 따라서 개선 효과를 평가할 때는 직접 만든 쌍(pair) 요청 로그와 과금 기록을 기준으로 삼아야 해요.
💰 대조 권장: 3.2절 로그의
request_id를 소비 로그와 하나씩 연관 지어 “사용량 필드 → 추정 금액 → 실제 과금” 세 개의 열을 만들어 보세요. 어느 열에서 편차가 나타나면 그 단계에서 문제가 생겼다는 뜻이에요.
4.4 세 가지 개선
- 도구 정의 고정과 안정적인 지시문: 도구 정의는 기존 순서를 유지하고 세션 도중에 수정하지 않아요. 장기 지시문은
input의 첫 번째 developer 메시지에 두고, 현재 턴의 임시 프롬프트는 GPT-6.2의 최상위instructions를 사용할 수 있지만, 캐시되지 않은 입력으로 과금된다는 점은 감수해야 해요. - 순서대로 컨텍스트 덧붙이기: 새 메시지, 새 도구 결과, 새 검색 자료는 모두 끝에 덧붙여요. 정말로 간소화해야 할 때는 완전한 항목을 삭제하고, 그 안의 내용은 다시 쓰지 않아요.
- 긴 컨텍스트와 버전 마이그레이션은 별도로 테스트: 긴 컨텍스트가 입력 토큰 272,000을 넘으면 다른 가격 구간이 적용되므로 별도의 대조군을 만들어야 해요.
gpt-6.1-sol에서gpt-6.2-sol로 마이그레이션하거나, 가격 구간을 조정하거나, 모델 패밀리를 전환할 때는 먼저 3절의 대조 방법으로 검증한 뒤 전체에 적용하세요.
위 개선을 마친 뒤에는 이렇게 효과를 검증할 수 있어요. 같은 작업 세트에서 두 그룹 대조를 다시 실행해 보세요. 덧붙이기만 한 그룹의 cached_tokens 비중이 안정적이고, reasoning_tokens가 비정상적으로 높아지지 않았으며, 요청 ID로 확인한 실제 과금이 추정과 일치한다면 이 부분 비용은 이미 통제되고 있다는 뜻이에요.
참고 자료
- OpenAI《Keep the prefix unchanged》: prefix 유지와
prefix_mismatch진단- 링크:
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- 링크:
- OpenAI《Reasoning models》: 추론 항목 재사용과 전체 항목 삭제의 예외
- 링크:
developers.openai.com/api/docs/guides/reasoning
- 링크:
- OpenAI《Prompt caching》과 《Counting tokens》: 캐시 매칭 규칙과 사용량 필드
- 링크:
developers.openai.com/api/docs/guides/prompt-caching
- 링크:
- OpenAI API Changelog(GPT-6.2 항목, 2026-11-17)
- 링크:
developers.openai.com/api/docs/changelog
- 링크:
- OrcaRouter《GPT-6.2 Preserved Reasoning》: 제3자가 정리한 append-only 재작성 방식
- 링크:
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- 링크:
- APIYI《모델 가격 전체 목록》
- 링크:
docs.apiyi.com/models
- 링크:
- APIYI《로그 조회 API》
- 링크:
docs.apiyi.com/api-capabilities/log-query
- 링크:
- APIYI《OpenAI Responses API 네이티브 호출 가이드》
- 링크:
docs.apiyi.com/api-capabilities/openai/native
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈페이지에서 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요.