작성자 주: 공개된 Kimi K3 실측 데이터를 바탕으로 K3.1 Pro를 로컬에 배포할 때 필요한 하드웨어 사양, 월간 비용, 토큰당 비용, 손익분기점을 추산해 언제 임대하고, 구매하고, API를 이용하는 게 좋을지 판단할 수 있도록 정리했어요.
먼저 결론부터 말하면 Kimi K3.1 Pro는 곧 오픈소스로 공개될 예정이지만, 로컬 배포는 개인을 위한 선택지가 아니에요. 공식 발표에 따르면 전체 가중치는 11월 4일 전에 공개될 예정이며, 3T급 오픈소스 가중치 모델로 제공됩니다. 2026년 10월 26일 기준으로 K3.1 Pro의 가중치는 아직 공개되지 않았어요. 이 글의 하드웨어 및 VRAM 수치는 모두 이미 공개된 Kimi K3의 실측값을 바탕으로 추산했기 때문에, 가중치가 공개된 뒤에는 다시 확인해야 해요.
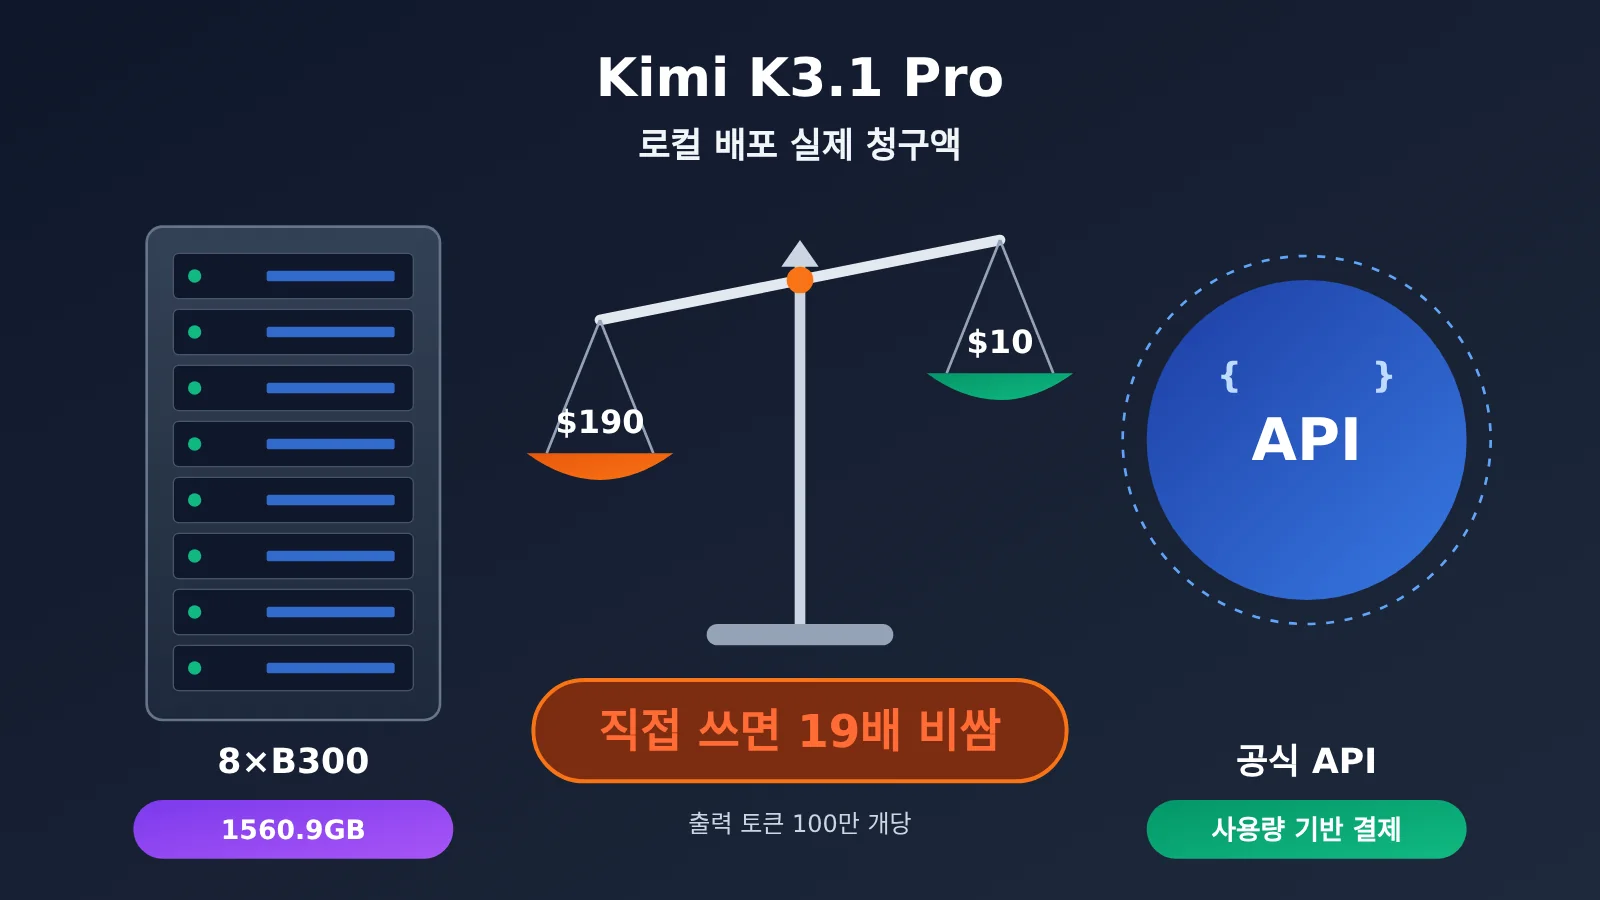
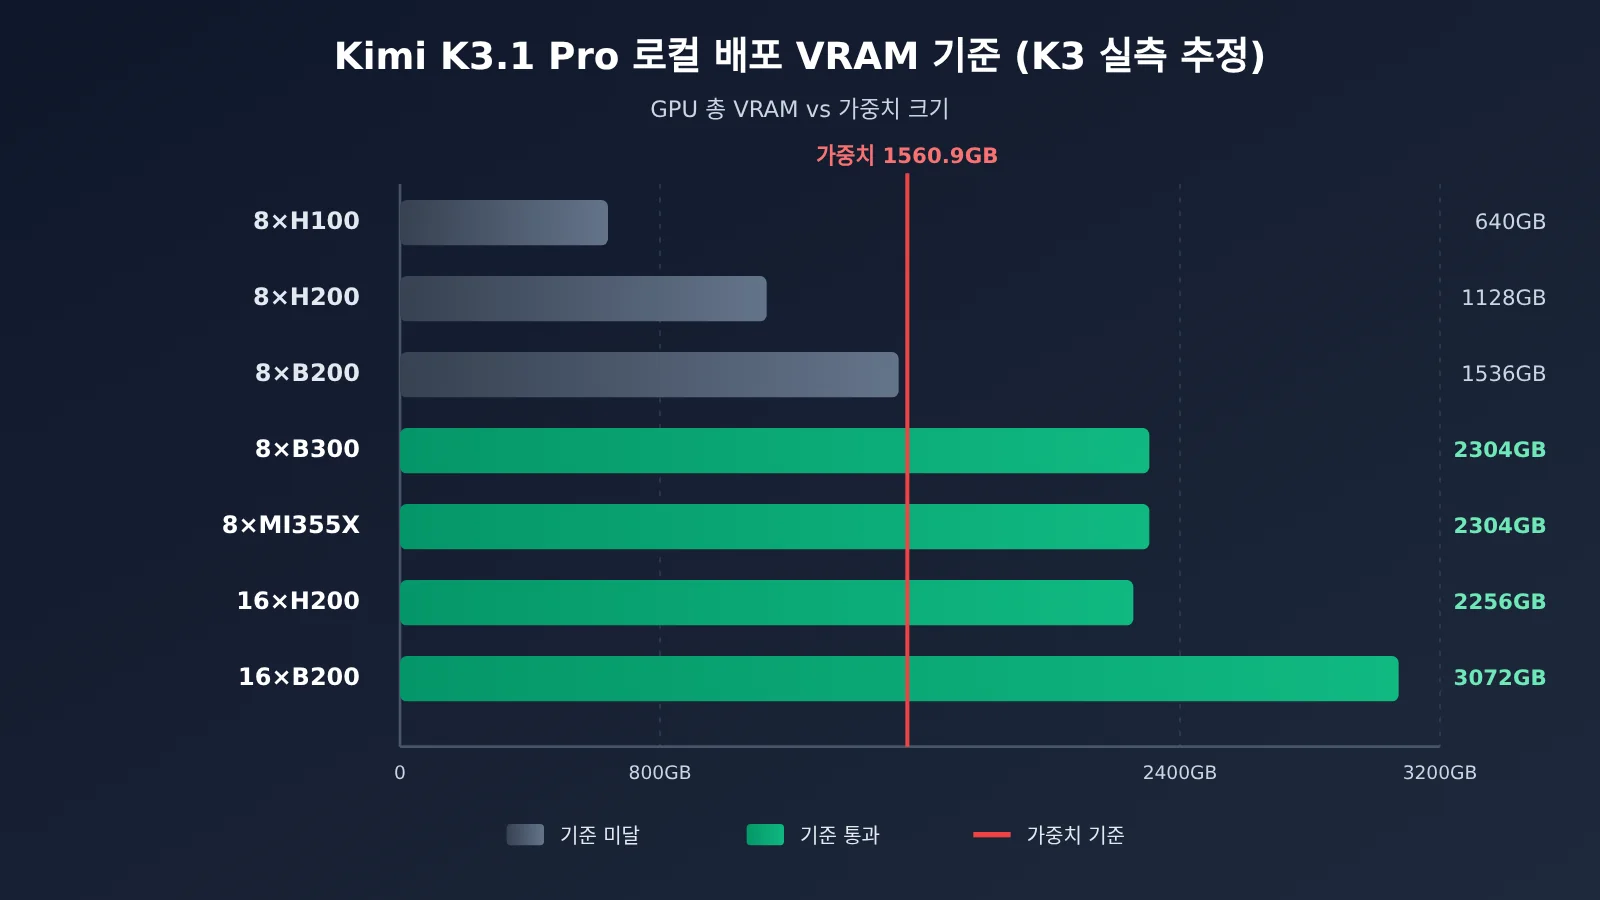
K3 실측 기준으로 가중치만 1560.9GB에 달해요. B300 8장에는 겨우 들어가지만, H200 8장으로는 약 400GB가 부족하죠. 8×B300 서버를 혼자 사용하는 경우 출력 토큰 100만 개당 비용이 약 $190.00으로, 공식 API 요금($10.00)의 19배예요.
이 글은 로컬 배포를 만류하려는 글이 아니에요. 직접 구축할지 판단할 수 있도록 돕는 의사결정 가이드예요. 각 수치에는 공식 자료, 제3자 실측, 이 글의 추산 중 어디에서 나온 값인지 표시했으니, 실제 사용량을 대입해 계산해 보세요.
핵심 가치: 이 글을 읽고 나면 Kimi K3.1 Pro를 직접 구축할 때 실제로 얼마가 드는지 계산하고, 체크리스트를 통해 장비를 임대할지, 구매할지, 아니면 API를 바로 이용할지 판단할 수 있어요.
Kimi K3.1 Pro 로컬 배포 핵심 요점
| 요점 | 결론 | 근거 수준 |
|---|---|---|
| 가중치 공개 상태 | 아직 공개되지 않았으며, 공식 발표에 따르면 11월 4일 전에 공개 예정 | 공식 원문 |
| 가중치 용량 | K3 가중치는 1,560.9GB이며, K3.1 Pro도 같은 아키텍처를 사용 | 제3자 실측(K3) |
| 최소 단일 서버 구성 | 8×B300 / 8×GB300 / 8×MI355X | 추론 프레임워크 구성 예시 + 실측 |
| 자체 운영 단위 비용 | 출력 토큰 100만 개당 약 $190.00 | 제3자 실측 청구 내역 |
| API 비용과 비슷해지는 조건 | 장기간 안정적으로 1,500 tok/s 이상 출력 | 본문 추정 |
Kimi K3.1 Pro 로컬 배포 관련 사실의 구분
이 글에서는 사실을 세 가지 수준으로 나눠 설명해요. 읽을 때 각 수준을 구분해 주세요. 공식 원문은 Moonshot이 kimi.ai 블로그, platform.kimi.ai 문서, Hugging Face 모델 카드에서 밝힌 내용을 뜻해요. 제3자 실측은 AWS, GPUStack, OpenZeka, Modal 사용자 등이 공개한 테스트 데이터예요. 본문에 출처와 날짜를 함께 표기할게요. 본문 추정은 공개된 가격과 처리량을 바탕으로 계산한 결과예요. 계산식과 가정을 명시하며, 공식 데이터가 아니에요.
추정의 근거도 공식 발표에서 찾을 수 있어요. K3.1 Pro는 Kimi K3의 후훈련 버전(post-trained version of Kimi K3)으로, 아키텍처는 그대로 사용하고 RL 후훈련에 투입하는 연산량만 늘렸어요. 따라서 K3의 파라미터 수, 양자화 형식, 가중치 용량을 K3.1 Pro 배포에 필요한 최소 사양을 가늠하는 합리적인 기준으로 삼을 수 있어요.
Kimi K3.1 Pro 로컬 배포에 필요한 하드웨어: 왜 B300 8장이 최소일까요?
【공식 문서】K3 모델 카드에 따르면 총 파라미터 수는 2.8T, 활성 파라미터 수는 104B이며, 총 93개 레이어로 구성돼요. 라우팅 전문가 896개 중 토큰마다 16개를 선택하고, 공유 전문가 2개를 추가로 사용해요. 컨텍스트 길이는 1,048,576이에요. 가중치에는 MXFP4, 활성값에는 MXFP8을 사용하며, SFT 단계부터 양자화 인식 학습을 적용했어요.
【제3자 실측】한 사용자가 Hugging Face 저장소의 파일을 하나씩 집계한 결과, safetensors 샤드 96개의 총용량은 1,560,936,091,448바이트, 약 1560.9GB였어요. 실제 용량이 「2.8T × 0.5 byte = 1400GB」라는 이론값보다 큰 이유는 config에서 어텐션 레이어, 공유 전문가, lm_head, 비전 타워 등의 일부를 허용 목록에 포함해 높은 정밀도를 유지하기 때문이에요. vLLM 레시피에 명시된 최소 GPU 메모리는 1680GB이며, 최소 8×GB300이 필요해요. 실제 운영 트래픽을 처리하려면 여러 노드가 필요해요.
| 구성 | 총 GPU 메모리 | 실행 가능 여부 | 설명 |
|---|---|---|---|
| 8×H100 80GB | 640GB | 불가 | 가중치 용량이 GPU 메모리의 2.4배예요 |
| 32×H100 | 2.56TB | 간신히 가능 | SGLang 레시피가 있지만, Hopper는 MXFP4를 기본 지원하지 않아 런타임 역양자화가 필요해요 |
| 8×H200 141GB | 1.13TB | 불가 | 약 400GB가 부족해요. 가장 아쉬운 구성입니다 |
| 16×H200(두 대) | 2.26TB | 가능 | 마찬가지로 역양자화가 필요해요 |
| 8×B200 180GB | 1.44TB | 불가 | 약 120GB가 부족해요 |
| 16×B200 / GB200 | 2.88TB | 가능 | Blackwell 기준 구성 |
| 8×B300 / GB300 | 2.30TB | 가능 | 공식 기본 구성으로, 단일 서버에 간신히 들어가요 |
| 8×MI355X | 2.30TB | 가능 | AMD의 day-0 검증 구성 |
| 단일 카드 / RTX 4090 / 512GB Mac | — | 불가 | RTX 4090은 가중치만 담는 데 75장이 필요해요 |
KV 캐시는 오히려 병목이 아니에요. K3는 24개 레이어에서만 Gated MLA를 사용하며 토큰당 약 27KiB를 써요. 나머지 69개 KDA 레이어는 시퀀스마다 고정된 상태만 필요해요. 제3자 계산에 따르면 컨텍스트 길이 1M에서 사용자 한 명의 KV 캐시는 약 29.5GB, 8K에서는 약 0.7GB예요. 실제 병목은 1.56TB에 달하는 가중치 자체예요.
그래도 배포하려면 프레임워크 측에서 다음 조건을 충족해야 해요(K3용 vLLM 레시피와 SGLang 쿡북 기준).
- vLLM 이미지:
vllm/vllm-openai:kimi-k3. CUDA 13 버전만 제공되며, r580 이상 드라이버와 vLLM ≥ 0.27.0이 필요해요. - 병렬화 전략: TP / TEP는 최소 8개 GPU, DEP는 최소 16개 GPU가 필요해요. 분산 KV 캐시는 명시된 모든 하드웨어에서 지원되지 않는 것으로 표시돼 있어요.
- SGLang 노드 구성: B300은 노드 1대에 GPU 8개, B200과 H200은 각각 노드 2대에 GPU 8개가 필요해요.
- Moonshot의 2026년 8월 기준(제3자 전언): 프로덕션 환경에는 가속기 64개 이상을 탑재한 슈퍼노드를 권장해요.
Kimi K3.1 Pro 로컬 배포 실제 비용: 네 가지 방식의 월 비용
아래는 단일 서버에서 8×B300을 24시간 가동한다고 가정해 추산한 월 비용이에요. 환율은 모두 1달러 = 7.25위안으로 계산했어요. 가격 출처는 세 곳입니다. ComputeUnion이 2026년 10월 24~25일에 수집한 종량제 요금, Modal 사용자가 직접 확인한 청구 내역, 그리고 《컴퓨팅 파워 임대 산업 조사》 회의록(2026년 5월 20일 시나재경 전재본)입니다.
⚠️ 중국 내 서버 임대 및 구매 가격(예: H200 월 약 8만 위안/대, B300 5년 계약 월 16만~19만 위안/대, B300 현물 가격 680만~700만 위안/대)은 업계 조사 기준이며, 제조사의 공식 공개 가격이 아니므로 대략적인 규모를 파악하는 용도로만 참고해 주세요. 일반적으로 8카드 서버 전체를 기준으로 계약하며, 최소 계약 기간은 1년입니다.
| 방식 | 계산 기준 | 월 비용 | 비고 |
|---|---|---|---|
| 해외 종량제 임대(24시간 가동) | B300 서버 시간당 342~464위안 × 730시간 | 약 24.98만~33.87만 위안(3.45만~4.67만 달러) | 제3자 견적 + 본문 추산 |
| Modal 실측(24시간 가동) | 시간당 $56.79 × 730시간 | $41,457.00, 약 30.06만 위안 | 제3자 실측 청구 내역 |
| 중국 내 5년 계약 서버 임대 | 업계 조사 기준 | 16만~19만 위안 | 비공개 견적, 최소 계약 기간 1년 |
| 일시불 구매 + 전기 요금 | 680만~700만 위안을 3년 정액 감가상각하고 전기 요금 약 0.88만 위안 추가 | 약 19.8만~20.3만 위안 | 운영 인력, 예비 부품, 랙 공간, 대역폭 비용 제외 |
| 하루 4시간만 가동 후 종료 | 해외 종량제 | 약 2.6만~3만 위안 | 매번 재시작할 때 콜드 스타트에 약 27분 소요 |
전기 요금은 이 글의 가정을 바탕으로 추산했어요. 부하 13.2kW, PUE 1.3, 전기 요금 0.7위안/kWh를 기준으로 하면 시간당 약 12위안입니다. 일시불 구매 방식이 가장 저렴해 보이지만, 표에는 운영 엔지니어의 인건비가 포함되지 않았어요. 이 비용이야말로 소규모 팀에서 가장 큰 숨은 지출입니다.
‘하루 4시간만 가동하고 종료’하는 방식은 비용을 아끼는 것처럼 보이지만, 실제로 적용하기는 쉽지 않아요. Modal 실측 결과 콜드 스타트에 약 27분이 걸렸고, 이 과정에서 1.56TB의 가중치를 로드하고 JIT 컴파일을 수행한 뒤 CUDA 그래프 51개를 캡처해야 했어요. 작업 시간이 짧으면 추론 시간보다 대기 시간이 더 길어질 수도 있습니다.
Kimi K3.1 Pro 단위 비용: 처리량에 따라 API보다 몇 배나 비쌀지가 달라져요
월 구독료는 겉으로 보이는 비용일 뿐이에요. 실제로 비용 대비 효율을 결정하는 것은 토큰 100만 개당 단위 비용입니다. 이 글에서는 다음 공식을 사용해 추정해요. 출력 토큰 100만 개당 비용 = 시간당 머신 비용 ÷ 시간당 출력 토큰 수(백만 단위). 분자는 Modal에서 실측한 시간당 $56.79로 통일했어요.
【제3자 실측】8×B300 구성에서 측정한 처리량 데이터는 다음과 같아요.
- Modal 단일 머신(TP8, 네이티브 MXFP4): 안정 상태에서 92 tok/s, TTFT 0.92~1.02초
- OpenZeka(DGX B300, TP8, vLLM): 동시성 1에서 105.7 tok/s, 동시성 64에서는 사용자당 32.45 tok/s. 채팅 사용자 150명 또는 Agent 50명을 지원할 수 있는 것으로 추정
- AWS 공식 예시(2026년 7월 29일, p6-b300.48xlarge): 동시성 8에서 516 tok/s, 높은 동시성에서 총 처리량 4,634 tok/s
- GPUStack(2026년 7월 30일): 입력 64K, 동시성 10에서 vLLM 엔드투엔드 처리 시간 100.5초, 프리필 집계 처리량 약 19K~23K tok/s
| 안정 상태 출력 처리량 | 시간당 출력량 | 출력 토큰 100만 개당 비용 | 공식 API $10.00와 비교 |
|---|---|---|---|
| 92 tok/s(단일 요청으로 최대 처리) | 0.33M | $171.50(원문 작성자 기준 $190.00) | 약 17~19배 |
| 500 tok/s | 1.80M | $31.50 | 약 3배 |
| 1,000 tok/s | 3.60M | $15.80 | 약 1.6배 |
| 1,500 tok/s | 5.40M | $10.50 | 거의 동일 |
| 3,000 tok/s | 10.80M | $5.30 | 약 절반 |
| 4,634 tok/s(AWS 실측 최고치) | 16.68M | $3.40 | 약 3분의 1 |
한두 명이 사용하는 경우라면 실제로는 첫 번째 행에 해당해요. 동시 요청을 충분히 늘리지 못하면 머신은 대부분의 시간을 유휴 상태로 보내고, 출력 토큰 100만 개당 비용은 약 $190.00에 이릅니다. 제목에서 말하는 ‘19배 비싸다’는 표현이 여기서 나온 거예요. 업무에서 장시간 처리량을 1,500 tok/s 이상으로 유지할 수 있어야 자체 구축의 단위 비용이 API와 비슷해집니다.
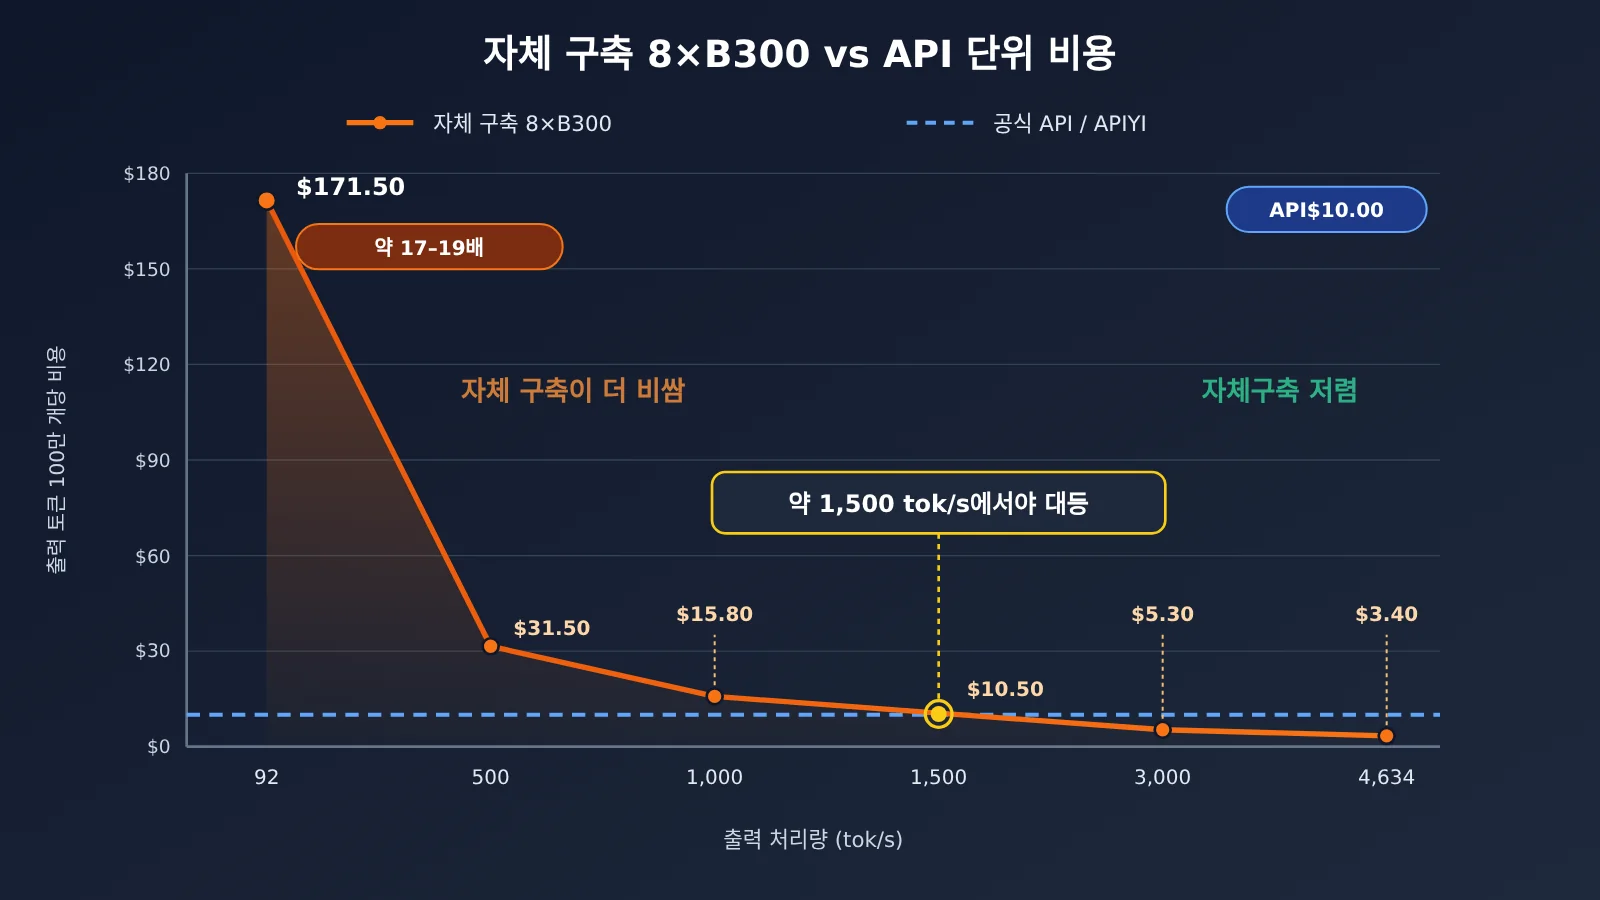
💡 비교 안내: 위 그래프의 API 기준선은 출력 토큰 100만 개당 공식 가격인 $10.00입니다. APIYI apiyi.com의 kimi-k3.1-pro 출력 가격도 공식 가격과 같아, 그대로 비교 기준으로 삼을 수 있어요.
Kimi K3.1 Pro 로컬 배포 손익분기점: 매달 토큰을 얼마나 써야 할까
관점을 바꿔 볼게요. 매달 토큰을 얼마나 써야 직접 구축하는 편이 API 사용과 비용 면에서 같아질까요? 아래 추정치는 공식 API 요금인 입력 $2.00 / 출력 $10.00을 기준으로 했어요. 입력과 출력 비율은 일반적인 에이전트 환경에서 흔한 5:1로 가정했고, 캐시 적중은 계산에 포함하지 않았어요.
| 직접 구축 방식 | 월 비용 | 월 입력 토큰 기준 | 월 출력 토큰 기준 |
|---|---|---|---|
| 해외 종량제 24/7 | $41,457.00 | 약 104억 | 약 20.7억 |
| 국내 5년 약정 완제품 | 19만 위안 | 약 65.5억 | 약 13.1억 |
| 장비 구매(감가상각 + 전기료) | 20.3만 위안 | 약 69.8억 | 약 14억 |
매달 출력 토큰이 10억 단위라니 어느 정도일까요? OpenZeka의 추정에 따르면 8×B300 한 대로 에이전트를 동시에 사용하는 사용자 50명을 감당할 수 있어요. 직원이 10명도 안 되는 작은 팀이라면 이 규모에 한참 못 미칠 거예요.
놓치기 쉬운 변수가 하나 더 있어요. 바로 캐시예요. 공식 캐시 적중 요금은 토큰 100만 개당 $0.20에 불과하고, 에이전트나 긴 문서를 다루는 환경에서는 캐시 적중률도 대체로 낮지 않아요. 캐시 비중이 높아질수록 API 사용 비용은 더 낮아지고, 직접 구축이 손익분기점에 도달하는 사용량도 더 늘어나요.
Kimi K3.1 Pro를 직접 구축해야 하는 경우
직접 구축하는 게 불가능한 건 아니지만, 그럴 만한 분명한 이유가 있어야 해요. 다음과 같은 경우라면 직접 구축을 고려할 만합니다.
- 규정 준수나 오프라인 운영이 필수인 경우: 데이터가 내부망 밖으로 나가면 안 되거나 물리적으로 격리해야 한다면, API가 아무리 저렴해도 사용할 수 없어요. 다만 공식 API는 이미 데이터 보존을 하지 않는 옵션(ZDR)을 지원하므로, 먼저 해당 옵션이 규정 준수 요건을 충족하는지 확인해 보세요.
- 미세 조정이나 지식 증류가 필요한 경우: K3.1 Pro를 기반으로 특정 분야에 맞게 후속 학습을 하거나, 30B~120B급 소형 모델로 증류하려면 전체 가중치를 확보해야 해요.
- 유휴 GPU와 전담 운영 인력이 있는 경우: 8×B300, 8×MI355X 또는 H200 두 대를 놀리고 있고, vLLM이나 SGLang을 다룰 줄 아는 엔지니어가 운영을 맡을 수 있어야 한계 비용을 낮출 수 있어요.
- 실제 사용량이 충분한 경우: 처리량이 장기간 안정적으로 1,500 tok/s를 넘고, 월간 출력량이 10억 토큰 수준에 도달해야 해요.
라이선스도 미리 확인해야 해요. K3는 Kimi K3 License를 적용하며, 제3자 요약에 따르면 외부에 모델 서비스를 제공해 연 매출이 2,000만 달러를 넘으면 별도 라이선스가 필요해요. K3.1 Pro의 라이선스는 가중치가 공개된 뒤 Hugging Face 저장소의 LICENSE를 기준으로 확인해야 합니다. 현재로서는 공식 입장을 대신해 단정할 수 없어요.
Kimi K3.1 Pro를 절대 직접 구축하면 안 되는 경우
다음과 같은 이유라면 직접 구축은 손해로 이어질 가능성이 커요.
- 비용을 아끼고 싶을 때: 처리량이 장기간 1,500 tok/s를 넘지 않는다면 단위 비용은 API보다 높아요. 개인 사용 환경에서는 약 19배 비쌉니다.
- 장시간 작업에 쓰면서 필요할 때만 켜고 싶을 때: 콜드 스타트에 약 27분이 걸려, 필요할 때 켜고 끄는 방식은 사실상 불가능해요.
- 혼자 또는 소규모 팀에서만 쓸 때: 동시 요청을 충분히 처리하지 못하면 시간당 $56.79를 내고 92 tok/s의 속도를 쓰는 셈이에요.
- 양자화로 단일 서버에 넣으려 할 때: 커뮤니티에서 나온 방법은 모두 프로덕션에 적합하지 않아요. Unsloth 1-bit(UD-IQ1_S, 594GB)는 8×A100에서 약 9 tok/s를 내며, 출력 토큰 100만 개당 비용으로 환산하면 $620.00이에요. 전체 정밀도 모델보다 3.3배 비쌉니다. 1-bit 모델과 전체 모델의 top-1 일치율은 약 79%예요.
kimi-k3-in-c는 메모리 8.24GB로 전체 가중치를 실행할 수 있지만, 속도가 토큰당 10~32초라 기술 시연 수준에 그쳐요.
실제로 ‘로컬에서 실행할 수 있는’ 형태는 커뮤니티에서 추후 출시할 증류 버전이에요. 그전까지는 개인과 소규모 팀이 API를 사용하는 게 가장 간편합니다.
Kimi K3.1 Pro 빠르게 시작하기: 먼저 API로 업무를 검증하세요
직접 구축할지 결정하기 전에 API로 실제 업무를 한 달간 처리해 보는 것을 강력히 권장해요. 입력·출력 토큰과 캐시 적중률을 확인한 다음, 위의 손익분기 표를 기준으로 비용을 계산해 보세요. APIYI apiyi.com에는 kimi-k3.1-pro가 등록되어 있으며, 공식 API와 같은 가격으로 제공됩니다. 입력 $2.00 / 출력 $10.00 / 캐시 읽기 $0.20(단위: 토큰 100만 개당 달러)이며, 모델명과 가격은 플랫폼의 모델 목록을 기준으로 확인하세요.
연동 방법(OpenAI 호환 API):
- APIYI apiyi.com에 가입하고 API 키를 만드세요. 신규 사용자는 무료 테스트 크레딧을 받을 수 있어요.
- SDK의 base_url을
https://api.apiyi.com/v1로 설정하세요. - 모델 ID에는
kimi-k3.1-pro를 입력하세요. 속도가 중요하다면kimi-k3.1-pro-highspeed($4.00 입력 / $20.00 출력)를 사용할 수 있어요. - 추론 강도 매개변수
reasoning_effort는low/high/max중에서 선택할 수 있어요. 공식 기본값은max입니다. 공식 평가 설정은temperature = 1.0,top_p = 0.95예요. - 여러 차례 대화하거나 도구를 호출할 때는
reasoning_content가 포함된 assistant 메시지를 원본 그대로 다시 전달해야 해요. 그렇지 않으면 컨텍스트에 문제가 생길 수 있습니다. - 통계 스크립트를 작성해
prompt_tokens,completion_tokens, 캐시 적중량을 매일 기록하세요. 나중에 직접 구축할지 판단하는 데 도움이 됩니다.
| 모델 | 입력 | 출력 | 캐시 읽기 | 이용 가능 플랫폼 |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | APIYI apiyi.com, Kimi 공식 API |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | APIYI, Kimi 공식 API |
| kimi-k3 | $3.00 | $15.00 | $0.30 | APIYI |
🚀 빠르게 시작하기: 프로젝트를 검증하는 단계라면 APIYI apiyi.com에서 하나의 키로 kimi-k3.1-pro와 다른 주요 모델을 함께 테스트해 보세요. 먼저 K3.1 Pro가 실제 작업에서 가장 적합한지 확인한 다음, 직접 구축할지 검토하는 것을 추천해요.
Kimi K3.1 Pro 로컬 배포 FAQ
Q1: Kimi K3.1 Pro 가중치를 지금 다운로드할 수 있나요?
아직은 안 돼요. 공식 원문에는 “The full model weights will be released by Nov 4”라고 나와 있어요. 즉, 2026년 11월 4일까지 공개될 예정이에요. 이 글의 하드웨어 수치는 모두 공개된 K3를 기준으로 추산했으니, 가중치가 공개되면 실제 파일 크기를 기준으로 다시 확인해 주세요.
Q2: H200 8장으로 Kimi K3.1 Pro를 실행할 수 없는 이유는 무엇인가요?
H200 8장의 총 GPU 메모리는 1.13TB지만, K3 가중치의 실측 크기는 1560.9GB예요. 약 400GB가 부족하죠. 게다가 Hopper는 MXFP4를 기본 지원하지 않아요. 16×H200 시스템 두 대를 사용하더라도 런타임 역양자화가 필요해 속도가 나오지 않아요.
Q3: ‘19배 비싸다’는 수치는 어떻게 계산한 건가요?
이 수치는 제3자 실측 결과를 바탕으로 해요. Modal의 H200 8장 인스턴스 비용은 시간당 $56.79이고, 단일 요청의 정상 상태 처리 속도는 약 92 tok/s예요. 이를 100만 출력 토큰당 비용으로 환산하면 약 $190.00이고, 공식 API 출력 가격인 $10.00으로 나누면 19배가 돼요. 92 tok/s를 기준으로 엄밀하게 계산하면 $171.50이지만, 원 작성자의 계산에는 실제 운영 중 발생하는 손실도 포함돼 있어요.
Q4: 소규모 팀이 Kimi K3.1 Pro를 직접 구축해 비용을 아낄 방법이 있나요?
사실상 없어요. 장비를 구매하는 방식은 인건비를 제외해도 월 약 20만 위안이 들어요. 양자화해 단일 서버에 넣으면 오히려 비용이 더 들고 성능은 떨어지죠. 소규모 팀에는 API를 사용량에 따라 결제하는 방식이 더 현실적이에요. 예를 들어 APIYI apiyi.com을 통해 kimi-k3.1-pro를 호출하면 사용한 만큼만 결제하고, 캐시 적중분은 토큰 100만 개당 $0.20만 내면 돼요.
Q5: Kimi K3.1 Pro API를 빠르게 호출하려면 어떻게 해야 하나요?
APIYI apiyi.com에 가입해 API 키를 발급받고, base_url을 `https://api.apiyi.com/v1`로 설정한 뒤 모델에 `kimi-k3.1-pro`를 입력하면 돼요. 기존 OpenAI SDK 코드는 대부분 수정하지 않아도 돼요. 다만 여러 차례 대화할 때는 `reasoning_content`를 다시 전달해야 해요.
Q6: Kimi K3.1 Pro 로컬 배포에는 어떤 제한 사항이 있나요?
주요 제한은 세 가지예요. 첫째, 콜드 스타트에 약 27분이 걸려 탄력적인 확장·축소에 적합하지 않아요. 둘째, vLLM 이미지는 CUDA 13 버전만 제공되므로 드라이버가 r580 이상이어야 해요. 구형 클러스터는 먼저 업그레이드해야 하죠. 셋째, 안내된 하드웨어에서는 분산 KV 캐시를 지원하지 않아 여러 장비로 확장하기 어려워요.
Q7: 로컬 배포가 현실적으로 가능해지는 시점은 언제인가요?
커뮤니티에서 30B~120B급 증류 버전을 내놓아야 개인이나 소규모 팀도 로컬에서 실행할 수 있어요. 전체 3T급 모델은 당분간 데이터센터급 환경이 필요한 작업이에요.
Kimi K3.1 Pro 로컬 배포 핵심 요약
- 가중치 미공개: 공식 발표에 따르면 11월 4일 이전에 공개될 예정이며, 현재 나온 수치는 모두 K3를 기준으로 추정한 값이에요.
- 최소 하드웨어 사양: 가중치 용량은 1,560.9GB예요. 단일 서버로 운영하려면 최소 8×B300, GB300 또는 MI355X가 필요해요.
- 월간 비용 규모: 단일 서버를 24시간 내내 운영하면 경로에 따라 월 약 16만~34만 위안이 들어요.
- 토큰당 비용: 자체 운영 시 출력 토큰 100만 개당 약 $190.00로, 공식 API보다 19배 비싸요.
- 비용을 따라잡는 조건: 장기 처리량이 1,500 tok/s를 넘고, 월간 출력량이 10억 토큰 수준이어야 해요.
- 시작 방법: 먼저 APIYI apiyi.com에서 kimi-k3.1-pro를 호출해 실제 업무에 적용해 보세요. 데이터를 바탕으로 자체 구축 여부를 결정하면 돼요.
Kimi K3.1 Pro 배포 방식 자가 점검 체크리스트
아래 5가지 질문에 차례로 답하면 직접 임대하거나 구매할지, API를 이용할지 판단할 수 있어요.
- 규정 준수 요건상 데이터를 사내망 밖으로 반출할 수 없고, 공식 ZDR로도 해결할 수 없나요? — 아니라면 API를 바로 사용하세요.
- 미세 조정이나 증류를 위해 가중치가 필요한가요? — 그렇다면 단기간 필요한 만큼만 서버를 임대하고, 사용이 끝나면 중단하는 방안을 고려하세요.
- 월간 출력 토큰이 꾸준히 13억 개를 넘나요? — 아니라면 자체 구축 비용이 API보다 더 많이 들어요.
- 유휴 상태인 8×B300 또는 MI355X급 서버와 전담 운영 인력이 이미 있나요? — 그렇다면 자체 구축을 고려할 수 있어요. 없다면 이 용도로 서버를 따로 구매하지 마세요.
- 업무 특성상 언제든 서비스를 시작하고 중단하거나, 탄력적으로 규모를 조정해야 하나요? — 그렇다면 콜드 스타트에 27분이 걸리는 자체 구축은 적합하지 않으니 API를 선택하세요.
요약
Kimi K3.1 Pro를 로컬에 배포할 때 알아둘 핵심은 다음과 같아요.
- 높은 진입 장벽: K3를 기준으로 추산하면 가중치 크기가 약 1.56TB라서 8×B300으로 겨우 수용할 수 있어요.
- 개인 사용에는 비경제적: 단일 서버에서 직접 운영하면 출력 토큰 100만 개당 약 $190.00으로, API를 이용할 때보다 19배 비싸요.
- 대규모 운영에서만 비용 효율적: 처리량이 장기간 1,500 tok/s를 넘고 월 출력량이 10억 토큰 수준에 도달해야 자체 구축을 고려할 만해요.
중국 내 대부분의 개발자와 소규모 팀이라면 먼저 API로 서비스를 운영하고 사용량 데이터를 쌓은 다음, 자체 구축이 가치 있는지 판단하는 게 좋아요. APIYI apiyi.com을 통해 kimi-k3.1-pro를 호출해 보세요. 공식 가격과 동일하고, 신규 사용자에게는 무료 사용량이 제공돼요. API 키 하나로 다른 주요 모델도 손쉽게 비교할 수 있어요.
📚 참고 자료
- Kimi K3.1 Pro 공식 출시 블로그: 가중치 공개 시점과 모델의 포지셔닝
- 링크:
kimi.ai/blog/kimi-k3-1-pro -
설명: 공식 원문으로, 가중치가 11월 4일 이전에 공개될 예정임을 확인할 수 있어요.
-
Kimi 공식 API 가격표: K3.1 Pro의 입력, 출력, 캐시 가격
- 링크:
platform.kimi.ai/docs/pricing/chat -
설명: 이 글에서 API 가격을 비교할 때 참고한 자료예요.
-
Kimi K3 모델 카드: 아키텍처, 양자화, 라이선스
- 링크:
huggingface.co/moonshotai/Kimi-K3 -
설명: 총 파라미터 2.8T, MXFP4 양자화, Kimi K3 라이선스 정보를 확인할 수 있어요.
-
vLLM Kimi K3 레시피: 최소 GPU 메모리와 배포 요구 사항
- 링크:
recipes.vllm.ai/moonshotai/Kimi-K3 -
설명: 최소 8×GB300이 필요하며, 최소 GPU 메모리는 1,680GB예요.
-
AWS 8×B300 추론 실측: 처리량 데이터
- 링크:
github.com/aws-samples/sample-llm-inference-on-eks -
설명: 높은 동시성 환경에서 총 처리량은 4,634 tok/s예요.
-
GPUStack 8×B300 실측: 긴 컨텍스트에서 vLLM과 SGLang 비교
- 링크:
cnblogs.com/gpustack/p/22073008 - 설명: 입력 길이 64K / 200K에서의 엔드투엔드 처리 시간을 확인할 수 있어요.
작성자: APIYI 기술팀
기술 문의: APIYI 공식 웹사이트 홈페이지에서 문의해 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.