필자 노트: 하나의 API 키와 OpenAI 호환 엔드포인트만으로 대규모 언어 모델 전환을 완료하는 방법을 다루고, 이미지·Embedding처럼 모델 간 통합 시 별도로 맞춰야 하는 필드, 상태, 검수 기준까지 명확히 정리했어요.
이 글에서는 하나의 API 키와 하나의 OpenAI 호환 엔드포인트로 텍스트 전용 모델 전환을 먼저 구현해 본 뒤, 이미지와 벡터 두 가지 예시를 통해 모델 간 통합에서 어떤 필드·상태·검수 기준을 별도로 맞춰야 하는지 설명할게요. 결론에는 전제가 있어요. 동일한 엔드포인트에서 두 모델이 모두 지원하는 공통 파라미터만 사용할 때는 모델을 전환하더라도 보통 model 필드만 바꾸면 됩니다. 하지만 모델 고유의 사고(thinking) 파라미터, 도구 호출, 이미지 크기, 벡터 차원이 개입되는 순간에는 모델별로 따로 확인해야 해요.
이 글은 “코드 한 줄만 고치면 모든 게 해결된다”는 식의 홍보성 글이 아니에요. APIYI 통합 인터페이스에서 그대로 재사용할 수 있는 부분과 반드시 다시 검증해야 하는 부분을 구분해서 명확하게 짚어 주고, 실패 시나리오도 함께 다룰 거예요.
핵심 가치: 이 글을 다 읽고 나면 동일한 인증 체계와 코드로 텍스트 모델을 전환할 수 있고, 이미지와 Embedding에서 모델을 바꿀 때 어떤 파라미터를 수정해야 하는지 알게 되며, 실무에 바로 적용할 수 있는 전환 검수 방법까지 익힐 수 있어요.
APIYI 통합 인터페이스로 대규모 언어 모델을 전환하기 전에 알아야 할 9가지 용어
모델을 전환할 때 생기는 문제는 대부분 용어를 제각각 이해하는 데서 시작돼요. 예를 들어 Base URL에 /v1이 두 번 들어가게 적는다거나, 같은 차원의 벡터라면 섞어 써도 된다고 오해하는 경우죠. 먼저 아래 개념들을 하나로 통일해 두세요. 뒤에서 다룰 모든 단계가 이 정의들을 전제로 진행되니까요.
| 용어 | 실제 의미 | 전환할 때 확인할 점 |
|---|---|---|
| Base URL | SDK가 인터페이스 경로를 조립할 때 기준이 되는 루트 주소 | OpenAI SDK에는 /v1까지만 입력해서 경로 중복을 피하세요 |
| API Key | API 요청의 인증 수단 | 서버 측 설정이나 환경 변수에만 저장하세요 |
| 모델 ID | 요청에서 지정하는 모델로, 버전이나 채널 정보가 포함될 수 있음 | 모델 레지스트리에서 원본 ID를 복사하고, 손으로 직접 입력하지 마세요 |
| 토큰 그룹 | 현재 Key에서 사용 가능한 모델, 채널, 과금 조건을 결정 | 모델이 그룹에 없으면 401/403 또는 404가 반환돼요 |
| Chat Completions | 메시지 배열을 기반으로 텍스트 대화를 처리하는 인터페이스 프로토콜 | 텍스트만 다루는 전환의 주요 진입점 |
| Responses | 여러 유형의 출력과 도구 호출을 지원하는 인터페이스 프로토콜 | GPT-6.2의 도구 호출은 이 프로토콜을 사용해야 해요 |
| Embedding | 내용을 고정 차원의 벡터로 인코딩해 검색 등 유사도 매칭에 쓰는 기술 | 모델을 바꾸는 건 벡터 공간을 바꾸는 것과 같아요 |
| 벡터 인덱스 | 특정 차원과 벡터 공간을 기준으로 유사한 항목을 찾는 구조 | 차원이 바뀌든 모델이 바뀌든 모두 재구축이 필요해요 |
| 첫 표시 토큰 지연 시간 | 요청을 보낸 후 사용자가 유효한 생성 결과를 처음 보기까지 걸리는 대기 시간 | 추론 모델의 사고 시간이 이 지표를 길게 만들어요 |
이 중에서 ‘토큰 그룹’이 가장 놓치기 쉬운 개념이에요. 같은 계정이라도 Key가 속한 그룹에 따라 보이는 모델 목록이 다를 수 있거든요. 그래서 ‘모델이 존재하지 않는다’는 오류를 만났을 때는 코드부터 의심하기보다, Key가 속한 그룹부터 확인하는 게 순서예요.
APIYI 통합 인터페이스로 대규모 언어 모델 전환하기: 핵심 포인트
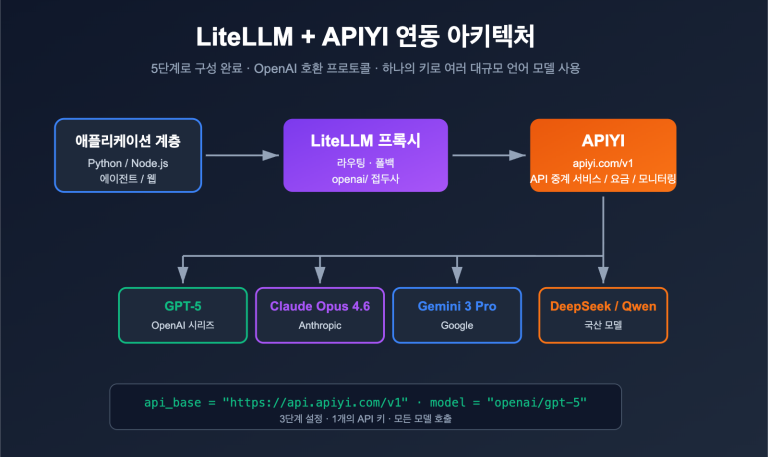
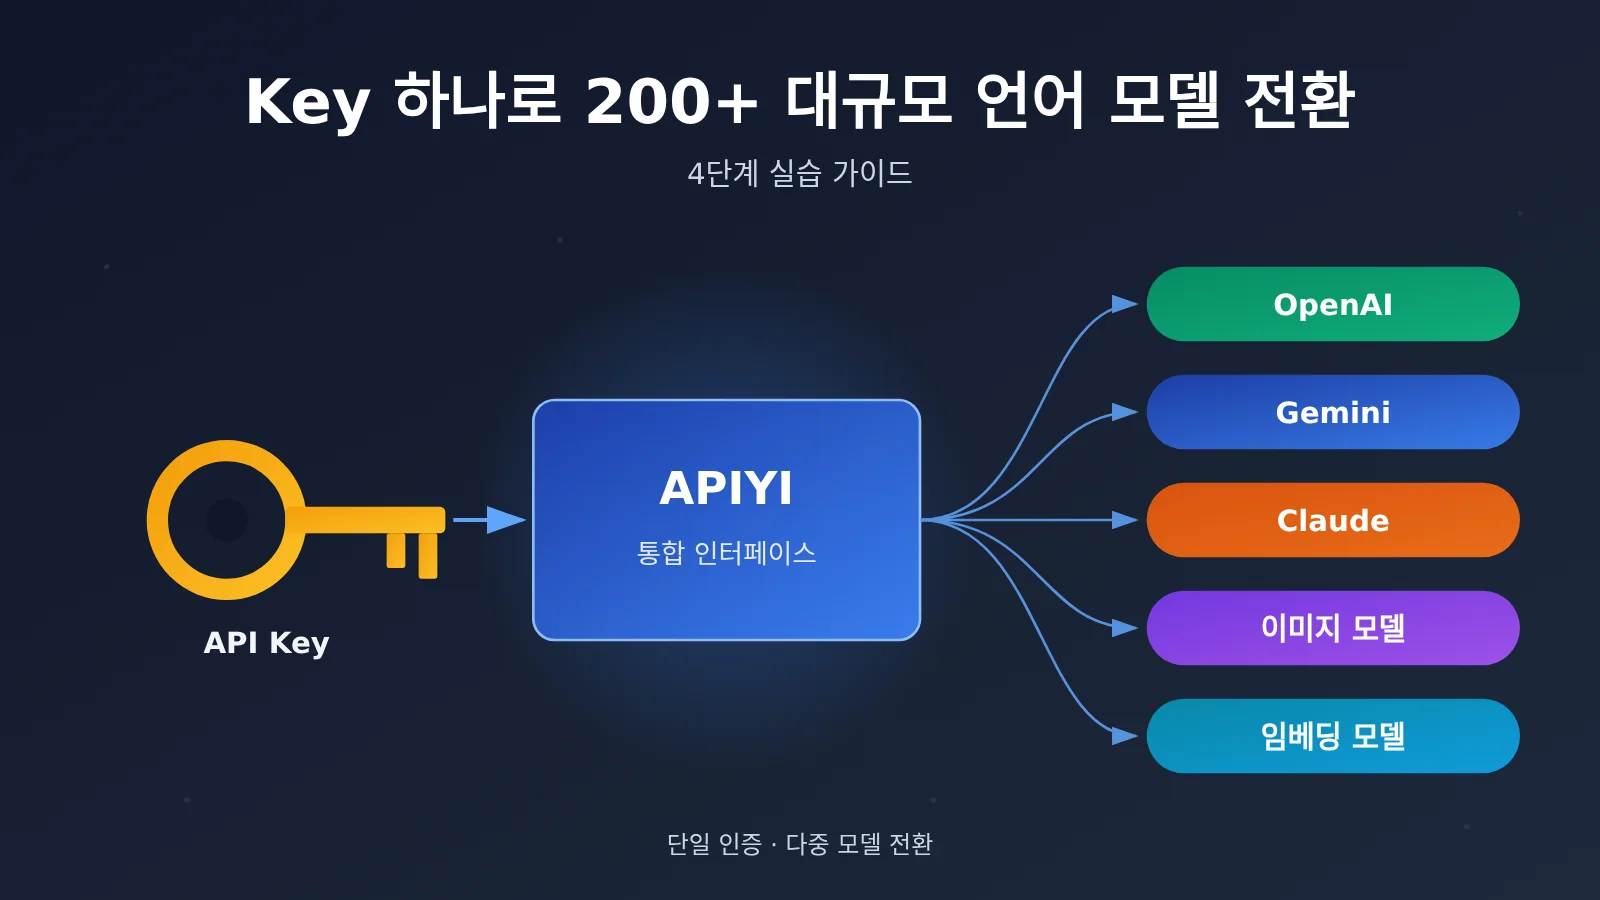
통합 연결이 진짜로 아껴주는 건 “반복 작업”이에요. 벤더마다 계정을 따로 만들고, 키를 여러 벌 관리하고, SDK도 여러 개에 맞춰 코드를 고칠 필요가 없어지죠. APIYI(apiyi.com)의 기본 소개와 빠른 시작 문서에 따르면, 인증 설정 한 벌에 OpenAI 호환 진입점 하나만 있으면 서로 다른 벤더의 사용 가능한 모델에 접근할 수 있어요.
| 구분 | 재사용 가능 | 모델별로 확인 필요 |
|---|---|---|
| 인증 | 동일한 API 키, 동일한 요청 헤더 | 키가 속한 토큰 그룹에 대상 모델이 포함되어 있는지 |
| 진입점 | 동일한 Base URL | 대상 모델이 지원하는 엔드포인트 종류(채팅/Responses/이미지/임베딩) |
| 요청 본문 | model, 기본 messages, input 등 공통 필드 |
추론(사고) 레벨, 도구, 구조화된 출력, 이미지 크기, 임베딩 차원 |
| 응답 처리 | choices, finish_reason, usage 파싱 로직 |
빈 본문, 도구 호출만 있는 응답, 안전 필터링 등 특수 반환 |
| 과금 | 동일한 계정 잔액과 청구 내역 | 모델별 단가, 가격 등급, 캐시 과금 방식이 다름 |
200+와 289: APIYI 모델 수를 세는 두 가지 기준
APIYI의 공개 소개 기준으로는 200+개의 엄선된 모델을 연동한다고 안내하고 있어요. 반면 2026-11-20에 생성된 공개 모델 레지스트리에서는 model_count 필드가 289로 나왔죠. 두 숫자는 모순이 아니에요. 레지스트리 집계에는 같은 모델의 서로 다른 버전과 라인별 변형까지 포함되기 때문에, 항목 수가 “엄선된 모델” 수보다 많아지는 게 자연스러워요.
한 가지 주의할 점은, 개별 토큰이 실제로 호출할 수 있는 목록은 그룹·모델 권한·엔드포인트라는 세 겹의 제약을 받는다는 거예요. 레지스트리에 어떤 ID가 존재한다고 해서 여러분이 가진 키로 반드시 호출할 수 있는 건 아니라는 뜻이에요.
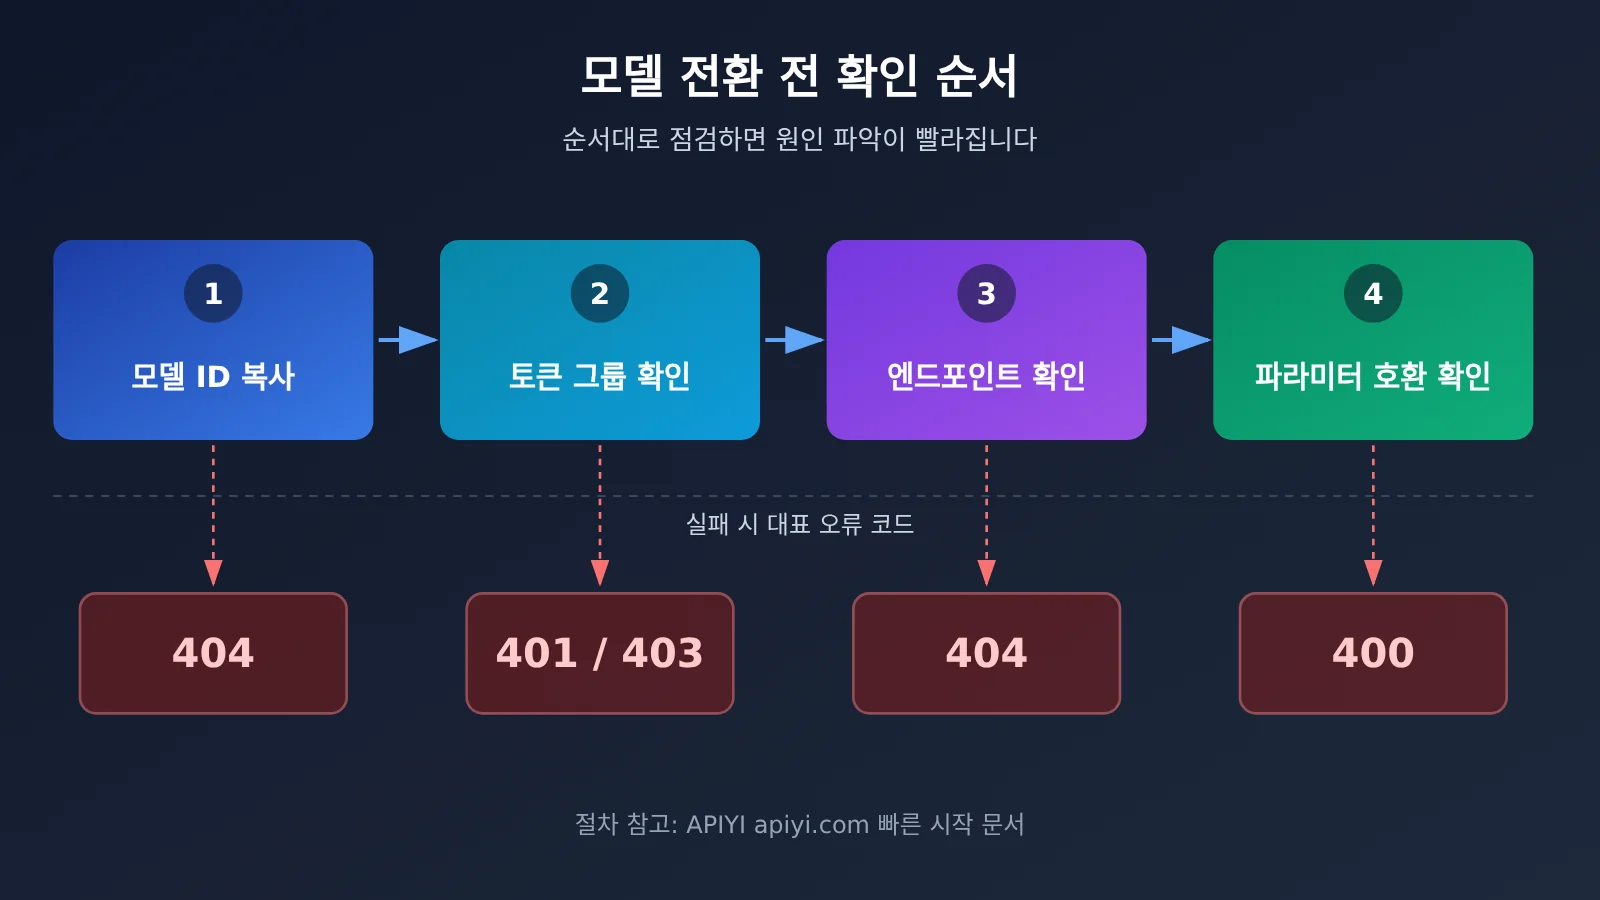
전환 전 확인 순서
새 모델을 도입할 때마다 정해진 순서대로 점검하는 걸 추천해요. 문제가 생겼을 때 여러 방향을 동시에 뒤지는 수고를 막을 수 있거든요:
- 모델 ID 확인: 당일 모델 레지스트리에서 원본 ID를 그대로 복사하고, 대소문자와 하이픈이 완전히 일치하는지 확인하세요.
- 토큰 그룹 확인: 현재 키가 속한 그룹에서 해당 모델이 개방되어 있는지 확인하세요. 일부 모델은 특정 그룹에서만 제공되기도 해요.
- 엔드포인트 확인: 호출하려는 인터페이스 유형을 해당 모델이 지원하는지 확인하세요. 텍스트, 이미지, 임베딩 엔드포인트는 각각 달라요.
- 파라미터 확인: 두 모델이 모두 지원하는 공통 파라미터만 남긴 뒤, 전용 파라미터는 하나씩 추가하면서 검증하세요.
APIYI 통합 인터페이스로 텍스트 대규모 언어 모델 빠르게 전환하는 방법
아래에서는 Chat Completions로 접근하는 텍스트 모델 두 가지, gemini-4-neon과 gpt-6.2-sol을 예로 들어 볼게요. 두 모델 모두 POST /v1/chat/completions를 사용하고, 기본 messages만 쓸 때는 model 필드만 바꾸면 전환이 끝나요. 다만 내 API 키 그룹에서 이 두 모델이 보여야 한다는 전제가 있으니, 호출하기 전에 모델 등록 목록에서 먼저 확인하세요.
최소 예제: 같은 코드로 두 모델 전환하기
Base URL을 https://api.apiyi.com/v1로 설정하고, API 키는 환경 변수에서 읽어 와요:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],     # 서버 측 환경 변수에만 보관
    base_url="https://api.apiyi.com/v1",     # APIYI OpenAI 호환 엔드포인트
)

for model in ["gemini-4-neon", "gpt-6.2-sol"]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是向量索引"}],
    )
    choice = resp.choices[0]
    print(model, "| finish_reason:", choice.finish_reason, "| usage:", resp.usage)
    print(choice.message.content or "<空正文>")
응답 필드 확인하기, HTTP 200만 보지 말고
응답을 받았다면 최소한 세 곳은 확인해 보세요. choices[0].message.content가 비어 있는지, finish_reason이 stop인지 아니면 길이 초과로 잘리는 등 다른 이유로 끝났는지, 그리고 usage의 토큰 사용량이 합리적인 수준인지요. 추론 계열 모델은 생각하는 과정에서도 출력 예산을 소모하기 때문에, 예산이 너무 작으면 “HTTP 200인데 본문이 비어 있는” 상황이 생길 수 있어요.
또 하나 주의할 점은, 응답 본문에서 모델이 스스로 밝히는 이름은 실제 백엔드 모델을 검증하는 근거가 될 수 없다는 거예요. 실제로 어떤 모델이 호출됐는지 확인해야 한다면 요청 ID, 응답 메타데이터, 과금 로그를 먼저 확인하는 편이 좋아요.
전체 구현 코드 보기: 스트리밍 첫 토큰 지연, 백오프 재시도, 지표 기록 포함
import os
import time
import random
from openai import OpenAI, RateLimitError, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",   # APIYI 통합 인터페이스
)

def call_once(model: str, prompt: str, max_retries: int = 3) -> dict:
    """스트리밍으로 한 번 호출하여 첫 가시 토큰 지연 시간, 총 소요 시간, 종료 사유를 기록합니다"""
    for attempt in range(max_retries + 1):
        start = time.perf_counter()
        first_token_at = None
        parts, finish_reason, usage = [], None, None
        try:
            stream = client.chat.completions.create(
                model=model,
                messages=[{"role": "user", "content": prompt}],
                stream=True,
                stream_options={"include_usage": True},
            )
            for chunk in stream:
                if chunk.usage:
                    usage = chunk.usage
                if not chunk.choices:
                    continue
                delta = chunk.choices[0].delta
                if delta and delta.content:
                    if first_token_at is None:
                        first_token_at = time.perf_counter()
                    parts.append(delta.content)
                if chunk.choices[0].finish_reason:
                    finish_reason = chunk.choices[0].finish_reason
            end = time.perf_counter()
            return {
                "model": model,
                "ok": bool(parts),
                "ttft_s": round(first_token_at - start, 3) if first_token_at else None,
                "total_s": round(end - start, 3),
                "finish_reason": finish_reason,
                "usage": usage,
                "text": "".join(parts),
            }
        except RateLimitError:
            # 일시적인 레이트 리밋에만 유한 횟수, 지터를 곁들인 지수 백오프 적용
            if attempt == max_retries:
                raise
            time.sleep((2 ** attempt) + random.uniform(0, 0.5))
        except APIStatusError as e:
            # 400/401/403/404는 설정 또는 파라미터 문제이므로 재시도해도 무의미
            return {"model": model, "ok": False, "status": e.status_code,
                    "error": str(e)[:300]}

if __name__ == "__main__":
    prompt = "用三句话说明向量索引为什么要和 Embedding 模型绑定"
    for m in ["gemini-4-neon", "gpt-6.2-sol"]:
        r = call_once(m, prompt)
        print({k: v for k, v in r.items() if k != "text"})
🚀 빠른 시작: 먼저 APIYI apiyi.com에서 신규 사용자 무료 테스트 크레딧으로 위의 최소 예제를 돌려 보세요. 두 모델 ID 모두 내 토큰 그룹에서 본문을 정상적으로 반환하는지 확인한 뒤, 비즈니스 코드에 연결하는 걸 권장해요.
전용 파라미터는 별도로 확인해야 해요
위 예제에서는 의도적으로 공통 필드만 사용했어요. 하지만 다음 파라미터가 포함되는 순간 “model만 바꾸면 끝”이라고 가정할 수 없어요:
- GPT-6.2 시리즈: OpenAI API에서
gpt-6.2-astra와gpt-6.2-sol은 Chat Completions와 Responses를 모두 지원해요. Chat Completions에서는 추론 강도 필드가reasoning_effort이고, Responses에서는reasoning.effort예요. 두 모델 모두none값은 거부해요. 도구 호출이 필요하다면 Responses로 전환해야 해요. - Gemini 4 시리즈:
gemini-4-neon은 APIYI의 Gemini 네이티브 방식과 OpenAI 호환 대화 엔드포인트를 모두 지원해요. 네이티브 REST에서는/v1beta/models/{id}:generateContent를 사용하며, 추론 강도는generationConfig.thinkingConfig.thinkingLevel에 지정해요.low,medium,high,xhigh중에서 선택할 수 있고 기본값은high예요. 이전 버전의thinkingBudget과minimal은 Gemini 4에는 적용되지 않아요. Google 문서에는 Gemini 4가temperature,topP를 무시한다는 내용도 기록되어 있어요. - 구조화된 출력과 도구: 양쪽의 JSON Schema 제약 조건과 도구 정의 형식이 반드시 일치하지는 않아서, 대상 모델 문서를 기준으로 항목별로 검증해야 해요.
참고로 APIYI의 Neon 출시 안내에는 출시 시점에 가격 API만 확인했고, 출시 전 실제 모델 호출은 진행하지 않았다고 나와 있어요. 따라서 위에서 언급한 듀얼 엔드포인트와 도구 호출은 문서화된 동작이니, 실제 사용 전에 최소 요청으로 직접 검증해 보시길 권해요.
APIYI 통합 인터페이스 기능 간 전환: 이미지와 Embedding 비교
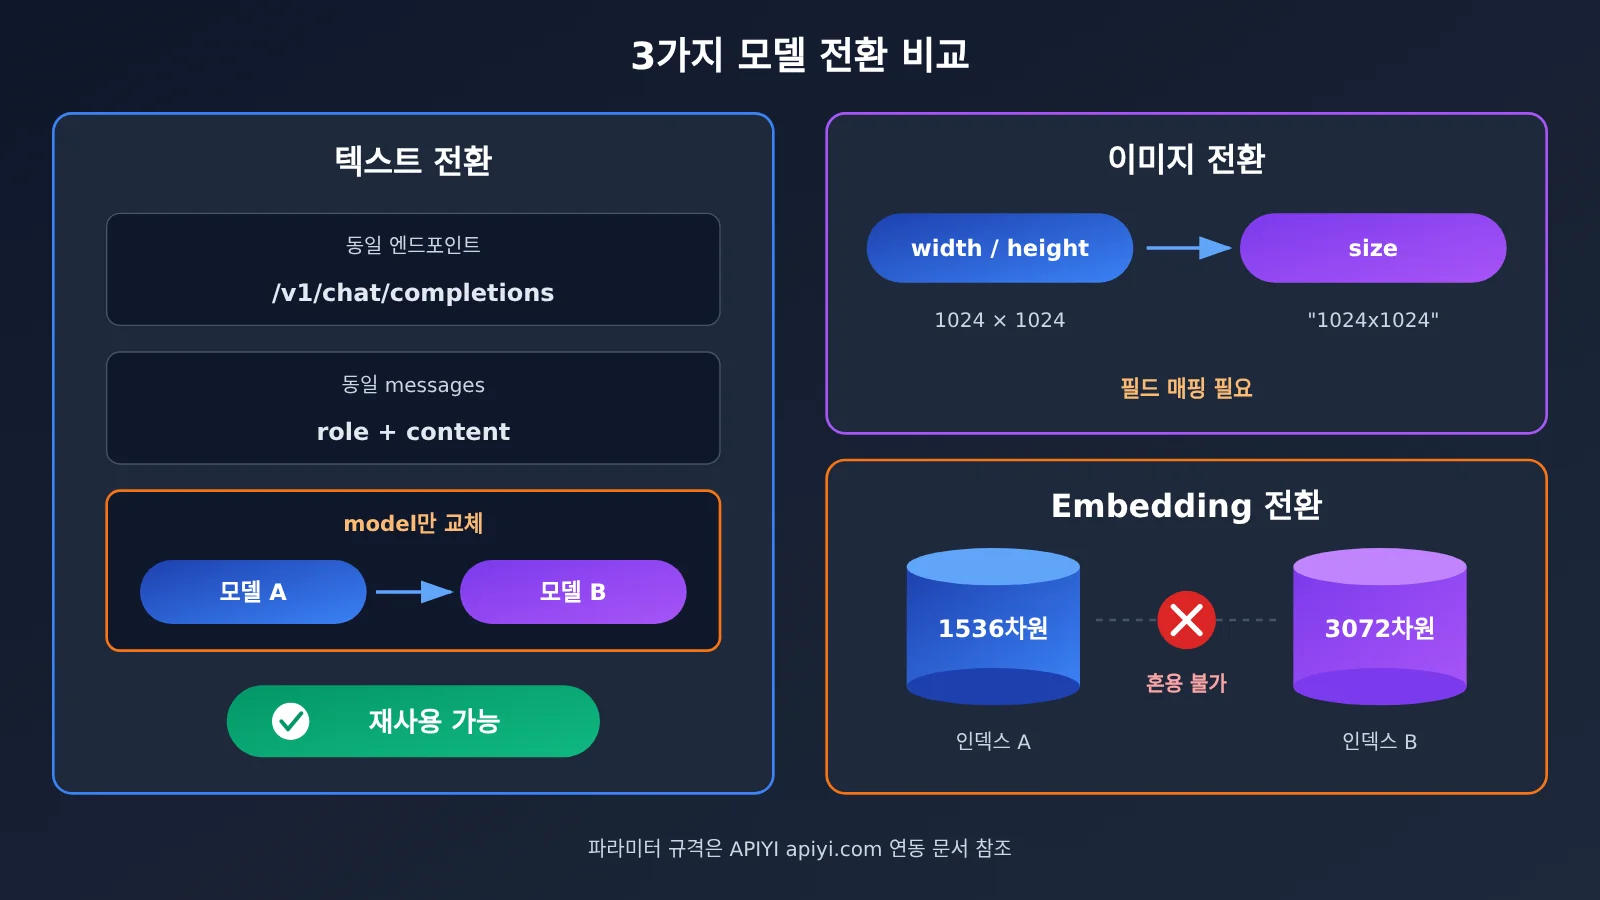
텍스트 대화 외에 이미지와 벡터는 가장 흔한 크로스 모델 시나리오인 동시에, ‘model만 바꾸면 끝’이라는 접근이 가장 쉽게 깨지는 지점이기도 해요. 아래 두 예제는 각각 ‘파라미터 구조가 다른 경우’와 ‘결과 공간이 다른 경우’라는 두 가지 유형의 문제에 대응합니다.
이미지 모델 전환: MAI-Image-2.7과 Seedream 5.5
두 모델 모두 같은 Key의 Images 기능으로 호출할 수 있지만, 크기, 참조 이미지, 투명 출력을 지정하는 방식은 완전히 달라요:
| 구분 | MAI-Image-2.7 | Seedream 5.5 |
|---|---|---|
| 엔드포인트 | 생성은 generations, 편집은 edits 사용 |
순수 텍스트와 참조 이미지 모두 generations 사용 |
| 크기 파라미터 | width, height로 총 픽셀 수를 제어, 공지된 상한은 4,194,304 픽셀 |
size로 가격 등급을 선택, 생략 시 2K 등급 적용 |
| 참조 이미지 | 편집 시 참조 이미지 최대 5장 | 참조 이미지를 image 필드에 전달 |
| 투명 출력 | background: "transparent" 하나로 alpha 채널이 포함된 PNG 반환 |
background: "transparent"와 output_format: "png"를 동시에 지정해야 함 |
| 과금 | 독립 과금 | size 가격 등급별로 독립 과금 |
| 이용 가능 플랫폼 | APIYI apiyi.com (레지스트리와 그룹 설정 기준) | APIYI (레지스트리와 그룹 설정 기준) |
호출할 때는 비즈니스 레이어에서 필드를 직접 조립하기보다, 모델마다 파라미터 매핑 함수를 하나씩 만들어 두는 걸 추천해요:
# 앞선 예제의 client를 그대로 사용; 모델 ID는 당일 레지스트리에서 복사하세요
def build_image_kwargs(model: str, prompt: str, transparent: bool = False) -> dict:
    if model.startswith("MAI-Image"):
        body = {"width": 1024, "height": 1024}
        if transparent:
            body["background"] = "transparent"
        return {"model": model, "prompt": prompt, "extra_body": body}
    # Seedream 5.5: size가 가격 등급을 결정하며, 값은 연동 문서를 기준으로 함
    body = {"size": "2K"}
    if transparent:
        body.update({"background": "transparent", "output_format": "png"})
    return {"model": model, "prompt": prompt, "extra_body": body}

img = client.images.generate(**build_image_kwargs("MAI-Image-2.7", "扁平风格的钥匙图标", True))
두 모델의 투명 이미지, 참조 이미지 효과, 응답 형식, 비용은 각각 따로 검증해야 해요. 한 모델의 검수 결과를 다른 모델에 그대로 적용할 수는 없습니다.
Embedding 모델 전환: small과 large는 직접 섞어 쓸 수 없어요
벡터화 호출 방식은 확실히 통일되어 있어요. 모두 POST /v1/embeddings로 요청하고 model과 input만 넘기면 끝이거든요.
for m in ["text-embedding-3-small", "text-embedding-3-large"]:
    e = client.embeddings.create(model=m, input=["统一接口切换模型"])
    print(m, "维度:", len(e.data[0].embedding))   # 기본 차원은 각각 1536과 3072
문제는 결과예요. text-embedding-3-small은 기본이 1536차원, text-embedding-3-large는 기본이 3072차원이라서, 차원이 다른 벡터는 같은 인덱스에 담을 수 없어요. dimensions 파라미터로 large를 1536차원으로 줄이더라도 두 모델의 벡터 공간은 서로 통하지 않기 때문에, 기존 문서 벡터와 새 쿼리 벡터 사이의 유사도는 의미가 없어요.
따라서 Embedding 모델을 전환하는 올바른 순서는 이래요. 새 벡터 인덱스를 만들고, 기존 문서 전체를 다시 벡터화한 뒤, 쿼리 쪽 모델도 함께 전환하고, 마지막으로 라벨링해 둔 샘플 세트로 유사도 임계값을 다시 보정하는 거예요. 이 비용은 model 한 줄을 고치는 것보다 훨씬 크기 때문에, 모델 선정 단계에서 미리 감안해 둬야 해요.
APIYI 통합 인터페이스에서 모델 전환을 검증하는 방법
모델 전환을 실제 적용하기 전에는 “호출만 되는 수준”을 “검증 가능한 수준”으로 끌어올려야 해요. 검증은 오류 코드 점검과 지표 비교, 두 부분으로 나뉘어요.
오류 코드 점검 대조표
점검의 전제는 최소 요청 하나를 먼저 고정해 두는 거예요. 동일한 Key, 동일한 노드, 동일한 엔드포인트, 동일한 모델 ID로 안정적으로 재현해야 해요:
| 현상 | 흔한 원인 | 확인 및 수정 |
|---|---|---|
| 400 | 이전 모델 전용 필드, 도구 파라미터, 구조화된 출력, 이미지 형식 등이 호환되지 않음 | 필수가 아닌 필드를 모두 제거한 뒤 하나씩 다시 추가하면서 원인 찾기 |
| 401/403 | 토큰 형식 오류, 그룹에 해당 모델이 포함되지 않음, 모델이 화이트리스트에 없음 | Key, 토큰 그룹, 모델 화이트리스트 확인 |
| 404 | SDK가 /v1을 중복으로 붙이거나, 모델이 해당 인터페이스 타입에 속하지 않음 |
OpenAI SDK의 Base URL에는 /v1 포함. Google GenAI SDK는 /v1이 없는 루트 주소에 v1beta 설정. 원본 모델 ID를 그대로 복사 |
| 429 | 단기 속도 제한, 동시 요청 수 초과, 크레딧 부족 | 먼저 오류 본문을 확인. 단기 속도 제한이면 제한된 횟수 안에서 지터를 넣은 지수 백오프로 재시도하고, 크레딧 문제는 해결한 뒤 재전송 |
| 200인데 본문이 비어 있음 | 출력 예산이 추론(사고)에 전부 소진됨, 안전 필터, 도구 호출만 반환됨 | 완료 사유와 반환 타입을 확인하고 출력 예산 늘리기. 도구 없는 최소 요청으로 대조 테스트 |
Gemini 4의 멀티턴 도구 흐름에서는 응답에 담긴 thoughtSignature를 원본 그대로 돌려보냈는지, 그리고 도구 호출과 도구 결과가 하나씩 정확히 대응하는지도 함께 확인하세요.
지표를 기록해 모델 차이와 채널 오버헤드 구분하기
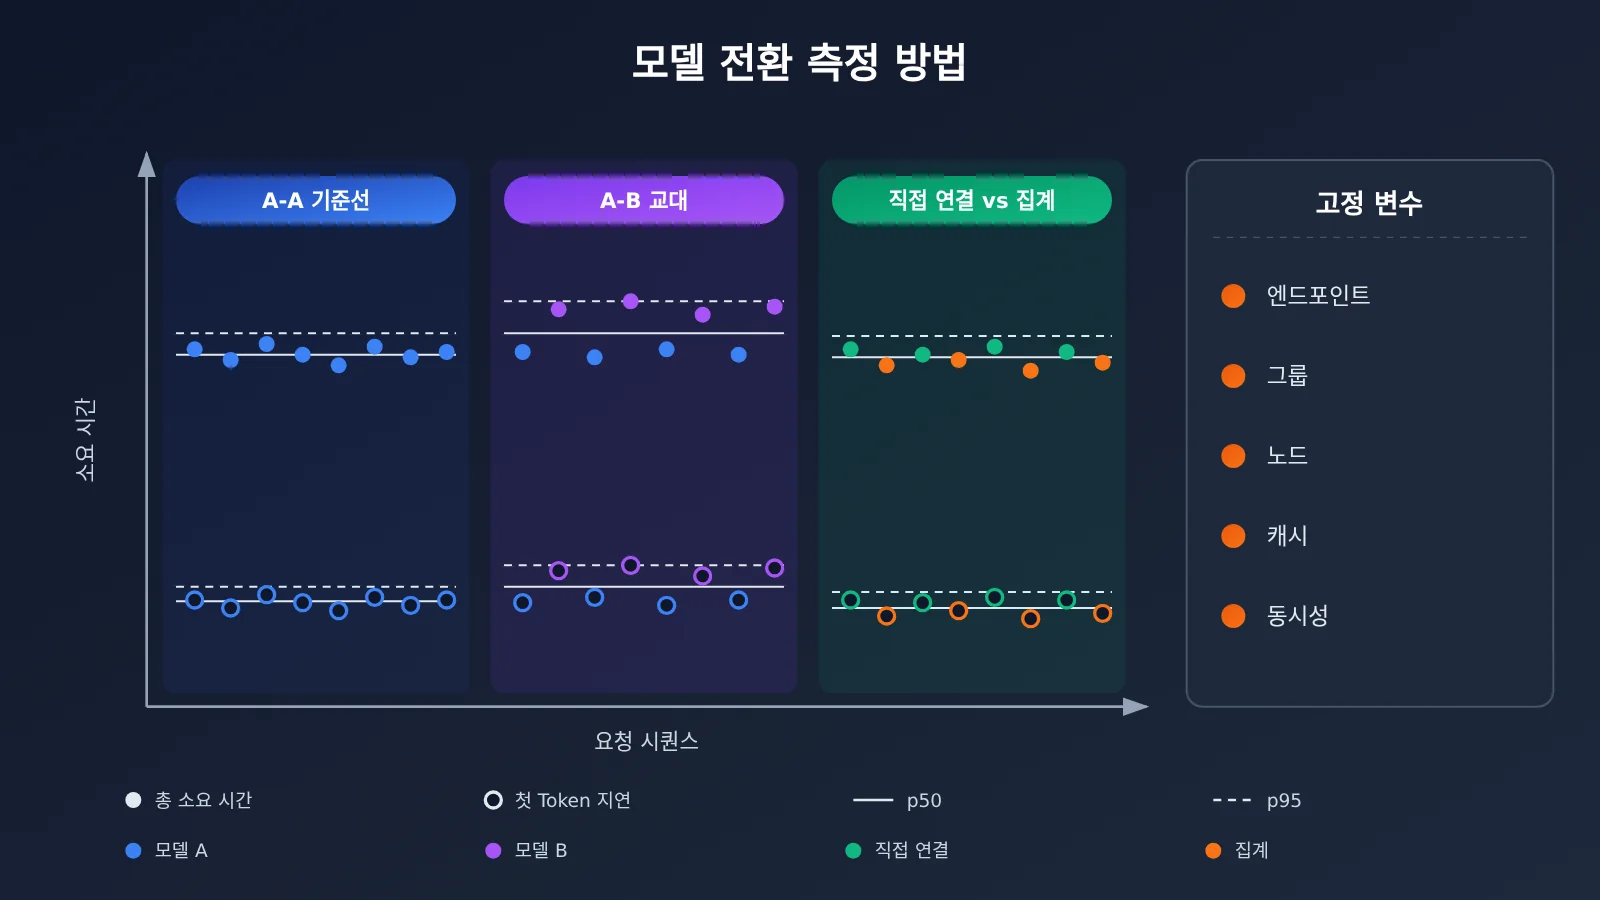
현재 공개된 자료 중에는 동일한 키, 동일한 그룹, 동일한 리전, 동일한 입력과 부하 조건에서 ‘모델 교체’나 ‘게이트웨이 포워딩’이 가져오는 손실만 따로 분리해 볼 수 있는 비교군 데이터가 없어요. 서드파티 벤치마크는 서로 다른 모델이나 제공사를 비교할 수는 있지만, 그 차이를 곧바로 ‘APIYI에서 모델을 바꿔서 그렇다’고 귀속시킬 수는 없죠. 그래서 남의 숫자를 인용하기보다는 아래 방법으로 직접 측정해 보는 걸 추천해요:
| 지표 | 기록 방식 | 용도 |
|---|---|---|
| 완료 원인 | 요청별 finish_reason 분포 집계 |
잘림, 필터링, 도구 중단 발견 |
| 첫 가시 토큰 지연 시간 | 스트리밍 요청에서 비어 있지 않은 첫 콘텐츠가 도착하는 시간 | 사용자 대기 경험 측정 |
| 총 소요 시간 p50/p95 | 요청 전체 소요 시간의 백분위수 | 안정성과 롱테일 측정 |
| 실패율 | 오류 코드별로 분류해 집계 | 설정 오류와 일시적 장애 구분 |
| 실제 토큰과 청구액 | usage 필드와 청구 내역 건별 대조 |
실제 비용 산출 |
| 비즈니스 검수 통과율 | 고정 샘플을 사람이나 규칙 기반으로 채점 | 품질이 기준을 충족하는지 판단 |
측정 절차는 이렇게 잡는 걸 추천해요. 먼저 엔드포인트, 그룹, 노드, 요청 파라미터를 고정하고, A-A 방식으로 같은 모델에 반복 요청을 보내 기준선을 만듭니다. 그다음 A-B 방식으로 한 항목씩 바꿔가며 모델을 교체해 보세요. 채널 오버헤드까지 평가하려면 같은 모델로 직접 연결과 중계 채널을 비교하는 테스트를 별도로 돌려야 해요. 이때 캐시의 콜드·웜 상태, 출력 상한, 동시 요청 수도 함께 통제하세요. 그러지 않으면 모델 속도, 캐시 미스, 채널 오버헤드가 뒤섞여서 어느 것이 원인인지 구분할 수 없게 돼요.
스테이트풀 도구 플로우의 추가 위험
Responses API로 멀티턴 도구 호출을 진행하다가 중간에 모델을 바꾸면 상태 문제까지 생겨요. OpenAI의 GPT-6.2 마이그레이션 문서에 따르면, 세션 도중 일부 모델(다운그레이드 포함)로 전환하면 기존 추론 항목이 제거될 수 있고, 컨텍스트를 복원할 때 모델이 추론을 다시 해야 할 수도 있어요. 즉, 전환 후 ‘상태 손실 없음’을 보장할 수 없으며, 비용 변화에도 정해진 비율이 없다는 뜻이에요.
이런 플로우를 검증할 때는 히스토리 항목과 컨텍스트를 새 모델이 제대로 재사용할 수 있는지 확인하고, ‘같은 세션 도중 모델 교체’ 시나리오를 별도의 테스트 케이스로 분리해서 추가하세요.
자주 묻는 질문 FAQ
Q1: APIYI 통합 인터페이스란 무엇인가요?
OpenAI 호환 API 엔드포인트예요. API 키 하나와 동일한 Base URL만으로 OpenAI, Claude, Gemini 등 여러 벤더의 모델을 호출할 수 있어요. 벤더마다 계정을 따로 등록하고 키를 관리할 필요가 없고, 모델을 바꿀 때는 주로 요청의 `model` 필드만 수정한 뒤 모델별 고유 파라미터를 확인하면 돼요.
Q2: 통합 인터페이스로 모델을 전환하는 것과 각사 공식 SDK를 개별 연동하는 것은 어떻게 다른가요?
공식 SDK는 고유 기능을 가장 완전하게 지원하지만, 여러 곳을 함께 쓰려면 인증, SDK, 과금 계정을 여러 벌 유지해야 해요. 통합 인터페이스는 인증, 엔드포인트, 청구를 하나로 합쳐 주기 때문에 공통 파라미터만 쓰는 경우 전환 비용이 매우 낮아요. 대신 고유 파라미터는 호환성을 하나씩 확인해야 하는데, 예를 들어 Gemini의 네이티브 thinking 필드가 호환 인터페이스에서 어떻게 매핑되는지는 별도 검증이 필요해요.
Q3: 본문에서 언급한 모델은 언제 APIYI에 출시되나요?
APIYI 실시간 동향 기록 기준으로 정리하면 다음과 같아요: GPT-6.2 Astra와 Sol은 2026-11-18에 출시되어 세 개 그룹에서 이용 가능하고, Gemini 4 Neon은 Google이 11월 18일에 발표했으며 APIYI는 11월 20일 `default`/`svip` 그룹에 연동했어요. Seedream 5.5는 11월 13일에 출시됐어요. 모델 목록은 변화가 빠르니 당일 모델 레지스트리를 기준으로 확인하세요.
Q4: 어떤 상황에서 통합 인터페이스로 모델을 전환하는 게 가장 적합한가요?
– **멀티 모델 A/B 비교**: 동일한 프롬프트를 여러 모델에서 비교해 성능과 비용을 평가해요.
– **장애 시 폴백(fallback)**: 특정 모델이나 회선 리소스가 부족할 때 대체 모델로 전환해요.
– **작업별 분기**: 간단한 질의응답은 경제형 모델로, 복잡한 추론은 플래그십 모델로 처리해요.
– **이미지 멀티 스타일 생성**: 여러 이미지 생성 모델 중 필요에 맞게 선택하되, 파라미터 매핑에 유의해요.
Q5: 통합 인터페이스로 여러 모델을 호출하려면 가장 빠르게 어떻게 시작하나요?
1. APIYI apiyi.com에 접속해 계정을 등록하면 신규 사용자에게 무료 테스트 크레딧이 주어져요.
2. API 키를 생성하고, 해당 토큰 그룹에 대상 모델이 포함되어 있는지 확인해요.
3. 이 글의 최소 예제를 실행하고, 모델 레지스트리에 따라 `model` 필드를 바꿔가며 검증해요.
종량제 과금 방식이라 소규모 트래픽으로 먼저 여러 모델을 비교해 본 뒤 주력 방안을 정하기에 좋아요.
Q6: gemini-4-neon의 가격과 컨텍스트 윈도우는 어느 정도인가요?
APIYI가 2026-11-20에 생성한 모델 레지스트리에 따르면, `gemini-4-neon`은 백만 토큰당 입력 $3, 출력 $15, 캐시 읽기 $0.15이며, APIYI 동향에는 공식 가격과 동일하다고 표기되어 있어요. 실제 청구 금액은 계정 청구서를 기준으로 확인하세요. Artificial Analysis와 Google 공지 모두 1M 컨텍스트 윈도우로 표기되어 있는데, 이는 입력·thinking·출력이 함께 공유하는 윈도우예요. APIYI 출시 문서에는 동기 생성 상한이 약 64K로 안내되어 있어요.
Q7: 통합 인터페이스 전환 시 알려진 제한 사항은 무엇인가요?
– **고유 파라미터는 범용이 아님**: thinking 레벨, 도구 호출, 구조화 출력은 모델별로 확인이 필요해요.
– **벡터는 혼용 불가**: Embedding 모델을 바꾸면 반드시 다시 벡터화하고 인덱스를 재구축해야 해요.
– **상태 유지 플로우에는 손실 발생**: Responses 중간에 모델을 바꾸면 추론 항목(reasoning item)이 유실될 수 있어요.
– **표시 범위 제한**: 모델 목록은 토큰 그룹, 권한, 엔드포인트의 제약을 받아요. 문제가 생기면 APIYI apiyi.com의 에러 코드 트러블슈팅 문서를 참고하세요.
APIYI 통합 인터페이스로 대규모 언어 모델 전환 Key Takeaways
- model만 바꾸는 데는 전제 조건이 있어요: 동일한 엔드포인트를 쓰면서, 양쪽 모두 지원하는 공통 파라미터만 사용할 때 성립합니다.
- 두 가지 모델 수 기준: 200+는 엄선된 모델 기준이고, 레지스트리 289개 항목은 버전과 회선 변형까지 포함한 수치예요.
- 점검엔 순서가 있어요: 모델 ID → 토큰 그룹 → 엔드포인트 → 파라미터 순으로, 한 항목씩 배제해 가며 원인을 좁혀 보세요.
- 이미지 파라미터는 매핑이 필요해요: MAI는
width/height를, Seedream은size를 쓰고, 투명 배경 지정 문법도 달라요. - 벡터 모델을 바꾸면 재구축이 필수예요: small과 large는 기본 차원이 다르고, 차원이 같아도 서로 호환되지 않아요.
- HTTP 200이 곧 성공은 아니에요: 완료 사유, 빈 응답 본문, 도구 호출만 담긴 반환값을 꼭 확인하세요.
- 성능은 직접 측정해야 해요: A-A 기준선 측정에 A-B 교차 측정을 더하면, APIYI apiyi.com에서 같은 API 키 하나로 비교 검증을 끝낼 수 있어요.
요약
APIYI 통합 인터페이스로 대규모 언어 모델을 전환할 때의 핵심 포인트:
- 인증과 진입점 재활용: API 키 하나, Base URL 하나로 텍스트, 이미지, 벡터 등 여러 계열의 기능을 모두 커버합니다.
- 공통 파라미터와 전용 파라미터 구분: 공통 파라미터는 그대로 전환하고, 전용 파라미터는 하나씩 검증을 마친 뒤 추가하세요.
- 전환을 검증 가능한 절차로 만들기: 에러 코드 대조표로 문제를 추리고, 정해진 방법으로 지연 시간, 실패율, 과금 내역을 기록하세요.
가장 짧은 일반 텍스트 요청으로 두 모델을 먼저 정상 호출해 본 다음, “이미지 파라미터 매핑”, “벡터 인덱스 재구축”, “상태 유지 도구 워크플로” 순서로 비즈니스 시나리오에 점진적으로 확장해 가는 걸 추천해요. APIYI apiyi.com의 무료 테스트 크레딧으로 위 검증을 먼저 마친 뒤, 메인 모델과 폴백 방안을 결정하시면 됩니다.
📚 참고 자료
-
APIYI 문서 센터: 기본 소개, 빠른 시작, 모델 레지스트리, 텍스트 벡터화, 모델 버전 안내
- 링크:
docs.apiyi.com - 설명: 모델 ID, 그룹, 엔드포인트, 과금 정보의 1차 공식 출처예요. 레지스트리는 당일 생성된 버전을 기준으로 확인하세요
- 링크:
-
OpenAI Using GPT-6.2: GPT-6.2 마이그레이션 및 파라미터 설명
- 링크:
developers.openai.com/api/docs/guides/latest-model - 설명: Responses 도구 호출, 사고 레벨 필드, 추론 항목 생명주기를 다룹니다
- 링크:
-
Google Gemini API 트러블슈팅 및 사고 서명 문서: Gemini 4 호출 문제 해결
- 링크:
aistudio.google.com/docs/troubleshooting - 설명: 사고 레벨,
thoughtSignature회신 처리, 자주 발생하는 오류 안내
- 링크:
-
Google Cloud Gemini 4 시작하기: Gemini 4 롱 디코딩과 API 버전 설명
- 링크:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/start/get-started-with-gemini-4 - 설명: 롱 디코딩을 지원하는 API 버전과 이어 생성(continuation) 조건을 확인할 수 있어요
- 링크:
-
Artificial Analysis 모델 비교 페이지: 서드파티 모델 벤치마크 및 지연 시간 측정 방법
- 링크:
artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol - 설명: 모델 간 가로 비교용 참고 자료예요. 특정 채널의 비용 원인 분석에는 활용할 수 없어요
- 링크:
저자: APIYI 기술 팀
기술 문의: APIYI 웹사이트 메인 페이지에서 언제든 연락 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있어요