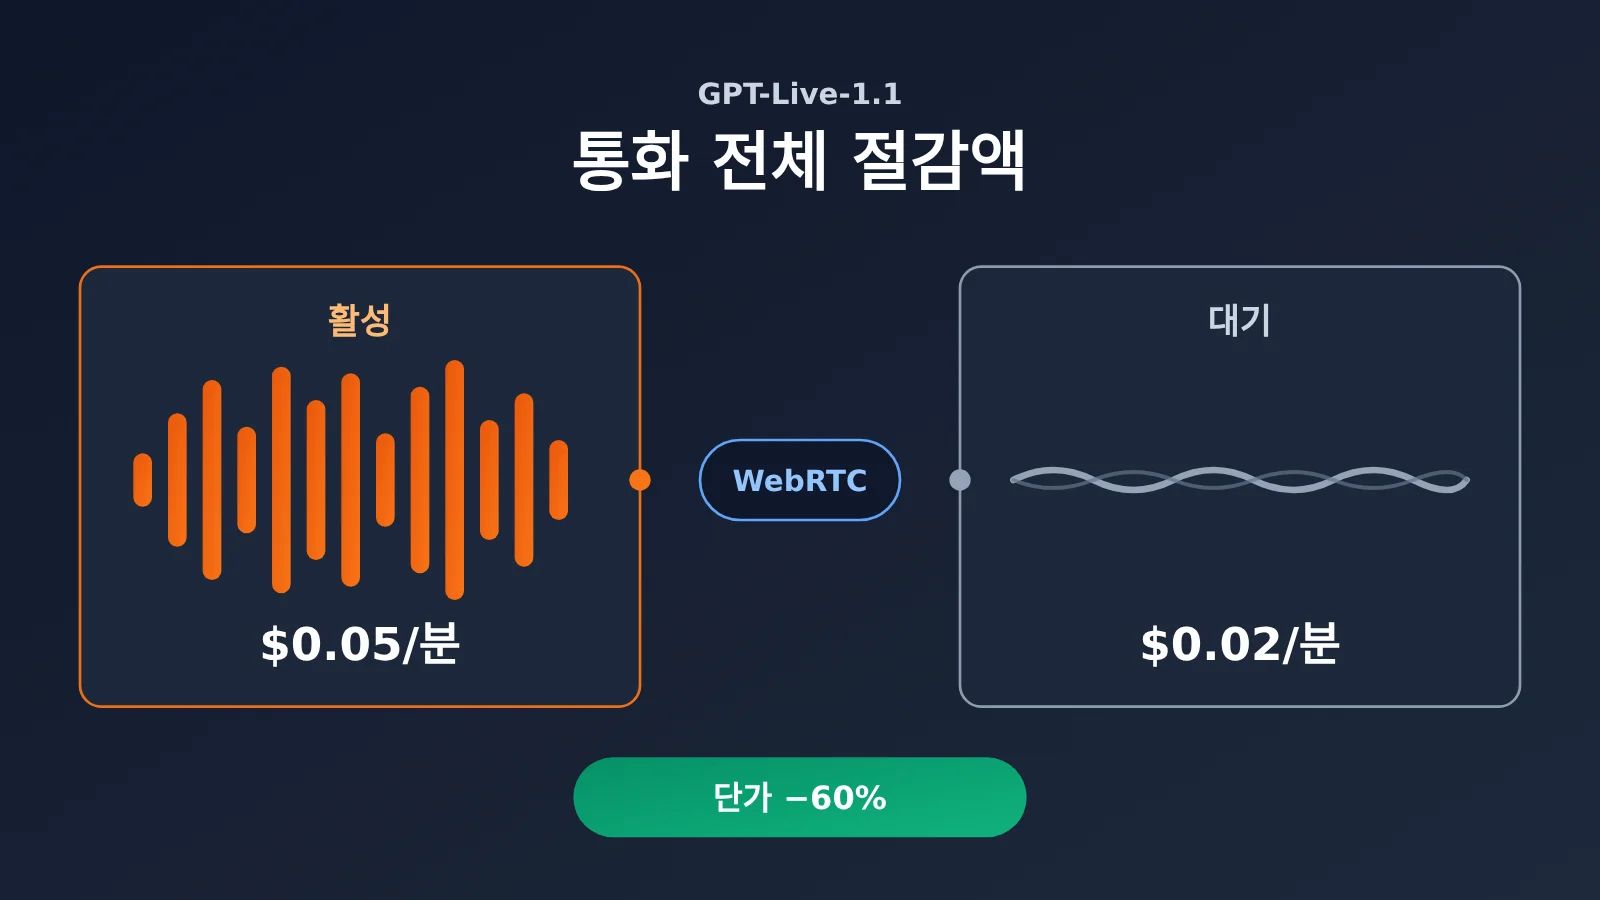
작성자 주: GPT-Live-1.1의 WebRTC 세션이 대기 상태에 들어가면 음성 단가가 분당 0.05달러에서 0.02달러로 내려갑니다. 이 글에서는 설정 방법, 과금 내역을 어떻게 대조할지, 그리고 통화 한 건에서 실제로 얼마나 절약할 수 있는지 설명합니다.
한 줄 요약: GPT-Live-1.1의 WebRTC 세션이 조건을 충족해 대기 상태에 들어가면 음성 단가가 분당 0.05달러에서 0.02달러로 내려갑니다. 실제 절감액은 활성 시간과 대기 시간의 비중, 그리고 백엔드 모델과 도구의 사용량에 따라 달라집니다.
결론에는 전제가 있습니다. 대기 상태가 설정되고 추론이 일시 중지된 WebRTC 세션에서만 분당 0.02달러의 대기 요금을 적용받을 수 있습니다. 이 전제대로라면 절감 비율은 대략 ‘대기 시간 비중 × 60%’와 같습니다. 세션에서 계속 누군가 말하고 있거나 WebSocket 또는 SIP 주 연결을 사용한다면 이 인하는 사실상 적용받기 어렵습니다. 또한 백엔드 추론과 도구 호출은 별도로 과금되며, 긴 통화에서는 이 부분이 음성 요금보다 더 높은 경우가 많습니다.
이 글은 가격표를 그대로 전하는 속보가 아닙니다. 아래에서는 OpenAI 공식 문서를 기준으로 과금 조건과 설정 필드를 풀어보고, 실제 청구 내역과 대조할 수 있는 계산 방법을 제시합니다. 본문에 나오는 시나리오 예시는 모두 가정이며, 계산 방식을 설명하기 위한 것으로 실제 청구서를 의미하지 않습니다.
GPT-Live-1.1 WebRTC 대기 관련 용어 (To Know)
먼저 몇 가지 용어를 통일할게요. 뒤에 나오는 과금과 설정은 모두 이 정의를 기준으로 해요:
- WebRTC: 브라우저와 기기 사이에서 오디오 등 미디어를 실시간으로 전송하는 통신 기술이며, GPT-Live 네이티브 대기에 유일하게 적용되는 전송 방식이에요.
- WebSocket: 지속적인 양방향 연결이에요. 애플리케이션은 이를 통해 오디오, 세션 이벤트 또는 우회 제어 메시지를 전송할 수 있어요.
- SIP: 전화망에서 흔히 사용하는 세션 설정 및 제어 프로토콜이며, GPT-Live의 전화 접속은 이 경로를 사용해요.
- 대기: 이 글에서는 조건을 충족한 WebRTC 세션이 연결을 유지하지만 추론을 중지한 상태의 과금 상태만을 가리켜요.
- 활성 시간: 활성 요율로 과금되는 단계이며, 일시정지 조건에 도달하기 전의 조용한 기간을 포함할 수 있어요.
- 음성 웨이크업: 서비스가 누군가 말하는 것을 감지한 후 추론을 시작하거나 재개하는 것이에요.
- 유휴 임계값: 세션이 얼마나 오랫동안 음성이 없으면 대기 상태로 들어가는지 결정하며, 설정할 수 있어요.
- 우회 연결: 주 음성 연결과 분리되어 서버 제어 및 이벤트 모니터링에 사용되는 연결이며, 일반적인 형태는 sideband WebSocket이에요.
GPT-Live-1.1 WebRTC 대기 핵심 포인트
| 포인트 | 설명 | 개발자에게 주는 가치 |
|---|---|---|
| 두 단계 단가 | 활성 $0.05/분, 조건을 충족하는 WebRTC 대기 $0.02/분 (OpenAI Pricing) | 조용한 시간대 단가 60% 인하 |
| 초 단위 과금 | 두 요율 모두 초 단위로 정산하고, 분 단위로 올림하지 않아요 | 짧은 일시 정지도 절감으로 반영 |
| WebRTC 전용 | 네이티브 저가 대기는 대기를 설정하고 추론이 일시 중지된 WebRTC 세션에만 적용돼요 | 전송 방식을 고를 때부터 비용을 따져봐야 해요 |
| 백엔드 별도 계산 | 백엔드 모델과 도구 사용량은 따로 과금돼요 | 대기는 청구서의 한 항목만 최적화해요 |
| 첫 턴 지연 | 대기에서 깨어난 뒤 짧은 음성의 첫 응답이 더 느릴 수 있어요 | 비용과 경험 사이에서 트레이드오프가 필요해요 |
과금표로 이해하는 GPT-Live-1.1 대기 60%의 분모
먼저 날짜 기준부터 짚어볼게요. OpenAI API Changelog는 이 업데이트를 2026-11-19에 기록했고, OpenAI 개발자 커뮤니티의 출시 공지 페이지는 2026-11-20을 표시해요. 하루 차이라 타임존 기준이 달라서 생긴 결과일 가능성이 커요. 이 글에서 날짜를 언급할 때는 출처를 함께 밝힐게요. OpenAI Pricing 페이지 기준으로 GPT-Live 두 모델의 활성 음성은 모두 $0.05/분이고, 조건을 충족하는 WebRTC 대기는 $0.02/분이며 초 단위로 과금되고, 백엔드 모델과 도구 사용량은 별도로 계산돼요.
「60% 인하」는 흔히 「통화 전체에서 60% 절감」으로 오해되곤 해요. 60%의 분모는 활성 단가예요: (0.05 − 0.02) ÷ 0.05 = 60%, 이는 대기로 전환된 뒤 분당 단가가 얼마나 내려가는지만 설명해요. 통화 전체의 절감률은 여기에 대기 시간 비중을 다시 곱해야 나와요.
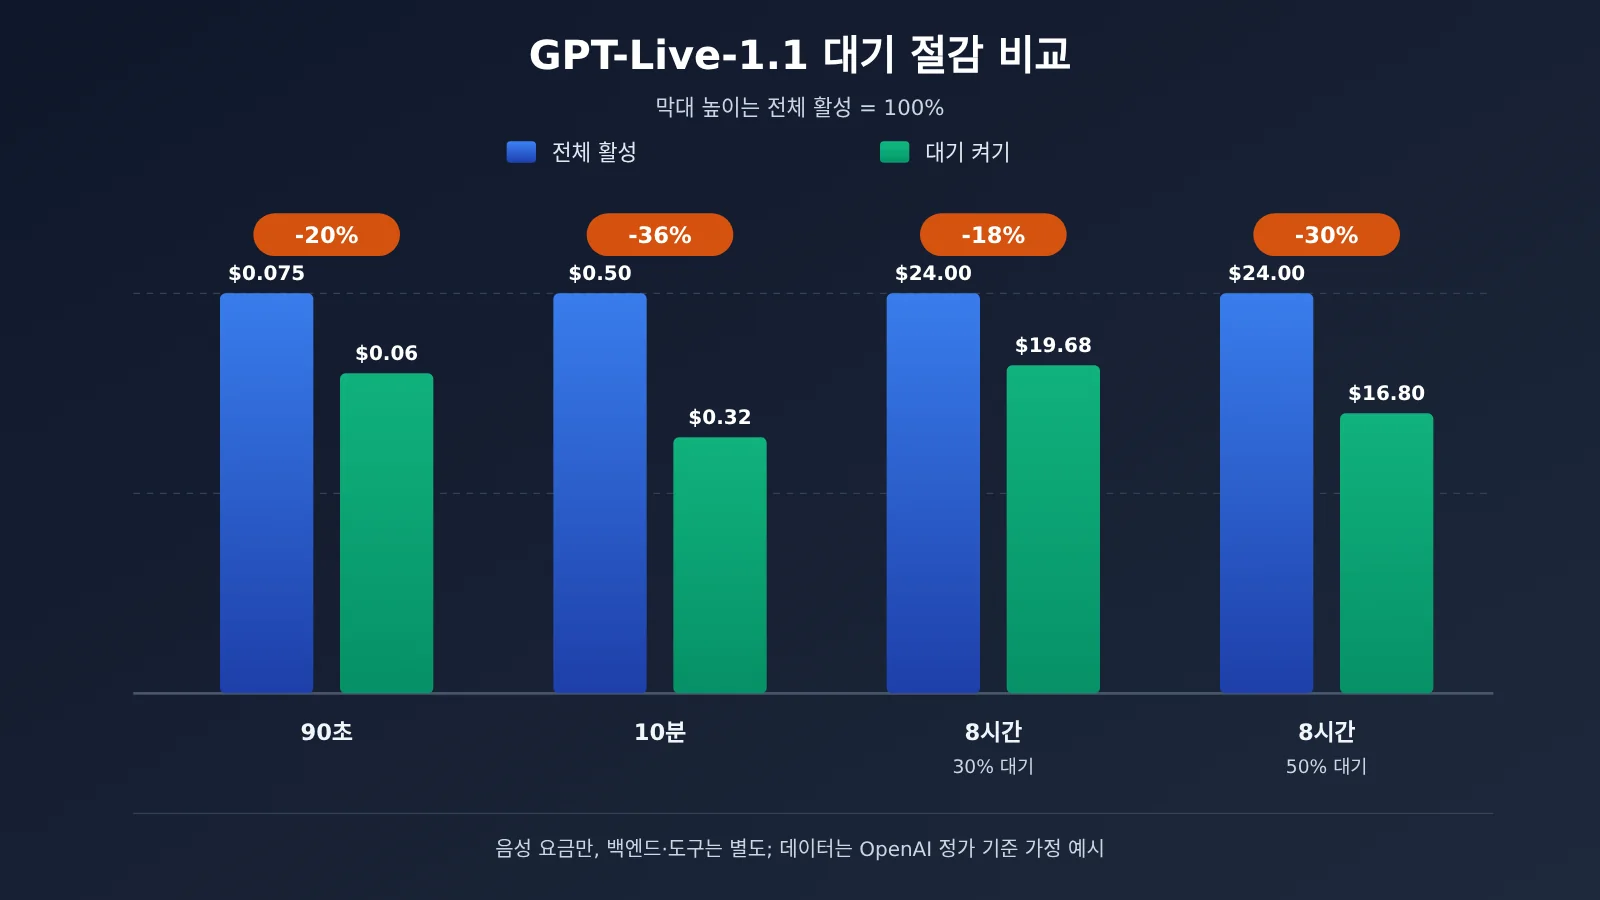
가정 예시를 하나 들어볼게요. 10분짜리 세션에서 과금 시간 중 활성 4분, 대기 6분이면 음성 요금은 4×0.05 + 6×0.02 = $0.32예요. 같은 10분을 내내 활성으로 쓰면 $0.50이고요. 둘을 비교하면 음성 요금은 36% 낮아지는데, 이 값은 정확히 60% × 60%의 대기 비중과 같아요.
| 과금 항목 | 단가(OpenAI 공식 표기가) | 과금 단위 | 대기 영향 여부 |
|---|---|---|---|
| 활성 음성 | $0.05/분 | 초 단위 | 예, 대기 구간으로 일부 대체돼요 |
| WebRTC 대기 음성 | $0.02/분 | 초 단위 | 조건을 충족하는 WebRTC만 |
| 백엔드 모델 토큰 | 선택한 모델 표기가 기준 | 토큰 단위 | 아니오 |
| 도구 호출 | 도구 표기가 기준 | 회당 또는 사용량 기준 | 아니오 |
GPT-Live-1.1 WebRTC 대기 모드 설정: 세션 설정부터 정산 확인까지
OpenAI의 《Managing GPT-Live sessions》 문서를 보면 WebRTC 대기 모드의 설정 항목은 많지 않지만, 각 항목이 과금 단계가 어떻게 나뉘는지에 직접 영향을 줘요.
| 필드 / 이벤트 | 값 또는 의미 | 설정 포인트 |
|---|---|---|
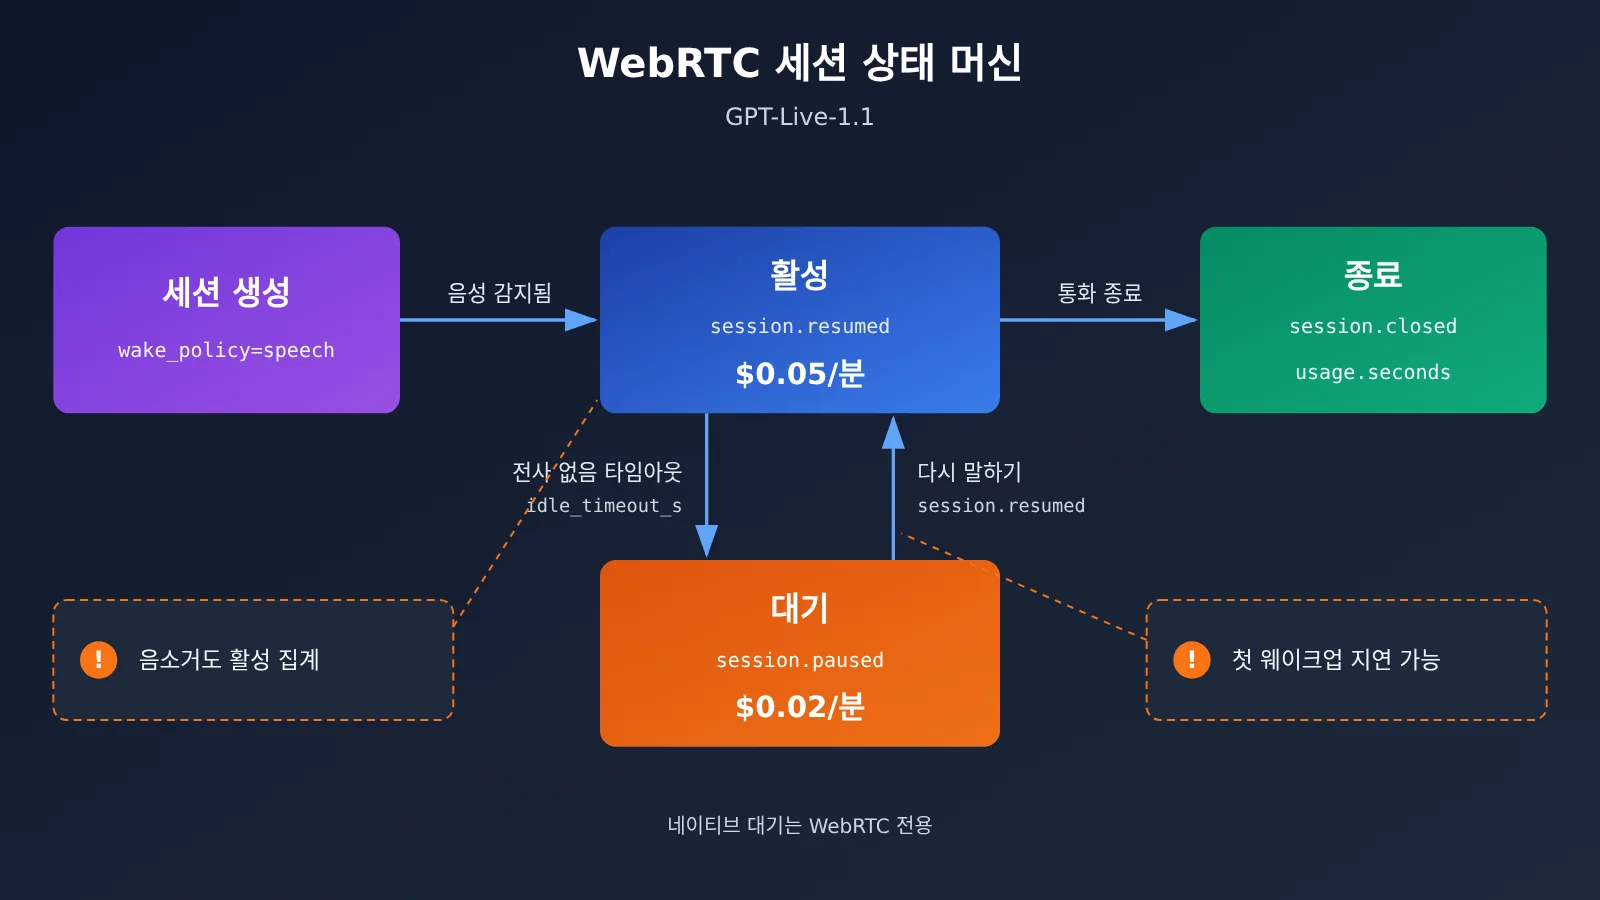
session.wake_policy.type |
"speech"로 설정 |
세션은 음성이 감지된 뒤에야 추론을 시작하며, 연결되자마자 추론하지 않아요 |
session.idle_timeout_s |
5–60 사이의 정수(초) | 설정하지 않으면 최초 웨이크업 후 추론이 계속 활성 상태로 유지돼요 |
session.wake_policy.vad_threshold |
0–1, 기본값 0.5 (서드파티 OrcaRouter의 문서 정리 기준) | 주변이 시끄럽거나 잘못 깨우는 일이 잦을 때 높여요 |
session.paused |
유휴 타임아웃 후 추론 일시정지 | 대기 시작으로 기록돼요 |
session.resumed |
추론 재개 준비 완료, 최초 웨이크업 시에도 트리거됨 | 활성 시작으로 기록돼요 |
session.closed |
세션 종료, 최종 usage.seconds 포함 |
청구서와 대조하는 데 사용해요 |
GPT-Live-1.1 대기 모드 설정의 4단계
- WebRTC 세션 생성 시 음성 웨이크업 켜기:
session.wake_policy.type = "speech"로 설정해요. - 유휴 임계값 설정하기:
session.idle_timeout_s는 5–60 사이의 정수로 지정해요. 임계값이 짧을수록 더 빨리 대기 상태로 들어가지만, 사용자가 잠깐만 멈춰도 일시정지가 걸릴 수 있어요. - 마이크 트랙을 활성 상태로 유지하기: 대기 중에도 마이크 트랙이 살아 있어야 서비스가 음성을 감지해 깨울 수 있어요. 연결과 세션 ID는 그대로 유지되고, 복귀할 때 대화 기록도 함께 이어져요.
- 이벤트를 수신하고 타임스탬프 기록하기:
session.paused와session.resumed로 서버가 지금 어느 단계에 있는지 판단해요.
아래는 세션 설정을 보여주는 예시 조각이에요. 필드 경로는 공식 문서에서 가져왔고, 전체 요청 구조는 OpenAI의 《Create session》을 기준으로 해요.
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
어떤 무음 구간이 여전히 활성 요금으로 정산될까
‘조용한’ 상황 중에서 계산이 가장 틀리기 쉬운 세 가지가 있어요.
- 타임아웃 전 무음 구간: 마지막 발화가 끝난 순간부터
idle_timeout_s가 만료될 때까지 세션은 여전히 활성 상태로 과금돼요. 임계값을 30초로 잡으면, 멈출 때마다 최소 30초는 활성 요금으로 계산돼요. - 마이크 음소거: 사용자가 클라이언트에서 음소거를 눌러도 세션이 대기 상태로 넘어가지는 않고 계속 활성 상태를 유지해요.
- 백엔드 응답 대기: 추론이 일시 중지되지 않은 채 백엔드 모델이나 도구 결과를 기다리는 시간도 활성 단계로 정산돼요.
초기화 비용도 하나 있어요. OrcaRouter가 공식 문서를 정리한 내용에 따르면, POST /v1/live/sessions로 WebRTC 세션을 만들 때 먼저 15초 음성 사용 시간이 청구되고, 세션이 실행을 시작한 뒤 사용 시간 요금에서 차감돼요. 세션을 시험 삼아 자주 만드는 앱이라면 이건 실제로 나가는 비용이에요. 실제 기준은 OpenAI Pricing을 따르세요.
이벤트 시간으로 정산 검증하기
정산을 검증하는 방법은 이벤트 타임스탬프로 각 단계의 길이를 추정한 다음, session.closed에 담긴 최종 usage.seconds와 실제 청구 내역을 비교하는 거예요. 아래는 이벤트 로거를 보여주는 예시예요. 이벤트가 어느 채널(WebRTC 데이터 채널 또는 우회 연결)로 도착하는지는 공식 문서를 기준으로 하세요.
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
테스트할 때는 같은 스크립트, 같은 백엔드, 같은 녹음 파일로 ‘대기 상태 켜기’와 ‘대기 상태 끄기’를 각각 한 번씩 돌리고, 첫 오디오가 돌아온 시간을 따로 기록해서 깨운 뒤 첫 턴이 얼마나 지연되는지 비용을 수치로 확인하세요.
워크플로 관점에서 한 가지 덧붙이자면요. CellCog는 동일 구성 대조 실험 결과를 공개했는데, 먼저 스크립트 회의 560건을 돌리고 120건을 재측정으로 추가했어요. 기존 스크립트는 질문을 일찍 던지는 방식이었고, 구버전은 160개 질문 중 134개를 백엔드로 넘겼으며 1.1 버전은 91개를 넘겨서 약 84% 대 57%였어요. 재측정에서 첫 질문을 10초 이후로 옮기자 두 버전 모두 48/60(80%)이 나왔어요. 이건 단일 팀이 짧은 회의와 특정 프롬프트에서 보인 위임 결과일 뿐이고 대기 비용은 측정하지 않았어요. 그래도 한 가지는 보여줘요. 백엔드로 위임하는 횟수는 스크립트에 따라 달라지지만, 백엔드 비용은 대기 상태의 영향을 받지 않아요.
GPT-Live-1.1의 WebSocket 및 SIP 대기 모드 구현 경계
OpenAI는 WebRTC, WebSocket, 전화 SIP 세 가지 Live 연결 방식을 지원하지만, 네이티브 저가 대기 모드는 WebRTC에만 적용돼요. 여기서 한 가지 구분해야 할 점이 있어요. WebRTC나 SIP 세션에는 제어와 모니터링을 위한 별도의 우회 WebSocket을 추가로 붙일 수 있는데, 이건 “WebSocket으로 메인 오디오를 전달한다”는 것과는 전혀 다른 얘기예요. WebRTC 메인 연결에 우회 WebSocket을 붙여도 여전히 대기 모드를 사용할 수 있어요.
| 메인 오디오 전송 | 네이티브 대기 $0.02 | 공식 권장 유휴 처리 | 비용 주의점 |
|---|---|---|---|
| WebRTC | ✅ 조건 충족 시 적용 | wake_policy + idle_timeout_s | 타임아웃 전 조용한 구간은 활성으로 과금 |
| WebRTC + 우회 WebSocket | ✅ 메인 연결에 적용 | 우회는 제어와 이벤트만 담당 | 우회 자체는 과금 단계를 바꾸지 않음 |
| 메인 WebSocket | ❌ 근거 없음 | 애플리케이션 측에서 유휴 감지 후 종료·재생성 | 세션 재생성에 초기화 비용 발생 |
| SIP 전화 | ❌ 근거 없음 | 세션 종료가 수신 전화에 미치는 영향 먼저 확인 | 통화 유지 기간은 활성 예산으로 계산 |
메인 WebSocket 방식: 애플리케이션 측에서 유휴 상태를 관리하고, 오디오 입출력, 재생 상태, 백엔드의 미완료 작업을 추적해요. 오랜 시간 조용하고 연결 해제가 허용될 때만 session.close를 호출하고 session.closed를 기다려요. 사용자가 돌아오면 세션을 재생성하는데, 저장이 허용되고 기록이 완료된 이전 세션에 fork를 실행하거나, 애플리케이션이 자체 저장한 텍스트 상태에서 컨텍스트를 복원할 수 있어요. 로컬 음성 웨이크업을 활성화했다면 연결 생성 중에 글자가 빠지지 않도록 첫 부분의 오디오를 미리 캐시해야 해요.
SIP 방식: 세션을 종료하면 수신 전화 연결 자체에 영향을 줄 수 있기 때문에, “끊고 다시 연결하기”를 제자리 대기 모드로 볼 수 없어요. 전화를 반드시 유지해야 한다면 애플리케이션이나 전화 시스템에서 대기 스트림을 처리하고, OpenAI의 활성 음성 요금을 예산에 포함시켜야 해요. 또 다른 방법은 자체 미디어 브리지를 구축해서 OpenAI 측에서 실제로 WebRTC 대기 모드를 사용하고 검증하는 거예요. 이상은 모두 전송과 세션 상태 차원의 구현 경계이며, 비 WebRTC 전송도 $0.02 대기 요금을 받을 수 있다는 근거는 전혀 없어요.
통화 한 건, 얼마나 절약될까: GPT-Live-1.1 대기 비용 빠르게 이해하기
아주 간단한 비용 계산
아래 함수는 ‘절감률 = 대기 비중 × 60%’를 코드로 옮긴 것이고, 입력은 초 단위예요:
ACTIVE, STANDBY = 0.05, 0.02  # OpenAI 공식 가격, 달러/분

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10분: 활성 4분 + 대기 6분
print(voice_cost(60, 30))        # 90초: 활성 60초 + 대기 30초
| 가정 시나리오 | 활성 / 대기 | 대기 포함 음성 요금 | 전체 활성 음성 요금 | 음성 요금 절감률 |
|---|---|---|---|---|
| 공식 예시(OrcaRouter 인용) | 60초 / 30초 | $0.06 | $0.075 | 20% |
| 10분 상담(본문 가정) | 4분 / 6분 | $0.32 | $0.50 | 36% |
| 8시간 상시 운영, 대기 30%(OrcaRouter 계산 예시) | 5.6시간 / 2.4시간 | $19.68 | $24.00 | 18% |
| 8시간 상시 운영, 대기 50%(OrcaRouter 계산 예시) | 4시간 / 4시간 | $16.80 | $24.00 | 30% |
표에는 음성 요금만 계산했습니다. 실제 배포에서는 백엔드 모델과 도구 비용이 청구서에서 더 큰 항목인 경우가 많아요. OrcaRouter 글에서는 OpenAI 문서가 먼저 gpt-6-luna를 권장하고, 복잡한 백엔드 작업에는 gpt-6-sol로 바꾸라고 안내한다고 언급합니다. 둘 다 토큰 기준으로 과금돼요. 긴 통화에서는 백엔드 비용이 음성 요금을 완전히 넘어설 수 있어요.
💡 계산 제안: 위 표는 모두 공식 가격으로 추산한 가정이며, 실제 청구서는
usage.seconds와 플랫폼 청구서를 기준으로 해야 해요. 다른 실시간 음성 방안도 함께 검토 중이라면 APIYI apiyi.com의 무료 테스트 크레딧으로 같은 대본에서 토큰 기반 과금 Realtime 모델과 비교해 볼 수 있어요.
GPT-Live-1.1 음성 계층, 백엔드 모델, API 진입점을 따로 선택하기
조회일(2026-11-20) 기준으로, GPT-Live-1.1의 전용 세션 인터페이스와 분당 요금은 모두 OpenAI 공식 정보예요. 서드파티 OrcaRouter의 정리에 따르면 GPT-Live는 Live sessions 엔드포인트로만 연결할 수 있고, Chat Completions, Responses, Realtime 등 다른 엔드포인트는 지원하지 않아요.
APIYI 쪽을 보면, 공개 모델 레지스트리(2026-11-20 15:17, UTC+8 생성, 총 289개 기록)에는 gpt-live-1이나 gpt-live-1.1이 없어요. 동적 아카이브에도 해당 출시 공지가 없어요. 따라서 현재 APIYI가 GPT-Live 시리즈, /v1/live/sessions, 분당 과금을 이미 제공한다고 볼 수 없어요. APIYI가 OpenAI API와 호환된다고 해서 이런 전용 음성 세션까지 지원한다고 추론해서도 안 돼요.
APIYI가 이미 공개한 실시간 음성 옵션은 별도의 Realtime 제품이에요:
| 옵션 | 접속 방식 | 과금 방식 | 대기 / WebRTC / SIP | 사용 가능 플랫폼 |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions, WebRTC / WebSocket / SIP |
활성 $0.05, 대기 $0.02/분, 백엔드 별도 | WebRTC 네이티브 대기 지원 | OpenAI 공식 |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
오디오 입력/출력 $32/$64(백만 오디오 토큰당) | WebRTC, SIP 미개방 | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
오디오 입력/출력 $10/$20(백만 오디오 토큰당) | WebRTC, SIP 미개방 | APIYI |
APIYI Realtime 가격은 자사 문서에서 확인할 수 있어요(페이지에 2026-09-14 대조라고 명시돼 있어요). 과금 기준은 텍스트, 오디오, 이미지 토큰이라, GPT-Live의 분당 과금과 직접 환산할 수 없어요.
APIYI Realtime 초간단 연결 예시
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # 첫 번째 서버 이벤트 출력

asyncio.run(main())
전체 코드 보기: 메인 WebSocket의 애플리케이션 측 유휴 연결 종료
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # APIYI Realtime 진입점
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # 애플리케이션 측 유휴 임계값, 비즈니스에 맞게 조정 가능
pending_backend_tasks = 0  # 애플리케이션이 직접 관리: 백엔드 미완료 작업 수
is_playing = False         # 애플리케이션이 직접 관리: 오디오 재생 중 여부

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # 모든 서버 이벤트를 활동으로 간주

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
이벤트 형식과 쿼리 파라미터는 APIYI 《Realtime 실시간 음성(WebSocket)》 문서를 기준으로 해요. 이렇게 닫았다가 다시 만드는 방식은 애플리케이션 계층에서 유휴 연결을 줄이는 것일 뿐, 공식 저가 대기 요금제와는 대응되지 않아요.
🚀 연동 팁: GPT-Live 네이티브 대기 기능이 필요한 WebRTC 시나리오라면 현재는 OpenAI에 직접 연결하세요. WebSocket으로 실시간 음성 프로토타입을 빠르게 만들고 여러 모델을 한곳에서 관리하고 싶다면, 먼저 APIYI apiyi.com에서
gpt-realtime-2.1-mini로 흐름을 검증한 뒤 비용에 따라 정식 방안을 결정하세요.
자주 묻는 질문 FAQ
Q1: GPT-Live-1.1의 WebRTC 대기(대기 상태)란 무엇인가요?
WebRTC 세션의 과금 상태 중 하나예요. 음성 깨우기와 유휴 임계값을 설정하면, 음성이 없는 구간에는 추론이 멈추지만 연결은 유지되며 분당 $0.02로 과금돼요. 다시 누군가 말을 하면 기존 대화 이력을 그대로 이어받아 추론이 재개돼요.
Q2: 60% 인하면 통화 전체가 60% 싸진다는 뜻인가요?
아니에요. 60%는 대기 단가가 활성 단가 대비 낮아진 폭을 말해요. 통화 전체의 음성 요금 인하폭은 대기 비중에 60%를 곱한 값이에요. 대기가 절반을 차지한다면 음성 요금은 약 30% 절감되는 셈이에요. 백엔드와 도구 비용은 영향을 받지 않아요.
Q3: GPT-Live-1.1은 언제 API에 출시됐나요?
OpenAI API Changelog 항목 날짜는 2026-11-19이고, OpenAI 개발자 커뮤니티 공지 페이지에는 2026-11-20으로 표시되는데, 이 차이는 타임존 기준 차이에서 비롯된 것으로 보여요. GPT-Live-1은 앞서 2026-09-10에 정식 출시됐어요(OrcaRouter 정리 기준).
Q4: 어떤 상황에서 대기를 켜는 게 가장 유리한가요?
– **고객센터 대기열**: 고객이 연결은 유지한 채 오랫동안 말을 하지 않는 경우.
– **차량용 또는 데스크톱 어시스턴트**: 상시 연결 상태에서 간헐적으로 호출되는 경우.
– **장시간 상주 좌석**: 대기 비중이 높을수록 더 많이 절감돼요.
대화가 빽빽한 짧은 세션은 대기 비중이 낮고, 깨우기 이후 첫 턴이 느려지는 비용까지 감당해야 해서 이득이 제한적이에요.
Q5: APIYI를 통해 GPT-Live-1.1을 호출할 수 있나요?
2026-11-20 기준으로 APIYI의 공개 모델 레지스트리에는 GPT-Live 시리즈가 없고, 출시 공지도 없어요. 실시간 음성이 필요하다면 APIYI apiyi.com에 이미 공개된 `gpt-realtime-2.1` / `gpt-realtime-2.1-mini`를 사용할 수 있어요. `/v1/realtime` WebSocket으로 접속하고 오디오 토큰 기준으로 과금돼요. 신규 사용자에게는 무료 테스트 크레딧이 있어서 먼저 검증해볼 수 있어요.
Q6: GPT-Live-1.1 대기에는 어떤 알려진 제한이 있나요?
– WebRTC에만 적용돼요. WebSocket과 SIP 메인 연결에는 $0.02의 근거가 없어요.
– 타임아웃 전의 조용한 구간, 마이크 음소거, 백엔드 응답을 기다리는 시간은 모두 활성으로 과금돼요.
– 깨우기 이후 짧은 발화의 첫 턴 응답이 더 느릴 수 있어요.
– 현재 대기 깨우기와 청구 대조에 대한 서드파티 데이터가 부족하고, Artificial Analysis 리더보드 점수는 GPT-Live-1에만 해당하므로 1.1에 그대로 적용할 수 없어요.
GPT-Live-1.1 WebRTC 대기 모드 핵심 포인트
- 단가: 활성 상태는 분당 $0.05, 조건을 충족한 WebRTC 대기는 분당 $0.02이며, 둘 다 초 단위로 과금돼요.
- 계산 방식: 통화 전체의 음성 요금 인하 폭은 대기 비율에 60%를 곱한 값이지, 고정 60%가 아니에요.
- 설정:
wake_policy.type="speech"와 5–60초 범위의idle_timeout_s를 함께 지정하고, 마이크 트랙은 계속 활성 상태로 유지해요. - 과금 검증: paused/resumed 타임스탬프로 단계별 소요 시간을 추정한 뒤
usage.seconds로 청구서와 대조해요. - 경계: WebSocket과 SIP는 애플리케이션 측에서 닫은 뒤에만 다시 연결할 수 있어서, 저가 대기로는 계산되지 않아요.
- 진입점: GPT-Live는 OpenAI에 직접 연결해야 하고, WebSocket 실시간 음성은 APIYI apiyi.com에서 Realtime 모델로 사용해볼 수 있어요.
요약
GPT-Live-1.1 WebRTC 대기의 핵심 포인트:
- 할인에는 조건이 있어요: 대기를 설정하고 추론이 일시 중지된 WebRTC 세션만 분당 $0.02로 과금돼요.
- 절감은 비율에 달려 있어요: 10분 중 6분을 대기하면 음성 요금이 $0.50에서 $0.32로 떨어져 약 36%를 아껴요.
- 청구서는 전체를 봐야 해요: 백엔드 모델과 도구는 별도로 과금되고, 대기는 그중 한 항목만 최적화해요.
같은 발화 스크립트로 대기를 켜고 끄는 A/B 테스트를 먼저 해보고, 이벤트 시간과 첫 턴 지연을 기록한 다음에 유휴 임계값을 결정하는 걸 권장해요. 아직 여러 실시간 음성 방안을 비교 중이라면 APIYI apiyi.com을 통해 Realtime 프로토타입을 먼저 돌려보고, 무료 사용 한도로 비용과 경험을 비교해보세요.
📚 참고 자료
-
OpenAI API Pricing: GPT-Live 활성 및 대기 요금
- 링크:
developers.openai.com/api/docs/pricing - 설명: $0.05와 $0.02 공식 고지 가격의 출처
- 링크:
-
OpenAI Managing GPT-Live sessions: 대기 설정 및 이벤트 설명
- 링크:
developers.openai.com/api/docs/guides/live-conversations - 설명: wake_policy, idle_timeout_s 및 전송 경계
- 링크:
-
OpenAI API Changelog: GPT-Live-1.1 업데이트 항목
- 링크:
developers.openai.com/api/docs/changelog - 설명: 항목 날짜 2026-11-19
- 링크:
-
CellCog 대조 실험: GPT-Live-1.1 vs GPT-Live-1
- 링크:
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - 설명: 680건 스크립트 회의의 위임 데이터, 대기 비용 제외
- 링크:
-
OrcaRouter 출시 해설: GPT-Live-1.1 대기 과금 분석
- 링크:
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - 설명: 공식 산출 예시 전달 및 8시간 근무 형태 산정
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈페이지에서 문의해 주세요. Realtime 접속 세부 사항은 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.