작성자 주: 30분짜리 소프트웨어 개발 에이전트 작업을 시작으로, 에이전트의 다중 호출에서 일반 입력, 캐시 쓰기, 캐시 읽기, 출력, 도구 왕복에 드는 비용을 나눠 살펴봐요. 세 서비스 제공업체의 캐시 요금도 비교하고, 12회 호출 사례를 통해 어떤 조건에서 캐시가 실제로 비용을 절감하는지 설명해요.
2026년 11월 9일, Google Cloud는 8세대 TPU 시스템인 TPU 8tx와 TPU 8i Max를 발표하고, KV 캐시 전송에 사용하는 TPU Sync도 오픈소스로 공개했어요. ‘에이전트 시대의 메모리 장벽’이 다시 화제가 되면서, 많은 개발자가 자연스럽게 궁금해해요. 기반 기술인 KV 캐시가 점점 빨라지면 내 에이전트 API 비용도 저렴해질까요?
핵심 가치: 이 글을 읽고 나면 에이전트 비용을 계산하는 전체 공식과 세 서비스 제공업체의 캐시 요금 비교표, 바로 적용할 수 있는 비용 최적화 체크리스트를 얻을 수 있어요.
에이전트의 다중 호출 API 비용: 핵심 정보 한눈에 보기
| 항목 | 세부 내용 |
|---|---|
| 배경 사건 | 2026-11-09 Google이 TPU 8tx, TPU 8i Max, TPU Sync를 발표했어요. 에이전트의 메모리와 KV 캐시 병목 현상에 초점을 맞췄어요. |
| 개발자가 궁금해하는 점 | 하드웨어 수준의 최적화가 에이전트 API 청구액 감소로 이어질 수 있을까요? |
| 핵심 결론 | 청구액은 일반 입력, 캐시 쓰기, 캐시 읽기, 출력 토큰, 호출 횟수, 도구 사용 비용에 따라 달라져요. |
| 주요 변수 | 접두부가 안정적으로 유지되는지, 캐시 TTL이 도구 대기 시간을 감당하는지, 이전 대화 맥락이 통제되지 않은 채 늘어나지는 않는지가 중요해요. |
| 영향 범위 | 코딩 에이전트, 긴 문서 처리 에이전트, 다중 에이전트 협업 등 여러 차례 호출하는 상황 |
에이전트가 30분 동안 여러 차례 호출되는 작업은 어떤 모습일까요?
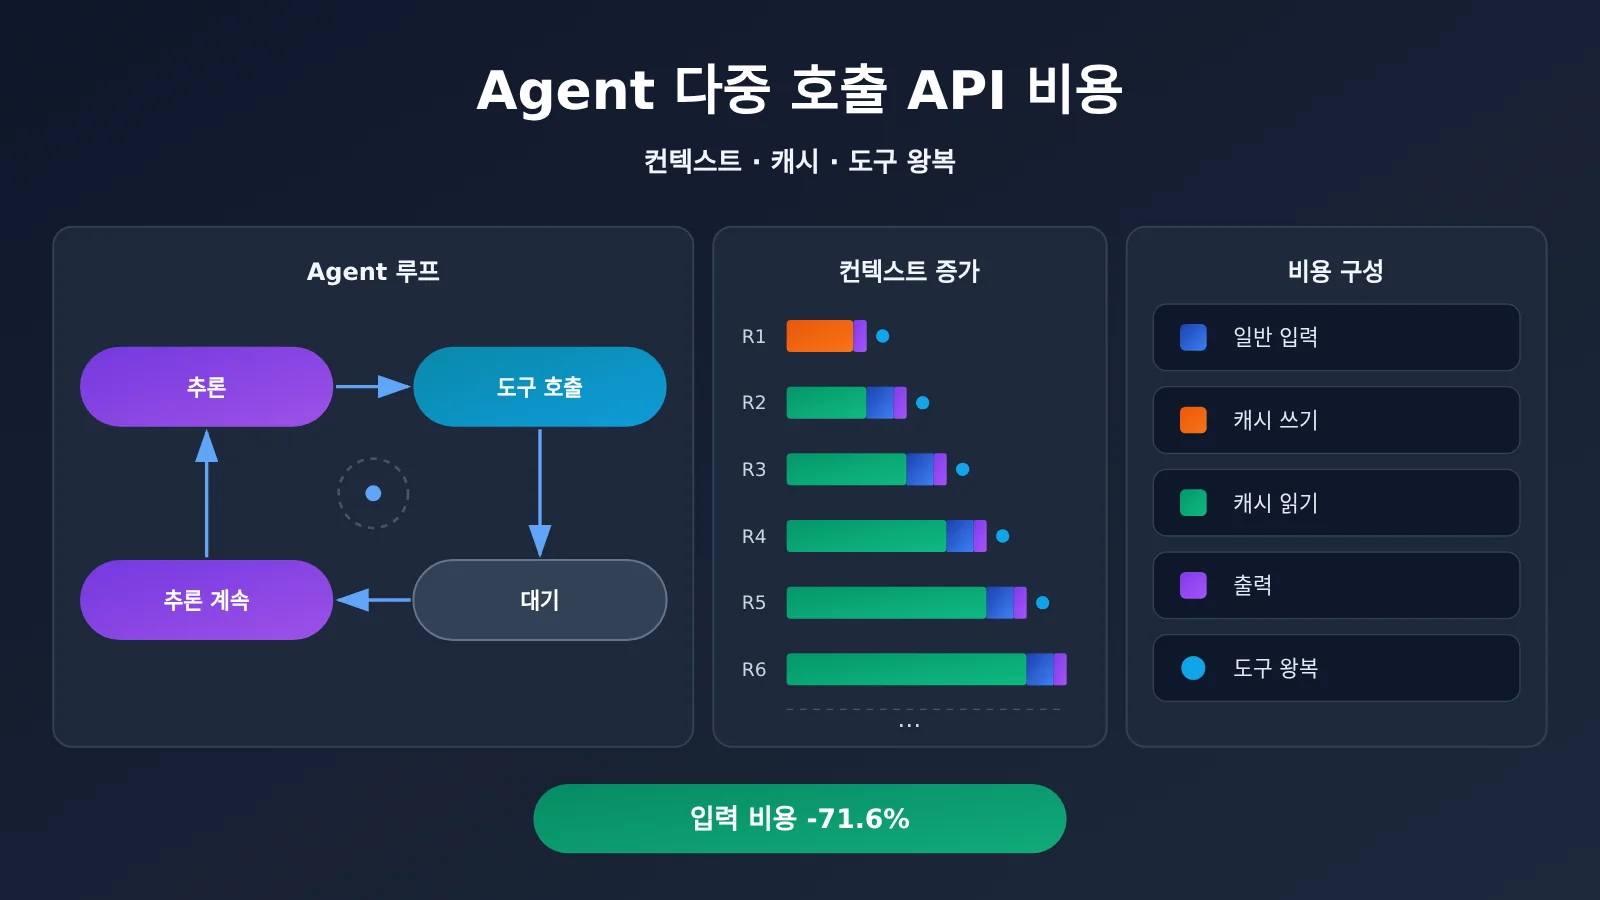
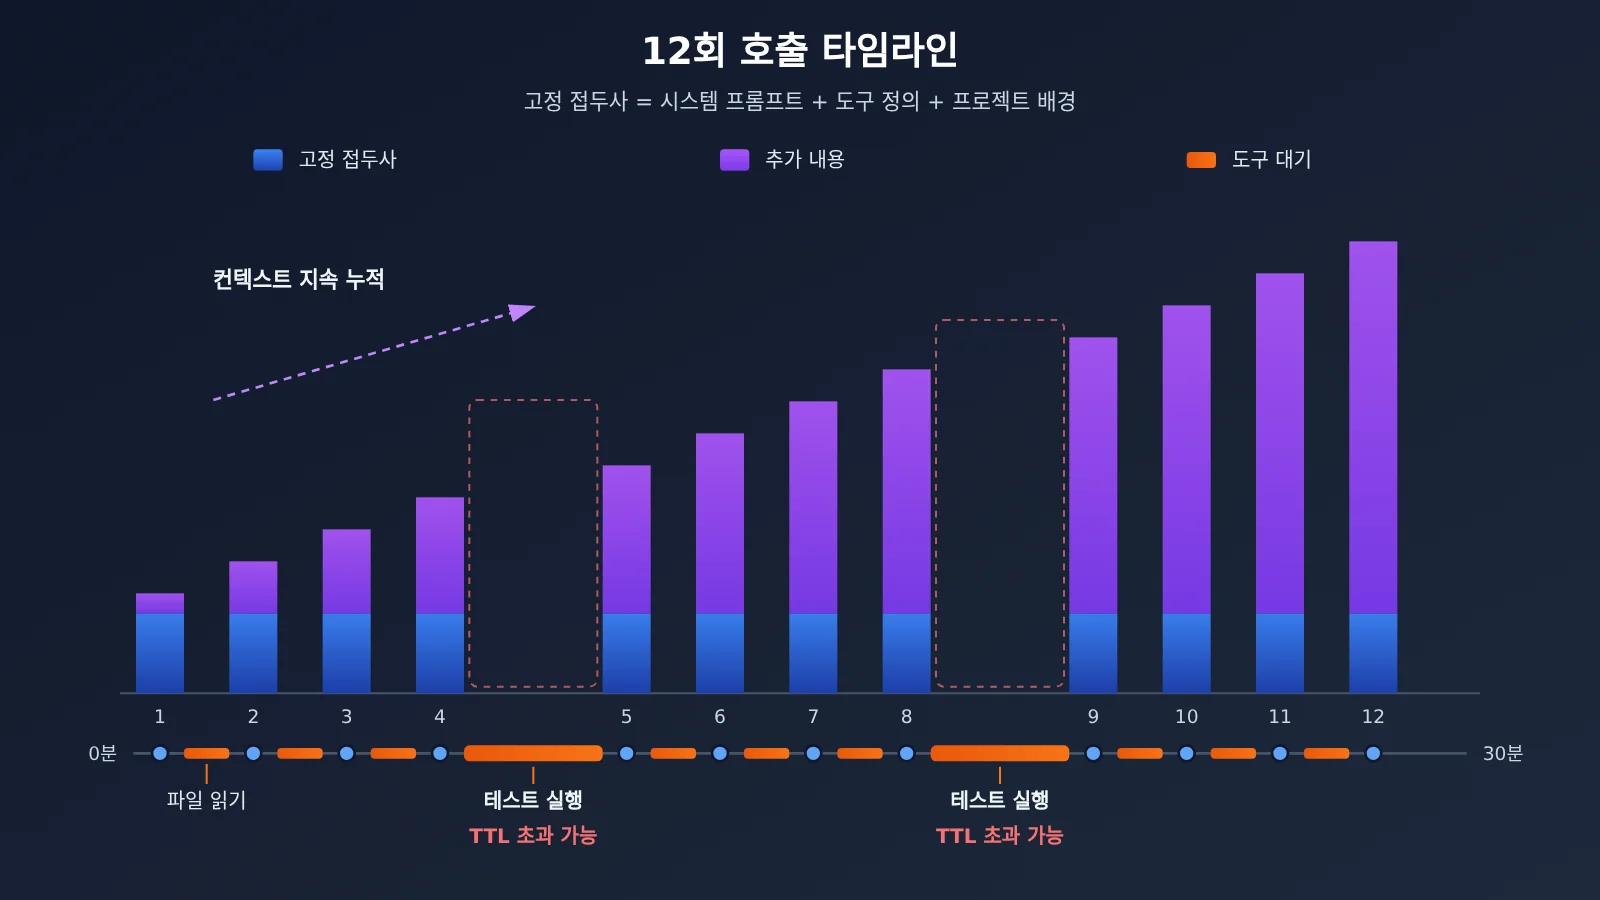
소프트웨어 개발 에이전트가 특정 모듈의 테스트 실패를 수정해 달라는 요청을 받았다고 해볼게요. 에이전트는 먼저 프로젝트 구조와 관련 소스 코드를 살펴보고 수정 계획을 세워요. 그런 다음 도구를 호출해 파일을 수정하고 테스트를 실행한 뒤, 결과를 기다렸다가 오류 내용을 바탕으로 다시 추론하죠. 30분 동안 이런 ‘추론—도구 사용—대기—추론’ 과정이 십여 차례 반복될 수 있어요.
문제는 대규모 언어 모델 API가 기본적으로 상태를 유지하지 않는다는 점이에요. 에이전트는 요청할 때마다 시스템 프롬프트, 도구 정의, 프로젝트 배경, 이전 대화 내용과 도구 출력 결과를 모델에 다시 보내야 해요. 12번째 요청에는 앞선 11차례의 기록이 거의 전부 포함되는 경우가 많아요. 이것이 바로 ‘컨텍스트 중복 계산’이 발생하는 원인이에요.
에이전트의 다중 호출 API 비용은 어떻게 구성될까요?
에이전트 작업을 나눠 보면 비용은 최소 다섯 가지로 구성돼요. 앞의 네 항목은 모델 토큰 비용이고, 다섯 번째는 모델 외부에서 발생하지만 자주 간과되는 비용이에요.
| 비용 항목 | 의미 | 과금 방식 |
|---|---|---|
| 일반 입력 | 캐시에 적중하지 않아 표준 요금이 적용되는 입력 토큰 | 표준 입력 단가 |
| 캐시 쓰기 | 재사용 가능한 캐시를 생성하는 입력 부분 | 일부 서비스 제공업체와 모델은 표준 입력보다 높은 배율로 과금 |
| 캐시 읽기 | 기존 캐시를 적중한 입력 | 보통 표준 입력 단가보다 훨씬 낮음 |
| 출력 토큰 | 도구 호출 매개변수를 포함해 모델이 생성한 내용 | 일반적으로 단가가 가장 높은 항목이며, 캐시로 비용을 낮출 수 없음 |
| 도구 및 외부 실행 | 검색, 코드 실행, 데이터베이스 등 외부 서비스 | 각 서비스의 요금 기준으로 과금되며, 모델 호출 횟수도 늘어남 |
이를 바탕으로 단일 작업의 비용을 다음과 같이 계산할 수 있어요.
작업 총비용 = Σ(일반 입력 × 입력 단가 + 캐시 쓰기 × 쓰기 단가 + 캐시 읽기 × 읽기 단가 + 출력 × 출력 단가)+ 도구 및 외부 실행 비용
수식의 Σ는 작업 중 발생한 모든 모델 호출의 비용을 합산한다는 뜻이에요. 즉, 호출 횟수 자체가 비용을 늘리는 요인이에요. 도구 왕복이 많아질수록 모델 호출도 늘고, 고정된 프리픽스에 비용을 반복해서 지불하게 돼요. 도구 호출은 도구 사용료만 발생시키는 게 아니에요. 한 번의 추론을 여러 단계로 나누기 때문에 매번 컨텍스트를 다시 전달해야 해요.
Agent 다중 호출에서 KV Cache, Prompt Cache, 컨텍스트 압축의 차이
Agent 비용을 논할 때 가장 혼동하기 쉬운 개념이 세 가지예요. 각각 서로 다른 계층에 속하며 청구 금액에 미치는 영향도 완전히 달라요.
| 기술 | 적용 계층 | 구체적인 의미 | API 사용자에게 미치는 영향 |
|---|---|---|---|
| KV Cache | 모델 추론 하위 계층 | 어텐션 계산에서 Key/Value 상태를 저장해 과거 Token을 반복 계산하지 않도록 해요 | 사용자가 직접 제어할 수 없고, 서비스 제공업체의 비용과 지연 시간에 영향을 줘요 |
| Prompt Cache | API 서비스 계층 | 서비스 제공업체가 반복되는 프롬프트 접두부를 재사용하고, 캐시 쓰기와 읽기를 별도로 과금해요 | 청구서의 캐시 항목에 직접 반영돼요 |
| 컨텍스트 압축 | 애플리케이션 계층 | 이전 내용을 요약하거나 선별 또는 잘라낸 뒤 전달해요 | 실제로 전달하는 Token 수를 줄이지만, 세부 정보가 손실될 수 있어요 |
OpenAI 공식 문서에 따르면 Prompt Cache는 원시 Token 텍스트가 아니라 KV Tensor를 실제로 저장해요. 따라서 Prompt Caching은 하위 계층의 KV 상태 재사용 기능을 서비스화하고 과금에 반영한 것으로 이해할 수 있어요. KV Cache와 전혀 관계없는 것은 아니지만, 사용자가 체감할 수 있는 것은 과금 규칙뿐이에요.
컨텍스트 압축은 이와는 다른 개념이에요. 후속 요청에서 ‘무엇을 전달할지’를 바꾸는 것이지, ‘어떻게 재사용할지’를 바꾸는 게 아니에요. 압축을 많이 할수록 Token 수는 줄지만, Agent가 중요한 세부 정보를 잊어버릴 위험도 커져요.
Agent 다중 호출의 하위 계층 최적화가 청구 금액 감소로 이어지지 않는 이유
Google이 이번에 발표한 TPU 8i Max는 HBM 대역폭과 온칩 SRAM을 두 배로 늘렸어요. Ironwood 플랫폼의 내부 테스트에서 TPU Sync는 KV Cache 전송 지연을 90% 넘게 줄였고, Agent Compute Engine은 Agent가 유휴 상태일 때 세션을 일시 중지하고 작업 메모리를 칩 밖으로 옮겨요. 이러한 최적화는 서비스 제공업체의 리소스 활용률과 추론 지연 시간(예: TTFT)에 영향을 줘요. 사용자는 더 빠른 응답을 경험할 수 있죠.
하지만 API 가격은 서비스 제공업체가 정하는 상업적 요금이에요. 사용자의 청구 금액은 여전히 Token을 기준으로 산정돼요. 하드웨어 효율 향상이 장기적으로 요금에 영향을 줄 수는 있지만, 그 효과가 자동으로 같은 비율만큼 사용자에게 전달되지는 않아요. 또한 TPU 8tx와 TPU 8i Max는 2026-11-10 현재도 Coming soon으로 표시되어 있으며, 가격은 아직 공개되지 않았어요. 개발자가 당장 제어할 수 있는 것은 자신의 Token 구성이지, 상위 서비스의 하드웨어가 아니에요.
에이전트 다중 호출 API 비용: 주요 3개 서비스의 캐시 과금 비교
주요 서비스 3곳 모두 캐시 기능을 제공하지만, 캐시 적용 방식과 TTL, 과금 기준에는 뚜렷한 차이가 있어요. 아래 표는 각 서비스의 공식 문서를 바탕으로 정리했으며, 구체적인 내용은 해당 모델과 인터페이스의 안내를 기준으로 확인해 주세요.
| 서비스 | 캐시 방식 | TTL 옵션 | 쓰기 과금 | 읽기 과금 | 사용 가능한 플랫폼 |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, 모델이 자동으로 접두사 캐시를 지원 | 일부 최신 모델은 기본 30분, 일부 모델은 12시간 지원 | 해당 설정을 지원하는 모델 및 인터페이스 기준: 30분은 일반 입력의 1.25배, 12시간은 2.5배. 다른 캐시 방식은 쓰기 비용이 추가되지 않을 수 있음 | 일반적으로 일반 입력의 0.1배이며, 일부 모델은 더 낮음 | 공식 API, APIYI apiyi.com |
| Anthropic | Prompt Caching | 기본 5분, 최대 1시간으로 연장 가능 | 5분은 일반 입력의 1.25배, 1시간은 2배 | 모델에 따라 다름 | 공식 API, APIYI apiyi.com |
| Google Gemini | Context Caching, 암시적 캐시 + 명시적 캐시 | 명시적 캐시는 TTL 설정 가능 | 명시적 캐시는 캐시 토큰 수와 저장 시간에 따라 별도 과금 | 캐시 적중 시 반복 입력 비용 절감 | 공식 API, APIYI apiyi.com |
Claude Sonnet 5.5의 공식 가격을 예로 들면, 일반 입력은 토큰 100만 개당 $2.00, 5분 캐시 쓰기는 $2.50, 1시간 캐시 쓰기는 $4.00, 캐시 읽기는 $0.10이에요. 캐시 읽기 비용은 일반 입력의 5%에 불과해 반복되는 접두사의 비용을 크게 줄일 수 있어요.
다만 OpenAI는 캐시 적중을 매번 보장할 수 없다고 공식적으로 안내하고 있어요. Gemini의 명시적 캐시도 ‘무료 저장’이 아니며, 저장 시간 자체에 비용이 발생해요. 캐시는 조건에 따라 적용되는 할인이지, 기본적으로 자동 적용되는 가격 인하는 아니에요.
🎯 기술 제안: 상위 모델마다 캐시 기능과 과금 규칙, 반환 필드가 다르기 때문에 통합 게이트웨이를 사용해도 모든 모델에 동일한 캐시 할인이 자동 적용되지는 않아요. APIYI apiyi.com에서 동일한 OpenAI 호환 코드로 후보 모델을 각각 테스트하고, 실제 반환된 usage 필드와 청구 내역을 기준으로 확인해 보세요.
Agent 다중 호출 캐시 비용 계산: 12회 호출 사례
앞에서 살펴본 30분 개발 작업에 Claude Sonnet 5.5의 공식 가격을 적용해 예시를 계산해 볼게요. 조건은 다음과 같아요.
- 작업 중 모델을 총 12회 호출하고, 호출당 입력은 22,000 Token이에요.
- 이 중 20,000 Token은 반복되는 시스템 프롬프트, 도구 정의, 프로젝트 배경이에요.
- 매번 새로 추가되는 입력은 2,000 Token이에요.
- 1시간 캐시를 사용하고, 이후 요청은 모두 캐시를 재사용한다고 가정해요.
캐시 미사용: 12 × 22,000 × $2 / 1,000,000 = $0.528
1시간 캐시 사용: 최초 20,000 Token 캐시 쓰기 비용은 $0.080, 최초 일반 입력 2,000 Token 비용은 $0.004예요. 이후 11회의 캐시 읽기 비용은 $0.022, 새 입력 11회의 비용은 $0.044예요. 총 $0.150으로, 입력 비용을 약 71.6% 절감할 수 있어요.
이 예시는 입력 Token만 계산하며 출력 Token, 도구 호출, 외부 서비스 비용은 포함하지 않아요. 실제 Agent에서는 대화가 이어질수록 기록이 누적되지만, 반복되는 컨텍스트가 다중 호출 비용을 키운다는 점은 달라지지 않아요.
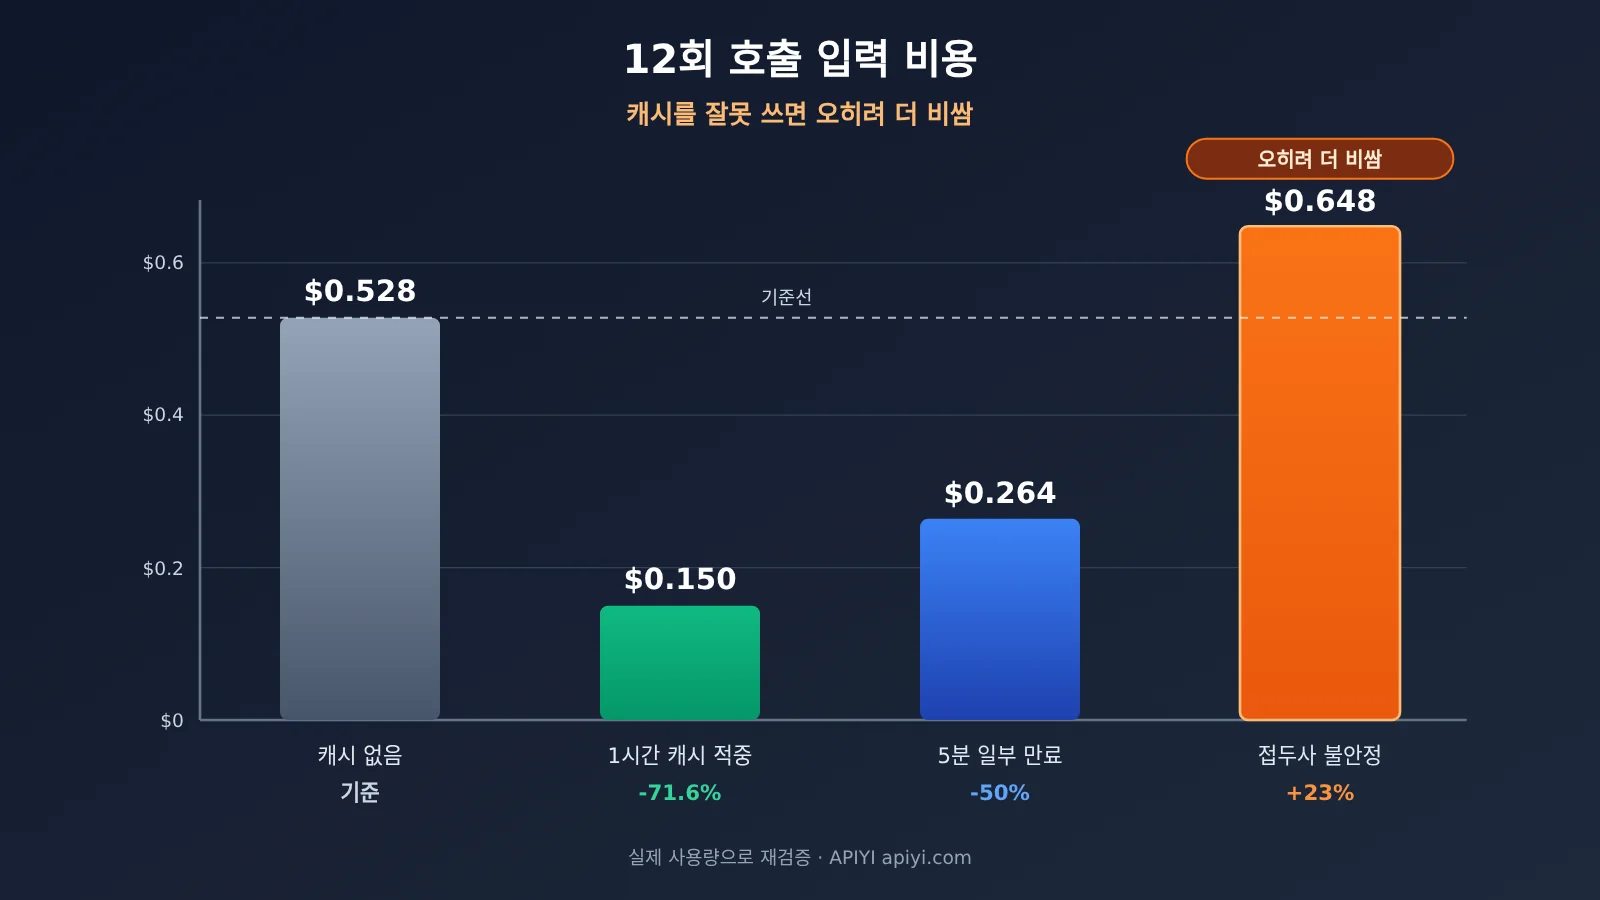
캐시 만료, 접두사 변경, TTL이 Agent 비용에 미치는 영향
위 예시는 이상적인 상황이에요. 같은 가격을 기준으로 자주 발생하는 세 가지 변수를 추가로 계산해 볼게요. 아래는 이 글에서 공식 단가를 적용해 산출한 예시예요.
| 시나리오 | 가정 | 입력 비용 | 캐시 미사용 대비 |
|---|---|---|---|
| 캐시 미사용 | 12회 모두 일반 입력으로 처리 | $0.528 | 기준 |
| 1시간 캐시 적중 | 캐시 1회 쓰기, 11회 읽기 | $0.150 | 약 71.6% 절감 |
| 5분 캐시 적중 | 쓰기 단가 $2.50, 11회 읽기 | $0.120 | 약 77.3% 절감 |
| 5분 캐시 부분 만료 | 도구 대기 시간 초과로 총 4회 쓰기, 8회 읽기 | $0.264 | 약 50% 절감 |
| 접두사 불안정 | 접두사가 매번 바뀌어 12회 모두 5분 캐시 쓰기 비용 발생 | $0.648 | 오히려 약 23% 추가 지출 |
다음 내용을 의사 결정에 참고할 수 있어요.
- TTL은 도구 대기 시간을 고려해 설정하세요: 5분 캐시는 쓰기 비용이 더 저렴하지만, 테스트 실행이나 사람의 확인에 5분 넘게 걸리면 캐시가 만료되어 다시 써야 해요. 그러면 절감 효과가 크게 줄어들어요.
- TTL보다 접두사의 안정성이 더 중요해요: 타임스탬프나 임의 ID를 프롬프트 앞부분에 넣으면 요청마다 캐시가 적중하지 않아요. 쓰기 비용이 더 높은 방식에서는 캐시 때문에 오히려 비용이 늘어날 수 있어요.
- TTL이 길다고 무조건 좋은 건 아니에요: 1시간 캐시의 쓰기 단가는 5분 캐시보다 1.6배 높아요. 호출 간격이 실제로 5분을 넘을 수 있을 때만 유리해요.
에이전트 다중 호출 API 비용을 낮추는 방법
간단한 예시: 호출마다 캐시 적중 기록하기
비용 최적화의 첫 단계는 비용을 ‘파악’하는 거예요. 아래 코드는 OpenAI 호환 인터페이스로 요청을 보내고, usage에서 캐시 관련 필드를 출력해요.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="your-model-name",  # 테스트할 모델로 바꾸세요
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
전체 구현 보기: 안정적인 접두부 + 작업별 비용 추적
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 고정 접두부: 시스템 지침, 도구 정의, 공통 프로젝트 배경을 맨 앞에 두고 바이트 단위로 동일하게 유지합니다
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # 단가: 달러 / 백만 토큰. 사용하는 모델의 공식 가격을 입력하세요
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # 새 메시지만 추가하고 대화 기록은 재정렬하지 않습니다. 타임스탬프 같은 동적 정보는 마지막에 둡니다
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
위 계산은 캐시 읽기 할인만 반영해요. 사용하는 모델이 캐시 쓰기에 별도 요금을 부과한다면, 반환된 필드에 따라 쓰기 비용도 추가해야 해요. 모델마다 usage 필드의 이름과 의미가 다를 수 있으니 실제 응답을 기준으로 확인하세요.
🚀 빠른 시작: 먼저 APIYI apiyi.com의 무료 테스트 크레딧으로 위 추적 스크립트를 실행해 보세요. 같은 작업을 여러 모델에 적용해 캐시 적중률과 작업별 비용을 확인한 뒤, 운영 환경에 사용할 모델과 TTL을 결정하면 돼요.
에이전트 다중 호출 비용을 최적화하는 다섯 가지 방법
- 프롬프트 접두부를 안정적으로 유지하세요: 시스템 지침, 도구 정의, 공통 참고 자료는 앞에 배치하고 타임스탬프와 사용자별 동적 정보는 뒤에 배치하세요. 도구 정의의 순서와 필드도 임의로 변경하지 마세요.
- TTL을 적절히 선택하세요: 호출이 잦고 간격이 짧은 작업에는 짧은 TTL을 사용하세요. 테스트, 빌드 또는 사람의 승인을 기다리느라 에이전트가 오랫동안 멈출 수 있다면, 더 긴 TTL의 쓰기 비용이 불필요한 재작성을 얼마나 줄여 주는지 따져 보세요.
- 과거 컨텍스트를 관리하세요: 내용을 추가만 하고 순서를 바꾸지 않아 캐시 접두부가 깨지지 않도록 하세요. 긴 도구 출력은 요약하고, 핵심 결론과 작업 상태, 필요한 근거는 남겨 두세요.
- 불필요한 모델 호출을 줄이세요: 한꺼번에 실행할 수 있는 도구 작업은 한 번의 호출로 묶고, 정해진 절차는 모델의 판단에 맡기지 말고 코드로 처리해 왕복 횟수를 줄이세요.
- 실제 지표를 모니터링하세요: 작업별 일반 입력, 캐시 쓰기, 캐시 읽기, 출력 토큰, 캐시 적중률, TTFT, 총비용을 기록하세요. 단일 요청 비용이 아니라 작업 단위 비용으로 평가하세요.
에이전트 다중 호출이 API 비용에 미치는 영향
개발자에게 미치는 영향
- 비용 모델을 ‘단일 요청’에서 ‘단일 작업’으로 확장해야 해요: 에이전트 비용은 전체 호출 체인에 따라 달라지므로, 단가만 보면 실제 청구액을 크게 낮게 예상할 수 있어요.
- 프롬프트 엔지니어링에서 과금 구조도 고려해야 해요: 접두부가 안정적이어야 캐시가 작동하므로, 프롬프트 구조 설계도 비용 최적화의 일부가 돼요.
- 여러 모델을 실제로 비교해야 해요: 캐시 할인율, TTL, 쓰기 추가 비용은 모델마다 달라요. 같은 작업도 모델을 바꾸면 비용 차이가 클 수 있어요.
업계에 미치는 영향
- 인프라 경쟁의 초점이 에이전트 부하로 옮겨가고 있어요: Google이 메모리 대역폭, KV 캐시 전송, 에이전트 일시 중지 및 복구를 중점 과제로 삼은 것은 다중 호출과 긴 컨텍스트가 주류 부하 형태가 됐다는 뜻이에요.
- 사용자가 얻는 이점은 지연 시간에서 먼저 나타나요: 하위 계층 최적화는 우선 TTFT와 처리량을 개선해요. 토큰 가격 인하 여부는 서비스 제공업체의 가격 정책에 달려 있으므로, 개발자는 이를 미리 예산에 반영하지 않는 편이 좋아요.
자주 묻는 질문(FAQ)
Q1: 에이전트가 여러 차례 호출할 때 API 비용이 예상보다 높은 이유는 무엇인가요?
API는 상태를 저장하지 않기 때문에 호출할 때마다 시스템 프롬프트, 도구 정의, 이전 대화 내용을 다시 전달해야 해요. 호출 횟수가 늘어날수록 이런 고정된 내용에 비용이 반복해서 부과되고, 도구를 주고받는 과정에서 호출 횟수도 더 늘어날 수 있어요.
Q2: KV Cache와 Prompt Cache는 같은 건가요?
완전히 같지는 않아요. KV Cache는 모델 추론의 하위 단계에서 상태를 재사용하는 기능이에요. Prompt Cache는 API 계층에서 재사용 가능한 프리픽스를 캐싱하고 요금을 부과하는 서비스 제공업체의 기능으로, OpenAI 문서에 따르면 캐시되는 데이터는 KV Tensor예요. 사용자는 요금 규칙을 통해서만 Prompt Cache를 확인할 수 있고, KV Cache를 직접 제어할 수는 없어요.
Q3: Google이 새 TPU를 출시하면 API 가격이 바로 내려가나요?
그렇게 판단할 근거는 없어요. 2026-11-10 기준 TPU 8tx와 TPU 8i Max는 아직 출시 예정이며, 가격도 공개되지 않았어요. 하드웨어 최적화는 주로 서비스 제공업체의 리소스 활용률과 지연 시간을 개선해요. 이러한 효과가 토큰 가격에 반영될지는 각 서비스 제공업체의 가격 정책에 따라 달라져요.
Q4: 캐싱을 사용하면 항상 비용을 절약할 수 있나요?
항상 그런 것은 아니에요. 프리픽스가 매번 달라 캐시가 적중하지 않는데, 사용하는 모드에서 캐시 쓰기에 추가 요금까지 부과한다면 캐시를 사용하지 않을 때보다 비용이 더 커질 수 있어요. 도구 응답을 기다리는 동안 TTL이 만료되면 캐시를 자주 다시 써야 하므로 절감 효과도 줄어들 수 있어요.
Q5: 여러 모델의 캐시 효과를 빠르게 비교하려면 어떻게 해야 하나요?
같은 에이전트 작업을 여러 모델에서 동일한 절차로 실행하고, 캐시 적중률과 작업당 총비용을 기록하는 방법을 권장해요. APIYI apiyi.com에서는 API 키 하나로 OpenAI, Claude, Gemini 등의 모델을 호출할 수 있어요. model 매개변수만 바꾸면 모델별로 비교할 수 있어요.
Q6: 컨텍스트 압축에는 어떤 위험이 있나요?
압축하면 후속 요청에 포함되는 내용이 달라져 중요한 세부 정보가 누락될 수 있어요. 그 결과 에이전트가 같은 실수를 반복하거나 호출 횟수가 오히려 늘어날 수 있어요. 또 압축된 내용을 매번 새로 생성하면 캐시 프리픽스가 깨질 수 있으므로 캐싱 전략과 함께 설계해야 해요.
Q7: 통합 게이트웨이에서 호출할 때 캐시 할인은 모든 모델에 동일하게 적용되나요?
그렇지 않아요. 캐시 기능, 요금 규칙, 반환 필드는 상위 모델에 따라 달라져요. APIYI apiyi.com에서 테스트할 때는 모델별로 캐시 관련 필드와 실제 청구 금액을 확인한 뒤 비용 예산에 반영해야 해요.
Agent 다중 호출 API 비용 핵심 요점
- 비용 단위는 작업이에요: Agent 비용은 단일 요청이 아니라 전체 호출 체인의 누적 비용이에요.
- 반복되는 컨텍스트가 가장 큰 비중을 차지해요: 12회 호출 예시에서 1시간 캐시를 사용하면 입력 비용을 약 71.6% 절감할 수 있어요.
- 캐시 할인에는 조건이 있어요: 프리픽스가 불안정하거나 TTL이 너무 짧으면 절감 효과가 줄거나 오히려 비용이 늘 수 있어요.
- 세 업체의 과금 기준이 달라요: 쓰기 배율, 읽기 할인, 저장 비용은 모델별로 확인해야 해요.
- 하드웨어 최적화가 곧 비용 절감은 아니에요: 하위 계층의 KV 최적화는 우선 지연 시간을 개선하며, 가격은 서비스 제공업체의 정책에 따라 달라져요.
- 먼저 측정한 뒤 최적화하세요: APIYI apiyi.com의 통합 인터페이스로 모델별 캐시 적중률과 작업 비용을 실제로 측정해 보세요.
요약
Agent의 다중 호출 API 비용은 컨텍스트 중복 계산, 캐시 적중, 도구 왕복에 따라 달라져요. 이 세 가지를 함께 살펴봐야 해요.
- 컨텍스트 중복 계산이 기본 비용을 결정해요. 호출 횟수가 늘수록 중복도 많아져요.
- 캐시 적중에 따라 중복 부분의 할인율이 달라져요. 프리픽스 안정성과 TTL이 핵심이에요.
- 도구 왕복은 외부 비용을 발생시키고 모델 호출 횟수도 늘려요.
Google이 인프라 계층에서 KV Cache와 메모리 월 문제에 투자하면 Agent 실행 속도는 빨라질 수 있어요. 하지만 개발자가 당장 제어할 수 있는 것은 자신의 토큰 구조예요. 안정적인 프리픽스, 적절한 TTL, 간결한 기록, 호출 횟수 줄이기, 작업 단위 모니터링의 다섯 가지부터 적용해 보세요. 그리고 APIYI apiyi.com에서 실제 데이터로 각 최적화의 효과를 확인해 보세요.
📚 참고 자료
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: 8세대 TPU 신규 시스템 출시 공지
- 링크:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
설명: 에이전트의 메모리 병목과 KV Cache의 배경을 알아보세요.
-
Google Cloud Blog – Introducing TPU Sync: KV Cache 및 가중치 전송 오픈소스 라이브러리
- 링크:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
설명: 저수준 KV Cache 전송 최적화와 테스트 기준을 알아보세요.
-
OpenAI API 문서 – Prompt Caching: 캐싱 메커니즘과 모범 사례
- 링크:
platform.openai.com/docs/guides/prompt-caching -
설명: 접두사 캐시 규칙, 보존 시간, 모니터링 권장 사항을 확인해 보세요.
-
Anthropic 문서 – Prompt Caching: 캐시 TTL 및 요금 안내
- 링크:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
설명: 5분 및 1시간 캐시의 쓰기·읽기 요금을 확인해 보세요.
-
Google AI for Developers – Context Caching: Gemini의 암시적·명시적 캐싱
- 링크:
ai.google.dev/gemini-api/docs/caching - 설명: 명시적 캐시의 TTL 및 저장 비용을 확인해 보세요.
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지를 방문해 문의해 주세요. 추가 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있습니다.