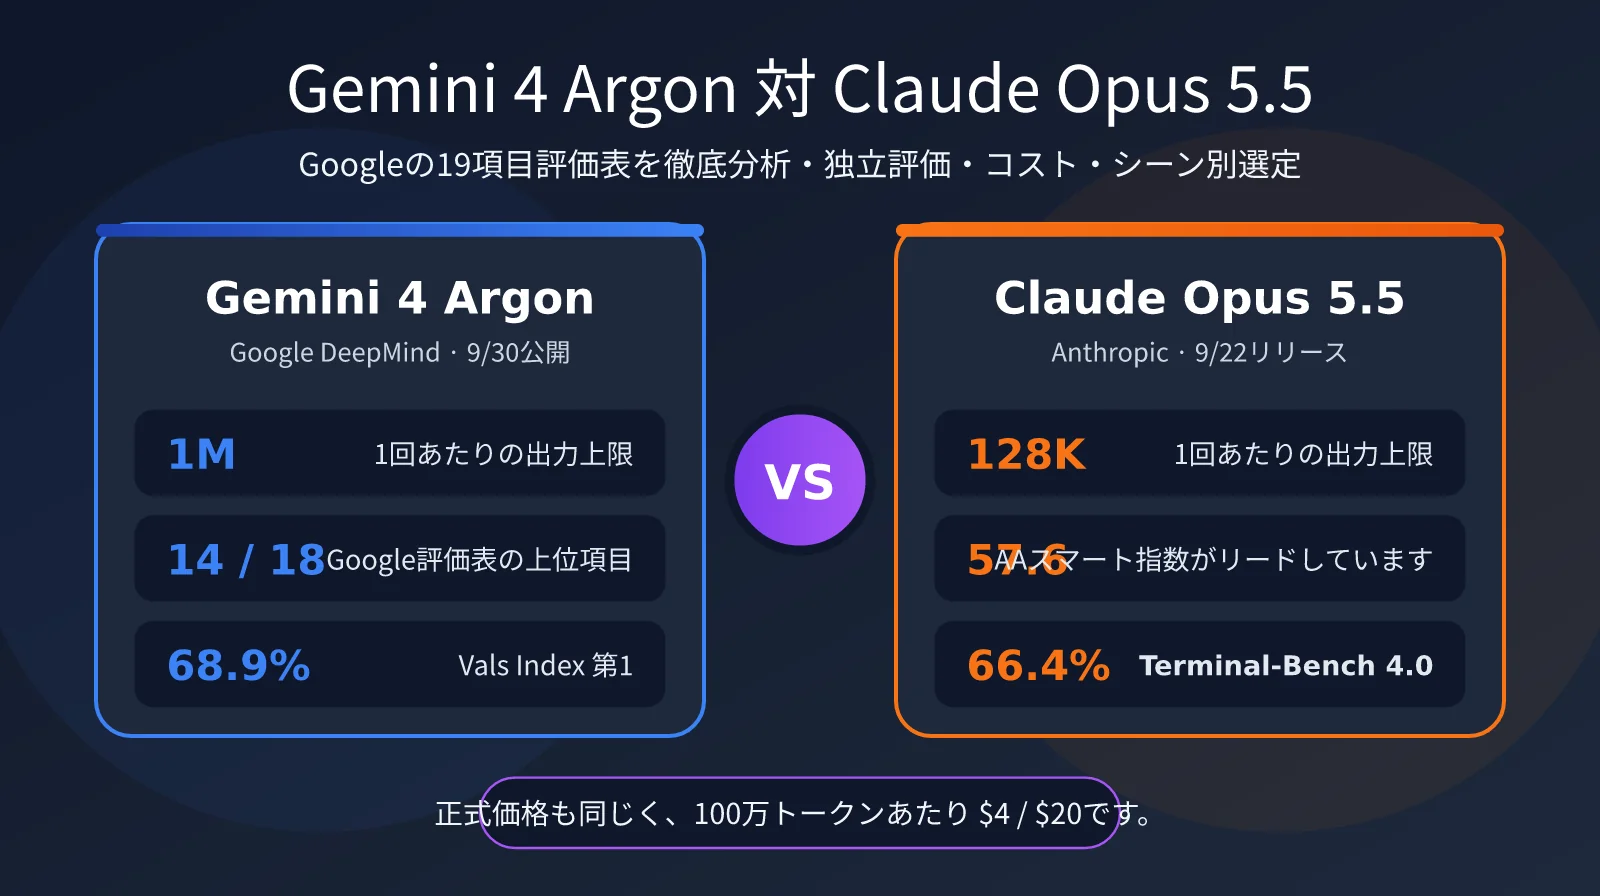
9月下旬から10月初旬にかけて、最先端の大規模言語モデルが相次いでアップデートされました。Anthropicは9月22日にClaude Opus 5.5を発表し、そのわずか8日後にGoogleがGemini 4 Argonをリリースしました。両モデルは、長い推論プロセス、エージェント型のプログラミング、企業のナレッジワークを重視しており、正式価格も入力が100万トークンあたり4ドル、出力が20ドルと同じです。そのため、Gemini 4 ArgonとClaude Opus 5.5のどちらを選ぶべきかは、開発者の間でよく話題に上がっています。
現時点で公開情報は限られています。最も包括的な一次データは、GoogleがArgonの評価ドキュメントで公開した19項目のベンチマーク比較表です。この表にはClaude Opus 5.5も含まれています。本記事ではこの比較表を軸に各項目を詳しく見ていくとともに、Artificial AnalysisやValsなどの第三者による独立評価、価格、出力上限、利用可能性といったエンジニアリング面の要素も取り上げ、2つのモデルがそれぞれどのような用途に適しているかを解説します。
この記事でわかること:Googleの評価表にある数値のうち、どれを参考にでき、どれは割り引いて見るべきかがわかります。また、実際の業務に合わせてGemini 4 ArgonとClaude Opus 5.5を選べるようになります。
Gemini 4 ArgonとClaude Opus 5.5の基本仕様を比較
ベンチマークのスコアを見る前に、まずは両モデルの基本仕様を比べてみましょう。正式価格はまったく同じです。主な違いは、出力上限、利用可能性、お試し価格の3点にあります。
| 比較項目 | Gemini 4 Argon | Claude Opus 5.5 |
|---|---|---|
| リリース日 | 2026年9月30日 | 2026年9月22日 |
| 現在の利用状況 | FairwindプログラムおよびVertex AIで段階的に提供。従量課金APIは全面開放前 | 全面利用可能:Claude API、Bedrock、Vertex AI、Foundry |
| モデルID | 公式未発表 | claude-opus-5-5 |
| 価格(入力/出力) | お試し価格 $2/$10、正式価格 $4/$20 | $4/$20 |
| キャッシュ読み取り | 入力料金から95%割引($0.10〜) | $0.20 |
| Batch一括処理の価格 | 未発表 | $2/$10 |
| コンテキストウィンドウ | 公式未発表(第三者情報では1M) | 1M、長文コンテキストの追加料金なし |
| 1回あたりの出力上限 | 100万トークン | 128Kトークン |
| 推論制御 | Highなどの推論レベル | lowからmaxまでの5段階のeffort、自動調整型の思考 |
仕様を見ると、Argonの最大の強みは100万トークンの出力上限です。Opus 5.5の約8倍にあたり、非常に長いコードの生成や大規模な移行タスクに向いています。一方、Opus 5.5の最大の強みは、今すぐ安定して利用できることです。モデルIDが明確で、主要なクラウドプラットフォームにもすべて対応しています。さらに、Batchでは半額になり、effortを5段階で調整できるなど、実運用に向けた機能もより充実しています。
🎯 選び方のヒント:2つのモデルは正式価格が同じなので、選ぶ際は主にタスクの種類を考慮しましょう。APIYI apiyi.comでは、同じインターフェースからClaude Opus 5.5やGeminiシリーズのモデルを呼び出せます。実際の業務で使うタスクを並べてテストすれば、ベンチマークだけを見るより確かな判断ができます。
Gemini 4 Argon vs Claude Opus 5.5:Googleの評価表を項目ごとに読み解く
以下は、GoogleがArgonの評価ドキュメントで公開した比較データです。ここではArgonとOpus 5.5の2列だけを抜き出し、カテゴリ別に整理しました。なお、これはGoogleが公開したベンダー評価表です。ArgonのスコアはGoogleが自社で測定したもので、Opus 5.5のスコアは大半が公開ランキングやAnthropicのシステムカードに基づいています。一部のベンチマークはGoogleが条件をそろえて再測定しています。
| カテゴリ | ベンチマーク | Gemini 4 Argon | Claude Opus 5.5 | 優位なモデル |
|---|---|---|---|---|
| ナレッジワーク | Vals Index | 68.9% | 67.0% | Argon +1.9 |
| ナレッジワーク | AutomationBench | 51.3% | 42.5% | Argon +8.8 |
| ナレッジワーク | Vals Finance Agent v2 | 65.4% | 58.6% | Argon +6.8 |
| ナレッジワーク | Harvey法律エージェント | 19.6% | 3.8% | Argon +15.8 |
| エージェント型コーディング | DeepSWE v1.1 | 77.9% | 74.2% | Argon +3.7 |
| エージェント型コーディング | FrontierSWE v2 | 55.0% | 62.3% | Opus +7.3 |
| エージェント型コーディング | Vibe Code Bench | 91.9% | 90.3% | Argon +1.6 |
| エージェント型コーディング | Terminal-Bench 4.0 | 57.4% | 66.4% | Opus +9.0 |
| MLエンジニアリング | PostTrainBench | 45.3% | 49.3% | Opus +4.0 |
| 科学・数学 | Terminal-Bench Science 0.1 | 57.6% | 63.3% | Opus +5.7 |
| 科学・数学 | LABBench 2 | 88.8% | 73.1% | Argon +15.7 |
| 科学・数学 | RiemannBench | 76.0% | 69.6% | Argon +6.4 |
| 長文コンテキスト | GraphWalks ≤128K | 99.7% | 90.6% | Argon +9.1 |
| 長文コンテキスト | GraphWalks 256K–1M | 84.2% | 66.8% | Argon +17.4 |
| コンピューター操作 | Agent’s Last Exam | 39.5% | 38.2% | Argon +1.3 |
| マルチモーダル | Chartography | 71.6% | 66.3% | Argon +5.3 |
| マルチモーダル | LVBench 長尺動画 | 91.7% | 83.7% | Argon +8.0 |
| サイバーセキュリティ | CWE-bench v1 | 68.0% | 67.0% | Argon +1.0 |
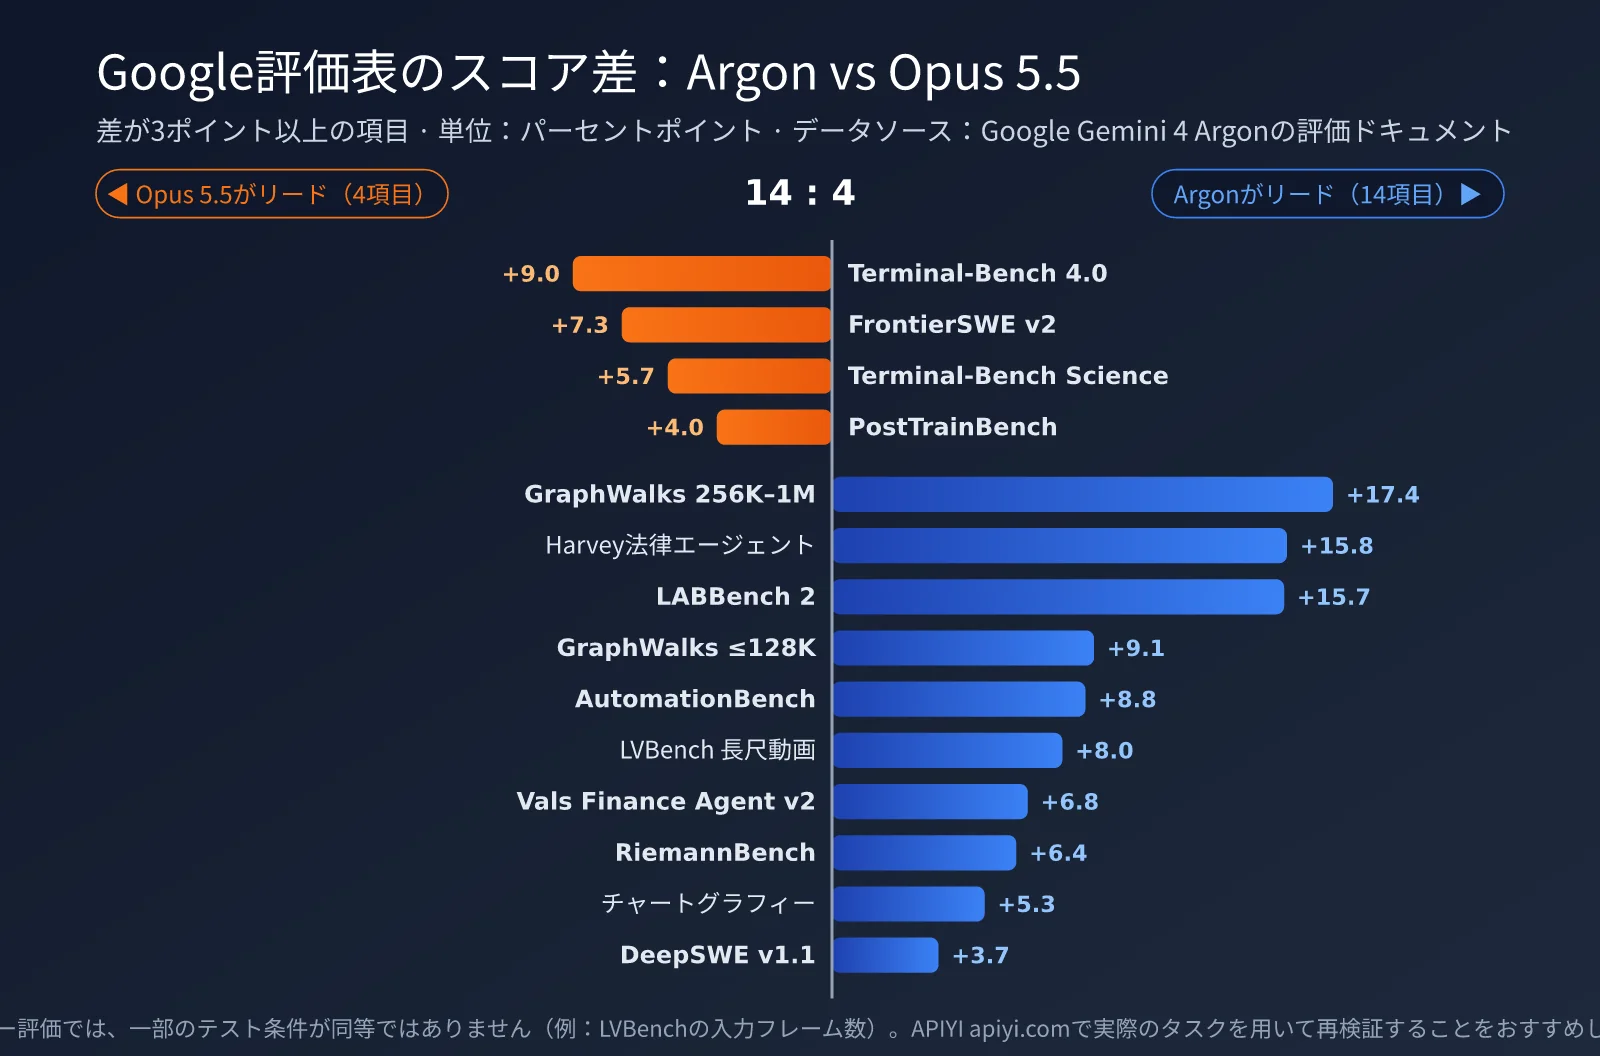
両モデルのスコアがそろっている18項目のうち、Argonは14項目で優位、Opus 5.5は4項目で優位です。Opus 5.5が勝った4項目には共通点があります。FrontierSWE v2、Terminal-Bench 4.0、PostTrainBench、Terminal-Bench Scienceはいずれも、実際のターミナル環境で長時間作業し、コマンドを繰り返し実行するタスクです。一方、Argonが大きくリードしているのは、長文コンテキスト(GraphWalks 256K–1Mで17.4ポイント差)、法律エージェント、生命科学(LABBench 2)です。
Googleの評価表で割り引いて見るべき点
ベンダーが公開する評価表は、どうしても自社モデルに有利な内容になりがちです。この表の脚注にも、注目すべき点がいくつかあります。こうした点を踏まえることで、Gemini 4 ArgonとClaude Opus 5.5のスコア差を正しく読み解けます。
- LVBenchの入力フレーム数が異なる:Argonは動画全体を毎秒1フレームで読み込む一方、Opus 5.5はAPIの制限により600フレームまでしか入力できません。長尺動画でのスコア差は、入力条件がそろっていないことにも一部起因しています。
- Terminal-Bench Scienceではタイムアウトが緩和されている:Argonの検証時のタイムアウトはデフォルト値の6倍に設定されています。それでもArgonはOpus 5.5に5.7ポイント差で負けています。
- DeepSWEのテストフレームワークが異なる:Argonはmini-swe agentフレームワークを使って評価されている一方、ClaudeのスコアはAnthropicのシステムカードから引用されています。両者のテストフレームワークは一致していません。
- Anthropicの公表値と食い違いがある:Anthropicが公表したOpus 5.5のスコアでは、AutomationBenchは40.0%、ツール使用ありのChartographyは89.0%、OSWorld 2.0は81.8%です。一方、Googleの表ではChartographyのスコアは66.3%にとどまり、OSWorldの欄は空欄です。
つまり、テスト条件をそろえると、両者の差は表から受ける印象よりも小さくなります。長文コンテキスト、法律、生命科学の分野におけるArgonの大幅なリードは、比較的信頼性が高いと考えられます。一方、Vals Index、Vibe Code、CWE-benchなど、差が1~2ポイントにとどまる項目は、ほぼ互角と見てよいでしょう。
Gemini 4 Argon vs Claude Opus 5.5:第三者による独立評価の結果
第三者による独立評価の結論は、Googleの評価表とは一致せず、総合知能指数では正反対の結果になっています。以下の表に、Artificial Analysis(AA)とValsが公開しているデータをまとめました。
| 独立評価項目 | Gemini 4 Argon | Claude Opus 5.5 | 優位なモデル |
|---|---|---|---|
| AA Intelligence Index v4.3 | 52.6 | 57.6 | Opus +5.0 |
| Vals Index 順位 | 68.90%(1位) | 66.97%(3位) | Argon +1.9 |
| AA Terminal-Bench 4.0 | 57.1% | 59.6% | Opus +2.5 |
| AA Humanity’s Last Exam | 57.1% | 61.4% | Opus +4.3 |
| AA SciCode | 61.8% | 66.9% | Opus +5.1 |
| AA 長文脈推論 | 79.7% | 84.7% | Opus +5.0 |
| AA GDPval(Elo) | 1611 | 1846 | Opus +235 |
| AA AutomationBench | 77.5% | 69.5% | Argon +8.0 |
| AA 出力速度 | 48.9 token/s | 92.2 token/s | Opusが約1.9倍高速 |
AAのテストでは、Opus 5.5が推論、科学プログラミング、長文脈推論、GDPvalの職業タスクで全般的に優位です。Argonが明確に上回ったのは、業務自動化を測るAutomationBenchのみでした。ただし、AAの比較条件は完全に公平とはいえません。ArgonはHigh設定のみで評価されたのに対し、Opus 5.5は適応型推論を使うMax設定で評価されています。そのため、差の一部はモデルの能力差ではなく、推論強度の設定による可能性があります。
一方、Vals Indexでは、41モデル中Argonが1位、Opus 5.5が3位でした。ただし、両者の差は標準誤差約1.5個分です。Argonがやや優勢ではあるものの、その優位性は確実とはいえません。総合すると、Gemini 4 ArgonとClaude Opus 5.5は、総合能力で同じクラスにあり、どちらか一方が他方を圧倒しているわけではありません。
💡 評価のポイント:評価機関によって結論が逆になることもあります。最終的には、自分のデータで確かめるのが一番です。APIYI(apiyi.com)では、共通のインターフェースを通じてClaude、Gemini、GPTなどの各シリーズのモデルを切り替えられるため、小規模な評価セットをすばやく構築するのに便利です。
Gemini 4 Argon vs Claude Opus 5.5:主な違いを解説
スコアはいったん脇に置いて、2つのモデルの設計思想の違いを見てみましょう。ベンチマークごとの点差よりも、こうした違いのほうがモデル選びの参考になります。
長い工程を要するタスクへの2つのアプローチ
Gemini 4 Argonのアプローチは、1回の出力で生成できる量を大きくすることです。出力上限が100万トークンのため、1回のリクエストで数十万行のコードや非常に長いレポートを続けて生成できます。Google社内では、Fuchsia Zirconカーネルの80万行を超えるC/C++コードのRustへの移行や、libgav1に含まれる3万2,000行のSIMDコードの置き換えなどに活用されました。この設計により、タスクの分割やコンテキストのつなぎ合わせを減らせます。特に「一度に大量の成果物を作る」用途に向いています。
Claude Opus 5.5のアプローチは、推論プロセスをより細かく制御できるようにすることです。超大容量の出力を追求するのではなく、lowからmaxまでの5段階のeffortと、常時有効な適応型思考を備えています。開発者はタスクの難易度に応じて、推論の深さとコストを調整できます。Claude Codeなどのエージェントフレームワークと組み合わせると、複数回のツール呼び出しを通じて、実行、観察、修正を繰り返すタスクを得意とします。Terminal-Benchのような、ターミナル上での操作を伴うタスクで明確に優位に立つのもそのためです。
速度、レイテンシ、安定性
Artificial Analysisのテストによると、Opus 5.5の出力速度は約92 token/sで、Argonの48.9 token/sのおよそ2倍です。リアルタイム性が求められるプログラミングアシスタントやカスタマーサポート用エージェントでは、この差がユーザー体験にそのまま表れます。一方、Argonは1回のリクエストでより多くの作業を完了できるため、リアルタイム性よりも1タスクあたりの規模が重視されるバックグラウンド処理に向いています。
また、Opus 5.5は複数のクラウドプラットフォームで数週間にわたって安定稼働しており、クォータ、レート制限、エラー処理に関するドキュメントも整っています。Argonはまだ提供拡大の初期段階で、クォータやレート制限の方針は明確になっていません。SLA要件の厳しい本番システムでは、この点もベンチマークスコアと同じくらい重視すべきです。
安全性とプロンプトインジェクション対策
両社とも、エージェントの安全性を重視しています。Googleは、Argonが同社のモデルの中で間接的なプロンプトインジェクションに対する耐性が最も高く、Gray Swan IPIベンチマークで優位に立ったとしていますが、具体的なスコアは公開していません。一方、第三者のセキュリティ企業による分析では、Opus 5.5は同じベンチマークでClaude Fable 5.1と並び、インジェクション成功率が最も低い結果でした。つまり、両モデルともプロンプトインジェクション対策ではトップクラスにあり、どちらも優位性を主張できる状況です。
外部のWebページ、メール、ドキュメントを読み込むエージェントで使う場合は、どちらのモデルを選ぶにしても、モデルだけに頼るべきではありません。ツールの権限を適切に分離し、人による確認の仕組みを設ける必要があります。
Gemini 4 Argon vs Claude Opus 5.5のコスト比較
両モデルの正式価格は同じですが、同じタスクでも消費するトークン数が異なるため、実際のコストには大きな差が出ます。以下は、第三者機関が実測したタスクあたりのコストです。
| コストの基準 | Gemini 4 Argon | Claude Opus 5.5 | 差 |
|---|---|---|---|
| AAのタスクあたり平均コスト | $1.99(お試し価格) | $5.98 | Argonは約3分の1 |
| AAの指数全体を実行した場合の総コスト | $2,407 | $8,708 | Argonは約28% |
| Valsの1回あたりのテストコスト | $15.68 | $32.14 | Argonは約49% |
| 正式価格に換算したAAのタスクあたりコスト | 約$3.98 | $5.98 | Argonは約3分の1安い |
| Batchによる一括処理 | 未発表 | 半額の$2/$10 | Opusは一括処理の割引が確定 |
正式価格の$4/$20に換算しても、AAのテストにおけるArgonのタスクあたりコストは、Opus 5.5より約3分の1安くなります。理由の一つとして、Max設定ではOpus 5.5の推論に時間がかかることが挙げられます。Opus 5.5のeffortをmediumまたはhighに設定すれば、コストを大幅に抑えられます。これも、Opus 5.5で5段階のeffortを調整できる実用上のメリットです。また、オフラインのバッチ処理では、Opus 5.5は半額のBatchを確実に利用できます。バッチ価格がまだ発表されていないArgonと比べ、コストを見積もりやすい点も利点です。
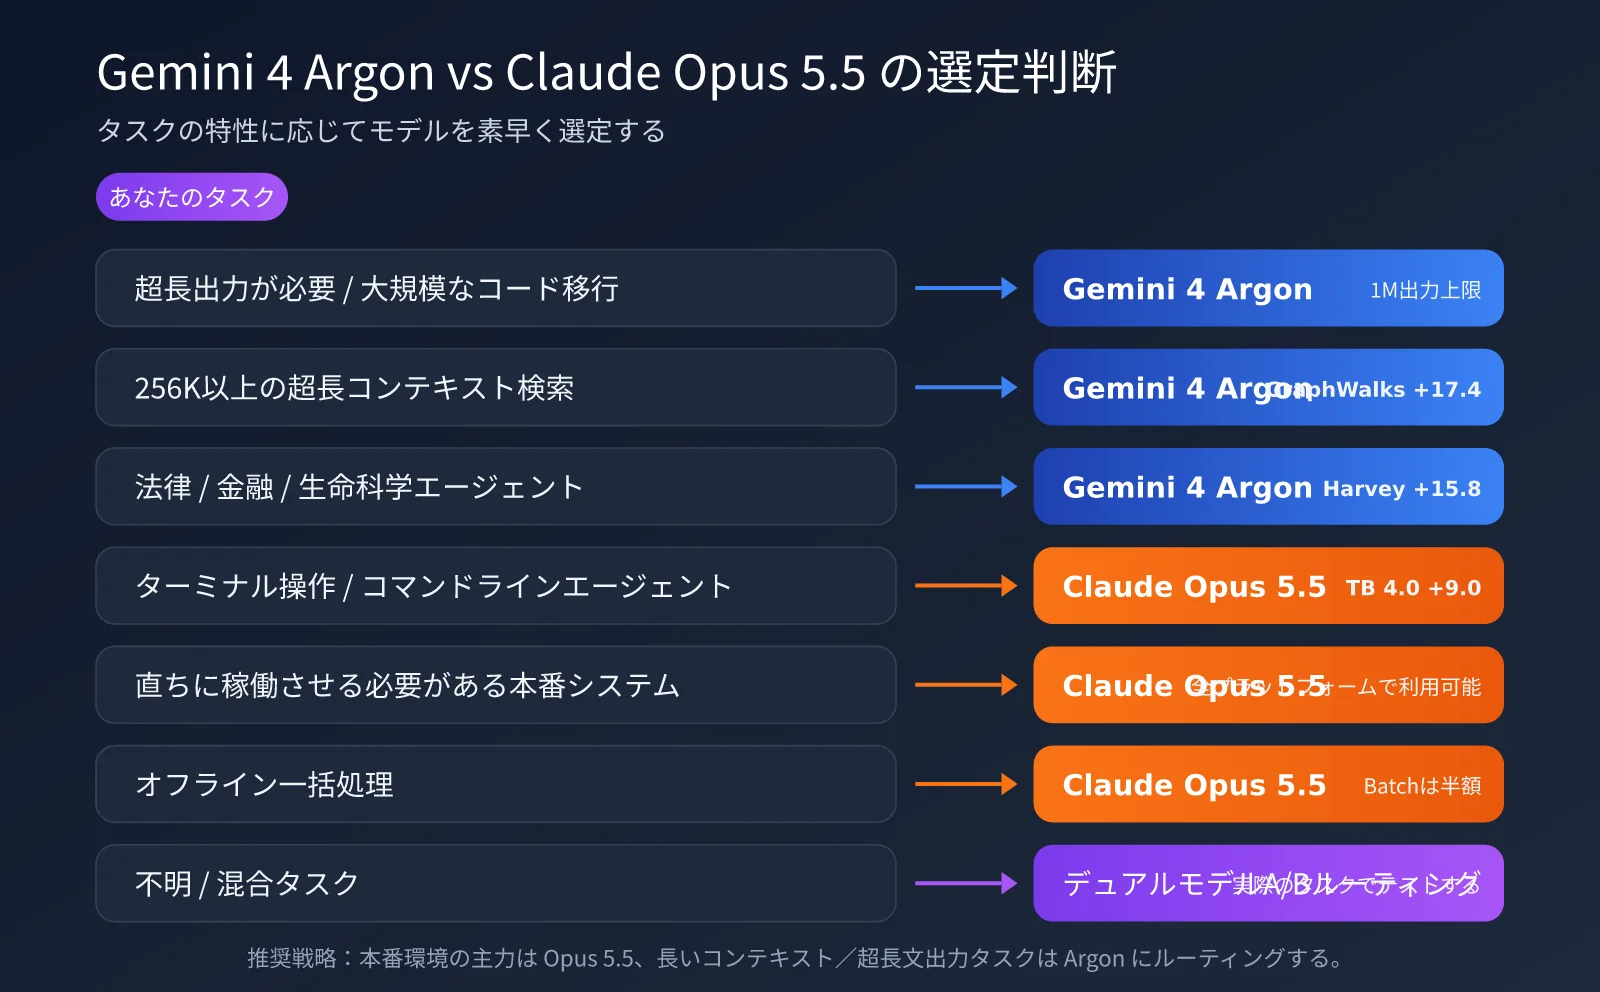
Gemini 4 Argon vs Claude Opus 5.5:用途別のおすすめと選び方
Googleの評価表、独立評価、コスト、利用可能性を踏まえると、タスクに応じて次のように選べます。
| 用途 | おすすめモデル | 主な理由 |
|---|---|---|
| 大規模なコード移行/超長文のコード生成 | Gemini 4 Argon | 出力上限が1M、DeepSWEで3.7ポイント上回る |
| 256Kを超える長文コンテキストの検索 | Gemini 4 Argon | GraphWalksの256K~1Mで17.4ポイント上回る |
| 法律・金融分野の専門Agent | Gemini 4 Argon | Harveyで15.8ポイント、Finance Agentで6.8ポイント上回る |
| 長尺動画や図表の理解 | Gemini 4 Argon | LVBench、Chartographyの両方で優位 |
| ターミナル操作、コマンドラインAgent | Claude Opus 5.5 | Terminal-Bench 4.0で9ポイント上回る |
| 科学技術計算のプログラミングや複雑な推論 | Claude Opus 5.5 | AAのSciCode、HLE、CritPtで優位 |
| すぐに本番環境へ導入したいシステム | Claude Opus 5.5 | すべてのプラットフォームで利用でき、モデルIDとクォータも明確 |
| オフラインの一括処理 | Claude Opus 5.5 | 半額のBatch($2/$10)が確定 |
Gemini 4 ArgonとClaude Opus 5.5を使い分けるモデルルーティング
多くのチームにとって現実的なのは、どちらか一方に決めるのではなく、2つのモデルを使い分けることです。まずはOpus 5.5を本番環境の主力として使い、長いコンテキストや大量の出力を得意とするタスクから、段階的にArgonへ振り分けていきます。以下は、OpenAI互換インターフェースを使ったシンプルな例です。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェース
)

OPUS = "claude-opus-5-5"
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")  # プラットフォームで実際に提供されているモデルIDを指定

def pick_model(prompt_tokens: int, need_long_output: bool) -> str:
    # 非常に長いコンテキストや出力が必要な場合はArgon、それ以外はOpus 5.5を使用
    return ARGON if prompt_tokens > 256_000 or need_long_output else OPUS

model = pick_model(prompt_tokens=12_000, need_long_output=False)
resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "排查这个 CI 流水线失败的原因"}],
)
print(model, resp.choices[0].message.content)
完全なコードを見る:同じタスクで2モデルをA/B比較
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODELS = {
    "claude-opus-5-5": (4.0, 20.0),
    os.getenv("ARGON_MODEL", "gemini-4-argon"): (
        float(os.getenv("ARGON_PRICE_IN", "2")),
        float(os.getenv("ARGON_PRICE_OUT", "10")),
    ),
}

TASKS = [
    "阅读以下合同条款,列出对乙方不利的 5 处风险并给出修改建议:...",
    "把这段 Python 2 代码迁移到 Python 3.12 并补充类型注解:...",
    "根据以下日志定位服务超时的根因:...",
]


def run(model: str, task: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        max_tokens=16000,
        messages=[{"role": "user", "content": task}],
    )
    u = resp.usage
    price_in, price_out = MODELS[model]
    cost = (u.prompt_tokens * price_in + u.completion_tokens * price_out) / 1_000_000
    return {
        "model": model,
        "latency": round(time.time() - start, 1),
        "out_tokens": u.completion_tokens,
        "cost": round(cost, 4),
        "answer": resp.choices[0].message.content,
    }


if __name__ == "__main__":
    for task in TASKS:
        print("=" * 60, "\n任务:", task[:30])
        for model in MODELS:
            r = run(model, task)
            print(f"[{r['model']}] {r['latency']}s, 输出 {r['out_tokens']} token, ${r['cost']}")
このA/Bテスト用スクリプトでは、同じタスクに対する各モデルのレイテンシ、出力トークン数、コストを記録します。実際の業務を代表するタスクを30~50件用意し、人手または評価モデルで採点したうえで、モデルの振り分け比率を決めるのがおすすめです。
🚀 すぐに試す:まずはAPIYI(apiyi.com)に登録してテスト用クレジットを取得し、Claude Opus 5.5で上記のA/Bテスト用スクリプトを動かしてみましょう。Argonがプラットフォームで正式に提供されたら、環境変数のモデル名を変更するだけで比較テストを実施できます。
よくある質問
Q1:Gemini 4 Argon と Claude Opus 5.5 は、結局どちらが優れていますか?
絶対的な答えはありません。Googleの評価表ではArgonが14項目、Opus 5.5が4項目で優位に立っています。一方、Artificial Analysisの総合知能指数では、Opus 5.5が57.6対52.6で上回っています。両者は同じクラスのモデルです。Argonは長いコンテキスト、非常に長い出力、専門分野のエージェントに強く、Opus 5.5はターミナル操作、複雑な推論、エンジニアリングの成熟度に優れています。
Q2:Googleの評価表のデータは信頼できますか?
参考にはなりますが、割り引いて見る必要があります。これはGoogleが公開したベンダー提供の評価表で、一部のベンチマークではテスト条件が同等ではありません。たとえば、LVBenchの入力フレーム数やTerminal-Bench Scienceのタイムアウト設定に差があります。また、Anthropicが公表したデータと比べると、Opus 5.5の一部の成績は低めです。5ポイント以上の差がある項目を重視し、1~2ポイント程度の差は同等と見なすのがおすすめです。
Q3:今、2つのモデルを同時に利用できますか?
Claude Opus 5.5は、Claude API、Bedrock、Vertex AI、Foundryで全面的に利用できます。Gemini 4 Argonは現在、段階的に提供が拡大されている状況です。Vertex AIからは利用できますが、有料APIはまだ全面公開されていません。まずはAPIYI(apiyi.com)経由でOpus 5.5とGeminiシリーズのモデルを導入し、Argonが正式に提供されたら、modelパラメーターを切り替えて比較するのがおすすめです。
Q4:2つのモデルの価格が同じなら、実際にはどちらのほうが安く使えますか?
第三者による実測では、Argonの1タスクあたりのコストはOpus 5.5の約3分の1から2分の1です。試用期間中は、その差がさらに大きくなる可能性があります。一方、Opus 5.5はeffortの段階を下げたり、料金が半額になるBatchを利用したりすることで、コストを大幅に抑えられます。最も正確な方法は、実際のタスクでusageを記録して計算することです。APIYI(apiyi.com)では料金を一元管理できるため、2つのモデルの実際の費用を簡単に比較できます。
まとめ
Gemini 4 ArgonとClaude Opus 5.5は、実力が拮抗したモデルです。Googleの評価表では、Argonは長いコンテキスト、法律・金融分野のエージェント、生命科学、マルチモーダルの分野で明確な強みを見せています。出力上限が1Mという点も、他にない特長です。一方、独立評価ではOpus 5.5が推論、科学研究のためのプログラミング、ターミナル操作で優位に立っています。さらに、すでにすべてのプラットフォームで利用でき、エンジニアリング面でも成熟しています。
現時点では、本番環境ではClaude Opus 5.5を主力とし、長いコンテキストや非常に長い出力が必要なタスクにはGemini 4 Argonを専用モデルとして段階的に導入するのがおすすめです。あわせて、自社の実際のタスクセットを使ったA/B比較を継続しましょう。Argonの有料APIが全面公開され、独立評価がさらに発表された後、データに基づいてモデルの振り分け比率を調整するのがよいでしょう。
ClaudeとGeminiシリーズのモデルは、APIYI(apiyi.com)経由で一元的に利用することをおすすめします。共通のインターフェースと請求書で複数モデルの比較や振り分けを行い、実データに基づいてモデルを選定できます。
参考資料:
- Google公式ブログ Gemini 4 Argonの発表記事: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Anthropic Claude Opus 5.5の発表情報: anthropic.com/news
- Artificial Analysisの知能指数とモデル比較: artificialanalysis.ai
- Vals AIのモデル評価ランキング: vals.ai
- Gemini 4 Argonの評価表まとめ(ToolScout): toolscout.ai/news/gemini-4-argon-benchmarks
著者:APIYI Team | 最先端の大規模言語モデルの評価や選定に関する情報を継続的に発信しています。モデル連携に関する最新情報は、APIYI(apiyi.com)をご覧ください。