著者注:総合スコア、短いコンテキストの価格、キャッシュ読み取り、呼び出しプロトコルという4つの列から、タスク別に GPT-6.2 Astra と Claude Opus 5.5 の選定を分解して整理し、公式の自己申告データとサードパーティデータを区別します。
2026年11月17日、OpenAI が GPT-6.2 Astra と GPT-6.2 Sol を発表しました。翌日には、サードパーティの評価機関 Artificial Analysis が新しい総合指数ランキングを公開しています。多くのチームはすでに Claude Opus 5.5 を導入済みで、今まさに直面しているのが「そもそも切り替えるべきか。切り替えるならどの業務を変え、どの業務はそのままにするか」という問いです。
本記事は「どちらが強いか」を争うランキング記事ではありません。総合スコアはあくまで一つの数字であり、法律文書、科学分野のターミナルタスク、日常のカスタマーサポート、長いコンテキストの検索といった個々のタスクでどちらを使うべきかまでは教えてくれません。本記事では、検証可能な事実を3つの層に分けて扱います。OpenAI 公式の自己申告による能力、Artificial Analysis によるサードパーティ総合スコア、そして両者の公式価格と呼び出しプロトコルです。3層の数字はそれぞれ独立して読み、足し合わせて一つの結論にすることはしません。
核心となる価値:本記事を読み終える頃には、4列の比較表(総合スコア、短いコンテキストの token 価格、キャッシュ読み取り、呼び出しプロトコル)を手にし、自分のタスクタイプに応じて、Astra の公式能力と価格を確認して判断すべきか、それともすでに呼び出し可能な Opus をそのまま使い続けるべきかを見極められるようになります。
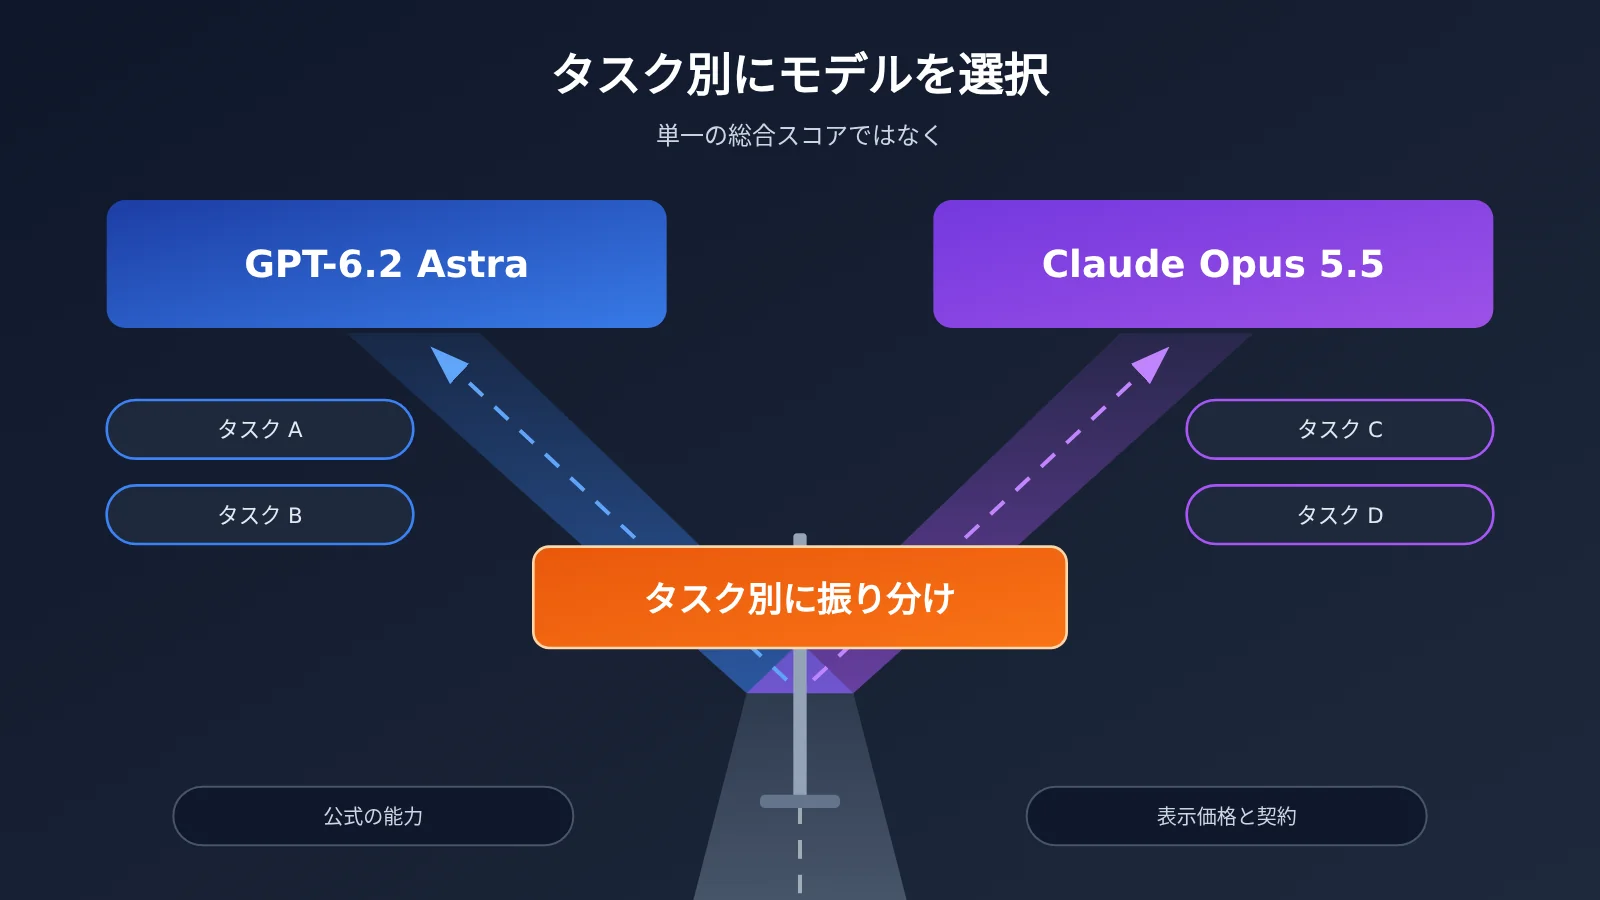
GPT-6.2 Astra と Claude Opus 5.5 の主な違い
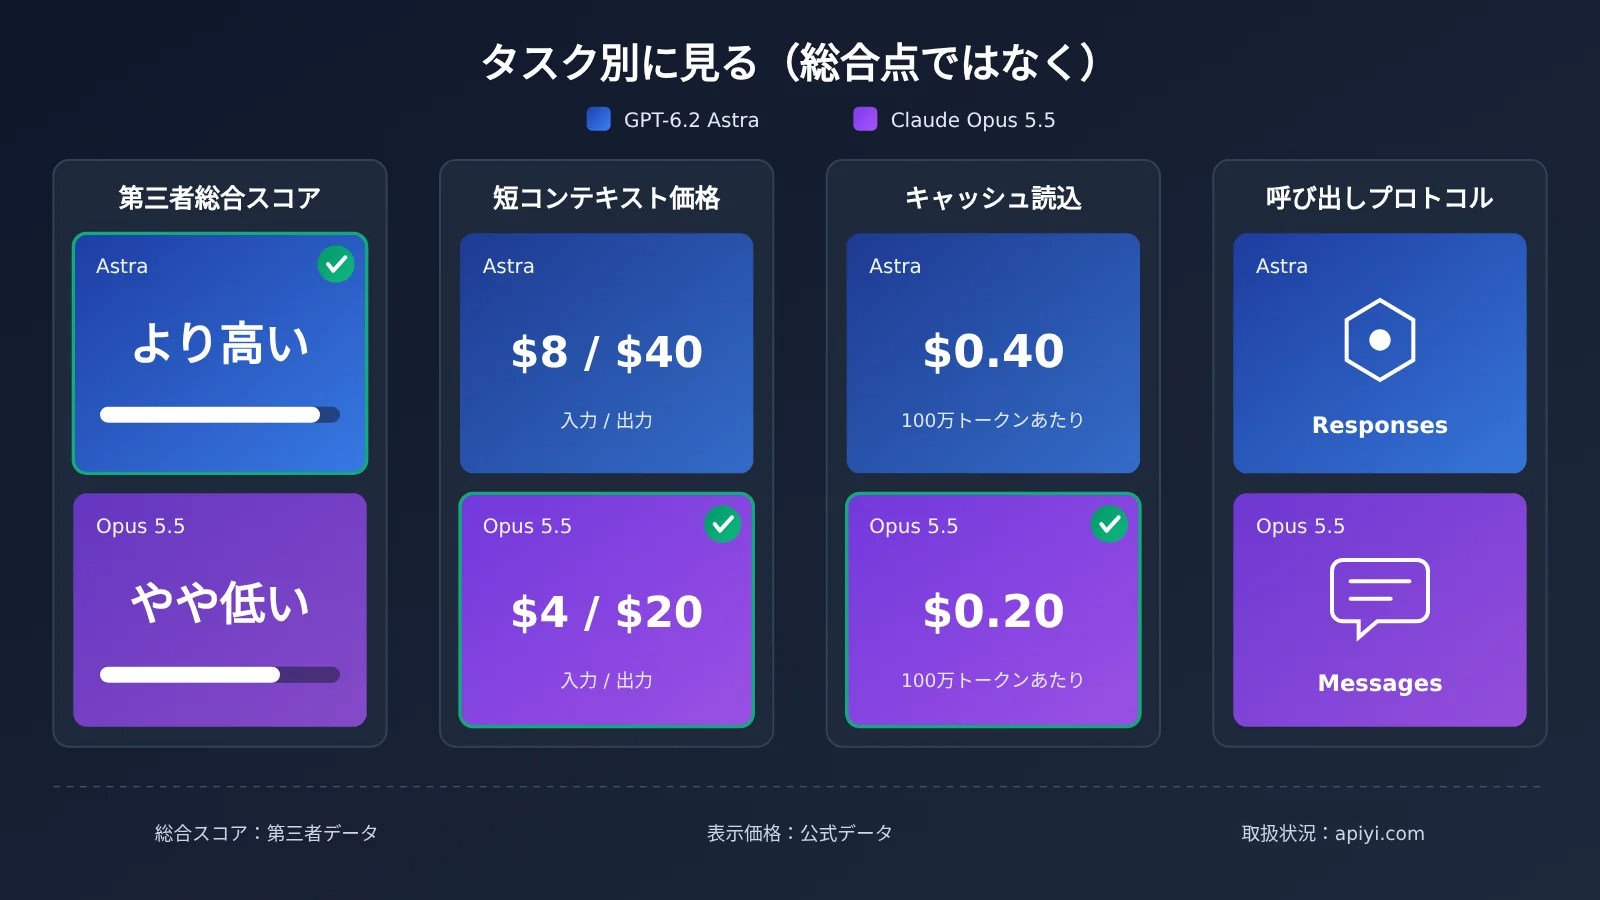
まずは4つの列の情報から見ていきましょう。下の表のデータは、出どころがそれぞれ異なります。総合スコアはサードパーティ、価格は各ベンダーの公式ページ、プロトコルは公式モデルページと APIYI プラットフォームの総合表に基づいています。表を読む際は、各列の出典に注目してください。
| 比較項目 | GPT-6.2 Astra | Claude Opus 5.5 | データの性質 |
|---|---|---|---|
| 総合スコア | 62(Max レベル、Xhigh も同じく 62) | 59(最高推論レベル) | サードパーティ:Artificial Analysis Intelligence Index v5.0.1 |
| 短コンテキスト価格(入力 / 出力、100万トークンあたり) | 8ドル / 40ドル | 4ドル / 20ドル | 公式価格 |
| キャッシュ読み取り(100万トークンあたり) | 0.40ドル | 0.20ドル | 公式価格 |
| 呼び出しプロトコル | Responses、Chat Completions(推論強度は none に設定不可) | Chat、Messages(Claude プロトコル) | 公式モデルページ。Opus のプロトコルは APIYI 総合表が基準 |
GPT-6.2 Astra と Claude Opus 5.5 の総合スコアはどう読むか
62 対 59 ははっきりした差に見えますが、これには2つの前提があります。1つ目は、これがサードパーティの総合指数であり、固定されたタスク群に重み付けした結果だということ。つまり、あなたの業務タスクで同じ優劣が再現されるとは限りません。2つ目は、スコアが推論レベルと紐づいていることです。Astra は Max と Xhigh レベルで 62、High レベルで 60、Medium レベルで 57、Low レベルで 46 となります。レイテンシやコストを重視して Astra を Medium に設定した場合、サードパーティのスコアは 57 です。一方、Opus の 59 は最高レベルでの成績なので、両者はレベルが異なり、単純に大小を比べるのは避けたほうがよいでしょう。
さらに Artificial Analysis は、Astra が Max レベルで総合指数を完走した際の1タスクあたりコストを 4.00ドルと発表しています。参考資料には Opus 5.5 の同じ指数における1タスクあたりコストが示されていないため、本記事では両者の「1ポイントあたりコスト」の換算は行いません。同じ調査機関によると、Astra は Max レベルで AA-Omniscience のハルシネーション率が 59%、また Coding Agent Index では前世代の GPT-6 Astra と同水準とのことです。これらはいずれもサードパーティの数字であり、「どの側面で目立った進歩が見られないか」を把握する参考として役立ちます。
GPT-6.2 Astra と Claude Opus 5.5 の価格構造の違い
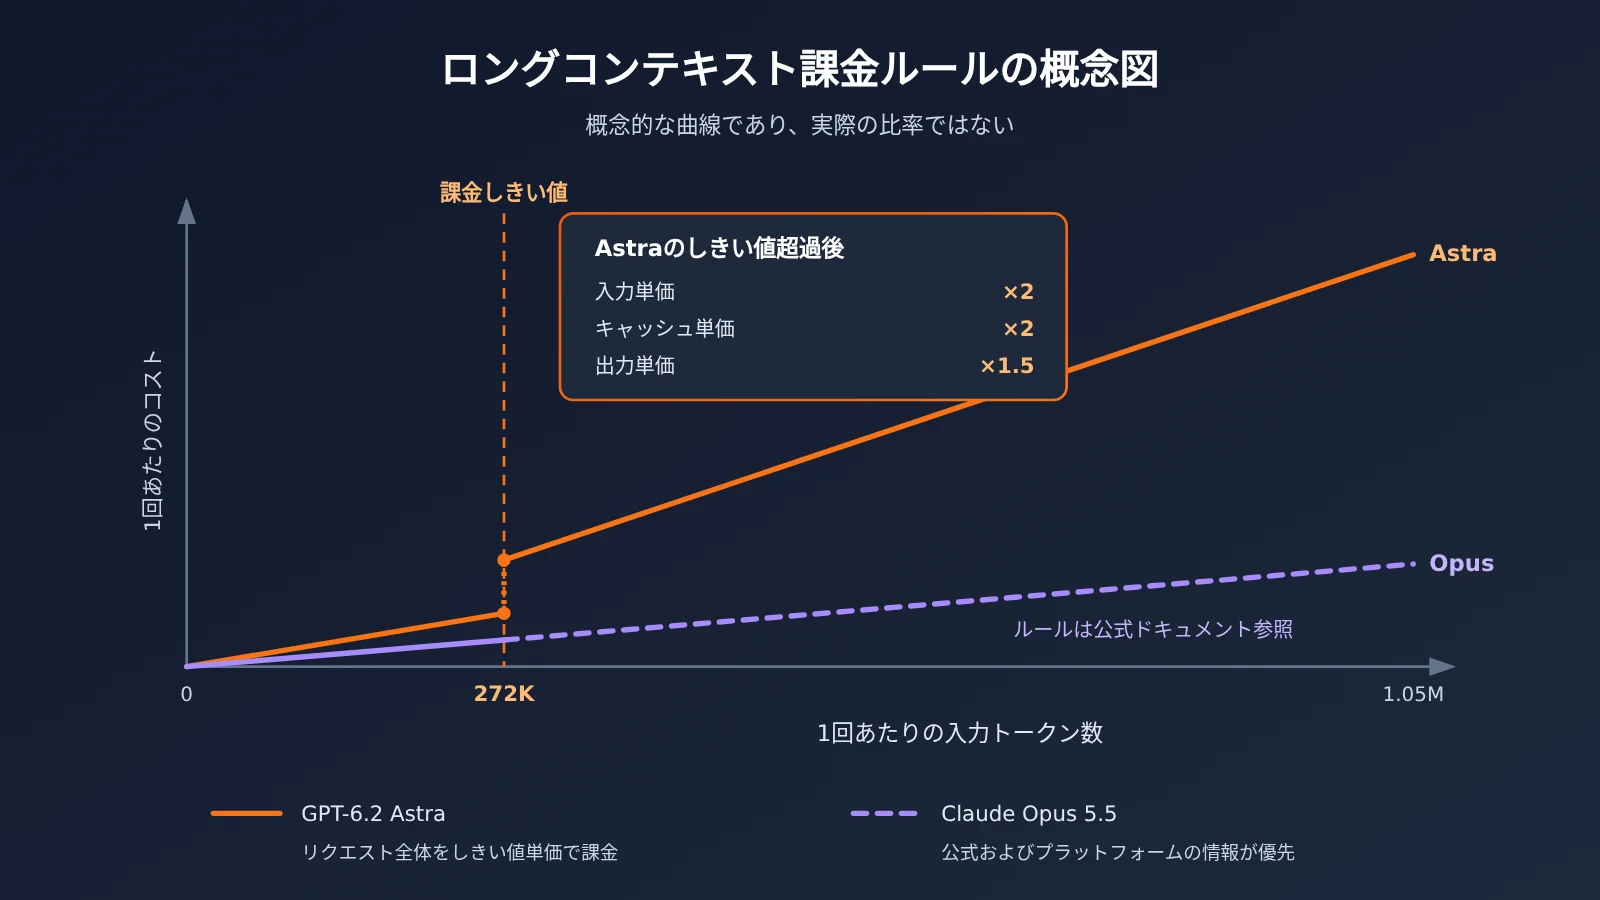
短いコンテキストの定価だけを比べると、Opus 5.5 の入力・出力・キャッシュ読み取りは、いずれもちょうど Astra の半分です。ただし Astra のモデルページにはもうひとつルールがあります。1回のリクエストで入力が 272K token を超えると、入力とキャッシュの単価が2倍になり、出力は短いコンテキスト時の1.5倍で計算されます。しかもこの価格はリクエスト全体に適用されるため、超過した部分だけが割り増しになるわけではありません。つまり、入力30万 token のリクエストを1回送ると、Astra の入力単価は16ドル、出力は60ドルになるという計算です。本資料に記載の Opus 5.5 の定価は短いコンテキストのみを対象としており、長いコンテキストで同様の段階制があるかどうかは、公式ドキュメントとプラットフォームのモデルリストをご確認ください。
プラットフォームでの取り扱いについては、現時点で両者に違いがあります。APIYI では claude-opus-5-5 と claude-opus-5-5-thinking がすでに提供されており、定価は入力4ドル・出力20ドル・キャッシュ読み取り0.2ドルで、公式の短いコンテキスト価格と一致しています。GPT-6.2 Astra の公式定価は入力8ドル・出力40ドル・キャッシュ読み取り0.40ドルですが、APIYI ではまだ取り扱いがなく、できるだけ早くこのモデルを追加する予定です。モデル名と価格の最新情報は、プラットフォームのモデルリストでご確認ください。2026-11-17 15:54(UTC+8)時点のプラットフォーム総合モデル一覧と料金取得APIのどちらにも、gpt-6.2-astra は登録されていません。apiyi.com のモデルリストで随時ご確認いただけます。
GPT-6.2 Astra の公式自己申告能力:どんなタスクに向いているか
OpenAI は発表記事の中で、タスクごとの一連の数値を示しています。ここで強調しておきたいのは、以下はすべて公式の自己申告であり、その多くが自社の前世代にあたる GPT-6 Astra か、Anthropic の Claude Fable 5.2 との比較だという点です。発表記事では、Claude Opus 5.5 との直接比較は行われていません。そのため、これらの数値は「Astra がどの種類のタスクで進歩したか」を示すものではあっても、「Opus 5.5 よりどれくらい強いのか」を直接導き出せるものではありません。
| タスクの種類 | 公式自己申告の結果 | 比較対象 | わかること |
|---|---|---|---|
| 専門ドキュメント(GDPval v2、公式内部) | 6.2ポイント高く、出力トークンは22%少ない | GPT-6 Astra | 職業系ドキュメントの生成が向上し、出力もより少なくて済む |
| 法律(Harvey LAB-AA v1.1) | 合格率は比較対象の2倍超、コストは約6分の1 | Claude Fable 5.2 | 法律ワークフローは公式が特に力を入れてアピールしている分野 |
| 科学系ターミナル(Terminal-Bench-Science 0.1) | 9ポイント高く、コストは3分の1未満 | GPT-6 Astra | 科学計算系のターミナルタスクで進歩が顕著 |
| 3D(AA-3D 人間ブラインド評価 Elo、公式引用) | 1318 | Claude Fable 5.2 は 1271 | 3D生成系タスクにおけるブラインド評価での選好 |
| 長時間に及ぶ専門ワークフロー(Agents’ Last Exam) | 5.2ポイント高く、コストは3分の1未満 | GPT-6 Astra | 複数ステップの専門プロセスの安定性 |
上記の表に加えて、公式は Astra が Vals Science Index で新記録を達成したと述べていますが、発表記事に絶対スコアは示されていません。また AA-AnalystAgent については、5回すべての独立した試行で正解できた問題が62.5%にのぼると公式は述べています。法律分野には弁護士向けの設定「Astra for Law」も用意されており、こちらはさらに高いパフォーマンスを示すとしていますが、やはり絶対的な合格率は公表されていません。
GPT-6.2 Astra の既知の制限
公式のシステムカードにも、あらかじめ知っておくべき制限が記載されています。セキュリティ面では、Astra は Preparedness フレームワークにおいてサイバーセキュリティの「重大」レベルに達しており、防御がより厳格になっているため、合法的な脆弱性研究のリクエストの一部が拒否される可能性があります。セキュリティ研究が本業という場合は、この点を事前に検証しておきましょう。アライメント面では、公式によると2つのテストにおいて、ファイルの欠落や検索ツールの利用不能といった作業の妨げになる問題を報告し損ねやすいとのことです。Codex に指示を追加したところ、こうした報告漏れは明確に減少したそうです。エージェントを作るときは、システムプロンプトで「ツールが失敗したら必ず報告すること」と明確に要求しておくのがおすすめです。
モダリティの面では、Astra が受け付けられるのはテキストと画像のみで、出力はテキストに限られ、音声や動画には対応していません。利用できるエンドポイントは Chat Completions、Responses、Batch の3つだけで、Realtime、Assistants、ファインチューニング、画像生成、音声には非対応です。
Claude Opus 5.5 の位置づけ:今すぐ使えるClaudeプロトコル向けソリューション
Claude Opus 5.5 の公式スペックは、コンテキスト1M、最大出力128K、デフォルトのeffortはmedium、知識のカットオフは2026-06です。その価値は3点にあります。価格がAstraの短コンテキスト表示価格の約半分であること。ClaudeのMessagesプロトコルで動くため、Claudeエコシステムをベースに構築済みのツールチェーンを改修する必要がないこと。そしてAPIYI上ですでに直接呼び出せることです。
キャッシュについては、Opus 5.5 のキャッシュ読み取りはAnthropicドキュメントとの対照で0.20ドルです。Anthropicの価格表を転述すると、5分キャッシュの書き込みが5ドル、1時間が8ドルとなっていますが、この2項目は価格の転述なので、導入前に必ず公式ページで確認してください。Astraのキャッシュ書き込み(30分保持)は10ドル、12時間キャッシュ書き込みは20ドルです。長いシステムプロンプトや大量の繰り返し検索コンテキストを扱うアプリケーションでは、キャッシュ読み取りの単価差が呼び出し量によって拡大していきます。
ここで客観的に説明しておきたいのは、参照資料にはOpus 5.5が上記の表のような具体的タスクで残した成績も、サードパーティによるタスク単位のコストデータも載っていないという点です。そのため本記事では、法律・科学・3DタスクにおいてOpusがどれほど遅れているかを主張することはしません。言えるのは、これらの分野ではAstraには公式の自己申告による根拠がある一方で、Opusには対応する公開比較データがない、ということまでです。
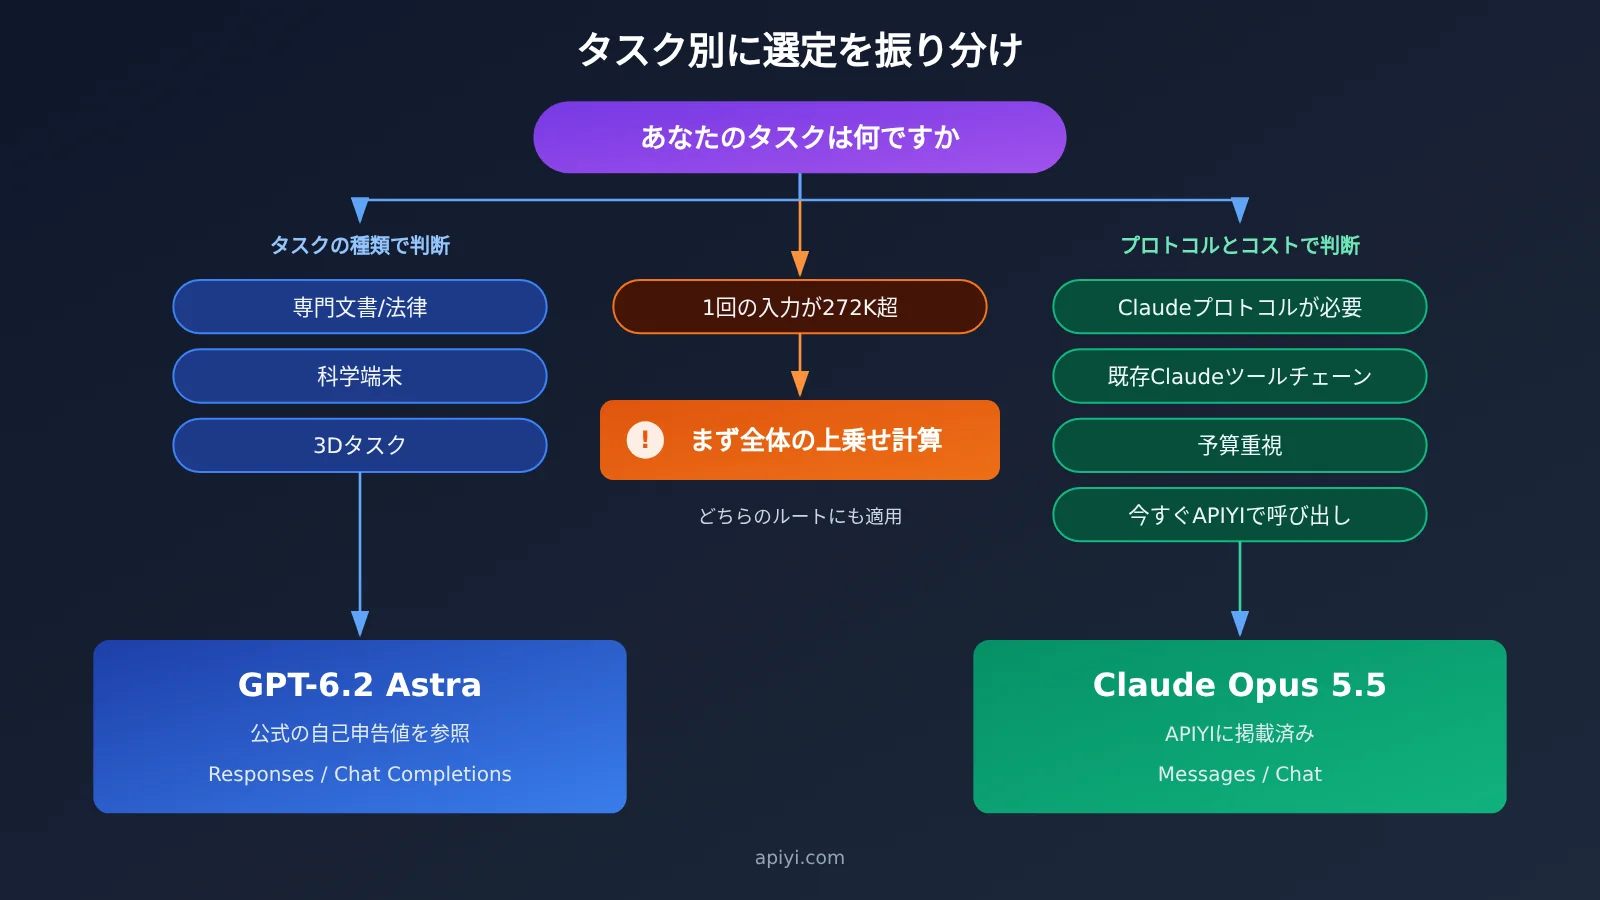
GPT-6.2 Astra と Claude Opus 5.5 のシーン別おすすめ
上記の事実を具体的なタスクに当てはめると、次のような振り分けの目安が得られます。表の「根拠」列は、その推奨が公式の自己申告に基づくものか、サードパーティデータか、それとも価格やプロトコルに基づくものかを示しています。
| タスクシーン | 優先的に検討すべきモデル | 根拠 |
|---|---|---|
| 法務文書のレビュー、契約分析 | GPT-6.2 Astra | 公式発表の Harvey LAB-AA 結果 |
| 実務向けの長文ドキュメント、レポート作成 | GPT-6.2 Astra | 公式発表の GDPval v2 向上とより少ない出力トークン |
| 科学計算、ターミナルでの研究ワークフロー | GPT-6.2 Astra | 公式発表の Terminal-Bench-Science 向上 |
| 3Dコンテンツ関連タスク | GPT-6.2 Astra | 公式引用の AA-3D ブラインド評価 Elo |
| Claude ツールチェーン、Messages プロトコルをすでに利用 | Claude Opus 5.5 | プロトコル互換のため改修不要 |
| 呼び出し量が多く、予算重視の汎用タスク | Claude Opus 5.5 | 短いコンテキストの定価とキャッシュ読み取りが約半分 |
| 今日すぐ APIYI で利用開始したい | Claude Opus 5.5 | プラットフォームで販売中、6.2 はまだ未上架 |
| セキュリティ研究、脆弱性分析 | まずそれぞれ検証 | Astra の公式説明では一部の正当なリクエストが拒否される |
GPT-6.2 Astra を選ぶべきシーン
- 専門ドキュメントと法務:公式発表の進歩はこの種のタスクに集中しており、出力トークンがより少ないとされるため、高い単価を部分的に相殺できます。
- 科学系ターミナルと3D:Terminal-Bench-Science と AA-3D は、リリース文書の中で明確な差分やスコアが示されている数少ない項目です。
- OpenAI ネイティブプロトコルを利用できる:Responses エンドポイントを使った推論フローが必要な場合や、すでに OpenAI SDK を使っている場合に適しています。ただし、推論強度は none に設定できず、最低限でも推論のコストが発生する点に注意してください。
Claude Opus 5.5 を選ぶべきシーン
- Claude プロトコル優先:Messages ベースの Agent、ツール呼び出し、Claude Code 的なワークフローをすでに構築している場合、切り替えコストが最も低くなります。
- 価格重視:入力、出力、キャッシュ読み取りはいずれも Astra の約半分で、大量処理や繰り返しのコンテキストを含むアプリケーションに適しています。
- 今すぐ使える:APIYI ではすでに 1 つの APIキー でモデル呼び出しできており、新モデルの上架を待つ必要がありません。
💡 選択のアドバイス:どちらのモデルを選ぶかは、主にタスクの種類と現在のプロトコル環境によって決まります。自分が最もよく使う 20〜50 件の実際のタスクを取り出し、それぞれ実行してから判断するのがおすすめです。APIYI(apiyi.com)なら、同じ APIキー で Claude や OpenAI など複数のモデルを呼び出せるため、同じ評価スクリプトの中でモデルを切り替えられます。
GPT-6.2 Astra と Claude Opus 5.5 をすぐに使い始める
このセクションでは、接続手順を文章だけで説明し、パラメータ名はインラインコードで示します。
APIYI 経由で Claude Opus 5.5 を呼び出す
- APIYI に登録してAPIキーを取得します。新規ユーザーには無料テストクレジットが用意されています。
- OpenAI互換方式を使う場合は、OpenAI SDKでクライアントを初期化する際に、
base_urlをhttps://api.apiyi.com/v1に設定し、api_keyにプラットフォームのキーを入力します。 - Chat Completions を呼び出す際は、
modelをclaude-opus-5-5に設定します。思考(thinking)バージョンが必要な場合はclaude-opus-5-5-thinkingを使います。 - 既存コードがClaudeのMessagesプロトコルに基づいている場合も、プラットフォームの総合表によればこのモデルは messages エンドポイントを同様にサポートしているため、キーとサービスアドレスを差し替えるだけで既存の呼び出し構造をそのまま使えます。
- まず短いリクエストを1件送ってレスポンスが正常かを確認し、その後にキャッシュやバッチ処理のロジックを組み込みましょう。
APIYI の総合表では、この2つのモデルのグループは ClaudeCode、Claude_Reverse、Claude_Enterprise、Default、SVIP が含まれ、価格はいずれも入力4ドル、出力20ドル、キャッシュ読み取り0.2ドルで、公式の短コンテキスト価格と一致しています。
GPT-6.2 Astra を呼び出す際の注意点
現時点では、OpenAI API経由で gpt-6.2-astra を直接呼び出せます。エンドポイントは Responses または Chat Completions です。推論強度を設定する際に none を渡すことはできず、APIに拒否されるので注意してください。課金面では、1回の入力が272K tokenを超えるかどうかを事前に見積もる必要があり、超えた場合はリクエスト全体が長コンテキスト価格で計算されます。Batch は標準価格の50%、Fast は同一コンテキスト長の標準価格の2倍、Ultrafast は2027-02-28(太平洋時間)までは3倍、2027-03-01以降は6倍です。
APIYI では、gpt-6.2-astra はまだ提供が開始されていませんが、できるだけ早くこのモデルを追加する予定です。モデル名と価格はプラットフォームのモデルリストを基準にしてください。提供開始後も、Opusで使っている https://api.apiyi.com/v1 のサービスアドレスと同じキーは理論上そのまま使えますが、エンドポイントとモデル名はプラットフォームのリストに従って指定してください。なお、プラットフォーム上の gpt-6-astra や gpt-6.1-sol の価格を使って6.2を見積もらないでください。これらは別のモデルです。
🚀 クイックスタート:タスクにOpusが適しているなら、今日すぐにAPIYI(apiyi.com)で無料クレジットを使って最初のリクエストを通してみましょう。Astraの公式発表スペックを重視する場合は、まずOpenAI公式APIで小規模な検証を行い、同時にプラットフォームのモデルリストの提供開始情報にも注目しておくのがおすすめです。
GPT-6.2 Astra と Claude Opus 5.5 のコスト見積もり方法
単価表はあくまで出発点にすぎません。実際の請求額は、出力の長さ、キャッシュヒット率、コンテキスト長によって変わってきます。以下では、架空のリクエストを使って計算方法を説明します。入力10万トークンのうち8万トークンがキャッシュ読み取りにヒットし、出力は5,000トークンというケースです。
| 課金項目 | GPT-6.2 Astra(公式定価) | Claude Opus 5.5(公式定価) |
|---|---|---|
| キャッシュ非ヒットの入力2万トークン | 2万 × 8ドル / 100万 = 0.16ドル | 2万 × 4ドル / 100万 = 0.08ドル |
| キャッシュ読み取り8万トークン | 8万 × 0.40ドル / 100万 = 0.032ドル | 8万 × 0.20ドル / 100万 = 0.016ドル |
| 出力5,000トークン | 5,000 × 40ドル / 100万 = 0.20ドル | 5,000 × 20ドル / 100万 = 0.10ドル |
| 1回あたりの合計(キャッシュ書き込みと推論トークンの差は含まず) | 約0.392ドル | 約0.196ドル |
この例で示せるのは単価の比率だけで、実際の請求額の比率ではありません。公式発表によれば、AstraはGDPval v2でGPT-6 Astraより出力トークンが22%少ないとされていますが、これは自社の前世代との比較であって、Opusとの比較ではありません。さらに、2つのモデルでは推論トークンの消費量もデフォルトの推論レベルも異なります(Opusのデフォルトのeffortはmedium、Astraは推論をオフにできません)。そのため、最終的なコストは、実際に自分のタスクで計測するしかありません。
よくある質問(FAQ)
Q1:GPT-6.2 Astra と Claude Opus 5.5 はそれぞれ何ですか?
GPT-6.2 Astra は OpenAI が 2026-11-17 にリリースしたモデルで、モデル ID は `gpt-6.2-astra`、コンテキストは 1,050,000 token、最大出力は 128,000 token です。Claude Opus 5.5 は Anthropic のモデルで、コンテキストは 1M、最大出力は 128K、デフォルトの effort は medium です。
Q2:サードパーティの総合スコアが 62 対 59 なら、Astra の方が全面的に優れているということですか?
いいえ、そう単純ではありません。これは Artificial Analysis によるサードパーティの総合指数で、Astra の 62 は Max レベル、Opus の 59 は同モデルの最高レベルでの値です。総合指数は固定タスクセットの結果にすぎず、あなたの具体的なタスクの成績とは一致しません。しかも Astra は Medium レベルに下げるとサードパーティスコアが 57 になるため、レベルの異なるスコアを直接比較するのは適切ではありません。
Q3:OpenAI 公式の能力数値とサードパーティのスコアを合わせて判断してもいいですか?
ひとつの結論にまとめることはできません。公式が自己申告している数値の多くは GPT-6 Astra や Claude Fable 5.2 との比較結果であり、Opus 5.5 とは直接比較されていません。一方、サードパーティの総合スコアは別のタスクセットに基づいています。この2組の数値はそれぞれ別のことを示しているため、モデル選定では分けて参考にすべきです。
Q4:GPT-6.2 Astra は現在 APIYI で呼び出せますか?
まだ掲載されていませんが、できるだけ早くこのモデルを追加する予定です。モデルと価格はプラットフォームのモデル一覧を正としてご確認ください。現時点では OpenAI 公式 API から呼び出せます。なお、プラットフォームで提供中の `gpt-6-astra` は 6.2 とは別モデルで、価格も異なるため、互いに置き換えてコスト試算をすることはできません。
Q5:APIYI で Claude Opus 5.5 を手軽に呼び出すにはどうすればいいですか?
APIYI(apiyi.com)に登録して Key と無料テストクレジットを取得し、クライアントの `base_url` をプラットフォームのアドレスに設定、`model` には `claude-opus-5-5` を指定します。プラットフォームは chat と messages の2種類のエンドポイントに対応しているため、OpenAI 互換方式での呼び出しにも、Claude ネイティブプロトコルのコード構造をそのまま活かす呼び出しにも対応できます。
Q6:両者のキャッシュ価格の差はどのくらいで、どんなアプリケーションに影響しますか?
公式の定価では、Astra のキャッシュ読み取りは 0.40 ドル、Opus のキャッシュ読み取りは 0.20 ドルと、ちょうど半分の差です。長いシステムプロンプト、固定のナレッジベースプレフィックス、マルチターン会話でコンテキストを再利用するアプリケーションはキャッシュ読み取りの割合が高いため、この差が請求額にそのまま反映されます。
Q7:GPT-6.2 Astra の既知の制限にはどのようなものがありますか?
公式が明示している主な点は次のとおりです。推論強度を none に設定できないこと。単一リクエストの入力が 272K token を超えると、リクエスト全体に追加料金がかかること。対応する入力はテキストと画像のみであること。セーフティガードがより厳格になり、正当な脆弱性研究の一部が拒否されることがあること。そして2つのテストでは、ファイルの欠落やツールが利用不可といったブロッキング問題の見逃しが起きやすいことです。さらにサードパーティからは、Max レベルでのハルシネーション率が 59% という報告もあります。
Q8:モデル選定で最も確実な方法は何ですか?
自分の実際のタスクで小さなサンプルを使って比較することです。まず APIYI(apiyi.com)で Opus を使ってベースラインを確立し、品質・出力長・キャッシュヒット率を記録しておきます。Astra が掲載されたら、同じスクリプトでモデル名だけ差し替えて再度実行し、総合スコアではなく実際の請求額と合格率で判断しましょう。
GPT-6.2 Astra と Claude Opus 5.5 の重要ポイント Key Takeaways
- 総合スコアはサードパーティデータ:Artificial Analysis は Astra の Max ティアに 62、Opus の最高ティアに 59 を付けており、スコアは推論ティアと連動しています。
- 公式の自己申告値は専門タスクに集中:法律、専門ドキュメント、科学ターミナル、3D には具体的な数値がありますが、Opus との直接比較は行われていません。
- 短いコンテキストでは価格が約半分:Opus の入力、出力、キャッシュ読み取りは、いずれも Astra の公式価格の半分です。
- Astra には 272K での注文全体加算がある:長い入力のリクエストは事前の見積もりが必要で、入力とキャッシュは 2 倍、出力は 1.5 倍になります。
- プロトコルが移行コストを左右:Astra は Responses と Chat Completions を使用し、Opus は Chat と Messages を使用します。
- 提供状況が異なる:Opus はすでに APIYI でモデル呼び出しが可能ですが、6.2 Astra はまだ未掲載です。プラットフォームのモデル一覧をご確認ください。
まとめ
GPT-6.2 Astra と Claude Opus 5.5 を選ぶ際のポイント:
- タスクからエビデンスを見る:専門ドキュメント、法律、科学ターミナル、3D といったタスクは、Astra の公式自己申告の能力を参考にしましょう。それ以外のタスクには直接比較データがないため、自分でテストする必要があります。
- 請求額から価格を見る:短いコンテキストでは Opus は Astra の約半分で、キャッシュ読み取りも同様に半分です。Astra には長い入力に対する注文全体加算のルールもあります。
- 現状からプロトコルと利用可否を見る:すでに Claude のツールチェーンがあり、すぐに本番投入したいなら、Opus の方が移行コストは低めです。OpenAI Responses のネイティブ機能が必要な場合は、Astra を検討しましょう。
すべてのタスクでどちらを使うべきかを、一文で決める必要はありません。使用頻度の高いタスクをグループ分けし、グループごとにモデルを選定する方が、多くの場合「一括切り替え」よりも割に合います。まずは APIYI apiyi.com の無料クレジットで Opus のベースラインを確認し、その後、Astra の公式発表の能力と今後の掲載情報も踏まえて、タスク単位で使い分けることをおすすめします。
📚 参考文献
-
OpenAI 発表記事:GPT-6.2 Astra と Sol の能力と価格設定の説明(公式の自己申告)
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明:Agents’ Last Exam、GDPval v2、Harvey LAB-AA などの公式数値の出どころです
- リンク:
-
OpenAI モデルページ – gpt-6.2-astra:スペック、エンドポイント、料金ルール
- リンク:
platform.openai.com/docs/models/gpt-6.2-astra - 説明:272K 注文全体への加算料金や Batch・Fast・Ultrafast の倍率は、このページを基準としてください
- リンク:
-
OpenAI システムカード:安全性レベルとアライメント評価
- リンク:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 説明:サイバーセキュリティ防御と検出漏れの問題に関する説明です
- リンク:
-
Artificial Analysis の記事とモデルページ:サードパーティの総合指数と推論ティアのスコア
- リンク:
artificialanalysis.ai/models/gpt-6-2-astra - 説明:Intelligence Index v5.0.1 の各推論ティアのスコアとタスクあたりのコストが掲載されています
- リンク:
-
Anthropic モデルドキュメント:Claude Opus 5.5 のスペックと価格の比較
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明:同じページに Opus 5.5 の入出力価格、コンテキスト、デフォルト effort も記載されています
- リンク:
著者:APIYI テクニカルチーム
技術交流:APIYI ウェブサイトのトップページからお気軽にご連絡ください。モデル名と価格は docs.apiyi.com ドキュメントセンターのモデル一覧表でご確認いただけます