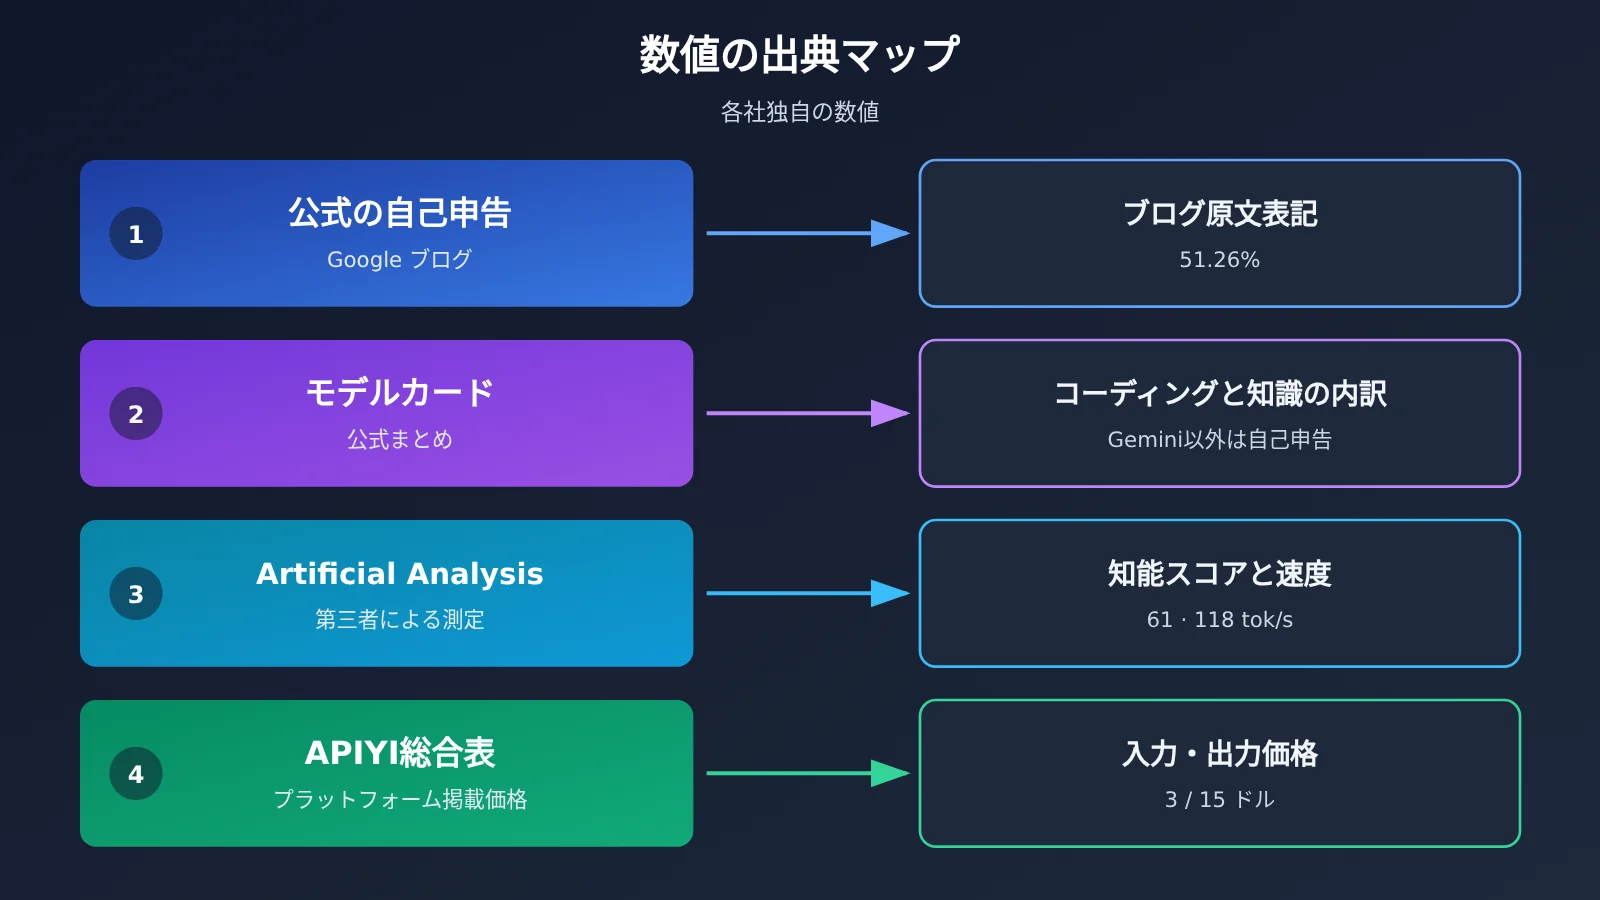
著者注:本記事では Gemini 4 Neon と Claude Opus 5.5 の公開数値を「コーディング」と「ナレッジワーク」という2つの軸に分けて読み、各数値が公式の自己申告、モデルカード、Artificial Analysis のモデルページ、Artificial Analysis の記事、APIYI の一覧表、価格インターフェースのいずれに由来するのかを、項目ごとに明記していきます。
すでにワークフローへ Claude Opus 5.5 を組み込んでいるなら、2026-11-18 にリリースされた Gemini 4 Neon は、ひとつのストレートな疑問を投げかけてきます。同じプロジェクトでどちらの数値が高いのか、そしてそれらの数値は同じ物差しで測られたものなのか。Google のブログ、DeepMind のモデルカード、Artificial Analysis は、いずれも公開当日に数値を公表しています。ただし、その集計基準、グレード、テストフレームワークはそれぞれ異なります。
本記事のデータ確認日は 2026-11-19 です。すべての数値は公開資料に基づいており、各数値には出典を明記しています。コーディングとナレッジワークは2つの軸で読み、モデルカードと Artificial Analysis は2つの節に分けて書いていきます。どちらのモデルがあなたに合うかは、どの行を重視するかで変わってきます。
この記事の価値:読み終えるころには、Gemini 4 Neon のモデルカードにある3列の表をどう読めばよいのか、Artificial Analysis の知能スコア・タスクあたりのコスト・所要時間・出力速度がそれぞれ何を意味するのか、そして APIYI 上で Claude Opus 5.5 のモデル名と価格をどう確認するのかが、きちんとわかるようになります。
Gemini 4 Neon と Claude Opus 5.5 の核心ポイント
まずはざっと全体像をつかめる早見表からどうぞ。各行には設定(推論の強さ)と出典を明記しています。同じ行に並ぶ2つの数値は、測定条件が完全に同一とは限りません。
| 項目 | Gemini 4 Neon | Claude Opus 5.5 | 出典 |
|---|---|---|---|
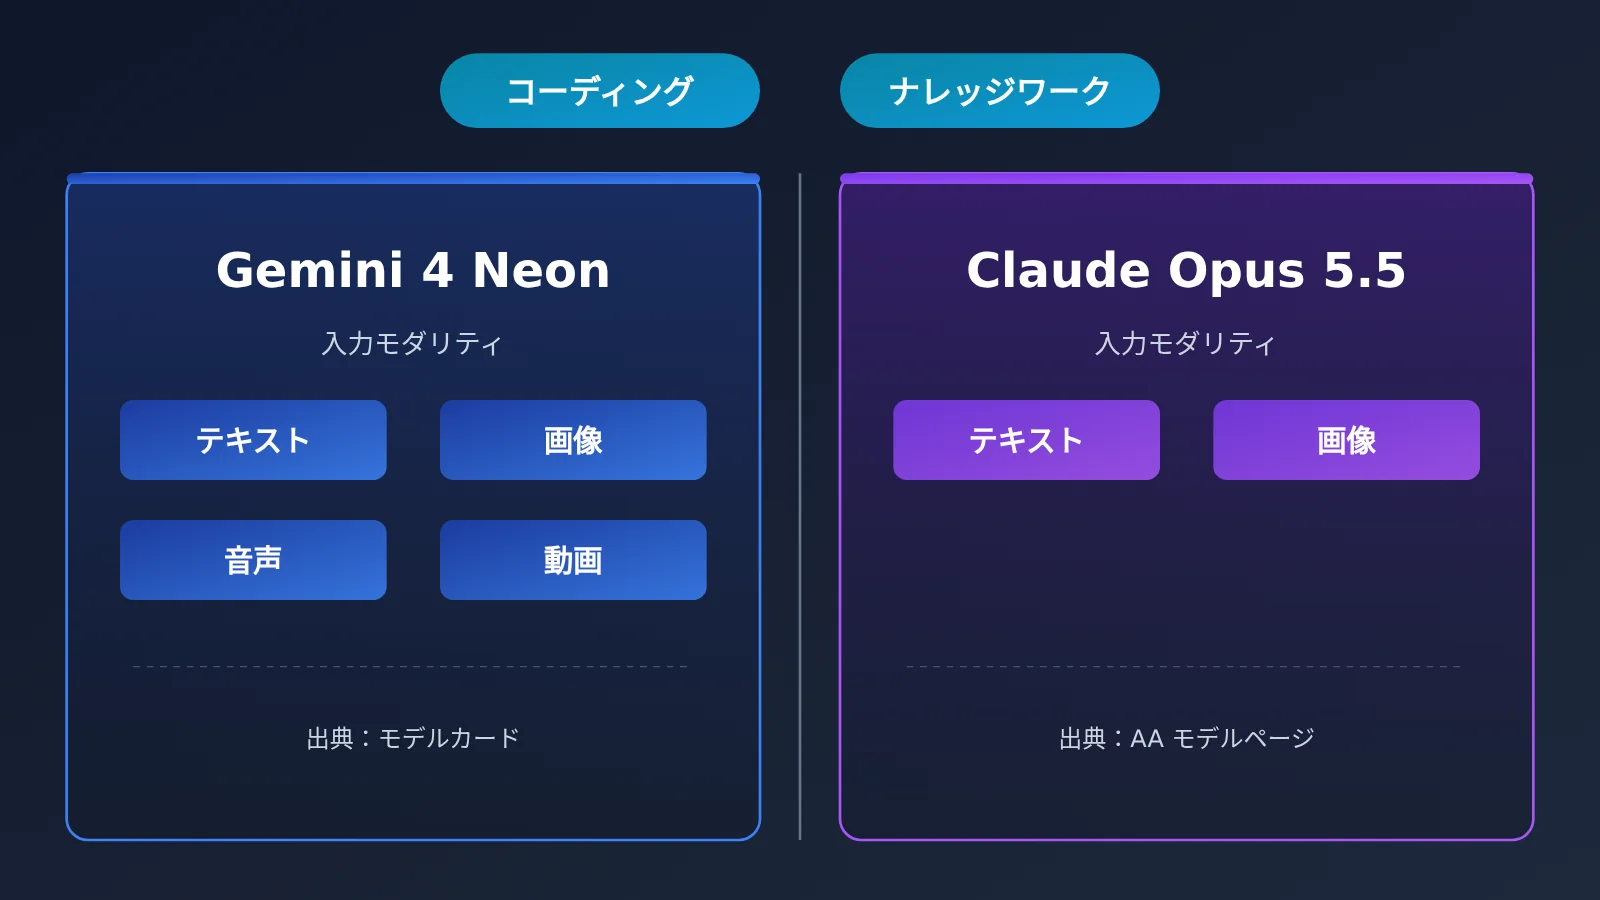
| 入力モダリティ | テキスト、画像、音声、動画 | テキスト、画像 | モデルカード / Artificial Analysis モデルページ |
| 知能スコア(指数 v5.0.1) | 61(xhigh) | 59(max) | Artificial Analysis モデルページ |
| Terminal-bench 4.1(不正調整後) | 65.2% | 65.8% | モデルカード(Gemini 以外の結果は各社の自己申告) |
| FrontierCode 2.0 | 46.2%(デフォルト high) | 47.3% | モデルカード |
| 1タスクあたりのコスト | 6.44ドル | 10.04ドル | Artificial Analysis モデルページ |
| 出力速度 | 110 トークン/秒 | 118 トークン/秒 | Artificial Analysis モデルページ |
| 定価(入力 / 出力、100万トークンあたり) | 3 / 15ドル | 4 / 20ドル | Google AI Studio 料金ページ / Artificial Analysis モデルページ |
Gemini 4 Neon と Claude Opus 5.5 の数値分布
この表では、両方のモデルがそれぞれ上回っている行があります。モデルカードの多くの項目と Artificial Analysis の知能スコア(61 対 59)では、Gemini 4 Neon のほうが高くなっています。一方、Terminal-bench 4.1(65.8% 対 65.2%)、FrontierCode 2.0(47.3% 対 46.2%)、出力速度(118 対 110 トークン/秒)では、Claude Opus 5.5 が上回っています。
入力モダリティについては補足が必要です。モデルカードによれば、Gemini 4 Neon はテキスト・画像・音声・動画を入力できます。Artificial Analysis のモデルページでは、Claude Opus 5.5 の入力はテキストと画像です。音声や動画を直接扱うタスクであれば、この項目がモデル選定を左右します。テキストとスクリーンショットしか扱わないなら、この項目は差にはなりません。
Gemini 4 Neon と Claude Opus 5.5 の比較:モデルカードの3列表をどう読むか
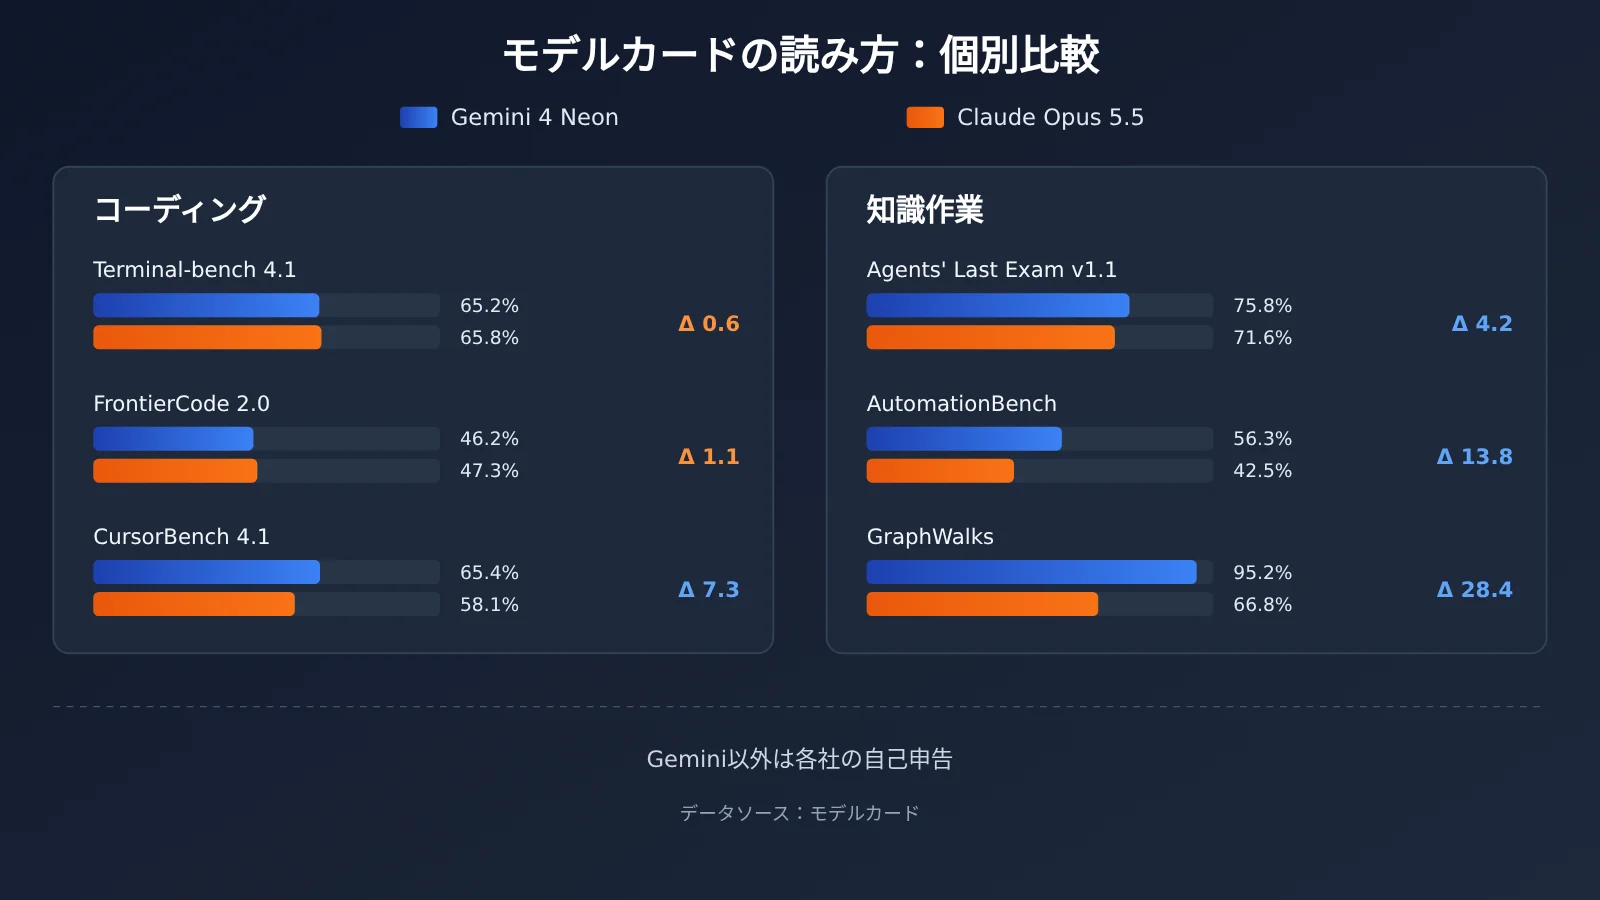
DeepMind のモデルカードにある比較表は3列だけで、それぞれ Gemini 4 Neon、Claude Opus 5.5、GPT-6.2 Sol です。本記事では最初の2列のみを読みます。評価説明の PDF には、Gemini 以外の結果は既定で各社の自己申告によるものだと明記されています。したがってこの表は公式の集約であり、各列は同一のラボが同じ日に再測定した結果ではありません。読む際には、各セルを1つの公開表明として扱う必要があります。
Gemini 4 Neon と Claude Opus 5.5 のコーディング系項目
以下はモデルカードにある、コーディングおよびセキュアプログラミングに関連する行です。
| 項目(モデルカード) | Gemini 4 Neon | Claude Opus 5.5 | 高い側 |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | Neon |
| Terminal-bench 4.1(チート調整後の正確率) | 65.2% | 65.8% | Opus |
| FrontierCode 2.0 | 46.2%(デフォルト high) | 47.3% | Opus |
| SWE-sweep ベンダー harness | 39.0% | 10.1% | Neon |
| SWE-sweep mini-SWE harness | 12.8% | 3.6% | Neon |
| CWE-Bench v2 | 70.7% | 67.1% | Neon |
| WebExploitBench v1.2 | 51.3% | 37.1% | Neon |
この表を読む際の注意点は3つあります。
- Opus の方が高い2項目はいずれもメインラインのコーディングに属します。Terminal-bench 4.1 と FrontierCode 2.0 はどちらもターミナル操作とコードタスクを測るもので、差はそれぞれ 0.6 ポイントと 1.1 ポイントです。Neon の FrontierCode スコアにはデフォルト high 設定と注記されています。
- SWE-sweep の2行は2種類の harness を使っています。Neon は Google Antigravity では 39.0%、mini-SWE harness では 12.8% です。Google のブログではこの差を harness の有効化によるものとしており、モデル自体に3倍の差があると解釈すべきではありません。2つのモデルを比較する際は、同じ harness の下で比べる必要があります。つまり 39.0% 対 10.1%、または 12.8% 対 3.6% です。
- 同じ数値でも情報源によって表記が異なります。WebExploitBench はモデルカードでは 51.3%、Google のブログでは 51.26% です。どちらの表記もそのまま保持し、取捨選択はしていません。
Gemini 4 Neon と Claude Opus 5.5 の知識・科学系サブ項目
知識作業、科学推論、長コンテキストに関するサブ項目は数が多く、この部分では Neon が上回るケースが多数を占めています。
| 項目(モデルカード) | Gemini 4 Neon | Claude Opus 5.5 |
|---|---|---|
| AA Index v5.0.1 | 61 | 59 |
| Vals Index v2.2 | 70.9% | 70.1% |
| AutomationBench | 56.3% | 42.5% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% |
| RiemannBench | 84.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% |
| HLE-Diamond | 71.3% | 67.9% |
| MKA Climb WSR | 56.5% | 53.0% |
| Chartography | 73.5% | 66.3% |
| LVBench | 89.0% | 83.7% |
| GraphWalks(256k〜1M、BFS の F1) | 95.2% | 66.8% |
各行の差の大きさは一様ではありません。Vals Index はわずか 0.8 ポイント差ですが、GraphWalks は 28.4 ポイント差で、こちらは 256k〜1M トークンという超長コンテキストでのグラフ走査を測る項目です。長い文書の中を検索して推論する知識作業が中心なら、GraphWalks の行を重点的に見るべきでしょう。業務自動化が目的なら、AutomationBench の 56.3% 対 42.5% という数字のほうが実際の利用シーンに近いはずです。
Google のブログでは、公式の自己申告として順位もいくつか挙げられています。たとえば Legal Research Bench と Tax Agent Bench で 1 位、Surge では金融・会計・表計算モデリングの多くで 1 位といった具合です。ただしブログにはこれらの項目の百分率も、Opus 側の対応する数値も示されていません。そのため、これらの順位をそのまま2モデルの対照表に組み入れることはできません。
Gemini 4 Neon と Claude Opus 5.5 の比較:Artificial Analysis の4つの数値の読み方
Artificial Analysis はサードパーティによる測定で、モデルカードとは別の体系に属します。同サイトのモデルページでは、推論(思考)レベルごとに知能スコア、タスクあたりのコスト、所要時間、出力速度を提示しています。本節の主な比較は Neon xhigh 対 Opus max です。これは両社がモデルページ上で示すそれぞれの最高レベルですが、両者のレベルは同等ではありません。
| 指標(Artificial Analysis モデルページ、v5.0.1) | Gemini 4 Neon(xhigh) | Claude Opus 5.5(max) |
|---|---|---|
| 知能スコア | 61 | 59 |
| タスクあたりのコスト | 6.44 ドル | 10.04 ドル |
| タスクあたりの所要時間 | 21.5 分 | 24.5 分 |
| 出力速度 | 110 token/秒 | 118 token/秒 |
| 最初の回答トークン | 56.51 秒 | 335.85 秒 |
| 指数実行時の出力トークン | 2.83 億 | 2.18 億 |
| 定価(入力 / 出力) | 3.00 / 15.00 ドル | 4.00 / 20.00 ドル |
| 実効価格 | 2.21 ドル | 2.94 ドル |
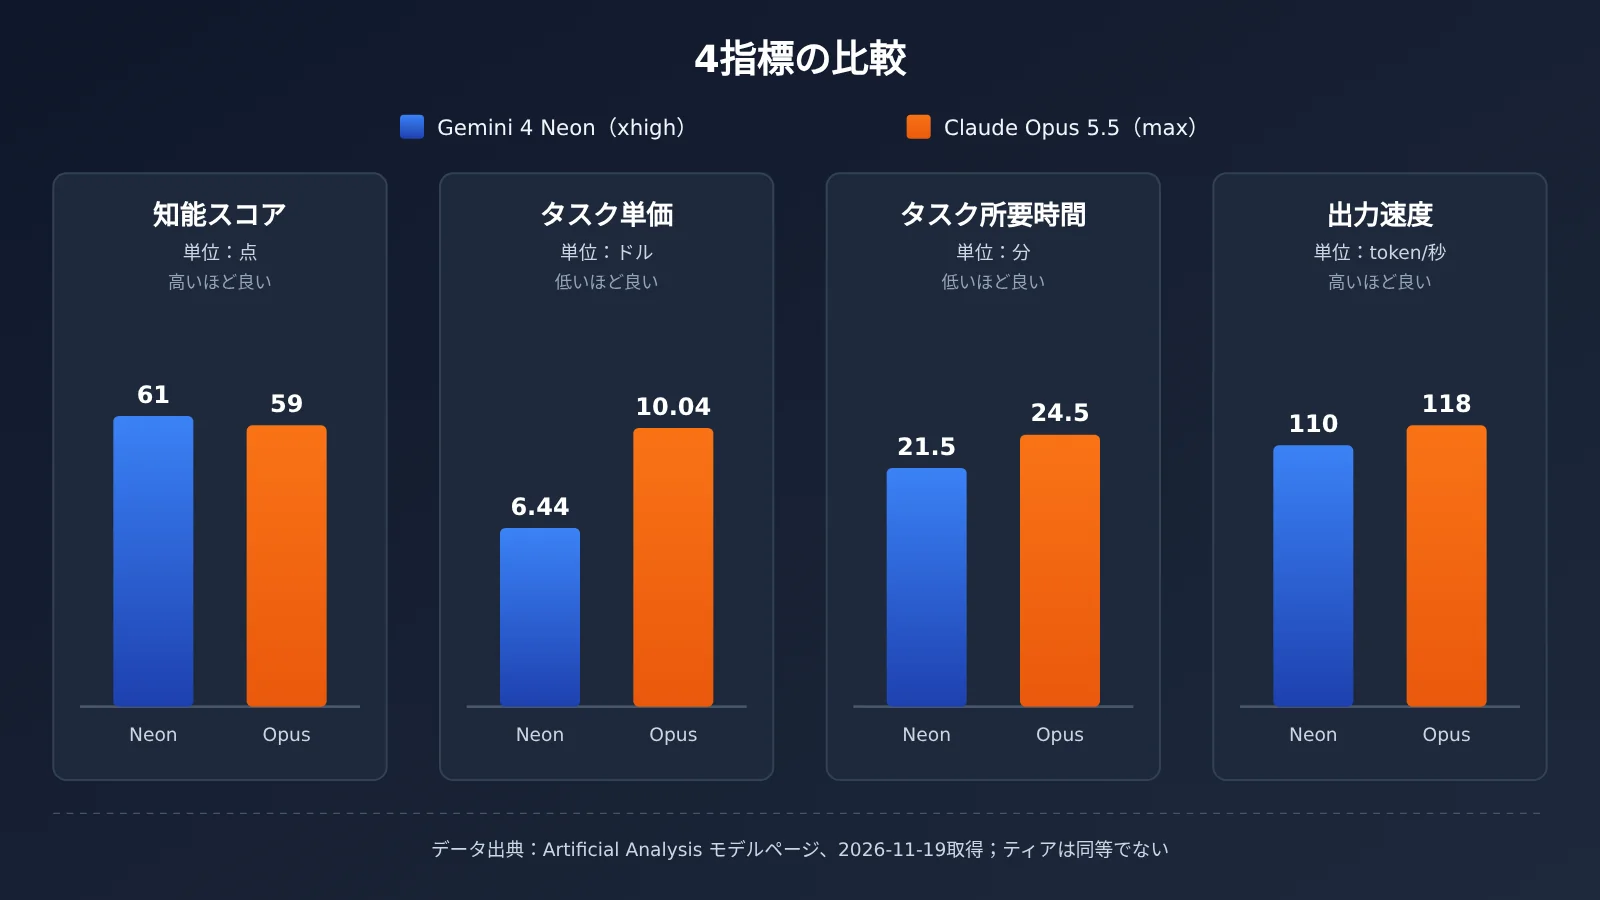
📊 図表の説明:上記の数値は Artificial Analysis モデルページに由来し、サードパーティが指数を実行した際の記録を反映しています。APIYI apiyi.com で Claude Opus 5.5 を呼び出す場合は、プラットフォームのモデル一覧と定価を基準にしてください。
タスクあたりのコスト:ベンチマーク上の計算
タスクあたり6.44ドル対10.04ドルというコストは、Artificial Analysisがインデックスを実行した後に換算した費用で、ベンチマーク上の計算値であり、APIYIでの請求額とは異なります。この数値は単価と使用量の両方に依存します。モデルページのデータによると、Neonはインデックス実行時に2億8,300万トークンを出力し、Opusの2億1,800万トークンより多いものの、単価は3/15ドルで、Opusは4/20ドルです。実際の費用は、自身のタスクの入力長、出力長、キャッシュヒット率によって決まります。
所要時間、出力速度、ファーストトークン時間
出力速度はOpusの方が高く、118対110トークン/秒です。しかしタスクあたりの所要時間はNeonの方が短く、21.5対24.5分となっています。この2組の数値は矛盾しません。所要時間にはファーストトークンの待ち時間と総出力量も含まれるからです。モデルページによると、Opus maxの最初の回答トークンは335.85秒、Neon xhighは56.51秒です。インタラクティブなシーンでは、ファーストトークン時間の方がスループットよりも体感に大きく影響します。
同一ティアでの比較とコーディングスコア
ティアを下げると、モデルページの数値も連動して変わります。Neon high は 60 点、14.8 分、101 トークン/秒、Opus xhigh は 57 点、16.1 分、107 トークン/秒、Opus high は 52 点、9.3 分、108 トークン/秒です。Neon の high、medium、low の3ティアでは、初回トークンまでの時間がそれぞれ 40.64 秒、20.14 秒、13.93 秒です。この数値群はモデルページの FAQ に由来し、上記の集計表とは別の欄に記載されています。
コーディングに関しては、Artificial Analysis の記事で Coding Agent Index が示されています。Neon xhigh は Antigravity CLI 上で 59、Opus 5.5 max は Claude Code 上で 58 で、両者は異なる CLI で実行されています。Google のブログでは 58.6 と書かれており、これは公式の自己申告値で、記事中の 59 とは別の数値です。同じ記事では、コーディング1タスクあたりのコストも示されており、Neon は 6.86 ドル、Opus 5.5 max は 12.61 ドルです。
Gemini 4 Neon と Claude Opus 5.5 のユースケース別推奨
以下は上記の数値に基づく判断で、推奨であって事実ではありません。ご自身のタスクサンプルと照らし合わせて確認してください。
Gemini 4 Neon を選びたいシーン
- オーディオや動画を直接入力する場合:モデルカードによると、Neon はオーディオと動画をサポートし、Opus の入力はテキストと画像です。
- 超長コンテキストでの検索・推論:GraphWalks では 95.2% 対 66.8%。Neon の統合ウィンドウは最大 1048576 トークンです(Google Cloud 開発者ガイド)。
- 業務自動化やナレッジワーク向けエージェント:AutomationBench では 56.3% 対 42.5%、Agents’ Last Exam v1.1 では 75.8% 対 71.6% です(モデルカード)。
- 初回トークン待ちに敏感なインタラクション:Artificial Analysis のモデルページによると、Neon xhigh の初回トークンまでの時間は 56.51 秒、Opus max は 335.85 秒です。
Claude Opus 5.5 を引き続き使いたいシーン
- ターミナル操作系のコーディング:Terminal-bench 4.1 では 65.8% 対 65.2% です(モデルカード)。
- FrontierCode 系のコードタスク:47.3% 対 46.2% です(モデルカード、Neon はデフォルトの high)。
- 長い出力のスループット:出力速度は 118 対 110 トークン/秒です(Artificial Analysis モデルページ)。
- Claude Code や messages エンドポイントにすでに深く依存しているワークフロー:移行コスト自体も考慮に入れる必要があります。
APIYI で Claude Opus 5.5 を呼び出す方法と Gemini 4 Neon のステータス確認
APIYI における Claude Opus 5.5 のモデルIDと価格
すでに Opus を使っている方は、APIYI(apiyi.com)で同じキーを使ってモデルIDと価格を確認できます。APIYI の一覧表 docs.apiyi.com/models.md に記載されている更新日時は 2026-11-16 09:39(UTC+8)です。価格API api.apiyi.com/api/pricing は 2026-11-19 に取得したもので、バージョンは shell-api-modelmak-v1、モデル数は 285 件です。
| モデルID | 入力 / キャッシュ読み取り / 出力(100万トークンあたり、米ドル) | エンドポイント | グループ(APIYI 一覧表) | グループ id(価格API) |
|---|---|---|---|---|
claude-opus-5-5 |
4 / 0.2 / 20 | chat、messages | ClaudeCode、Claude_Reverse、Claude_Enterprise、Default、SVIP | ClaudeCode、ClaudeCodeReverse、ClaudeOfficial、default、svip |
claude-opus-5-5-thinking |
4 / 0.2 / 20 | chat、messages | 上記と同じ | 上記と同じ |
gemini-4-neon |
未提供 | — | — | — |
2 つのグループ名は完全には一致していないため、表には両方の表記を残しています。価格API では model_ratio が 1 のとき入力 100万トークンあたり 2 ドルに対応し、completion_ratio が 5 のときは出力単価が入力の 5 倍であることを示します。これは一覧表の最初の区分の書き方と一致しており、このルールを使って上表の価格をご自身で確認できます。
APIYI の一覧表にも価格API にも gemini-4-neon は存在せず、独立したモデルページもありません。現在未提供ですが、できるだけ早くこのモデルを公開する予定です。モデルと価格はプラットフォームのモデル一覧を基準にしてください。参考として、Google AI Studio の価格ページに記載されている Neon の有料価格は、入力 3.00 ドル、出力 15.00 ドル(思考トークンを含む)、キャッシュ 0.15 ドルで、いずれも 100万トークンあたりです。無料枠はなく、暗黙的キャッシュのみをサポートしています。
呼び出し手順
- キーを環境変数(例:
APIYI_API_KEY)に設定します。コード内では環境変数から読み取るだけにして、平文で書かないようにしましょう。 - OpenAI 互換クライアントを使う場合は、base_url を
https://api.apiyi.com/v1に設定します。 modelフィールドにはclaude-opus-5-5またはclaude-opus-5-5-thinkingを指定し、エンドポイントは用途に応じて chat か messages を選びます。- 業務の必要に応じてグループを選択します。グループ名は一覧表と価格API の表記を基準にしてください。
- Neon の提供開始後に比較テストを行う際の注意点:Google Cloud のデベロッパーガイドによると、思考レベルは low、medium、high、xhigh のみで、デフォルトは high です。
thinking_budgetやMINIMALを渡すと HTTP400が返ります。明示的なコンテキストキャッシュはサポートされておらず、暗黙的キャッシュは 4096 トークン以上の共有プレフィックスに対して自動的に有効になります。
🚀 クイックスタート:まずご自身の実タスクを十数件、Opus で実行してベースラインを測り、出力トークン数と所要時間を記録します。APIYI apiyi.com で Neon が提供開始されたら、同じサンプルと同じ思考レベルで比較テストを行えば、自社業務に即したコスト指標が得られます。
Gemini 4 Neon と Claude Opus 5.5 の選択アドバイス
💡 選択のヒント:作業がターミナルやコードタスク中心であれば、モデルカードと Artificial Analysis が示す差はどちらも小さく、Opus は Terminal-bench 4.1 と FrontierCode 2.0 でわずかに上回っているため、乗り換える明確な理由はありません。作業が知識整理、長いコンテキスト、マルチモーダル入力に偏っているなら、モデルカードの多くの項目で Neon のスコアが高く、リリース後できるだけ早く比較テストする価値があります。以上は判断であり、事実ではありません。
コスト面では、Artificial Analysis の 6.44 ドルと 10.04 ドルをそのまま予算の根拠にしないでください。また、Google のブログにある「デフォルト high の単一タスクコストは Carbon より 32% 低い」という記述を Opus に当てはめるのも避けましょう。これは Google 自身のアルゴリズムによる比較であり、比較対象も Opus ではありません。
よくある質問 FAQ
Q1:Gemini 4 Neon はどんな位置づけですか?
Google ブログ(公式の自己申告)と Google Cloud 開発者ガイドによると、Neon は Hydrogen(日常的な高速実行)と Carbon(複雑な長距離タスク)の間に位置し、高頻度の複雑なワークフローを想定しています。モデルカードには Gemini 4 Carbon から改編されたと記載されており、知識のカットオフは 2026 年 3 月です。
Q2:コーディングにおいて Gemini 4 Neon と Claude Opus 5.5 ではどちらの数値が高いですか?
項目ごとに見る必要があります。モデルカードでは Opus が Terminal-bench 4.1(65.8% 対 65.2%)と FrontierCode 2.0(47.3% 対 46.2%)で上回り、Neon は CursorBench 4.1 と SWE-sweep で上回っています。Artificial Analysis の記事にある Coding Agent Index は 59 対 58 ですが、両者は異なる CLI で実行されています。
Q3:知能スコア 61 対 59 は同じティアで比較した結果ですか?
いいえ。これは Neon xhigh 対 Opus max で、それぞれモデルページ上の最高ティアを取ったものです。Neon high(60)と Opus xhigh(57)を比較すると、差の大きさは変わります。知能スコア 61 は Google ブログ、モデルカード、Artificial Analysis の間で一致しています。
Q4:単タスク費用 6.44 ドル対 10.04 ドルは、そのまま自分の請求額とみなせますか?
いいえ。これは Artificial Analysis が指数を計測した際のランキング上の数字で、同社のタスクセットと出力トークン量に依存します。実際の請求額は、あなた自身の入力・出力・キャッシュ使用量と、プラットフォームの価格設定に基づいて計算されます。APIYI(apiyi.com)では、Opus の価格は入力 4 ドル、キャッシュ読み取り 0.2 ドル、出力 20 ドル(100万トークンあたり)です。
Q5:今 APIYI で Gemini 4 Neon を呼び出せますか?
APIYI の一覧表(2026-11-16 更新)と価格インターフェース(2026-11-19 読み取り)のいずれにも `gemini-4-neon` はありません。まだ未上架ですので、このモデルはできるだけ早く上架します。型番と価格はプラットフォームのモデル一覧を基準にしてください。現時点では apiyi.com で `claude-opus-5-5` を使ってベースラインのサンプルを実行し、後の比較に備えることができます。
Q6:なぜ Opus は出力速度が速いのに、単タスクの所要時間は長いのですか?
所要時間には最初のトークンまでの待ち時間が含まれます。Artificial Analysis のモデルページによると、Opus max の最初の回答トークンは 335.85 秒、Neon xhigh は 56.51 秒です。出力速度は、出力が始まった後のスループットのみを反映します。
Q7:これらの比較にはどのような限界がありますか?
モデルカード内の Gemini 以外の結果は、デフォルトで各社の自己申告によるものです。Coding Agent Index には 58.6 と 59 の 2 バージョン、MKA には 56.5% と 56% の 2 バージョンがあり、本文ではいずれもそのまま保持しています。SWE-sweep の 12.8% と 39.0% は 2 種類の harness に由来します。Google ブログの順位と安全に関する数字は公式の自己申告であり、第三者による再テストの結果ではありません。
Gemini 4 Neon と Claude Opus 5.5 の要点まとめ(Key Takeaways)
- 数値は双方に優位な項目がある:Neon はモデルカードの多くの項目と知能スコアで上回り、Opus は2つのコーディングスコアと出力速度で上回っています。
- モデルカードは公式のまとめ:Gemini 以外の結果は各社の自己申告によるもので、同日に再計測したものではありません。
- 設定(ティア)は明記が必要:知能スコアの比較は Neon xhigh 対 Opus max です。
- タスク単価はランキング上の計算値:6.44 対 10.04 ドルは、プラットフォームの請求額とは異なります。
- モダリティに違いがある:Neon は音声と動画を入力できますが、Opus はテキストと画像です。
- 利用開始の方法:Opus はすでに APIYI で提供中、Neon は未提供です。プラットフォームのモデル一覧を基準にしてください。
まとめ
Gemini 4 Neon と Claude Opus 5.5 の比較は、コーディングとナレッジワークに分けて見る必要があります。
- コーディング系:Opus は Terminal-bench 4.1 と FrontierCode 2.0 でわずかに高く、Neon は CursorBench 4.1 と同一ハーネスでの SWE-sweep で上回っています。
- ナレッジワーク系:モデルカードの多くの項目で Neon が高く、GraphWalks と AutomationBench の差が最も顕著です。
- Artificial Analysis の4つの数値:知能スコア 61 対 59、タスク単価 6.44 対 10.04 ドル、所要時間 21.5 対 24.5 分、出力速度 110 対 118 token/秒、設定は Neon xhigh 対 Opus max です。
まず自分のタスクサンプルで Opus のベースラインを構築し、Neon が提供開始されてから同じ設定で比較することをおすすめします。APIYI(apiyi.com)では claude-opus-5-5 と claude-opus-5-5-thinking の価格とグループを確認でき、同じ Key で呼び出しとその後の切り替えが可能です。
📚 参考資料
-
Sundar Pichai の投稿:Gemini 4 Neon の提供チャネル
- リンク:
x.com/sundarpichai/status/2123167780988125621 - 内容:公式が自己申告した提供範囲
- リンク:
-
Google ブログ「Introducing Gemini 4 Neon」:公式が自己申告したベンチマーク、価格、セキュリティの数値
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 内容:Coding Agent Index 58.6、SWE-sweep のハーネスに関する説明
- リンク:
-
DeepMind モデルカード:3列の比較表と評価の説明
- リンク:
deepmind.google/models/model-cards/gemini-4-neon/ - 内容:Gemini 以外の結果は、特記がない限り各社の自己申告によるもの
- リンク:
-
Google Cloud デベロッパーガイド:モデル ID、思考レベル、キャッシュのルール
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 内容:HTTP 400 が発生する条件
- リンク:
-
Google AI Studio 料金ページ:Neon の有料価格
- リンク:
aistudio.google.com/docs/pricing - 内容:無料枠はなく、暗黙的キャッシュのみをサポート
- リンク:
-
Artificial Analysis の記事:Neon の知能スコアとコーディング単一タスクあたりのコスト
- リンク:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 内容:第三者による測定、Coding Agent Index 59
- リンク:
-
Artificial Analysis のモデルページ:Neon と Opus 5.5 の階層別データ
- リンク:
artificialanalysis.ai/models/gemini-4-neon、artificialanalysis.ai/models/claude-opus-5-5 - 内容:2026-11-19 時点で取得、インデックス v5.0.1
- リンク:
作者:APIYI 技術チーム
技術的なお問い合わせ:APIYI のウェブサイトのトップページからお気軽にご連絡ください。モデルと価格はドキュメントセンター docs.apiyi.com でご確認いただけます