著者注:GPT-6.2 Astra と Claude Fable 5.2 について、サードパーティ総合ランキング、公式自己申告の個別タスク、公定価格という三層に分けて分析し、キャッシュ読み込みの違いと、APIYI で現在どのモデルを呼び出せるかを明確にします。
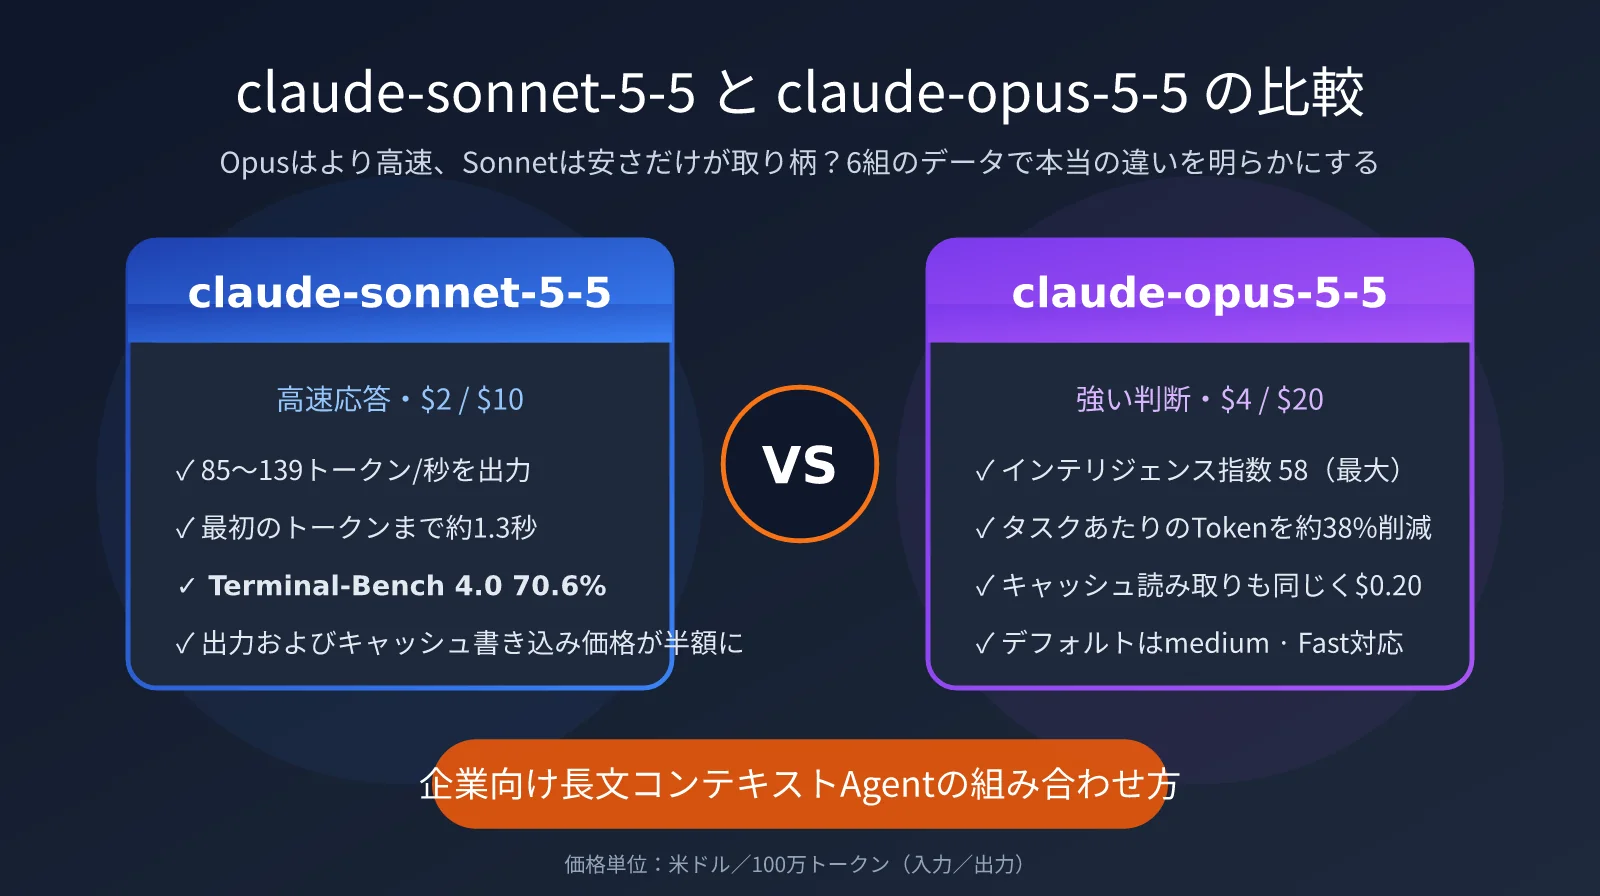
2026年11月17日、OpenAI は GPT-6.2 Astra と GPT-6.2 Sol を発表しました。約1週間前の2026年11月9日、Anthropic のドキュメントで Claude Fable 5.2 が公開されています。両フラッグシップモデルのショートコンテキスト入力および出力の公定価格は、いずれも100万トークンあたり8ドルと40ドルです。そのためモデル選定の議論は、自然と GPT-6.2 Astra と Claude Fable 5.2 の間に集中しています。
問題は、二種類のランキングが示す方向性が一致していないことです。サードパーティの Artificial Analysis の総合指数では、Fable 5.2 のスコアがより高くなっています。一方、OpenAI の発表文で自己申告されたいくつかの専門タスクでは Astra がリードしており、さらに公式が示すタスクあたりのコストも低くなっています。二組の数値を混ぜ合わせてしまうと「どちらがより強力か」という結論を導いてしまいますが、その結論はどちらのデータにも裏付けられていません。
これはどちらが勝ったかを宣言する記事ではありません。本記事では数値を三層に分けます。サードパーティ総合ランキング、公式自己申告の個別項目、公定価格です。各層を個別に見たうえで、最後に APIYI で現在どのモデルを呼び出せるかを説明します。
核心的な価値:本記事を読み終えると、自分が関心を持つタスクに応じて対応するランキングを確認でき、キャッシュ読み込み価格の違いを明確に把握し、両モデルの現在の接続状況を知ることができます。
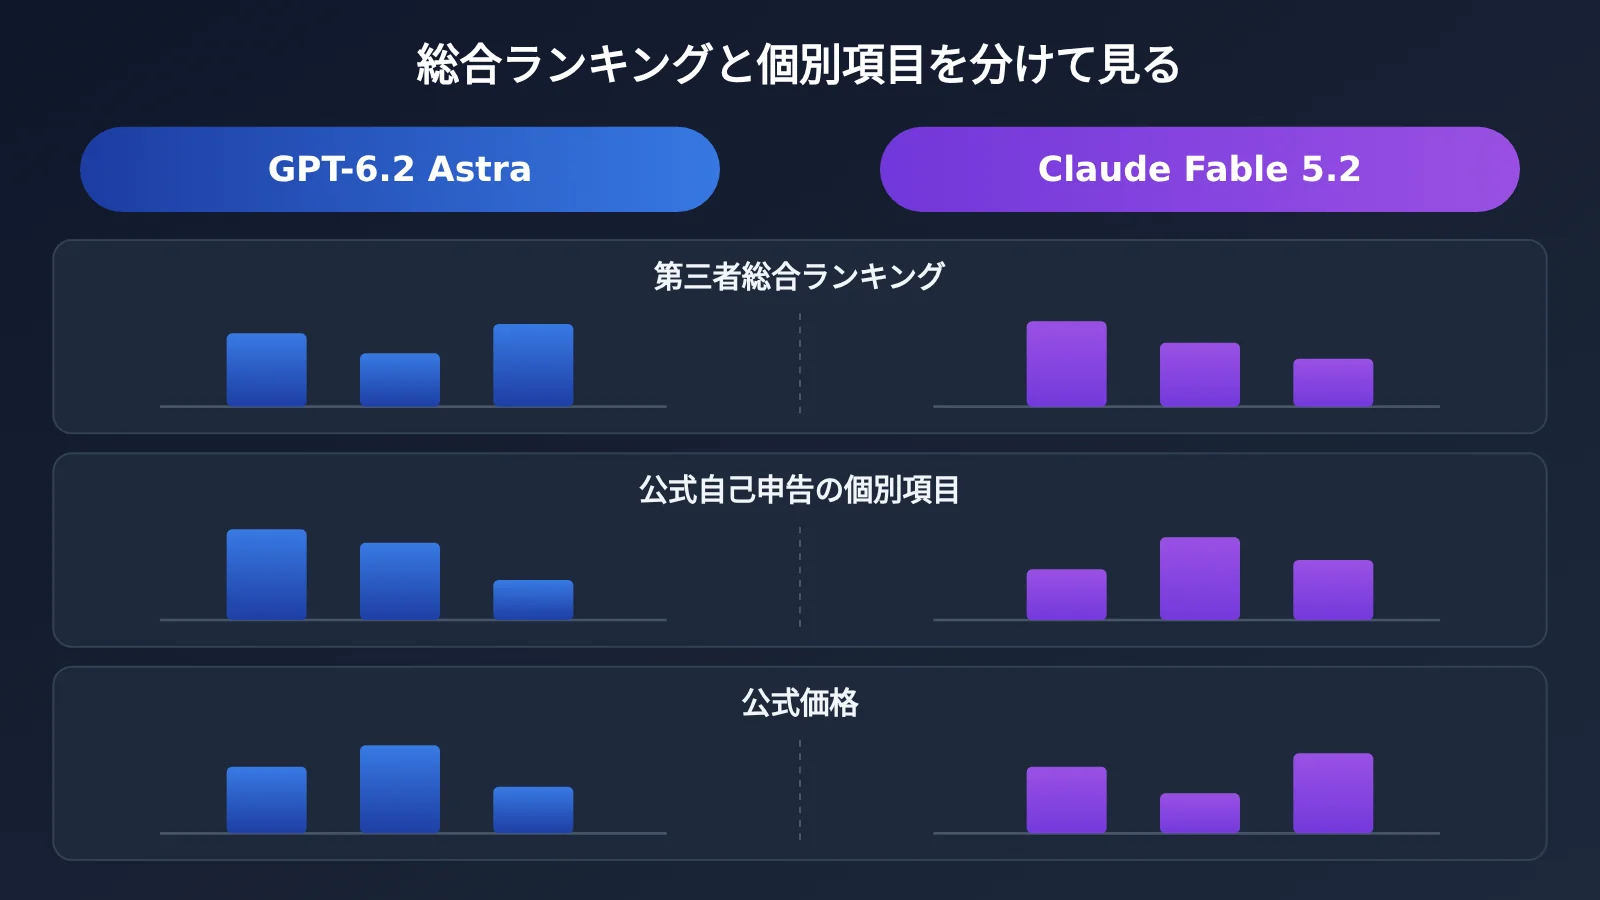
GPT-6.2 Astra と Claude Fable 5.2 の核心ポイント:3層の数字を混同しないこと
GPT-6.2 Astra と Claude Fable 5.2 を比較するとき、いちばん間違えやすいのが、出典の異なる数字を同じ結論にまとめてしまうことです。以下の表では、まず3層の情報について出典の性質と見方を分けて整理します。
| 数字の層 | 出典の性質 | この層が示す方向 | 利用時の注意 |
|---|---|---|---|
| 総合ランキング | 第三者機関 Artificial Analysis による Intelligence Index v5.0.1 | Fable 5.2 は 65、Astra(Max)は 62 | 推論レベルを必ず明記する。レベルによってスコアは大きく異なる |
| 個別タスク | OpenAI の発表記事による公式の自己申告。AA-3D は公式が伝えた第三者ブラインド評価 | Agents’ Last Exam、Harvey LAB-AA、AA-3D では Astra が先行 | ALE のランキングで Fable は9項目の予備モデルタスクを含まない |
| 公表価格 | 両社の公式モデルページとドキュメント | 入力・出力は同価格、キャッシュ読み込みは Fable が安い | キャッシュ書き込みの保持期間が異なり、長いコンテキストのルールも異なる |
GPT-6.2 Astra と Claude Fable 5.2 が「それぞれ別の項目で先行」するのはなぜか
総合指数は、固定されたタスク群における平均的なパフォーマンスを見るもので、重みは第三者が設定しています。一方、OpenAI の発表記事が取り上げているのは、長期的な専門ワークフロー、法務、3D 生成といった具体的なシナリオであり、テストの設定は公式が決めています。両者が答える問いは、そもそも異なります。前者は平均水準を見ており、後者は特定のワークフローでの性能を見ているのです。結論が一致しないからといって、どちらかのデータに問題があるわけではありません。
コストも同じ構図です。Artificial Analysis が示す「タスクあたりのコスト」は、同社の総合指数タスクを実行するのにかかる費用です。OpenAI が言う「ALE のコストは Fable の約5%」は、別のタスク群・別の算出基準による数字です。この2つは割ることも、相互に換算することもできません。
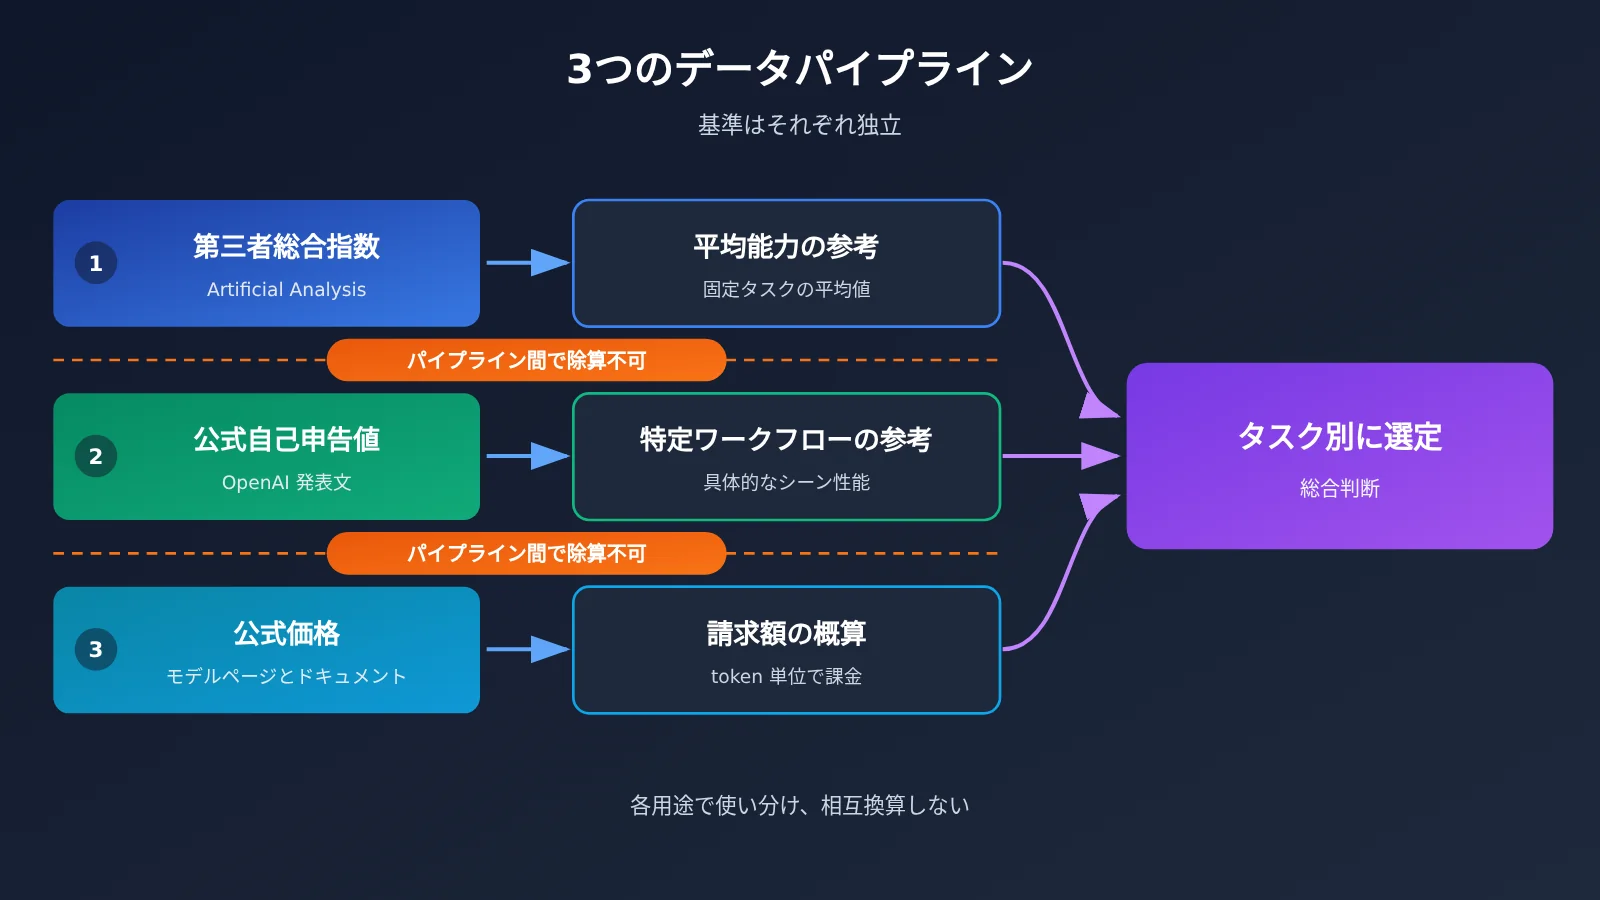
GPT-6.2 Astra と Claude Fable 5.2 の核心的な違い:第三者総合ランキング
Artificial Analysis は 2026-11-17 に記事を公開し、モデルページを更新しました。以下のスコアはすべて Intelligence Index v5.0.1 によるもので、第三者評価であり、いずれの当事者による自己申告でもありません。
| モデル | 推論ティア | Intelligence Index v5.0.1 | 総合指数あたりの単一タスクコスト(各モデルページ) |
|---|---|---|---|
| Claude Fable 5.2 | 最高推論ティア | 65(ランキング1位) | 26.54ドル |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4.00ドル(Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1.01ドル(Max) |
| Gemini 4 Carbon | 最高ティア | 60 | — |
| Claude Opus 5.5 | 最高ティア | 59 | — |
この第三者ランキングでは、Fable 5.2 の総合スコアは Astra の最高ティアを3ポイント上回っています。Astra は前世代の GPT-6 Astra より5ポイント高く、Gemini 4 Carbon や Claude Opus 5.5 の最高ティアも超えています。また注意したいのは、Astra を Low ティアまで下げると46ポイントしか出ない点です。コスト削減のために推論強度を落とす場合、62ポイントの性能を前提にしてはいけません。
Artificial Analysis の記事には、いくつかの細分化された結果も掲載されており、これらも第三者データです。AA-Robotics v0.1 の研究プレビューでは、Astra が79、Fable 5.2 が75でした。科学系タスクでは、Astra は Terminal-Bench-Science 0.1 でリードし、CritPt v2 のハードサブセットでは Fable 5.2 に次ぐ結果でした。Coding Agent Index(Codex harness、max)では、Astra は GPT-6 Astra と同等です。AA-Omniscience のハルシネーション率(Max)に関しては、Astra は59%です。
GPT-6.2 Astra と Claude Fable 5.2 の中核的な違い:公式自己申告の個別項目
以下の数値は OpenAI の発表文とモデルページに由来し、すべて公式自己申告です。発表文で絶対スコアが示されていない項目については、本記事でも相対的な差だけを記載します。
| 個別タスク | 公式自己申告の結果 | 公式が示したコスト算定基準 | 確認すべき脚注 |
|---|---|---|---|
| Agents’ Last Exam(長期的な専門ワークフロー) | Astra は Fable 5.2 より 5.5 ポイント高い | コストは Fable の約 5% | ランキング上の Fable 5.2 は、代替モデルを使用した9項目のタスクを含まない |
| Harvey LAB-AA v1.1(法律) | Astra の合格率は Fable 5.2 の2倍超 | コストは約6分の1 | 発表文では絶対合格率が示されていない。弁護士向けの「Astra for Law」構成はより高スペック |
| AA-3D(人手によるブラインド評価 Elo) | Astra 1318、Fable 5.2 1271、Sol 1259 | 未提供 | 第三者によるブラインド評価だが、公式発表文による転述 |
| Terminal-Bench-Science 0.1 | Astra は GPT-6 Astra より 9 ポイント高い | コストは前世代の3分の1未満 | Fable には2つの数値があり、異なるテストに由来。後述参照 |
Agents’ Last Exam の脚注については個別に説明が必要です。OpenAI は、ランキング上の Fable 5.2 の結果には代替モデルを使用した9項目のタスクが含まれていないと明記しています。この「5.5 ポイント高」を読む際は、両者のタスクカバー範囲が完全には同一でないことを理解しておく必要があります。
Terminal-Bench-Science 0.1 では、Fable 5.2 に由来の異なる2つの数値があります。1つは Artificial Analysis によるもので、mini-swe-agent を使用しています。もう1つは Anthropic の自己申告による 74.6% で、テスト環境は Claude Code、Max 推論強度です。この2つの数値は同一テストの結果ではなく、相互に代替できませんし、Astra と直接比較することもできません。
AA-3D の 1318 と 1271 自体は第三者による人手ブラインド評価の Elo ですが、本記事で引用しているのは OpenAI 発表文による転述です。引用する際は「公式が転述した第三者ブラインド評価」と書くのが望ましく、純粋な公式自己申告とも、本記事の著者が独自に検証したものとも書かないでください。
💡 選定のアドバイス:個別項目のランキングは、タスクの種類が読者の業務に近い場合にのみ参考価値があります。Fable 5.2 はすでに APIYI apiyi.com 経由で呼び出せるため、まず実際のサンプルで一度実行し、そのうえで上記2つの表を組み合わせて判断してください。
GPT-6.2 Astra と Claude Fable 5.2 の公式価格比較:キャッシュ読み取りが異なる
公式価格によれば、両モデルの短いコンテキストにおける標準価格は入力・出力ともに完全に同一で、違いはキャッシュ関連項目と長いコンテキストのルールに集中しています。以下の表の価格はすべて米ドル/100万トークン単位です。
| 料金項目 | GPT-6.2 Astra(OpenAI 公式) | Claude Fable 5.2(Anthropic 公式) | 利用可能プラットフォーム(APIYI 総合表 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| 入力 | 8 | 8 | Astra は未掲載、Fable は 8 |
| 出力 | 40 | 40 | Astra は未掲載、Fable は 40 |
| キャッシュ読み取り | 0.40 | 0.20 | Astra は未掲載、Fable は 0.2 |
| キャッシュ書き込み | 10(30分間保持)、20(12時間) | 10(5分)、16(1時間) | プラットフォームの一覧を参照 |
| コンテキスト/最大出力 | 1,050,000/128,000(最大入力 922,000) | 1M/128K | — |
| Batch | 標準価格の 50% | 入力・出力ともに半額 | — |
GPT-6.2 Astra の OpenAI 公式価格は、入力 8 ドル、キャッシュ読み取り 0.40 ドル、出力 40 ドルです。現在は未掲載ですが、このモデルはできるだけ早く掲載します。モデル名と価格はプラットフォームのモデル一覧を基準にしてください。 APIYI のモデル総合表 docs.apiyi.com/models.md および公開価格 API では、2026-11-17 時点で gpt-6.2-astra を確認できません。すでに掲載済みの gpt-6-astra(短いコンテキストで 10/50/1)を使って 6.2 の価格を見積もらないでください。この2つは同じモデルではありません。
キャッシュ読み取りの差は、Agent や長い会話のシナリオに大きな影響を与えます。同じく1億トークンのキャッシュを読み取る場合、公式価格では Astra が 40 ドル、Fable 5.2 が 20 ドルです。システムプロンプトが非常に長い場合や、同じドキュメント群を繰り返し参照する場合、この項目は請求額にそのまま反映されます。キャッシュ書き込みは表面上どちらも 10 ドルですが、Astra は30分間保持、Fable は5分間保持となるため、ヒット率はリクエストの間隔に左右されます。単価だけを比較するのは適切ではありません。
長いコンテキストのルールも異なります。Astra のモデルページには、1回のリクエストで入力が 272K トークンを超えると、入力とキャッシュの単価が倍になり、出力は短いコンテキスト価格の1.5倍となり、さらに請求全体がこの価格で計算されると明記されています。本記事で参照した Fable の価格表の抜粋には同様の段階設定はないため、接続前に Anthropic のドキュメントでご自身で確認してください。
高速化オプションも両者で異なります。Astra の Fast は標準価格の2倍、Ultrafast は 2027-02-28(太平洋時間)までは3倍、2027-03-01 以降は6倍になります。Fable の Fast モードは最大約2.5倍速で、価格は入力 16 ドル、出力 80 ドルです。
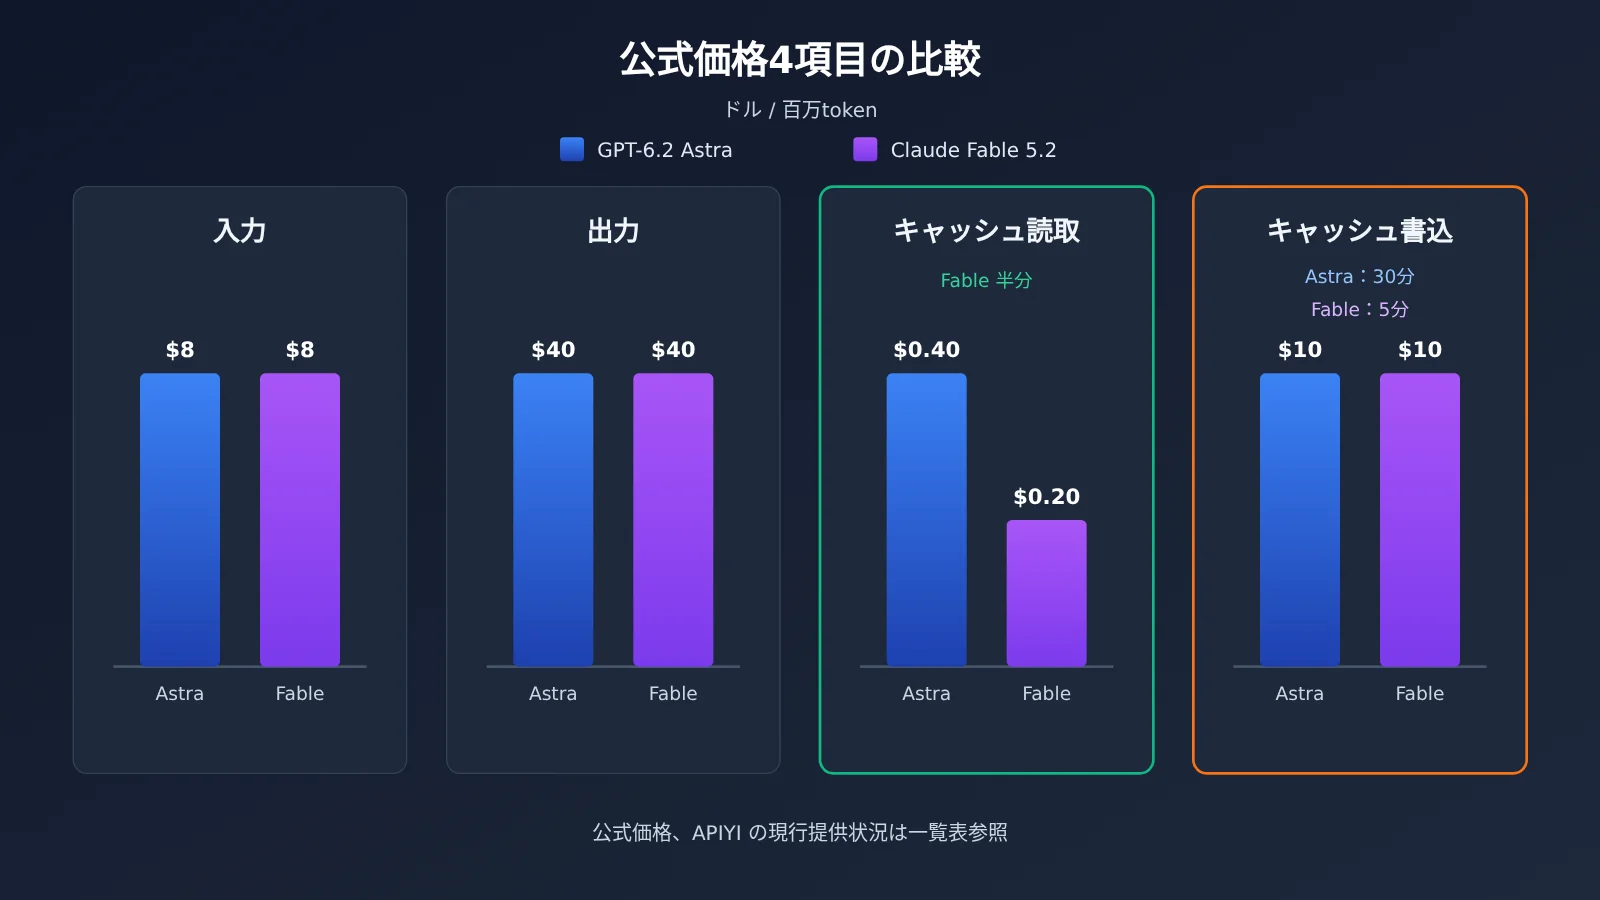
🎯 データについて:上図は両社の公式価格のみを示しています。プラットフォームで実際に呼び出せるモデルと価格は、APIYI apiyi.com のモデル一覧を基準としてください。Astra 6.2 は現在リストにありません。
GPT-6.2 Astra と Claude Fable 5.2 のシーン別推奨
以下では「この項目のランキングが何を示しているか」に応じてシーンを対応づけ、全体としての優劣については結論を出しません。
GPT-6.2 Astra を優先的に評価すべきシーン
- 長期的な専門ワークフロー:公式が自己申告した Agents’ Last Exam では Astra がリードしていますが、Fable が9項目のタスクを含まないという脚注も考慮する必要があります。
- 法律文書系のタスク:公式の自己申告では Harvey LAB-AA v1.1 の通過率が Fable の2倍を超えており、重点的にテストする方向性として有効です。
- 3D生成に関連する嗜好評価:公式が引用した AA-3D ブラインド評価の Elo は 1318 対 1271 です。
- 総合指数の単一タスクコストを気にする場合:サードパーティのページ上では Astra(Max)は 4.00 ドルですが、これは総合指数のタスク群にのみ当てはまります。
Claude Fable 5.2 を優先的に評価すべきシーン
- 総合能力で底上げしたい汎用アプリケーション:サードパーティの総合指数では Fable 5.2 が 65 で、ランキング1位です。
- キャッシュ読み取りの比率が高いアプリケーション:キャッシュ読み取りの表示価格は 0.20 ドルで、Astra の半分です。
- すぐに接続する必要がある場合:
claude-fable-5-2とclaude-fable-5-2-thinkingはすでに APIYI の総合表にあります。
| 注目点 | まずどの層を見るか | この層の方向性 | 補足の注意点 |
|---|---|---|---|
| 平均能力 | サードパーティ総合ランキング | Fable 5.2 が高い | 推論グレードに注意 |
| 専門ワークフロー / 法律 | 公式自己申告の個別項目 | Astra がリード | 自己申告データのため脚注を確認 |
| 長い対話のキャッシュコスト | 公式の表示価格 | Fable はキャッシュ読み取りがより低い | キャッシュ書き込みの保持期間が異なる |
| 現時点で呼び出せるか | APIYI 総合表 | Fable のみ提供中 | Astra 6.2 は提供開始待ち |
GPT-6.2 Astra と Claude Fable 5.2 クイックスタート:3ステップの判断
ステップ1:まず確認したい項目のランキングを見る
まず、自分の業務がどの種類のタスクに当たるかを決めます。汎用アシスタントや混合タスクなら、Artificial Analysis の総合指数を参考にし、自分が使う予定の推論レベルをメモしておきましょう。長距離 Agent、法律、3D なら、OpenAI が自己申告している該当する個別項目を参考にし、あわせて脚注も読みます。総合ランキングのスコア差と個別項目ランキングのスコア差を足し合わせて「合計点」にしてはいけません。
ステップ2:次にキャッシュ読み取りを見る
リクエストの中で、どれくらいの割合が繰り返しのプレフィックス(システムプロンプト、ナレッジベースの断片、複数ターンの会話履歴など)なのかを見積もります。キャッシュ読み取りの割合が高いほど、0.20 と 0.40 の差はより顕著になります。1回の入力がよく 272K を超える場合は、Astra のリクエスト全体への追加料金ルールも計算に入れておきましょう。
ステップ3:最後に APIYI で今どれを呼び出せるかを見る
現時点で APIYI の総合一覧表から呼び出せるのは Fable 5.2 で、モデル ID は claude-fable-5-2 です。明示的な思考バージョンが必要な場合は claude-fable-5-2-thinking を使います。価格は入力 8、出力 40、キャッシュ読み取り 0.2 で、エンドポイントは chat と messages に対応しています。このモデルの説明ページは現在 404 を返しているため、価格は総合一覧表を基準にしてください。
OpenAI 互換方式で接続する場合は、SDK で base_url を https://api.apiyi.com/v1 に設定し、model には claude-fable-5-2 を指定します。その他のパラメータは通常の Chat Completions 呼び出しと同じです。注意すべき点として、Fable 5.2 の思考機能は常に有効で無効にできず、デフォルトの effort は high です。将来 Astra に切り替える場合、その API は reasoning effort を none に設定することを受け付けません。
🚀 クイックスタート:まず APIYI apiyi.com の無料テスト枠を使って、自分のサンプルで
claude-fable-5-2をテストし、出力品質とキャッシュヒット状況を記録することをおすすめします。gpt-6.2-astraが公開されたら、同じサンプル群でもう一度テストすると、比較がより公平になります。
よくある質問 FAQ
Q1:GPT-6.2 Astra と Claude Fable 5.2 はそれぞれ何ですか?
GPT-6.2 Astra は、OpenAI が 2026年11月17日にリリースしたフラッグシップモデルで、モデルIDは `gpt-6.2-astra` です。同時に、より安価な GPT-6.2 Sol もリリースされています。Claude Fable 5.2 は Anthropic のモデルで、ドキュメントの公開日は 2026年11月9日です。両モデルとも約1Mのコンテキストと最大128Kの出力に対応しています。
Q2:GPT-6.2 Astra と Claude Fable 5.2 は、どちらが強いのですか?
現時点のデータだけでは一概に答えられません。第三者の総合指数では、Fable 5.2 の65点が Astra(Max)の62点を上回っています。OpenAI 公式が自己申告した ALE、Harvey、および公式が伝える AA-3D ブラインド評価では Astra がリードしています。自分のタスク種別に応じて、該当する層のデータを見るべきです。
Q3:ALE の「コスト5%」と Artificial Analysis の1タスクあたりコストを相互に裏づけにできますか?
できません。「約5%」は OpenAI が Agents’ Last Exam で自己申告した基準です。4.00ドルと26.54ドルは Artificial Analysis が総合指数を測定するタスク群を実行した際のコストです。両者はタスクも基準も異なるため、割り算も相互検証もできません。
Q4:GPT-6.2 Sol のデータは第三者によるものですか?
いいえ。Sol は OpenAI 自身のモデルで、発表文にある Sol の数値はすべて公式の自己申告です。Artificial Analysis も Sol を個別に測定しており、Max 枠で57点、この部分が第三者データです。Sol の公式価格は入力2、キャッシュ読み取り0.10、出力10です。まだ掲載されていませんが、できるだけ早くこのモデルを掲載します。モデルと価格はプラットフォームのモデル一覧を基準にしてください。
Q5:現在、API から Claude Fable 5.2 を呼び出すにはどうすればよいですか?
APIYI apiyi.com に登録して APIキーを取得し、OpenAI 互換 SDK で base URL を `https://api.apiyi.com/v1` に設定し、モデルには `claude-fable-5-2` を指定します。Anthropic ネイティブプロトコルを使う場合は、messages エンドポイントを利用できます。
Q6:GPT-6.2 Astra にはどのような既知の制限がありますか?
公式説明によると、Astra は準備フレームワークにおけるサイバーセキュリティの「重大」レベルに達しており、防御がより厳格で、合法的な脆弱性研究リクエストの一部が拒否されます。アラインメント評価では、2つのテストにおいて、ファイル欠落や検索ツール利用不可など、作業を妨げる問題を見落としやすい傾向があります。第三者の AA-Omniscience 幻覚率(Max)は59%です。また、音声・動画入力には対応しておらず、Realtime とファインチューニングにも対応していません。
Q7:12月以降、表示価格は変わりますか?
本記事の参考資料では、両モデルとも12月の価格改定は発表されていません。変わるのは Astra の Ultrafast 倍率です。2027年3月1日から3倍から6倍に調整されます。プラットフォームでの実際の課金は APIYI apiyi.com のモデル一覧を基準にしてください。
GPT-6.2 Astra と Claude Fable 5.2 の核心ポイント Key Takeaways
- 総合ランキングは第三者評価を見る:AA Intelligence Index v5.0.1 では Fable 5.2 が 65、Astra(Max)が 62 です。
- 個別項目は公式の自己申告を見る:ALE、Harvey、そして公式が伝える AA-3D では Astra がリードしていますが、脚注を読む必要があります。
- 2種類のコストは割り算して比べられない:ALE の約 5% と AA の単一タスクあたりコストは、タスクも基準も異なります。
- 入力と出力が同価格:両モデルともショートコンテキストでは 8 / 40 ドル、キャッシュ読み取りはそれぞれ 0.40 と 0.20 です。
- Astra は長コンテキストで段階制:1回の入力が 272K を超えると、リクエスト全体がより高い単価で課金されます。
- 提供状況が異なる:Fable 5.2 は APIYI apiyi.com の総合一覧にすでに掲載済みで、Astra 6.2 は掲載待ちです。
まとめ
GPT-6.2 Astra と Claude Fable 5.2 を比較する際のポイントは、数字の出どころを分けて考えることです。
- 第三者の総合ランキング:Fable 5.2 のほうが高く、引用する際は推論レベルを必ず明記してください。
- 公式の自己申告による個別項目:Astra はいくつかの専門タスクでリードしており、公式が示す単一タスクあたりのコストもより低いですが、これは自己申告のデータです。
- 公式の価格設定:入力・出力は同じ、キャッシュ読み取りは Fable が半額、長コンテキストのルールも異なります。
この2つのモデルは、どの観点でも一方が完全に勝ち抜くというわけではありません。より確実な方法は、まず自分のタスクの種類を絞り込み、次にキャッシュのコストを確認し、最後に実際のサンプルでテストすることです。現在、Fable 5.2 は APIYI apiyi.com 経由で呼び出すことができ、Astra 6.2 は掲載後に同じサンプル群で追加検証できます。このモデルはできるだけ早く掲載します。
📚 参考資料
-
OpenAI の発表記事:GPT-6.2 Astra と Sol のリリースノートおよび公式の自己申告評価
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明:ALE、Harvey、AA-3D などの個別データと脚注の出典
- リンク:
-
OpenAI のモデルページ:GPT-6.2 Astra の仕様と価格
- リンク:
platform.openai.com/docs/models/gpt-6.2-astra - 説明:キャッシュ書き込み価格、272K の課金ルールはこちらを基準としています
- リンク:
-
Artificial Analysis の記事:GPT-6.2 Astra と Sol の第三者評価
- リンク:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - 説明:Intelligence Index v5.0.1 における各推論ティアのスコア
- リンク:
-
Artificial Analysis のモデルページ:Claude Fable 5.2
- リンク:
artificialanalysis.ai/models/claude-fable-5-2 - 説明:総合スコアと総合インデックスにおけるタスク単価コスト
- リンク:
-
Anthropic のドキュメント:Claude Fable 5.2 の概要
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明:価格、キャッシュの読み書き、effort と思考設定
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお問い合わせください。モデルと価格はプラットフォームのモデル一覧を基準とします。