著者注:Artificial Analysis Search Index の 2026-11-09 ランキングによると、回答モデルを固定して検索設定だけを変えた場合、総合スコアは 33 点から 83 点まで変化し得ます。ただし、モデル選定の際にはタスクコスト、所要時間、評価の境界も同時に確認する必要があります。
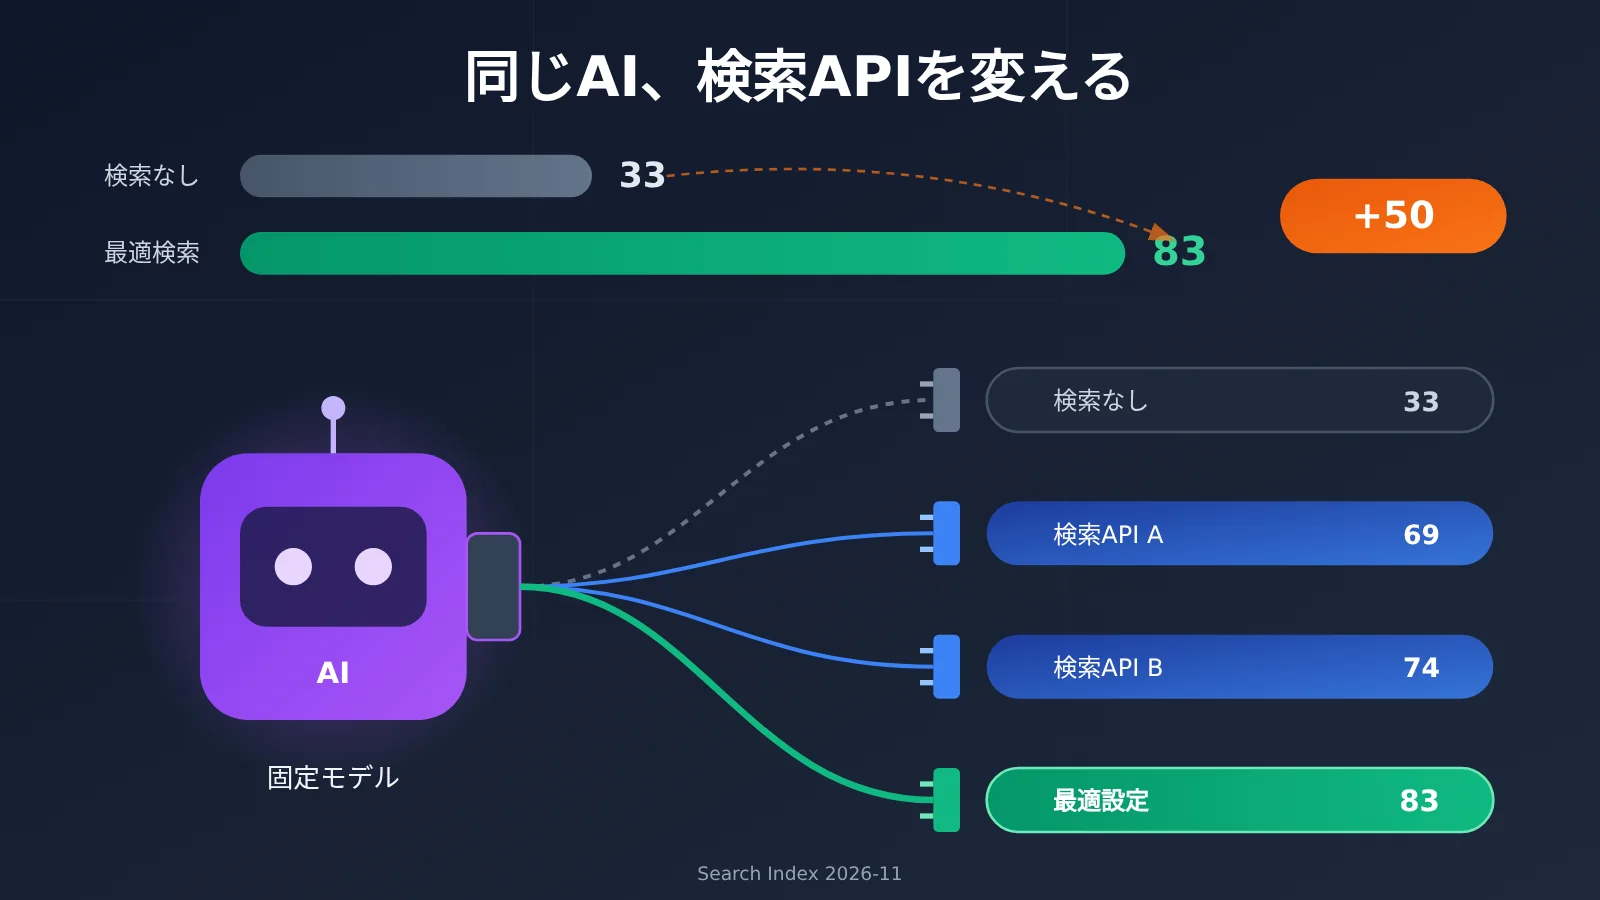
多くの人が Agent を作るとき、まずモデルを選び、その流れで検索ツールを適当に接続します。多くのチームにとって、検索は「ネットに繋がれば十分」な付属品にすぎません。Artificial Analysis が 2026 年 11 月 9 日に更新した Search Index は違う結果を示しています。同じモデルでも、検索を接続しない場合は 33 点、最高の検索 API 設定に変えると 83 点に達する。
これはまた「各社それぞれに長所がある」ランキングの転載ではありません。 本記事では 83 点の計算方法とテスト条件を分解して説明し、品質、タスク全体の所要時間、検索費用とモデル費用を並べて比較します。最後に、このランキングがどのような意思決定に使えるか、どこではそのまま適用できないかをシーン別に説明します。
コアバリュー:本記事を読めば、公開ランキングで検索 API の候補を絞り込み、自分のタスクと組み合わせて二次比較を行い、最高スコアだけで判断することを避けられます。
検索APIランキングを読み取る前に知っておきたい用語
一言まとめ:Search Indexは同じモデルを異なる検索設定で比較するもので、その差は最大50ポイントに達します。ただし「スコアが高い」ことは「あなたに最適」を意味しません。コスト、所要時間、評価の対象範囲も併せて見る必要があります。
ランキングを読む前に、まず以下の用語を整理しておきましょう。
- Search Index:指定された検索ベンチマークをルールに従って集計した総合スコア。本記事では特にArtificial Analysisの検索API評価指数を指し、満点は100です。
- F1:適合率と再現率の調和平均。答えが「一連のエンティティ」である場合に、回答の正確さと網羅性を測る指標です。
- Harness:モデルへの入力、ツール実行、タスクの採点を組織化するテストフレームワーク。Artificial Analysisが使用しているAgentループはStirrupと呼ばれます。
- Search API:クエリに応じてWebページのリンク、タイトル、関連スニペットなどの検索結果を返すインターフェース。例えばExa、Brave、Perplexity Search APIなどがあります。
- Token:モデルがテキストを処理する際の計量単位。検索結果が冗長になるほど、モデルに送り込まれるTokenが増え、モデル費用も高くなります。
検索APIで同じAIが50ポイントも変わることがある?
Artificial Analysisは2026年8月18日に検索APIベンチマークを公開しました。最新の公開データは2026年11月9日に更新され、14社のプロバイダー、26のSearch API製品または構成を対象としています。評価するのはモデルではなく、検索サービスをAgentに組み込んだ後の実際の効果です。
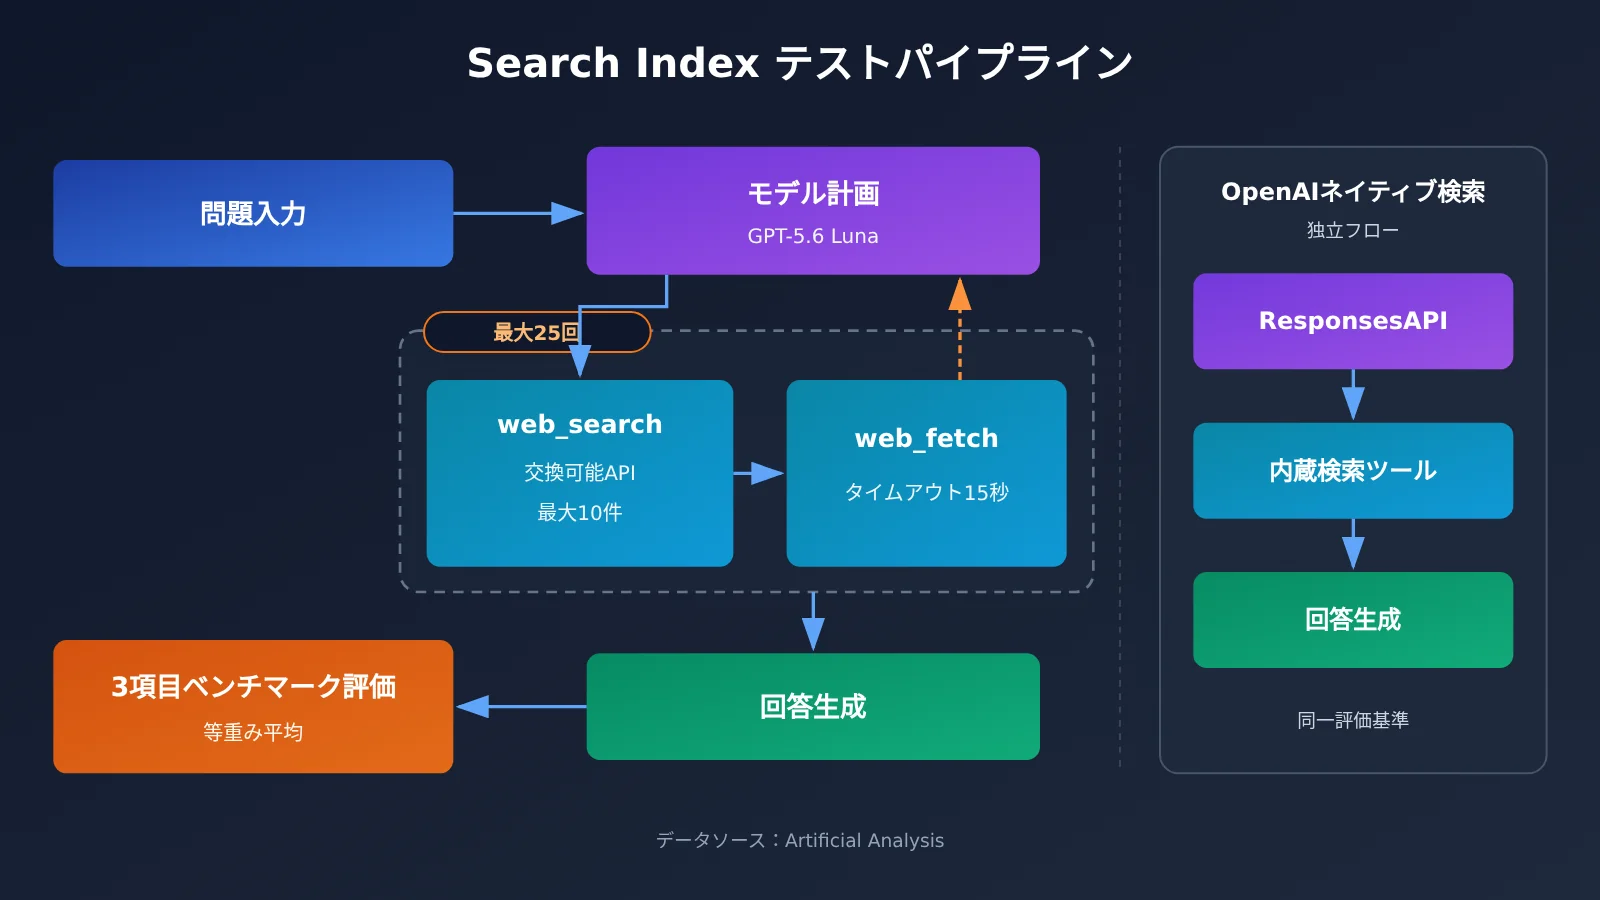
実験設計の要点は「変数の制御」にあります。回答候補のモデルはGPT-5.6 Luna(medium)に固定し、Agentフレームワークも固定したまま、検索サービスだけを差し替えます。この条件下では、検索ツールを使わないベースラインはわずか33点、1位のKeenable Proは83点で、50ポイントの差が生じました。検索を接続した構成同士でも、DeepSeek Search Summaryの69点からKeenable Proの83点まで、14ポイントの差があります。
一つ例外を個別に説明します。OpenAIネイティブのWeb Searchは動作方式が異なります。他の独立系Search APIはすべてArtificial Analysisの外部Agentループ上で動作します。一方、OpenAI Web SearchはResponses APIの組み込みツールフローを使用し、検索回数や実行方式はOpenAI自身が決定します。そのため、その74点は参考にはできますが、まったく同じ条件下での「APIの入れ替え」実験と見なすことはできません。
また、この50ポイントは同一評価体系における検索拡張の効果です。誰もがどのモデルでも検索を接続すれば50ポイント向上する、という意味ではありません。
Search Index の83点は、いったいどうやって測られているのか?
Search Index の3つのベンチマークと採点方式
総合スコアは3つのベンチマークの等権平均で、それぞれが3分の1ずつを占めます。
| ベンチマーク | タスク規模 | タスク種別 | 評価指標 |
|---|---|---|---|
| DeepSearchQA | 900件 | 複雑な事実調査、答えが集合であることが多い | 回答集合のF1 |
| BrowseComp | 200件 | 難度の高いウェブ検索Q&A | 精確回答の正確率 |
| AA-Omniscience | 600件 | 事実Q&A | 事実Q&Aの正確率 |
3項目を合わせると1,700タスクになりますが、総合スコアは1,700問をまとめて正答率を計算したものではありません。Keenable Pro を例に取ると、3項目のスコアは順に 88、87、73 で、平均は約 82.67、四捨五入して 83 と表示されます。つまり、83点は「正答率83%」を意味しません。
Search Index のテスト条件
方法論で公開されている主要な設定は次のとおりです。
| 実験項目 | 実際の設定 |
|---|---|
| 候補回答モデル / 採点モデル | GPT-5.6 Luna(medium) |
| 最大Agentラウンド数 | 25ラウンド、1ラウンド内のツール呼び出し回数は無制限 |
| 利用可能なツール | web_search、web_fetch(独立したウェブページ読み取り) |
| 検索結果ごとの件数 | 最大10件 |
| 本文取得のタイムアウト | 1ページあたり15秒 |
| モデルに返される内容 | サービスプロバイダのネイティブ応答内容 |
| 検索なしのベースライン | 同一モデルで、検索ツールを使用しない |
この表から2つのポイントが読み取れます。第一に、モデルに返されるのは「サービスプロバイダのネイティブ応答」です。スニペットの長さ、要約の方式、ハイライトの組み立て方がそのままモデルのコンテキストに入るため、スコアは基盤となるウェブインデックスの品質だけでなく、情報の構成方法も反映します。第二に、429、5xx、タイムアウトなどの致命的なエラーは成功するまで継続的にリトライされ、しかもこれらのエラーは最終結果にカウントされません。これは、このランキングが測っているのが「正常に動作したとき」の品質であり、各サービスの本番環境での可用性や障害率を証明するものではない、ということを意味します。
最新 Search Index ランキング:どの検索 API が最も効果を発揮するのか?
以下の表では、品質スコアと BrowseComp は 2026-11-09 時点のランキングに基づいています。所要時間は 2026-11-13 に取得したランキング値で、標準的なテストタスクが開始から終了までにかかる平均時間を指します。検索 API の単一リクエストに対するネットワーク遅延ではありません。
| 検索構成 | 総合スコア(11-09) | BrowseComp | 平均タスク所要時間(11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16.6 秒 |
| Keenable Realtime | 82 | 86% | 16.0 秒 |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36.7 秒 |
| Perplexity Search Medium | 80 | 87% | 31.1 秒 |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19.4 秒 |
| Parallel Advanced | 75 | 77% | 今回の所要時間更新では未掲載 |
| Brave LLM Context | 75 | 77% | 今回の所要時間更新では未掲載 |
| OpenAI Web Search Medium(Responses 組み込みフロー) | 74 | 74% | 33.1 秒 |
| DeepSeek Search Summary | 69 | 63% | 22.4 秒 |
| 検索なしのベースライン | 33 | 17% | — |
検索 API ランキングに見られる 3 つの典型的なギャップ
同点でも速度が異なる。 Exa Auto と Perplexity Medium はいずれも 80 点ですが、タスク全体の所要時間はそれぞれ 36.7 秒と 31.1 秒です。Keenable Pro はスコアがより高いにもかかわらず、所要時間はわずか約 16.6 秒にとどまります。リアルタイム応答が求められる Agent にとって、この差はユーザーが直接体感できるものです。
BrowseComp は総合スコアに完全には連動しない。 Perplexity Medium の BrowseComp は 87% に達し、Keenable Pro と並んでいますが、総合スコアは 3 点低くなっています。差は主に他の 2 つのベンチマークに起因します。自社の業務が「難問のウェブ検索」に近い場合は、BrowseComp の列を単独で参考にするとよいでしょう。
同一ベンダーの異なるモードでは差が大きい。 Exa Lite と Exa Auto はわずか 1 点差ですが、所要時間はほぼ 2 倍も異なります。そのため、具体的な製品モードごとに解釈すべきであり、Exa Lite と Exa Auto をまとめて 1 つの「Exa スコア」にしてはいけません。
💡 データについて:上記のスコアは Artificial Analysis による第三者評価の結果で、所要時間は標準タスクの所要時間です。自社の業務課題で同様の比較を再現したい場合は、APIYI apiyi.com で回答モデルを 1 つに固定し、そこに異なる検索ツールをそれぞれ接続して A/B テストを行えます。
検索APIは最高スコアが最もコスト効率が良いのか?
Artificial Analysisは、ベンチマークタスク1,000件あたりの推定コストも公開しており、検索料金とモデル料金に分けて表示しています(2026-11-09のランキング、米ドル)。「1スコアあたりのコスト」の列は、本文編集者が「総コスト ÷ 総合スコア」で概算したもので、横並び比較の参考用であり、公式指標ではありません。
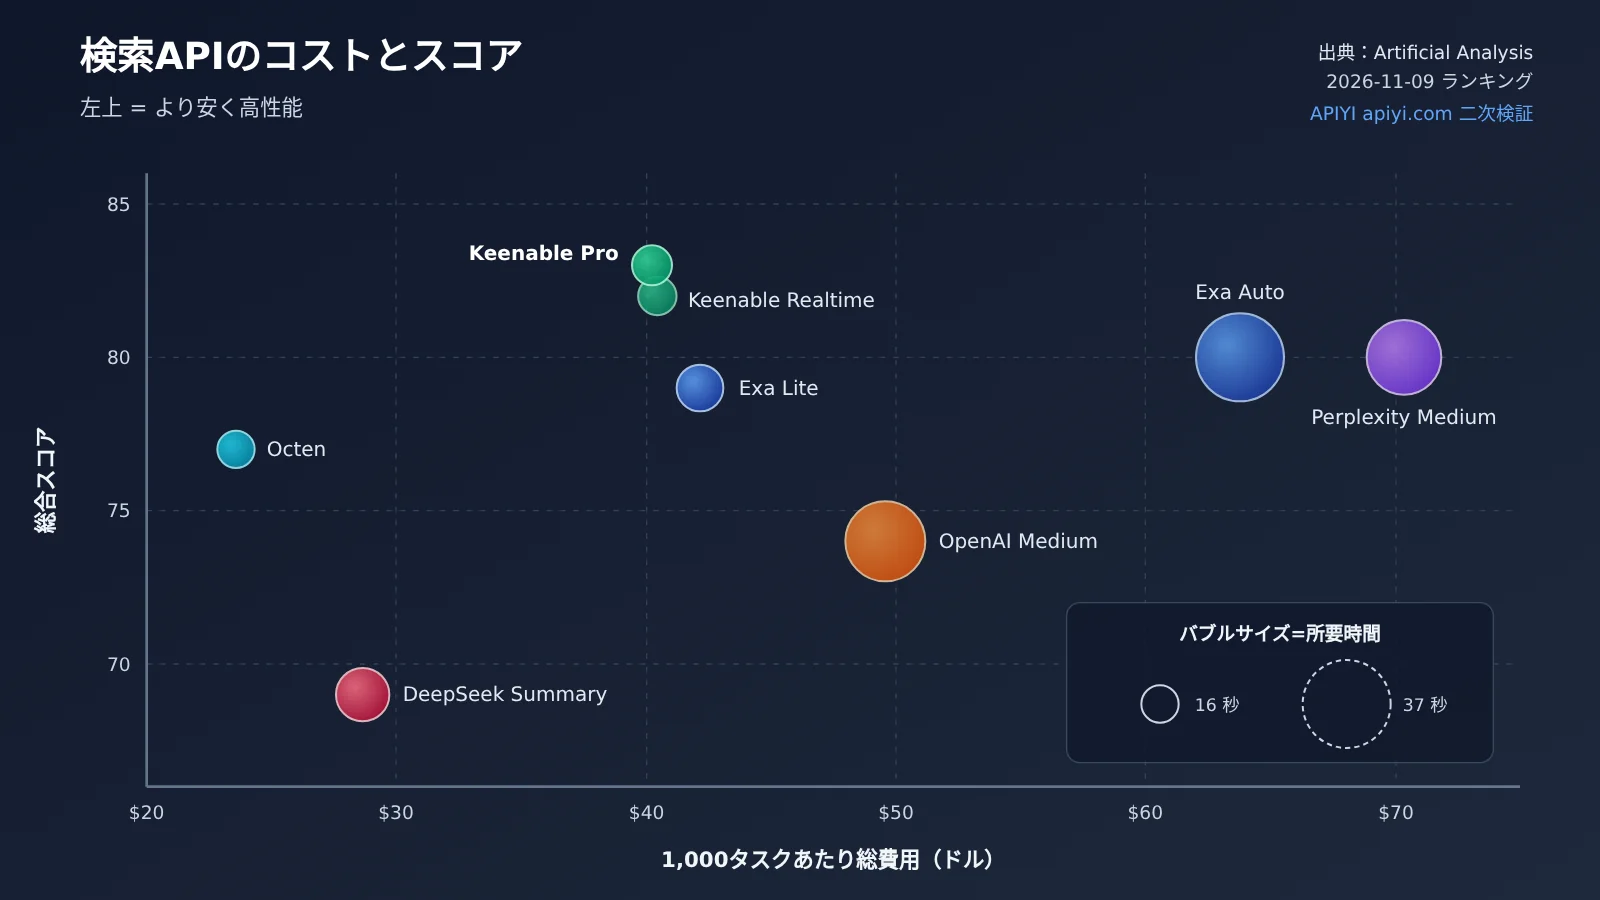
| 検索構成 | 品質スコア | 検索料金 + モデル料金 | 総コスト/千タスク | 1スコアあたりのコスト(編集者算出) | タスク所要時間(11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | 約 $0.48 | 16.6 秒 |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | 約 $0.49 | 16.0 秒 |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | 約 $0.80 | 36.7 秒 |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | 約 $0.88 | 31.1 秒 |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | 約 $0.53 | 19.4 秒 |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | 約 $0.31 | 15.6 秒 |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | 約 $0.67 | 33.1 秒 |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | 約 $0.42 | 22.4 秒 |
検索APIコスト表から得られる3つの結論
最高スコアが必ずしも最高コストとは限らない。 Keenable Proは83点で1位、1,000タスクあたり約$40.22、1タスクあたり約$0.04となり、サンプル内では中程度の水準です。Perplexity Mediumはスコアが3点低いものの、総コストは約75%高くなっています。
1点の差で、コストは3割以上変わりうる。 Exa Lite + Highlightsは79点・$42.15/千タスク、Exa Auto + Highlightsは80点・$63.77/千タスクで、前者は約34%安く、所要時間も短くなっています。Exa公式価格ページ(2026-11-13時点の資料)を参照すると、Liteプランは1,000リクエストあたり$4、Autoプランは1,000リクエストあたり$7です。ランキングにおける検索料金の差は、この価格体系と整合しています。
検索料金が安いと、モデル料金が高くなる可能性がある。 DeepSeek Search Summaryの検索料金はわずか$8.47ですが、モデル料金は$20.19に達し、表の中で最高です。Octenは総コストが最低ですが、モデル料金はKeenable、Exa、Perplexityより高くなっています。検索結果が十分に有効でないと、Agentはより多くの検索ラウンドを重ね、より多くのページを読み、Token消費が増加します。したがって、コスト計算は「1タスクを完了するための総コスト」を単位とすべきであり、検索APIの単価だけを見てはいけません。
この Search Index ランキングは、実際の選択にどう役立つか?
Search Indexは英語中心の汎用ファクト検索ベンチマークであり、中国語インターネット専用のベンチマークではありません。以下では、よくあるエージェントのユースケースと対応づけながら、どの場面で直接参考にでき、どこに追加テストが必要かを示します。
| エージェントのユースケース | 最も重要な指標 | ランキングの参考価値 | 推奨候補 |
|---|---|---|---|
| ファクト型Q&A | 正答率、引用の正確性 | 高。AA-Omniscienceを直接参考にできる | Keenable、Exa Lite、Perplexity |
| 複数ソース横断の複雑なリサーチ | マルチホップ検索、集合単位の再現率 | 高。DeepSearchQAとBrowseCompを特に確認 | Keenable Pro、Exa Auto、Perplexity Medium |
| 低遅延エージェント | タスク全体の所要時間、P95レイテンシ | 中。タスク所要時間は参考程度 | Keenable Realtime、Octen、Exa Lite |
| 中国語ニュース検索 | 中国語ソースのカバレッジ、中国国内サイトへの到達性 | 低。中国語のテストセットを自前で構築する必要がある | 百度千帆、博查、阿里云百炼を比較対象に加える |
| プログラミングドキュメント検索 | 公式ドキュメントのカバレッジ、バージョン情報 | 低〜中。実際の技術的な質問で再テストする必要がある | Exa、Perplexity、Parallel |
Search Indexを使った検索APIの二次比較方法
より合理的なのは、公開ランキングを「一次スクリーニング用のツール」として使い、そのうえで自社のタスクで第2ラウンドの比較を行うことです。
- 品質、所要時間、総コストの3項目で、ランキングから3–4個の候補構成を選びます。
- 自社の業務上の質問を50–100問用意し、単純なファクト、最近のニュース、マルチホップの質問、中国語および言語横断クエリをカバーします。
- 回答モデル、最大ターン数、結果件数を同じに固定し、検索ツールだけを差し替えます。
- 正答率、引用の正確性、タスクあたりの総コスト、P50/P95の所要時間、空の結果とタイムアウト回数を記録します。
- 本番環境の安定性については別途負荷テストを行います。ランキングはリトライ後の致命的エラーをすでに除外しているためです。
検索APIの選定アドバイスとクイックスタート
🎯 選定のヒント:総合的な品質と速度を重視するなら、まず Keenable Pro/Realtime を試してください。コストを抑えつつ80点に近い品質を求めるなら、Exa Lite + Highlights と Octen が重点的に試す価値があります。すでに OpenAI エコシステムを深く利用しているチームは、内蔵の Web Search をそのまま使えますが、その実行フローが制御できない点は受け入れる必要があります。実際に導入する際は、APIYI apiyi.com 経由で回答モデルを統一的に呼び出し、検索ツールをプラガブルなモジュールとして作ることをおすすめします。そうすれば、検索APIを切り替えるときにモデル側のコードを変更する必要がありません。
超シンプルな例:モデル側は統一インターフェースで
以下のコードは回答モデルを固定し、検索ツールを関数として宣言しています。実際にどの Search API で実装するかは、ローカル側のコードで置き換えるだけです。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の統一インターフェース、モデルは差し替え可能
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # 評価したいモデルに変更
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
完全なコードを見る:同一モデルで複数の検索APIをA/B比較
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # 回答モデルを固定し、制御変数を維持
MAX_TURNS = 25          # Search Index と一致するターン数の上限

# 各社の検索APIのアダプター関数。公式ドキュメントに従って実装してください
def search_provider_a(query: str) -> list:
    return []  # [{"title":..., "url":..., "snippet":...}] を返す

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "联网搜索,返回最多10条结果",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 クイックスタート:新規ユーザーは APIYI apiyi.com で無料のテスト枠を受け取れます。まず少量の業務に関する質問で上の A/B スクリプトを動かしてみて、その後どの検索APIを正式な方案に組み込むかを決めてください。
よくある質問(FAQ)
Q1:Search Index とは何ですか?
Search Index は Artificial Analysis が公開している検索 API 評価インデックスです。回答モデルと Agent フレームワークを固定し、検索サービスだけを差し替えて、DeepSearchQA、BrowseComp、AA-Omniscience の3つのベンチマークの等重み平均スコアで検索性能を評価します。満点は100です。
Q2:83点は正答率83%を意味しますか?
いいえ。83 は3つのベンチマークスコアの平均値で、3項目の指標もそれぞれ異なります。DeepSearchQA は F1、残り2項目は正解率です。Keenable Pro の3項目は順に 88、87、73 で、平均は約 82.67、表示は 83 です。
Q3:ランキングデータはいつのものですか?
品質スコアとコストデータは 2026-11-09 のランキング更新に基づき、完全なタスクの所要時間は 2026-11-13 に取得した値を使用しています。ランキングは継続的に更新されるため、引用時には日付を明記してください。
Q4:ランキングの所要時間は検索 API の応答速度と見なせますか?
いいえ。表の所要時間は、複数回の検索、Web ページの読み取り、モデル推論を含む標準タスクの合計時間です。単発の HTTP レイテンシーは別途測定する必要があり、P50 と P95 の両方を記録するのが望ましいです。
Q5:自社業務で異なる検索 API の効果を素早く比較するには?
回答モデルを1つに固定し、検索ツールだけを差し替えます。APIYI apiyi.com を通じて OpenAI 互換インターフェースでモデルを呼び出し、base_url を `https://api.apiyi.com/v1` に設定して、本記事の A/B スクリプトを適用します。モデルを変更した後の検索効果の変化も確認したい場合は、同じ APIキーで OpenAI、Claude、Gemini などのモデルを切り替えられます。
Q6:Search Index にはどのような限界がありますか?
主に4点あります。中国語インターネットに特化したベンチマークではないこと。OpenAI ネイティブ検索の実行フローが他の構成と異なること。429、5xx、タイムアウトなどのエラーはリトライ後に結果へ計上されず、本番環境の安定性を反映できないこと。コストは評価タスクに基づく推定であり、実際の請求額と一致しない可能性があることです。中国語ニュースや中国国産技術ドキュメントの検索については、別途テストセットを構築し、APIYI apiyi.com を通じて中国国産モデルと組み合わせて検証することをおすすめします。
Search Index 検索API選定の要点
- 検索は独立した変数:同じモデルが33点から83点まで向上しました。検索APIの選択はAgentの品質に直接影響します。
- 83点は正答率ではありません:3つのベンチマークの等重み平均であり、採点基準はそれぞれ異なります。
- 所要時間はタスク全体で見る:Keenableは約16秒、Exa Autoは約37秒で、いずれも単発APIのレイテンシではありません。
- コストは分解して見る:検索費用が安い代わりにモデル費用が高くなる可能性があるため、1タスクあたりの総費用で比較すべきです。
- 1点の差が34%になり得る:Exa LiteとAutoはわずか1点差ですが、前者は約3割以上安価です。
- ランキングは一次スクリーニングに過ぎない:中国語やプログラミング文書などのシナリオでは、自らのタスクで二次的なA/B比較を行う必要があります。
まとめ
この Search Index ランキングの最も価値ある点は、「同一モデル・異なる検索ツール」という設計によって、検索品質がAgentに与える影響を独立して測定したことです。
- 品質:検索なしで33点、最高で83点。たとえ双方とも検索を接続していても、構成によって約14点の差があります。
- 速度:同じ80点でも、タスク全体の所要時間は5秒以上差が出ることがあります。高得点の構成でも高速に実行できます。
- コスト:Keenable Proは品質が最も高く、コストは中程度。Exa LiteとOctenはコスト効率で際立っています。DeepSeek Summaryの例は、検索費用が低いことが総コストの低さを意味しないことを示しています。
まずランキングで3〜4の候補を選び、その後、自分の問題セット上でモデルを固定してA/Bテストを行うことをおすすめします。APIYI apiyi.com を通じて回答モデルを統一的に呼び出し、検索ツールを交換可能なモジュールとして組み込んで、品質・速度・コストの3つのデータで最終案を決定しましょう。
参考資料
- Artificial Analysis Search API ランキング:品質スコア、コスト、所要時間のデータ
- リンク:
artificialanalysis.ai/agents/search-api -
説明:本記事におけるスコア、コスト、所要時間の主な出典
-
Artificial Analysis Search API の評価方法:テスト構成と採点ルール
- リンク:
artificialanalysis.ai/methodology/search-api -
説明:モデル、ラウンド数、結果件数、リトライルールなどの説明を含みます
-
Exa Pricing:Lite、Auto などのプランの料金
- リンク:
exa.ai/pricing -
説明:ランキング上で Exa のモードごとに検索コストが異なる理由を理解するための資料
-
Exa 3.0 のお知らせ:Lite モードと Dynamic Highlights
- リンク:
exa.ai/blog/exa-3 -
説明:2026-10-19 に公開された記事で、ベンダー自身によるテストデータを含みます
-
OpenAI Web Search ドキュメント:Responses API に組み込まれた検索ツール
- リンク:
developers.openai.com/api/docs/guides/tools-web-search -
説明:OpenAI ネイティブの検索がどのように実行されるか、またそのパラメータを理解するための資料
-
Perplexity Search API の料金:Standard と Fast の各プラン
- リンク:
docs.perplexity.ai/docs/getting-started/pricing - 説明:リクエスト単位の課金ルールを理解するための資料
著者:APIYI 技術チーム
技術交流:APIYI サイトのトップページからお気軽にお問い合わせください。その他の接続資料については docs.apiyi.com ドキュメントセンターをご覧ください。