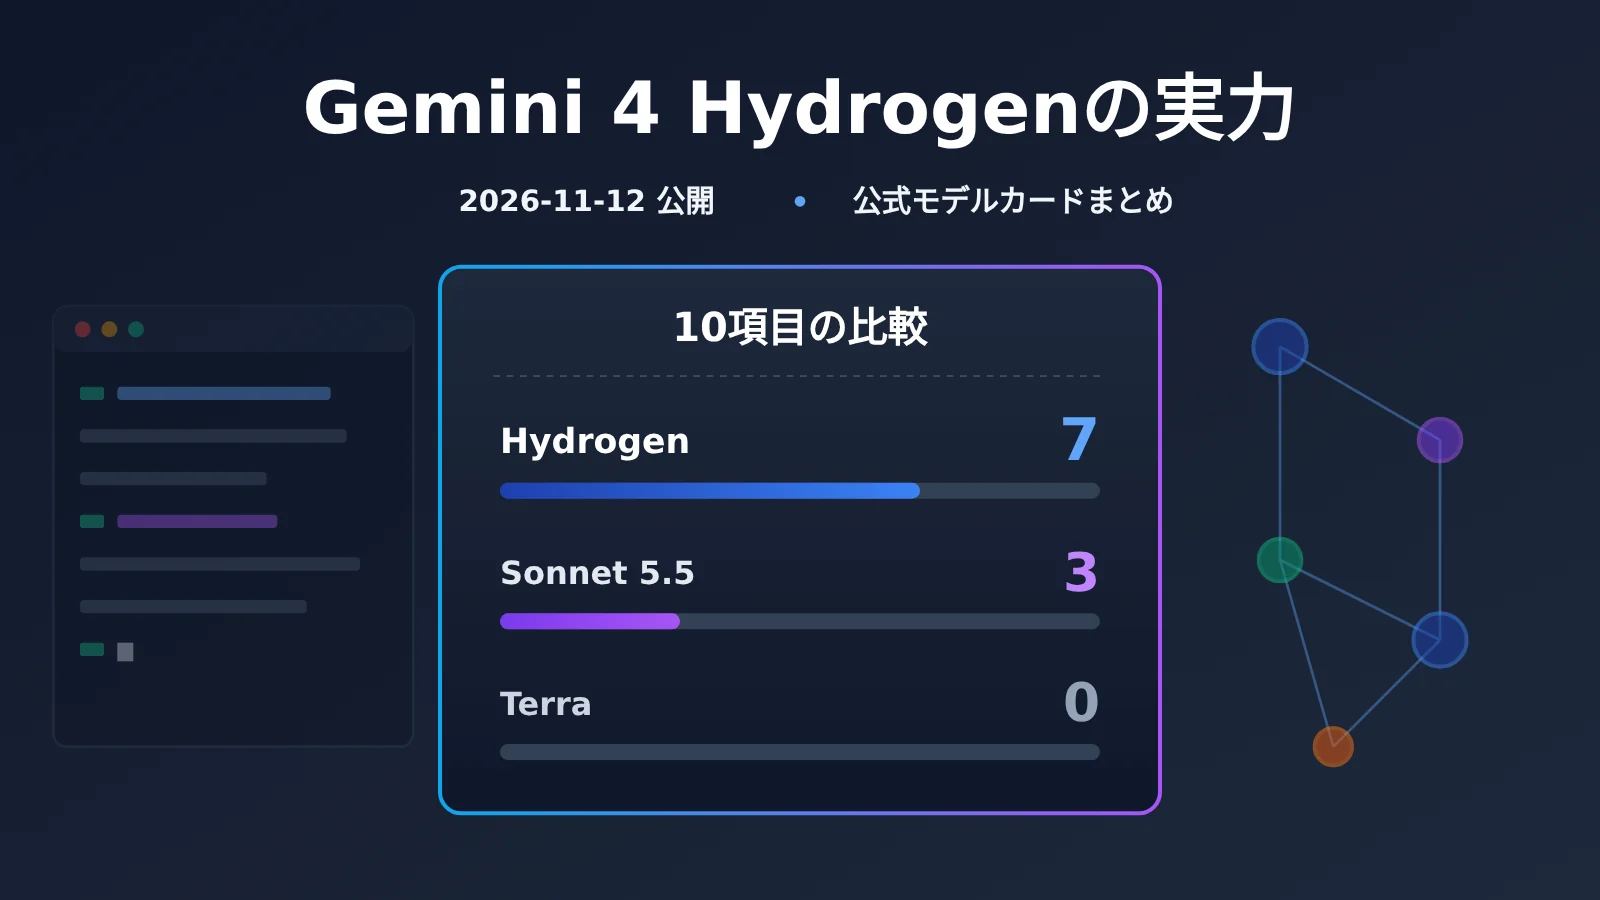
著者注:Google は 2026-11-12 に Gemini 4 Hydrogen を正式に発表しました。モデル ID は gemini-4-hydrogen です。その位置づけは より高速な日常コーディングと各種エージェント実行であり、Carbon や Argon のように最も難しい長期的推論を担うモデルではありません。公式のグローバル標準ティア料金は、入力 $1.50、出力 $7.50(100万トークンあたり)です。DeepMind のモデルカードにある10項目の比較表では、そのうち7項目で最高スコアを獲得しています。
これは発表前のコードネームに関する噂ではありません。Google のブログ、開発者向け速報、DeepMind のモデルカードはすでに公開されており、AI Studio の試用リンクでも gemini-4-hydrogen という ID がそのまま使われています。なお、本記事で引用するスコアはすべて公式の自己申告または公式モデルカードの集計によるもので、APIYI による再測定の結果ではありません。
本記事の核心:本記事を読み終えると、Gemini 4 Hydrogen がどのタスクで優れ、どのタスクで Claude Sonnet 5.5 に後れを取るのか、そしてこれらの数値をどう読むべきかが分かります。
Gemini 4 Hydrogen の核心情報をざっと確認
まずは基本的事実から見ていきましょう。以下の表の情報は、Google のブログ、開発者向けニュースレター、DeepMind のモデルカード(Published November 2026)に基づいており、確認日は 2026-11-13 です。
| 情報項目 | Gemini 4 Hydrogen の詳細 |
|---|---|
| 公開日 | 2026-11-12、当日から世界で順次展開 |
| 公開元 | Google / Google DeepMind |
| モデル ID | gemini-4-hydrogen |
| 由来 | モデルカードに「adapted from Gemini 4 Carbon」と明記、つまり Carbon から派生したモデル |
| 公式の位置づけ | 日常的なコーディング、エージェント実行;単体でも使え、マルチモデルフローの中で実行エンジンとしても使える |
| 思考レベル | low、medium、high(デフォルト)、xhigh の4段階 |
| 知識カットオフ | 2026年3月、一部の領域ではより古い可能性あり |
| 公式チャネル | AI Studio の全プラン、Gemini API、Android Studio、Gemini for business、Gemini App、Google Search |
Google は Gemini 4 ファミリーの役割分担についてかなり率直に語っています。Carbon と Argon が最も難しい長期的な推論を担い、Hydrogen はより高速な日常タスクを担うというわけです。そのため、Hydrogen と Carbon を「同じティアのモデルの新旧バージョン」として比較するのは不適切です。Carbon との関係はむしろ、同じ基盤の上にある2つの役割分担に近いものです。
利用チャネルについてですが、有料の Google AI Pro / Ultra ユーザーは Google Antigravity 内でも Hydrogen を利用できます。Sheets はまず Pro / Ultra と条件を満たす企業向けサブスクリプションから順次開放されます。AI Studio は公式に全プランで利用可能と確認されていますが、無料プランの具体的な上限は今回は確認できていないため、ここでは触れません。
Gemini 4 Hydrogen の4段階の思考レベル
4段階の思考レベルは Hydrogen を使う上での重要なポイントです。公式の説明によると、レベル間の品質・レイテンシ・コストは滑らかに増加していくため、開発者は必要な推論の深さに対してのみコストを支払うことができます。デフォルトは high で、これは請求額に直接影響します。この点は後述の料金のパートで改めて触れます。
Gemini 4 Hydrogen 公式 10項目比較表
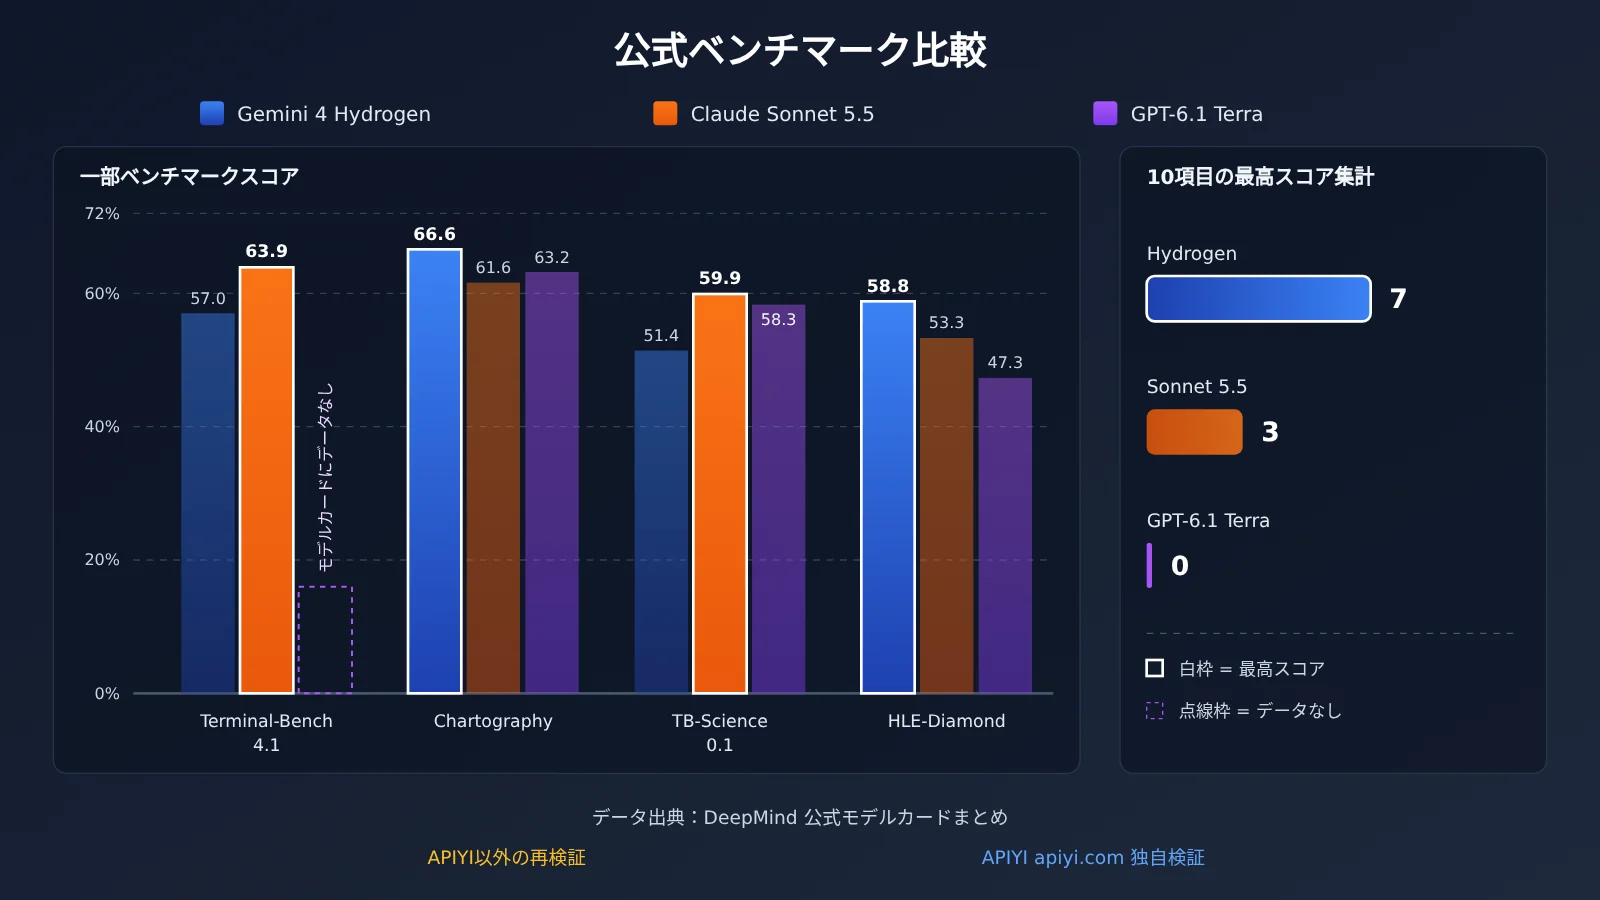
ここがこの記事の核心部分です。DeepMind のモデルカードには10項目のベンチマーク比較表が掲載されており、比較対象は Gemini 4 Hydrogen、Claude Sonnet 5.5、GPT-6.1 Terra の3モデルです。
| ベンチマーク | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | 最高値 |
|---|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1(cheating-adjusted) | 57.0% | 63.9% | データなし | Sonnet |
| Agents’ Last Exam v1.1 | 71.6% | 60.4% | 69.8% | Hydrogen |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% | Hydrogen |
| Vending-Bench 2(アカウント残高、米ドル) | 14549 | 11165 | 9107 | Hydrogen |
| OSWorld-2.1(offline subset) | 77.6% | 83.9% | 74.2% | Sonnet |
| MKA(Climb WSR accuracy) | 53.4% | 52.0% | 43.8% | Hydrogen |
| Chartography | 66.6% | 61.6% | 63.2% | Hydrogen |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% | Sonnet |
| HLE-Diamond | 58.8% | 53.3% | 47.3% | Hydrogen |
集計結果は、Hydrogen が7項目で最高、Sonnet 5.5 が3項目で最高(Terminal-Bench 4.1、OSWorld-2.1 のコンピュータ操作、Terminal-Bench-Science)というものです。GPT-6.1 Terra はスコアが記載されたセルでは1位を獲得していません。
ここで特に注意すべき点が2つあります。第一に、Terra の Terminal-Bench 4.1 欄は空欄で、モデルカードに数値が示されていません。そのため「Terra のターミナル能力が劣る」と解釈してはいけません。第二に、「10項目中7項目で勝利」は全面超越を意味するわけではなく、Hydrogen はターミナルとコンピュータ操作というエージェント実行と密接に関わる2種類のタスクでは、依然として Sonnet 5.5 に後れを取っています。
この Gemini 4 Hydrogen 比較表の読み方
モデルカードの手法説明によって、この表からどこまで読み取れるかが決まります。Hydrogen のスコアは別途注記がない限り、すべて最高思考ティア、pass@1、単一試行、Gemini API 経由での実行によるものです。Sonnet 5.5 と GPT-6.1 Terra は、既定ではそれぞれ公開されている最大の思考/推論ティアを採用し、公開結果がない場合は入手可能な最良の結果を用いています。
言い換えれば、これは同じ日に同じスクリプトで3つのモデルを再実行したものではありません。特に SWE-sweep は明確で、競合モデルのスコアは公開リーダーボードに由来するものであり、Google が同じスキャフォールドで再測定したものではありません。したがってこの表は大まかな強弱の方向性を判断するのに適しており、1ポイントごとの差を厳密な結論として扱うのには向いていません。
また、表の Hydrogen の数値は最高思考ティアでの成績ですが、その既定ティアは high です。本番環境で既定ティアを使う場合、実際の性能は表の数値と乖離する可能性があります。自分のタスクで検証してみる価値はあるでしょう。
Gemini 4 Hydrogen が Gemini 3.8 Flash から進化した点
Gemini 3.8 Flash を使っている開発者にとっては、横並びの比較よりもこのセクションのほうが参考になるかもしれません。以下の数値はすべてベンダー公式の自己申告によるものです。
| 項目 | Gemini 3.8 Flash | Gemini 4 Hydrogen | 補足 |
|---|---|---|---|
| タスク完了速度(デフォルト high) | 基準 | 2.5倍高速 | 公式自己申告 |
| Terminal-Bench 4.1 | 18.2% | 57% | 3倍超 |
| 根拠のない記述(捏造) | 基準 | 5分の1以下に減少 | 公式自己申告 |
| ツール失敗時/検索結果が空のとき | — | より自発的に別ルートへ切り替える | 公式の定性的記述 |
| パートナー企業の早期テスト速度 | 基準 | 2〜2.8倍高速 | グラフ、SQL、データ集約的な処理 |
| パートナー企業の早期テストにおけるtoken使用量 | 基準 | 12〜23%削減 | 公式による伝聞、公開ベンチマークではない |
ターミナルタスクが 18.2% から 57% へ跳ね上がったのが、今回のリリースで最も目立つ変化です。これは「小規模モデルが本当にコマンドラインタスクを実行できるのか」という点で、Hydrogen が実用のハードルを越えたことを示しています。ただし横並びの表に戻って見ると、57% は Sonnet 5.5 の 63.9% を依然として下回っています。
パートナー企業の早期テストデータも、切り離して見る必要があります。これは公式が伝聞として紹介したパートナーの結果であり、公開ベンチマークではありません。シナリオも複雑なグラフ、SQL、データ集約的な処理に集中しており、あらゆる業務に当てはまるとは限りません。
Gemini 4 Hydrogen のその他の公式自己申告スコア
10項目の表以外にも、ブログとモデルカードにはいくつかのスコアが並んでおり、これらも同じく公式の自己申告です。
- Artificial Analysis Intelligence Index:デフォルトの high で 51、Argon で 50、xhigh では 54。これは Google が AA の数値を引用したものです。Carbon は以前に AA Index v5 で 59 点を公表しましたが、今回の発表では Hydrogen が同じバージョンの指数を使っているかが示されていません。そのため両者を直接引き算して比較するのは適切ではありません。
- Agent Arena:オープン agent タスクで第5位。
- Vals Tax Agent Bench:52.3%、公式は総合1位としています。
- Vals Legal Research Bench:55.8%、公式は同率1位としています。
- HLE-Diamond:58.8%、公式は同レベルで先行としています。
マルチモデル・フローにおける Gemini 4 Hydrogen の役割
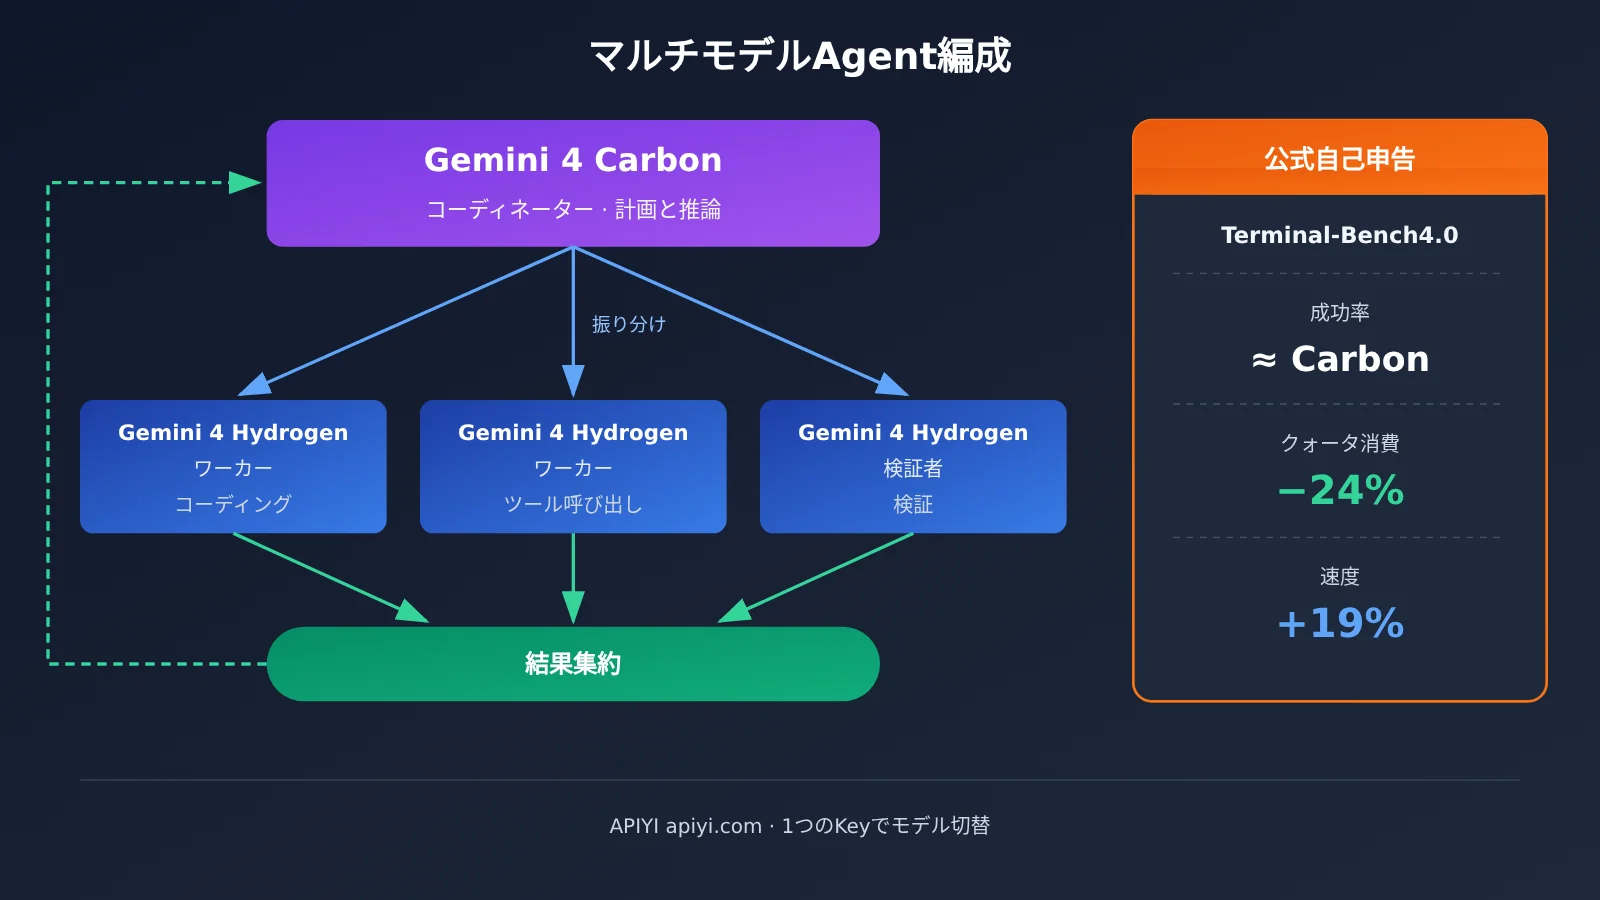
公式は組み合わせ利用のデータも提示しています。Antigravity Orchestrator では、システムが Carbon と Hydrogen を切り替えながら動作し、Terminal-Bench 4.0 でのタスク成功率は Carbon 単体とほぼ同等で、平均してクォータを 24% 削減し、19% 高速でした。並列モードでは Carbon がオーケストレーター役、Hydrogen が worker または verifier を担当します。
このデータは、Google が Hydrogen をどう位置づけているかをよく表しています。Carbon を置き換えるのではなく、具体的な実行を大量に担い、コストの高い推論は本当に必要なステップに残す、という設計意図です。
Gemini 4 Hydrogen の仕様と価格
コンテキストウィンドウ:モデルカードとブログの2つの記述
モデルカードとブログでは表現が完全には一致していないため、ここでは両方の記述を並べて示します。
- モデルカード: combined input-output token context window of up to 1M(入出力合計で最大100万トークン)。同期呼び出しではデフォルトで最大6.4万トークンを出力し、バックグラウンドの long decode では最大100万トークンを出力します。
- ブログ: ネイティブで100万トークン入力、出力は最大100万トークン。
実際の開発では、モデルカードのより保守的な「合計ウィンドウ」という基準に沿って予算を立て、同期呼び出しにおける出力のデフォルト上限が6.4万トークンである点にも注意してください。非常に長い出力にはバックグラウンドの long decode を利用する必要があります。入力モダリティについては、Hydrogen はテキスト、画像、音声、動画をサポートします。
Gemini 4 Hydrogen の公式標準ティア価格
ブログでは、100万トークンのウィンドウ全体に対して一律価格とされています。以下の表は Google Cloud の料金ページ(2026-11-13 時点で取得)に基づくもので、標準ティアのみを掲載しています。単位は米ドル / 100万トークンです。
| 課金項目 | グローバル標準ティア | 非グローバル |
|---|---|---|
| 入力(テキスト、画像、動画、音声) | $1.50 | $1.65 |
| キャッシュ読み取り | $0.075 | $0.0825 |
| 出力(応答と推論の合計) | $7.50 | $8.25 |
| キャッシュ書き込み | 定価 $1.875、2027-01-12 から課金開始 | — |
見落としがちな点として、出力価格は応答と推論を合算して計算されます。Hydrogen のデフォルトの思考レベルは high のため、出力の請求には思考トークンも含まれます。モデルカードでも、より高い思考レベルではより多くのトークンを消費する可能性があると注意しています。簡単なタスクでは low または medium に下げてコストを抑えることも検討するとよいでしょう。
今日、Gemini 4 Hydrogen を呼び出せるのはどこか
公式チャネルでは、Google AI Studio と Gemini API が当日から利用可能です。APIYI 側では、2026-11-13 に docs.apiyi.com/models のドキュメント一覧表、モデルページ、api.apiyi.com/api/pricing の価格インターフェースを確認しましたが、gemini-4-hydrogen は見つかりませんでした。モデルページは 404 を返し、価格インターフェースではその日の 282 モデルを検索しても hydrogen の結果はゼロでした。現時点では未提供で、このモデルはできるだけ早く提供を開始する予定です。モデルと価格はプラットフォームのモデル一覧を基準としてください。
Hydrogen の提供開始前に、APIYI apiyi.com では 10 項目表にある 2 つの競合モデルと、Hydrogen の「母体」である Carbon をすでに呼び出せるので、まず比較フローを組み立てるのに適しています:
| モデル ID | 入力 | 出力 | キャッシュ読込 | エンドポイント | 利用可能なプラットフォーム |
|---|---|---|---|---|---|
gemini-4-carbon |
$2 | $10 | $0.1 | chat、gemini | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | chat、messages | APIYI |
gpt-6.1-terra |
$1 | $5 | $0.05 | responses(推奨)、chat | APIYI |
Carbon の価格について補足します。APIYI のドキュメントには、$2 / $10 は Google の期間限定価格で、有効期限は 2026-11-30 と明記されています。2026-12-01 からは公式の調整に伴い $4 / $20、キャッシュ読み $0.10 になります。
接続方法は OpenAI 互換インターフェースです。base_url を https://api.apiyi.com/v1 に設定し、モデルフィールドに gemini-4-carbon、claude-sonnet-5-5、または gpt-6.1-terra を入力するだけです。Hydrogen の提供開始後は、モデルフィールドを gemini-4-hydrogen に置き換えるだけで、同じコードの中で上記 10 項目表が扱うタスクタイプを再現できます。
🎯 技術的なアドバイス:公式モデルカードの競合スコアは各社の公開結果に基づくもので、あなたの業務シーンと一致するとは限りません。まず APIYI apiyi.com を通じて同じ実タスク群で Sonnet 5.5 と Terra を比較し、Hydrogen の提供開始後に一列追加して、自分たちだけの勝敗表を作ることをおすすめします。
Gemini 4 Hydrogen の影響分析
開発者への影響
- エージェント実行レイヤーに選択肢が増える:AutomationBench-AA、Agents’ Last Exam、Vending-Bench 2 といったエージェントタスクでは Hydrogen の公式スコアがリードしており、ワークフロー内の多くの実行ステップを担う用途に適しています。
- ターミナルとコンピューター操作は引き続き要評価:Terminal-Bench 4.1 と OSWorld-2.1 では Sonnet 5.5 がリードしています。中心となるユースケースがコマンドラインエージェントやデスクトップ自動化なら、「7項目で勝利」という見方だけで判断すべきではありません。
- 3.8 Flash ユーザーは移行を検討する価値あり:速度、ターミナル成功率、捏造率はいずれも公式の自己申告で明確に改善していますが、自社データで確認する必要があります。
- コストは思考レベル次第:デフォルトの high レベルでは思考トークンが出力トークンとして計上されるため、レベルの選択がそのまま請求額を左右します。
モデル分業の構図への影響
Hydrogen の発表は、「コーディネーター + エグゼキューター」という階層的な使い方をさらに強化しています。Orchestrator の公式データによると、安価なモデルに実行を、高価なモデルに計画を担当させることで、近い成功率を保ちながら利用枠を節約できます。これは、マルチモデルオーケストレーションが実験的な手法からベンダー公式推奨の手法へと移りつつあることを意味し、複数モデルを一元的に切り替えられる接続レイヤーの重要性も増していきます。
Gemini 4 Hydrogen の既知の制約
弱点も避けずに、モデルカードに記載された制約は次のとおりです。
- ハルシネーションは依然として発生し得る。遅くなる、またはタイムアウトする可能性がある。より高い思考レベルではトークン消費が増えることがある。知識カットオフは2026年3月。
- 安全性の自動評価では、3.8 Flash と比べて2項目が悪化しています。拒否時の口調スコアが0.65ポイント低下し、拒否すべきでない場面での拒否回答率が5.57ポイント上昇しました(この指標は低いほどよい)。
- フロンティア安全性については、Argon と比べて能力面で特筆すべき飛躍はありません。CBRN とサイバーセキュリティはいずれも CCL に達していませんが、警告閾値には達しています。これは「関連リスクがない」という意味ではありません。完全な安全性レポートは後日公開されると公式に述べています。
好材料もあります。エージェントの範囲外動作は最大81%減少、内部の誠実性評価は96.7%、Gray Swan の間接プロンプトインジェクション耐性は2.3倍超に向上、HealthBench Pro の誤拒否率は0.4%未満です。これらも同様に公式の自己申告によるものです。
よくある質問(FAQ)
Q1:Gemini 4 Hydrogen とはどのようなモデルですか?
2026-11-12 に Google が発表した Gemini 4 ファミリーの一員で、モデル ID は `gemini-4-hydrogen` です。Gemini 4 Carbon から派生したモデルで、より高速な日常コーディングやエージェント実行向けに位置づけられています。最も難易度の高い長距離推論は Carbon と Argon が担当します。
Q2:Gemini 4 Hydrogen と Claude Sonnet 5.5 では、どちらが強いですか?
公式モデルカードの 10 項目の表では、Hydrogen が 7 項目、Sonnet 5.5 が 3 項目で勝っています。Sonnet の強みは、ターミナルタスク、コンピュータ操作、サイエンス系ターミナルに集中しています。比較対象のスコアは各社が公開している最大思考設定の結果であり、同じスクリプトで再実行したものではありません。APIYI apiyi.com 経由で、ご自身のタスクを使って比較テストすることをおすすめします。
Q3:「10 項目中 7 項目で勝利」は第三者による測定結果ですか?
いいえ、違います。これは DeepMind のモデルカードによる公式の集計で、Hydrogen は最高思考設定、pass@1 の単一試行によるものです。APIYI による再測定の結果でもないため、公式の自己申告データとして見るべきです。
Q4:Gemini 4 Hydrogen はどのようなシーンに適していますか?
公式の成績が良好なシーンには、多段階の自動化ワークフロー(AutomationBench-AA)、グラフ理解(Chartography)、マルチモーダル知識エージェント(MKA)、そしてマルチモデルフローにおける worker や verifier の役割などが含まれます。コマンドラインエージェントやデスクトップ操作については、Sonnet 5.5 も併せて評価することをおすすめします。
Q5:現在、APIYI 経由で Gemini 4 Hydrogen を呼び出せますか?
2026-11-13 時点ではまだ提供を開始していません。このモデルはできるだけ早く公開する予定で、型番と価格はプラットフォームのモデル一覧を基準とします。現在は APIYI apiyi.com で `gemini-4-carbon`、`claude-sonnet-5-5`、`gpt-6.1-terra` を呼び出せます。`base_url` には `https://api.apiyi.com/v1` を使用し、まずは比較フローを構築してください。
Q6:Gemini 4 Hydrogen の出力コストが予想より高くなるのはなぜですか?
公式の出力価格 $7.50 は応答と推論の合計で課金される仕組みで、さらにデフォルトの思考設定が high のため、思考トークンも出力の請求に含まれます。簡単なタスクでは low や medium に切り替えてコストを抑えられます。
Gemini 4 Hydrogen の主なポイント(Key Takeaways)
- 位置づけが明確:2026-11-12 にリリース。日常的なコーディングとエージェント実行を主眼とし、Carbon をベースに改良。
- 公式表では10項目中7項目で勝利:Sonnet 5.5 はターミナル、コンピューター操作、サイエンス・ターミナルの3項目で勝利。Terra は首位なし。
- 評価基準を区別:スコアはベンダー自己申告。比較対象は各社が公開している最大思考モードの値で、同一スクリプトによる再実行ではありません。
- 3.8 Flash からの飛躍は明確:2.5倍高速。Terminal-Bench 4.1 は18.2%から57%へ。
- 標準ティアの価格:グローバル入力 $1.50、出力 $7.50。出力には思考トークンを含む。
- コンテキストウィンドウには2つの記述:モデルカードでは合計100万。ブログでは入力100万、出力最大100万。
- APIの提供状況:APIYI ではまだ提供開始されていません。まず apiyi.com で Carbon、Sonnet、Terra を使って比較環境を構築できます。
まとめ
Gemini 4 Hydrogen の主なポイント:
- 強みはエージェント実行:公式の10項目表で7項目を制し、自動化、エージェント試験、グラフ、HLE-Diamond でリード。
- 弱みはターミナルとコンピューター操作:Terminal-Bench 4.1、OSWorld-2.1、サイエンス・ターミナルの3項目で Claude Sonnet 5.5 に劣る。
- 数字は評価基準を確認して読む:すべてベンダー自己申告またはモデルカードの集計。比較対象のスコアは公開結果に基づくもので、同一条件での再実行ではありません。
エージェントのワークフローを構築しているなら、Hydrogen は候補リストに入れる価値があります。特にマルチモデル構成の実行レイヤーに適しています。最終的な判断は、自分のタスクでの結果を基準にしてください。APIYI apiyi.com で既存の Carbon、Sonnet 5.5、Terra を使ってベースラインを構築しておくことをおすすめします。Hydrogen が提供開始されたら、そのまま追加テストできます。
📚 参考資料
- Google ブログ「Introducing Gemini 4 Hydrogen」:発表告知と位置づけの説明
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
内容: 公式の位置づけ、AA Index、3.8 Flash と比較した性能向上
-
Google 開発者向けニュース「Build with Gemini 4 Hydrogen」:開発者向けの接続情報
- リンク:
blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-hydrogen -
内容: 利用可能なチャネルと開発者向けの注記
-
DeepMind モデルカード「Gemini 4 Hydrogen」:仕様、10項目の比較表、安全性評価
- リンク:
deepmind.google/models/model-cards/gemini-4-hydrogen -
内容: 本記事の10項目の表と制限事項の主な出典
-
DeepMind 評価手法の解説:比較表の方法論
- リンク:
deepmind.google/models/evals-methodology/gemini-4-hydrogen -
内容: 思考ティア、pass@1、競合モデルのスコアの出典
-
Google Cloud 料金ページ:標準ティアの価格
- リンク:
cloud.google.com/vertex-ai/generative-ai/pricing - 内容: グローバル/非グローバルの標準ティア単価、キャッシュ書き込みの適用開始日
作者: APIYI 技術チーム
技術交流: APIYI のウェブサイトトップページからお問い合わせいただけます。詳しい資料は docs.apiyi.com ドキュメントセンターをご覧ください。