著者注:Alphabetは、自社モデルのAPIが毎分約320億トークンを処理していると明らかにしました。この記事では、公式価格、独立したベンチマーク評価、コストシミュレーションの3つの観点からGemini 4 Argon、3.8 Flash、3.5 Flash-Liteを比較し、「要件を満たすタスク1件あたりの総コスト」を考えます。
2026年10月28日、AlphabetのCEO Sundar Pichai氏は第3四半期の決算発表で、自社モデルのAPIが現在、毎分約320億トークンを処理しており、前年同期比で4倍以上増加したと発表しました。この数字は、開発者や企業によるGemini API全体の利用状況を示すもので、特定のモデル単体の実績ではありません。
この記事は「とにかく最強モデルを選べ」というおすすめ記事ではありません。呼び出し量が増えるほど、コストやモデル選定の影響も大きくなります。モデルのグレードを選び間違えると、月額料金に数倍の差が出ることもあれば、能力不足による繰り返しの再試行で、かえって高くつくこともあります。
この記事でわかること:Argon、Flash、Flash-Liteの3つのGeminiモデルについて、能力、価格、速度、適用シーンの違いを解説します。また、実際の業務でそのまま試せるテスト方法も紹介するので、初期段階のモデル選定に役立てられます。
Gemini APIの利用量が急増:主要情報まとめ
| 項目 | 詳細 |
|---|---|
| 発表日 | 2026年10月28日(Alphabet 2026年第3四半期決算) |
| 発表者 | Alphabet CEO Sundar Pichai |
| 主要データ | 自社モデルのAPIは毎分約320億トークンを処理。前回公表値から約40%増、前年同期比で4倍以上 |
| 現在の主力APIモデル | Gemini 4 Argon、Gemini 3.8 Flash、Gemini 3.5 Flash-Lite |
| 影響範囲 | Gemini Developer APIを通じてアプリを構築するすべての開発者と企業 |
毎分320億トークンはGemini APIの開発者にとって何を意味するのか
利用量の急増は、モデルが本番環境で大規模に使われるようになったことを示しています。ただし、どのプロジェクトでも最も高価なフラッグシップモデルを選ぶべきというわけではありません。実際のモデル選びでは、少なくともタスクの複雑さ、求められる出力品質、リクエスト数、応答速度、トークン消費量、業務上のエラー許容度、長いコンテキストやツール呼び出しの必要性、そして将来の価格変動を考慮する必要があります。
特に注意したいのは、この記事でいうFlashはGemini 3.8 Flash、Flash-LiteはGemini 3.5 Flash-Liteを指すという点です。旧バージョンのGemini 2.5 Flashシリーズと混同しないようにしましょう。また、世界全体の利用量がどれほど大きくても、個人開発者のクォータが無制限になるわけではありません。呼び出し制限については後ほど詳しく説明します。
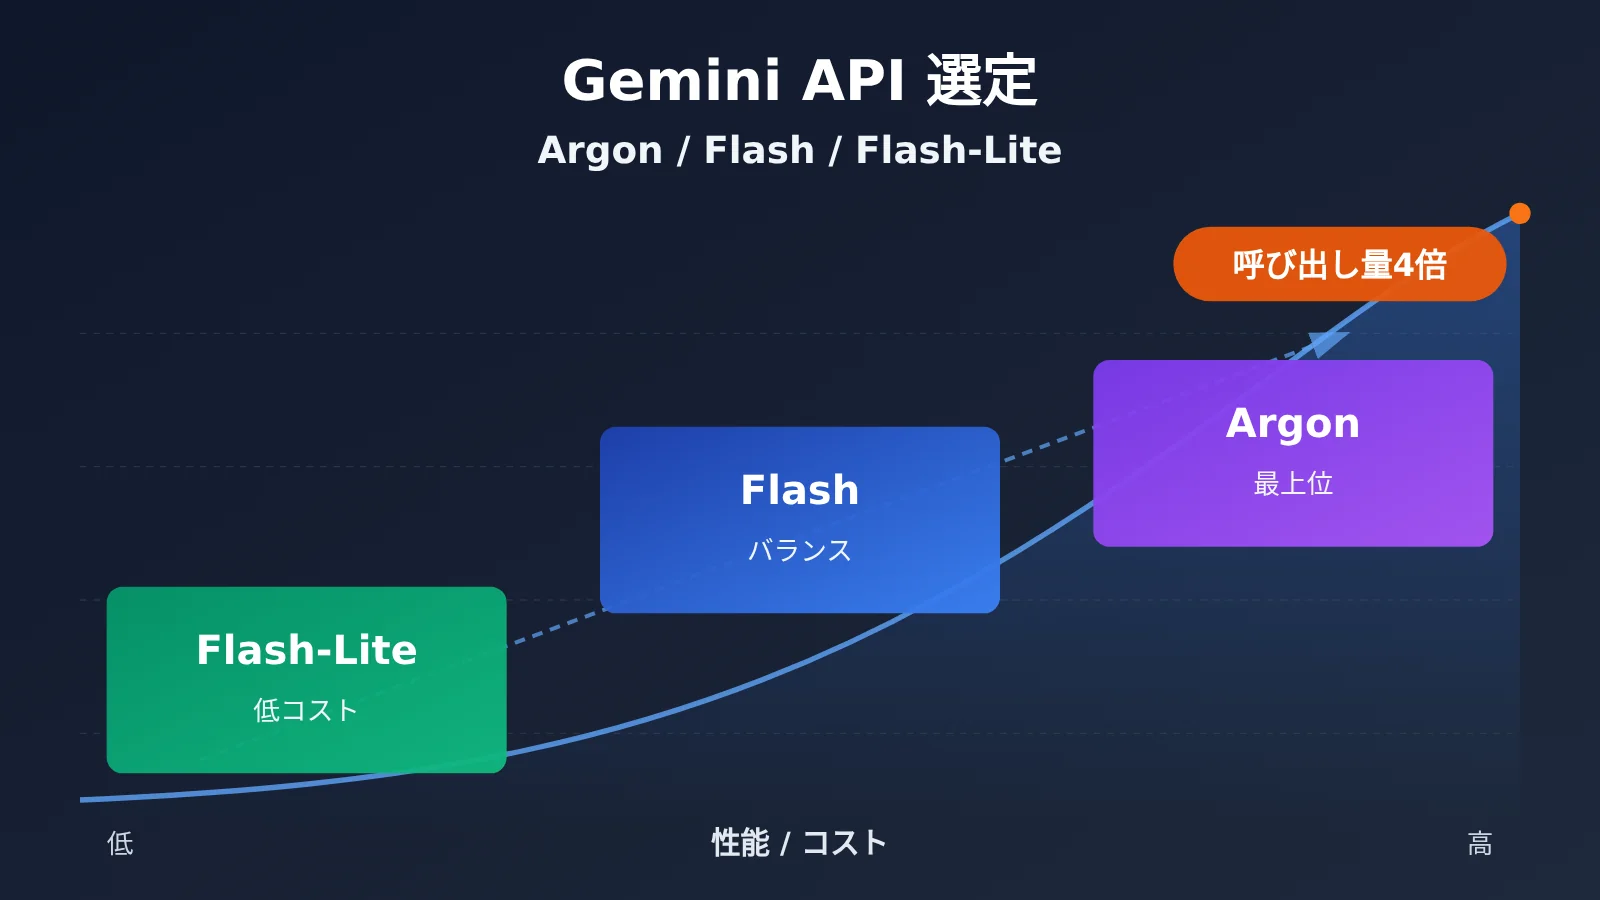
Argon、Flash、Flash-Liteの3つのGeminiモデルの位置づけ
Googleは現在、コストと能力に関するさまざまなニーズに対応するため、3つのモデルを提供しています。以下の表は、公式のモデル仕様ページをもとにまとめたものです。
| 項目 | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| API ID | gemini-4-argon |
gemini-3.8-flash |
gemini-3.5-flash-lite |
| 公式の位置づけ | フラッグシップ推論モデル | 効率と能力のバランスを重視 | 低遅延・低コスト・高スループット |
| コンテキスト | 約100万トークン | 入力1048576トークン | 入力1048576トークン |
| デフォルトの出力上限 | 65536トークン(長文出力の仕組みで拡張可能) | 65536トークン | 65536トークン |
| 思考レベル | low / medium / high、デフォルトはmedium | low / medium / high、デフォルトはmedium | minimal / low / medium / high、デフォルトはminimal |
| ツール機能 | 関数呼び出し、構造化出力、Search Grounding、コード実行 | 関数呼び出し、構造化出力、コード実行、ファイル検索、Search Grounding | 構造化出力、関数呼び出し、キャッシュ |
| 入力モダリティ | テキスト、画像、音声、動画、PDF | テキスト、画像、音声、動画、PDF | テキスト、画像、音声、動画、PDF |
| 無料API枠 | 提供なし | 制限付きの無料枠あり | 制限付きの無料枠あり |
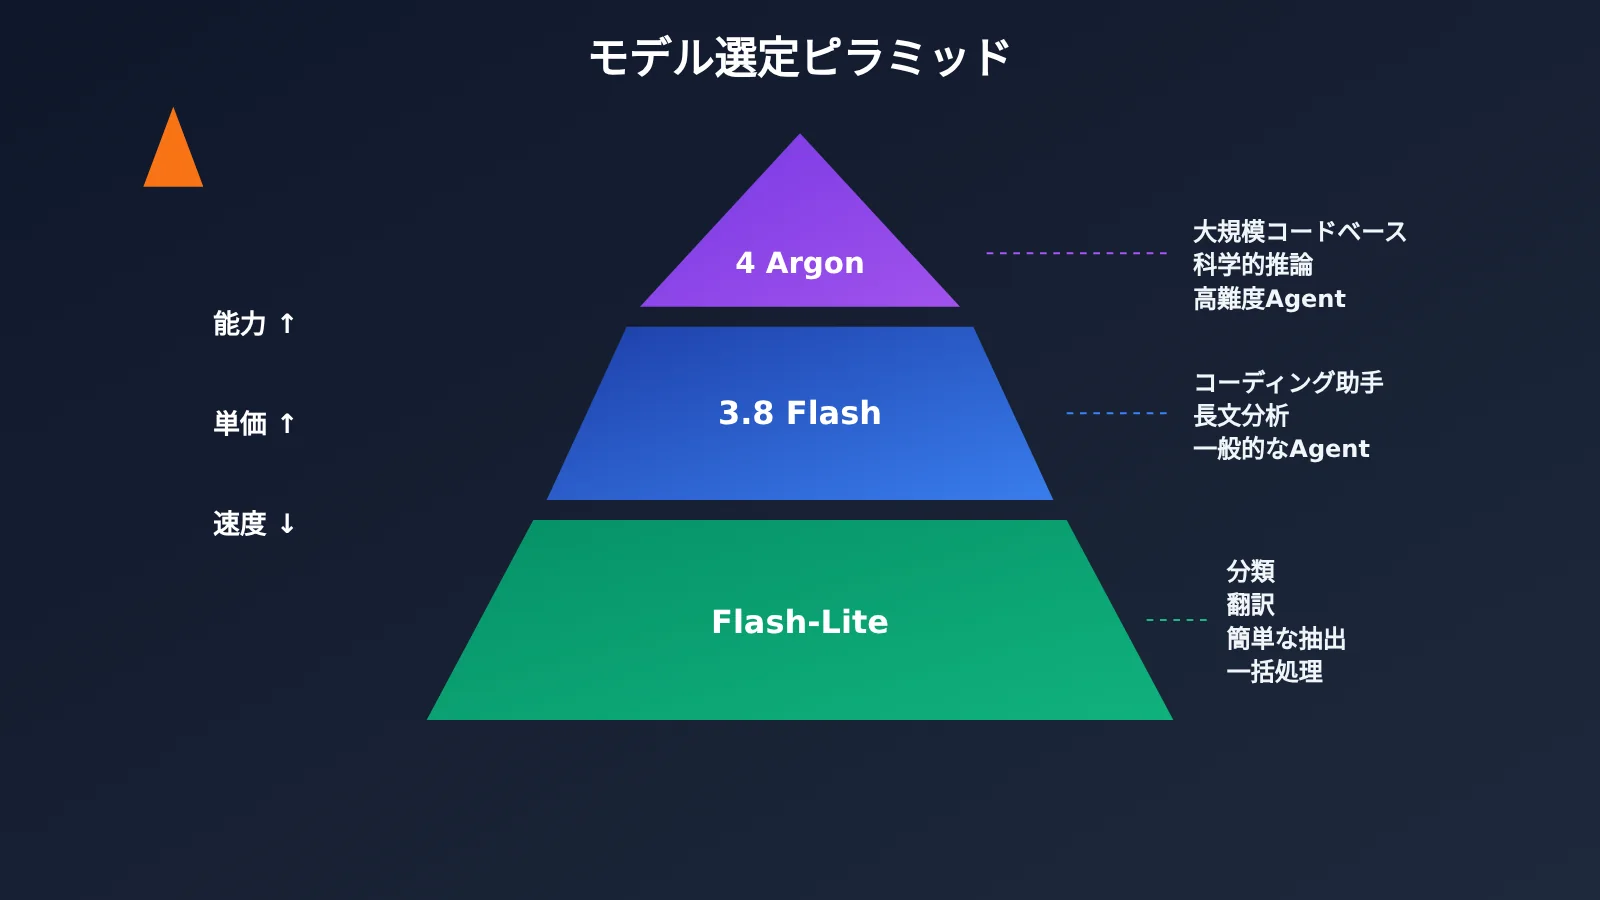
Geminiの3モデルの能力と適用範囲
Argonは2026年10月13日に正式リリースされ、主に複雑なソフトウェアエンジニアリング、数学・科学の推論、自律的な複数ステップのエージェント、長文生成を対象としています。長文出力には専用の仕組みと実行設定が必要で、どのリクエストでも直接100万トークンを返せるわけではありません。
3.8 Flash自体にも推論能力があり、「思考できない廉価版」ではありません。一般的なプログラミングアシスタント、長文ドキュメントの分析、コンテンツ作成、エージェントのワークフローに適しています。3.5 Flash-Liteは2026年7月21日にリリースされ、分類、翻訳、簡単な抽出、ドキュメント解析、エージェント内部の単純なサブタスク向けに最適化されています。一定のプログラミングや推論タスクにも対応でき、上位モデルとの主な違いは、複雑なタスクにおける能力、安定性、コストパフォーマンスにあります。
Gemini API 公式料金:Argon、Flash、Flash-Lite のコスト比較
以下は、Gemini Developer API の標準有料プランにおける公式料金です(単位:米ドル/100万トークン)。サードパーティプラットフォームの上乗せ料金、企業向け契約、ツール呼び出し料金は含みません。
| モデル | 入力 | 出力 | キャッシュヒット時の入力 | 料金の適用期間 |
|---|---|---|---|---|
| Gemini 4 Argon(現在) | $2.00 | $10.00 | $0.10 | 2026-11-30 まで |
| Gemini 4 Argon(改定後) | $4.00 | $20.00 | $0.20 | 2026-12-01 から |
| Gemini 3.8 Flash(現在) | $0.75 | $3.75 | $0.075 | 2026-12-31 まで |
| Gemini 3.8 Flash(改定後) | $1.50 | $7.50 | $0.15 | 2027-01-01 から |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | $0.03 | 料金が倍になる日付は公式に記載なし |
現在の料金では、Argon の入力単価は Flash の約2.67倍、Flash の入力単価は Flash-Lite の2.5倍、Argon の出力単価は Flash-Lite の4倍です。Argon と Flash はどちらも現在プロモーション価格で提供されており、それぞれ2026年11月30日と12月31日に終了します。その後、単価は2倍になります。長期プロジェクトで年間予算を立てる際は、改定後の料金で試算する必要があります。
もう一つ見落としやすいのが、Google ではモデル内部の思考トークンも出力料金に含まれる点です。請求額はユーザーに見える回答の文字数だけで決まるわけではなく、思考レベルを高くすると出力料金が大幅に増えることがあります。リアルタイムの応答が不要なタスクでは、Batch API を利用できます。3モデルとも入力・出力の単価が標準料金より50%安くなりますが、実行方式やキューの制限はリアルタイムリクエストとは異なります。
Gemini 3モデルの独立ベンチマークと速度比較
以下のデータは、独立した第三者評価プラットフォーム Artificial Analysis によるものです。すべて Intelligence Index v5.0 の評価体系を使用しており、旧版の v4.x のスコアは含まれていません。
| 指標 | Gemini 4 Argon(High) | Gemini 3.8 Flash(High) | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| 総合能力指数 v5.0 | 50 | 31 | 12 |
| AutomationBench-AA | 78% | 60% | 25% |
| Terminal-Bench 4.0 | 57% | 20% | 1% |
| FrontierCode 2.0 | 26% | 19% | 6% |
| 観測された出力速度 | 約80トークン/秒強 | 約120〜140トークン/秒 | 約400トークン/秒強 |
| 利用可能なサービス | Google 公式 API、APIYI apiyi.com | Google 公式 API、APIYI | Google 公式 API、APIYI |
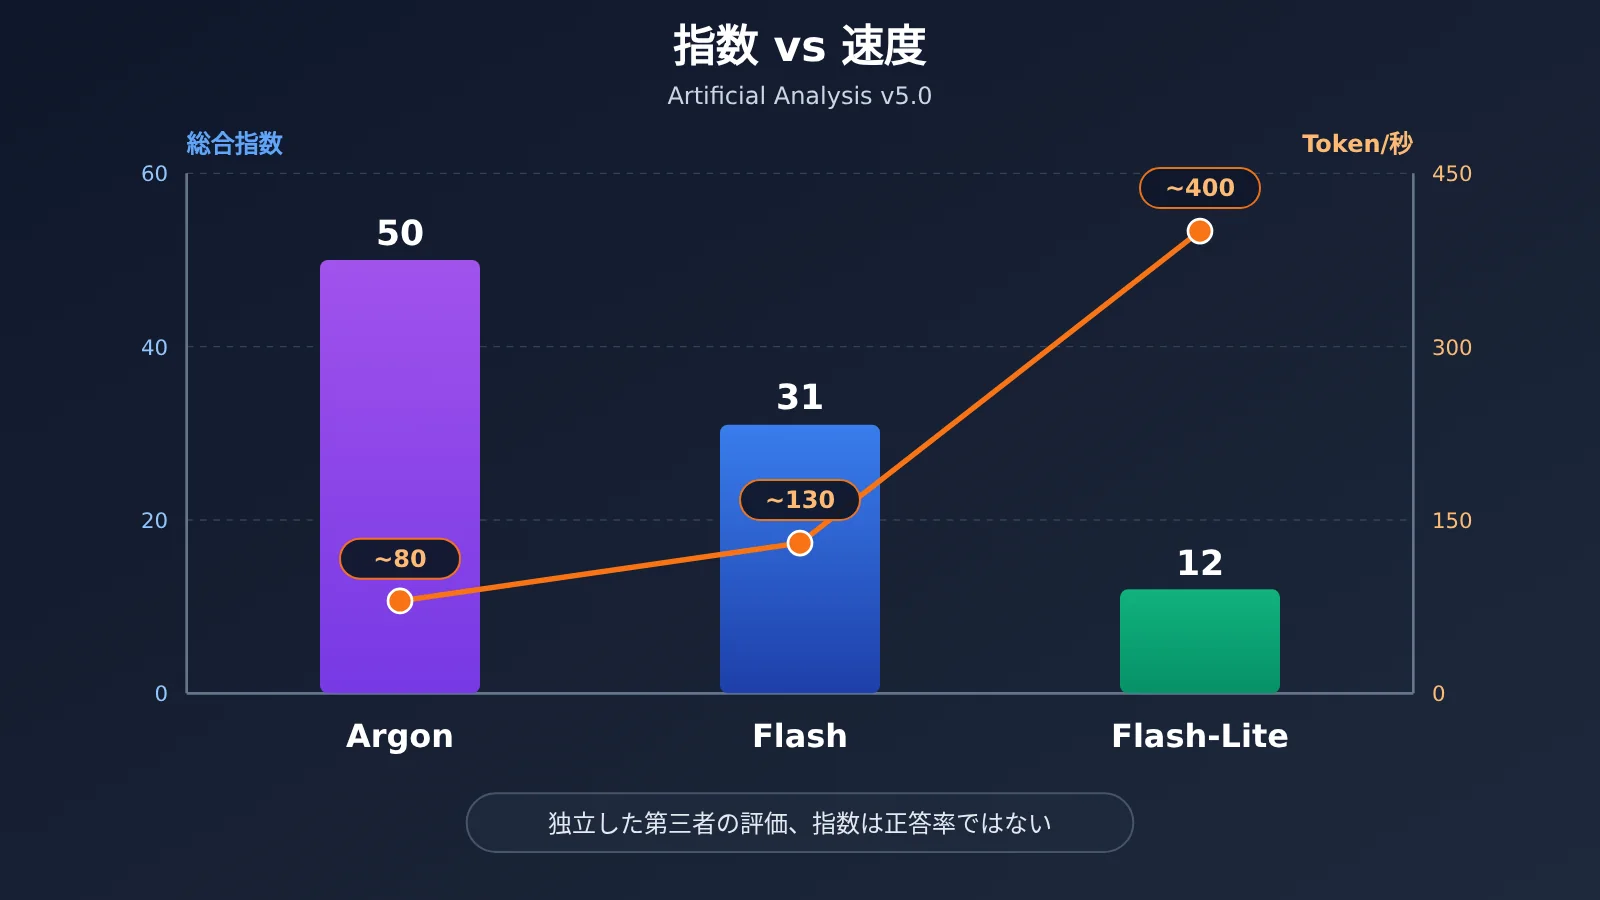
このデータを正しく理解するには、次の3点に注意が必要です。
- 指数は正答率ではない:50、31、12は評価体系内の指数スコアであり、「50%正解した」という意味ではありません。
- 複雑なタスクでは能力差が明確:複雑なプログラミングや自動化のベンチマークでは、Argon が最も強く、Flash が中間、Flash-Lite はそれに続きます。ただし、これは Argon があらゆる単純な業務でも優れていることを証明するものではありません。分類や書式の整理といったタスクでは、3モデルのいずれでも十分に対応できる可能性があります。
- 速度から所要時間を単純に換算することはできない:スループットはサービスの状態によって変わります。実際の所要時間は、思考時間、最初のトークンが出力されるまでの遅延、ツール呼び出し、待ち行列、ネットワークの変動にも左右されます。
💡 比較について:ベンチマークのスコアはモデルの能力差の目安にすぎません。最終的な判断基準は、自分の業務で得られる結果です。APIYI apiyi.com では、同じ APIキーで3つの Gemini モデルを切り替え、手元のサンプルで比較を再現できます。
Gemini APIのコストシミュレーション:Argon、Flash、Flash-Liteの料金差は?
以下は理論上の例であり、実際の請求額ではありません。出力Tokenにすべての思考Tokenが含まれ、キャッシュ、検索ツール、リトライの費用は含まないと仮定し、すべて2026年10月の標準料金で計算しています。
| シナリオの前提 | Gemini 4 Argon | Gemini 3.8 Flash | Gemini 3.5 Flash-Lite |
|---|---|---|---|
| A:1日1000回、1回あたり入力5000 / 出力1000 Token(1日のコスト) | $20.00 | $7.50 | $4.00 |
| A:同じ条件で30日間 | 約 $600 | 約 $225 | 約 $120 |
| B:10万件の分類、1件あたり入力1000 / 出力200 Token | $400 | $150 | $80 |
| B:Batch APIに変更(単価が半額) | 約 $200 | 約 $75 | 約 $40 |
シナリオBが示すのは、同じToken使用量における単価の違いだけです。実際には、モデルごとに思考Token、出力の長さ、リトライ回数が異なります。Flash-Liteに$80をかければ、Argonに$400をかけた場合と同じ品質が得られるとは限りません。また、ArgonとFlashのプロモーション価格が終了すると、表の両モデルの料金は2倍になります。
影響分析:Gemini APIはなぜToken単価だけで判断できないのか
開発者への影響
モデルの「価格」には、少なくとも3つの層があります。1つ目はToken単価、2つ目は入力、出力、思考、コンテキストの繰り返し、リトライを含む、タスクで実際に消費されるTokenです。3つ目は基準を満たすタスクを完了するための総コストで、成功率、手動レビュー、失敗時のリトライ、完了までの時間、エラーによるビジネス上の損失も考慮する必要があります。
単純な分類でFlash-Liteがすでにビジネス上の基準を満たしているなら、Argonに切り替えるのは無駄になります。反対に、複雑なコード関連のタスクでFlash-Liteが何度も失敗する一方、Argonなら少ないリトライで完了できる場合は、Argonのほうが総合的な費用対効果は高くなる可能性があります。これはモデル選定の原則に基づく条件付きの推論であり、3モデルの実際の成功率を統計的に比較した結論ではありません。
コミュニティからの報告も、この点を示しています。あるRedditユーザーは、OpenCode環境でArgon Highを使ってリバースエンジニアリングを行い、1回の実行で約90万Tokenを消費したものの、タスクを完了できませんでした。これは個人のテストであり、業界平均とは見なせませんが、複雑なエージェントワークフローでは大量のTokenを消費しても、成功が保証されないことを示しています。また、Argonを個人向けサブスクリプションで利用した際、すぐに利用上限に達したという報告もあります。これはGeminiのサブスクリプション製品での体験であり、Developer APIの利用上限と同じものではありません。
業界への影響
- 複数モデルを使い分ける構成が標準に:Google Cloudは、タスクの振り分けによって企業のコストを削減するマルチモデルオーケストレーションとSmart Routingについて、すでに公開情報を提供しています。
- 評価指標が「単価」から「基準を満たすタスクのコスト」へ:呼び出し量が増えるほど、ランキングを参考にするのではなく、業務用のテストセットに基づいてモデルを選定することが重要になります。
- 予算の見直し周期が短縮:プロモーション価格が順次終了するため、チームは四半期ごとにモデルの組み合わせと予算を見直す必要があります。
開発者は Argon、Flash、Flash-Lite をどう選ぶ?
以下は、一定の条件を踏まえたおすすめです。あらゆる場面で最適なモデルはありません。
- 大量のデータ分類(10万件のAIニュースをリリース、アップデート、価格、ポリシーなどに分類する場合):まず Flash-Lite を試しましょう。サンプルテストで精度と形式の適合率が基準を満たすことが前提です。満たせない場合は 3.8 Flash に切り替えます。
- 長文資料の構造化(決算報告書や技術文書を事実の一覧表にまとめる場合):まず 3.8 Flash を試しましょう。Lite より理解力が高く、Argon より安価です。文書間の矛盾の検出や難しい推論が必要な場合は、その部分に絞って Argon を呼び出します。
- 複雑なコードプロジェクト(大規模なコードベースの理解、複数段階のリファクタリング):まず Argon を試しましょう。公式の位置づけや第三者によるプログラミングベンチマークでは優れていますが、実際のプロジェクトで成功率、ツールの実行状況、コストを検証する必要があります。
- 大量のシンプルな翻訳:まず Flash-Lite を試しましょう。法律や医療など専門性の高い内容には追加の品質チェックが必須です。安価だからといって、人による確認なしで使うことは避けましょう。
- 企業向け Agent:単一のモデルだけを使うことはおすすめしません。Flash-Lite に分類・抽出・形式の標準化を、3.8 Flash に一般的な計画立案と複数ステップのワークフローを、Argon に難しい推論と問題の原因調査を担当させる方法があります。これは推奨されるエンジニアリング上の戦略であり、Google が義務付けているものではありません。
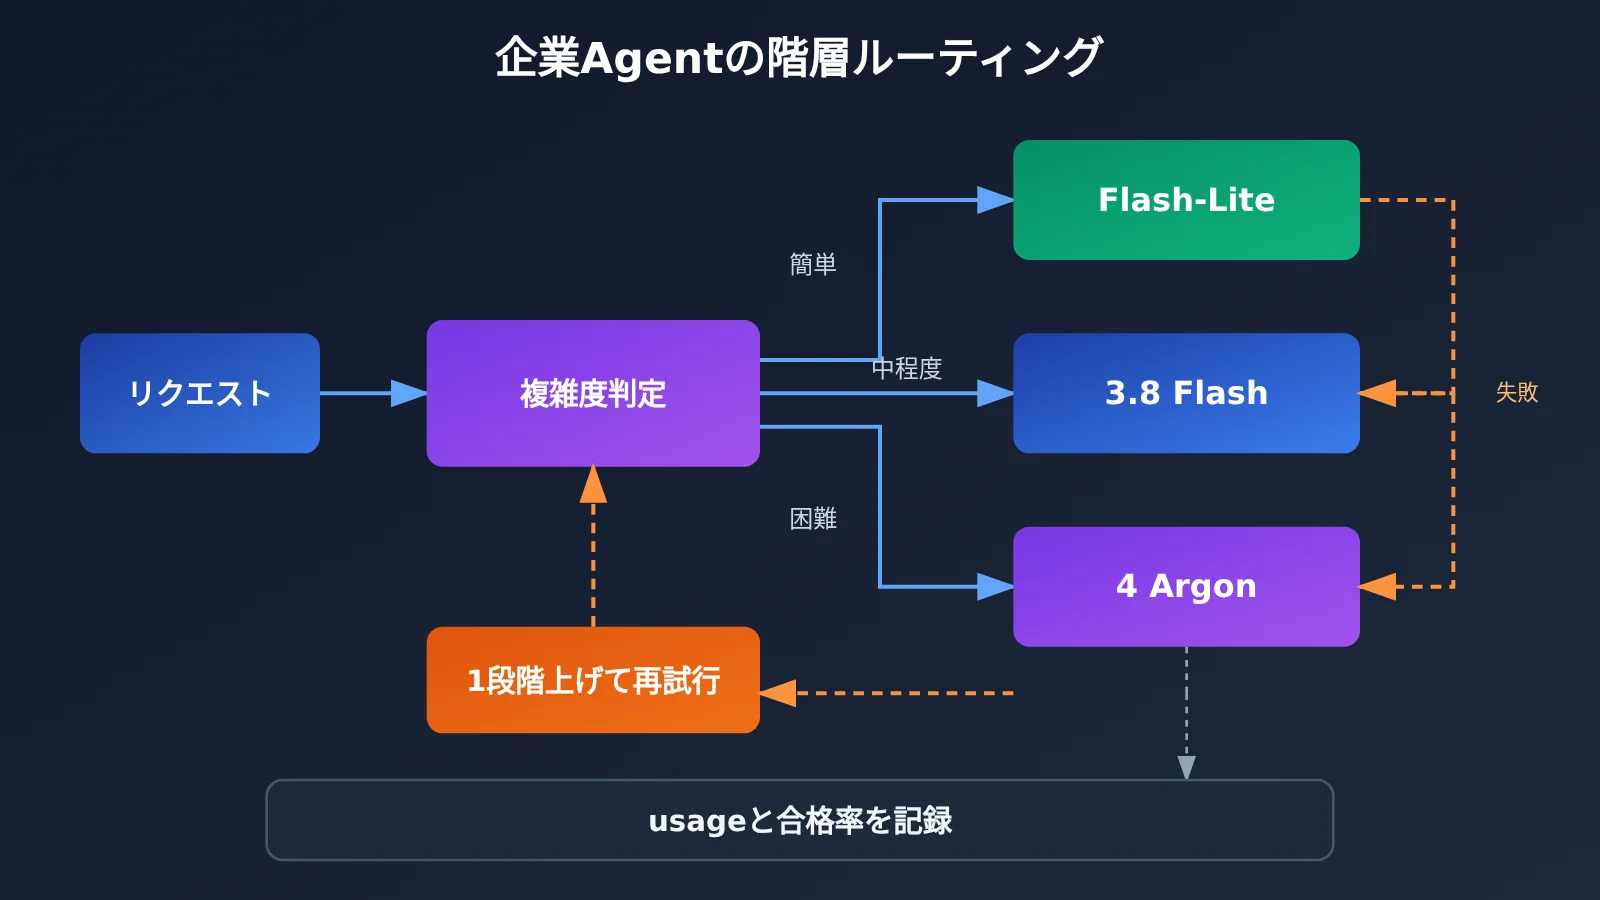
🎯 選び方のポイント:階層型ルーティングでは、3つのモデルを低コストで切り替えられることが重要です。APIYI apiyi.com は OpenAI 互換のインターフェースを提供しており、
modelパラメータを変更するだけでモデルを切り替えられます。まずは小規模な比較テストに活用できます。
クイックスタート:API で Gemini の3モデルを呼び出す
最小限のサンプル
OpenAI SDK を使って呼び出せます。model を変更するだけで、Argon、Flash、Flash-Lite を切り替えられます。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",
    messages=[{"role": "user", "content": "把这条新闻分类为:模型发布/产品更新/价格变化/行业政策"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # 以实际计费 Token 为准,而非可见字数
階層ルーティングとコスト試算の完全なコードを見る
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Google 官方标准价(美元/100万Token,2026年10月),仅用于估算
PRICE = {
    "gemini-3.5-flash-lite": (0.30, 2.50),
    "gemini-3.8-flash": (0.75, 3.75),    # 2027-01-01 起翻倍
    "gemini-4-argon": (2.00, 10.00),     # 2026-12-01 起翻倍
}
TIERS = ["gemini-3.5-flash-lite", "gemini-3.8-flash", "gemini-4-argon"]

def estimate_cost(model: str, usage) -> float:
    pin, pout = PRICE[model]
    # completion_tokens 应包含思考 Token,具体以返回字段为准
    return usage.prompt_tokens / 1e6 * pin + usage.completion_tokens / 1e6 * pout

def run(prompt: str, start_tier: int = 0, validator=None):
    """从低档模型开始,不合格则升级一档,记录每次成本"""
    total = 0.0
    for model in TIERS[start_tier:]:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        text = resp.choices[0].message.content
        cost = estimate_cost(model, resp.usage)
        total += cost
        print(f"{model}: tokens={resp.usage.total_tokens}, cost≈${cost:.5f}")
        if validator is None or validator(text):
            return {"model": model, "output": text, "total_cost": total}
    return {"model": None, "output": None, "total_cost": total}

result = run(
    "从以下文本抽取公司名和金额,输出JSON:...",
    validator=lambda t: t.strip().startswith("{"),
)
print(result)
🚀 クイックスタート:まず APIYI(apiyi.com)で新規ユーザー向けの無料テスト枠を取得し、代表的なサンプル100〜300件で3段階のモデルを比較してから、本番環境で使用するデフォルトのモデルを決めることをおすすめします。なお、サードパーティ製プラットフォームの料金、利用枠、キャッシュのサポートは Google への直接接続と異なる場合があるため、各プラットフォームの実際の規定を確認してください。
Gemini API を本番導入する前の注意点
- 呼び出し制限:Gemini API は RPM、TPM、RPD によってレート制限されます。制限は個々のキーではなくプロジェクト単位で計算され、いずれかを超えるとエラーになります。
- 思考トークン:出力料金には思考トークンも含まれます。usage metadata を確認し、画面に表示される回答の長さだけでコストを見積もらないようにしましょう。
- キャッシュ:Argon は暗黙的キャッシュのみをサポートし、明示的キャッシュには対応していません。Flash と Flash-Lite はキャッシュに対応しており、実際の課金は設定によって異なります。
- 無料枠のデータ:無料枠のデータは製品改善に使用される可能性があります。企業の機密データを無料枠に入力せず、本番導入前にサービス利用規約を確認してください。
- テスト指標:成功率、事実の正確性、構造の準拠率、ハルシネーションの件数、平均レイテンシとテールレイテンシ、実際のトークン数、リトライ回数、基準を満たしたタスクあたりのコストを記録しましょう。デフォルトの思考レベルはモデルによって異なるため、レポートには実際に使用した設定を明記してください。
Gemini APIのモデル選びに関するよくある質問 FAQ
Q1:Gemini 4 Argon、3.8 Flash、3.5 Flash-Liteはそれぞれどんなモデルですか?
この3つは、現在のGoogle Gemini APIを代表する3つのモデルです。Argonはフラッグシップの推論モデル、3.8 Flashは性能と効率のバランスに優れたモデル、3.5 Flash-Liteは低遅延・低コスト・高スループットを重視したモデルです。いずれも約100万トークンの入力コンテキストに対応し、テキストを出力します。
Q2:ArgonとFlashの割引価格はいつ終了しますか?
Argonの現在の価格は2026年11月30日までで、12月1日から入力・出力・キャッシュの単価がすべて2倍になります。3.8 Flashは2026年12月31日までで、2027年1月1日から2倍になります。Flash-Liteについては、現時点で公式に同様の値上げ日は示されていません。
Q3:Artificial Analysisの50点は、正答率50%を意味しますか?
いいえ。50、31、12はIntelligence Index v5.0の総合指数スコアであり、正答率ではありません。モデル間のおおまかな性能差を比較するのには適していますが、業務での成功率に直接換算することはできません。
Q4:3つのGeminiモデルを低コストで比較するにはどうすればよいですか?
複数のモデルに対応したOpenAI互換インターフェースの利用がおすすめです。APIYI(apiyi.com)に登録してAPIキーと無料利用枠を取得したら、この記事のサンプルにある `model` を3つのAPI IDに順番に変更し、同じサンプルでusageと合格率を記録するだけで比較できます。
Q5:RedditではArgonの利用枠が数ターンでなくなると言われていますが、APIでも同じですか?
その報告はGeminiのコンシューマー向けサブスクリプションに関するもので、Developer APIの制限とは異なります。APIのクォータは支払い階層、プロジェクトの状態、モデルによって決まり、RPM・TPM・RPDで計算されます。集約プラットフォーム経由で呼び出す場合は、そのプラットフォーム独自の利用枠ルールも適用されます。APIYI(apiyi.com)のコンソールで、実際に利用できるモデルと課金方式を確認できます。
Q6:3つのモデルにはそれぞれどんな既知の弱点がありますか?
Argonは単価が最も高く、速度も最も遅いうえ、通常の無料枠がありません。また、複雑なエージェントタスクでは大量のトークンを消費する可能性があります。3.8 Flashは、特に難易度の高いターミナル操作やプログラミングのベンチマークでArgonとの差が目立ちます。Flash-Liteは複雑なプログラミングや自動化タスクがやや苦手で、専門分野の翻訳には人による確認が必要です。
Gemini API選定のポイント Key Takeaways
- ニュースの背景:Google純正モデルのAPI利用量は毎分約320億トークンに達しています。これは全体の伸びであり、単一モデルの実績ではありません。
- 3つのモデルの役割:Argonは複雑な推論、3.8 Flashはバランスの取れた主力モデル、Flash-Liteは高スループットが求められる軽量タスクを担います。
- 価格差:現在の入力単価はそれぞれ$2 / $0.75 / $0.30です。ArgonとFlashはプロモーション価格の終了後、2倍になります。
- 評価結果の読み方:AA v5.0指数はそれぞれ50 / 31 / 12です。これは正答率ではなく指数であり、単純なタスクでは必ずしも差が開くとは限りません。
- 見落としがちなコスト:思考トークンは出力に計上されます。キャッシュ、再試行、ツールの料金も含めて、最終的な請求額が決まります。
- 試し方:APIYI apiyi.comなら、1つのAPIキーで3つのモデルを切り替え、100~300件のサンプルで比較テストできます。
まとめ
Gemini APIの呼び出し量の急増は、大規模言語モデルが大規模な本番運用の段階に入ったことを示しています。ただし、モデル選定の基本は変わりません。
- タスクに応じて使い分ける:分類や翻訳にはまずFlash-Lite、文書の構造化には3.8 Flash、複雑なコードや難度の高いエージェントにはArgonを試しましょう。
- 品質基準を満たすタスクのコストを見る:最適化すべきなのは、100万トークンあたりの最安単価ではなく、品質基準を満たすタスク1件あたりの総コストです。
- 価格の適用期限に注意する:Argonは11月30日、Flashは12月31日にプロモーション価格が終了します。予算は改定後の価格で見積もりましょう。
開発者が本当に必要としているのは、常に最も高性能なモデルでも、常に最も安いモデルでもありません。許容できるコストで業務タスクを安定してこなせるモデルの組み合わせです。まずはAPIYI apiyi.comの無料枠で3つのモデルを比較テストし、その結果を踏まえて本番環境のルーティング戦略を決めることをおすすめします。
📚 参考資料
- Alphabet 2026年第3四半期決算 CEOメッセージ:毎分320億トークンのデータ出典
- リンク:
blog.google/company-news/inside-google/message-ceo/alphabet-earnings-q3-2026/ -
概要:ニュースの背景とAPI利用量の増加に関する一次情報
-
Gemini API 公式料金表:3モデルの標準料金、キャッシュ料金、Batch料金
- リンク:
ai.google.dev/gemini-api/docs/pricing -
概要:プロモーション価格の終了日と、思考トークンの課金に関する説明を掲載
-
Gemini モデル仕様ドキュメント:Argon / 3.8 Flash / 3.5 Flash-Lite
- リンク:
ai.google.dev/gemini-api/docs/models/gemini-4-argon -
概要:コンテキストウィンドウ、出力上限、思考レベル、ツール機能
-
Artificial Analysis モデル比較:独立した第三者による評価 v5.0
- リンク:
artificialanalysis.ai/models/comparisons/gemini-4-argon-vs-gemini-3-8-flash -
概要:総合指標、分野別ベンチマーク、速度の測定結果
-
Gemini API レート制限と思考の仕組み:RPM/TPM/RPDと思考設定
- リンク:
ai.google.dev/gemini-api/docs/rate-limits -
概要:本番運用前に確認しておきたいクォータと思考トークンのルール
-
Google Cloud マルチモデルオーケストレーション:Smart Routingとエージェントのコスト管理
- リンク:
cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026 - 概要:企業向けの階層型ルーティングに関する公式の考え方
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI公式サイトのトップページからお問い合わせください。接続に関する詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。