Note de l’auteur : à partir des 10 évaluations inter-modèles publiées par Google DeepMind, cet article décrypte les forces et faiblesses de Gemini 4 Hydrogen, GPT-6.1 Terra et Claude Sonnet 5.5 en programmation, automatisation d’agents et utilisation d’ordinateur, puis propose des recommandations de choix selon la tâche.
Résumé en une phrase : les évaluations inter-modèles publiées par Google montrent que Gemini 4 Hydrogen et Claude Sonnet 5.5 ont chacun leurs avantages sur différentes tâches de programmation et d’agents, tandis que GPT-6.1 Terra se distingue par son positionnement en coût et en opérations visuelles. Le choix réel doit tenir compte des conditions de test, du type de tâche et du coût.
À savoir : 5 termes à comprendre avant de lire cet article
- Harness : cadre de test qui organise les entrées du modèle, l’exécution des outils et la notation des tâches. Avec un même modèle, un changement de Harness peut modifier sensiblement les résultats.
- Version de référence : version des données, des tâches et des règles d’une évaluation. Par exemple, Terminal-Bench 4.0 et 4.1 sont des versions différentes : les scores doivent être interprétés séparément.
- Agent : système dans lequel le modèle et l’environnement d’exécution des outils accomplissent ensemble une tâche en plusieurs étapes. Le score reflète la performance globale du « modèle + chaîne d’outils ».
- Token : unité de mesure utilisée par le modèle pour traiter du texte et d’autres informations. Le prix des API est généralement facturé par million de Tokens.
- API : interface permettant à un programme d’appeler un service. Les développeurs l’utilisent pour intégrer le modèle à leur application ou à leur Agent.
Le 12 novembre 2026, Google a officiellement lancé Gemini 4 Hydrogen, et l’a placé dans sa fiche modèle officielle aux côtés de GPT-6.1 Terra et Claude Sonnet 5.5 dans un même tableau d’évaluation. Ce tableau couvre la programmation, l’automatisation d’agents, l’utilisation d’ordinateur et le travail intellectuel multimodal : c’est actuellement l’ensemble de données comparatives publiques le plus concentré sur ces trois modèles.
Ce n’est pas une analyse de compromis qui « donne raison à tout le monde ». Nous allons décomposer, test par test, ce que mesure chaque évaluation et dans quelles conditions les résultats ont été obtenus, puis tirer des conclusions séparément pour la programmation, les agents et l’utilisation d’ordinateur, avant de produire une matrice de sélection directement applicable.
L’essentiel : après lecture, vous saurez clairement sur quelles tâches Gemini 4 Hydrogen est en tête, sur lesquelles il reste derrière Sonnet 5.5, et quelle place Terra peut occuper dans le flux de travail de votre équipe.
Pourquoi comparer Gemini 4 Hydrogen à Terra et Sonnet 5.5
Les trois modèles sont sortis à moins de deux mois d’intervalle et leurs positionnements se recoupent largement : ce ne sont pas les modèles de raisonnement phares les plus lourds de chaque éditeur, mais des « modèles de travail principaux » destinés aux développeurs, à l’exécution d’agents et aux tâches professionnelles à haute fréquence. Pour les équipes qui doivent les appeler massivement chaque jour, c’est justement cette couche qui détermine réellement le coût et l’efficacité.
Gemini 4 Hydrogen est le nouveau modèle haute efficacité de Google DeepMind. Il est officiellement positionné pour le codage quotidien et l’exécution d’agents IA ; il peut fonctionner seul ou servir d’exécutant ou de vérificateur dans un système multi-modèles. GPT-6.1 Terra a été publié par OpenAI le 26 octobre 2026, avec l’accent sur le raisonnement visuel, l’utilisation de l’ordinateur et le travail quotidien à haut rendement. Claude Sonnet 5.5 a été publié par Anthropic le 28 septembre 2026 ; Anthropic met en avant le codage quotidien, la correction de bugs, la production de documents professionnels et la conception d’interfaces complexes.
| Modèle | Éditeur | Date de publication | Positionnement officiel | Tarif API standard (par million de tokens, entrée/sortie) | Source du tarif |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | Codage quotidien, appels à plusieurs outils, exécution d’agents | $1.50 / $7.50 | Page tarifaire de Google AI Studio, vérifiée le 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | Raisonnement visuel, utilisation de l’ordinateur, travail quotidien | $1 / $5 | Documentation de lancement d’OpenAI, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | Codage quotidien, correction de bugs, documents professionnels, conception d’interfaces | Non couvert par les sources de référence ; se référer à la page tarifaire officielle | Anthropic officiel |
Il faut préciser que les tokens de réflexion de Hydrogen sont facturés au prix de sortie : le coût réel ne peut pas être estimé uniquement à partir du texte final visible. Par ailleurs, les modes Batch et Flex de Hydrogen sont facturés $0.75 / $3.75, ce qui convient aux tâches par lots hors ligne.
La comparaison quantitative de cet article s’appuie principalement sur la fiche modèle de Google DeepMind de novembre 2026 et les documents de méthodologie d’évaluation associés. Cela signifie que les données sont compilées par Google, et qu’une partie des résultats des concurrents provient de rapports publics des éditeurs ou de classements ; nous verrons dans la section 5 l’impact de ce point sur les conclusions.
Comparaison des capacités de programmation de Gemini 4 Hydrogen : qui répare le mieux les problèmes réels ?
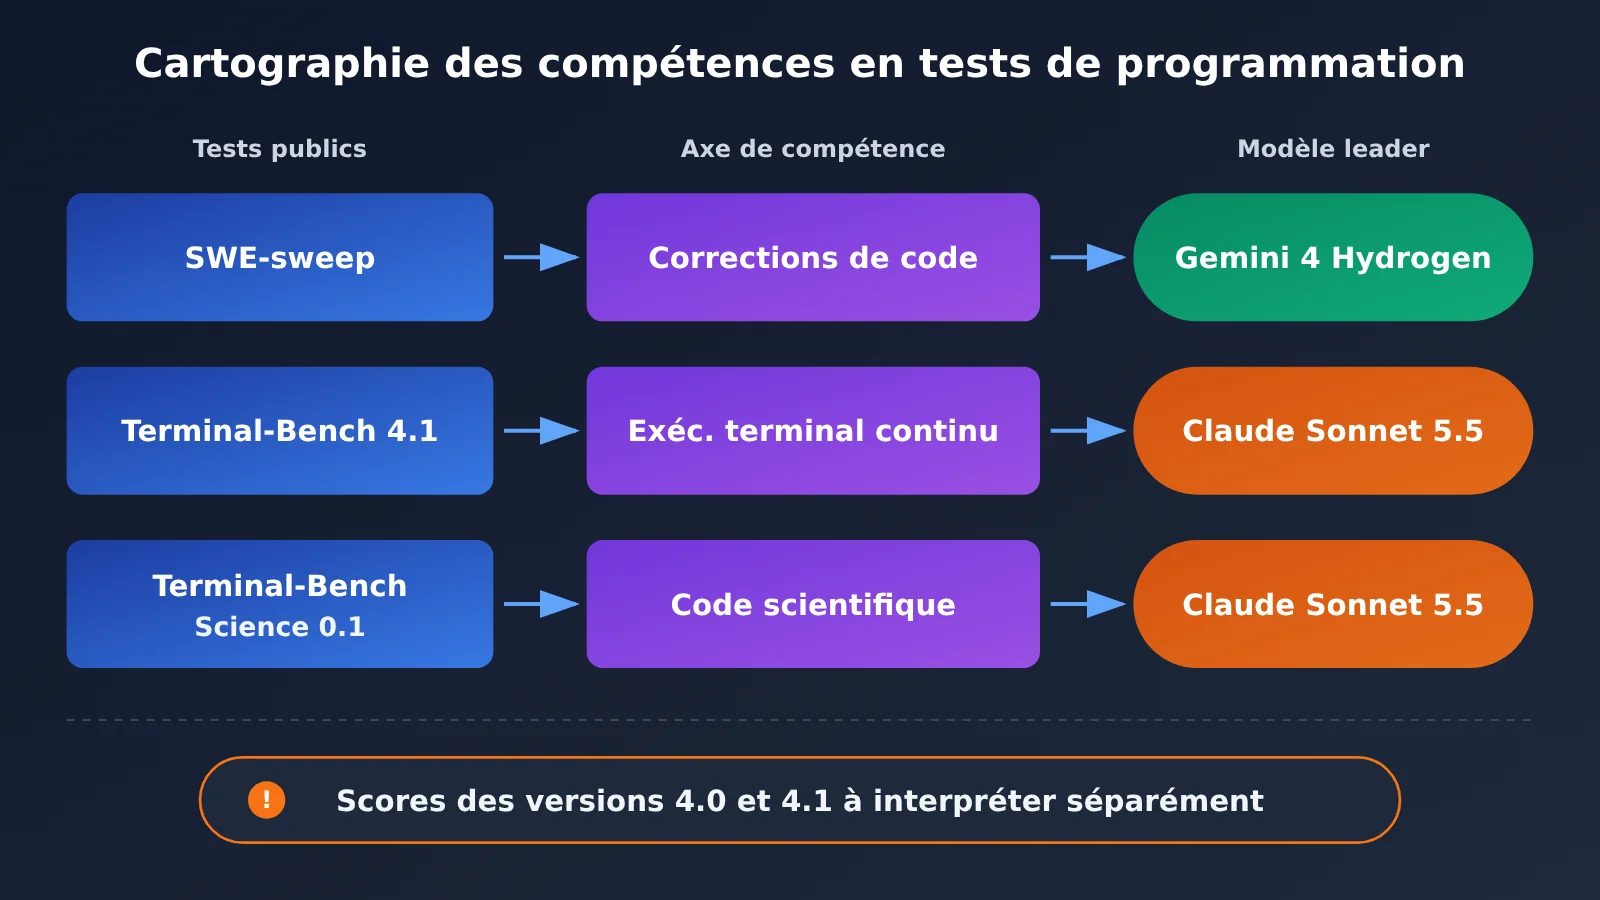
Les tests de programmation peuvent se diviser en deux grands types de compétences : d’un côté, repérer et corriger des problèmes dans une base de code réelle ; de l’autre, enchaîner des commandes dans un terminal pour mener à bien une tâche d’ingénierie. SWE-sweep évalue plutôt la première, la série Terminal-Bench la seconde, tandis que Terminal-Bench-Science mesure la capacité à accomplir des tâches de recherche scientifique avec du code.
| Évaluation (version) | Indicateur | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Leader |
|---|---|---|---|---|---|
| SWE-sweep | Récompense pondérée par sous-tâche | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 | Récompense moyenne | 57.0% | 63.9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | Score de tâche | 51.4% | 59.9% | 58.3% | Sonnet |
Source : Google DeepMind, « Gemini 4 Hydrogen Model Evaluation » et fiche modèle, novembre 2026.
Décryptage des résultats des tests de programmation
Les scores absolus de SWE-sweep sont globalement bas, ce qui confirme qu’il s’agit d’un test particulièrement difficile. Hydrogen obtient 13.5%, soit environ plus du double de Terra et plus du quadruple de Sonnet : c’est sur cette évaluation que l’écart est le plus net. Toutefois, pour cette évaluation, Hydrogen a été exécuté avec Antigravity-CLI 1.4.8, l’outil maison de Google, et les conditions d’exécution des concurrents ne sont pas nécessairement identiques. Une partie de l’écart peut donc venir de l’adaptation au harness.
Sur Terminal-Bench 4.1, Sonnet 5.5 devance Hydrogen avec 63.9% contre 57.0%, tandis que Terra n’a pas de score pour cette évaluation dans le tableau de Google. Pour ce test, Hydrogen utilise le harness mini-swe-agent vision et le niveau de réflexion High, avec 5 exécutions par tâche et une récompense moyenne. Sur Terminal-Bench-Science 0.1, Sonnet reste en tête, Terra suit de près avec 58.3%, et Hydrogen se retrouve troisième.
Conclusion pour la programmation : Hydrogen a un avantage marqué sur les tests de correction de problèmes dans une base de code comme SWE-sweep ; Sonnet 5.5 est plus régulier sur les tâches d’exécution en terminal ; Terra est proche de Sonnet sur les tâches de code scientifique. Aucun modèle ne domine l’ensemble des tests de programmation.
Données Terminal-Bench 4.0 déclarées par les éditeurs
OpenAI et Anthropic ont chacun publié des résultats sur Terminal-Bench 4.0. Comme 4.0 et 4.1 sont deux versions différentes du benchmark, le tableau ci-dessous est présenté à part : il ne faut pas comparer directement ces scores avec ceux de la version 4.1 du tableau précédent.
| Évaluation (version) | Modèle | Score | Conditions de test | Source |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | Auto-évaluation de l’éditeur | Documentation de publication Anthropic, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | Configuration de raisonnement maximale | Documentation de publication OpenAI, 2026-10-26 |
L’intérêt de ces données est de fournir un point de comparaison : dans les conditions de test propres à chaque éditeur, Sonnet 5.5 est nettement plus performant que Terra sur les tâches en terminal, ce qui va dans le même sens que l’avance de Sonnet sur les tests de terminal dans le tableau de Google.
Gemini 4 Hydrogen peut-il réaliser un travail complet dans les tests d’agents et d’automatisation ?
La grande différence entre les tests d’agents et les questions-réponses à un seul tour, c’est que le modèle doit planifier lui-même les étapes, appeler des outils en continu, ajuster sa stratégie après un échec et, au final, vérifier le résultat. Ces tests ressemblent davantage à de vrais workflows automatisés et mettent aussi plus à l’épreuve la « discipline d’exécution » du modèle.
Le tableau ci-dessous regroupe tous les scores inter-modèles des évaluations Google sur l’automatisation par agents, les opérations sur ordinateur et le travail de connaissances multimodal ; les sections 3 et 4 partagent ce tableau.
| Évaluation (version) | Axe de compétence | Métrique | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | Agent spécialisé multi-étapes | Score de tâche | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | Automatisation de workflows | Score de tâche | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | Gestion simulée sur longue durée | Solde final en capital | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | Opérations sur ordinateur/interface graphique | Taux de réussite des tâches | 77.6% | 83.9% | 74.2% |
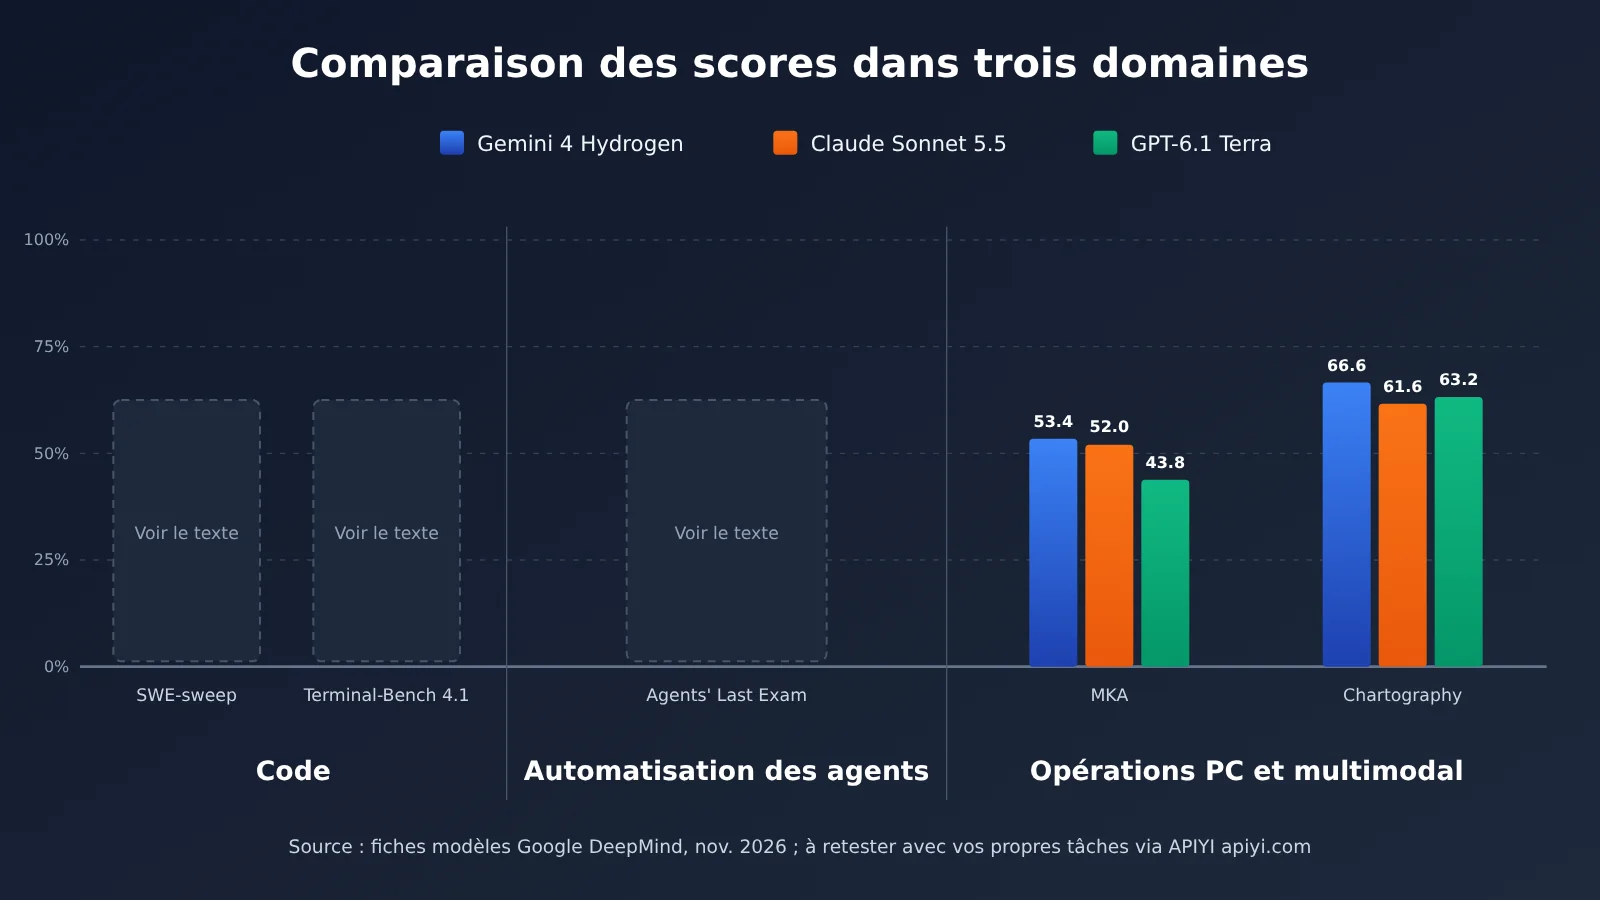
| MKA | Travail de connaissances multimodal | Score de tâche | 53.4% | 52.0% | 43.8% |
| Chartography | Compréhension de graphiques (sans outils) | Précision | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | Raisonnement sur connaissances difficiles | Précision | 58.8% | 53.3% | 47.3% |
Source : fiche modèle de Google DeepMind et document « Gemini 4 Hydrogen Model Evaluation », novembre 2026.
Lecture des résultats sur les agents et l’automatisation
Agents’ Last Exam v1.1 comprend 122 tâches et une fenêtre de 5 heures ; Hydrogen l’exécute également avec Antigravity-CLI 1.4.8. Hydrogen mène avec 71.6%, mais il faut noter que Terra suit juste derrière à 69.8%, soit près de 10 points de pourcentage de plus que Sonnet. Cela montre que Terra n’est pas faible sur les tâches spécialisées multi-étapes.
La configuration d’AutomationBench-AA est différente : Hydrogen à 76.1%, Sonnet à 71.8%, et Terra nettement derrière à 60.2%. Si votre activité repose sur beaucoup d’automatisation de processus inter-systèmes, cet écart mérite votre attention.
Vending-Bench 2 est une tâche de gestion simulée sur longue durée, dont la métrique est le solde final en capital plutôt que la précision. Hydrogen mène nettement avec $14,549 ; on peut y voir un indicateur complémentaire de « stabilité des décisions sur long cycle », mais il s’agit d’un seul environnement simulé, qu’il ne faut pas généraliser directement à toutes les tâches longues.
Conclusion pour le domaine des agents : dans les tests d’agents et d’automatisation listés par Google, Hydrogen arrive en tête partout ; Terra est proche de Hydrogen sur les tâches spécialisées multi-étapes, mais reste derrière en automatisation de processus ; Sonnet se situe entre les deux.
🚀 Démarrage rapide : les scores des agents dépendent fortement du harness et de la définition des outils ; les scores publics ne peuvent servir que de point de départ. Je vous conseille de faire tourner les trois modèles via APIYI apiyi.com avec la même chaîne d’outils et le même lot de tâches réelles ; une seule clé API suffit pour basculer, ce qui facilite l’obtention de données comparatives adaptées à votre propre contexte.
Gemini 4 Hydrogen et Sonnet 5.5 : qui est le plus fort en utilisation d’ordinateur et en travail intellectuel multimodal ?
Les tests d’utilisation d’ordinateur demandent au modèle de « regarder l’écran, cliquer et taper au clavier », ce qui correspond directement à des scénarios comme l’automatisation du navigateur ou des logiciels de bureautique. Le travail intellectuel multimodal, lui, évalue la lecture de fichiers complexes et la compréhension de graphiques, ce qui renvoie à l’analyse de rapports financiers, à la synthèse d’études, etc.
OSWorld-2.1 : Sonnet 5.5 en tête sur les opérations d’interface graphique
Dans l’évaluation de Google, OSWorld 2.1 utilise 82 tâches hors ligne, en résolution 1080p, avec un maximum de 500 étapes ; le modèle observe via des captures d’écran et exécute les actions via PyAutoGUI. Sonnet 5.5 arrive en tête avec 83.9 %, devant Hydrogen à 77.6 % et Terra à 74.2 %.
Il faut toutefois signaler un problème de convention de mesure : Anthropic publie pour Sonnet 5.5 un score de 80.1 % sur une partie des tests OSWorld 2.1, tandis que le tableau comparatif de Google retient 83.9 %, ce dernier chiffre ayant été obtenu par Google dans des conditions définies, en prenant le meilleur résultat de plusieurs exécutions. Autrement dit, un test portant le même nom peut donner des scores différents selon le fournisseur ; pour comparer, il faut toujours s’en tenir à une même source.
MKA et Chartography : Hydrogen légèrement en tête
Dans MKA, qui évalue le travail intellectuel multimodal, Hydrogen (53.4 %) et Sonnet (52.0 %) sont très proches, tandis que Terra (43.8 %) est environ 10 points derrière. Chartography teste la compréhension de graphiques sans utilisation d’outils : Hydrogen mène avec 66.6 %, et chose intéressante, Terra se classe deuxième à 63.2 %, devant Sonnet à 61.6 %, ce qui correspond au positionnement d’OpenAI pour Terra sur le « raisonnement visuel ».
Conclusion sur l’utilisation d’ordinateur et le multimodal : pour les opérations d’interface graphique, privilégiez Sonnet 5.5 ; pour la lecture de fichiers complexes et l’intégration de connaissances multimodales, Hydrogen et Sonnet sont proches, avec un léger avantage à Hydrogen ; pour la simple compréhension de graphiques, Hydrogen est en tête, et Terra reste compétitive.
Comment lire correctement les données d’évaluation publiques de Gemini 4 Hydrogen
Le piège le plus fréquent quand on lit une évaluation publique, c’est de prendre un tableau pour un relevé de notes obtenu « dans la même salle d’examen, avec les mêmes règles ». En réalité, le document méthodologique d’évaluation de Google précise plusieurs préalables essentiels :
- Niveau de réflexion : Hydrogen est généralement testé avec le réglage de réflexion le plus élevé, mais certains projets font exception — Terminal-Bench 4.1 utilise par exemple le niveau High.
- Harness d’exécution : SWE-sweep et Agents’ Last Exam utilisent Antigravity-CLI 1.4.8, Terminal-Bench 4.1 utilise le harness mini-swe-agent vision, et OSWorld 2.1 s’appuie sur des captures d’écran plus PyAutoGUI.
- Nombre d’exécutions : Terminal-Bench 4.1 fait tourner chaque tâche 5 fois et retient la récompense moyenne, alors que pour OSWorld les scores des concurrents prennent le meilleur résultat sur plusieurs exécutions — les deux méthodes statistiques sont déjà différentes en soi.
- Provenance des scores : les résultats des concurrents viennent principalement des rapports publics et des classements de chaque éditeur ; tous les modèles ne sont pas exécutés par la même équipe selon un protocole unique.
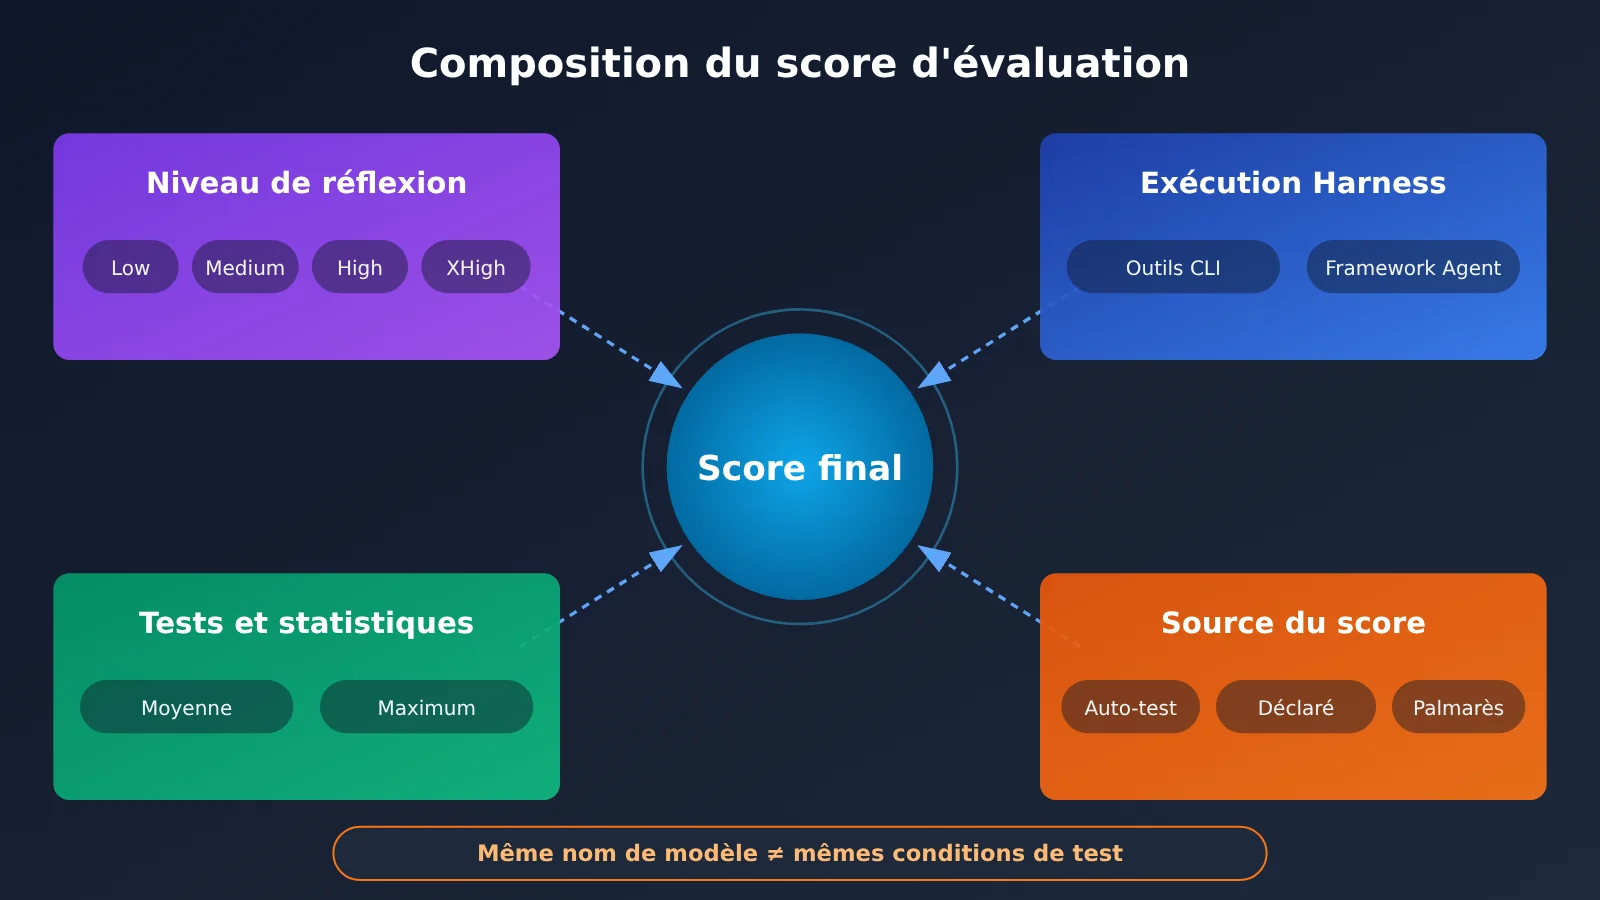
L’impact du niveau de réflexion est particulièrement marqué. Le 12 novembre, Artificial Analysis a mené une évaluation indépendante des quatre niveaux de Hydrogen : indice d’intelligence de 27 pour Low, 41 pour Medium, 51 pour High (par défaut) et 54 pour XHigh ; le coût moyen correspondant de ses tâches d’évaluation standardisées va de $0.29 à $3.16. Ce sont les résultats sur ses tâches de référence, pas le coût réel facturé à l’utilisateur à chaque appel, mais cela suffit à montrer qu’un même modèle varie énormément selon le niveau : XHigh ne gagne que 3 points sur High, alors que le coût augmente nettement.
Donc, en lisant les scores de cet article, gardez deux choses en tête : premièrement, les conclusions ne portent que sur les tests publics listés ; deuxièmement, ne collez pas bout à bout les données les plus favorables du tableau de Google, de l’auto-déclaration d’OpenAI et de celle d’Anthropic pour en faire un « classement global ».
Démarrage rapide avec Gemini 4 Hydrogen : comparer trois modèles avec le même code
La façon la plus fiable de choisir un modèle, c’est de faire tourner les trois sur vos propres tâches. L’exemple ci-dessous utilise une interface compatible OpenAI : il suffit de modifier le paramètre model pour changer de modèle.
Exemple minimal
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI, interface compatible OpenAI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Voir le code complet : script de comparaison des trois modèles sur la même question
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Les ID de modèle suivent la liste du platform ; gemini-4-hydrogen est l'ID officiel Google
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # ID indicatif, à vérifier dans la console
    "claude-sonnet-5.5",   # ID indicatif, à vérifier dans la console
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Quelques points à garder en tête lors de la migration vers Hydrogen : les valeurs personnalisées de temperature, top_p et top_k sont ignorées ; thinking_budget et MINIMAL ne sont pas pris en charge ; le niveau de réflexion par défaut est High ; les appels d’outils sur plusieurs tours doivent renvoyer correctement les thought signatures. Si votre agent s’appuyait sur une température basse pour contrôler sa sortie, il faudra passer à des sorties structurées ou à des instructions plus explicites.
Conseil : commencez par 10 à 20 tickets ou tâches réels comme jeu d’évaluation, appelez les trois modèles séparément sur APIYI apiyi.com, et notez le taux de réussite, la durée et le nombre de tokens en sortie. Les nouveaux utilisateurs disposent d’un quota de test gratuit, de quoi valider à petite échelle avant un achat définitif.
Recommandations par scénario et matrice de sélection : Gemini 4 Hydrogen, Terra et Sonnet 5.5
Scénarios recommandés pour Gemini 4 Hydrogen
- Correction de bugs et mise à jour des dépendances dans une base de code : SWE-sweep est en tête avec la plus large avance, et l’équipe officielle a surtout amélioré la précision d’édition.
- Agents multi-étapes et automatisation des workflows : Agents’ Last Exam, AutomationBench-AA et Vending-Bench 2 sont tous en tête.
- Analyse de documents et de graphiques complexes : MKA et Chartography sont en tête, avec prise en charge des PDF, des documents Office et d’autres formats d’entrée.
Scénarios recommandés pour Claude Sonnet 5.5
- Tâches d’ingénierie intensives en terminal : Terminal-Bench 4.1 et Terminal-Bench-Science 0.1 sont en tête.
- Opérations sur bureau et interface graphique : OSWorld-2.1 obtient le meilleur score dans Google Sheets.
- Documents professionnels et conception d’interfaces : un axe particulièrement mis en avant par Anthropic.
Scénarios recommandés pour GPT-6.1 Terra
- Tâches à forte volumétrie et sensibles au coût : tarif standard de 1 $ / 5 $, le plus bas des trois tarifs connus.
- Raisonnement visuel et automatisation du quotidien : Chartography arrive en deuxième position, et Agents’ Last Exam est proche de Hydrogen.
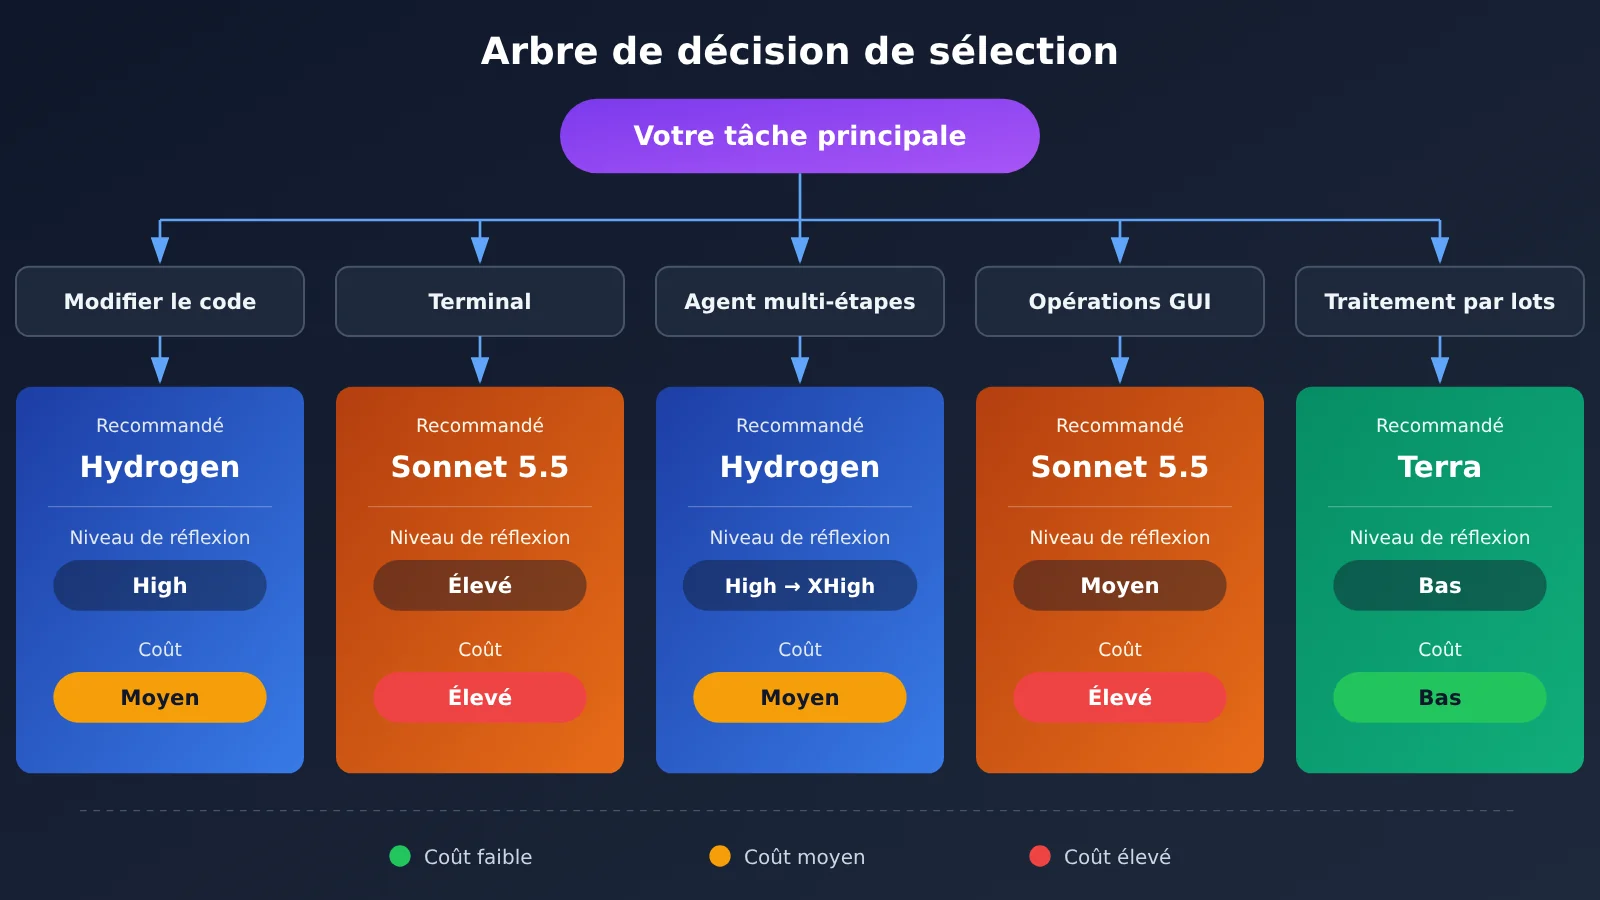
| Type de tâche | Choix principal | Alternative | Sensibilité au coût | Mode d’exécution conseillé | Canal d’accès |
|---|---|---|---|---|---|
| Maintenance de base de code, correction de bugs | Hydrogen | Sonnet 5.5 | Moyenne | Hydrogen modifie le code, Sonnet valide dans le terminal | Interface unifiée APIYI apiyi.com |
| Exploitation en terminal, code scientifique | Sonnet 5.5 | Terra | Moyenne | Session longue avec un seul modèle | Idem |
| Workflow d’agent multi-étapes | Hydrogen | Terra | Moyenne | Démarrer au niveau High, passer à XHigh en cas d’échec | Idem |
| Opérations GUI sur bureau/navigateur | Sonnet 5.5 | Hydrogen | Faible | Observation par captures d’écran + outils d’action | Idem |
| Lecture de graphiques et de documents | Hydrogen | Terra | Moyenne | Sans outil ou avec recherche augmentée | Idem |
| Automatisation quotidienne à grande échelle | Terra | Hydrogen (Batch) | Élevée | Traitement asynchrone par lots | Idem |
💡 Conseil de choix : si l’équipe a à la fois des besoins de programmation et d’automatisation GUI, inutile de miser sur un seul modèle : on peut s’inspirer de l’approche de Google Antigravity Orchestrator et répartir les rôles par étapes. Avec APIYI apiyi.com, une même clé API permet d’appeler plusieurs modèles, et le changement de routage ne demande qu’un seul paramètre.
FAQ – questions fréquentes
Q1 : qu’est-ce que Gemini 4 Hydrogen ?
Gemini 4 Hydrogen est le modèle haute efficacité publié par Google DeepMind le 12 novembre 2026. Son ID de modèle API est `gemini-4-hydrogen` et il est positionné sur la programmation du quotidien et l’exécution d’agents. Il prend en charge une fenêtre de contexte unifiée de 1 048 576 tokens et propose quatre niveaux de réflexion — Low, Medium, High et XHigh — avec High par défaut.
Q2 : entre Gemini 4 Hydrogen et Claude Sonnet 5.5, lequel est le plus fort en programmation ?
Tout dépend du type de tâche. Hydrogen garde une avance nette sur les tests de réparation de base de code SWE-sweep ; Sonnet 5.5 devance sur les tests d’exécution en terminal comme Terminal-Bench 4.1 et Terminal-Bench-Science 0.1. Pour modifier du code au quotidien, Hydrogen est plutôt favori ; pour l’ingénierie intensive en terminal, Sonnet l’emporte.
Q3 : GPT-6.1 Terra ne remporte aucune première place — vaut-il quand même le coup ?
Il mérite d’être considéré. Dans le tableau croisé publié par Google, Terra n’obtient effectivement aucun meilleur score par catégorie, mais il est proche de Hydrogen sur Agents’ Last Exam, se classe deuxième sur Chartography, et affiche le prix API standard le plus bas. Pour les scénarios sensibles aux coûts, centrés sur les opérations visuelles et l’automatisation courante, c’est un candidat sérieux.
Q4 : pourquoi le score OSWorld de Sonnet 5.5 existe-t-il en deux versions, 80,1 % et 83,9 % ?
80,1 % correspond à des résultats partiels publiés par Anthropic elle-même ; 83,9 % provient de tests réalisés par Google dans des conditions spécifiées, en retenant le meilleur résultat sur plusieurs exécutions. Les conditions de test diffèrent : pour comparer, il faut s’en tenir à une seule source, sans mélanger les deux.
Q5 : comment comparer rapidement ces trois modèles via l’API ?
Le plus simple est d’utiliser une plateforme d’agrégation API qui prend en charge plusieurs modèles :
1. Rendez-vous sur APIYI apiyi.com, créez un compte et récupérez votre clé API ;
2. Dans la liste des modèles de la console, vérifiez les ID disponibles pour les trois modèles ;
3. Définissez le `base_url` du code de cet article sur `https://api.apiyi.com/v1`, puis appelez chaque modèle avec le même lot de tâches.
APIYI propose une interface compatible OpenAI, facturée à l’usage, ce qui facilite une comparaison transversale dans un seul script.
Q6 : quelles sont les limites connues de Gemini 4 Hydrogen ?
La fiche modèle officielle indique : le modèle peut encore produire des hallucinations ; les niveaux de réflexion élevés augmentent nettement le temps de réponse et le coût ; les connaissances s’arrêtent à mars 2026 ; l’indicateur de refus injustifié se dégrade de 5,57 points de pourcentage par rapport à 3.8 Flash ; le rapport de sécurité complet n’était pas encore publié au moment de la vérification. Des développeurs signalent par ailleurs une exécution excessive sur certaines tâches d’agent. Enfin, son prix standard par token est le double du tarif actuel de 3.8 Flash : pour les tâches par lots, le mode Batch mérite d’être envisagé.
Gemini 4 Hydrogen : les points clés de la comparaison
- Pas de champion toutes catégories en programmation : Hydrogen excelle dans la réparation de bases de code, Sonnet 5.5 dans l’exécution de tâches en terminal.
- Automatisation d’agents : Hydrogen en tête : dans les tests d’agents et d’automatisation listés par Google, Hydrogen obtient à chaque fois le meilleur score.
- Pour les opérations GUI, regardez Sonnet 5.5 : sur OSWorld-2.1, Sonnet mène avec 83.9%, mais attention aux différences de protocole de mesure.
- Terra gagne sur le coût et le visuel : c’est le tarif standard le plus bas, et il ne déçoit pas sur la compréhension de graphiques ni sur les tâches d’agents spécialisés.
- Ne mélangez pas les versions ni les sources : Terminal-Bench 4.0 et 4.1, les chiffres auto-déclarés par les éditeurs et les tests internes de Google doivent rester séparés.
- Le niveau de réflexion a un impact énorme : l’indice d’intelligence de Hydrogen High et XHigh ne diffère que de 3 points, alors que le coût augmente nettement.
- Testez à nouveau avec vos propres tâches : vous pouvez comparer les trois modèles côte à côte avec une seule clé via APIYI apiyi.com.
En résumé
Les points clés de la comparaison entre Gemini 4 Hydrogen, GPT-6.1 Terra et Claude Sonnet 5.5 :
- Programmation : Hydrogen mène sur SWE-sweep, Sonnet 5.5 arrive en tête sur deux tests de type terminal, et Terra est proche de Sonnet sur les tâches de code scientifique.
- Agents : Hydrogen est en tête partout sur les agents multi-étapes, l’automatisation de processus et la gestion simulée sur le long terme ; Terra suit de près sur les tâches spécialisées.
- Utilisation de l’ordinateur et multimodal : Sonnet 5.5 domine les opérations sur interface graphique, tandis que Hydrogen conserve une légère avance sur le travail de connaissance multimodal et la compréhension de graphiques.
Les benchmarks publics vous disent « qui est le plus fort dans un ensemble de conditions donné », pas « qui est le plus adapté à votre activité ». L’approche réaliste consiste à retenir un ou deux candidats à l’aide de la matrice de sélection ci-dessus, puis à refaire un test à petite échelle avec vos vraies tâches, un niveau de réflexion fixe et votre propre chaîne d’outils.
Je recommande de vérifier rapidement les résultats via APIYI apiyi.com : la plateforme propose des crédits de test gratuits et une interface unifiée pour plusieurs modèles, ce qui convient bien à une équipe qui veut réaliser une évaluation comparative avant la mise en production.
📚 Références
- Blog officiel Google – Introducing Gemini 4 Hydrogen : annonce de lancement et cas d’usage des partenaires
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Description : positionnement officiel, étendue des capacités et données des premiers tests
-
Fiche modèle Google DeepMind : tableau comparatif des évaluations entre modèles
- Lien :
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Description : principale source des données quantitatives de cet article
-
PDF d’évaluation des modèles Google DeepMind : détails des conditions d’exécution des tests
- Lien :
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
Description : harnais de test, niveaux de réflexion, nombre d’exécutions et résultats complémentaires comme Vending-Bench 2
-
Documentation technique Google Cloud : spécifications de Hydrogen et notes de migration
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Description : limites de la fenêtre de contexte, comportement des paramètres et points d’attention sur la compatibilité
-
Page tarifs Google AI Studio : tarification officielle de l’API
- Lien :
aistudio.google.com/docs/pricing -
Description : prix des modes Standard, Batch, Flex et Priority
-
OpenAI – Introducing GPT-6.1 Terra : documentation de lancement de Terra
- Lien :
openai.com/index/introducing-gpt-6-1-terra/ -
Description : résultats auto-déclarés de Terminal-Bench 4.0 et prix de l’API
-
Anthropic – Introducing Claude Sonnet 5.5 : documentation de lancement de Sonnet 5.5
- Lien :
anthropic.com/claude-sonnet-5-5 -
Description : résultats auto-déclarés de Terminal-Bench 4.0 et OSWorld 2.1
-
Artificial Analysis – Gemini 4 Hydrogen : évaluation indépendante des quatre niveaux de réflexion
- Lien :
artificialanalysis.ai/models/gemini-4-hydrogen - Description : indices Intelligence Index v5.0.1 par niveau, temps d’exécution et coût
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources sur l’intégration des modèles, rendez-vous au centre de documentation docs.apiyi.com