著者注:Google DeepMindが公開した10項目のモデル横断評価に基づき、Gemini 4 Hydrogen、GPT-6.1 Terra、Claude Sonnet 5.5がプログラミング、Agent自動化、コンピュータ操作でそれぞれどこが強くどこが弱いのかを読み解き、タスク別の選定ポイントを提案します。
一言まとめ:Googleが公開したモデル横断評価では、Gemini 4 HydrogenとClaude Sonnet 5.5がプログラミングやAgentタスクでそれぞれ異なる強みを示し、GPT-6.1 Terraはコストと視覚的操作を重視する位置づけに強みがあります。実際の選定では、テスト条件、タスク種別、コストを組み合わせて判断する必要があります。
To know:本記事を読む前に知っておくべき5つの用語
- Harness:モデルへの入力、ツール実行、タスクの採点をまとめるテストフレームワーク。同じモデルでもHarnessを変えると、スコアが大きく変わる可能性があります。
- ベンチマークバージョン:ある評価におけるデータ、タスク、ルールのバージョン。たとえばTerminal-Bench 4.0と4.1は別バージョンなので、スコアは分けて解釈する必要があります。
- Agent:モデルとツール実行環境が共同で複数ステップのタスクを完了するシステム。スコアは「モデル + ツールチェーン」全体の性能を反映します。
- トークン:モデルがテキストなどの情報を処理する際の計量単位。API価格は通常、100万トークンあたりで課金されます。
- API:プログラムからサービスを呼び出すためのインターフェース。開発者はこれを通じてモデルを自分のアプリやAgentに組み込みます。
2026年11月12日、Googleは正式にGemini 4 Hydrogenを発表し、公式モデルカードでGPT-6.1 Terra、Claude Sonnet 5.5と同じ評価表に並べました。この表はプログラミング、Agent自動化、コンピュータ操作、マルチモーダル知識作業をカバーしており、現時点で3モデルを最も集中的に比較できる公開データです。
これは「それぞれに良さがある」といった妥協的な分析ではありません。各テストが何を測っているのか、どのような条件で実行されたのかを項目ごとに分解し、プログラミング、Agent、コンピュータ操作の3領域でそれぞれ結論を出します。最後に、そのまま実務で使える選定マトリクスを示します。
核心価値:本記事を読み終えるころには、Gemini 4 Hydrogenがどのタスクでリードし、どのタスクでSonnet 5.5に劣るのか、そしてTerraをチームのワークフローのどこに置くべきかが明確になるでしょう。
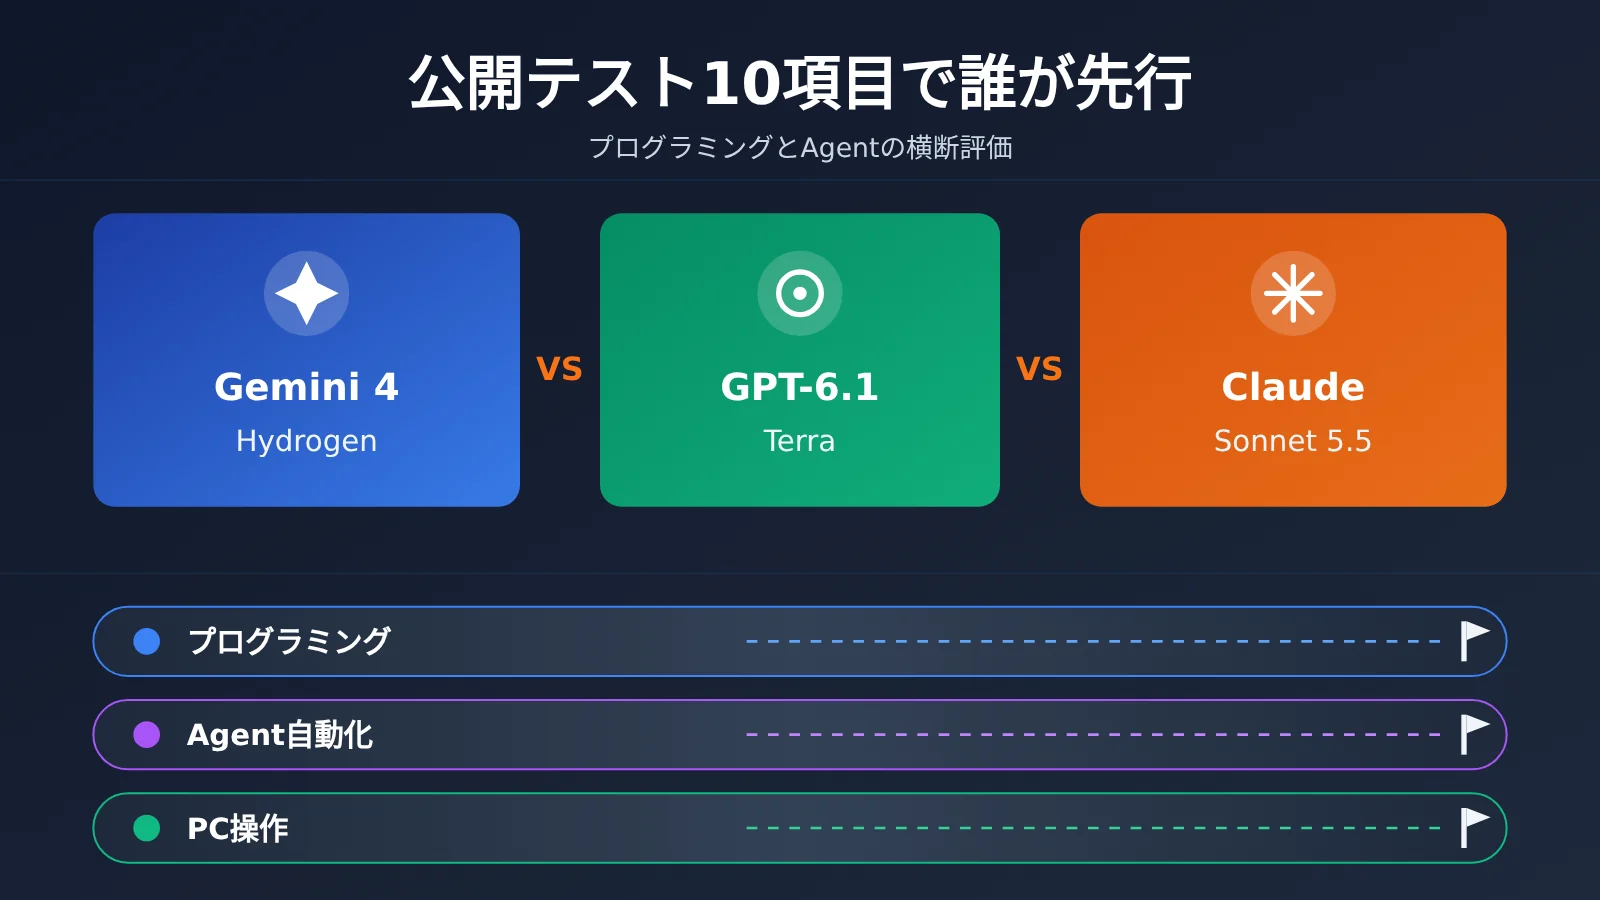
なぜ Gemini 4 Hydrogen を Terra、Sonnet 5.5 と並べて比較するのか
3つのモデルはリリース時期が2か月以内に収まり、立ち位置も大きく重なっています。いずれも各社の最も重いフラッグシップ推論モデルではなく、開発者、エージェント実行、高頻度の専門タスクに向けた「主力の実務モデル」です。毎日大量に呼び出すチームにとって、コストと効率を実際に左右するのはこの層です。
Gemini 4 Hydrogen は Google DeepMind の新世代高効率モデルで、日常的なコーディングと AIエージェント実行向けと公式に位置づけられています。単独で動作でき、マルチモデルシステム内で実行者または検証者を担うこともできます。GPT-6.1 Terra は OpenAI が2026年10月26日にリリースしたモデルで、視覚推論、コンピュータ操作、高効率の日常業務を重視しています。Claude Sonnet 5.5 は Anthropic が2026年9月28日にリリース。公式には日常的なコーディング、バグ修正、専門ドキュメント作成、複雑なインターフェース設計を強調しています。
| モデル | ベンダー | リリース日 | 公式の位置づけ | 標準API価格(100万トークンあたり、入力/出力) | 価格の出典 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | 日常的なコーディング、マルチツール呼び出し、エージェント実行 | $1.50 / $7.50 | Google AI Studio 価格ページ、2026-11-13 時点で確認 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | 視覚推論、コンピュータ操作、日常業務 | $1 / $5 | OpenAI リリース資料、2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | 日常的なコーディング、バグ修正、専門ドキュメント、インターフェース設計 | 参考資料では未確認、公式価格ページを参照 | Anthropic 公式 |
補足すると、Hydrogen の思考トークンは出力価格に含まれるため、実際のコストは最終的に見えるテキストだけから見積もることはできません。また、Hydrogen の Batch モードと Flex モードの価格は $0.75 / $3.75 で、オフラインのバッチ処理に向いています。
本記事の定量的な比較は、主に Google DeepMind の2026年11月版モデルカードおよび付属の評価方法ドキュメント に基づいています。つまり、データは Google が取りまとめたもので、一部の競合モデルのスコアは各社の公開レポートやリーダーボードから取得しています。この点が結論に与える影響については、第5節で詳しく扱います。
Gemini 4 Hydrogen のプログラミング能力比較:実際の問題の修正が得意なのはどちらか
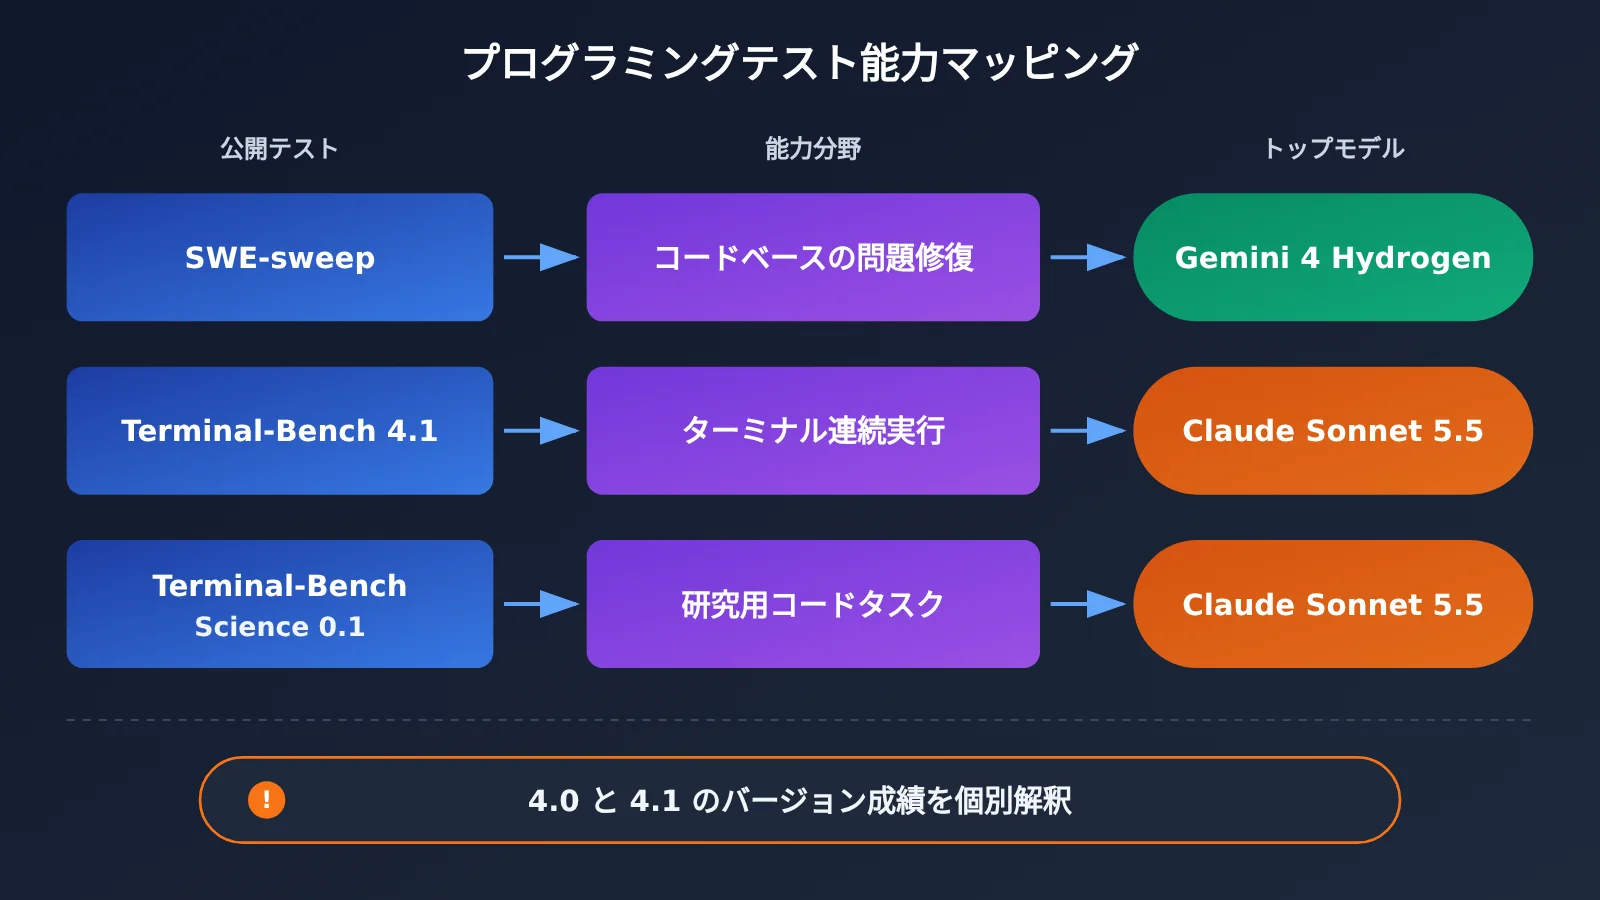
プログラミング系のテストは、大きく2種類の能力に分けられます。1つは実際のコードベースで問題を見つけて修正する能力、もう1つはターミナル環境でコマンドを連続実行し、エンジニアリング作業を完遂する能力です。SWE-sweep は前者寄り、Terminal-Bench シリーズは後者寄りで、Terminal-Bench-Science はコードを使って科学研究タスクを完了する能力を評価します。
| 評価(バージョン) | 指標 | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | 首位 |
|---|---|---|---|---|---|
| SWE-sweep | サブタスク加重報酬 | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 | 平均報酬 | 57.0% | 63.9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | タスクスコア | 51.4% | 59.9% | 58.3% | Sonnet |
出典:Google DeepMind『Gemini 4 Hydrogen Model Evaluation』およびモデルカード、2026年11月。
プログラミングテスト結果の読み解き
SWE-sweep は絶対スコアが全体的に低く、難度の高いテストであることがわかります。Hydrogen の 13.5% は Terra の2倍強、Sonnet の4倍強で、この項目の差が最も顕著です。ただし、この項目で Hydrogen は Google 自社の Antigravity-CLI 1.4.8 を使って実行しており、競合モデルの実行条件は必ずしも同一ではありません。差の一部はハーネスへの適応に由来する可能性があります。
Terminal-Bench 4.1 では、Sonnet 5.5 が 63.9% で Hydrogen の 57.0% をリードし、Terra は Google の表にこの項目の成績がありません。Hydrogen はこの項目で mini-swe-agent vision Harness と High 思考レベルを使用し、各タスクを5回実行して平均報酬を算出しています。Terminal-Bench-Science 0.1 では Sonnet が引き続き首位、Terra が 58.3% で続き、Hydrogen はむしろ3位です。
プログラミング領域の結論:Hydrogen は SWE-sweep のようなコードベース問題修正テストで優位性が明らかです。Sonnet 5.5 はターミナル実行系タスクでより安定しています。Terra は科学研究向けコードタスクで Sonnet に近い性能を示します。プログラミングテスト全体で完全にリードするモデルはありません。
ベンダーが自己申告した Terminal-Bench 4.0 の参考データ
OpenAI と Anthropic はそれぞれ Terminal-Bench 4.0 の成績を公表しています。4.0 と 4.1 は異なるベンチマークバージョンのため、下表では別途掲載します。上表の 4.1 成績と混在させて比較することはできません。
| 評価(バージョン) | モデル | スコア | テスト条件 | 出典 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | ベンダー自社テスト | Anthropic の発表資料、2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | 最高推論設定 | OpenAI の発表資料、2026-10-26 |
このデータの価値は参照値を提供することにあります。各ベンダーのテスト条件下で、Sonnet 5.5 のターミナルタスク能力は Terra より明らかに高く、Google の表で Sonnet がターミナル系テストでリードしている方向性と一致しています。
Gemini 4 Hydrogen はエージェントと自動化テストで一連の作業を完遂できるか
エージェントテストと単一ターンの質疑応答の最大の違いは、モデル自身が手順を計画し、継続的にツールを呼び出し、失敗後に戦略を調整し、最終的に結果を検証する必要がある点です。この種のテストは実際の自動化ワークフローに近く、モデルの「実行規律」もより強く問います。
以下の表は、Google の評価におけるエージェント自動化、PC操作、マルチモーダル知識作業について、全モデル横断の成績をまとめたものです。第3節と第4節でこの表を共用します。
| 評価(バージョン) | 能力領域 | 指標 | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | 専門的なマルチステップエージェント | タスクスコア | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | ワークフロー自動化 | タスクスコア | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | 長期シミュレーション経営 | 最終資金残高 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | PC/GUI操作 | タスク成功率 | 77.6% | 83.9% | 74.2% |
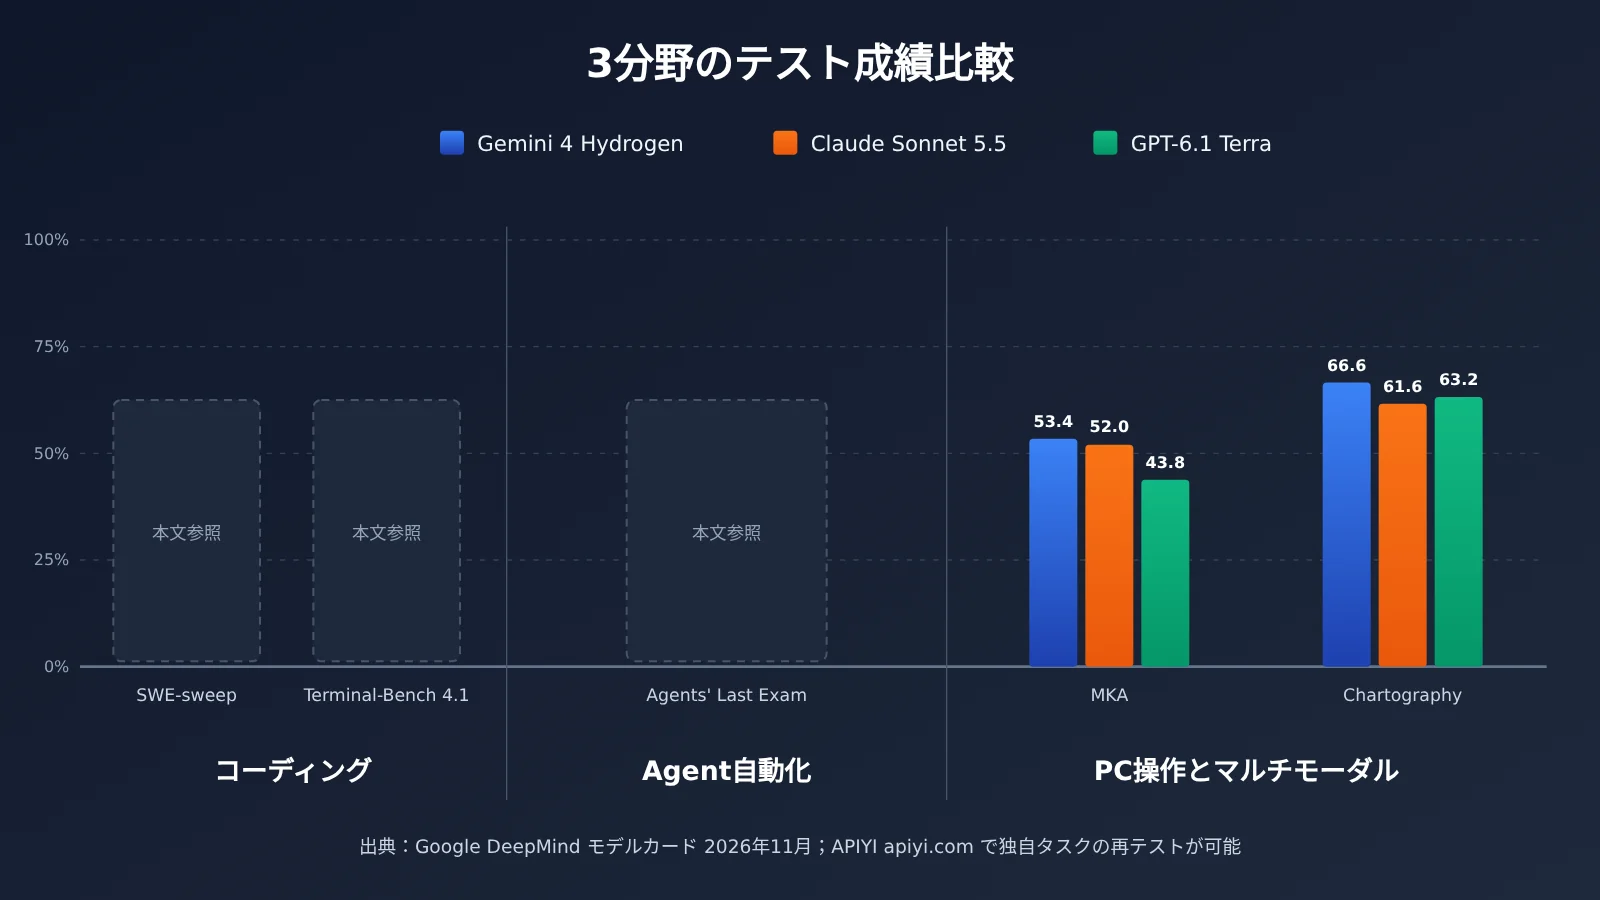
| MKA | マルチモーダル知識作業 | タスクスコア | 53.4% | 52.0% | 43.8% |
| Chartography | グラフ理解(ツールなし) | 精度 | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | 高難度知識推論 | 精度 | 58.8% | 53.3% | 47.3% |
出典:Google DeepMind モデルカードおよび「Gemini 4 Hydrogen Model Evaluation」、2026年11月。
エージェントと自動化の成績を読み解く
Agents’ Last Exam v1.1 には122のタスクと5時間の制限時間があり、Hydrogen も同様に Antigravity-CLI 1.4.8 を使用して実行しました。Hydrogen が71.6%でリードしていますが、注目すべきは Terra が69.8%で直後に続き、Sonnet より約10ポイント高いことです。これは、専門的なマルチステップタスクにおいて Terra が決して弱いわけではないことを示しています。
AutomationBench-AA の構図はやや異なります。Hydrogen が76.1%、Sonnet が71.8%であるのに対し、Terra は60.2%で明確に後れを取っています。業務が多数のシステム横断ワークフロー自動化である場合、この差は無視できません。
Vending-Bench 2 は長期シミュレーション経営タスクで、指標は精度ではなく最終資金残高です。Hydrogen の $14,549 はかなりリードしており、「長期的な意思決定の安定性」を補足的に観察する材料になります。ただし単一のシミュレーション環境であるため、すべての長期タスクにそのまま一般化するのは適切ではありません。
エージェント領域の結論:Google が列挙したエージェントおよび自動化テストでは、Hydrogen がすべてでリードしています。Terra は専門的なマルチステップタスクで Hydrogen に近づきますが、ワークフロー自動化では後れを取っています。Sonnet は中間の位置にあります。
🚀 クイックスタート:エージェントのスコアはハーネスとツール定義に大きく依存するため、公開スコアはあくまで出発点として扱うべきです。APIYI apiyi.com を通じて、同じツールチェーンと同じ実タスク群で3モデルをそれぞれ実行することをおすすめします。APIキー1つで切り替えられるため、自分のシナリオに合った比較データを得やすいです。
Gemini 4 Hydrogen と Sonnet 5.5、コンピューター操作とマルチモーダル知識作業ではどちらが強いのか
コンピューター操作系のテストでは、モデルに「画面を見て、マウスをクリックし、キーボードを叩く」ことが求められ、ブラウザ操作やオフィスソフトの自動化などのシナリオに直結します。マルチモーダル知識作業では、複雑なファイルの読解やグラフ・チャートの理解を評価し、決算分析や調査レポートの整理といった業務に対応します。
OSWorld-2.1:Sonnet 5.5 がリードする GUI 操作
OSWorld 2.1 は Google の評価で 82 個のオフラインタスクを使用し、解像度は 1080p、最大 500 ステップです。モデルはスクリーンショットで観察し、PyAutoGUI で操作を実行します。Sonnet 5.5 が 83.9% でリードし、Hydrogen が 77.6%、Terra が 74.2% でした。
ここで必ず指摘しておきたい基準の違いがあります。Anthropic が自社で公表した Sonnet 5.5 の OSWorld 2.1 の一部テスト成績は 80.1% ですが、Google の比較表では 83.9% を採用しています。後者は Google が指定条件でテストし、複数回の実行のうち最高結果を取ったものです。つまり、同じ名前のテストでもベンダーによって異なるスコアになり得るため、比較する際は必ず同一の情報源に固定する必要があります。
MKA と Chartography:Hydrogen がわずかにリード
MKA のマルチモーダル知識作業では、Hydrogen の 53.4% と Sonnet の 52.0% が非常に近く、Terra は 43.8% で約 10 ポイント差をつけられています。Chartography はツールを使わない条件下でグラフ理解をテストしており、Hydrogen が 66.6% でリードしています。興味深いのは、Terra が 63.2% で2位につけ、Sonnet の 61.6% を上回っている点です。これは OpenAI が Terra を「視覚推論」と位置づけていることと合致します。
コンピューター操作とマルチモーダルの結論:GUI 操作はまず Sonnet 5.5 を見るべきです。複雑なファイル読解とマルチモーダル知識の統合では Hydrogen と Sonnet が接近し、Hydrogen がやや優位です。純粋なグラフ理解では Hydrogen がリードし、Terra にも競争力があります。
Gemini 4 Hydrogen の公開評価データを正しく読む方法
公開評価で最も誤読されやすいのは、一枚の表を「同じ試験場・同じルール」の成績表とみなすことです。実際には、Google の評価手法ドキュメントはいくつかの重要な前提を示しています。
- 思考レベル:Hydrogen は通常、最高の思考設定でテストされますが、一部の項目では別の規定があります。たとえば Terminal-Bench 4.1 は High 段階を使用します。
- 実行ハーネス:SWE-sweep と Agents’ Last Exam は Antigravity-CLI 1.4.8、Terminal-Bench 4.1 は mini-swe-agent vision ハーネス、OSWorld 2.1 はスクリーンショット+PyAutoGUI を使用します。
- テスト回数:Terminal-Bench 4.1 は各タスクを5回実行して平均報酬を取りますが、OSWorld の競合製品スコアは複数回実行の最高結果を採用しており、この2つの統計方式自体に違いがあります。
- スコアの出所:競合他社の結果は主に各社の公開レポートとリーダーボードから得られたものであり、すべてのモデルが同じチームによって統一的に実行されているわけではありません。
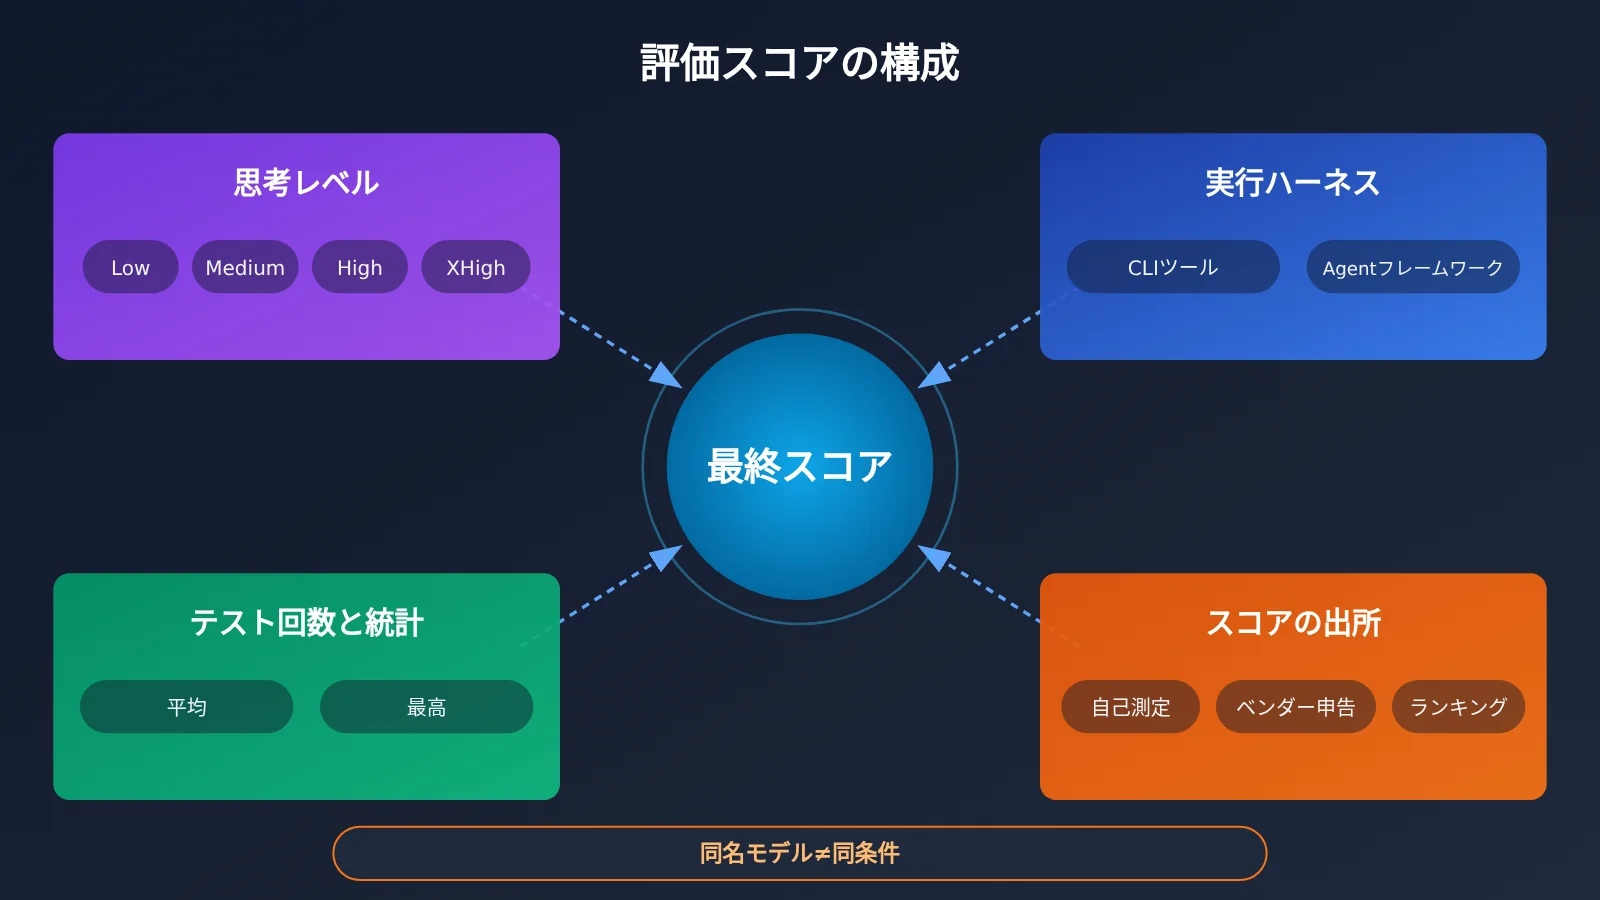
思考レベルの影響は特に大きいです。Artificial Analysis は 11月12日に Hydrogen の4段階について独立評価を実施しました。インテリジェンス指数は Low が 27、Medium が 41、High(デフォルト)が 51、XHigh が 54 でした。対応する標準化評価タスクの平均コストは $0.29 から $3.16 までと幅があります。これらはベンチマークタスクの結果であり、一般ユーザーが毎回呼び出す際の実際の費用ではありませんが、同じモデルでも異なる段階で大きな差が出ること、XHigh は High よりわずか3点多いだけでコストは明らかに上昇することを十分に示しています。
したがって、本文のスコアを読む際は次の2点を覚えておいてください。第一に、結論は列挙された公開テストのみを対象としています。第二に、Google の表、OpenAI の自己報告、Anthropic の自己報告の中でそれぞれ最も有利なデータをつなぎ合わせて一枚の「総合ランキング」にしてはいけません。
Gemini 4 Hydrogen クイックスタート:同じコードで3モデルを比較
最も信頼できるモデル選定方法は、自分のタスクで3つのモデルを実際に走らせてみることです。以下の例では OpenAI 互換インターフェースを使用しているため、model パラメータを変更するだけで切り替えられます。
最小限のサンプル
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 互換インターフェース
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
完全な実装コードを見る:3モデル同一問題の比較スクリプト
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# モデルIDはプラットフォームのモデル一覧に準拠。gemini-4-hydrogen は Google 公式 ID
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # 例示用 ID。コンソールで確認してください
    "claude-sonnet-5.5",   # 例示用 ID。コンソールで確認してください
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Hydrogen へ移行する際には、いくつか注意点があります。カスタムの temperature、top_p、top_k は無視されます。thinking_budget と MINIMAL はサポートされません。デフォルトの思考レベルは High です。マルチターンのツール呼び出しでは、thought signatures を正しく返す必要があります。もしあなたのエージェントがもともと低い temperature で出力を制御していた場合は、構造化出力や、より明確な指示で制約する方法に切り替える必要があります。
提案:まず 10〜20 件の実際のチケットやタスクを評価セットとして用意し、APIYI apiyi.com 上で3つのモデルをそれぞれ呼び出して、成功率、所要時間、出力トークン数を記録しましょう。新規ユーザーには無料のテスト枠があるので、正式購入の前に小規模な検証を済ませられます。
Gemini 4 Hydrogen、Terra、Sonnet 5.5 のシーン別推奨と選定マトリクス
Gemini 4 Hydrogen を選ぶシーン
- コードベースの問題修正と依存関係のアップグレード:SWE-sweep でのリード幅が最大であり、公式も精度の高い編集を重点的に改善しています。
- マルチステップ Agent とプロセス自動化:Agents’ Last Exam、AutomationBench-AA、Vending-Bench 2 のいずれでもリードしています。
- 複雑なドキュメントと図表の分析:MKA、Chartography でリードし、PDF、Office ドキュメントなど複数形式の入力にも対応しています。
Claude Sonnet 5.5 を選ぶシーン
- ターミナルを多用するエンジニアリングタスク:Terminal-Bench 4.1 と Terminal-Bench-Science 0.1 のいずれでもリードしています。
- デスクトップと GUI 操作:OSWorld-2.1 は Google の表で最高位です。
- 専門ドキュメントとインターフェース設計:Anthropic 公式が重点的に強調する方向性です。
GPT-6.1 Terra を選ぶシーン
- コストを重視する大量バッチタスク:標準価格は $1 / $5 で、三者の中で既知の価格としては最も低いです。
- 視覚推論と日常的な自動化:Chartography は 2 位、Agents’ Last Exam も Hydrogen に近い水準です。
| タスク種別 | 第一候補 | 代替候補 | コスト感度 | 実行方法の推奨 | 接続チャネル |
|---|---|---|---|---|---|
| コードベース保守、Bug 修正 | Hydrogen | Sonnet 5.5 | 中 | Hydrogen がコードを修正、Sonnet がターミナルで検証 | APIYI apiyi.com の統一インターフェース |
| ターミナル運用、研究コード | Sonnet 5.5 | Terra | 中 | 単一モデルでの長セッション | 同上 |
| マルチステップ Agent ワークフロー | Hydrogen | Terra | 中 | High レベルから開始し、失敗したら XHigh に昇格 | 同上 |
| デスクトップ/ブラウザ GUI 操作 | Sonnet 5.5 | Hydrogen | 低 | スクリーンショット観察 + 操作ツール | 同上 |
| 図表とドキュメントの読解 | Hydrogen | Terra | 中 | ツールなし、または検索拡張 | 同上 |
| 大量の日常自動化 | Terra | Hydrogen(Batch) | 高 | バッチ非同期処理 | 同上 |
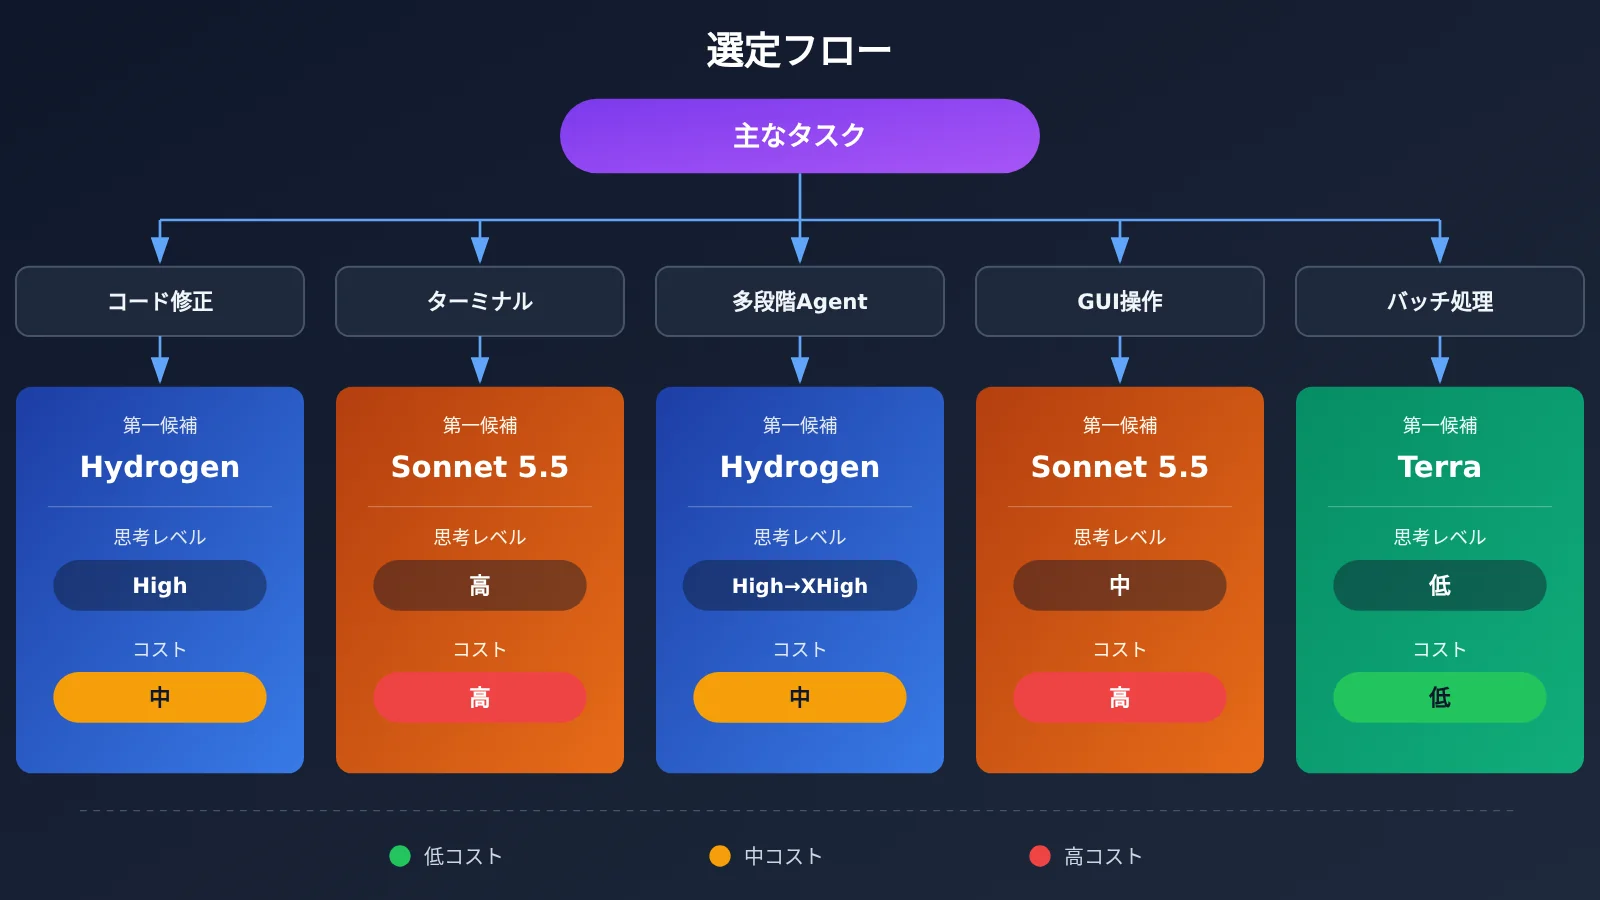
💡 選択のヒント:チームにプログラミングと GUI 自動化の両方のニーズがある場合、1 つのモデルだけに賭ける必要はありません。Google Antigravity Orchestrator の考え方を参考に、フェーズごとに役割を分担することができます。APIYI apiyi.com を通じて同じ Key で複数のモデルを呼び出せるため、ルーティングの切り替えはパラメータを 1 つ変えるだけです。
よくある質問 FAQ
Q1:Gemini 4 Hydrogen とは何ですか?
Gemini 4 Hydrogen は、Google DeepMind が 2026年11月12日にリリースした高効率モデルで、API モデル ID は `gemini-4-hydrogen` です。日常的なプログラミングとエージェント実行を想定しています。1,048,576 トークンの統合コンテキスト枠をサポートし、Low、Medium、High、XHigh の 4 段階の思考を提供、デフォルトは High です。
Q2:Gemini 4 Hydrogen と Claude Sonnet 5.5 は、プログラミングでどちらが強いですか?
タスクの種類によります。Hydrogen は SWE-sweep のコードベース修正テストで大きくリードしています。一方、Sonnet 5.5 は Terminal-Bench 4.1 や Terminal-Bench-Science 0.1 といったターミナル実行系のテストでリードしています。日常的なコード修正なら Hydrogen、ターミナルを多用するエンジニアリングなら Sonnet が向いています。
Q3:GPT-6.1 Terra は一つも 1 位を取っていませんが、それでも使う価値はありますか?
検討する価値はあります。Google が提示した三者同表の結果では、Terra は確かに単項目で最高スコアを取っていませんが、Agents’ Last Exam では Hydrogen に近い性能を示し、Chartography では 2 位、しかも標準 API の価格が最も安価です。コストに敏感で、視覚操作や定型的な自動化が中心のシーンでは、重要な候補となります。
Q4:Sonnet 5.5 の OSWorld スコアに 80.1% と 83.9% の二つのバージョンがあるのはなぜですか?
80.1% は Anthropic 自身が公表した一部のテスト結果で、83.9% は Google が指定条件下でテストし、複数回の実行のうち最高結果を採用したものです。両者はテスト条件が異なるため、比較する際は必ず同一の出典に固定して使い、混在させてはいけません。
Q5:API を通じてこれら三つのモデルを素早く比較するにはどうすればよいですか?
複数モデルをサポートする API 集約プラットフォームの利用をおすすめします:
1. APIYI apiyi.com にアクセスしてアカウントを登録し、APIキーを取得する;
2. コンソールのモデル一覧で、三つのモデルの利用可能な ID を確認する;
3. 本記事のコードの base_url を `https://api.apiyi.com/v1` に設定し、同じタスク群でそれぞれ呼び出す。
APIYI は OpenAI 互換インターフェースを提供し、従量課金制なので、一つのスクリプト内で横断比較を完結させられます。
Q6:Gemini 4 Hydrogen にはどのような既知の制限がありますか?
公式モデルカードでは次の点が指摘されています:依然として幻覚を生じる可能性がある;高思考段階では所要時間とコストが明らかに増加する;知識は 2026年3月時点で打ち切られている;不合理な拒答の指標は 3.8 Flash と比べて 5.57 ポイント悪化している;完全なセーフティレポートは検証時点で未公開である。さらに、一部のエージェントタスクで過剰実行が発生するとの開発者フィードバックもあります。加えて、トークンあたりの標準価格は 3.8 Flash の現行価格の 2 倍であるため、バッチ処理のタスクでは Batch モードの利用を検討できます。
Gemini 4 Hydrogen 比較の要点(Key Takeaways)
- プログラミングに万能な王者はいない:Hydrogen はコードベースの修復が得意で、Sonnet 5.5 はターミナルでのタスク実行が得意です。
- Agent の自動化では Hydrogen がリード:Google が挙げた Agent と自動化に関するテストのいずれでも、Hydrogen が最高スコアでした。
- GUI 操作は Sonnet 5.5 をチェック:OSWorld-2.1 では Sonnet が 83.9% でリードしていますが、評価基準の違いに注意してください。
- Terra はコストと視覚で優位:標準価格が最も低く、グラフの理解や専門的な Agent タスクでも見劣りしません。
- バージョンと出典は混在させない:Terminal-Bench 4.0 と 4.1、ベンダー自己申告と Google の自社測定は分けて扱う必要があります。
- 思考レベルが大きく影響する:Hydrogen の High と XHigh はインテリジェンス指数でわずか3点差ですが、コストは明らかに上がります。
- 自社タスクでの再測定を基準に:APIYI apiyi.com なら1つの APIキーで3モデルを横断的にテストできます。
まとめ
Gemini 4 Hydrogen、GPT-6.1 Terra、Claude Sonnet 5.5 の比較における核心的なポイントは次のとおりです。
- プログラミング領域:Hydrogen は SWE-sweep でリードし、Sonnet 5.5 は2つのターミナル系テストでリード、Terra は科学研究向けのコードタスクで Sonnet に迫ります。
- Agent 領域:Hydrogen は多段階 Agent、プロセス自動化、長期シミュレーション経営のすべてでリードし、Terra が専門タスクでそのすぐ後ろに続きます。
- PC 操作とマルチモーダル:Sonnet 5.5 がグラフィカルインターフェース操作を主導し、Hydrogen はマルチモーダルなナレッジワークとグラフ理解で小差ながらリードしています。
公開ベンチマークが教えてくれるのは「ある一定の条件下でどちらが強いか」であって、「あなたのビジネスにどちらが適しているか」ではありません。より現実的な比較方法は、上記の選型マトリクスで候補を1〜2モデルに絞り込み、自社の実際のタスク、固定した思考レベル、そしてツールチェーンを使って小規模な再測定を行うことです。
APIYI apiyi.com を通じて効果をすばやく検証することをおすすめします。同プラットフォームは無料のテスト枠と複数モデルを統一するインターフェースを提供しており、チームが本番リリース前に横断的な評価を完了するのに適しています。
📚 参考資料
- Google 公式ブログ – Introducing Gemini 4 Hydrogen:発表告知とパートナー事例
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
内容: 公式の位置づけ、能力範囲、初期テストデータ
-
Google DeepMind モデルカード:モデル横断の評価対照表
- リンク:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
内容: 本記事における主な定量データの出典
-
Google DeepMind モデル評価 PDF:テスト実行条件の詳細
- リンク:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
内容: Harness、思考レベル、実行回数、Vending-Bench 2 などの補足スコア
-
Google Cloud 技術ドキュメント:Hydrogen の仕様と移行ガイド
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
内容: コンテキスト制限、パラメータの挙動、互換性に関する注意点
-
Google AI Studio 料金ページ:公式 API 価格
- リンク:
aistudio.google.com/docs/pricing -
内容: Standard、Batch、Flex、Priority 各モードの価格
-
OpenAI – Introducing GPT-6.1 Terra:Terra の発表資料
- リンク:
openai.com/index/introducing-gpt-6-1-terra/ -
内容: Terminal-Bench 4.0 の自己申告スコアと API 価格
-
Anthropic – Introducing Claude Sonnet 5.5:Sonnet 5.5 の発表資料
- リンク:
anthropic.com/claude-sonnet-5-5 -
内容: Terminal-Bench 4.0 と OSWorld 2.1 の自己申告スコア
-
Artificial Analysis – Gemini 4 Hydrogen:4段階の思考モードの独自評価
- リンク:
artificialanalysis.ai/models/gemini-4-hydrogen - 内容: Intelligence Index v5.0.1 における各段階の指数、所要時間、コスト
著者: APIYI 技術チーム
技術交流: APIYI のウェブサイトトップページからお気軽にお問い合わせください。モデル接続に関する資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。