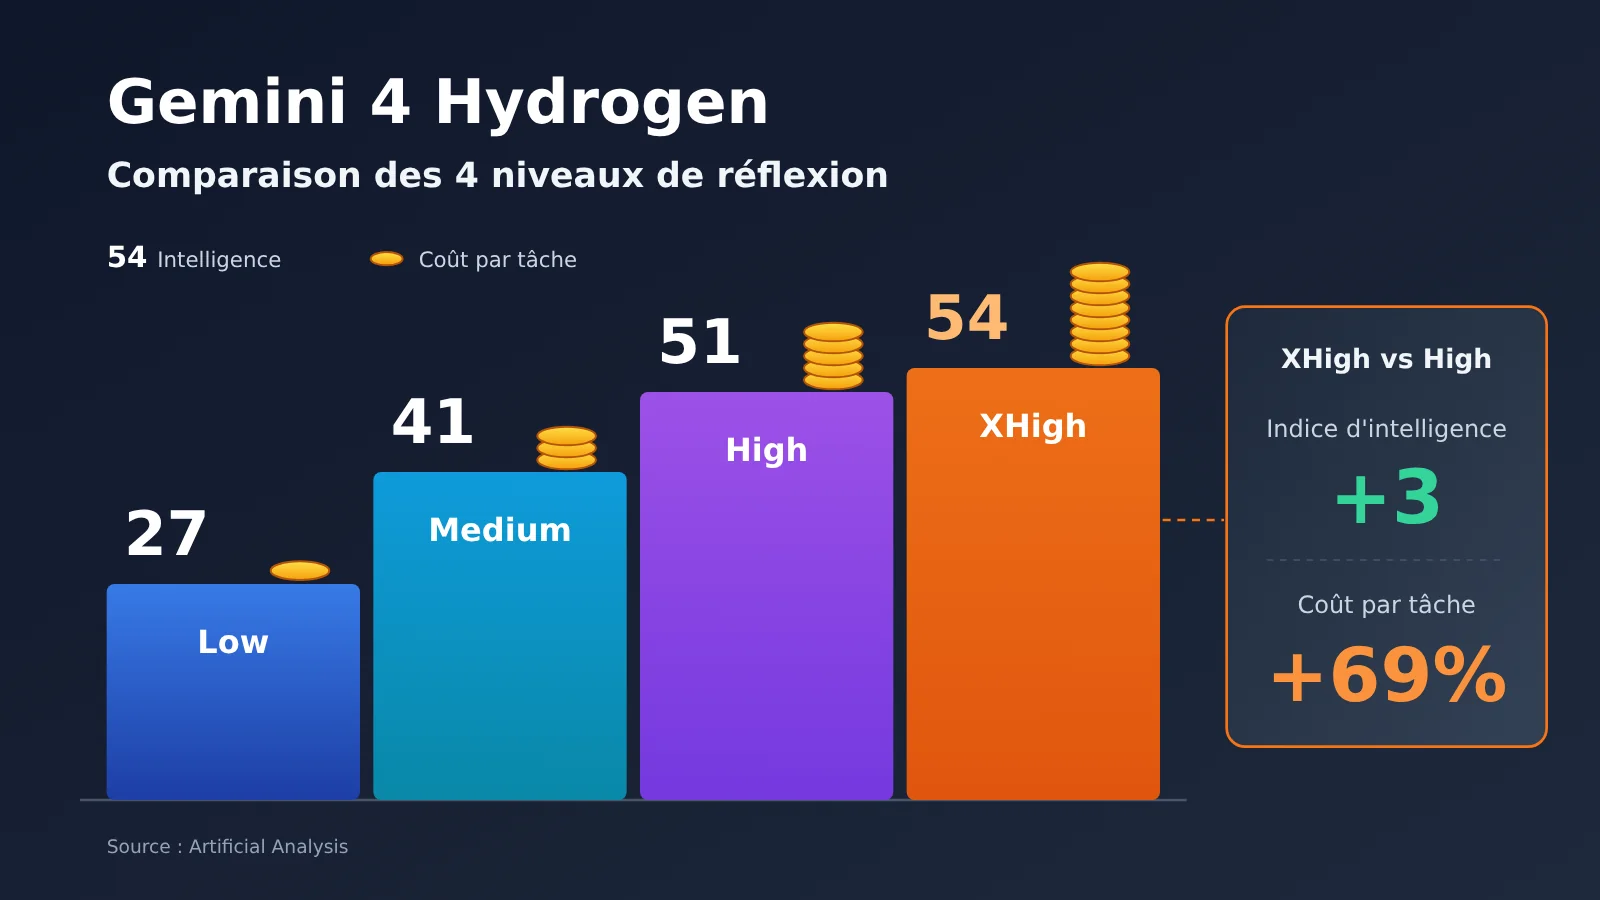
Résumé en une phrase : les évaluations à quatre niveaux d’Artificial Analysis montrent que, lorsque Gemini 4 Hydrogen passe de High à XHigh, l’indice d’intelligence n’augmente que de 3 points, alors que le coût des tâches d’évaluation augmente d’environ 69 %. Il est donc plus pertinent de configurer le niveau de réflexion en fonction de la difficulté de la tâche.
Google a officiellement publié Gemini 4 Hydrogen le 12 novembre 2026, avec les quatre niveaux de réflexion Low, Medium, High et XHigh. Les quatre niveaux utilisent le même ID de modèle et le même prix unitaire des tokens, mais les scores, les coûts et les temps d’attente des évaluations tierces varient considérablement.
Il ne s’agit pas d’une recommandation du type « plus le niveau est élevé, mieux c’est ». Cet article s’appuie sur les données d’évaluation standardisées d’Artificial Analysis pour calculer le gain marginal de chaque niveau, et formule des recommandations claires sur le niveau à choisir selon le type de tâche.
Valeur essentielle : après avoir lu cet article, vous pourrez déterminer quel niveau convient à votre activité et comment utiliser le paramètre thinking_level pour maîtriser le coût de la réflexion.
Termes à connaître avant de comparer les quatre niveaux de réflexion de Gemini 4 Hydrogen
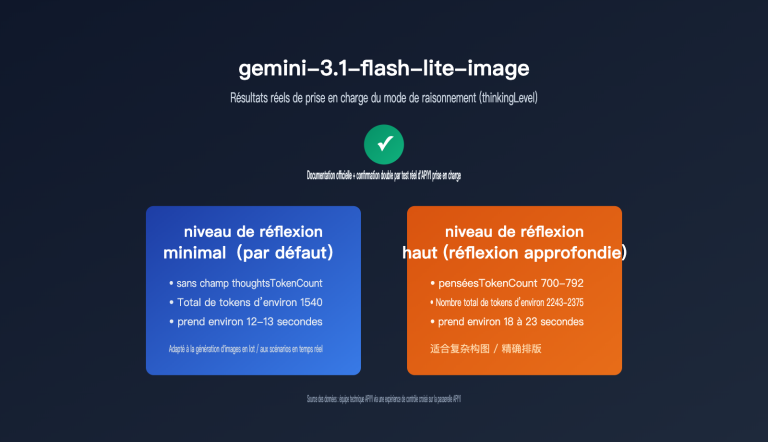
- thinking_level : paramètre du niveau de réflexion qui contrôle la profondeur de raisonnement du modèle. Hydrogen prend en charge quatre valeurs : Low, Medium, High et XHigh.
- Tokens de réflexion : tokens utilisés par le modèle pour raisonner avant de fournir la réponse finale. D’après la page tarifaire officielle de Google, ils sont facturés au prix de sortie.
- Token : unité de mesure utilisée par le modèle pour traiter du texte, des images et d’autres informations. L’API facture par million de tokens.
- Harness : cadre de test qui organise les entrées du modèle, exécute les appels d’outils et attribue une note aux tâches. Les scores obtenus avec différents harness ne sont pas directement comparables.
- API : interface permettant à un programme d’appeler un service. Les exemples de code de cet article utilisent le format compatible OpenAI.
Pourquoi le même Gemini 4 Hydrogen affiche-t-il des performances si différentes selon les quatre niveaux ?
Gemini 4 Hydrogen est un modèle à haut rendement publié par Google DeepMind, principalement destiné à la programmation quotidienne et à l’exécution de tâches d’agent IA. Son ID de modèle API est gemini-4-hydrogen. Les quatre niveaux de réflexion ne correspondent pas à quatre modèles, mais à quatre profondeurs de raisonnement d’un même modèle. La documentation Google Cloud indique un usage recommandé pour chaque niveau :
| Niveau de réflexion | Usage recommandé officiel | Profondeur de raisonnement | Par défaut |
|---|---|---|---|
| Low | Tâches simples comme la classification | Faible | Non |
| Medium | Programmation classique | Moyenne | Non (niveau par défaut de 3.8 Flash) |
| High | Agent multi-étapes | Profonde | ✅ Par défaut pour Hydrogen |
| XHigh | Raisonnement complexe et approfondi | La plus profonde | Non |
Les quatre niveaux de réflexion de Hydrogen ont le même prix unitaire : pourquoi la facture diffère-t-elle ?
Au 13 novembre 2026, le tarif Standard officiel de Google est de $1.50 en entrée et $7.50 en sortie par million de tokens, sans différence entre les quatre niveaux. L’écart vient de la consommation de tokens : plus le niveau est élevé, plus le modèle génère de tokens de réflexion avant de répondre, et ces tokens sont facturés au prix de sortie.
Donc « même prix unitaire » ne signifie pas « même coût par tâche ». Une même question en XHigh peut générer plusieurs fois plus de contenu de réflexion qu’en High, et la facture augmente en conséquence. Pour estimer le coût, il ne faut pas seulement regarder la longueur de la réponse finale : il faut aussi compter la partie invisible de la réflexion.
Gemini 4 Hydrogen : données de test des quatre niveaux — comparaison des scores, des coûts et des vitesses
Les données ci-dessous proviennent de l’organisme tiers Artificial Analysis et ont été obtenues le jour de la publication. L’indice d’intelligence, le coût par tâche d’évaluation et la durée moyenne par tâche proviennent de son Intelligence Index v5.0.1 ; la latence du premier token de réponse et le volume total de tokens de sortie proviennent d’une capture de page datée du 13 novembre 2026. Tous les résultats ci-dessous sont des résultats d’évaluation standardisés produits par un tiers, et non des mesures réalisées par nos soins.
| Niveau de réflexion | Indice d’intelligence | Coût moyen par tâche | Durée moyenne par tâche | Latence du premier token de réponse | Tokens de sortie sur l’ensemble de l’évaluation |
|---|---|---|---|---|---|
| Low | 27 | $0.29 | 1,3 min | environ 5,7 s | 20,3 millions |
| Medium | 41 | $0.80 | 3,7 min | environ 11,8 s | 54,4 millions |
| High (par défaut) | 51 | $1.87 | 8,3 min | environ 18,9 s | 110 millions |
| XHigh | 54 | $3.16 | 13,5 min | environ 37,8 s | 304 millions |
Trois indicateurs à ne pas confondre
Ce tableau présente trois types d’indicateurs aux significations différentes :
- Indice d’intelligence : un score de capacité qui synthétise plusieurs benchmarks ; il ne reflète que le niveau relatif au sein de cette suite d’évaluations.
- Durée moyenne par tâche : un indicateur pondéré calculé à partir du nombre de tokens de sortie de la tâche et de la vitesse de sortie de bout en bout ; il correspond à une charge de travail d’évaluation standardisée. Pour une question simple, l’utilisateur n’attend pas nécessairement 8,3 minutes.
- Latence du premier token de réponse : le temps d’attente entre l’envoi de la requête et l’affichage du premier token de réponse, y compris la phase de réflexion du modèle de raisonnement. C’est l’indicateur que l’utilisateur ressent le plus dans un contexte conversationnel.
On constate dans le tableau que l’écart de score entre Medium et High (10 points) est bien plus grand qu’entre High et XHigh. Pour un même nom de modèle, l’écart de capacité réelle entre les niveaux peut dépasser 20 points. Avant de comparer Hydrogen à un autre modèle, il faut donc d’abord vérifier le niveau utilisé pour ce dernier.
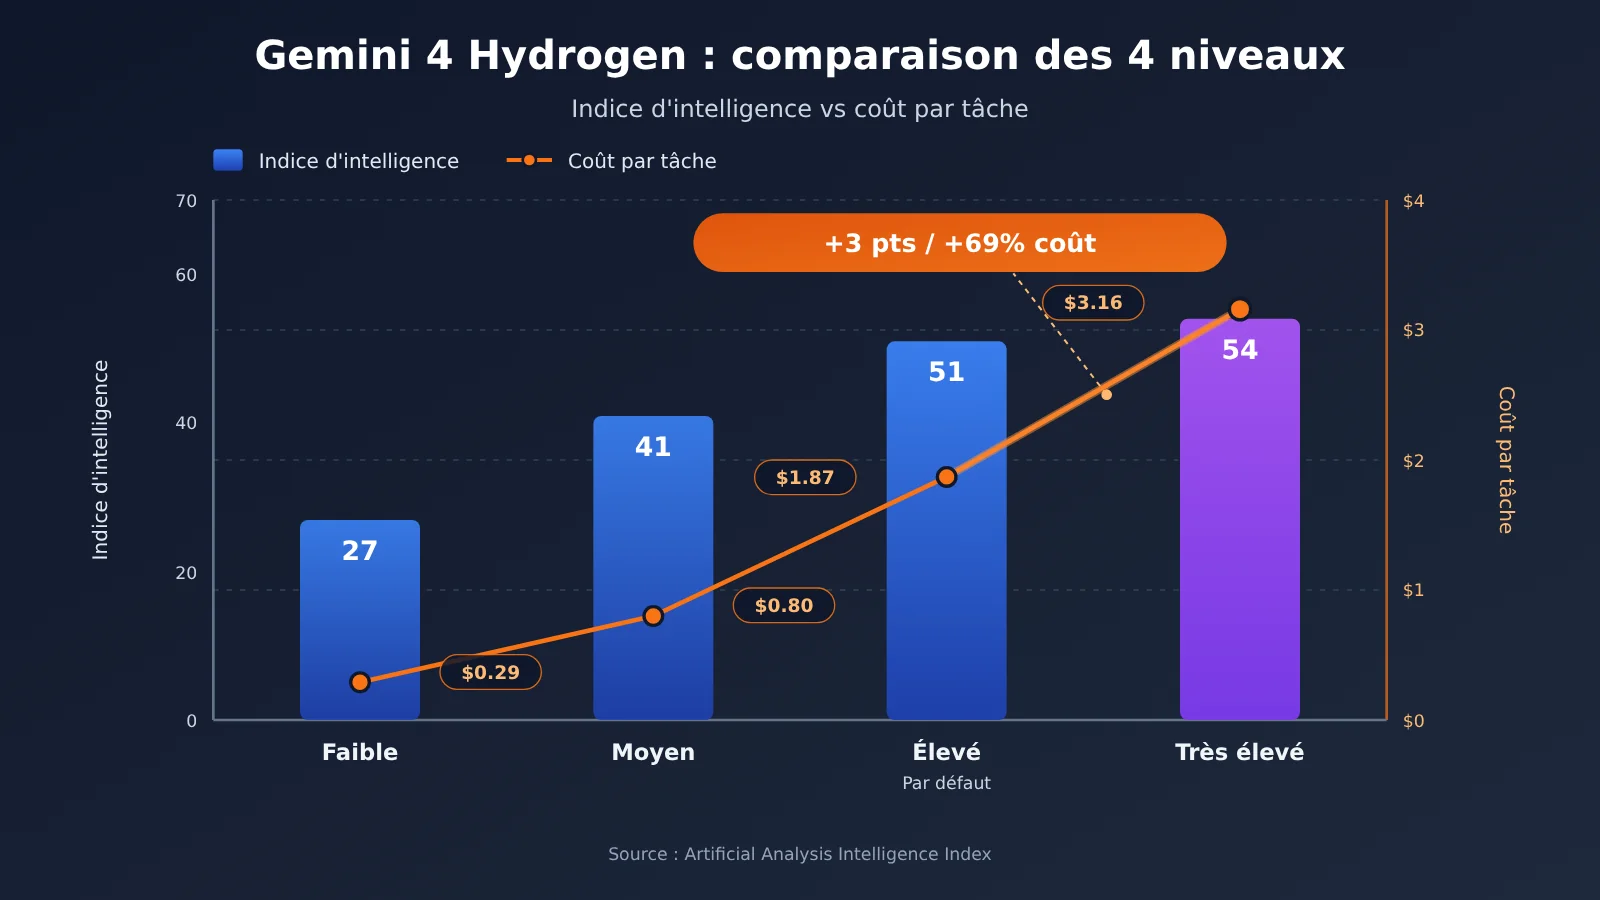
Gemini 4 Hydrogen XHigh coûte 69 % de plus que High : qu’achetez-vous réellement ?
En comparant les quatre niveaux deux à deux, on voit le gain et le coût de chaque montée en gamme. Les pourcentages d’augmentation du tableau ci-dessous ont été calculés par la rédaction à partir des données publiées par Artificial Analysis.
| Montée en gamme | Variation de l’indice d’intelligence | Variation du coût par tâche | Variation de la durée moyenne | Coût supplémentaire par point gagné |
|---|---|---|---|---|
| Low → Medium | +14 points | +176 % | +185 % | env. 0,036 $ |
| Medium → High | +10 points | +134 % | +124 % | env. 0,107 $ |
| High → XHigh | +3 points | +69 % | +63 % | env. 0,43 $ |
Rendements décroissants : le coût marginal des quatre niveaux de réflexion de Hydrogen
En passant de High à XHigh, l’indice d’intelligence grimpe de 51 à 54, soit environ 5,9 % de mieux ; le coût par tâche passe de 1,87 $ à 3,16 $, la durée de 8,3 à 13,5 minutes, et le délai de la première réponse double, d’environ 18,9 secondes à environ 37,8 secondes. Rapporté au « point supplémentaire gagné », le coût marginal de XHigh est environ 12 fois celui de Low → Medium.
La raison principale tient au volume de tokens. Sur l’ensemble du benchmark, High génère environ 110 millions de tokens en sortie, contre environ 304 millions pour XHigh, soit environ 2,76 fois plus. Pour autant, la facture ne gonfle pas de 2,76 fois : le coût total dépend aussi des tokens d’entrée, des hits de cache et de la pondération des tâches du benchmark. On ne peut donc pas déduire le coût directement à partir du multiple de tokens de sortie.
Un score moyen plus faible ne veut pas dire un gain faible sur les tâches complexes
L’indice d’intelligence est une moyenne calculée sur de nombreuses tâches : un écart de 3 points peut s’expliquer simplement — la plupart des tâches se comportent à l’identique sur les deux niveaux, tandis qu’une minorité de tâches très difficiles est nettement mieux réussie par XHigh. Pour les tâches où une seule erreur fait tout échouer — raisonnement scientifique, preuve mathématique, gros refactoring multi-fichiers — la réflexion supplémentaire d’XHigh peut faire la différence entre réussite et échec.
La formulation la plus juste est donc celle-ci : XHigh offre un rapport qualité-prix médiocre sur les tâches ordinaires, mais peut s’avérer indispensable sur quelques tâches très difficiles. Pour savoir si les 69 % supplémentaires en valent la peine, il faut le vérifier sur vos propres échantillons de tâches, et pas seulement sur un score moyen.
🎯 Conseil technique : commencez par sélectionner 20 à 50 échantillons de tâches réelles, lancez-les une fois avec High et une fois avec XHigh, puis comparez le taux de réussite et le coût par tâche. Avec APIYI apiyi.com, il suffit de changer de paramètre avec la même clé API pour mener ce test A/B, sans toucher à la structure du code métier.
À quelles tâches correspondent les quatre niveaux de réflexion de Gemini 4 Hydrogen ?
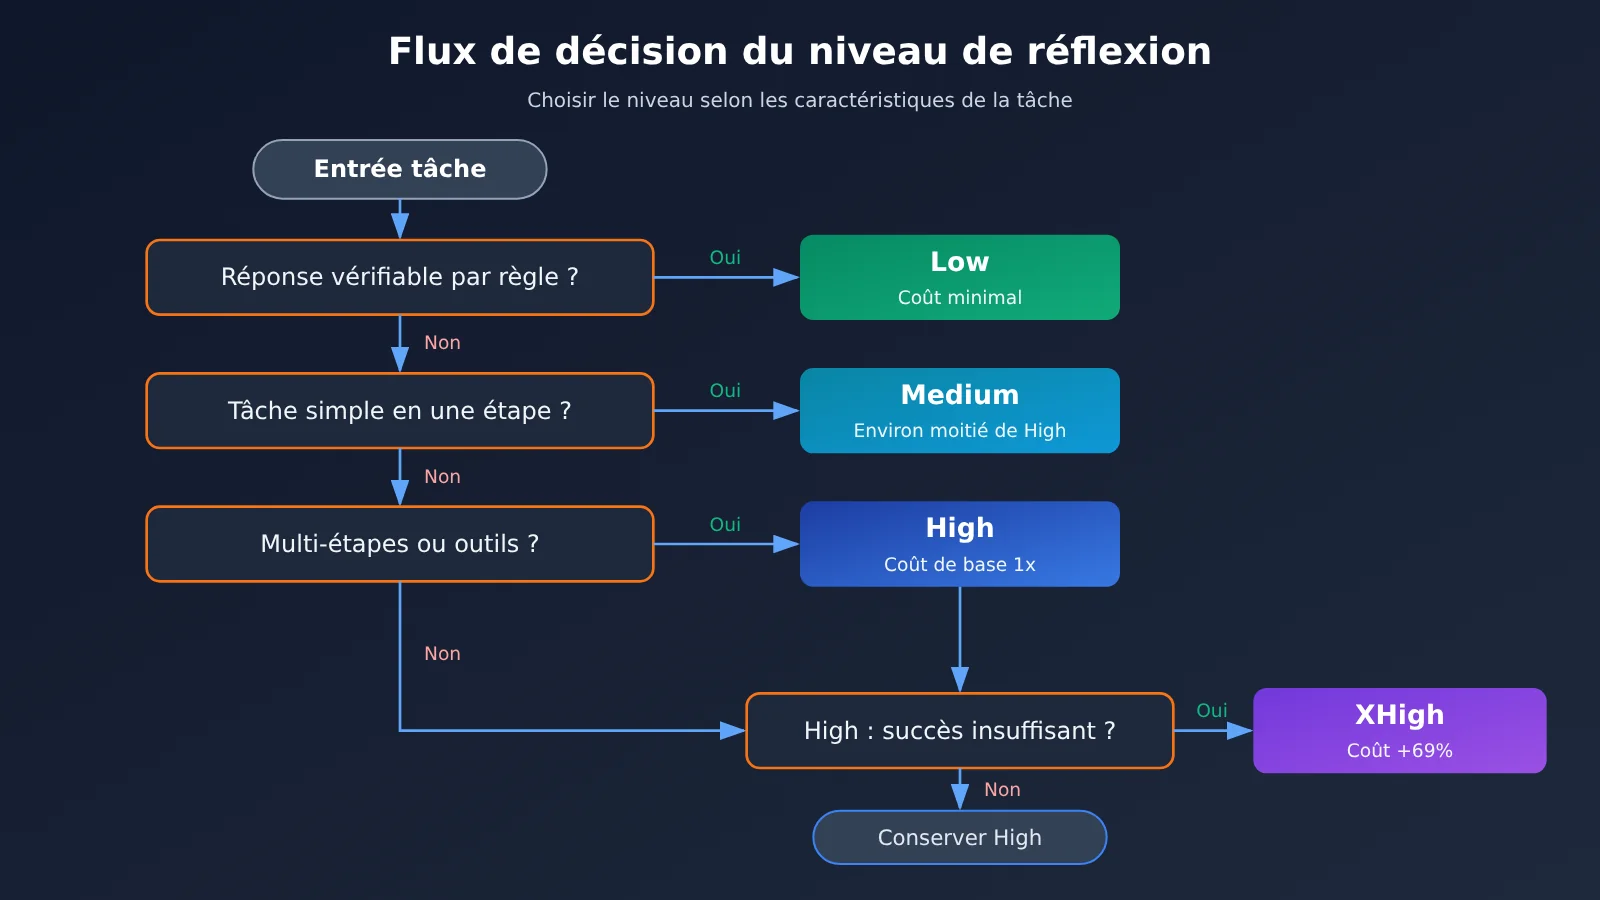
En combinant les recommandations officielles de Google et les données de coût ci-dessus, on peut proposer les conseils suivants selon la difficulté de la tâche :
| Type de tâche | Niveau recommandé | Exemples typiques | Raison du choix |
|---|---|---|---|
| Classification, extraction, mise en forme | Low | Tri de tickets, extraction de champs, formatage JSON, questions-réponses simples | Coût le plus bas, latence du premier token d’environ 5,7 s, adapté aux traitements à forte concurrence |
| Code et traitement de contenu courants | Medium | Écriture d’une fonction dans un fichier unique, réécriture de textes, résumé de documents, automatisation métier générale | 14 points de plus que Low, pour un coût toujours inférieur à la moitié de High |
| Agent multi-étapes et appels d’outils | High | Correction de bugs sur plusieurs fichiers, appels d’outils en chaîne, synthèse après recherche | Niveau par défaut de Google, bon équilibre entre capacité et coût |
| Raisonnement très complexe | XHigh | Raisonnement scientifique, démonstrations mathématiques, refonte de grands projets logiciels | À n’utiliser que lorsque le taux de réussite de High est manifestement insuffisant |
Quand utiliser les niveaux bas de Hydrogen
Low et Medium conviennent aux situations où l’objectif de la tâche est clair et où la réponse est facile à vérifier. Par exemple, extraire un montant et une date d’un contrat, ou classer des retours utilisateurs dans dix catégories : pour ce genre de tâche, réfléchir plus longtemps n’améliore guère la précision et ne fait qu’ajouter de la latence et des frais. Pour le chat en temps réel ou l’autocomplétion de recherche, où la latence du premier token est critique, les ~5,7 s de Low sont nettement préférables aux ~37,8 s de XHigh.
Quand utiliser les niveaux hauts de Hydrogen
High est le niveau par défaut défini par Google et convient à la plupart des workflows d’agents. Il ne faut passer à XHigh que lorsque la situation suivante se présente : « High échoue à répétition et le coût des nouvelles tentatives dépasse déjà celui du passage au niveau supérieur ». À noter : la fiche modèle officielle de Google indique aussi que les niveaux de réflexion élevés peuvent augmenter sensiblement la durée et le coût, avec parfois des ralentissements ou des dépassements de délai ; sur les tâches à longue chaîne, il faut donc prévoir une stratégie de timeout et de nouvelle tentative.
Comment les développeurs peuvent maîtriser le coût de réflexion de Gemini 4 Hydrogen
Le paramètre thinking_level et sa valeur par défaut
Hydrogen choisit son niveau de réflexion via le paramètre thinking_level. Si vous ne le transmettez pas, la valeur par défaut est High. Lors d’une migration depuis Gemini 3.8 Flash, plusieurs points méritent votre attention :
- Avec 3.8 Flash, la valeur par défaut est Medium. Après la migration, si vous ne transmettez aucun paramètre, elle passera automatiquement à High, ce qui peut faire augmenter la facture.
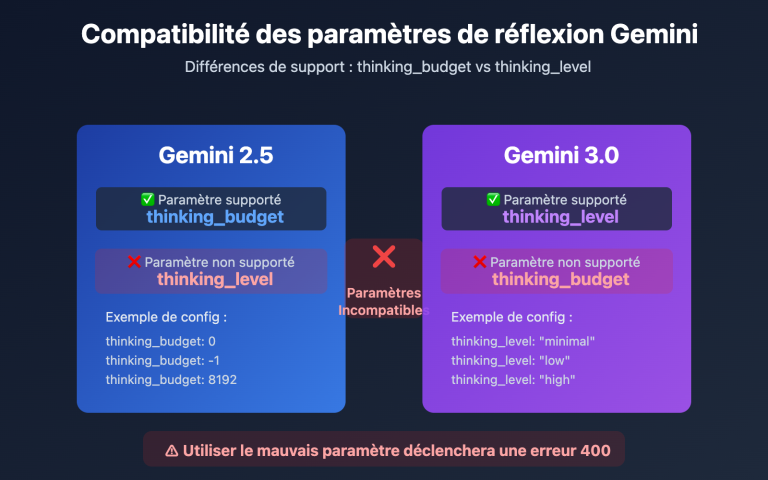
thinking_budgetetMINIMALne sont plus pris en charge ; leur utilisation renvoie une erreur HTTP 400.- Les valeurs personnalisées de temperature, top_p et top_k sont ignorées.
- Les appels d’outils multi-tours doivent conserver et renvoyer correctement les thought signatures.
Exemple minimal : appeler Hydrogen selon le niveau
Voici un appel au format compatible OpenAI, avec le niveau de réflexion transmis via extra_body. Selon la plateforme, le champ utilisé pour faire passer ce paramètre peut varier ; reportez-vous à la documentation de la plateforme pour le nom exact.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "把这条反馈分类:退款太慢"}],
    extra_body={"thinking_level": "low"}  # Classification simple : utiliser Low
)
print(resp.choices[0].message.content)
Afficher le code d’implémentation complet : classer selon la difficulté de la tâche et augmenter automatiquement le niveau
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Correspondance entre le type de tâche et le niveau par défaut
LEVEL_MAP = {
    "classify": "low",
    "extract": "low",
    "content": "medium",
    "code": "medium",
    "agent": "high",
    "reasoning": "xhigh",
}
ESCALATE = {"low": "medium", "medium": "high", "high": "xhigh"}


def call_hydrogen(prompt: str, level: str) -> tuple[str, dict]:
    resp = client.chat.completions.create(
        model="gemini-4-hydrogen",
        messages=[{"role": "user", "content": prompt}],
        extra_body={"thinking_level": level},
    )
    usage = resp.usage.model_dump() if resp.usage else {}
    return resp.choices[0].message.content, usage


def run_task(prompt: str, task_type: str, validator=None,
             max_level: Optional[str] = "high") -> str:
    """Commencer par le niveau bas, puis augmenter progressivement en cas d'échec de validation ; max_level limite le niveau maximal"""
    level = LEVEL_MAP.get(task_type, "medium")
    while True:
        answer, usage = call_hydrogen(prompt, level)
        print(f"[{level}] usage={usage}")  # Enregistrer les tokens pour calculer le coût des tâches réussies
        if validator is None or validator(answer):
            return answer
        if level == max_level or level not in ESCALATE:
            return answer
        level = ESCALATE[level]


result = run_task(
    prompt="提取订单号,只返回数字:订单 A-20261113-889 已发货",
    task_type="extract",
    validator=lambda s: s.strip().replace("-", "").isalnum(),
)
print(result)
🚀 Démarrage rapide : APIYI apiyi.com propose une interface compatible OpenAI. Une seule clé API suffit pour appeler les principaux modèles comme Gemini, Claude ou OpenAI. Les nouveaux utilisateurs disposent d’un quota d’essai gratuit, idéal pour valider d’abord la stratégie de niveaux ci-dessus avant de passer en production.
Stratégie de gradation : commencer par le niveau bas, remonter en cas d’échec
L’approche recommandée, c’est « niveau bas par défaut, montée en charge à la demande » : pour les tâches simples, on reste fixé sur Low ou Medium ; pour les tâches complexes, on démarre sur High et on ne passe à XHigh qu’en cas d’échec de validation ; enfin, on fixe un plafond de niveau par type de tâche, pour éviter une explosion inattendue des coûts. C’est la même logique que celle de Google dans Antigravity Orchestrator, où différents modèles se répartissent le travail — sauf qu’ici, ce que l’on ajuste, c’est la profondeur de réflexion d’un même modèle.
Mesurer l’effet de l’optimisation des niveaux Hydrogen avec quatre indicateurs
| Indicateur d’optimisation | Mode de calcul | Pourquoi y prêter attention |
|---|---|---|
| Précision / taux de réussite | Nombre de tâches validées ÷ nombre total de tâches | La qualité ne doit pas chuter sensiblement après une descente de niveau |
| Temps de bout en bout | Durée totale entre la requête et l’obtention d’un résultat exploitable, reprises comprises | Le délai du premier token n’en représente qu’une partie |
| Consommation de tokens | Tokens d’entrée + de sortie (réflexion comprise) | Les tokens de réflexion sont facturés au tarif de sortie |
| Coût par tâche réussie | Dépense totale ÷ nombre de tâches réussies | Un niveau bas qui échoue souvent et doit être relancé peut coûter plus cher qu’un niveau élevé |
Le « coût par tâche réussie » est le plus fidèle reflet de la dépense réelle. Si Medium oblige à relancer 30 % des tâches alors que High réussit du premier coup, le coût par tâche réussie de High peut très bien être inférieur.
FAQ
Q1 : les quatre niveaux de réflexion de Gemini 4 Hydrogen correspondent-ils à quatre modèles différents ?
Non. Ces quatre niveaux correspondent à différentes profondeurs de raisonnement d’un même modèle, `gemini-4-hydrogen`, que l’on sélectionne via le paramètre thinking_level. Le prix par Token est identique ; seule diffère la quantité de tokens de réflexion générés.
Q2 : XHigh ne dépasse High que de 3 points, est-il donc totalement inutile de l’utiliser ?
Ce n’est pas la bonne façon de voir les choses. Ces 3 points sont un écart moyen sur plusieurs tâches. En raisonnement scientifique, en démonstration mathématique et sur de gros projets d’ingénierie, XHigh peut faire la différence entre réussir ou non la tâche. Pour des tâches ordinaires, son rapport coût-efficacité est faible, mais pour quelques tâches très difficiles, il peut être indispensable.
Q3 : High prend en moyenne 8,3 minutes, faut-il donc attendre aussi longtemps à chaque question ?
Non. Ces 8,3 minutes correspondent au temps pondéré des tâches d’évaluation standardisées d’Artificial Analysis. Pour une conversation ordinaire, il vaut mieux se référer à la latence du premier token de réponse : environ 18,9 secondes pour High et 5,7 secondes pour Low. La durée réelle dépend aussi de la longueur de la tâche.
Q4 : que se passe-t-il si l’on ne passe pas thinking_level ?
High est utilisé par défaut. Les projets migrés depuis Gemini 3.8 Flash (qui utilise Medium par défaut) risquent, s’ils conservent l’ancien code sans passer de paramètre, de voir leur niveau de réflexion augmenter automatiquement, avec une hausse de coût possible. Mieux vaut définir explicitement le niveau.
Q5 : comment comparer rapidement l’efficacité des différents niveaux sur son propre cas d’usage ?
Nous conseillons de préparer un échantillon de tâches réelles, de l’exécuter avec différents niveaux, puis de comparer le taux de réussite et la consommation de tokens :
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API ainsi qu’un crédit de test gratuit
2. Utiliser le code de cet article en modifiant la valeur de `thinking_level`
3. Choisir le niveau le plus adapté en fonction du « coût par tâche réussie »
Q6 : quels sont les problèmes connus des niveaux de réflexion élevés de Hydrogen ?
La fiche du modèle Google indique que les niveaux de réflexion élevés peuvent nettement augmenter la durée et le coût, avec parfois des latences ou des délais dépassés. Par ailleurs, des utilisateurs sur Hacker News signalent des cas d’exécution excessive sur certaines tâches d’agent. Nous conseillons de définir un délai d’expiration, un niveau maximal et des conditions d’arrêt pour les tâches longues.
Q7 : quelle est l’erreur la plus courante lorsqu’on estime un coût en Tokens ?
Se baser uniquement sur le nombre de caractères de la réponse finale. Les tokens de réflexion sont facturés au prix de sortie : sur l’ensemble des évaluations, les tokens de sortie de XHigh représentent environ 2,76 fois ceux de High. Consulter le détail de la consommation réelle dans la console APIYI apiyi.com est plus fiable qu’une estimation manuelle.
Gemini 4 Hydrogen — les quatre niveaux de réflexion : points clés à retenir
- Même modèle, niveaux différents : les quatre niveaux ont un prix unitaire identique ; le coût réel d’une tâche dépend de la consommation de tokens de réflexion.
- Rendements décroissants évidents : de High à XHigh, on gagne 3 points, mais le coût des tâches d’évaluation augmente d’environ 69 %.
- Latence doublée : en XHigh, la latence de la première réponse est d’environ 37,8 secondes, soit le double de High.
- Le niveau par défaut est High : lors d’une migration depuis 3.8 Flash, il faut définir explicitement le niveau.
- Choisir le niveau selon la difficulté : Low pour la classification, Medium pour les tâches courantes, High pour les agents, XHigh uniquement pour les problèmes difficiles.
- Regarder le coût des tâches réussies : en incluant les nouvelles tentatives, on peut comparer le coût réel des différents niveaux.
- Valider avec des échantillons : on peut comparer les quatre niveaux avec une seule clé API via APIYI apiyi.com.
Conclusion
Les conclusions essentielles de la comparaison des quatre niveaux de réflexion de Gemini 4 Hydrogen :
- Écart de capacités important : de 27 points en Low à 54 points en XHigh, les capacités varient du simple au double sous un même nom de modèle.
- Coût marginal croissant : chaque point supplémentaire coûte environ 0,036 $ pour Low → Medium, contre environ 0,43 $ pour High → XHigh.
- Utiliser XHigh selon les besoins : l’écart sur la moyenne est faible, mais pour quelques tâches très difficiles, cela peut rester déterminant.
Pour les activités quotidiennes, le conseil est le suivant : définissez explicitement thinking_level, utilisez un niveau bas pour les tâches simples, remontez d’un cran pour les étapes complexes et prenez le coût des tâches réussies comme mesure finale.
Nous recommandons de valider rapidement l’effet de chaque niveau avec de vrais échantillons de tâches via APIYI apiyi.com ; la plateforme propose une interface compatible OpenAI et un quota de test gratuit.
📚 Références
- Artificial Analysis – page d’évaluation des quatre niveaux de Gemini 4 Hydrogen : indice d’intelligence, coût par tâche, durée et données de latence
- Lien :
artificialanalysis.ai/models/gemini-4-hydrogen-low - Lien :
artificialanalysis.ai/models/gemini-4-hydrogen-medium - Lien :
artificialanalysis.ai/models/gemini-4-hydrogen-high - Lien :
artificialanalysis.ai/models/gemini-4-hydrogen -
Remarque : source de toutes les données comparatives des quatre niveaux présentées dans cet article, la latence étant un indicateur dynamique
-
Blog officiel de Google – Introducing Gemini 4 Hydrogen : annonce de sortie
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Remarque : positionnement du modèle, étendue des capacités et cas d’usage des partenaires
-
Guide développeur Google Cloud – Gemini 4 Hydrogen : thinking_level et points d’attention pour la migration
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Remarque : usages recommandés des quatre niveaux, niveau par défaut, paramètres incompatibles
-
Page de tarifs Google AI Studio : tarifs officiels de l’API Hydrogen
- Lien :
aistudio.google.com/docs/pricing -
Remarque : tarifs des modes Standard, Batch, Flex et Priority, règles de facturation des tokens de réflexion
-
Fiche de modèle Google DeepMind : limites et évaluation de sûreté
- Lien :
deepmind.google/models/model-cards/gemini-4-hydrogen/ - Remarque : risques de durée au niveau de réflexion élevé, refus de réponse et hallucinations parmi les problèmes connus
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI pour obtenir davantage de ressources sur l’intégration des modèles de la série Gemini