Примечание автора: на основе 10 кросс-модельных тестов, опубликованных Google DeepMind, разбираем, в чём Gemini 4 Hydrogen, GPT-6.1 Terra и Claude Sonnet 5.5 сильнее или слабее в программировании, агентной автоматизации и управлении компьютером, и даём рекомендации по выбору модели под задачу.
Кратко: опубликованные Google кросс-модельные тесты показывают, что Gemini 4 Hydrogen и Claude Sonnet 5.5 по-разному сильны в задачах программирования и работы с Agent, а GPT-6.1 Terra выделяется стоимостью и позиционированием в визуальном управлении. На практике при выборе модели стоит учитывать условия тестирования, тип задач и стоимость.
Что стоит знать: 5 терминов перед чтением
- Harness — тестовый фреймворк, который организует подачу входных данных модели, выполнение инструментов и оценку задач. Для одной и той же модели с другим Harness результаты могут заметно отличаться.
- Версия бенчмарка — версия данных, задач и правил конкретной оценки. Например, Terminal-Bench 4.0 и 4.1 — разные версии, поэтому их результаты нужно интерпретировать отдельно.
- Agent — система, в которой модель и среда выполнения инструментов вместе решают многошаговую задачу; результат отражает общую работу «модель + цепочка инструментов».
- Токен — единица измерения обрабатываемой моделью информации, например текста; цены API обычно указываются за миллион токенов.
- API — интерфейс, через который программа вызывает сервис; разработчики подключают с его помощью модель к своему приложению или Agent.
12 ноября 2026 года Google официально представила Gemini 4 Hydrogen, а в официальной карточке модели свела её с GPT-6.1 Terra и Claude Sonnet 5.5 в одной таблице оценок. Эта таблица охватывает программирование, агентную автоматизацию, управление компьютером и мультимодальные задачи работы со знаниями — это самый полный на сегодняшний день открытый срез для сравнения трёх моделей.
Это не компромиссный разбор в стиле «у каждого есть свои сильные стороны». Мы по пунктам разберём, что именно проверяет каждый тест и в каких условиях получены результаты, затем отдельно сделаем выводы по программированию, агентной автоматизации и управлению компьютером, а в конце предложим готовую к применению матрицу выбора.
Что вы получите: после прочтения вы поймёте, на каких задачах Gemini 4 Hydrogen лидирует, где уступает Sonnet 5.5, и где Terra уместнее всего встроить в командный рабочий процесс.
Зачем сравнивать Gemini 4 Hydrogen с Terra и Sonnet 5.5
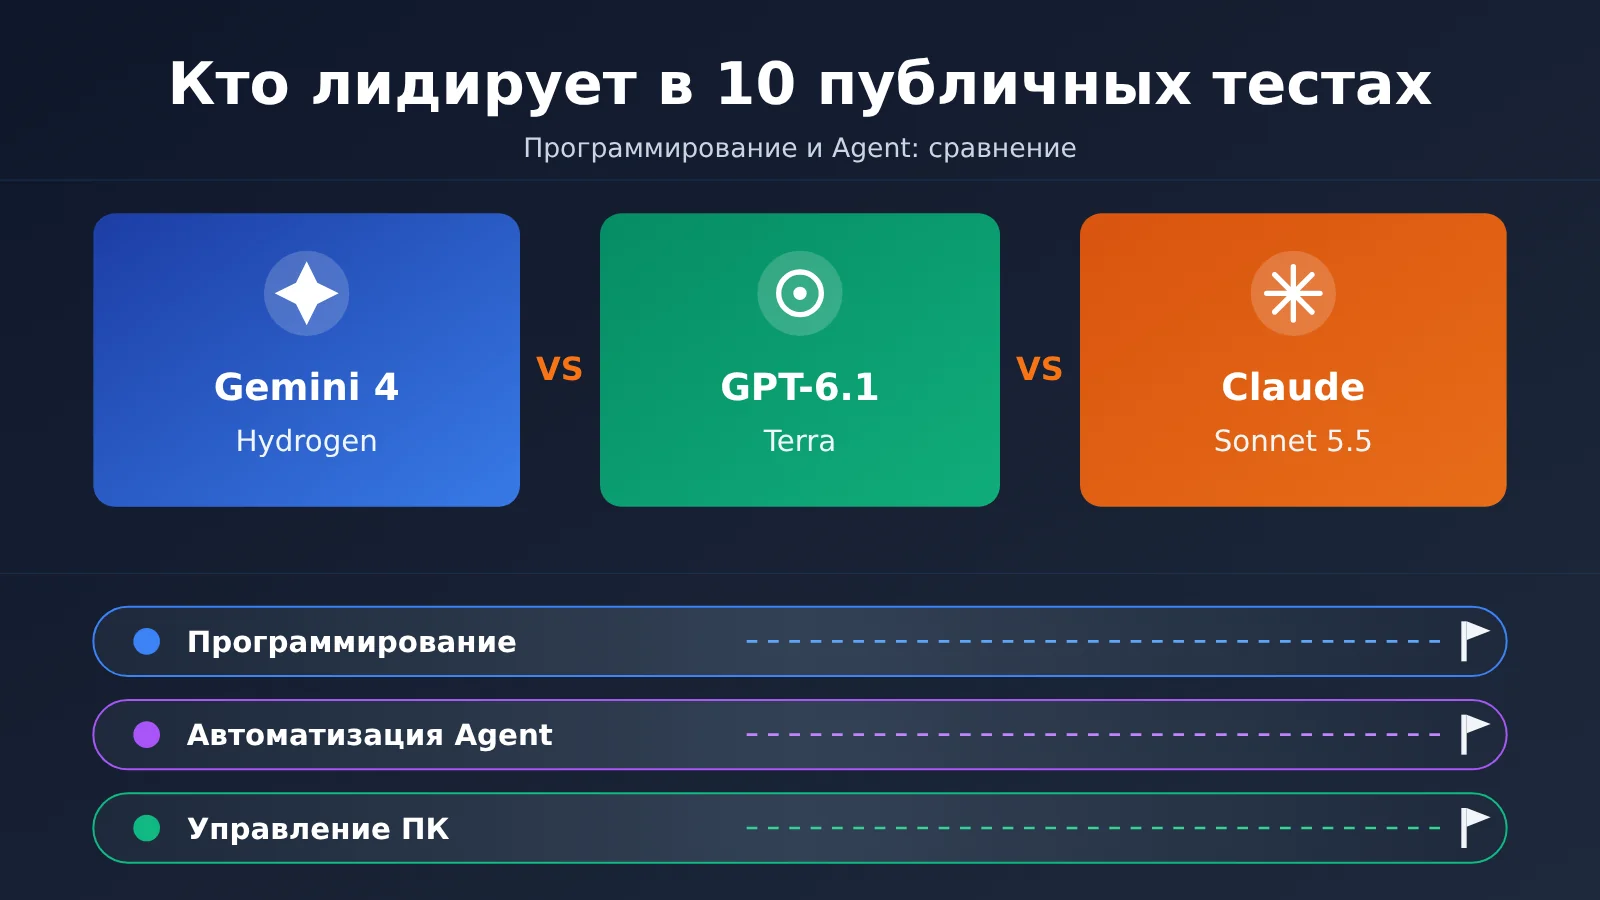
Все три модели вышли с разницей меньше чем в два месяца, и их позиционирование во многом пересекается: это не самые тяжёлые флагманские модели для рассуждений, а «основные рабочие лошадки» для разработчиков, выполнения задач агентами и часто повторяющихся профессиональных сценариев. Для команд, которые ежедневно делают много вызовов, именно этот класс моделей определяет затраты и эффективность.
Gemini 4 Hydrogen — новое поколение высокоэффективных моделей Google DeepMind. Официально модель позиционируется для повседневного программирования и выполнения задач AI-агентами: она может работать самостоятельно, а также выступать исполнителем или верификатором в мультимодельных системах. GPT-6.1 Terra от OpenAI выпущена 26 октября 2026 года с акцентом на визуальные рассуждения, работу с компьютером и эффективное выполнение повседневных задач. Claude Sonnet 5.5 от Anthropic выпущена 28 сентября 2026 года; официально подчёркиваются повседневное программирование, исправление багов, подготовка профессиональных документов и дизайн сложных интерфейсов.
| Модель | Производитель | Дата выпуска | Официальное позиционирование | Стандартная цена API (за миллион токенов, ввод/вывод) | Источник цены |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | Повседневное программирование, вызовы множества инструментов, выполнение задач агентами | $1.50 / $7.50 | Страница цен Google AI Studio, проверено 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | Визуальные рассуждения, работа с компьютером, повседневные задачи | $1 / $5 | Материалы релиза OpenAI, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | Повседневное программирование, исправление багов, профессиональные документы, дизайн интерфейсов | В справочных материалах не указана; ориентируйтесь на официальную страницу с ценами | Официальный сайт Anthropic |
Стоит отметить, что у Hydrogen токены размышления включаются в цену вывода, поэтому реальную стоимость нельзя оценивать только по финальному видимому тексту. Кроме того, в режимах Batch и Flex цена Hydrogen составляет $0.75 / $3.75 — они подходят для офлайн-пакетной обработки.
Количественное сравнение в этой статье в первую очередь опирается на карточку моделей Google DeepMind версии ноября 2026 года и сопутствующий документ с методикой оценки. Это значит, что данные собраны Google, а часть результатов конкурентов взята из публичных отчётов производителей или рейтингов. В пятом разделе мы отдельно обсудим, как это влияет на выводы.
Сравнение программистских способностей Gemini 4 Hydrogen: кто лучше справляется с реальными задачами
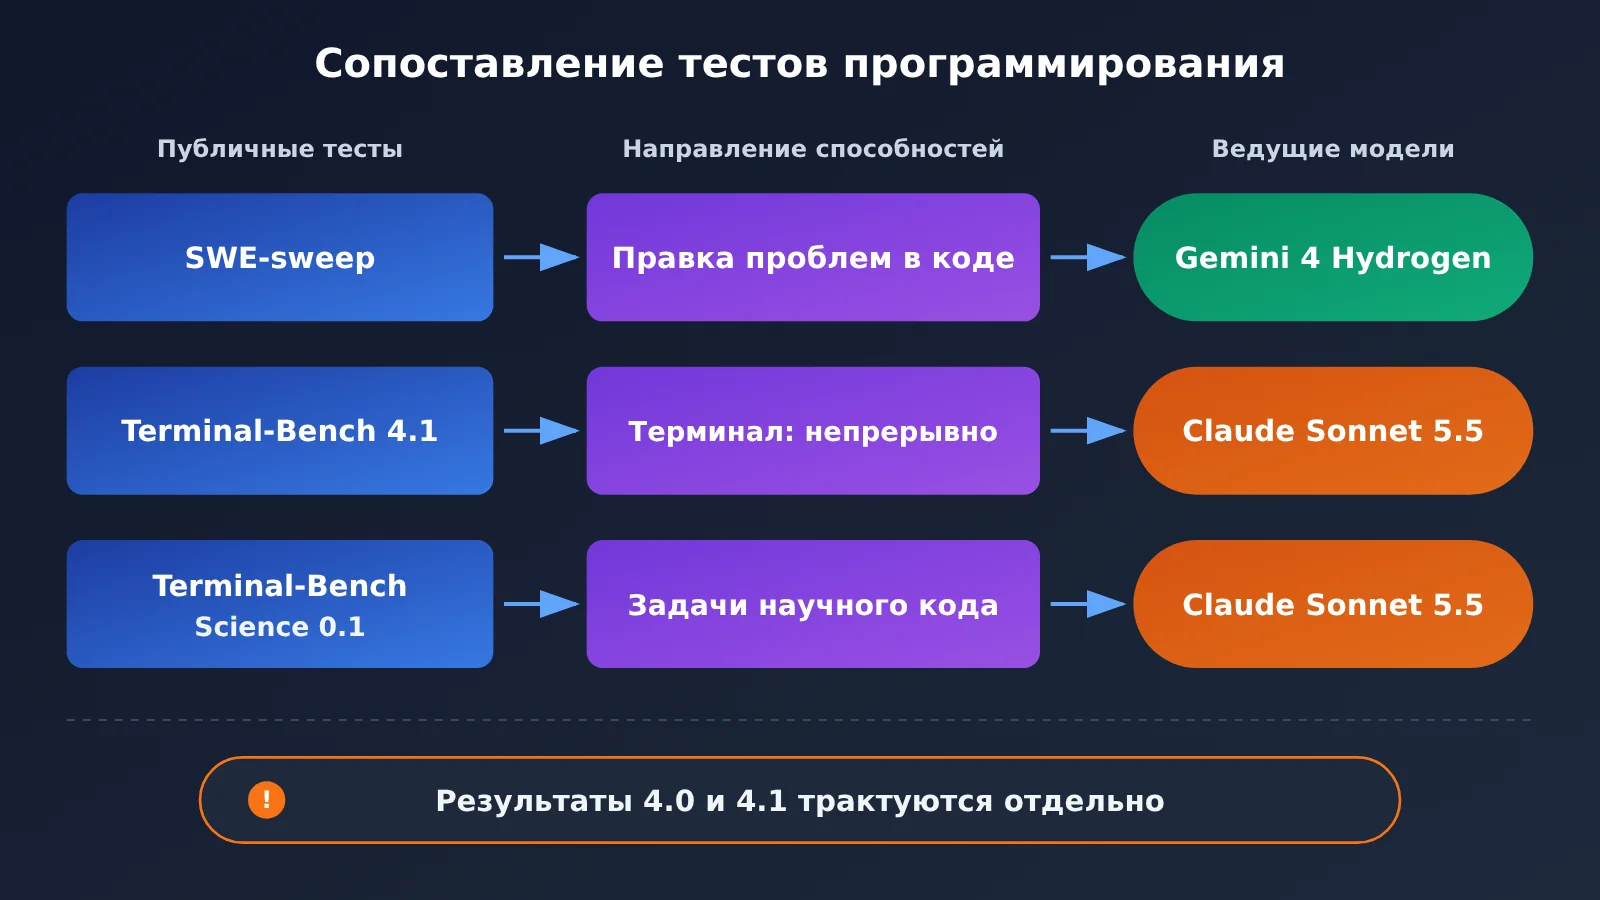
Тесты на программирование можно разделить на две группы навыков: первая — находить и исправлять проблемы в реальной кодовой базе, вторая — последовательно выполнять команды в терминале и доводить инженерную задачу до конца. SWE-sweep проверяет первое, семейство Terminal-Bench — второе, а Terminal-Bench-Science оценивает умение решать научные задачи с помощью кода.
| Тест (версия) | Метрика | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Лидер |
|---|---|---|---|---|---|
| SWE-sweep | Взвешенная награда по подзадачам | 13,5% | 3,1% | 5,8% | Hydrogen |
| Terminal-Bench 4.1 | Средняя награда | 57,0% | 63,9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | Балл за задачу | 51,4% | 59,9% | 58,3% | Sonnet |
Источник: Google DeepMind, «Gemini 4 Hydrogen Model Evaluation» и карточка модели, ноябрь 2026 года.
Как читать результаты программистских тестов
Абсолютные баллы в SWE-sweep в целом низкие — это говорит о том, что тест очень сложный. Результат Hydrogen в 13,5% примерно вдвое больше, чем у Terra, и более чем вчетверо больше, чем у Sonnet; именно здесь разрыв наиболее заметен. Правда, в этом тесте Hydrogen запускался через собственный Antigravity-CLI 1.4.8 от Google, а условия запуска конкурентов не обязательно были такими же — часть разрыва может объясняться адаптацией к Harness.
В Terminal-Bench 4.1 Sonnet 5.5 лидирует с 63,9% против 57,0% у Hydrogen; у Terra в таблице Google результата по этому тесту нет. Hydrogen здесь использовал Harness mini-swe-agent vision и уровень размышлений High, каждая задача запускалась 5 раз, а затем бралась средняя награда. В Terminal-Bench-Science 0.1 Sonnet по-прежнему впереди, Terra идёт следом с 58,3%, а Hydrogen оказывается лишь третьим.
Вывод по программированию: Hydrogen явно сильнее в тестах на исправление проблем в кодовой базе, таких как SWE-sweep; Sonnet 5.5 стабильнее в задачах с выполнением команд в терминале; Terra близка к Sonnet в научных задачах с кодом. Ни одна модель не лидирует во всех программистских тестах сразу.
Справочные данные Terminal-Bench 4.0 от производителей
OpenAI и Anthropic публиковали результаты Terminal-Bench 4.0. Поскольку 4.0 и 4.1 — это разные версии бенчмарка, ниже они вынесены в отдельную таблицу: их нельзя смешивать и сравнивать с результатами 4.1 из таблицы выше.
| Тест (версия) | Модель | Результат | Условия тестирования | Источник |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | Тест производителя | Материалы Anthropic, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | Максимальный уровень рассуждений | Материалы OpenAI, 2026-10-26 |
Эти данные ценны как ориентир: в условиях тестирования, заданных самими производителями, Sonnet 5.5 заметно сильнее Terra в терминальных задачах — это совпадает с картиной в таблице Google, где Sonnet лидирует в терминальных тестах.
Сможет ли Gemini 4 Hydrogen выполнить всю работу в агентных и автоматизированных тестах
Главное отличие агентных тестов от однократного вопроса-ответа в том, что модели нужно самостоятельно планировать шаги, последовательно вызывать инструменты, корректировать стратегию после неудач и в конце проверять результат. Такие тесты ближе к реальным автоматизированным рабочим процессам и сильнее проверяют «дисциплину выполнения» у модели.
В таблице ниже собраны все результаты сравнения моделей в оценке Google по агентной автоматизации, работе с компьютером и мультимодальной работе со знаниями. Она используется в третьем и четвёртом разделах.
| Тест (версия) | Направление способностей | Метрика | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | Профессиональные многошаговые агентные задачи | Балл за задачу | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | Автоматизация рабочих процессов | Балл за задачу | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | Долгосрочная симуляция бизнеса | Итоговый баланс средств | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | Работа с компьютером/графическим интерфейсом | Доля успешных задач | 77.6% | 83.9% | 74.2% |
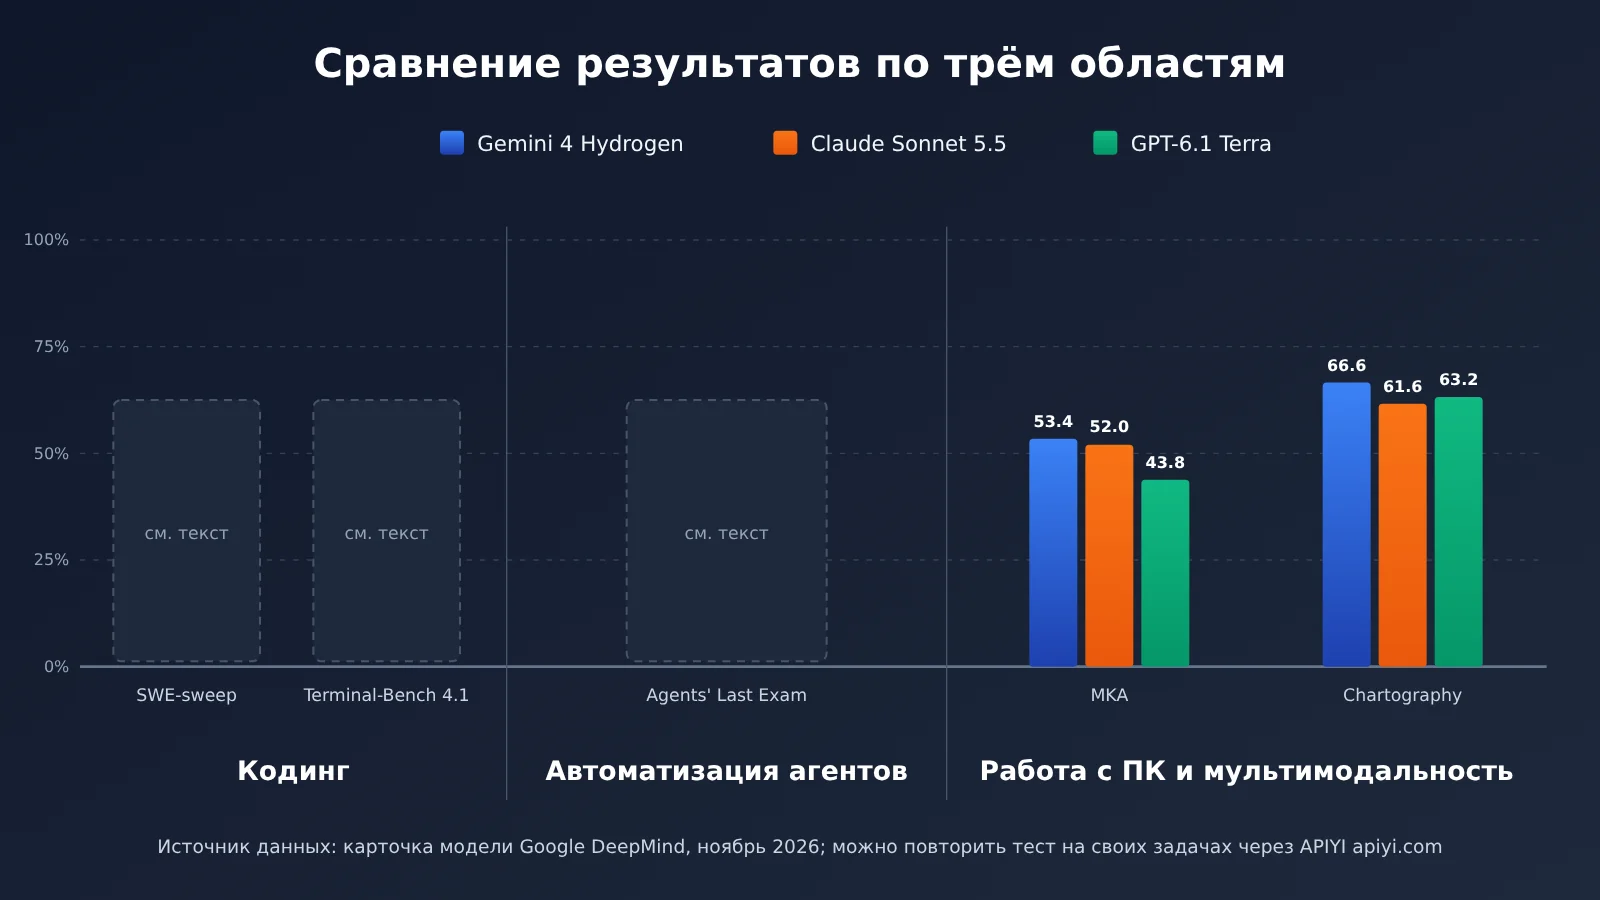
| MKA | Мультимодальная работа со знаниями | Балл за задачу | 53.4% | 52.0% | 43.8% |
| Chartography | Понимание графиков (без инструментов) | Точность | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | Рассуждения на сложных знаниях | Точность | 58.8% | 53.3% | 47.3% |
Источник: карточка модели Google DeepMind и «Gemini 4 Hydrogen Model Evaluation», ноябрь 2026 г.
Разбор результатов в агентных и автоматизированных задачах
Agents’ Last Exam v1.1 включает 122 задачи и 5-часовое окно; Hydrogen тоже выполняется через Antigravity-CLI 1.4.8. Hydrogen лидирует с 71.6%, но примечательно, что Terra с 69.8% идёт следом и оказывается почти на 10 процентных пунктов выше Sonnet. Это показывает, что на профессиональных многошаговых задачах Terra не так уж слаба.
В AutomationBench-AA расклад другой: Hydrogen — 76.1%, Sonnet — 71.8%, а Terra заметно отстаёт с 60.2%. Если ваш бизнес связан с массовой автоматизацией межсистемных процессов, на этот разрыв стоит обратить внимание.
Vending-Bench 2 — это задача долгосрочного симуляционного управления бизнесом, где метрика — итоговый баланс средств, а не точность. Hydrogen с $14,549 заметно впереди; это можно рассматривать как дополнительный сигнал о «стабильности решений на длинном горизонте», но среда здесь одна, поэтому переносить вывод на все длинные задачи не стоит.
Вывод по агентным задачам: во всех агентных и автоматизированных тестах из списка Google Hydrogen лидирует; Terra близка к Hydrogen на профессиональных многошаговых задачах, но отстаёт в автоматизации процессов; Sonnet занимает промежуточное положение.
🚀 Быстрый старт: результаты в агентных тестах сильно зависят от Harness и описания инструментов, а публичные оценки — лишь отправная точка. Рекомендую проверить все три модели через APIYI apiyi.com на одном и том же стеке инструментов и одной и той же подборке реальных задач: один API-ключ позволяет переключаться, так будет проще получить сравнительные данные именно для вашего сценария.
Кто сильнее в работе с компьютером и мультимодальной работе со знаниями — Gemini 4 Hydrogen или Sonnet 5.5
Тесты на работу с компьютером требуют, чтобы модель «смотрела на экран, щёлкала мышью и набирала текст на клавиатуре». Это напрямую соответствует работе в браузере, автоматизации офисных приложений и другим подобным сценариям. Мультимодальная работа со знаниями проверяет чтение сложных файлов и понимание графиков — это анализ финансовых отчётов, подготовка исследовательских отчётов и т. п.
OSWorld-2.1: Sonnet 5.5 лидирует в операциях с графическим интерфейсом
В тестировании Google OSWorld 2.1 использует 82 офлайн-задачи с разрешением 1080p и максимум 500 шагов; модель смотрит на скриншоты и выполняет действия через PyAutoGUI. Sonnet 5.5 лидирует с 83,9%, у Hydrogen 77,6%, у Terra 74,2%.
Здесь есть важный нюанс методологии: Anthropic сам публикует для Sonnet 5.5 результат 80,1% по части тестов OSWorld 2.1, а в сравнительной таблице Google стоит 83,9%; второе значение Google получил в заданных условиях и выбрал лучший результат из нескольких прогонов. Иными словами, один и тот же тест у разных производителей может давать разные баллы, поэтому при сравнении нужно фиксировать один источник.
MKA и Chartography: Hydrogen немного впереди
В тесте MKA на мультимодальную работу со знаниями Hydrogen (53,4%) и Sonnet (52,0%) очень близки, а Terra с 43,8% отстаёт примерно на 10 процентных пунктов. Chartography проверяет понимание графиков без использования инструментов: Hydrogen лидирует с 66,6%. Интересно, что Terra с 63,2% оказывается второй, выше Sonnet с 61,6%; это совпадает с тем, как OpenAI позиционирует Terra — как модель для «визуального рассуждения».
Вывод по работе с компьютером и мультимодальным задачам: для операций с графическим интерфейсом приоритет — Sonnet 5.5; в чтении сложных файлов и мультимодальной интеграции знаний Hydrogen и Sonnet близки, Hydrogen немного лучше; в чистом понимании графиков лидирует Hydrogen, а Terra тоже конкурентоспособна.
Как правильно читать открытые результаты оценки Gemini 4 Hydrogen
Самое частое заблуждение при чтении публичных бенчмарков — воспринимать одну таблицу как ведомость с «одной аудиторией и одними правилами». На самом деле в методичке Google по оценке указано несколько важных оговорок:
- Уровень рассуждения: Hydrogen обычно тестируют с максимальной настройкой рассуждения, но для некоторых задач правила другие. Например, в Terminal-Bench 4.1 используется уровень High.
- Harness выполнения: в SWE-sweep и Agents’ Last Exam применяется Antigravity-CLI 1.4.8, в Terminal-Bench 4.1 — mini-swe-agent vision Harness, в OSWorld 2.1 — скриншоты плюс PyAutoGUI.
- Количество прогонов: в Terminal-Bench 4.1 каждая задача запускается 5 раз и берётся средняя награда, тогда как для оценок конкурентов в OSWorld использовался лучший результат из нескольких запусков. Сами методы подсчёта уже различаются.
- Источник результатов: результаты конкурентов в основном взяты из публичных отчётов производителей и лидербордов; не все модели прогоняла одна и та же команда.
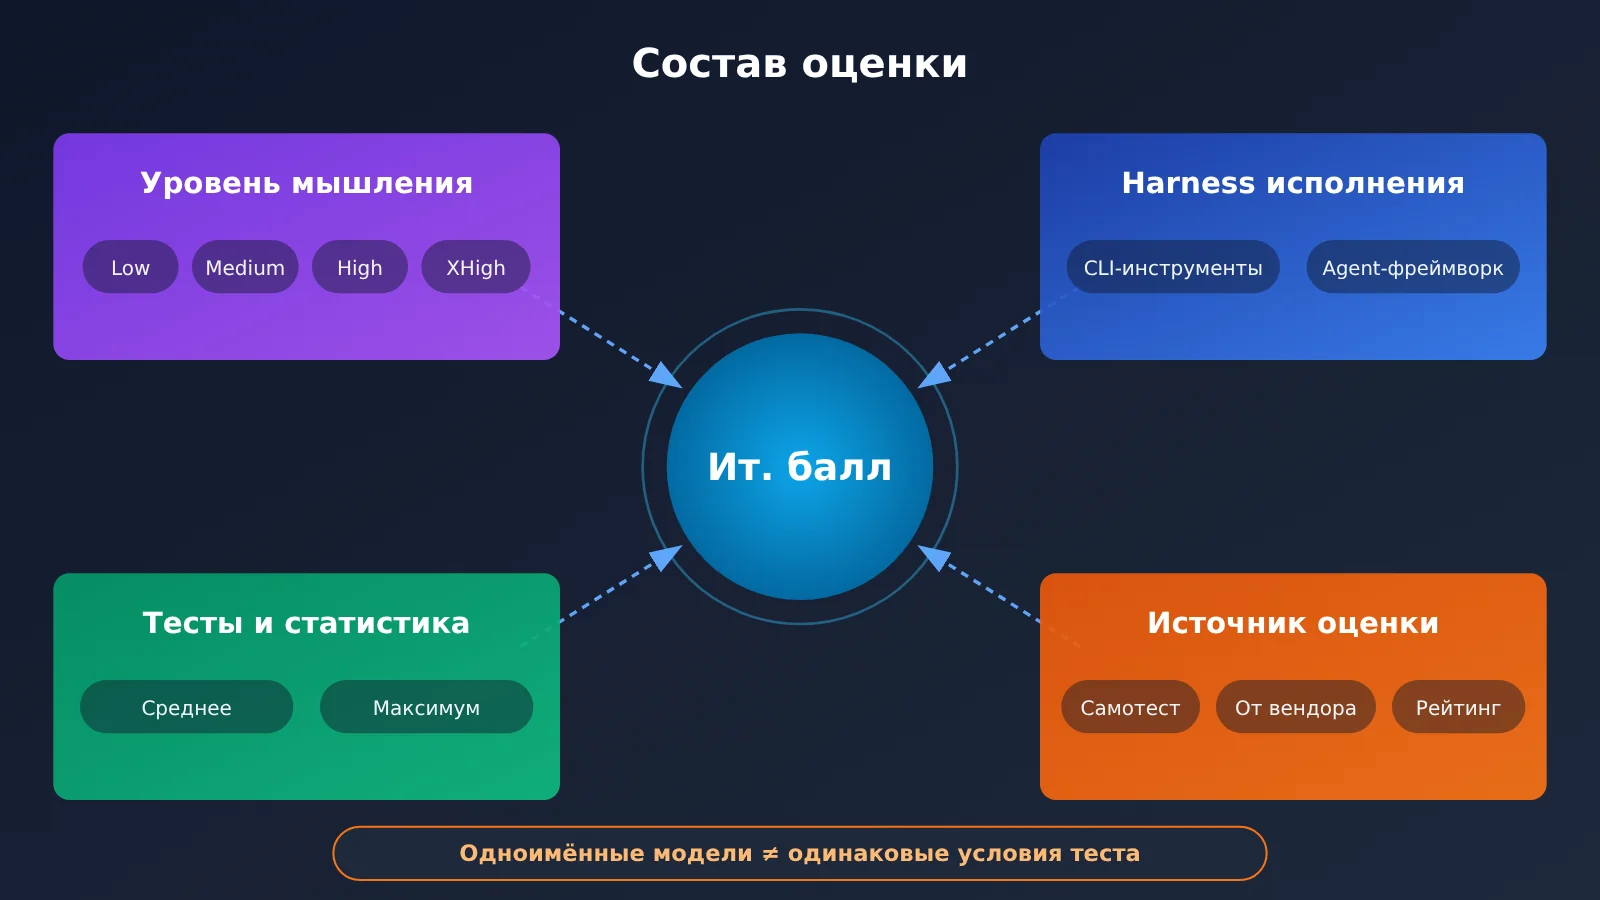
Влияние уровня рассуждения особенно велико. 12 ноября Artificial Analysis независимо проверила четыре уровня Hydrogen: индекс интеллекта составил 27 для Low, 41 для Medium, 51 для High (по умолчанию) и 54 для XHigh; средняя стоимость соответствующих стандартизированных тестовых задач — от $0.29 до $3.16. Это результаты на их эталонных задачах, а не фактические расходы обычного пользователя на каждый вызов, но этого достаточно, чтобы показать: одна и та же модель на разных уровнях сильно различается — XHigh всего на 3 балла выше High, но обходится заметно дороже.
Поэтому, читая результаты в этой статье, помните два момента: во-первых, выводы относятся только к перечисленным открытым тестам; во-вторых, не составляйте «общий рейтинг», склеивая самые выгодные цифры из таблицы Google, самоотчётов OpenAI и самоотчётов Anthropic.
Быстрый старт с Gemini 4 Hydrogen: сравниваем три модели на одном и том же коде
Самый надёжный способ выбрать модель — прогнать все три на своих собственных задачах. Пример ниже использует OpenAI-совместимый интерфейс: достаточно изменить параметр model, чтобы переключиться.
Минимальный пример
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Найди баг в этом коде на Python и предложи минимальное исправление"}]
)
print(response.choices[0].message.content)
Посмотреть полный код: скрипт сравнения трёх моделей на одной задаче
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# ID моделей берём из списка моделей платформы; gemini-4-hydrogen — официальный ID Google
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # условный ID, проверьте в консоли
    "claude-sonnet-5.5",   # условный ID, проверьте в консоли
]

def compare(prompt: str, system: str = "Ты опытный инженер, меняй только тот код, который действительно нужно"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("Исправь: функция выбрасывает IndexError при пустом списке на входе ..."):
        print(r)
При переходе на Hydrogen есть несколько моментов, о которых стоит помнить: пользовательские значения temperature, top_p и top_k игнорируются; thinking_budget и MINIMAL не поддерживаются; уровень рассуждений по умолчанию — High; при многошаговых вызовах инструментов нужно корректно возвращать thought signatures. Если ваш агент раньше опирался на низкую температуру для контроля вывода, придётся перейти на структурированный вывод или на более явные инструкции.
Совет: возьмите 10–20 реальных заявок или задач в качестве оценочного набора, по очереди вызовите на APIYI apiyi.com все три модели и фиксируйте долю успешных ответов, время выполнения и количество выходных токенов. У новых пользователей есть бесплатный тестовый лимит, так что небольшое тестирование можно провести ещё до正式 покупки.
Сценарии применения и матрица выбора Gemini 4 Hydrogen, Terra и Sonnet 5.5
Когда выбирать Gemini 4 Hydrogen
- Исправление проблем в кодовой базе и обновление зависимостей: наибольший отрыв в SWE-sweep, плюс официально доработано точное редактирование.
- Многошаговые агенты и автоматизация процессов: лидирует в Agents’ Last Exam, AutomationBench-AA и Vending-Bench 2.
- Анализ сложных документов и графиков: лидирует в MKA и Chartography, поддерживает ввод в разных форматах — PDF, документы Office и другие.
Когда выбирать Claude Sonnet 5.5
- Задачи, требующие активной работы в терминале: лидирует в Terminal-Bench 4.1 и Terminal-Bench-Science 0.1.
- Работа с рабочим столом и графическим интерфейсом: OSWorld-2.1 — лучший результат в таблице Google.
- Профессиональные документы и дизайн интерфейсов: направление, которое Anthropic официально выделяет особо.
Когда выбирать GPT-6.1 Terra
- Массовые задачи с чувствительностью к цене: стандартная цена $1 / $5 — самая низкая из известных цен этих трёх моделей.
- Визуальное рассуждение и повседневная автоматизация: второе место в Chartography, в Agents’ Last Exam — почти как у Hydrogen.
| Тип задачи | Основной выбор | Альтернатива | Чувствительность к цене | Рекомендации по выполнению | Канал подключения |
|---|---|---|---|---|---|
| Поддержка кодовой базы, исправление багов | Hydrogen | Sonnet 5.5 | Средняя | Hydrogen правит код, Sonnet проверяет в терминале | Единый интерфейс APIYI apiyi.com |
| Работа в терминале, научный код | Sonnet 5.5 | Terra | Средняя | Долгая сессия с одной моделью | То же |
| Многошаговые рабочие процессы агентов | Hydrogen | Terra | Средняя | Начинать с уровня High, при неудаче переходить на XHigh | То же |
| GUI-операции на рабочем столе и в браузере | Sonnet 5.5 | Hydrogen | Низкая | Наблюдение по скриншотам + инструменты управления | То же |
| Чтение графиков и документов | Hydrogen | Terra | Средняя | Без инструментов или с расширенным поиском | То же |
| Массовая повседневная автоматизация | Terra | Hydrogen (Batch) | Высокая | Пакетная асинхронная обработка | То же |
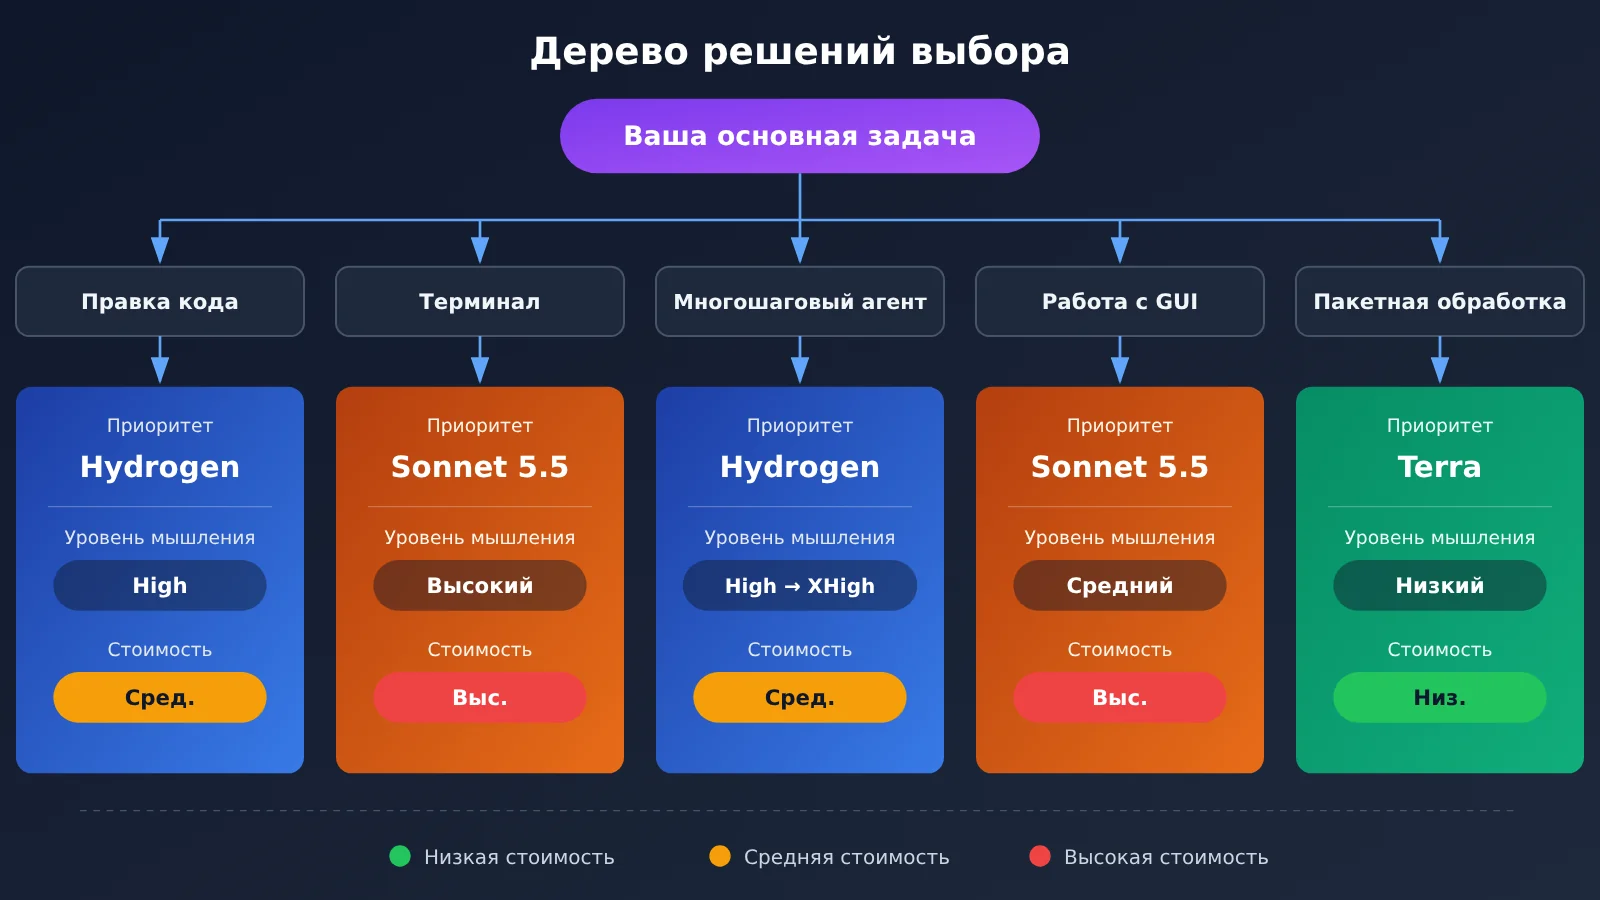
💡 Совет по выбору: если команде нужны одновременно и программирование, и автоматизация GUI, не стоит ставить на одну модель — можно взять подход Google Antigravity Orchestrator и разделить работу по этапам. Через APIYI apiyi.com вы вызываете несколько моделей одним и тем же ключом, а переключение маршрута — это изменение одного параметра.
Часто задаваемые вопросы (FAQ)
Вопрос 1: Что такое Gemini 4 Hydrogen?
Gemini 4 Hydrogen — это высокоэффективная модель, выпущенная Google DeepMind 12 ноября 2026 года. ID модели в API — `gemini-4-hydrogen`, её назначение — повседневное программирование и выполнение задач в Agent-режиме. Модель поддерживает единое контекстное окно на 1 048 576 токенов и предлагает четыре уровня «размышления»: Low, Medium, High и XHigh, по умолчанию — High.
Вопрос 2: Кто сильнее в программировании — Gemini 4 Hydrogen или Claude Sonnet 5.5?
Зависит от типа задачи. Hydrogen заметно лидирует в тестах исправления кода SWE-sweep; Sonnet 5.5 впереди в терминальных тестах вроде Terminal-Bench 4.1 и Terminal-Bench-Science 0.1. Для повседневной правки кода лучше подходит Hydrogen, для инженерии с интенсивной работой в терминале — Sonnet.
Вопрос 3: GPT-6.1 Terra не взяла ни одного первого места — стоит ли её использовать?
Стоит рассмотреть. В сведённой таблице от Google, где сравниваются три модели, у Terra действительно нет ни одного максимального балла. Но в Agents’ Last Exam она близка к Hydrogen, в Chartography занимает второе место, а по стандартному API у неё самая низкая цена. Для сценариев, чувствительных к стоимости и построенных на визуальных операциях и обычной автоматизации, это важный кандидат.
Вопрос 4: Почему у Sonnet 5.5 два результата OSWorld — 80,1% и 83,9%?
80,1% — это результат части тестов, опубликованный самой Anthropic. 83,9% — результат, полученный Google при заданных условиях тестирования с выбором лучшего из нескольких прогонов. Условия тестирования разные, поэтому при сравнении нужно держаться одного источника и не смешивать их.
Вопрос 5: Как быстро сравнить эти три модели через API?
Рекомендую платформу-агрегатор API, поддерживающую несколько моделей:
1. Зайдите на APIYI apiyi.com, зарегистрируйте аккаунт и получите API-ключ;
2. В списке моделей в консоли проверьте доступные ID всех трёх моделей;
3. В коде из этой статьи укажите `base_url` равным `https://api.apiyi.com/v1` и вызовите каждую модель на одном и том же наборе задач.
APIYI предоставляет интерфейс, совместимый с OpenAI, с оплатой по факту использования — так удобно провести горизонтальное сравнение в одном скрипте.
Вопрос 6: Какие известные ограничения есть у Gemini 4 Hydrogen?
Официальная карточка модели указывает: галлюцинации всё ещё возможны; на высоких уровнях «размышления» время и стоимость заметно растут; знания обрезаны мартом 2026 года; показатель необоснованных отказов ухудшился на 5,57 процентного пункта по сравнению с 3.8 Flash; полный отчёт по безопасности на момент проверки ещё не был опубликован. Кроме того, разработчики сообщают о чрезмерном «перевыполнении» в некоторых Agent-задачах. Плюс стандартная цена за токен вдвое выше текущей цены 3.8 Flash — для массовых задач стоит рассмотреть Batch-режим.
Gemini 4 Hydrogen: ключевые выводы из сравнения
- В программировании нет универсального чемпиона: Hydrogen силён в исправлении кодовой базы, Sonnet 5.5 — в задачах выполнения в терминале.
- Hydrogen лидирует в автоматизации агентов: в тестах агентов и автоматизации, перечисленных Google, Hydrogen везде показывает лучший результат.
- В работе с GUI смотрите на Sonnet 5.5: на OSWorld-2.1 Sonnet лидирует с 83,9%, но обратите внимание на разницу в методологии.
- Terra выигрывает за счёт стоимости и визуальных возможностей: самая низкая стандартная цена, при этом понимание графиков и профессиональные задачи агентов у неё на достойном уровне.
- Версии и источники нельзя смешивать: Terminal-Bench 4.0 и 4.1, данные самих производителей и собственные тесты Google нужно рассматривать отдельно.
- Уровень рассуждений влияет очень сильно: Hydrogen High и XHigh различаются по индексу интеллекта всего на 3 балла, но стоимость заметно выше.
- Ориентируйтесь на повторное тестирование на своих задачах: можно через APIYI apiyi.com с одним API-ключом провести горизонтальное сравнение всех трёх моделей.
Итог
Ключевые выводы из сравнения Gemini 4 Hydrogen, GPT-6.1 Terra и Claude Sonnet 5.5:
- Программирование: Hydrogen лидирует в SWE-sweep, Sonnet 5.5 — в двух терминальных тестах, Terra близка к Sonnet в задачах научного кода.
- Агенты: Hydrogen лидирует во всех категориях — многошаговые агенты, автоматизация процессов и долгосрочное моделирование бизнеса, Terra идёт следом в профессиональных задачах.
- Работа с компьютером и мультимодальность: Sonnet 5.5 доминирует в операциях с графическим интерфейсом, Hydrogen немного впереди в мультимодальной работе со знаниями и понимании графиков.
Публичные бенчмарки говорят «кто сильнее при определённом наборе условий», а не «кто лучше подходит для вашего бизнеса». Практичный подход — выбрать одну-две модели-кандидата по матрице выбора выше, а затем провести небольшое повторное тестирование на своих реальных задачах, с фиксированным уровнем рассуждений и тем же набором инструментов.
Рекомендуем быстро проверить результат через APIYI apiyi.com: платформа даёт бесплатный пробный лимит и единый интерфейс для нескольких моделей — удобно для команды, чтобы завершить горизонтальную оценку перед официальным запуском.
📚 Справочные материалы
- Официальный блог Google — Introducing Gemini 4 Hydrogen: анонс выпуска и кейсы партнёров
- Ссылка:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Описание: официальное позиционирование, рамки возможностей и данные ранних тестов
-
Карточка модели Google DeepMind: сводная таблица сравнительных оценок моделей
- Ссылка:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Описание: основной источник количественных данных для этой статьи
-
Google DeepMind, PDF с оценкой модели: подробное описание условий тестирования
- Ссылка:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
Описание: harness, уровни размышления, число прогонов и дополнительные результаты вроде Vending-Bench 2
-
Техническая документация Google Cloud: спецификации Hydrogen и заметки по миграции
- Ссылка:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Описание: ограничения контекста, поведение параметров и нюансы совместимости
-
Страница тарифов Google AI Studio: официальные цены API
- Ссылка:
aistudio.google.com/docs/pricing -
Описание: цены для тарифов Standard, Batch, Flex и Priority
-
OpenAI — Introducing GPT-6.1 Terra: материалы о выпуске Terra
- Ссылка:
openai.com/index/introducing-gpt-6-1-terra/ -
Описание: самостоятельно заявленные результаты Terminal-Bench 4.0 и цены API
-
Anthropic — Introducing Claude Sonnet 5.5: материалы о выпуске Sonnet 5.5
- Ссылка:
anthropic.com/claude-sonnet-5-5 -
Описание: заявленные компанией результаты Terminal-Bench 4.0 и OSWorld 2.1
-
Artificial Analysis — Gemini 4 Hydrogen: независимая оценка четырёх уровней размышления
- Ссылка:
artificialanalysis.ai/models/gemini-4-hydrogen - Описание: значения Intelligence Index v5.0.1 по каждому уровню, время выполнения и затраты
Автор: техническая команда APIYI
Связь по техническим вопросам: пишите нам через главную страницу сайта APIYI; больше материалов по подключению моделей — в документации на docs.apiyi.com