Nota del autor: a partir de las 10 evaluaciones cruzadas de modelos publicadas por Google DeepMind, este artículo analiza las fortalezas y debilidades de Gemini 4 Hydrogen, GPT-6.1 Terra y Claude Sonnet 5.5 en programación, automatización con agentes y operación de computadora, y ofrece recomendaciones para elegir según la tarea.
Resumen en una frase: las evaluaciones cruzadas publicadas por Google muestran que Gemini 4 Hydrogen y Claude Sonnet 5.5 tienen ventajas en distintas tareas de programación y agentes, mientras que GPT-6.1 Terra se distingue por su enfoque en costo y operación visual; la elección real debería combinar las condiciones de prueba, el tipo de tarea y el costo.
Para situarte: 5 términos que conviene conocer antes de leer
- Harness: marco de pruebas que organiza la entrada del modelo, la ejecución de herramientas y la puntuación de tareas. Un mismo modelo, con otro Harness, puede arrojar resultados claramente distintos.
- Versión del benchmark: versión de los datos, tareas y reglas de una evaluación. Por ejemplo, Terminal-Bench 4.0 y 4.1 son versiones distintas, así que sus resultados deben interpretarse por separado.
- Agente: sistema que, combinando el modelo con un entorno de ejecución de herramientas, completa tareas de varios pasos; el resultado refleja el desempeño conjunto de «modelo + cadena de herramientas».
- Token: unidad de medida de la información que procesa el modelo, como texto. El precio de la API normalmente se calcula por millón de tokens.
- API: interfaz que permite a los programas llamar a un servicio; los desarrolladores la usan para conectar el modelo con sus aplicaciones o agentes.
El 12 de noviembre de 2026, Google presentó oficialmente Gemini 4 Hydrogen y, en la ficha técnica oficial del modelo, lo situó en la misma tabla de evaluación que GPT-6.1 Terra y Claude Sonnet 5.5. Esta tabla abarca programación, automatización con agentes, operación de computadora y trabajo de conocimiento multimodal; hoy es el conjunto más concentrado de datos comparativos públicos sobre los tres modelos.
No se trata de un análisis conciliador del tipo «todos tienen algo bueno». Desglosaremos prueba por prueba qué mide cada test y bajo qué condiciones se obtuvo, y después daremos conclusiones por separado para programación, agentes y operación de computadora, hasta cerrar con una matriz de selección lista para aplicar.
Valor clave: al terminar, tendrás claro en qué tareas Gemini 4 Hydrogen lidera, en cuáles queda por debajo de Sonnet 5.5 y en qué punto del flujo de trabajo del equipo encaja mejor Terra.
Por qué comparar Gemini 4 Hydrogen con Terra y Sonnet 5.5
Los tres modelos se lanzaron con menos de dos meses de diferencia y sus posicionamientos se solapan bastante: ninguno es el modelo insignia de razonamiento más pesado de su fabricante, sino que están orientados a desarrolladores, ejecución de agentes y tareas profesionales de alta frecuencia; son los “modelos principales para el trabajo diario”. Para los equipos que necesitan hacer un gran volumen de invocaciones todos los días, son precisamente la capa que determina de verdad el costo y la eficiencia.
Gemini 4 Hydrogen es el nuevo modelo de alta eficiencia de Google DeepMind, posicionado oficialmente para programación cotidiana y ejecución de agentes de IA. Puede funcionar de forma independiente y también actuar como ejecutor o verificador en sistemas multimodelo. GPT-6.1 Terra fue lanzado por OpenAI el 26 de octubre de 2026 y se centra en razonamiento visual, operación de computadoras y trabajo diario de alta eficiencia. Claude Sonnet 5.5 fue lanzado por Anthropic el 28 de septiembre de 2026, y destaca oficialmente la programación cotidiana, la corrección de bugs, la creación de documentos profesionales y el diseño de interfaces complejas.
| Modelo | Fabricante | Fecha de lanzamiento | Posicionamiento oficial | Precio estándar de API (por millón de tokens, entrada/salida) | Fuente del precio |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | Programación cotidiana, invocación de múltiples herramientas, ejecución de agentes | $1.50 / $7.50 | Página de precios de Google AI Studio, verificada el 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | Razonamiento visual, operación de computadoras, trabajo diario | $1 / $5 | Material de lanzamiento de OpenAI, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | Programación cotidiana, corrección de bugs, documentos profesionales, diseño de interfaces | No cubierto en los materiales de referencia; consultar la página de precios oficial | Sitio oficial de Anthropic |
Cabe señalar que los tokens de pensamiento de Hydrogen se incluyen en el precio de salida, por lo que el costo real no puede estimarse solo a partir del texto final visible. Además, los precios de los modos Batch y Flex de Hydrogen son $0.75 / $3.75, adecuados para tareas por lotes sin conexión.
La comparación cuantitativa de este artículo se basa principalmente en la ficha del modelo de Google DeepMind de noviembre de 2026 y los documentos metodológicos de evaluación que la acompañan. Esto implica que Google consolidó los datos y que algunos resultados de modelos competidores provienen de informes públicos de los fabricantes o de rankings; abordaremos específicamente en la quinta sección cómo esto afecta las conclusiones.
Comparación de capacidades de programación de Gemini 4 Hydrogen: ¿quién es mejor para corregir problemas reales?
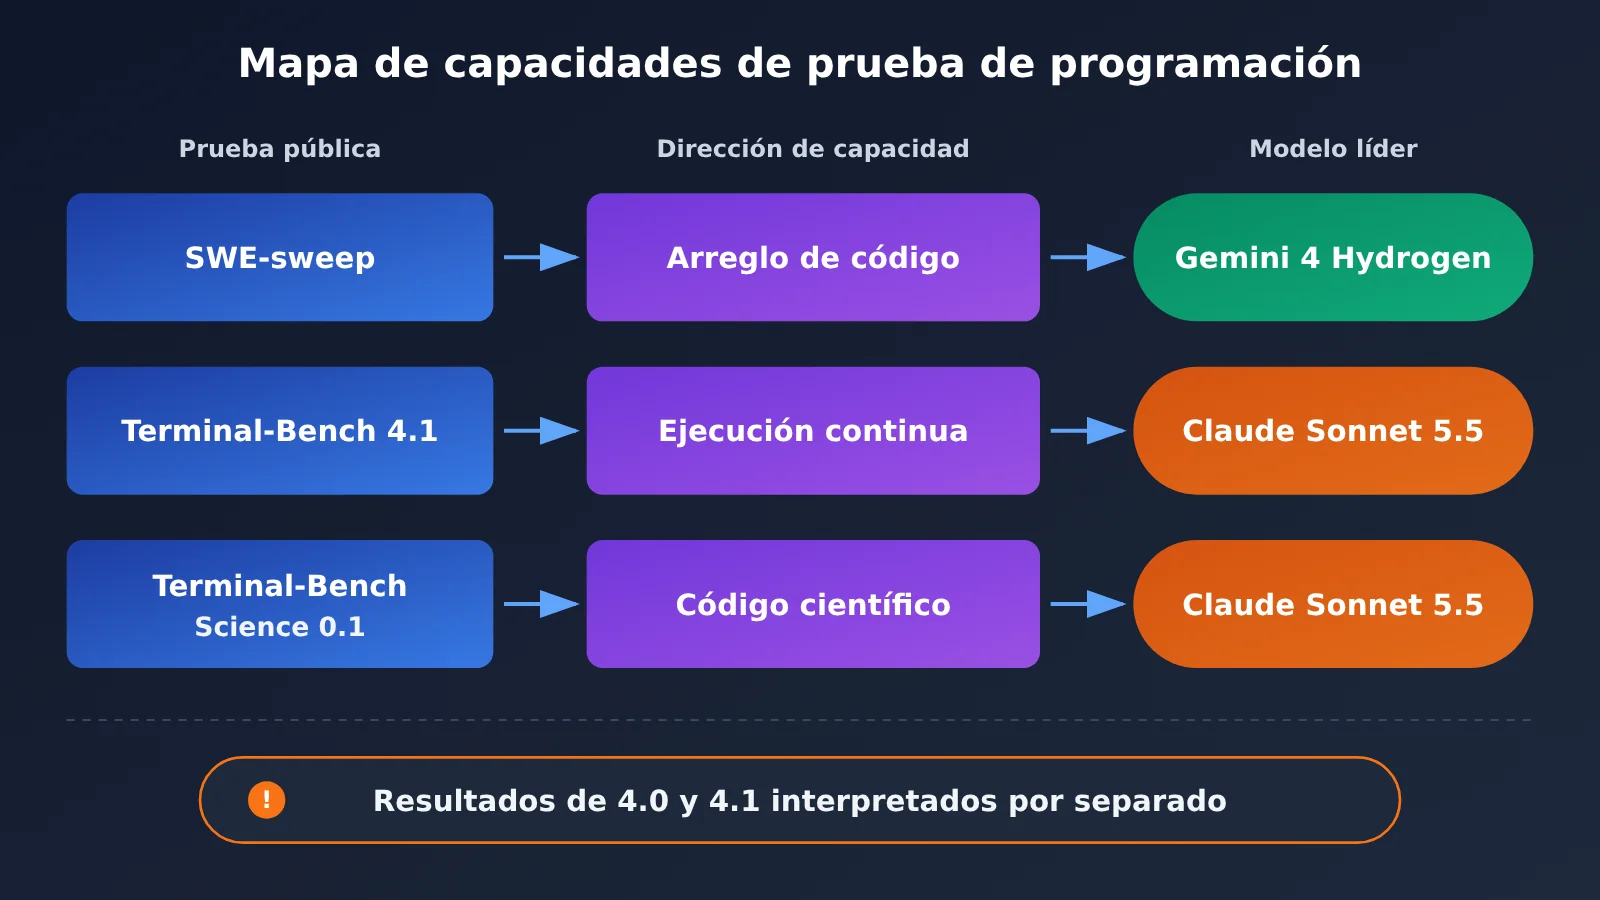
Las pruebas de programación pueden dividirse en dos capacidades: una es encontrar y corregir problemas en bases de código reales; la otra es ejecutar comandos de forma continua en un entorno de terminal y completar tareas de ingeniería. SWE-sweep se inclina hacia la primera, la serie Terminal-Bench hacia la segunda, y Terminal-Bench-Science evalúa la capacidad de realizar tareas de investigación científica mediante código.
| Evaluación (versión) | Métrica | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Líder |
|---|---|---|---|---|---|
| SWE-sweep | Recompensa ponderada por subtareas | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 | Recompensa promedio | 57.0% | 63.9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | Puntuación de la tarea | 51.4% | 59.9% | 58.3% | Sonnet |
Fuente: Google DeepMind, «Gemini 4 Hydrogen Model Evaluation» y la model card, noviembre de 2026.
Interpretación de los resultados de las pruebas de programación
Los puntajes absolutos de SWE-sweep son, en general, bajos, lo que indica que se trata de una prueba muy difícil. El 13.5% de Hydrogen es más del doble que Terra y más del cuádruple que Sonnet; en esta prueba, la diferencia es la más marcada. Sin embargo, Hydrogen se ejecutó con Antigravity-CLI 1.4.8, la herramienta propia de Google; las condiciones de ejecución de los competidores no son necesariamente las mismas, así que parte de la diferencia podría deberse a la adaptación del harness.
En Terminal-Bench 4.1, Sonnet 5.5 lidera con 63.9% frente al 57.0% de Hydrogen; Terra no tiene resultado en esta prueba en la tabla de Google. En esta prueba, Hydrogen usó mini-swe-agent vision Harness y el nivel de razonamiento High; cada tarea se ejecutó 5 veces y se promedió la recompensa. En Terminal-Bench-Science 0.1, Sonnet sigue liderando, Terra le sigue de cerca con 58.3% y Hydrogen, en cambio, queda en tercer lugar.
Conclusión en programación: Hydrogen tiene una ventaja clara en pruebas de corrección de problemas en bases de código como SWE-sweep; Sonnet 5.5 es más sólido en tareas de ejecución en terminal; Terra se acerca a Sonnet en tareas de código científico. Ningún modelo lidera en todas las pruebas de programación.
Datos de referencia de Terminal-Bench 4.0 publicados por los fabricantes
OpenAI y Anthropic han publicado cada uno sus resultados en Terminal-Bench 4.0. Como 4.0 y 4.1 son versiones distintas del benchmark, la siguiente tabla se presenta por separado; sus resultados no deben mezclarse ni compararse con los de 4.1 de la tabla anterior.
| Evaluación (versión) | Modelo | Resultado | Condiciones de prueba | Fuente |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | Autoevaluación del fabricante | Material publicado por Anthropic, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | Configuración de razonamiento máximo | Material publicado por OpenAI, 2026-10-26 |
El valor de estos datos es que sirven de referencia: en las condiciones de prueba de cada fabricante, la capacidad de Sonnet 5.5 en tareas de terminal es claramente superior a la de Terra, lo que coincide con la tendencia que muestra la tabla de Google, donde Sonnet lidera en las pruebas de terminal.
¿Puede Gemini 4 Hydrogen llevar a cabo un trabajo completo en agentes y pruebas automatizadas?
La principal diferencia entre las pruebas de agentes y las preguntas y respuestas de un solo turno radica en que el modelo debe planificar sus propios pasos, invocar herramientas de manera continua, ajustar su estrategia después de un fallo y, al final, verificar los resultados. Este tipo de pruebas se acerca más a los flujos de trabajo automatizados reales y también pone más a prueba la “disciplina de ejecución” del modelo.
La siguiente tabla resume todos los resultados comparativos entre modelos de las evaluaciones de Google sobre automatización de agentes, operación de computadoras y trabajo de conocimiento multimodal; las secciones tercera y cuarta comparten esta tabla.
| Evaluación (versión) | Área de capacidad | Métrica | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | Agente profesional de múltiples pasos | Puntuación de tarea | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | Automatización de flujos de trabajo | Puntuación de tarea | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | Simulación de negocio a largo plazo | Saldo final de fondos | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | Operación de computadora/interfaz gráfica | Tasa de éxito de tareas | 77.6% | 83.9% | 74.2% |
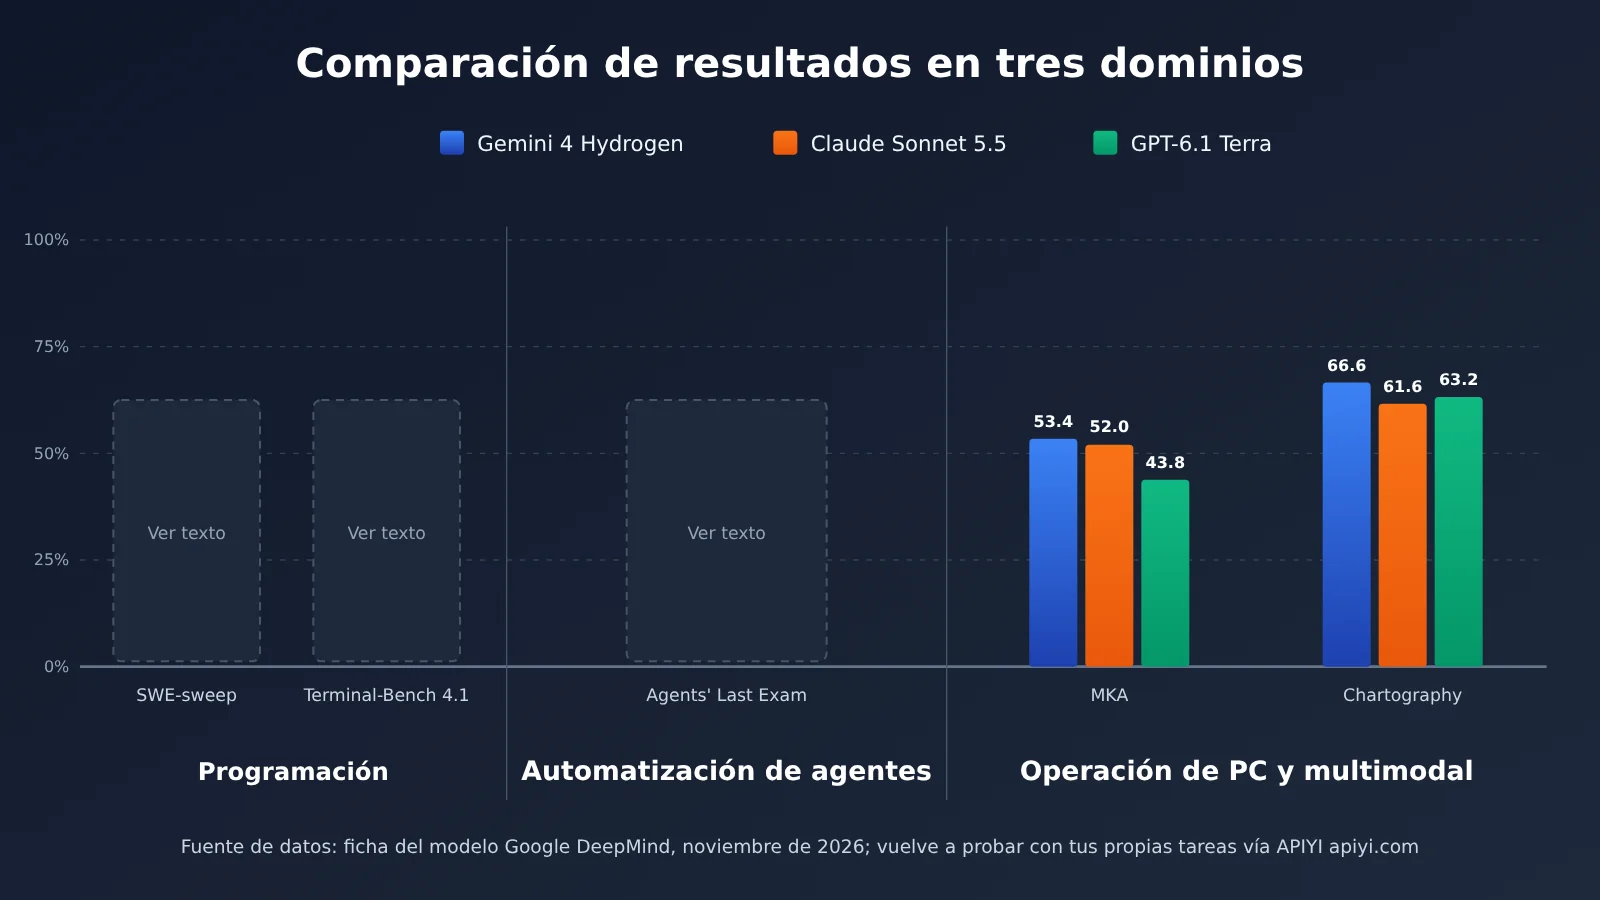
| MKA | Trabajo de conocimiento multimodal | Puntuación de tarea | 53.4% | 52.0% | 43.8% |
| Chartography | Comprensión de gráficos (sin herramientas) | Precisión | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | Razonamiento de conocimiento de alta dificultad | Precisión | 58.8% | 53.3% | 47.3% |
Fuente: ficha del modelo de Google DeepMind y «Gemini 4 Hydrogen Model Evaluation», noviembre de 2026.
Interpretación de los resultados de agentes y automatización
Agents’ Last Exam v1.1 incluye 122 tareas y una ventana temporal de 5 horas; Hydrogen también se ejecuta con Antigravity-CLI 1.4.8. Hydrogen lidera con 71.6%, pero llama la atención que Terra le sigue de cerca con 69.8%, superando a Sonnet por casi 10 puntos porcentuales. Esto muestra que Terra no es débil en tareas profesionales de múltiples pasos.
El panorama de AutomationBench-AA es diferente: Hydrogen 76.1%, Sonnet 71.8%, y Terra 60.2%, claramente por detrás. Si tu negocio consiste en automatizar muchos flujos entre sistemas, esta diferencia merece atención.
Vending-Bench 2 es una tarea de simulación de negocio a largo plazo, y la métrica es el saldo final de fondos, no la precisión. Hydrogen lidera con bastante ventaja con $14,549, lo que puede servir como observación complementaria de la “estabilidad de decisiones a largo plazo”, pero es un único entorno de simulación y no conviene extrapolarlo directamente a todas las tareas de larga duración.
Conclusión en el ámbito de agentes: en las pruebas de agentes y automatización enumeradas por Google, Hydrogen lidera en todas; Terra se acerca a Hydrogen en tareas profesionales de múltiples pasos, pero queda atrás en automatización de flujos; Sonnet se sitúa en una posición intermedia.
🚀 Inicio rápido: los resultados de los agentes dependen en gran medida del harness y de la definición de herramientas; las puntuaciones públicas solo pueden servir como punto de partida. Se recomienda usar APIYI apiyi.com para ejecutar los tres modelos por separado con el mismo conjunto de herramientas y el mismo lote de tareas reales; con una sola clave API se puede cambiar entre ellos, lo que facilita obtener datos comparativos adaptados a tu propio escenario.
Gemini 4 Hydrogen vs Sonnet 5.5: ¿quién es mejor en operación de computadoras y trabajo de conocimiento multimodal?
Las pruebas de operación de computadoras exigen que el modelo «vea la pantalla, haga clic con el mouse y escriba con el teclado», lo que se corresponde directamente con escenarios como la operación de navegadores y la automatización de suites ofimáticas. El trabajo de conocimiento multimodal, en cambio, evalúa la lectura de archivos complejos y la comprensión de gráficos, y se traduce en tareas como el análisis de informes financieros y la organización de estudios de investigación.
OSWorld-2.1: Sonnet 5.5 lidera en operación de interfaces gráficas
En la evaluación de Google, OSWorld 2.1 utiliza 82 tareas offline, resolución 1080p y hasta 500 pasos; el modelo observa mediante capturas de pantalla y ejecuta las acciones a través de PyAutoGUI. Sonnet 5.5 lidera con 83.9%, Hydrogen alcanza 77.6% y Terra 74.2%.
Aquí hay un problema de criterio de medición que conviene señalar: Anthropic publica por su cuenta una puntuación de 80.1% para Sonnet 5.5 en parte de las pruebas de OSWorld 2.1, mientras que la tabla comparativa de Google usa 83.9%, cifra que Google obtuvo al evaluar bajo condiciones específicas y quedarse con el mejor resultado entre varias ejecuciones. Es decir, una prueba del mismo nombre puede arrojar puntuaciones distintas según qué fabricante la ejecuta, así que al comparar hay que fijar una única fuente.
MKA y Chartography: Hydrogen aventaja por poco
En MKA, que mide trabajo de conocimiento multimodal, Hydrogen (53.4%) y Sonnet (52.0%) están muy cerca, mientras que Terra (43.8%) queda unos 10 puntos porcentuales por detrás. Chartography evalúa la comprensión de gráficos sin usar herramientas: Hydrogen lidera con 66.6% y, curiosamente, Terra queda segunda con 63.2%, por encima del 61.6% de Sonnet, lo que encaja con el posicionamiento de OpenAI para Terra como modelo de «razonamiento visual».
Conclusión sobre operación de computadoras y multimodalidad: para la operación de interfaces gráficas, Sonnet 5.5 es la primera opción; en lectura de archivos complejos e integración de conocimiento multimodal, Hydrogen y Sonnet están parejos, con Hydrogen ligeramente por delante; en comprensión de gráficos pura, Hydrogen lidera y Terra también resulta competitivo.
Cómo leer correctamente los datos públicos de evaluación de Gemini 4 Hydrogen
El error más común al interpretar una evaluación pública es tomar una tabla como si fuera un boletín de calificaciones de «mismo examen y mismas reglas». En realidad, el documento de metodología de evaluación de Google deja claros varios puntos clave:
- Nivel de pensamiento: Hydrogen normalmente se prueba con el ajuste de pensamiento más alto, pero algunos proyectos tienen reglas distintas; por ejemplo, Terminal-Bench 4.1 usa el nivel High.
- Harness de ejecución: SWE-sweep y Agents’ Last Exam usan Antigravity-CLI 1.4.8; Terminal-Bench 4.1 usa el Harness de visión mini-swe-agent; OSWorld 2.1 usa capturas de pantalla más PyAutoGUI.
- Número de ejecuciones: Terminal-Bench 4.1 ejecuta cada tarea 5 veces y promedia la recompensa, mientras que las puntuaciones de competidores en OSWorld tomaron el mejor resultado de varias ejecuciones. Son dos formas de estadística que, de por sí, ya son diferentes.
- Origen de las puntuaciones: los resultados de los competidores provienen principalmente de informes públicos de cada fabricante y de rankings, y no todos los modelos fueron ejecutados por el mismo equipo bajo un criterio unificado.
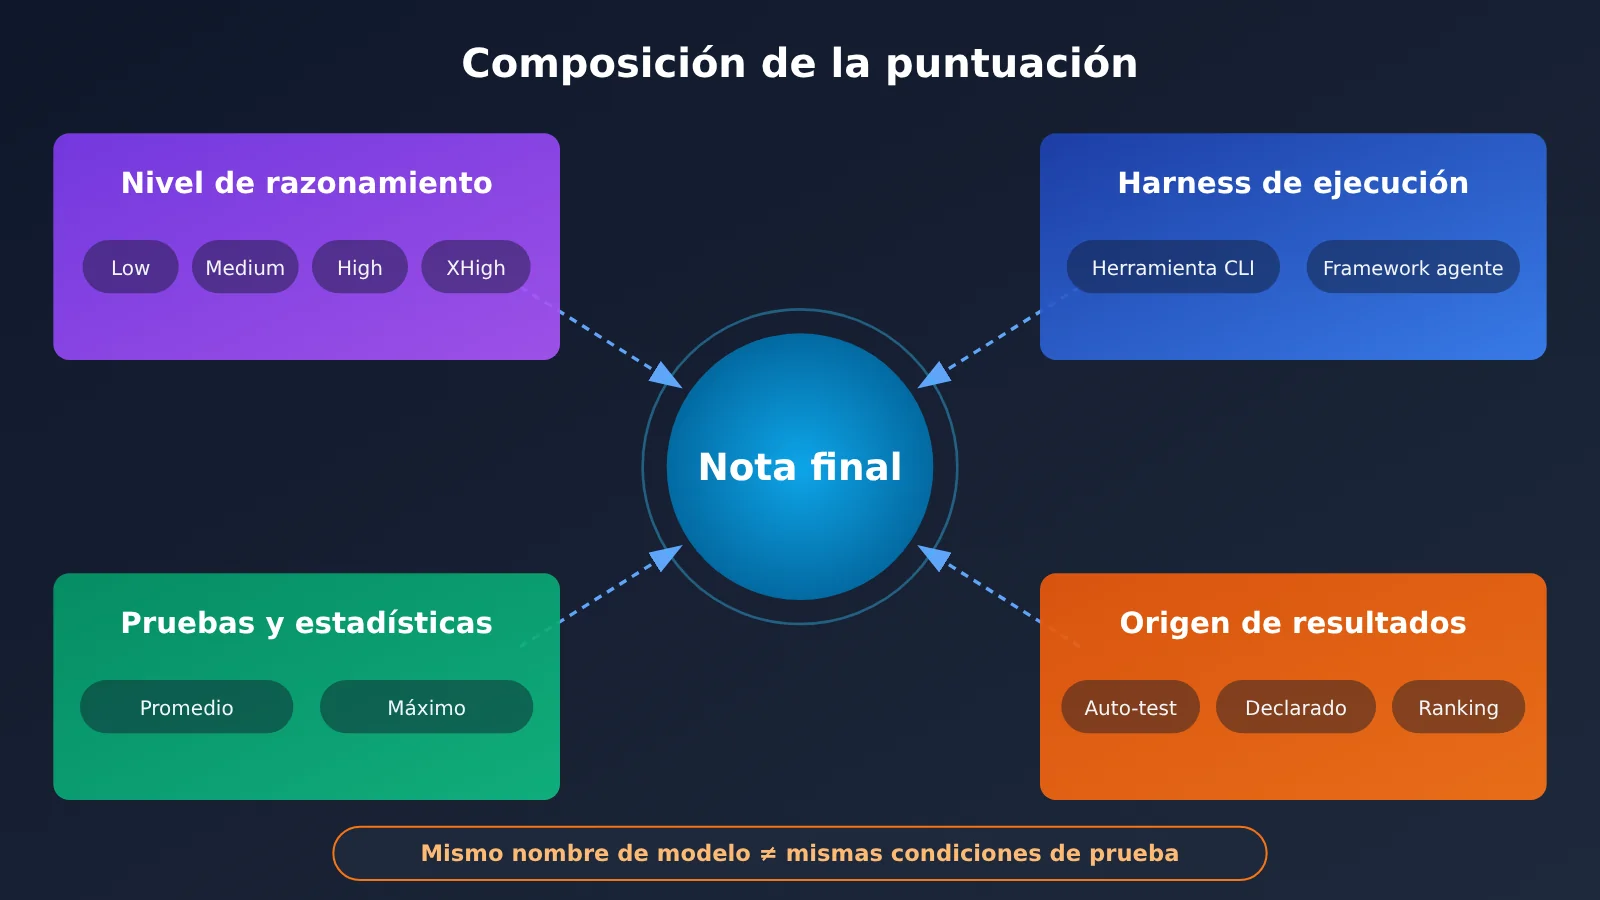
El impacto del nivel de pensamiento es especialmente grande. Artificial Analysis realizó el 12 de noviembre una evaluación independiente de los cuatro niveles de Hydrogen: el índice de inteligencia fue 27 en Low, 41 en Medium, 51 en High (predeterminado) y 54 en XHigh; el coste medio correspondiente de las tareas estandarizadas de evaluación iba de 0,29 a 3,16 dólares. Son resultados de sus tareas de referencia, no el coste real que paga un usuario común en cada llamada, pero bastan para mostrar que un mismo modelo cambia muchísimo según el nivel: XHigh solo saca 3 puntos más que High, pero el coste sube de forma evidente.
Por eso, al leer las puntuaciones de este artículo, conviene recordar dos cosas: primera, las conclusiones se refieren únicamente a las pruebas públicas aquí listadas; segunda, no hay que combinar los datos más favorables de la tabla de Google, del autoinforme de OpenAI y del autoinforme de Anthropic para fabricar un «ranking general».
Inicio rápido con Gemini 4 Hydrogen: comparar tres modelos con el mismo código
La forma más fiable de elegir un modelo es poner a prueba los tres con tus propias tareas. En el ejemplo siguiente usamos la interfaz compatible con OpenAI; solo tienes que cambiar el parámetro model para alternar entre un modelo y otro.
Ejemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Ver el código completo: script para comparar los tres modelos con la misma tarea
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Los ID de modelo deben coincidir con la lista de modelos de la plataforma; gemini-4-hydrogen es el ID oficial de Google
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # ID de ejemplo, confírmalo en la consola
    "claude-sonnet-5.5",   # ID de ejemplo, confírmalo en la consola
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Al migrar a Hydrogen hay varios puntos que conviene tener en cuenta: los valores personalizados de temperature, top_p y top_k se ignoran; thinking_budget y MINIMAL no son compatibles; el nivel de pensamiento predeterminado es High; las llamadas a herramientas de varios turnos deben devolver correctamente las thought signatures. Si tu agente dependía de temperaturas bajas para controlar la salida, tendrás que usar salidas estructuradas o instrucciones más explícitas para acotarla.
Recomendación: empieza usando 10-20 tickets o tareas reales como conjunto de evaluación, invoca los tres modelos por separado en APIYI apiyi.com y registra la tasa de éxito, el tiempo y el número de tokens de salida. Los usuarios nuevos disponen de crédito de prueba gratuito, así que puedes hacer una validación a pequeña escala antes de la compra definitiva.
Gemini 4 Hydrogen, Terra y Sonnet 5.5: recomendaciones por escenario y matriz de selección
Cuándo elegir Gemini 4 Hydrogen
- Corrección de problemas en bases de código y actualización de dependencias: es donde la ventaja en SWE-sweep es mayor, y el equipo oficial mejoró especialmente la edición precisa.
- Agentes de varios pasos y automatización de flujos: lidera en Agents’ Last Exam, AutomationBench-AA y Vending-Bench 2.
- Análisis de documentos y gráficos complejos: lidera en MKA y Chartography, además de admitir entradas en PDF, documentos de Office y otros formatos.
Cuándo elegir Claude Sonnet 5.5
- Tareas de ingeniería intensivas en terminal: lidera tanto en Terminal-Bench 4.1 como en Terminal-Bench-Science 0.1.
- Operación de escritorio e interfaces gráficas: OSWorld-2.1 es el valor más alto de la tabla de Google.
- Documentos profesionales y diseño de interfaces: la dirección que Anthropic destaca oficialmente.
Cuándo elegir GPT-6.1 Terra
- Tareas de gran volumen sensibles al costo: precio estándar de $1 / $5, el más bajo entre los tres precios conocidos.
- Razonamiento visual y automatización cotidiana: Chartography en segundo lugar, y Agents’ Last Exam cerca de Hydrogen.
| Tipo de tarea | Primera opción | Alternativa | Sensibilidad al costo | Enfoque de ejecución recomendado | Canal de acceso |
|---|---|---|---|---|---|
| Mantenimiento de bases de código, corrección de bugs | Hydrogen | Sonnet 5.5 | Media | Hydrogen modifica el código, Sonnet hace la verificación en terminal | Interfaz unificada de APIYI apiyi.com |
| Operaciones de terminal, código de investigación | Sonnet 5.5 | Terra | Media | Sesión larga con un solo modelo | Íbidem |
| Flujos de trabajo con agentes de varios pasos | Hydrogen | Terra | Media | Empezar con el nivel High y subir a XHigh si falla | Íbidem |
| Operación de GUI de escritorio/navegador | Sonnet 5.5 | Hydrogen | Baja | Observación mediante capturas + herramientas de operación | Íbidem |
| Lectura de gráficos y documentos | Hydrogen | Terra | Media | Sin herramientas o con recuperación aumentada | Íbidem |
| Automatización cotidiana de gran volumen | Terra | Hydrogen (Batch) | Alta | Procesamiento asíncrono por lotes | Íbidem |
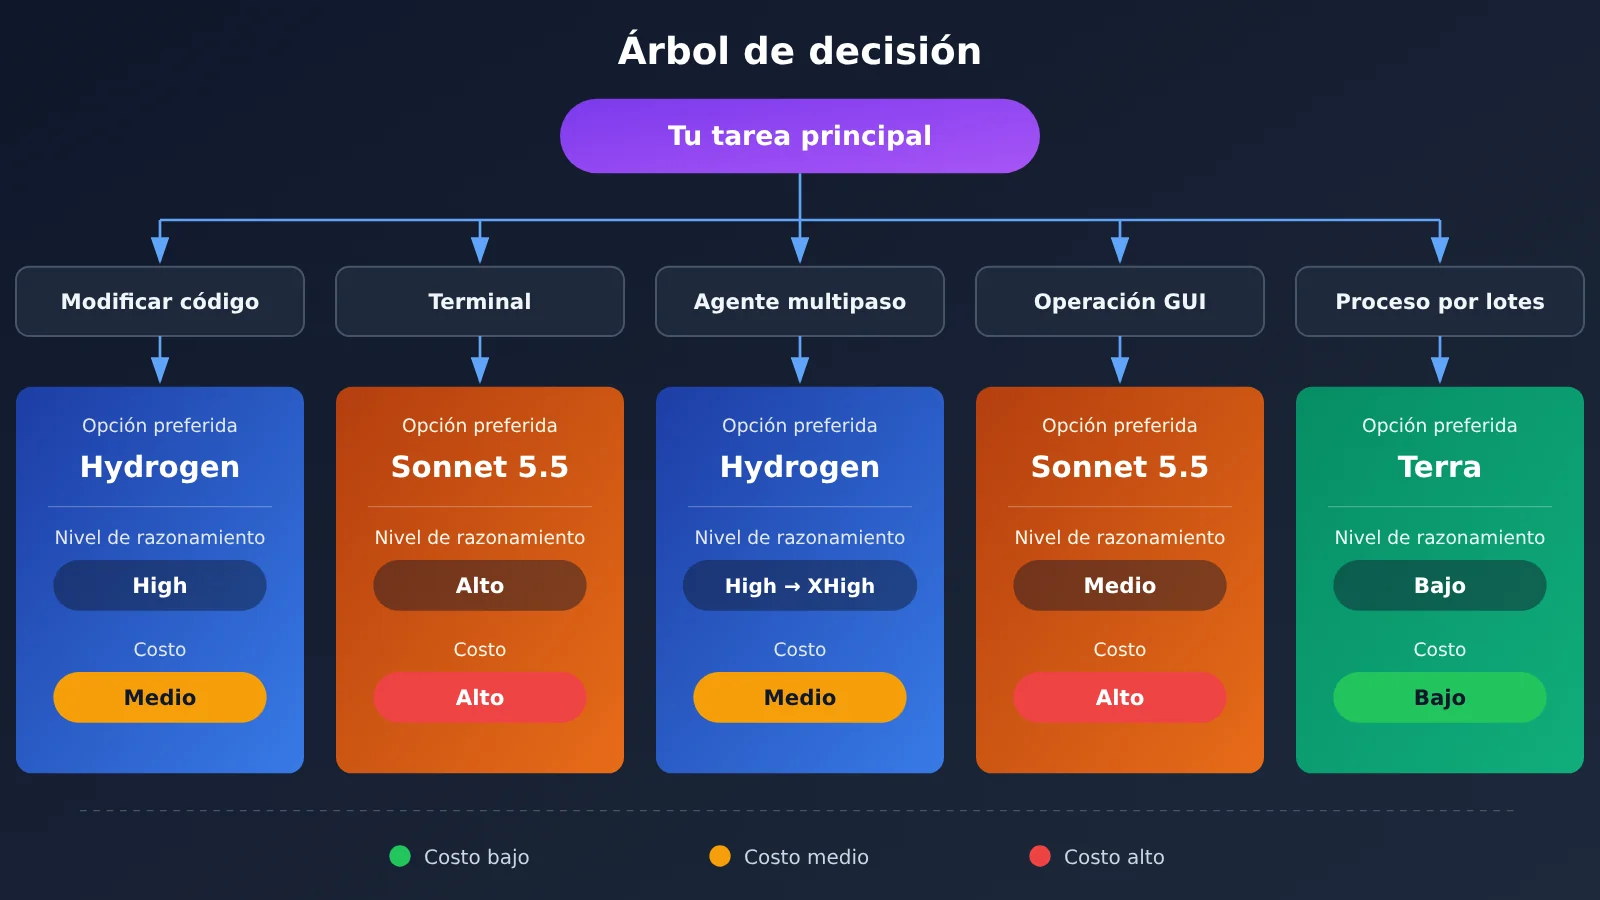
💡 Recomendación de selección: si el equipo tiene a la vez necesidades de programación y de automatización de GUI, no hace falta apostar todo a un solo modelo; puedes inspirarte en la idea de Google Antigravity Orchestrator y repartir el trabajo por etapas. Con APIYI apiyi.com puedes invocar varios modelos usando la misma clave, y para cambiar de ruta solo hay que modificar un parámetro.
Preguntas frecuentes (FAQ)
P1: ¿Qué es Gemini 4 Hydrogen?
Gemini 4 Hydrogen es un modelo de alta eficiencia lanzado por Google DeepMind el 12 de noviembre de 2026, con ID de modelo de API `gemini-4-hydrogen`, orientado a programación cotidiana y ejecución de agentes. Admite una ventana de contexto unificada de 1.048.576 tokens, ofrece cuatro niveles de pensamiento (Low, Medium, High y XHigh) y usa High por defecto.
P2: ¿Quién programa mejor, Gemini 4 Hydrogen o Claude Sonnet 5.5?
Depende del tipo de tarea. Hydrogen va bastante por delante en las pruebas de reparación de código en repositorios de SWE-sweep; Sonnet 5.5 lidera en pruebas de ejecución en terminal como Terminal-Bench 4.1 y Terminal-Bench-Science 0.1. Para cambios de código del día a día conviene Hydrogen; para ingeniería intensiva en terminal conviene Sonnet.
P3: GPT-6.1 Terra no quedó primero en nada, ¿aun así vale la pena usarlo?
Vale la pena tenerlo en cuenta. En los resultados de tres modelos que Google presentó en una misma tabla, es cierto que Terra no logró la puntuación más alta en ninguna categoría, pero quedó cerca de Hydrogen en Agents’ Last Exam, segundo en Chartography, y además tiene el precio de API estándar más bajo. Para escenarios sensibles al costo y centrados en operaciones visuales y automatización convencional, es un candidato importante.
P4: ¿Por qué Sonnet 5.5 tiene dos versiones de resultados en OSWorld, 80,1% y 83,9%?
El 80,1% corresponde a resultados parciales de pruebas publicados por Anthropic, mientras que el 83,9% proviene de pruebas realizadas por Google bajo condiciones específicas y tomando el mejor resultado de varias ejecuciones. Las condiciones de prueba son distintas, así que al comparar hay que ceñirse a una sola fuente y no mezclarlas.
P5: ¿Cómo comparar rápidamente estos tres modelos a través de la API?
Se recomienda usar una plataforma agregadora de API que soporte múltiples modelos:
1. Entra a APIYI apiyi.com, regístrate y obtén tu API Key;
2. En la lista de modelos de la consola, confirma los ID disponibles de los tres modelos;
3. Configura el `base_url` del código de este artículo como `https://api.apiyi.com/v1` y llama a cada modelo con el mismo lote de tareas.
APIYI ofrece una interfaz compatible con OpenAI y facturación por consumo, lo que facilita hacer una comparación horizontal dentro de un mismo script.
P6: ¿Qué limitaciones conocidas tiene Gemini 4 Hydrogen?
La tarjeta oficial del modelo señala que: todavía puede alucinar; los niveles altos de pensamiento elevan notablemente el tiempo de ejecución y el costo; el conocimiento tiene fecha de corte en marzo de 2026; el indicador de rechazos injustificados empeoró 5,57 puntos porcentuales respecto a 3.8 Flash; y el informe de seguridad completo aún no se había publicado al momento de la verificación. Además, algunos desarrolladores reportan ejecución excesiva en ciertas tareas de agentes. Por si fuera poco, su precio estándar por token es el doble del precio actual de 3.8 Flash, así que para tareas por lotes conviene considerar el modo Batch.
Gemini 4 Hydrogen: puntos clave de la comparación
- En programación no hay un campeón absoluto: Hydrogen destaca en la reparación de bases de código; Sonnet 5.5, en tareas de ejecución en terminal.
- Hydrogen lidera en automatización de agentes: en las pruebas de agentes y automatización enumeradas por Google, Hydrogen obtiene los valores más altos en todas.
- Para operar GUI, Sonnet 5.5: en OSWorld-2.1, Sonnet lidera con 83.9%; ojo con las diferencias en los criterios de medición.
- Terra gana en costo y visión: tiene el precio estándar más bajo y no se queda atrás en comprensión de gráficos ni en tareas profesionales de agentes.
- No mezcles versiones ni fuentes: Terminal-Bench 4.0 y 4.1, así como los datos autodeclarados por el fabricante y las mediciones propias de Google, deben separarse.
- El nivel de razonamiento influye muchísimo: entre Hydrogen High y XHigh, el índice de inteligencia solo difiere en 3 puntos, pero el costo sube de forma notable.
- Toma como referencia tus propias pruebas con tus tareas: puedes probar comparativamente los tres modelos con una sola clave en APIYI apiyi.com.
Resumen
Puntos clave de la comparación entre Gemini 4 Hydrogen, GPT-6.1 Terra y Claude Sonnet 5.5:
- Programación: Hydrogen lidera en SWE-sweep; Sonnet 5.5 lidera en dos pruebas de terminal; Terra se acerca a Sonnet en tareas de código para investigación.
- Agentes: Hydrogen lidera en agentes de múltiples pasos, automatización de flujos de trabajo y simulaciones de gestión de larga duración; Terra queda justo detrás en tareas especializadas.
- Uso de computadora y multimodalidad: Sonnet 5.5 domina la operación de interfaces gráficas; Hydrogen lidera ligeramente en trabajo de conocimiento multimodal y comprensión de gráficos.
Las evaluaciones públicas te dicen «quién es más fuerte bajo ciertas condiciones», no «quién encaja mejor en tu negocio». Lo más práctico es delimitar uno o dos candidatos con la matriz de selección anterior y luego hacer una reevaluación a pequeña escala con tus tareas reales, un nivel de razonamiento fijo y tu propia cadena de herramientas.
Se recomienda validar rápidamente los resultados a través de APIYI apiyi.com; la plataforma ofrece crédito de prueba gratuito y una interfaz unificada para varios modelos, ideal para que los equipos completen una evaluación comparativa antes del lanzamiento oficial.
📚 Referencias
- Blog oficial de Google – Introducing Gemini 4 Hydrogen: anuncio de lanzamiento y casos de socios
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Descripción: posicionamiento oficial, alcance de capacidades y datos de las pruebas iniciales
-
Ficha del modelo de Google DeepMind: tabla comparativa de evaluación entre modelos
- Enlace:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Descripción: principal fuente de datos cuantitativos de este artículo
-
PDF de evaluación del modelo de Google DeepMind: detalle de las condiciones de ejecución de las pruebas
- Enlace:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
Descripción: Harness, niveles de razonamiento, número de ejecuciones y resultados complementarios como Vending-Bench 2
-
Documentación técnica de Google Cloud: especificaciones de Hydrogen e instrucciones de migración
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Descripción: límites de contexto, comportamiento de los parámetros y notas de compatibilidad
-
Página de precios de Google AI Studio: precios oficiales de la API
- Enlace:
aistudio.google.com/docs/pricing -
Descripción: precios de cada modo: Standard, Batch, Flex y Priority
-
OpenAI – Introducing GPT-6.1 Terra: material de lanzamiento de Terra
- Enlace:
openai.com/index/introducing-gpt-6-1-terra/ -
Descripción: resultados autodeclarados de Terminal-Bench 4.0 y precios de la API
-
Anthropic – Introducing Claude Sonnet 5.5: material de lanzamiento de Sonnet 5.5
- Enlace:
anthropic.com/claude-sonnet-5-5 -
Descripción: resultados autodeclarados de Terminal-Bench 4.0 y OSWorld 2.1
-
Artificial Analysis – Gemini 4 Hydrogen: evaluación independiente de los cuatro niveles de razonamiento
- Enlace:
artificialanalysis.ai/models/gemini-4-hydrogen - Descripción: índice Intelligence Index v5.0.1 para cada nivel, tiempo de ejecución y coste
Autor: equipo técnico de APIYI
Contacto técnico: Puedes contactarnos en la página principal del sitio de APIYI; para más información sobre la integración de modelos, visita el centro de documentación docs.apiyi.com