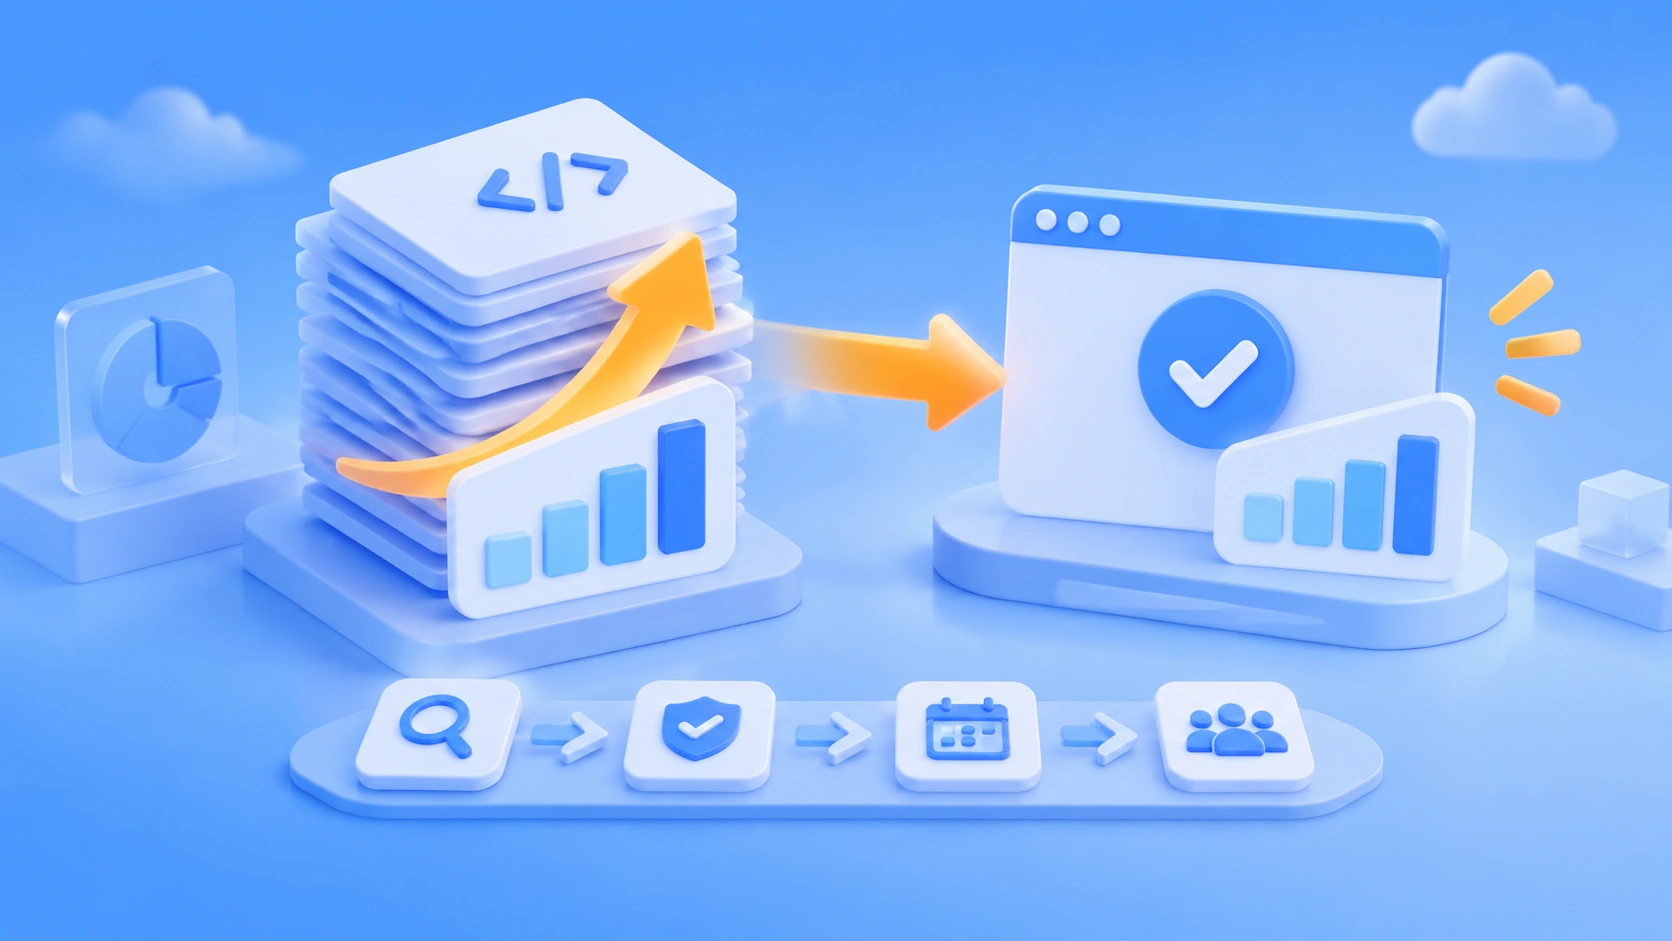
Note de l’auteur : les agents IA font grimper le nombre de lignes de code de 30 %, mais les tickets livrés n’augmentent que de 12 %. Cet article s’appuie sur des données de recherche pour identifier le goulot d’étranglement et propose des étapes concrètes que les équipes peuvent appliquer directement pour gagner en efficacité.
Beaucoup d’équipes constatent qu’après avoir adopté des agents IA, les commits se multiplient, les demandes de fusion aussi, mais les fonctionnalités ne sont pas livrées beaucoup plus vite. Une étude récente de l’université Harvard, menée via la plateforme Jellyfish auprès de 718 entreprises, apporte une conclusion chiffrée : le volume de code augmente de 30 %, mais la livraison n’augmente que de 12 % ; l’écart est principalement absorbé par les étapes en aval, comme la revue de code.
Ce n’est pas un énième article pessimiste sur le codage assisté par IA. La conclusion de l’étude est claire : les agents IA apportent bel et bien une hausse de production ; le problème, c’est que tout le pipeline de livraison n’a pas été dimensionné pour suivre. Cet article décortique d’abord les données, puis propose une méthode en 5 étapes, de la mesure à la refonte des processus.
L’essentiel : à la lecture de cet article, vous saurez identifier l’étape où le gain de productivité du codage assisté par IA coince dans votre équipe, par quoi commencer et comment mesurer si les améliorations portent leurs fruits.
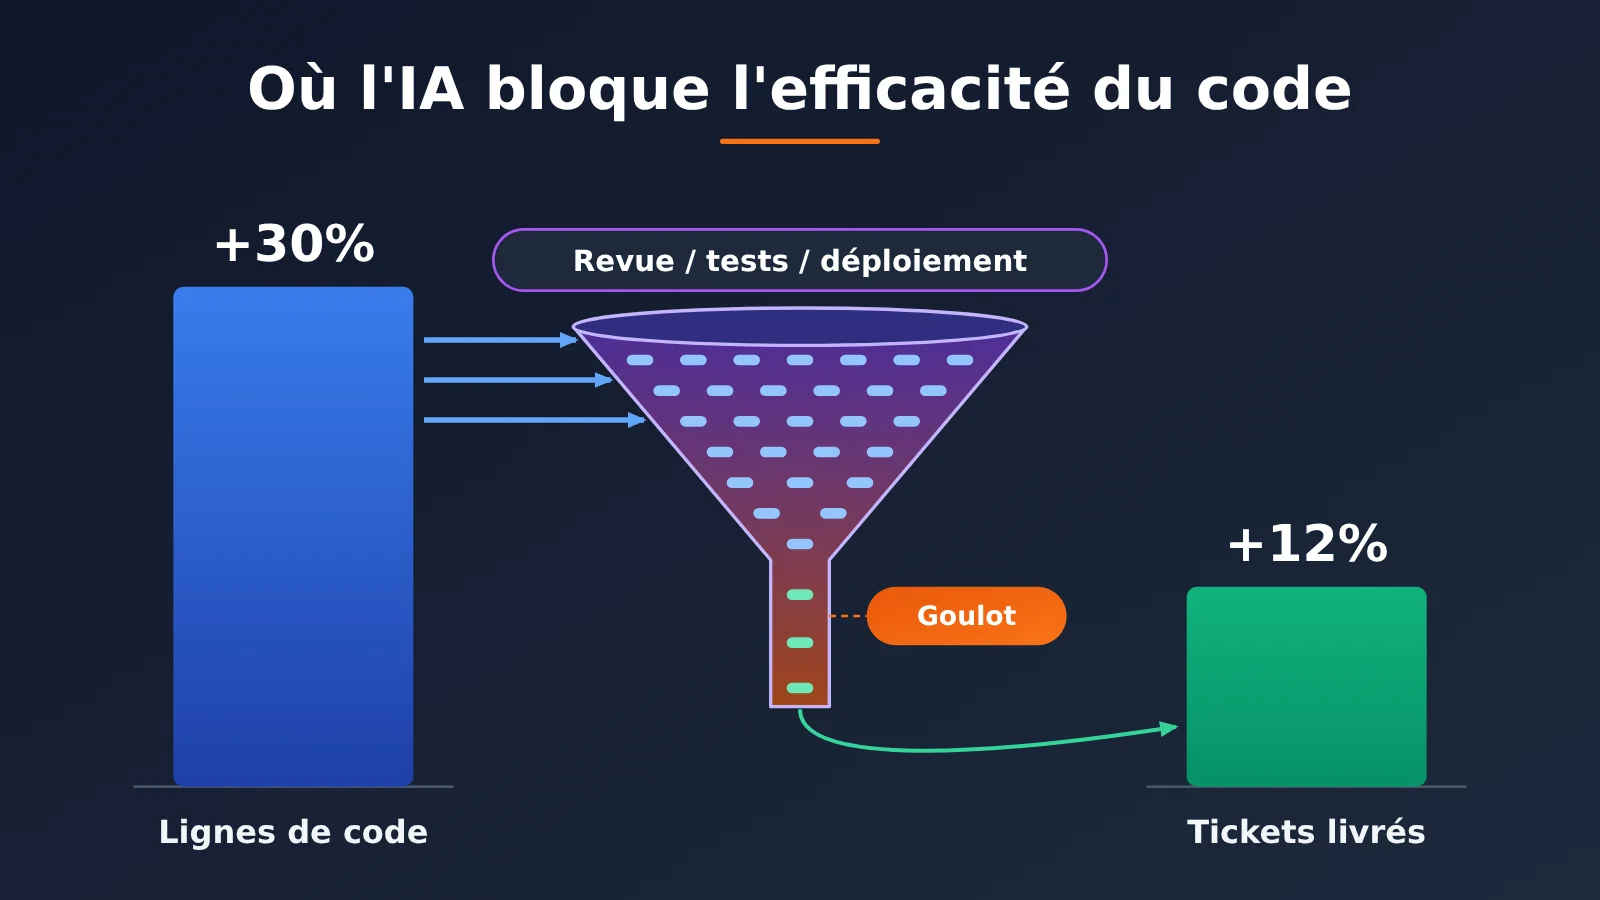
L’essentiel sur le goulot d’étranglement de la productivité du codage avec l’IA
Cette étude couvre la période de janvier 2021 à mars 2026, avec plus de 700 entreprises, 700 000 salariés et environ 300 millions d’événements de travail. Les sources de données incluent les informations RH, les systèmes de gestion de versions de code, les systèmes de tickets, les outils de planification, ainsi que les journaux d’utilisation d’outils d’IA générative comme GitHub Copilot, Cursor et Claude Code. La taille de l’échantillon est rarement atteinte dans les études comparables.
| Point clé | Résultat de l’étude | Ce que cela implique pour l’équipe |
|---|---|---|
| Croissance de la production | Les agents IA apportent +30 % de lignes de code, +20 % de commits et +23 % de pull requests | L’étape de codage est bel et bien plus rapide |
| Croissance des livraisons | Le nombre de tickets résolus par personne et par mois n’augmente que de 12 % | La production ne se traduit pas proportionnellement en livraisons |
| Répartition du temps | Les ingénieurs ne passent que 30 à 40 % de leur temps à écrire du code | Optimiser uniquement le codage plafonne très vite |
| Pression sur la revue | Durée de revue +49 %, commentaires +53 %, part des pull requests à retravailler ×2 | Le goulot d’étranglement s’est déplacé vers la revue |
| Revue assistée par IA | Avec une revue assistée par IA, la part des personnes impliquées dans les revues augmente encore de 14 % | Ajouter un outil de revue IA ne suffit pas à régler le problème |
Assistants IA vs agents IA : le détail des gains de productivité
L’étude distingue deux types d’outils. Les assistants de programmation (surtout autocomplétion et dialogue) apportent peu de gains : +12 % de lignes de code, +9 % de commits, +5 % de pull requests, et seule la hausse des commits est statistiquement significative. Plus important encore, les assistants de programmation n’ont pas augmenté le nombre de tickets résolus ; autrement dit, leur impact sur la livraison est presque impossible à mesurer.
Les agents IA (capables de mener seuls des tâches en plusieurs étapes) progressent nettement sur les trois indicateurs de production et font augmenter de 12 % le nombre de tickets traités. Cela montre qu’il est plus utile de « confier une tâche complète à l’IA » que de « demander à l’IA de compléter quelques lignes », mais cela signifie aussi que le volume de code reçu en aval et la charge de revue augmentent en même temps. L’étude précise également que la hausse de la charge de revue ne s’explique pas par la taille croissante des pull requests individuelles : le problème vient du code lui-même, qui demande plus de discussions et de modifications.
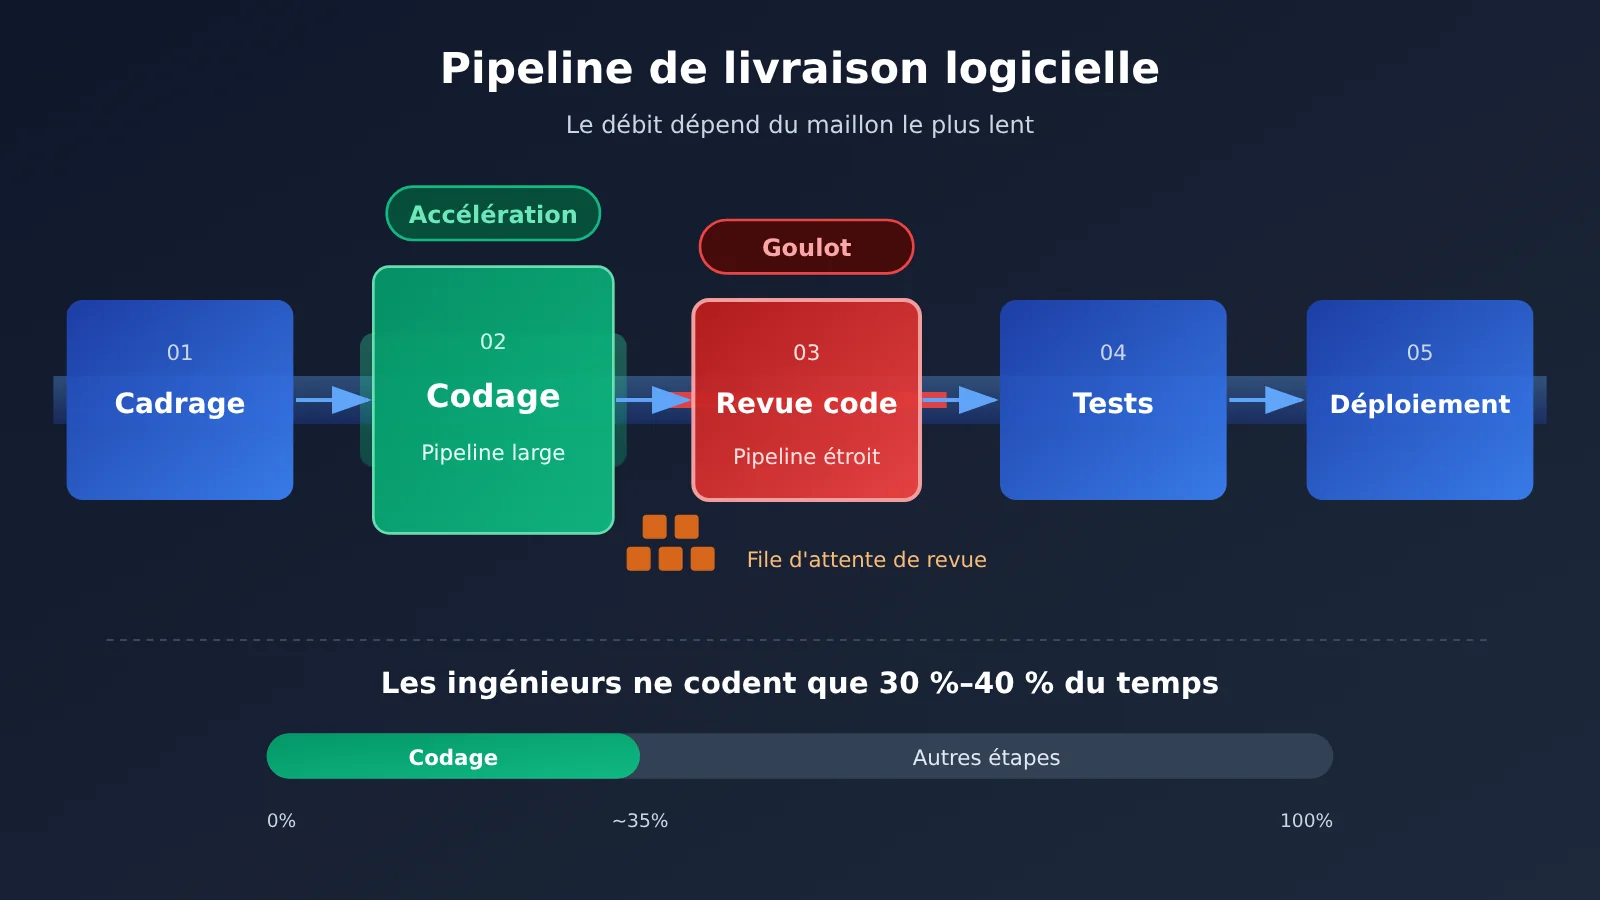
Où se situe le goulot d’étranglement de l’IA pour coder plus vite : comprendre avec la théorie des contraintes
Le débit d’une chaîne de livraison dépend de son maillon le plus lent. Quand l’écriture de code ne représente que 30 à 40 % du temps d’un ingénieur, même en doublant la vitesse de codage, le cycle global ne peut être raccourci que d’environ un tiers au mieux. Et dans la réalité, ce code accéléré ne fait qu’engorger un peu plus la revue et les tests avec du travail en attente.
Quelques chiffres issus des études suffisent à reconstituer toute la chaîne causale : les agents écrivent davantage, donc les pull requests se multiplient ; le nombre de commentaires par pull request augmente de 53 %, signe que les relecteurs doivent fournir plus d’efforts pour comprendre et challenger le code produit par l’IA ; la proportion de pull requests nécessitant des modifications double, ce qui indique une baisse de qualité de la première soumission. Ces coûts retombent tous sur les relecteurs humains — précisément les personnes les plus expérimentées et les plus occupées de l’équipe.
| Étape | Ce que l’IA change | Symptômes typiques | Priorité |
|---|---|---|---|
| Planification et périmètre | Quand la demande est floue, l’IA part « avec assurance » dans la mauvaise direction | Retravail, pull request entièrement rejetée | Élevée |
| Codage | Vitesse nettement améliorée | Volume de code qui explose, productivité individuelle qui semble excellente | Déjà optimisée |
| Revue de code | Le volume à relire et la complexité augmentent en même temps | File d’attente de revue, allers-retours de commentaires | La plus élevée |
| Tests | La couverture ne suit pas le volume de code ajouté | Multiplication des régressions | Élevée |
| Déploiement et exploitation | Les ingénieurs comprennent moins bien le code | Diagnostic des incidents plus lent | Moyen et long terme |
Les discussions de la communauté confirment ce constat. Un développeur commente que « chaque ligne de code est un risque potentiel », un autre souligne que l’agent est un collaborateur peu fiable, capable de faire n’importe quoi pour venir à bout d’une tâche. D’autres estiment que le MTTR (temps moyen de rétablissement) deviendra un indicateur clé pour évaluer l’impact de l’IA : moins les ingénieurs comprennent le code qu’ils livrent, plus le diagnostic est difficile.
Démarrage rapide pour l’efficacité du codage avec l’IA : une méthode de percée en 5 étapes
Les méthodes ci-dessous sont classées de l’effort le plus faible au plus élevé, et les équipes peuvent avancer dans l’ordre. Chaque étape s’efforce de fournir des indicateurs mesurables, afin d’éviter des jugements invérifiables du type « on a l’impression d’aller plus vite ».
Étape 1 : établir une base de référence pour la livraison de l’efficacité du codage avec l’IA
Ne vous précipitez pas pour changer d’outils : commencez par mettre en place un système de mesure. Si l’étude a pu révéler un écart, c’est parce qu’elle a examiné à la fois les indicateurs de production et ceux de livraison. Beaucoup d’équipes ne regardent que le nombre de lignes de code et de commits, et finissent par croire à tort que l’amélioration de l’efficacité est un succès.
Il est recommandé de suivre deux groupes d’indicateurs en parallèle : côté production, le nombre de commits et de pull requests ; côté livraison, le nombre de tickets fermés par personne et par mois, ainsi que le cycle d’un besoin depuis son démarrage jusqu’à sa mise en production. Ajoutez à cela trois indicateurs côté revue : la durée moyenne de revue d’une pull request, le nombre de commentaires par pull request, et la proportion de retouches nécessaires. Ces données peuvent généralement être exportées directement depuis la plateforme Git et des systèmes de tickets comme Jira.
| Catégorie d’indicateur | Indicateur concret | Source des données | Point d’attention |
|---|---|---|---|
| Production | Nombre de commits, nombre de pull requests | Plateforme Git | À titre indicatif uniquement, pas pour l’évaluation |
| Livraison | Nombre de tickets fermés par personne et par mois, cycle des besoins | Système de tickets | Indicateur cible principal |
| Revue | Durée de revue, nombre de commentaires, taux de retouche | Plateforme Git | Alerte de goulot d’étranglement |
| Qualité | Nombre d’incidents en production, MTTR | Supervision et registre d’incidents | Santé à long terme |
Étape 2 : faire remonter la planification des besoins à l’agent de codage IA
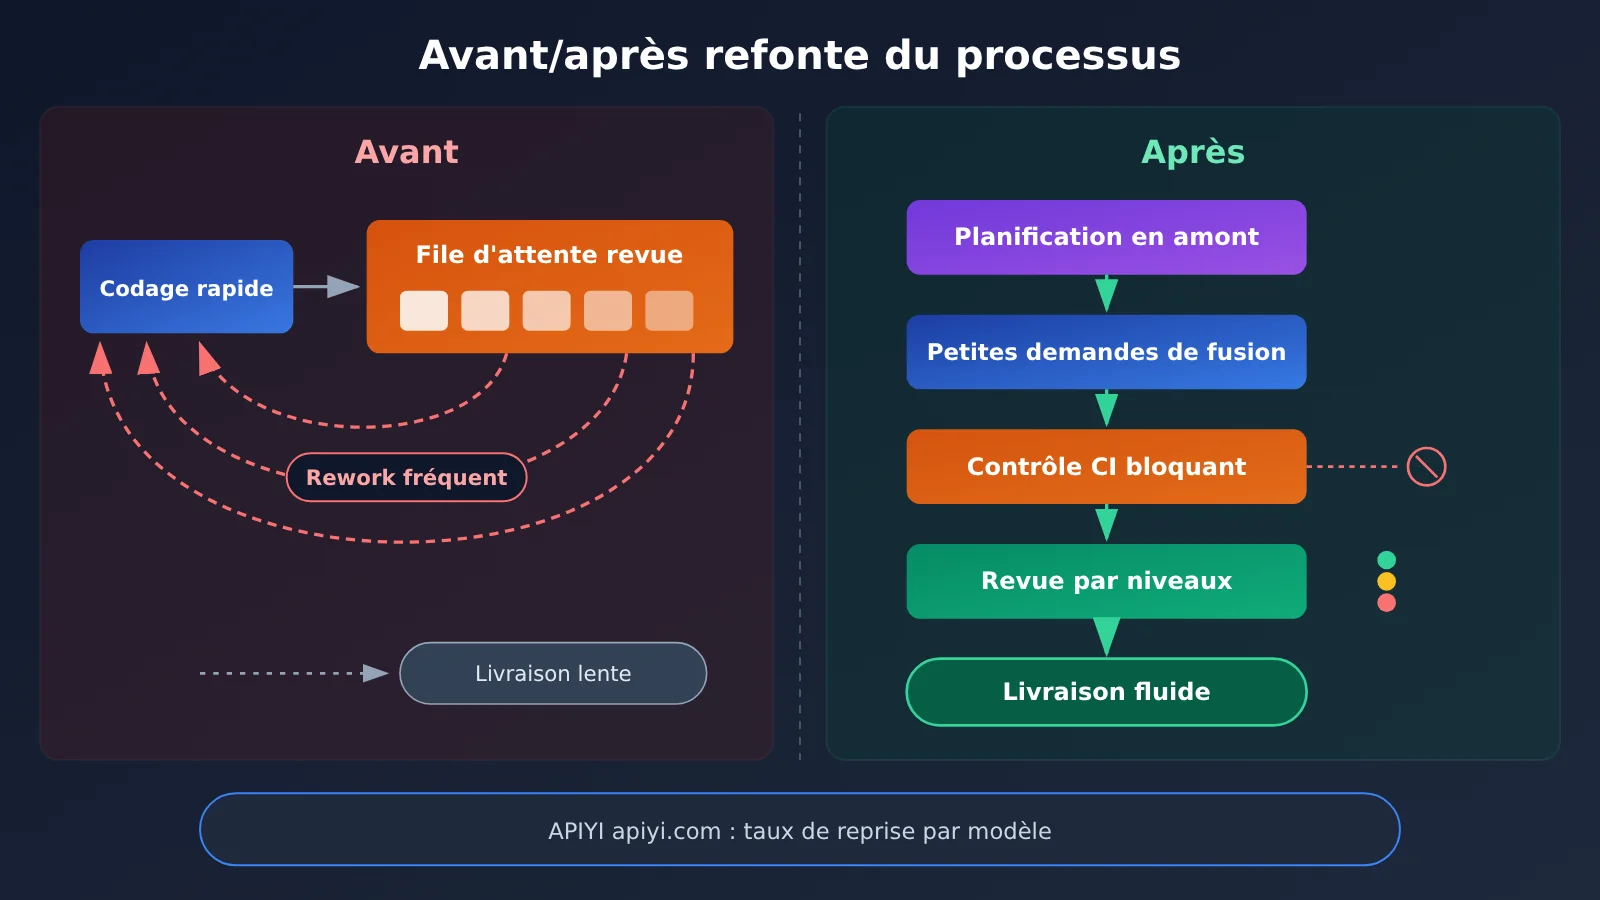
C’est quand une demande est floue qu’un agent a le plus tendance à « partir avec assurance dans la mauvaise direction ». Plutôt que de rejeter toute une demande de fusion au stade de la revue, mieux vaut consacrer dix minutes, avant de commencer, à rédiger une description de tâche claire : quels modules modifier, quelles interfaces ne pas toucher, quels sont les critères d’acceptation, quels tests ajouter.
Une approche pratique consiste à demander d’abord à l’agent de produire un plan de mise en œuvre, que l’ingénieur valide avant de passer au codage. Le coût des modifications au stade du plan est bien inférieur à celui du stade du code, et les relecteurs connaissent à l’avance l’étendue des changements. Cette étape peut sembler allonger le temps en amont, mais elle réduit directement des problèmes du type « la proportion de demandes de fusion à retravailler double ».
Étape 3 : contrôler la granularité des demandes de fusion du code généré par l’IA
L’attention d’un relecteur est une ressource limitée. Même si les études montrent que la hausse de la charge de revue n’est pas entièrement due à l’augmentation de la taille des demandes de fusion individuelles, contrôler la granularité reste le moyen le plus direct de réduire la charge cognitive. Il est conseillé de fixer des limites explicites aux tâches confiées à l’agent : une demande de fusion ne résout qu’un seul problème, et les refactorisations sont soumises séparément des changements fonctionnels.
Demandez également à l’agent d’indiquer dans la description de la demande de fusion la motivation du changement, le périmètre d’impact et les résultats de ses propres tests. Le relecteur peut alors évaluer le risque à la simple lecture de la description, au lieu de déduire l’intention à partir de plusieurs centaines de lignes de différences, et le nombre d’allers-retours dans les commentaires diminue nettement.
🎯 Conseil technique : les différents modèles présentent des écarts marqués en matière de découpage des tâches et de qualité des plans. APIYI apiyi.com propose l’appel aux API des principaux modèles cités dans cet article, comme Claude et GPT, tout en étant compatible avec les deux formats d’interface d’OpenAI et d’Anthropic ; les équipes peuvent donc changer de modèle au sein d’un même workflow d’agent et comparer lequel génère des demandes de fusion au taux de retravail le plus faible. Pour l’intégration, voir la documentation d’APIYI sur docs.apiyi.com.
Étape 4 : confier les tests et l’auto-vérification aux agents, pas aux relecteurs
L’étude révèle qu’après l’introduction d’une revue assistée par IA, la proportion de personnes participant aux revues a encore augmenté de 14 %. Cela montre qu’ajouter une IA au moment de la revue ne suffit pas ; il est plus efficace de déplacer le contrôle qualité en amont : faire en sorte que les agents complètent les tests unitaires, exécutent les tests en local, effectuent les vérifications statiques et le formatage avant la soumission.
Vous pouvez faire de « tests réussis, vérifications réussies » une condition préalable obligatoire à la soumission d’une demande de fusion, avec un blocage automatique par la CI. Les relecteurs peuvent ainsi se concentrer sur la pertinence de la conception, les cas limites et la logique métier, plutôt que de signaler des pointeurs nuls et des problèmes de nommage. Les outils de revue par IA conviennent comme premier filtre, mais la décision finale doit rester entre les mains de personnes qui comprennent le métier.
Étape 5 : revue par niveaux et stratification des risques du code généré par IA
Tout le code généré par IA n’a pas besoin d’une revue de même intensité. On peut classer les modifications par risque : documentation, tests et code boilerplate passent par une revue légère ; la logique métier par une revue classique ; les modifications touchant à l’authentification, aux paiements, aux migrations de données ou à la concurrence doivent faire l’objet d’une revue approfondie par un ingénieur senior, avec obligation pour l’auteur de justifier chaque changement.
| Niveau de risque | Type de modification | Mode de revue | Nombre de relecteurs recommandé |
|---|---|---|---|
| Faible | Documentation, cas de test, code boilerplate | Première revue par IA + confirmation humaine rapide | 1 personne |
| Moyen | Logique métier classique | Revue humaine complète | 1–2 personnes |
| Élevé | Authentification, paiements, migrations de données, concurrence | Revue approfondie par un ingénieur senior + présentation par l’auteur | 2 personnes ou plus |
Enfin, intégrez le MTTR au suivi à long terme. Si la compréhension du code par les ingénieurs devient de plus en plus superficielle, les problèmes finiront par apparaître lors d’incidents en production. Demander régulièrement aux auteurs de présenter le code IA qu’ils ont fusionné est un moyen peu coûteux d’éviter que « personne ne comprenne vraiment ce code ».
🚀 Démarrage rapide : si vous mettez en place un agent de codage interne à votre équipe, commencez par demander un crédit de test sur APIYI apiyi.com, puis appelez différents modèles avec le même jeu d’instructions de tâche. Notez la durée de revue et le taux de reprise des demandes de fusion générées, avant de choisir votre modèle principal.
Référence pour le choix des modèles destinés aux agents de codage IA
Le choix du modèle ne résout pas à lui seul les goulots d’étranglement du processus, mais il influence la qualité de la première soumission, et donc la charge de relecture. Le tableau ci-dessous propose des orientations selon le rôle dans le workflow ; les résultats concrets sont à vérifier par chaque équipe lors de ses propres tests.
| Rôle dans le workflow | Points forts requis | Piste de sélection | Plateformes disponibles |
|---|---|---|---|
| Génération du plan de mise en œuvre | Compréhension de longs contextes, découpage des tâches | Choisir un modèle phare doté de bonnes capacités de raisonnement | APIYI apiyi.com, API officielle |
| Écriture et refactorisation de code | Qualité du code, respect des contraintes | Choisir un modèle performant sur les évaluations de programmation | APIYI apiyi.com, API officielle |
| Ajout de tests et auto-vérification | Stabilité, volume d’appels élevé | Choisir un modèle au bon rapport qualité-prix | APIYI apiyi.com, API officielle |
| Première relecture par IA | Détection des défauts courants | Utiliser un modèle différent de celui qui écrit le code, afin d’éviter les angles morts liés à une même source | APIYI apiyi.com, API officielle |
💰 Note sur les coûts : les workflows d’agents génèrent un volume d’appels important, et le mode de facturation (prix unitaire des entrées, des sorties et des hits de cache) détermine directement le coût. Cet article ne donne pas de prix précis : pour tous les modèles, consultez les données en temps réel de la page tarifs APIYI, à l’adresse docs.apiyi.com/models.
FAQ – questions fréquentes
Q1 : Que signifie « le volume de code augmente de 30 % avec le codage IA, mais la livraison ne progresse que de 12 % » ?
C’est la conclusion d’une étude de Harvard s’appuyant sur les données de Jellyfish : après l’adoption d’agents IA, le nombre de lignes de code augmente de 30 %, mais le nombre de tickets résolus par ingénieur et par mois ne progresse que de 12 %. Cet écart vient surtout du fait que les étapes en aval – revue de code, tests – deviennent de nouveaux goulots d’étranglement.
Q2 : Quelle différence d’efficacité y a-t-il entre un assistant de codage IA et un agent IA ?
Pour l’assistant de codage, la hausse de production reste modeste : seuls les commits progressent de manière statistiquement significative (+9 %), et le nombre de tickets résolus n’augmente pas. L’agent IA, lui, fait croître de 30 %, 20 % et 23 % respectivement les lignes de code, les commits et les pull requests, avec en plus 12 % de tickets résolus.
Q3 : Les données de cette étude sur l’efficacité du codage IA sont-elles fiables ?
La période couverte va de janvier 2021 à mars 2026, avec plus de 700 entreprises, 700 000 employés et environ 300 millions d’événements de travail. La répartition du temps de travail a également été validée par une enquête auprès de 100 ingénieurs : la taille de l’échantillon et la validation croisée inspirent plutôt confiance.
Q4 : Adopter un outil de revue de code IA permet-il de résoudre le goulot d’étranglement des revues ?
Pas à lui seul. L’étude montre qu’après l’introduction d’une revue assistée par IA, la proportion de personnes participant aux revues a encore augmenté de 14 %. La démarche la plus efficace consiste à déplacer les tests et l’auto-vérification en amont de la soumission, puis à combiner avec une revue par niveaux, pour que la revue humaine se concentre sur les changements à risque élevé.
Q5 : Comment vérifier à faible coût l’impact de différents modèles sur la charge de revue ?
Le conseil : comparer plusieurs modèles sur un même lot de tâches réelles :
1. S’inscrire sur APIYI apiyi.com et récupérer un crédit de test
2. Suivre la documentation APIYI docs.apiyi.com pour brancher votre agent existant au format compatible OpenAI ou Anthropic
3. Relever, pour chaque modèle, la durée de revue des pull requests générées, le nombre de commentaires et le taux de reprise
Vous choisirez ainsi votre modèle sur des données, pas sur une impression.
Q6 : Comment estimer le coût d’un agent de codage IA pour une équipe ?
Commencez par mesurer la consommation moyenne de tokens en entrée et en sortie par tâche, puis multipliez par le prix unitaire du modèle et le volume mensuel de tâches. Les tâches d’agent ont souvent un contexte très long, et le taux de succès du cache pèse nettement sur le coût. Pour les prix unitaires et les règles de facturation du cache, référez-vous à la page tarifs d’APIYI docs.apiyi.com/models.
Q7 : Quels sont les risques à long terme du codage assisté par IA ?
Le risque principal est que les ingénieurs comprennent moins bien le code. La communauté estime que, lorsque la base de code grossit sans être bien comprise, les incidents peuvent devenir plus fréquents et le diagnostic plus difficile. Il est conseillé de suivre dans la durée le temps moyen de rétablissement après incident, et de demander à l’auteur de savoir expliquer le code IA qu’il a mergé.
Points clés pour gagner en efficacité avec le codage assisté par IA
- Produire n’est pas livrer : les agents IA font grimper le volume de code de 30 %, mais les tickets livrés n’augmentent que de 12 %
- Le codage ne représente que 30 à 40 % du temps : optimiser uniquement l’écriture du code plafonne vite le gain global
- La revue est le premier goulot d’étranglement : durée de revue +49 %, commentaires +53 %, taux de reprise doublé
- La revue par IA n’est pas une baguette magique : après son introduction, la part des personnes impliquées dans la revue augmente encore de 14 %
- Déplacer le contrôle qualité en amont : planification en amont, commits de petite granularité et auto-vérification avant commit sont les plus efficaces
- Surveiller le MTTR sur la durée : éviter que l’équipe « écrive beaucoup et comprenne peu » le code produit par l’IA
- Choisir son modèle avec des données : comparer les taux de reprise de chaque modèle via l’interface unifiée APIYI apiyi.com
En résumé
Où se bloque le gain d’efficacité du codage assisté par IA ? La recherche a déjà donné la réponse :
- Le goulot d’étranglement s’est déplacé : une fois le codage accéléré, la revue de code, les tests et la planification deviennent les nouveaux points de limitation
- Les métriques doivent se lire par paires : les indicateurs de production doivent être suivis avec ceux de livraison, de revue et de qualité
- Changer les processus compte plus que changer d’outils : planification en amont, maîtrise de la granularité, auto-vérification déplacée en amont, revue par niveaux, à dérouler dans cet ordre
Le vrai gain d’efficacité ne consiste pas à faire écrire plus de code par l’IA, mais à faire passer moins de code à travers la revue avec une meilleure qualité du premier coup. Je recommande de lancer d’abord un cycle d’itération pour établir des données de référence, puis de mettre en place progressivement la méthode en 5 étapes ci-dessus.
Si vous avez besoin de comparer les performances de différents modèles dans un workflow d’agents, je vous conseille de valider rapidement via APIYI apiyi.com : la plateforme est compatible avec les formats d’interface OpenAI et Anthropic, et les tarifs sont à consulter sur docs.apiyi.com/models.
📚 Références
- InfoQ Chine : le code généré par IA bridé par les goulets d’étranglement en aval : version chinoise du compte rendu de recherche
- Lien :
infoq.cn/article/c3vTLNrRwfCzw8SAmz90 -
Description : contient la méthodologie de recherche, les données clés et les discussions de la communauté
-
InfoQ English original : Jellyfish AI Productivity : version anglaise du compte rendu de recherche
- Lien :
infoq.com/news/2026/10/jellyfish-ai-productivity -
Description : pour les lecteurs qui souhaitent consulter la formulation originale en anglais
-
Centre de documentation APIYI : accès aux modèles et description des interfaces
- Lien :
docs.apiyi.com -
Description : les modalités d’accès aux formats compatibles OpenAI et Anthropic
-
Page tarifs des modèles APIYI : base de facturation de chaque modèle
- Lien :
docs.apiyi.com/models - Description : les prix unitaires d’entrée, de sortie et de cache suivent les données en temps réel de cette page
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; vous trouverez davantage de ressources d’accès dans le centre de documentation docs.apiyi.com