De nombreux développeurs ont récemment fait part d’une expérience « contre-intuitive » : claude-opus-5-5 ne semble pas lent du tout ; pour beaucoup de tâches, il termine même avant claude-sonnet-5-5. Si le modèle phare est à la fois rapide et puissant, Sonnet n’a-t-il plus que l’avantage d’être « deux fois moins cher » ? La réponse est plus nuancée. Cet article s’appuie sur 6 ensembles de données publiques pour analyser les différences réelles entre claude-sonnet-5-5 et claude-opus-5-5, avec une question plus concrète au centre : dans les scénarios Agent d’entreprise impliquant de longues entrées et sorties de contenu, comment répartir efficacement les rôles entre ces deux modèles ?
Valeur clé : après avoir lu cet article, vous comprendrez la véritable raison de la rapidité d’Opus, les atouts concrets de Sonnet au-delà de son prix, ainsi qu’une architecture Agent bimodèle Opus + Sonnet directement exploitable.
Aperçu des paramètres clés de claude-sonnet-5-5 et claude-opus-5-5
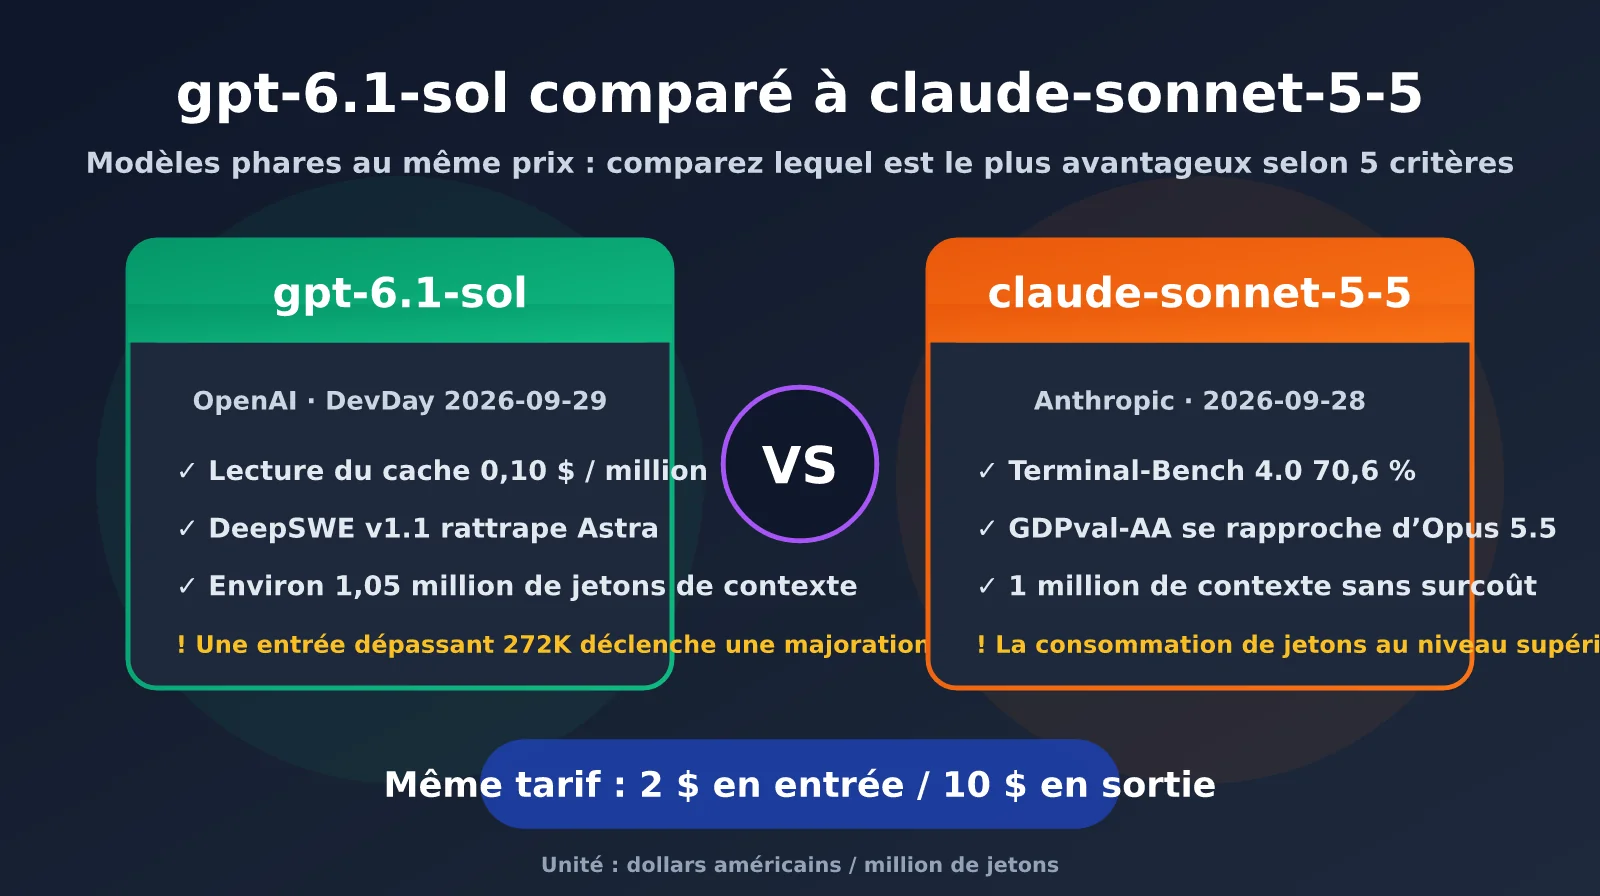
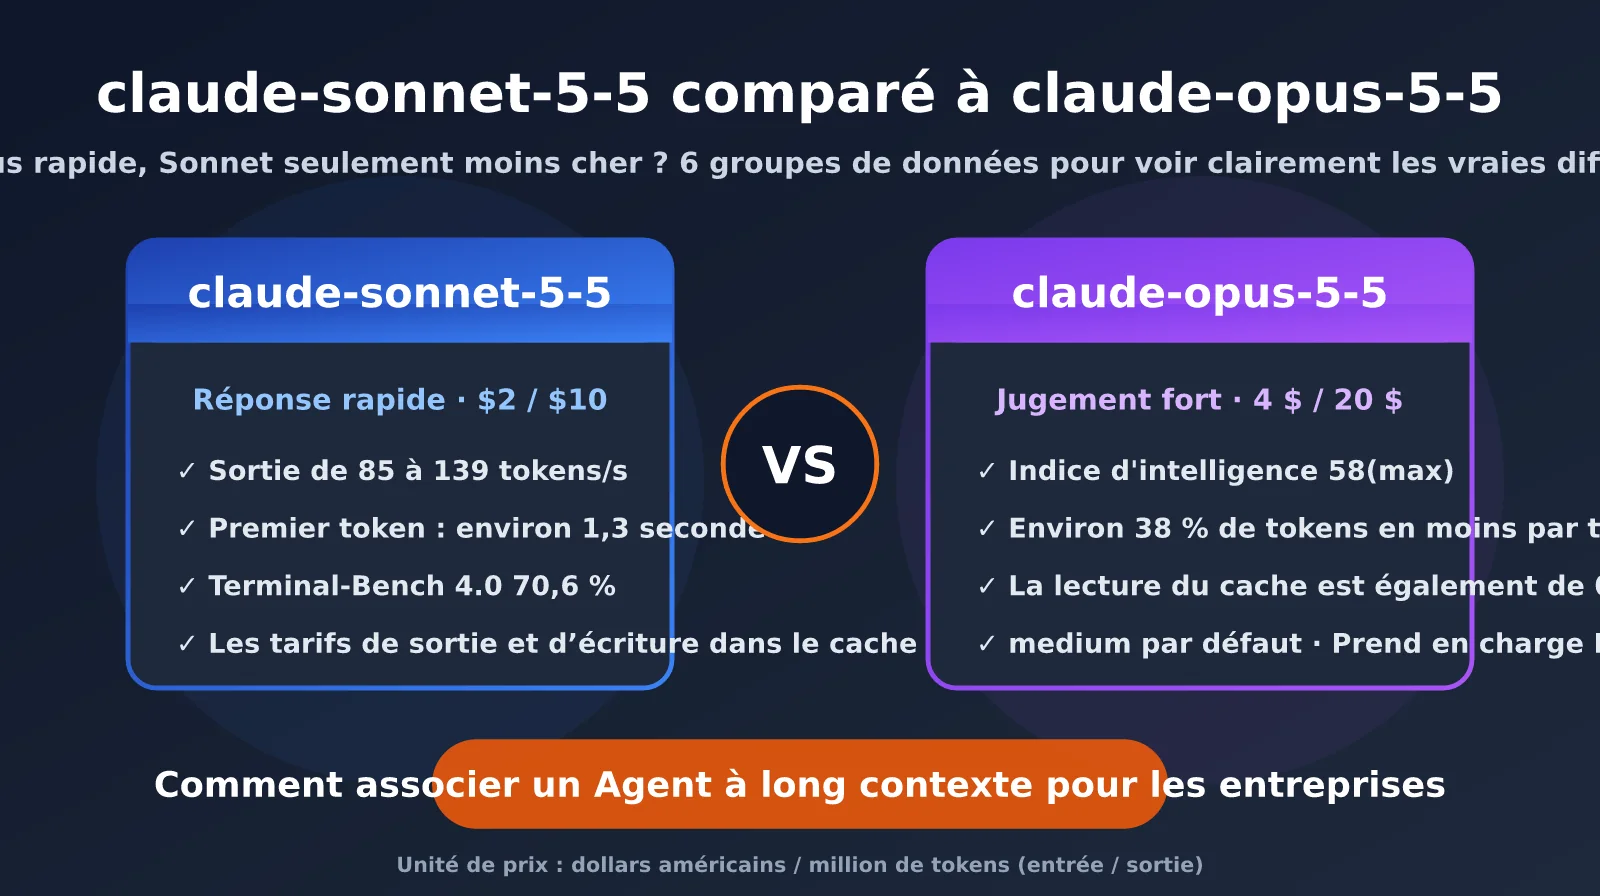
claude-opus-5-5 a été lancé le 22 septembre 2026, suivi de claude-sonnet-5-5 le 28 septembre 2026. Les deux appartiennent à la famille Claude 5.5. Le changement le plus notable de cette génération est la baisse de prix d’Opus : son tarif est passé de $5/$25 pour Opus 5 à $4/$20, soit une réduction de 20 %. La lecture du cache chute quant à elle de $0.50 à $0.20, exactement au même niveau que Sonnet. Sonnet 5.5 conserve un tarif de $2/$10 ; selon les chiffres officiels, son coût par tâche peut être jusqu’à 30 % inférieur à celui de la génération précédente.
| Paramètre | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| Date de lancement | 2026-09-28 | 2026-09-22 |
| Prix entrée / sortie | $2 / $10 | $4 / $20 |
| Lecture du cache | $0.20 | $0.20 (5 % du tarif d’entrée de base) |
| Écriture dans le cache, 5 minutes | $2.50 | $5 |
| Tarif Batch | $1 / $5 | $2 / $10 |
| Fenêtre de contexte | 1 million de tokens, sans surcoût pour les longs contextes | 1 million de tokens, sans surcoût pour les longs contextes |
| Sortie maximale | 128K (300K en bêta via Batch) | 128K (300K en bêta via Batch) |
| Niveau de raisonnement API par défaut | high | medium |
| Mode Fast | Non pris en charge | Pris en charge, vitesse de sortie environ 2,5 fois supérieure, $8 / $40 |
| Plateformes disponibles | APIYI apiyi.com, API officielle Anthropic | APIYI apiyi.com, API officielle Anthropic |
Le tableau cache deux détails qui influencent directement l’expérience. Premièrement, les niveaux de raisonnement par défaut sont différents : Opus utilise medium par défaut, tandis que l’API de Sonnet utilise high. C’est la principale raison pour laquelle beaucoup ont l’impression qu’Opus est plus rapide. Deuxièmement, le tarif de lecture du cache est identique : dans les scénarios Agent qui réutilisent massivement de longs contextes, l’écart de coût d’entrée entre les deux modèles se réduit donc fortement.
🎯 Conseil de test : pour comparer les deux modèles, veillez à définir explicitement le même niveau de raisonnement, faute de quoi les conclusions seront fortement biaisées. Nous vous recommandons d’utiliser la même clé API via APIYI apiyi.com pour appeler séparément claude-sonnet-5-5 et claude-opus-5-5 ; il suffit de ne modifier que les paramètres
modeletreasoning_effortpour réaliser un test comparatif.
Pourquoi claude-opus-5-5 semble plus rapide que claude-sonnet-5-5
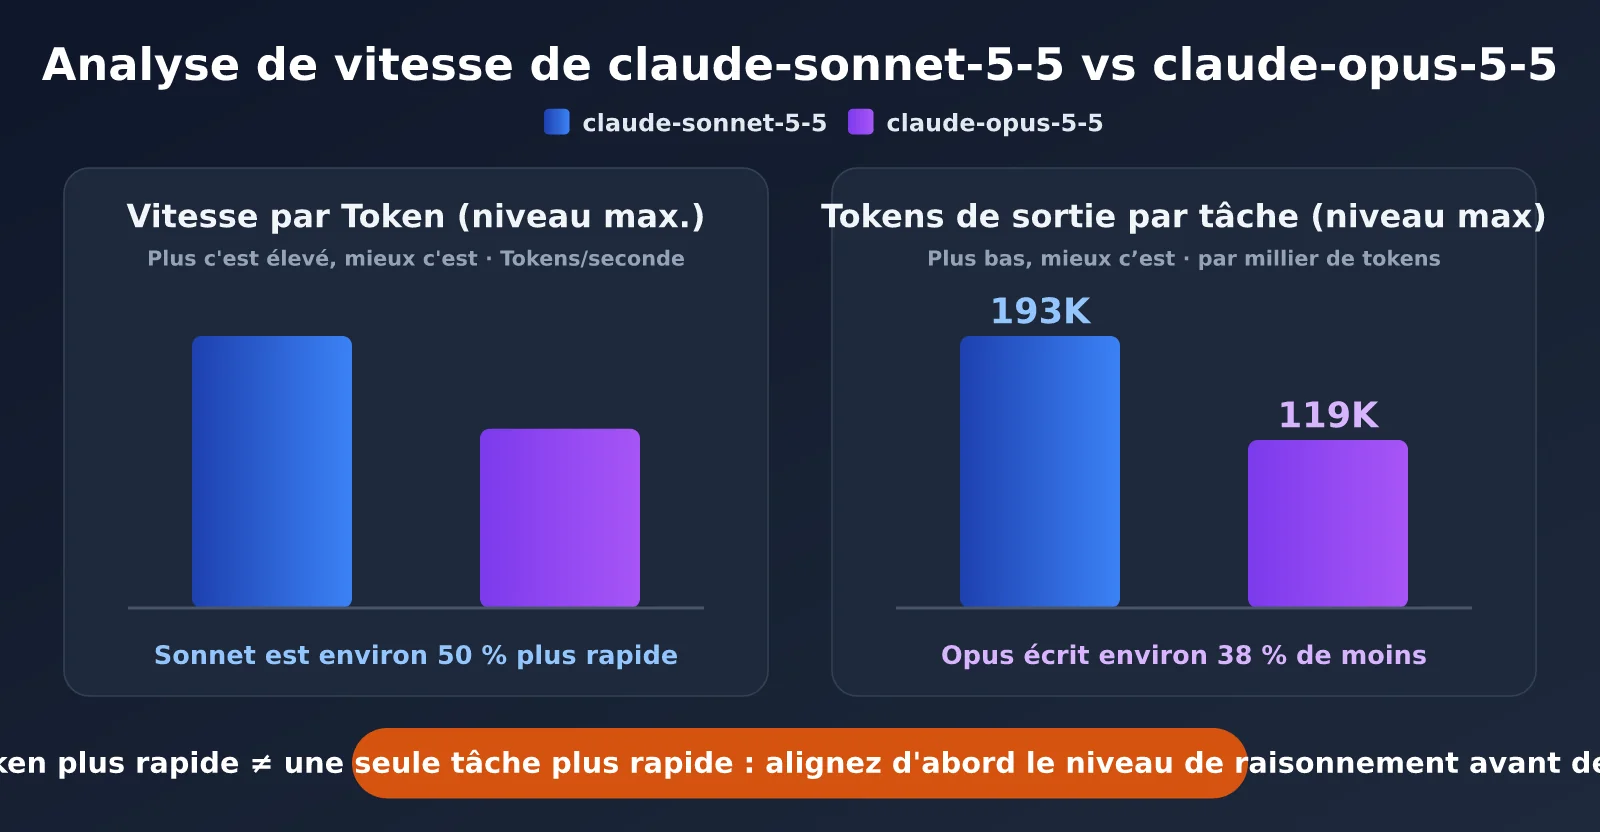
En termes de vitesse de génération pure, claude-sonnet-5-5 est en réalité nettement plus rapide. Les mesures d’Artificial Analysis indiquent que Sonnet 5.5 produit entre 85 et 139 tokens par seconde selon le niveau de raisonnement, contre 74 à 93 tokens par seconde pour Opus 5.5. Anthropic qualifie aussi la latence de Sonnet de « rapide », contre « moyenne » pour Opus. D’où vient donc l’impression qu’« Opus est plus rapide » ? Principalement de trois facteurs.
Raison 1 : les niveaux par défaut diffèrent, Sonnet réfléchit davantage par défaut
Opus 5.5 a abaissé le niveau par défaut de son API de high, pour la génération précédente, à medium. Selon Anthropic, le niveau medium atteint déjà ou dépasse les performances d’Opus 5 au niveau high. L’API de Sonnet 5.5 reste par défaut au niveau high, et son mode de réflexion ne peut pas être désactivé. Des tests indépendants montrent que Sonnet produit environ deux fois plus de tokens au niveau high qu’au niveau medium, sans amélioration nette de la qualité. Si vous les appelez directement avec les paramètres par défaut, Sonnet « réfléchit un cran de plus » et prend donc naturellement davantage de temps.
Raison 2 : Opus est plus efficace en tokens
Dans le test d’indice d’intelligence d’Artificial Analysis, Sonnet 5.5 au niveau max produit en moyenne environ 193 000 tokens par tâche, le volume le plus élevé mesuré par l’organisme. Opus 5.5, au même niveau, en produit environ 119 000. Être plus rapide par token ne signifie pas forcément être plus rapide par tâche. Sonnet peut générer environ 50 % de tokens de plus par seconde, mais s’il doit écrire 60 % de contenu supplémentaire, le temps de bout en bout peut être égalé, voire dépassé, par Opus.
Raison 3 : Opus dispose en exclusivité du mode Fast
Opus 5.5 prend en charge le mode Fast (aperçu de recherche). Avec une configuration d’inférence plus rapide pour le même modèle, la vitesse de sortie peut être multipliée par 2,5 environ, pour un tarif de $8/$40. Si vous activez le mode Fast pour Opus dans un outil de programmation, l’impression qu’« Opus est très rapide » est encore renforcée. Attention : le mode Fast augmente uniquement le nombre de tokens générés par seconde ; il n’améliore pas la latence du premier token et ne partage pas le cache d’invites avec la vitesse standard.
| Indicateur de vitesse | claude-sonnet-5-5 | claude-opus-5-5 | Explication |
|---|---|---|---|
| Vitesse de sortie (tokens/s) | 85-139 | 74-93 | Sonnet est plus rapide par token |
| Tokens produits par tâche (niveau max) | Environ 193 000 | Environ 119 000 | Opus consomme moins de tokens |
| Latence du premier token (niveau bas) | Environ 1,3 s (medium) |
Environ 14,3 s (low) |
Sonnet répond plus vite |
| Évaluation officielle de la latence | Rapide | Moyenne | D’après la page des modèles Anthropic |
| Durée d’une tâche réelle de programmation (tiers) | 29 min 27 s | 44 min 50 s | Sonnet est environ 1,5 fois plus rapide |
Conclusion : avec les paramètres par défaut, Opus peut sembler terminer plus vite, mais une fois les deux modèles réglés sur des niveaux adaptés, Sonnet conserve un net avantage en réactivité. C’est particulièrement vrai pour la latence du premier token : Sonnet commence à produire en environ 1,3 seconde au niveau medium, un point essentiel pour les agents interactifs destinés aux utilisateurs.
claude-sonnet-5-5 a-t-il seulement un avantage tarifaire ? Comparatif des capacités
Commençons par un chiffre qui peut surprendre : au niveau max, Sonnet n’est pas moins cher qu’Opus. Pour exécuter l’ensemble de l’indice d’intelligence d’Artificial Analysis, Sonnet 5.5 (max) coûte environ $8,977, contre environ $8,708 pour Opus 5.5 (max). Opus revient donc légèrement moins cher tout en obtenant un meilleur score (58 contre 56). La raison est précisément l’efficacité en tokens évoquée plus haut. Ainsi, si vous utilisez Sonnet uniquement au niveau max, son avantage tarifaire n’est même pas garanti.
Quelle est alors la valeur de Sonnet ? Le tableau suivant présente les scores des deux modèles sur l’indice d’intelligence selon le niveau de raisonnement, et montre comment les utiliser au mieux :
| Niveau de raisonnement | Indice d’intelligence de claude-sonnet-5-5 | Indice d’intelligence de claude-opus-5-5 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
En intelligence générale, Opus est devant à tous les niveaux comparables. Son avantage est aussi plus marqué pour l’exactitude factuelle (AA-Omniscience : 66 % contre 54 %), ainsi que dans les domaines spécialisés comme le droit, la finance ou la stratégie. Mais Sonnet possède plusieurs avantages concrets qu’Opus ne peut pas remplacer :
- Programmation d’agents en terminal : sur Terminal-Bench 4.0, Sonnet (
max) obtient 70,6 %, contre 66,4 % pour Opus (xhigh). Toutefois, à niveauxhighidentique, Opus reste devant, avec 66,4 % contre 61,5 % : Sonnet doit être poussé au maximum pour le dépasser. - Latence de réponse : sa latence au premier token comme sa vitesse de sortie par seconde sont nettement meilleures, ce qui convient aux scénarios front-end avec interactions en temps réel et sortie en streaming.
- Entrées sans cache et écritures dans le cache : leurs prix unitaires ne représentent que la moitié de ceux d’Opus. Sonnet est donc plus intéressant pour les tâches à longue entrée ponctuelle, où chaque document est nouveau.
- Sorties longues et traitement par lots : le tarif de sortie est de $10 contre $20, et celui du Batch de $5 contre $10. Pour générer à grande échelle des rapports ou documents longs, l’avantage de coût est directement doublé.
- Exécution à forte concurrence : dans le positionnement officiel d’Anthropic, Sonnet est le partenaire plus rapide et moins coûteux d’Opus. Il convient bien à l’exécution parallèle d’un grand nombre de sous-tâches clairement définies en tant que sous-agent.
Dans d’autres benchmarks publics, Opus devance Sonnet d’environ 2 points sur CursorBench 4.0 (57,8 % contre 55,5 %), FrontierCode 1.1 (54,4 % contre 52,1 %) et OSWorld 2.1 (81,8 % contre 80,1 %). En revanche, l’écart se creuse nettement dans ProgramBench, un test tiers agrégé de reconstruction de programmes à long contexte : Opus atteint 91,2 %, contre 79,7 % pour Sonnet. Cela montre que plus une tâche exige des jugements précis dans une fenêtre de contexte très longue, plus l’avantage d’Opus devient important.
💡 Conseil de sélection : utilisez Sonnet entre les niveaux
mediumetxhigh, comme un « exécutant » ; Opus convient davantage au rôle de « décideur » à partir du niveaumedium. Pour vérifier la différence sur vos propres cas d’usage, vous pouvez exécuter une même tâche sur des documents longs avec les deux modèles via APIYI apiyi.com, puis comparer la qualité des résultats et le coût réel.
Le coût réel des scénarios d’Agent d’entreprise à long contexte
La charge typique d’un Agent en entreprise comprend souvent, en entrée, des contrats, dépôts de code ou bases de connaissances de plusieurs centaines de milliers de tokens, et, en sortie, des rapports détaillés, des réécritures en lot ou du code réparti sur plusieurs fichiers. Comme les deux modèles prennent en charge 1 million de tokens de contexte sans surcoût lié au long contexte, les facteurs qui déterminent réellement le coût sont le taux de réussite du cache et la longueur de sortie. Voici une estimation de plusieurs scénarios typiques à partir des tarifs officiels (pour Sonnet, une sortie 1,6 fois plus longue qu’Opus est estimée, ce qui reflète l’écart d’efficacité en tokens entre les deux modèles au niveau max) :
| Scénario | Composition de la charge | claude-sonnet-5-5 | claude-opus-5-5 | Ratio de coût |
|---|---|---|---|---|
| Questions successives sur long contexte | 500 000 tokens de contexte, 95 % de cache atteint, 25 000 nouveaux tokens écrits | Environ 0,28 $ (12 000 tokens en sortie) | Environ 0,37 $ (7 500 tokens en sortie) | 1 : 1,3 |
| Premier chargement d’un long document | 500 000 tokens écrits dans un cache de 5 minutes + 10 000 tokens en sortie | Environ 1,35 $ | Environ 2,70 $ | 1 : 2 |
| Génération d’un rapport détaillé | 50 000 tokens en entrée + 50 000 en sortie (même volume de sortie) | Environ 0,60 $ | Environ 1,20 $ | 1 : 2 |
| Génération hors ligne en lot | Mode Batch, 100 000 tokens en entrée et en sortie | Environ 0,60 $ | Environ 1,20 $ | 1 : 2 |
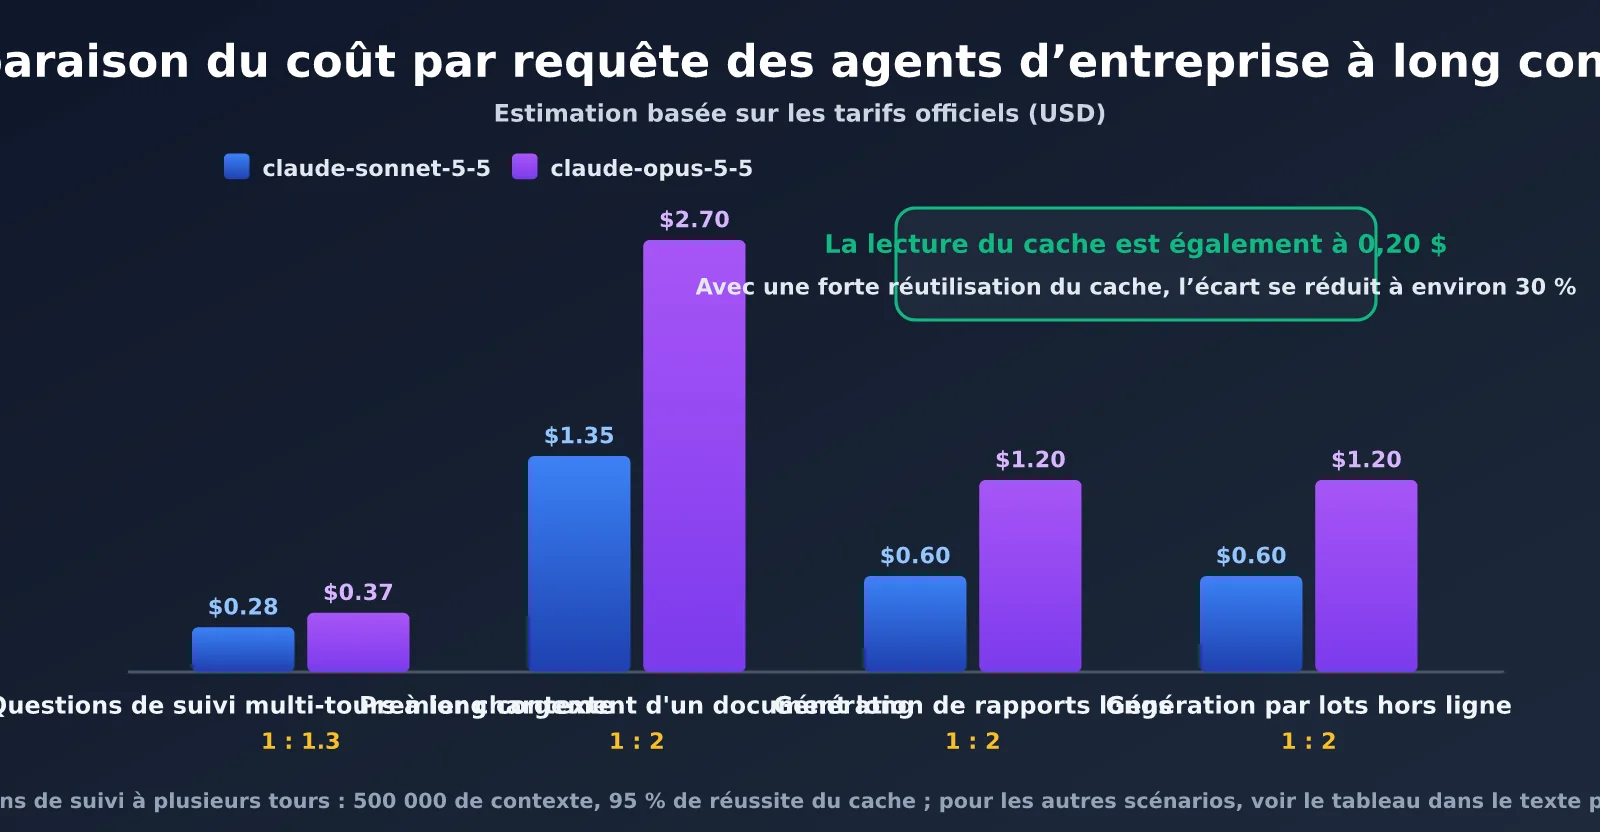
Ce tableau révèle une règle très importante : pour des questions successives associant une entrée longue, un fort taux de cache atteint et une sortie courte, Opus ne coûte qu’environ 30 % de plus que Sonnet. En effet, la lecture du cache, qui représente l’essentiel du coût, est facturée au même prix pour les deux modèles, tandis qu’Opus consomme aussi moins de tokens en sortie. À l’inverse, dans les cas de premier chargement d’un nouveau document et de génération longue, l’avantage de coût de Sonnet revient à son niveau complet : la moitié du prix.
Autrement dit, Opus convient à la lecture répétée d’un même corpus long pour porter un jugement, tandis que Sonnet est plus adapté pour ingérer une nouvelle matière une seule fois ou générer de longs contenus.
Un autre détail facile à négliger : le cache d’invites ne peut pas être partagé entre les modèles. Si Opus lit une fois un document de 500 000 tokens, puis que Sonnet le relit, vous paierez deux fois les frais d’écriture dans le cache. Dans une architecture à deux modèles, l’essentiel est donc de faire résider le long contexte sur un seul modèle, et de n’envoyer à l’autre qu’un résumé ciblé de la tâche.
Une combinaison pertinente de claude-sonnet-5-5 et claude-opus-5-5
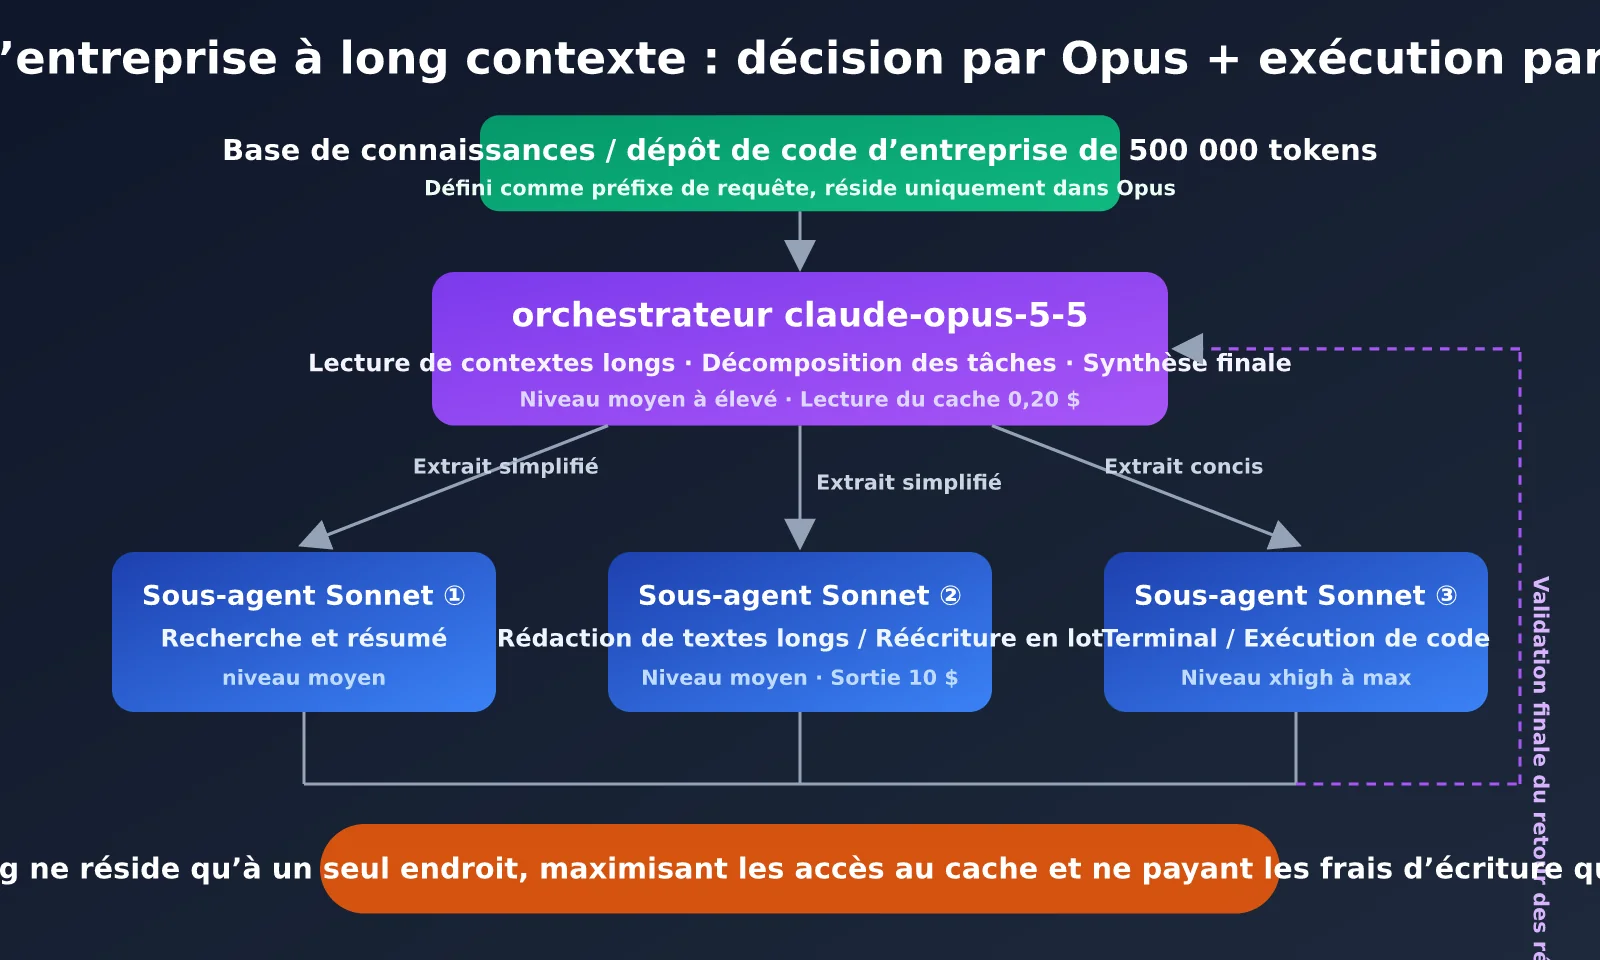
À partir de ces données, nous recommandons aux Agents d’entreprise traitant de longs contenus une architecture en couches : « Opus pour décider, Sonnet pour exécuter ». Selon le modèle qui porte le long contexte, cette approche se décline en deux modes.
Mode 1 : orchestration par Opus + sous-Agents Sonnet en parallèle
Ce mode convient lorsqu’il faut prendre des décisions complexes à partir de documents volumineux : revue de contrats, migration de code entre plusieurs dépôts ou due diligence. Opus conserve l’intégralité du long contexte, avec des accès répétés au cache, et se charge de comprendre l’ensemble, de décomposer la tâche et de la distribuer à plusieurs sous-Agents Sonnet. Chaque Sonnet ne reçoit qu’un extrait pertinent et des consignes précises, puis exécute rapidement son travail en parallèle au niveau medium. Opus centralise enfin les résultats et réalise la validation finale.
Dans cette architecture, le cache coûteux du long contexte n’est payé qu’une seule fois, tandis que Sonnet produit les longs contenus au tarif de sortie réduit de moitié.
Mode 2 : Sonnet en première ligne + escalade vers Opus
Ce mode est adapté aux cas interactifs à fort volume, comme les questions-réponses sur une base de connaissances d’entreprise, les Agents de support client ou les assistants IT internes. Sonnet conserve le long contexte et fournit, au niveau medium, un premier token en environ une seconde. Lorsqu’une demande présente un faible niveau de confiance, implique une décision de conformité, ou que l’utilisateur manifeste clairement son insatisfaction, le problème synthétisé et les extraits essentiels sont transmis à Opus.
La majorité du trafic est ainsi traitée par Sonnet à faible coût, tandis qu’Opus n’intervient que sur une minorité de demandes complexes.
| Rôle de l’Agent | Modèle recommandé | Niveau recommandé | Raison |
|---|---|---|---|
| Orchestrateur / planificateur | claude-opus-5-5 | medium ~ high | Intelligence globale et exactitude factuelle supérieures, bonne efficacité en tokens |
| Analyse à long contexte et validation finale | claude-opus-5-5 | high ~ xhigh | Avantage net pour les jugements précis sur long contexte |
| Rédaction longue / réécriture en lot | claude-sonnet-5-5 | medium | Tarif de sortie divisé par deux, génération par seconde plus rapide |
| Sous-Agent d’exécution terminal / code | claude-sonnet-5-5 | xhigh ~ max | Meilleur résultat à pleine puissance sur Terminal-Bench |
| Interface de conversation en temps réel | claude-sonnet-5-5 | medium | Latence du premier token d’environ 1,3 seconde |
| Traitement par lots hors ligne | claude-sonnet-5-5 | medium | Batch à 1 $ / 5 $, avec prise en charge de 300 000 tokens de sortie longue |
Mettre en œuvre l’orchestration Opus + l’exécution Sonnet avec une même interface
Voici un exemple minimal du premier mode. Il utilise une interface compatible OpenAI, et les deux modèles partagent la même clé :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
Développer pour consulter l’exemple complet : sous-Agents parallèles + préfixe fixe de long contexte
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. 长文档固定放在 system 前缀,只驻留在 Opus 上,便于多轮命中缓存
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Sonnet 子 Agent 只接收精简片段,并行执行
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. 回到 Opus 终审,复用同一长上下文前缀
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 Pour démarrer rapidement : les comptes Claude officiels imposent des exigences élevées concernant la région d’inscription et le moyen de paiement, ce qui bloque souvent les équipes d’entreprise dès l’ouverture du compte. Vous pouvez commencer par vous inscrire sur APIYI, apiyi.com, afin d’obtenir des crédits de test. Une même clé permet d’appeler claude-opus-5-5 et claude-sonnet-5-5 : mettez d’abord en route l’architecture à deux modèles ci-dessus, puis évaluez son coût à grande échelle.
Conseils pour choisir entre claude-sonnet-5-5 et claude-opus-5-5
Voici les 4 principes d’action à retenir de l’analyse précédente :
- Choisissez d’abord le niveau d’effort, puis le modèle : utilisez Sonnet en
mediumàxhigh, et Opus enmediumàhigh, afin d’éviter le gaspillage de tokens causé par le niveauhighpar défaut de Sonnet. - Confiez les longs contextes fortement réutilisés via le cache à Opus : le coût de lecture du cache est identique, et Opus ne coûte qu’environ 30 % de plus, tout en offrant une meilleure précision et moins de retouches.
- Confiez le chargement de nouveaux contenus et les longues sorties à Sonnet : les coûts d’écriture dans le cache et de sortie sont deux fois moins élevés que pour Opus. Pour les tâches hors ligne, ajoutez la réduction de 50 % de Batch.
- Ne conservez un long contexte qu’à un seul endroit : le cache ne peut pas être partagé entre les modèles. Les sous-agents ne doivent recevoir que des extraits condensés afin d’éviter de payer plusieurs fois l’écriture du cache.
Quant au mode Fast d’Opus, il convient aux cas où la vitesse d’une réponse individuelle est absolument critique et où le budget est confortable. Son prix est toutefois doublé et il ne partage pas le cache. Pour la plupart des agents d’entreprise, attribuer les interactions en temps réel à Sonnet au niveau medium est généralement plus rentable qu’activer Fast sur Opus.
Questions fréquentes
Q1 : claude-opus-5-5 est déjà très rapide ; est-il encore utile d’utiliser claude-sonnet-5-5 ?
Oui. La rapidité d’Opus provient surtout de son niveau d’effort par défaut plus faible et de sa meilleure efficacité en tokens. Sonnet reste néanmoins nettement devant en vitesse de génération par seconde et en latence avant le premier token, tout en coûtant deux fois moins cher en sortie. Pour la rédaction de textes longs, les conversations en temps réel et les sous-agents exécutés en parallèle, Sonnet reste donc le meilleur choix.
Q2 : Sonnet 5.5 au niveau max peut-il remplacer Opus ?
C’est possible pour certaines tâches précises, comme la programmation en terminal : le score de Sonnet en max sur Terminal-Bench 4.0 dépasse même celui d’Opus. Mais son indice global d’intelligence reste inférieur de 2 points. De plus, au niveau max, Sonnet consomme davantage de tokens, ce qui porte son coût total au niveau d’Opus, voire légèrement au-dessus. Si vous recherchez la qualité maximale, utiliser directement Opus est généralement plus rentable.
Q3 : Comment maîtriser le coût des deux modèles pour un agent d’entreprise qui traite de longs documents ?
Le point essentiel est d’augmenter le taux d’utilisation du cache : gardez les longs documents dans le préfixe des requêtes, ne laissez qu’un seul modèle détenir le contexte complet, et transmettez uniquement des extraits condensés aux sous-agents. Nous recommandons d’effectuer les invocations via APIYI apiyi.com et de surveiller les tokens de cache renvoyés par l’API. Ajustez progressivement la structure du préfixe : le taux de succès du cache est souvent le levier le plus efficace pour réduire les coûts.
Q4 : À quoi faut-il faire attention lors de la migration de Sonnet 5 ou Opus 5 vers la version 5.5 ?
Les deux modèles 5.5 introduisent des changements incompatibles avec les interfaces précédentes : le mode de réflexion ne peut plus être désactivé, les appels d’outils forcés (tool_choice défini sur any ou tool) renvoient une erreur 400, et l’ancien outil d’utilisation d’ordinateur doit également être mis à jour. Avant toute migration, il est recommandé d’exécuter les cas de régression dans un environnement de test, de comparer en parallèle les sorties des anciens et nouveaux modèles, puis de basculer progressivement le trafic de production.
Conclusion
Comparer claude-sonnet-5-5 à claude-opus-5-5 ne se résume pas à « le plus cher est meilleur et le moins cher est moins bon ». Depuis la baisse de prix d’Opus 5.5, la lecture du cache coûte autant que pour Sonnet, tandis que son niveau medium par défaut offre déjà une excellente efficacité. Il surpasse globalement Sonnet pour l’évaluation précise sur de longs contextes et l’intelligence générale. De son côté, Sonnet 5.5 conserve des avantages irremplaçables en vitesse de réponse, coût de sortie, programmation en terminal et exécution à forte concurrence. Sonnet n’est donc pas seulement avantageux par son prix : ses atouts se révèlent surtout avec le bon niveau et le bon rôle.
Pour les Agents d’entreprise traitant de gros volumes de contenu en entrée comme en sortie, l’association la plus pertinente est : « Opus décide, Sonnet exécute ». Opus conserve le long contexte et prend en charge la planification ainsi que la validation finale ; Sonnet travaille en parallèle au niveau medium pour rédiger et exécuter les tâches ; les traitements hors ligne sont confiés à Batch. En pratique, commencez par fixer les niveaux et mener des tests comparatifs, puis répartissez les Agents selon le tableau des rôles présenté dans cet article. Enfin, optimisez continuellement les coûts à l’aide de deux indicateurs : le taux de réussite du cache et le nombre de tokens générés.
Si vous souhaitez valider rapidement cette stratégie à deux modèles, nous recommandons d’appeler claude-opus-5-5 et claude-sonnet-5-5 de façon unifiée via APIYI apiyi.com. L’interface de la plateforme est compatible avec le format OpenAI : une seule clé permet de basculer librement entre les deux modèles. C’est particulièrement adapté aux tests de sélection comme à l’orchestration multimodèle en production.
Références :
– Documentation tarifaire d’Anthropic : platform.claude.com/docs/en/about-claude/pricing
– Documentation du mode Fast d’Anthropic : platform.claude.com/docs/en/build-with-claude/fast-mode
– Comparaison entre Sonnet 5.5 et Opus 5.5 par Artificial Analysis : artificialanalysis.ai
– Analyse de la sortie d’Opus 5.5 par Digital Applied : digitalapplied.com
– Comparaisons Sonnet 5.5 vs Opus 5.5 par Kingy AI et Emergent : kingy.ai, emergent.sh
À propos de l’auteur : l’équipe technique d’APIYI se consacre à l’intégration d’API de Grands modèles de langage et aux pratiques d’industrialisation. Échangez avec nous via APIYI apiyi.com sur l’orchestration d’Agents avec claude-opus-5-5 et claude-sonnet-5-5, ainsi que sur l’optimisation des coûts.