ملاحظة المؤلف: استنادًا إلى 10 تقييمات عابرة للنماذج أعلنتها Google DeepMind، نستعرض هنا نقاط قوة وضعف Gemini 4 Hydrogen وGPT-6.1 Terra وClaude Sonnet 5.5 في البرمجة وأتمتة الوكلاء والعمليات الحاسوبية، ونقدّم توصيات لاختيار النموذج حسب المهمة.
ملخص في جملة واحدة: تُظهر التقييمات العابرة للنماذج التي نشرتها Google أن Gemini 4 Hydrogen وClaude Sonnet 5.5 لكل منهما ميزة في مهام برمجية وأخرى متعلقة بالوكلاء، في حين يتميز GPT-6.1 Terra بالتكلفة والعمليات البصرية؛ لذلك ينبغي أن يجمع الاختيار الفعلي بين ظروف الاختبار ونوع المهمة والتكلفة.
للعلم: 5 مصطلحات تحتاج إلى معرفتها قبل قراءة المقال
- Harness: إطار اختبار ينظّم مدخلات النموذج وتنفيذ الأدوات واحتساب درجات المهام. قد تتغير نتيجة النموذج نفسه جوهريًا إذا تغيّر Harness.
- إصدار المعيار: إصدار البيانات والمهام والقواعد الخاص بتقييم ما. فمثلًا Terminal-Bench 4.0 و4.1 إصداران مختلفان، ويجب تفسير النتائج كلٍّ على حدة.
- Agent (وكيل): نظام يكمل مهامًا متعددة الخطوات بالاشتراك بين النموذج وبيئة تنفيذ الأدوات؛ وتعكس النتيجة أداء «النموذج + سلسلة الأدوات» ككل.
- Token (توكن): وحدة قياس لمعالجة النموذج للنصوص وغيرها، وعادةً تُسعّر API لكل مليون توكن.
- API: واجهة تتيح للبرامج استدعاء الخدمة، ومن خلالها يربط المطورون النموذج بتطبيقاتهم أو وكلائهم.
في 12 نوفمبر 2026، أطلقت Google رسميًا Gemini 4 Hydrogen، ووضعته في بطاقة النموذج الرسمية إلى جانب GPT-6.1 Terra وClaude Sonnet 5.5 داخل جدول تقييم واحد. يغطي هذا الجدول البرمجة وأتمتة الوكلاء والعمليات الحاسوبية والعمل المعرفي متعدد الوسائط، وهو اليوم أكثر البيانات العلنية للمقارنة الأفقية تركيزًا حول النماذج الثلاثة.
هذا ليس تحليلًا وسطًا يوحي بأن لكل نموذج نصيبه من التفوق. سنفكّك بندًا بندًا ما يقيسه كل اختبار، والظروف التي جُمعت فيها النتائج، ثم نستنتج في مجالات البرمجة والوكلاء والعمليات الحاسوبية كلٍّ على حدة، ونخرج في النهاية بمصفوفة اختيار قابلة للتطبيق مباشرة.
القيمة الأساسية: بعد قراءة هذا المقال، ستعرف بوضوح في أي المهام يتقدم Gemini 4 Hydrogen، وفي أيها يتفوق عليه Sonnet 5.5، وأين يناسب Terra أن يوضع داخل سير عمل الفريق.
لماذا نقارن Gemini 4 Hydrogen مع Terra وSonnet 5.5؟
صدرت النماذج الثلاثة في غضون أقل من شهرين، وتتشابه مواقعها بشكل كبير: فليست أياً منها النموذج الرائد الأثقل للاستدلال لدى شركتها، بل هي «النماذج العاملة الأساسية» الموجهة للمطورين وتنفيذ الوكلاء والمهام المهنية عالية التكرار. وبالنسبة للفرق التي تحتاج إلى استدعاءات كثيرة يومياً، تمثل هذه الطبقة العاملة ما يحدد التكلفة والكفاءة فعلياً.
Gemini 4 Hydrogen هو الجيل الجديد من نموذج Google DeepMind عالي الكفاءة، ويُوصف رسمياً بأنه مخصص للبرمجة اليومية وتنفيذ وكلاء الذكاء الاصطناعي، ويمكن تشغيله بشكل مستقل، كما يمكن أن يؤدي دور المنفّذ أو المدقق داخل أنظمة متعددة النماذج. أطلقت OpenAI نموذج GPT-6.1 Terra في 26 أكتوبر 2026، ويركز على الاستدلال البصري والتحكم بالحاسوب والعمل اليومي عالي الكفاءة. وأطلقت Anthropic نموذج Claude Sonnet 5.5 في 28 سبتمبر 2026، ويشدد الجانب الرسمي على البرمجة اليومية وإصلاح الأخطاء وإنشاء المستندات المهنية وتصميم الواجهات المعقدة.
| النموذج | الشركة المصنعة | تاريخ الإصدار | التوصيف الرسمي | سعر API القياسي (لكل مليون توكن، إدخال/إخراج) | مصدر السعر |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | البرمجة اليومية، واستدعاء أدوات متعددة، وتنفيذ الوكلاء | $1.50 / $7.50 | صفحة أسعار Google AI Studio، تم التحقق منها في 2026-11-13 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | الاستدلال البصري، والتحكم بالحاسوب، والعمل اليومي | $1 / $5 | مواد إصدار OpenAI، 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | البرمجة اليومية، وإصلاح الأخطاء، والمستندات المهنية، وتصميم الواجهات | لم تغطها المواد المرجعية، ويُعتمد على صفحة الأسعار الرسمية | الموقع الرسمي لـ Anthropic |
تجدر الإشارة إلى أن توكنات التفكير في Hydrogen تُحسب ضمن سعر الإخراج، لذا لا يمكن تقدير التكلفة الفعلية بناءً على النص المرئي النهائي فقط. كما أن سعر وضعي Batch وFlex في Hydrogen هو $0.75 / $3.75، وهو مناسب للمهام الدفعية غير المتصلة.
يعتمد المقارنة الكمية في هذا المقال بشكل أساسي على بطاقة نموذج Google DeepMind لإصدار نوفمبر 2026 وملف منهجية التقييم المرافق. وهذا يعني أن البيانات جمعتها Google، وأن بعض نتائج المنافسين مأخوذة من تقارير الشركات المعلنة أو لوحات الترتيب؛ وسنناقش أثر ذلك على الاستنتاجات تحديداً في القسم الخامس.
مقارنة قدرات البرمجة: Gemini 4 Hydrogen — من الأفضل في إصلاح المشكلات الواقعية؟
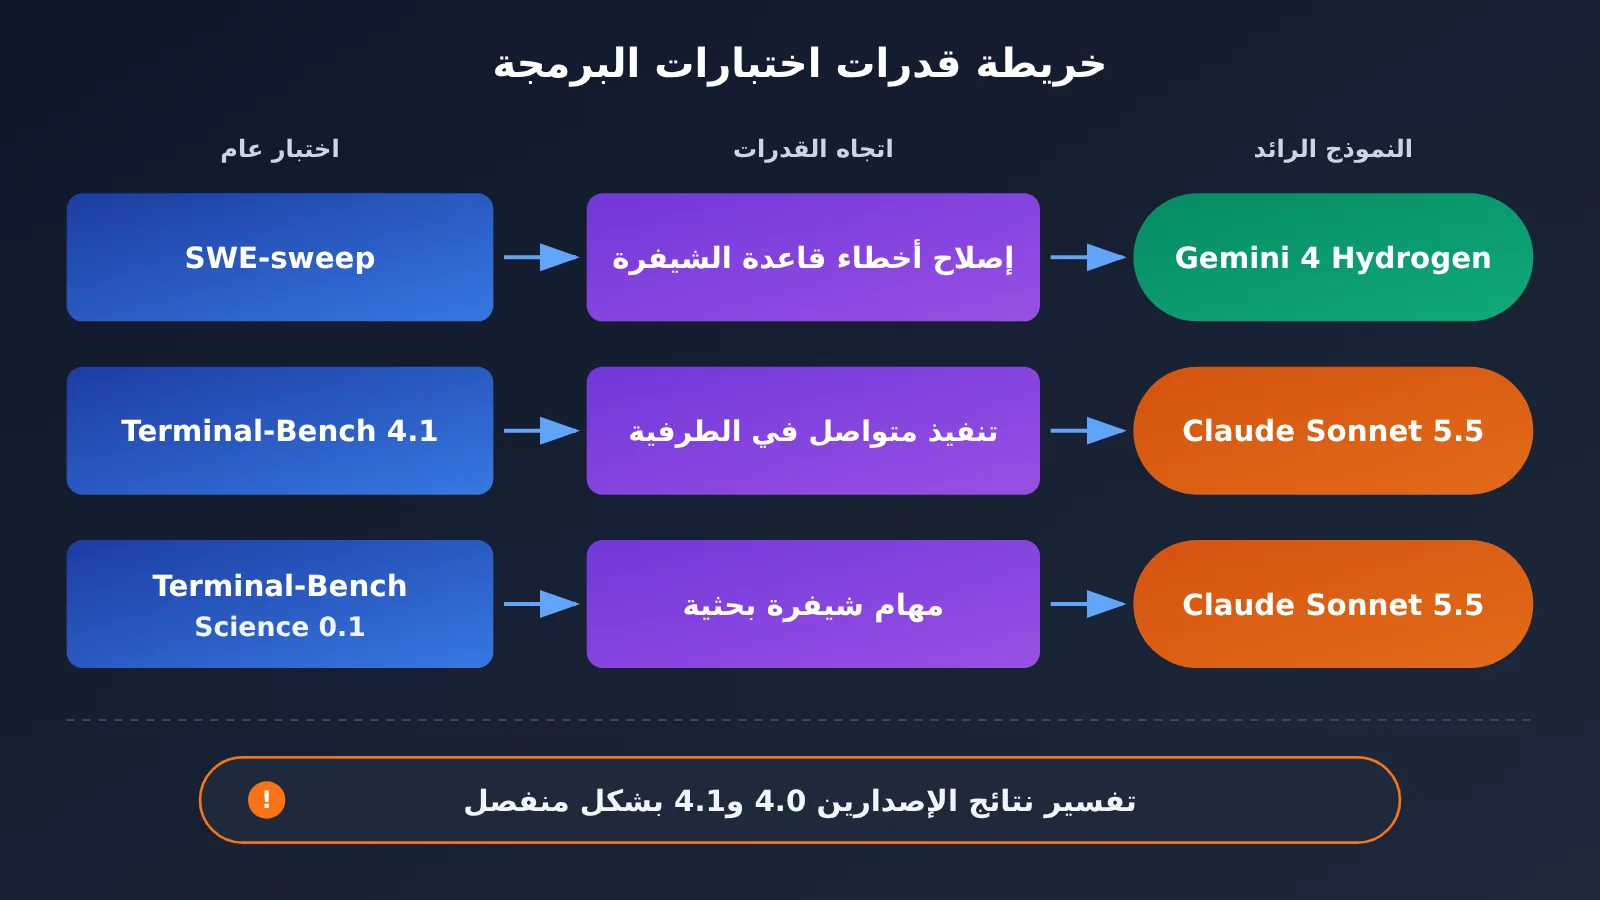
يمكن تقسيم اختبارات البرمجة إلى نوعين من القدرات: الأولى هي اكتشاف المشكلات وإصلاحها داخل قاعدة شيفرة حقيقية، والثانية هي تنفيذ الأوامر بشكل متتابع داخل بيئة الطرفية وإنجاز مهام هندسية. يميل SWE-sweep إلى النوع الأول، بينما تميل سلسلة Terminal-Bench إلى النوع الثاني، في حين يقيس Terminal-Bench-Science القدرة على إنجاز مهام بحثية باستخدام الشيفرة.
| التقييم (الإصدار) | المقياس | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | المتصدر |
|---|---|---|---|---|---|
| SWE-sweep | المكافأة المرجحة للمهام الفرعية | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 | متوسط المكافأة | 57.0% | 63.9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | درجة المهمة | 51.4% | 59.9% | 58.3% | Sonnet |
المصدر: Google DeepMind، «Gemini 4 Hydrogen Model Evaluation» وبطاقة النموذج، نوفمبر 2026.
قراءة نتائج اختبارات البرمجة
الدرجات المطلقة في SWE-sweep منخفضة عمومًا، ما يشير إلى أن الاختبار بالغ الصعوبة. نسبة Hydrogen البالغة 13.5% تزيد عن ضعف نتيجة Terra وأكثر من أربعة أضعاف نتيجة Sonnet، وهي أكبر فجوة في هذا البند. غير أن Hydrogen في هذا البند يستخدم أداة Google الخاصة Antigravity-CLI 1.4.8 للتنفيذ، وقد لا تكون ظروف تنفيذ المنافسين متطابقة، لذا قد يعود جزء من الفجوة إلى تكيّف Harness.
في Terminal-Bench 4.1، يتقدم Sonnet 5.5 بنسبة 63.9% على Hydrogen البالغ 57.0%، بينما لا توجد لدى Terra نتيجة لهذا البند في جدول Google. يستخدم Hydrogen في هذا البند mini-swe-agent vision Harness ومستوى التفكير High، مع تشغيل كل مهمة 5 مرات وأخذ متوسط المكافأة. وفي Terminal-Bench-Science 0.1، لا يزال Sonnet متقدمًا، ويأتي Terra بعده بنسبة 58.3%، بينما يحل Hydrogen في المركز الثالث.
الخلاصة في مجال البرمجة: يتمتع Hydrogen بميزة واضحة في اختبارات إصلاح المشكلات داخل قواعد الشيفرة مثل SWE-sweep؛ ويُعد Sonnet 5.5 أكثر ثباتًا في المهام التنفيذية داخل الطرفية؛ بينما يقترب أداء Terra من Sonnet في مهام الشيفرة العلمية. ولا يتفوق أي نموذج تفوقًا شاملًا في اختبارات البرمجة.
بيانات خلفية عن Terminal-Bench 4.0 المُعلنة من الشركات المصنّعة
نشرت OpenAI وAnthropic كلٌّ على حدة نتائج Terminal-Bench 4.0. وبما أن الإصدارين 4.0 و4.1 يمثلان نسختين مختلفتين من المعيار، فقد أُدرجت النتائج في الجدول أدناه بشكل منفصل، ولا يمكن مقارنتها أو خلطها مع نتائج 4.1 الواردة في الجدول السابق.
| التقييم (الإصدار) | النموذج | النتيجة | شروط الاختبار | المصدر |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | اختبار ذاتي من الشركة | مواد نشر Anthropic، 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | أعلى إعدادات الاستدلال | مواد نشر OpenAI، 2026-10-26 |
تكمن قيمة هذه البيانات في أنها توفر نقطة مرجعية: ففي ظل شروط الاختبار التي اعتمدتها كل شركة، تبدو قدرات Sonnet 5.5 في مهام الطرفية أعلى بوضوح من Terra، وهو ما يتوافق مع الاتجاه الوارد في جدول Google حيث يتصدر Sonnet في اختبارات الطرفية.
هل يستطيع Gemini 4 Hydrogen إنجاز عمل كامل في اختبارات الوكيل والأتمتة
الفرق الأكبر بين اختبار الوكيل (Agent) وبين سؤال وجواب من جولة واحدة هو أن النموذج يحتاج إلى تخطيط خطواته بنفسه، واستدعاء الأدوات بشكل متواصل، وتعديل استراتيجيته بعد الفشل، ثم التحقق من النتيجة في النهاية. هذا النوع من الاختبار أقرب إلى سير عمل أتمتة حقيقي، وهو أيضًا أكثر ما يختبر “الانضباط التنفيذي” لدى النموذج.
يجمع الجدول التالي جميع النتائج العابرة للنماذج في تقييم Google لأتمتة الوكيل، والتحكم في الحاسوب، والعمل المعرفي متعدد الوسائط، ويتشارك القسمان الثالث والرابع هذا الجدول.
| التقييم (الإصدار) | الاتجاه القدراتي | المؤشر | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | وكيل متعدد الخطوات احترافي | درجة المهمة | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | أتمتة سير العمل | درجة المهمة | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | محاكاة إدارة طويلة الأمد | رصيد الأموال النهائي | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | التحكم في الحاسوب/الواجهة الرسومية | معدل نجاح المهمة | 77.6% | 83.9% | 74.2% |
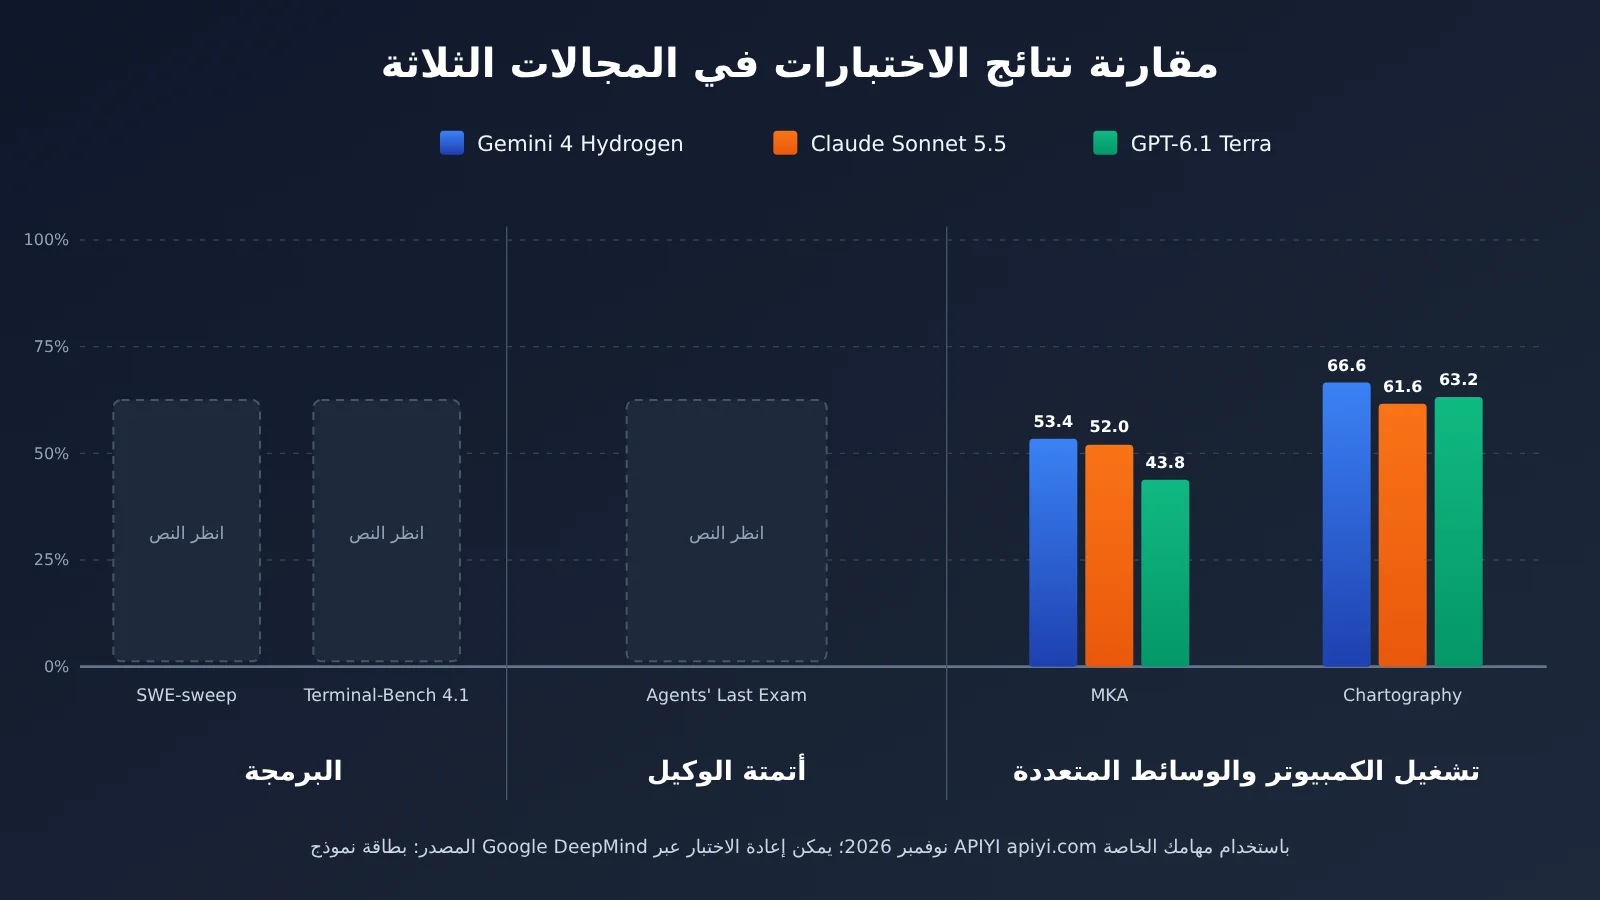
| MKA | العمل المعرفي متعدد الوسائط | درجة المهمة | 53.4% | 52.0% | 43.8% |
| Chartography | فهم المخططات (بدون أدوات) | الدقة | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | استدلال معرفي عالي الصعوبة | الدقة | 58.8% | 53.3% | 47.3% |
المصدر: بطاقة نموذج Google DeepMind وتقرير «Gemini 4 Hydrogen Model Evaluation»، نوفمبر 2026.
تفسير نتائج الوكلاء والأتمتة
تضم نسخة Agents’ Last Exam v1.1 عدد 122 مهمة ضمن نافذة زمنية مدتها 5 ساعات، ويستخدم Hydrogen أيضًا الإصدار Antigravity-CLI 1.4.8 للتنفيذ. يتقدم Hydrogen بنسبة 71.6%، لكن اللافت أن Terra يتبعه بنسبة 69.8%، وهي أعلى من Sonnet بنحو 10 نقاط مئوية. وهذا يدل على أن Terra ليس ضعيفًا في المهام الاحترافية متعددة الخطوات.
أما AutomationBench-AA فله ترتيب مختلف: Hydrogen 76.1%، وSonnet 71.8%، بينما يتأخر Terra بوضوح عند 60.2%. وإذا كان نشاطك التجاري يعتمد على أتمتة عمليات كبيرة تمتد عبر أنظمة متعددة، فإن هذه الفجوة تستحق الاهتمام.
أما Vending-Bench 2 فهو مهمة محاكاة إدارة أعمال طويلة الأجل، والمؤشر فيه هو الرصيد النهائي للأموال لا دقة الإجابات. ويتقدم Hydrogen هنا كثيرًا برصيد $14,549، ويمكن اعتبار ذلك مؤشرًا إضافيًا على «استقرار القرار على المدى الطويل»، لكنه بيئة محاكاة واحدة، ولا ينبغي تعميمه مباشرة على كل المهام الطويلة.
الخلاصة في مجال الوكلاء: في اختبارات الوكلاء والأتمتة التي أوردتها Google، يتقدم Hydrogen في جميعها؛ ويقترب Terra من Hydrogen في المهام الاحترافية متعددة الخطوات، لكنه يتأخر في أتمتة العمليات؛ ويقع Sonnet في موقع وسط.
🚀 البدء السريع: تعتمد نتائج الوكلاء بشدة على Harness وتعريفات الأدوات، لذا لا تصلح النتائج المنشورة إلا كنقطة انطلاق. نقترح تشغيل النماذج الثلاثة عبر APIYI apiyi.com باستخدام مجموعة الأدوات نفسها والمجموعة نفسها من المهام الواقعية، إذ يكفي مفتاح API واحد للتبديل بينها، ما يسهل الحصول على بيانات مقارنة تناسب سيناريوك الخاص.
Gemini 4 Hydrogen وSonnet 5.5: أيهما أقوى في التحكم بالحاسوب والعمل المعرفي متعدد الوسائط؟
تتطلب اختبارات التحكم بالحاسوب من النموذج أن “ينظر إلى الشاشة، وينقر بالفأرة، ويكتب على لوحة المفاتيح”، وهو ما يقابل مباشرة سيناريوهات مثل تشغيل المتصفح وأتمتة برامج المكتب. أما العمل المعرفي متعدد الوسائط فيقيّم قراءة الملفات المعقدة وفهم الرسوم البيانية، ويقابل أعمالًا مثل تحليل التقارير المالية وتنظيم تقارير البحث.
OSWorld-2.1: Sonnet 5.5 يتصدر في عمليات واجهة المستخدم الرسومية
في تقييم Google، يستخدم OSWorld 2.1 عدد 82 مهمة غير متصلة بالإنترنت، بدقة 1080p، وبحد أقصى 500 خطوة؛ يلاحظ النموذج عبر لقطات الشاشة، وينفذ العمليات عبر PyAutoGUI. يتصدر Sonnet 5.5 بنسبة 83.9%، يليه Hydrogen بنسبة 77.6%، ثم Terra بنسبة 74.2%.
هناك مسألة في منهجية القياس يجب توضيحها: النتيجة التي أعلنتها Anthropic نفسها لـ Sonnet 5.5 في جزء من اختبار OSWorld 2.1 هي 80.1%، بينما يعتمد جدول المقارنة من Google نتيجة 83.9%، وقد حصلت عليها Google في شروط محددة وبأخذ أعلى نتيجة من عدة تشغيلات. أي أن الاختبار نفسه قد يعطي درجات مختلفة لدى شركات مختلفة، لذا يجب تثبيت مصدر واحد عند المقارنة.
MKA وChartography: Hydrogen يتقدم بفارق طفيف
في مهام العمل المعرفي متعدد الوسائط ضمن MKA، تكون نسبة Hydrogen 53.4% قريبة جدًا من نسبة Sonnet 52.0%، بينما تأتي Terra عند 43.8%، متأخرة بنحو 10 نقاط مئوية. ويختبر Chartography فهم الرسوم البيانية دون استخدام أدوات، ويتقدم Hydrogen بنسبة 66.6%، ومن اللافت أن Terra تأتي في المرتبة الثانية بنسبة 63.2%، متقدمة على Sonnet صاحبة 61.6%، وهو ما يتوافق مع توصيف OpenAI لـ Terra بأنها ذات «استدلال بصري».
خلاصة التحكم بالحاسوب والمعرفة متعددة الوسائط: في عمليات واجهة المستخدم الرسومية، تُقدّم Sonnet 5.5؛ وفي قراءة الملفات المعقدة ودمج المعرفة متعددة الوسائط، يقترب Hydrogen من Sonnet مع أفضلية طفيفة لـ Hydrogen؛ وفي فهم الرسوم البيانية البحت، يتقدم Hydrogen، كما أن Terra قادرة على المنافسة.
كيف تقرأ بيانات التقييم العامة الخاصة بـ Gemini 4 Hydrogen بشكل صحيح
أكثر ما يُساء فهمه في التقييمات العامة هو التعامل مع جدول واحد وكأنه كشف درجات لـ«قاعة اختبار واحدة وقواعد واحدة». في الواقع، يوضح ملف منهجية التقييم من Google عدة افتراضات أساسية:
- مستوى التفكير: يُختبر Hydrogen عادةً بأعلى إعداد للتفكير، لكن بعض العناصر لها قواعد مختلفة؛ فمثلًا يستخدم Terminal-Bench 4.1 المستوى High.
- أداة التنفيذ Harness: يستخدم SWE-sweep وAgents’ Last Exam الإصدار Antigravity-CLI 1.4.8، ويستخدم Terminal-Bench 4.1 أداة mini-swe-agent vision Harness، ويستخدم OSWorld 2.1 لقطات الشاشة مع PyAutoGUI.
- عدد مرات الاختبار: يشغّل Terminal-Bench 4.1 كل مهمة 5 مرات ويأخذ متوسط المكافأة، بينما اعتمدت نتائج المنافسين في OSWorld على أعلى نتيجة من بين عمليات تشغيل متعددة؛ وطريقتا الإحصاء مختلفتان أصلًا.
- مصدر النتائج: تأتي نتائج المنافسين أساسًا من التقارير العامة لكل شركة ومن لوحات الترتيب، وليست كل النماذج نُفّذت اختباراتها بواسطة الفريق نفسه.
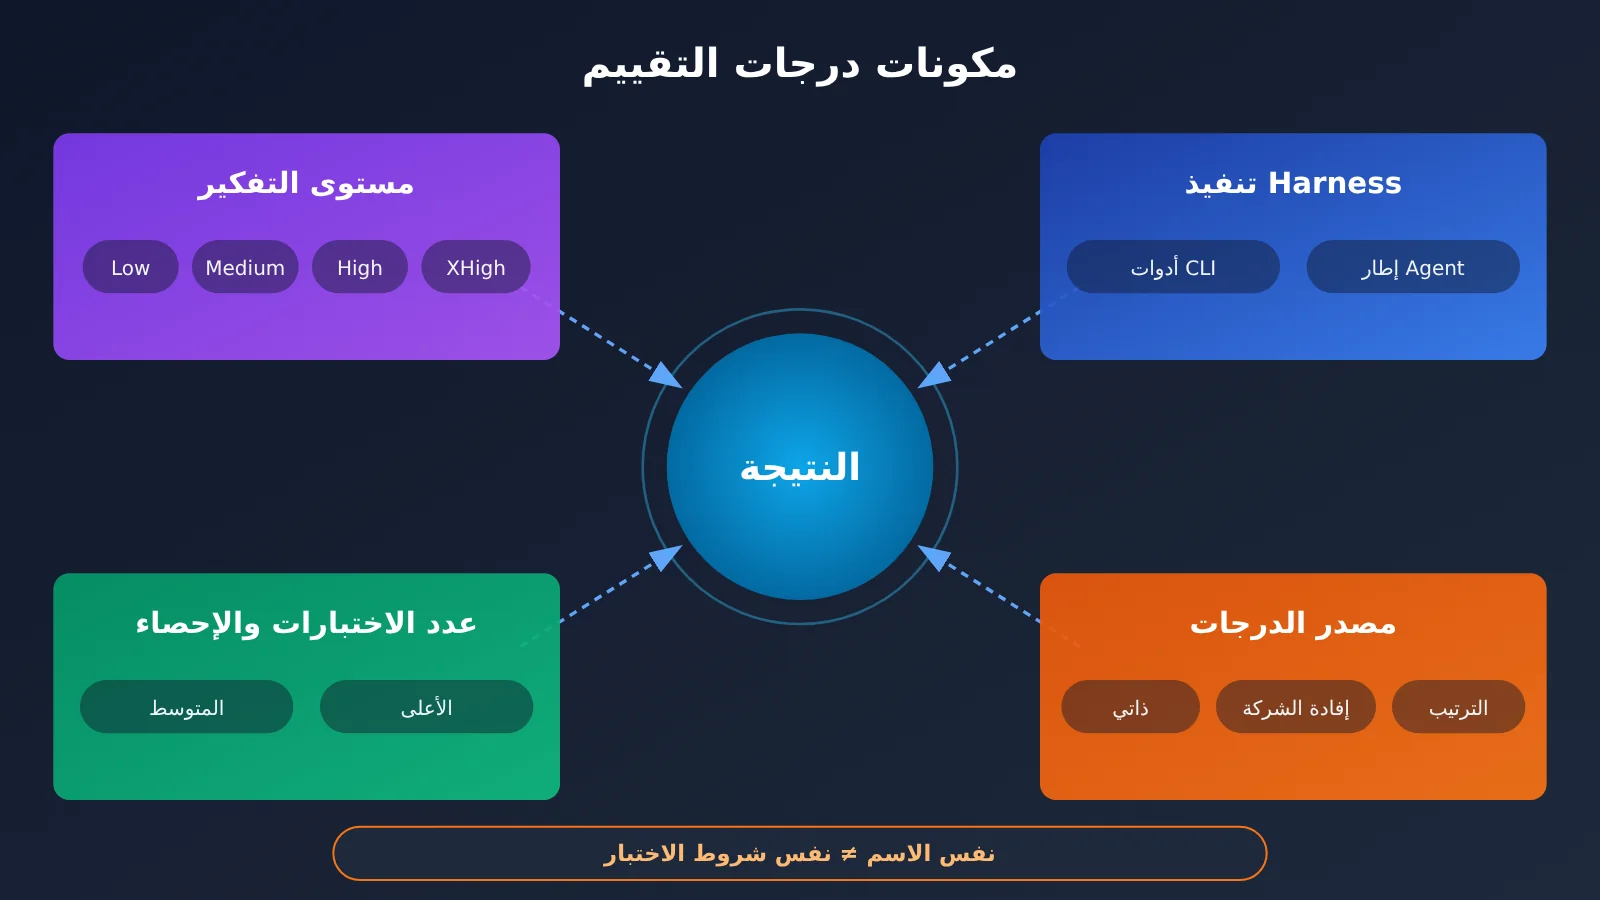
تأثير مستوى التفكير كبير بشكل خاص. أجرت Artificial Analysis في 12 نوفمبر تقييمًا مستقلًا للمستويات الأربعة من Hydrogen: جاء مؤشر الذكاء 27 عند Low، و41 عند Medium، و51 عند High (الافتراضي)، و54 عند XHigh؛ بينما تراوح متوسط تكلفة مهام التقييم المعيارية المقابلة بين $0.29 و$3.16. هذه نتائج مهامه المعيارية، وليست التكلفة الفعلية لكل استدعاء يقوم به المستخدم العادي، لكنها تكفي لبيان أن الفرق كبير جدًا بين مستويات النموذج نفسه؛ فـ XHigh لا يتفوق على High إلا بـ 3 نقاط، بينما ترتفع التكلفة بوضوح.
لذا، عند قراءة النتائج في هذا المقال تذكّر أمرين: أولًا، الاستنتاجات تخص فقط الاختبارات العامة المذكورة؛ ثانيًا، لا تجمع أكثر الأرقام ملاءمةً من جدول Google وبيانات OpenAI المعلنة ذاتيًا وبيانات Anthropic المعلنة ذاتيًا في «ترتيب إجمالي» واحد.
البدء السريع مع Gemini 4 Hydrogen: كود واحد لمقارنة ثلاثة نماذج
أكثر طريقة موثوقة لاختيار النموذج المناسب هي أن تُشغّل النماذج الثلاثة على مهامك الخاصة. يستخدم المثال التالي واجهة متوافقة مع OpenAI، وكل ما عليك هو تغيير المعامل model للتبديل بينها.
مثال مبسّط جدًا
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "اكتشف الخطأ في كود Python هذا واقترح أقل تعديل ممكن"}]
)
print(response.choices[0].message.content)
عرض الكود الكامل: سكربت مقارنة النماذج الثلاثة على نفس السؤال
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# معرّفات النماذج تُؤخذ من قائمة النماذج على المنصة؛ gemini-4-hydrogen هو المعرّف الرسمي لدى Google
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # معرّف توضيحي، تحقّق منه في لوحة التحكم
    "claude-sonnet-5.5",   # معرّف توضيحي، تحقّق منه في لوحة التحكم
]

def compare(prompt: str, system: str = "أنت مهندس خبير، عدّل الكود الضروري فقط"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("أصلح: الدالة ترمي IndexError عند تمرير قائمة فارغة ..."):
        print(r)
هناك عدة نقاط يجب الانتباه إليها عند الانتقال إلى Hydrogen: المعاملات المخصّصة مثل temperature وtop_p وtop_k سيتم تجاهلها؛ وthinking_budget وMINIMAL غير مدعومين؛ ومستوى التفكير الافتراضي هو High؛ واستدعاءات الأدوات في المحادثات متعددة الجولات تحتاج إلى إعادة إرسال thought signatures بشكل صحيح. وإذا كان وكيلك (Agent) يعتمد أصلاً على انخفاض درجة الحرارة للتحكم في الإخراج، فستحتاج إلى استخدام الإخراج المُهيكل (structured output) أو تعليمات أوضح لتقييد النتائج.
نصيحة: ابدأ باستخدام 10-20 تذكرة دعم حقيقية أو مهمة كمجموعة تقييم، ثم استدعِ النماذج الثلاثة كل واحد على حدة عبر منصة APIYI على apiyi.com، وسجّل في الوقت نفسه معدل النجاح والزمن المستغرق وعدد رموز (Tokens) الإخراج. يحصل المستخدمون الجدد على رصيد اختبار مجاني، مما يتيح لك إتمام تحقّق صغير النطاق قبل الشراء الرسمي.
Gemini 4 Hydrogen وTerra وSonnet 5.5: توصيات السيناريوهات ومصفوفة اختيار النموذج
سيناريوهات اختيار Gemini 4 Hydrogen
- إصلاح مشكلات قاعدة الشفرة وترقية التبعيات: يحقق أكبر تقدم في SWE-sweep، وقد ركزت الجهة المطورة رسميًا على تحسين التحرير الدقيق.
- الوكلاء متعددو الخطوات وأتمتة سير العمل: يتفوق في Agents’ Last Exam وAutomationBench-AA وVending-Bench 2.
- تحليل المستندات والرسوم البيانية المعقدة: يتفوق في MKA وChartography، ويدعم إدخال PDF ومستندات Office وغيرها من الصيغ المتعددة.
سيناريوهات اختيار Claude Sonnet 5.5
- المهام الهندسية الكثيفة في الطرفية: يتفوق في Terminal-Bench 4.1 وTerminal-Bench-Science 0.1.
- عمليات سطح المكتب وواجهة المستخدم الرسومية: يحقق OSWorld-2.1 أعلى نتيجة في جدول Google.
- المستندات الاحترافية وتصميم الواجهات: توجه تؤكد عليه Anthropic رسميًا.
سيناريوهات اختيار GPT-6.1 Terra
- المهام الضخمة الحساسة للتكلفة: السعر القياسي $1 / $5، وهو الأدنى بين الأسعار المعروفة للنماذج الثلاثة.
- الاستدلال البصري والأتمتة اليومية: يأتي Chartography في المرتبة الثانية، ويقترب Agents’ Last Exam من Hydrogen.
| نوع المهمة | الخيار الأول | البديل | حساسية التكلفة | اقتراح طريقة التنفيذ | قناة الوصول |
|---|---|---|---|---|---|
| صيانة قاعدة الشفرة وإصلاح الأخطاء | Hydrogen | Sonnet 5.5 | متوسطة | يعدّل Hydrogen الكود، ويتحقق Sonnet منه عبر الطرفية | واجهة موحدة عبر APIYI apiyi.com |
| تشغيل الطرفية والكود البحثي | Sonnet 5.5 | Terra | متوسطة | جلسة طويلة بنموذج واحد | نفس القناة |
| سير عمل وكيل متعدد الخطوات | Hydrogen | Terra | متوسطة | ابدأ بمستوى High، وارفع إلى XHigh عند الفشل | نفس القناة |
| عمليات سطح المكتب/المتصفح عبر GUI | Sonnet 5.5 | Hydrogen | منخفضة | مراقبة عبر لقطات الشاشة + أدوات تشغيل | نفس القناة |
| قراءة المخططات والمستندات | Hydrogen | Terra | متوسطة | بدون أدوات أو مع تعزيز الاسترجاع | نفس القناة |
| الأتمتة اليومية بكميات كبيرة | Terra | Hydrogen (Batch) | عالية | معالجة غير متزامنة بدفعات | نفس القناة |
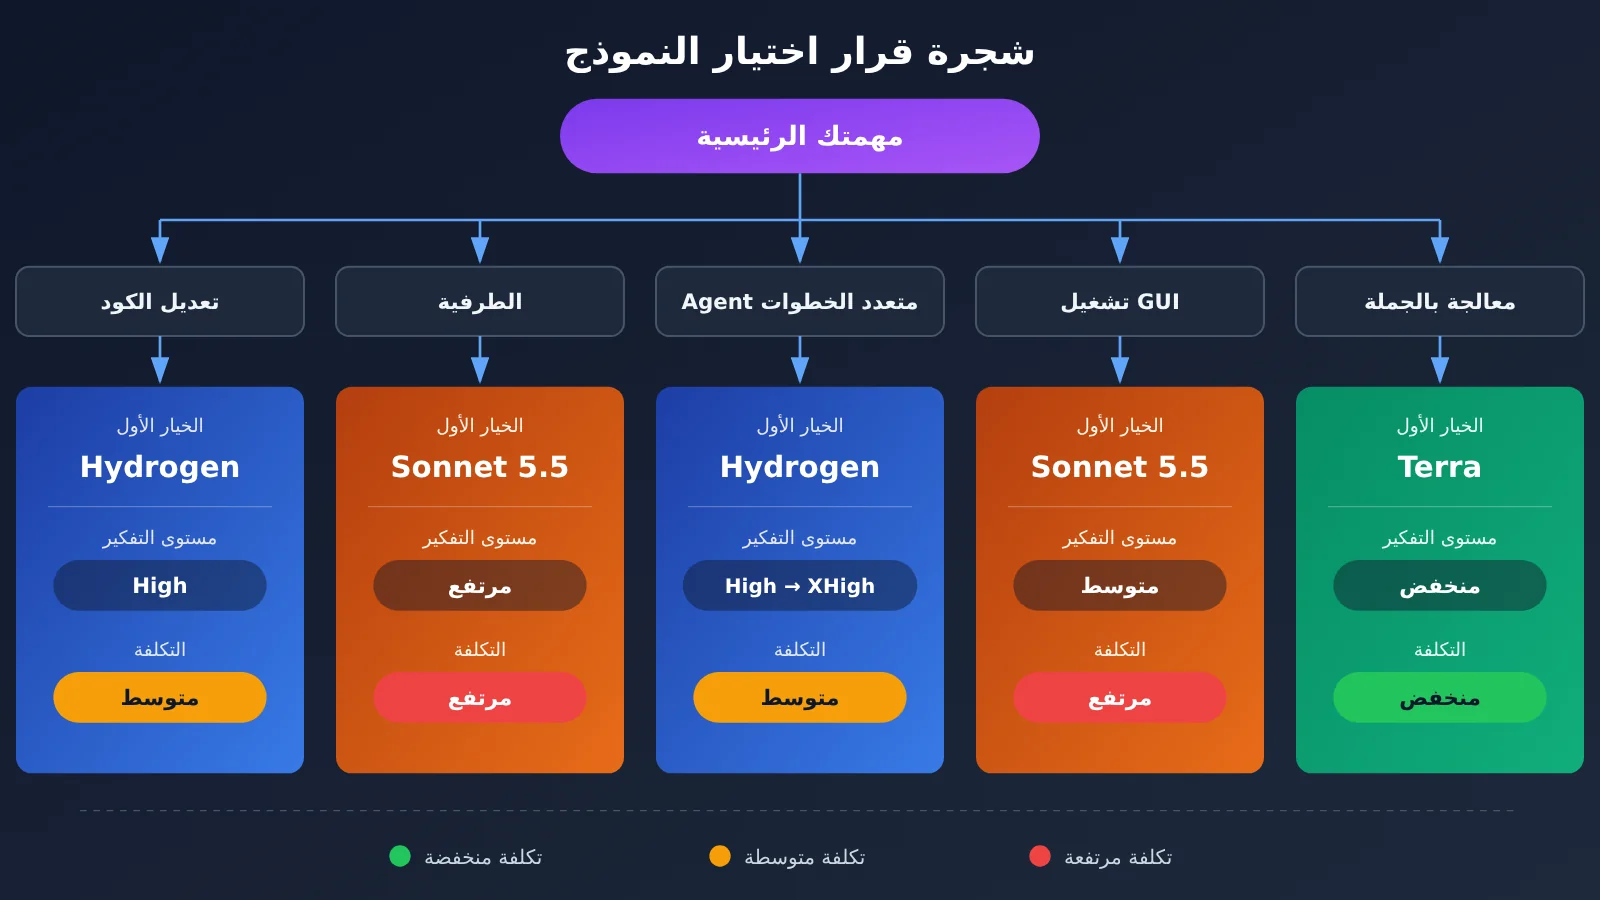
💡 توصية الاختيار: إذا كان لدى الفريق في الوقت نفسه احتياجات البرمجة وأتمتة GUI، فليس من الضروري الاعتماد على نموذج واحد فقط، بل يمكن الرجوع إلى فكرة Google Antigravity Orchestrator لتقسيم العمل حسب المراحل. عبر APIYI apiyi.com، استخدم مفتاحًا واحدًا لاستدعاء عدة نماذج، ولا يتطلب تبديل التوجيه سوى تغيير معامل واحد.
الأسئلة الشائعة
س1: ما هو Gemini 4 Hydrogen؟
Gemini 4 Hydrogen هو نموذج عالي الكفاءة أطلقته Google DeepMind في 12 نوفمبر 2026، ومعرّف النموذج في API هو `gemini-4-hydrogen`، وهو موجّه للبرمجة اليومية وتشغيل الوكلاء. يدعم حصة سياق موحّدة تبلغ 1,048,576 توكن، ويوفّر أربع درجات للتفكير: Low وMedium وHigh وXHigh، والافتراضية هي High.
س2: أيّهما أقوى في البرمجة: Gemini 4 Hydrogen أم Claude Sonnet 5.5؟
الأمر يعتمد على نوع المهمة. يتقدّم Hydrogen بفارق واضح في اختبارات إصلاح قواعد الشفرة SWE-sweep؛ بينما يتقدّم Sonnet 5.5 في اختبارات التنفيذ الطرفي مثل Terminal-Bench 4.1 وTerminal-Bench-Science 0.1. لتعديل الشفرة اليومي يُفضَّل Hydrogen، وللهندسة الكثيفة في الطرفية يُفضَّل Sonnet.
س3: GPT-6.1 Terra لم يحصد أي مركز أول، فهل ما زال يستحق الاستخدام؟
الأمر يستحق النظر. في النتائج الثلاثية التي نشرتها Google في جدول واحد، لم يحقّق Terra فعلاً أعلى درجة في أي بند، لكنه قريب من Hydrogen في Agents’ Last Exam، ويحلّ ثانيًا في Chartography، كما أن سعره في API القياسي هو الأدنى. وبالنسبة إلى السيناريوهات الحساسة للتكلفة والتي تعتمد أساسًا على العمليات البصرية والأتمتة الروتينية، فهو مرشّح مهم.
س4: لماذا توجد نسختان لنتيجة Sonnet 5.5 في OSWorld: 80.1% و83.9%؟
نسبة 80.1% هي نتيجة اختبار جزئي أعلنتها Anthropic بنفسها، أما 83.9% فهي نتيجة اختبرتها Google وفق شروط محدّدة وأخذت أعلى نتيجة من عدة تشغيلات. شروط الاختبار مختلفة بينهما، لذا عند المقارنة يجب تثبيت مصدر واحد وعدم خلط المصدرين.
س5: كيف يمكن مقارنة هذه النماذج الثلاثة بسرعة عبر API؟
نوصي باستخدام منصة تجميع API تدعم نماذج متعددة:
1. زيارة APIYI على apiyi.com للتسجيل والحصول على مفتاح API؛
2. التأكد من معرّفات النماذج الثلاثة المتاحة في قائمة النماذج داخل لوحة التحكم؛
3. ضبط `base_url` في شفرة هذا المقال على `https://api.apiyi.com/v1`، ثم استدعاء كل نموذج على حزمة المهام نفسها.
توفّر APIYI واجهة متوافقة مع OpenAI مع احتساب الدفع حسب الاستخدام، ما يسهّل إجراء مقارنة أفقية ضمن سكربت واحد.
س6: ما القيود المعروفة لـ Gemini 4 Hydrogen؟
تشير بطاقة النموذج الرسمية إلى ما يلي: قد يظل ينتج هلوسات؛ ودرجات التفكير العالية ترفع زمن التنفيذ والتكلفة بشكل ملحوظ؛ والمعرفة متوقفة عند مارس 2026؛ ومؤشر الرفض غير المبرر تدهور بمقدار 5.57 نقطة مئوية مقارنة بـ 3.8 Flash؛ وتقرير السلامة الكامل لم يكن قد نُشر بعد عند التحقق. كما أشار بعض المطورين إلى أنه يميل إلى الإفراط في التنفيذ في بعض مهام الوكلاء. إضافة إلى ذلك، سعره القياسي لكل توكن يعادل ضعف سعر 3.8 Flash الحالي، ويمكن للمهام المنفّذة بالدفعات أن تنظر في وضع Batch.
Gemini 4 Hydrogen — النقاط الأساسية للمقارنة
- لا بطل شامل في البرمجة: Hydrogen بارع في إصلاح مستودعات الشيفرة، وSonnet 5.5 بارع في مهام التنفيذ عبر الطرفية.
- Hydrogen يتصدّر أتمتة الـ Agent: في اختبارات الـ Agent والأتمتة التي أوردتها Google، حقّق Hydrogen أعلى النتائج في جميعها.
- تشغيل الواجهات الرسومية لصالح Sonnet 5.5: على OSWorld-2.1 يتصدّر Sonnet بنسبة 83.9%، مع الانتباه إلى اختلاف معايير القياس.
- Terra يتفوّق في التكلفة والرؤية: سعره القياسي هو الأدنى، وأداؤه في فهم الرسوم البيانية ومهام الـ Agent المتخصصة ليس ضعيفًا.
- لا تخلط بين الإصدارات والمصادر: يجب الفصل بين Terminal-Bench 4.0 و4.1، وبين الأرقام المعلنة من المورّد واختبارات Google الذاتية.
- لمستوى التفكير تأثير كبير: الفرق في مؤشر الذكاء بين Hydrogen High وXHigh لا يتجاوز 3 نقاط، لكن التكلفة ترتفع بوضوح.
- اعتمد على إعادة الاختبار بمهامك الخاصة: يمكنك عبر APIYI apiyi.com وباستخدام مفتاح واحد اختبار النماذج الثلاثة أفقيًا.
الملخص
النقاط الأساسية لمقارنة Gemini 4 Hydrogen وGPT-6.1 Terra وClaude Sonnet 5.5:
- مجال البرمجة: يتصدّر Hydrogen في SWE-sweep، ويتصدّر Sonnet 5.5 في اختبارين من فئة الطرفية، ويقترب Terra من Sonnet في مهام الشيفرة البحثية.
- مجال الـ Agent: يتصدّر Hydrogen في الـ Agent متعددة الخطوات وأتمتة العمليات ومحاكاة التشغيل طويلة المدى، ويأتي Terra في المركز التالي مباشرة في المهام المتخصصة.
- تشغيل الحاسوب والوسائط المتعددة: يهيمن Sonnet 5.5 على تشغيل الواجهات الرسومية، ويتقدّم Hydrogen قليلًا في أعمال المعرفة متعددة الوسائط وفهم الرسوم البيانية.
تخبرك الاختبارات المنشورة بـ”من الأقوى في ظروف معيّنة”، وليس “من الأنسب لعملك”. والطريقة العملية للمقارنة هي تحديد مرشّح أو مرشّحين وفق مصفوفة الاختيار أعلاه، ثم إعادة اختبار صغيرة النطاق بمهامك الحقيقية ومستوى تفكير ثابت وسلسلة أدواتك.
نوصي بالتحقق السريع من النتائج عبر APIYI apiyi.com، فالمنصة توفّر حصة اختبار مجانية وواجهة موحّدة لنماذج متعددة، وهو ما يناسب الفرق لإتمام التقييم المقارن قبل الإطلاق الرسمي.
📚 المراجع
- مدونة Google الرسمية – Introducing Gemini 4 Hydrogen: إعلان الإطلاق وحالات الشركاء
- الرابط:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
الوصف: التصنيف الرسمي ونطاق القدرات وبيانات الاختبارات المبكرة
-
بطاقة نموذج Google DeepMind: جدول مقارنة التقييمات بين النماذج
- الرابط:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
الوصف: المصدر الرئيسي للبيانات الكمية في هذا المقال
-
ملف PDF لتقييم نموذج Google DeepMind: شرح تفصيلي لظروف تنفيذ الاختبارات
- الرابط:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
الوصف: بيئة التشغيل (Harness)، ومستويات التفكير، وعدد مرات التشغيل، ونتائج تكميلية مثل Vending-Bench 2
-
وثائق Google Cloud التقنية: مواصفات Hydrogen وإرشادات الترحيل
- الرابط:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
الوصف: حدود السياق، وسلوك المعاملات، وملاحظات التوافق
-
صفحة الأسعار في Google AI Studio: التسعير الرسمي لواجهة API
- الرابط:
aistudio.google.com/docs/pricing -
الوصف: أسعار أوضاع Standard وBatch وFlex وPriority
-
OpenAI – Introducing GPT-6.1 Terra: مواد إطلاق Terra
- الرابط:
openai.com/index/introducing-gpt-6-1-terra/ -
الوصف: النتائج المعلنة ذاتيًا في Terminal-Bench 4.0 وسعر API
-
Anthropic – Introducing Claude Sonnet 5.5: مواد إطلاق Sonnet 5.5
- الرابط:
anthropic.com/claude-sonnet-5-5 -
الوصف: النتائج المعلنة ذاتيًا في Terminal-Bench 4.0 وOSWorld 2.1
-
Artificial Analysis – Gemini 4 Hydrogen: تقييم مستقل لمستويات التفكير الأربعة
- الرابط:
artificialanalysis.ai/models/gemini-4-hydrogen - الوصف: مؤشر كل مستوى في Intelligence Index v5.0.1، والزمن المستغرق، والتكلفة
المؤلف: فريق APIYI التقني
التواصل التقني: مرحبًا بكم في التواصل معنا عبر الصفحة الرئيسية لموقع APIYI، ولمزيد من مواد دمج النماذج يمكنكم زيارة مركز الوثائق docs.apiyi.com