Note de l’auteur : le prix unitaire des tokens de Terra est 10 fois supérieur à celui de Luna, mais l’écart de précision varie de 4,7 à 18,7 points de pourcentage. À partir de tests réels menés par Plotly, DualEntry et OSWorld, cet article calcule le coût réel de « chaque résultat correct » dans les tâches automatisées en masse.
OpenAI a lancé GPT-6.1 Terra le 26 octobre 2026, un peu plus d’un mois après GPT-6 Luna. Leurs tarifs API diffèrent d’un facteur 10, mais dans les tests comparatifs indépendants, l’avance de Terra en précision varie de moins de 5 à près de 19 points de pourcentage. Pour les tâches automatisées en masse, cette différence de prix est-elle justifiée ? C’est la question qui revient le plus souvent chez les développeurs.
Ce comparatif ne repose pas sur de simples impressions. Plotly, DualEntry et Artificial Analysis ont publié leurs résultats dès le lancement de Terra, et OpenAI a également communiqué des données sur OSWorld 2.1, MMMU-Pro et le taux d’erreurs factuelles. Cet article rassemble ces données pour répondre à une question précise : combien de résultats réellement corrects obtient-on en dépensant plus ?
Ce que vous allez en retirer : vous saurez pour quels types de tâches en masse l’écart entre GPT-6.1 Terra et GPT-6 Luna est important, et pour lesquels il est presque inexistant. Vous trouverez aussi le code d’une solution hybride : « première sélection avec Luna + vérification par règles + recours à Terra en dernier ressort ».
GPT-6.1 Terra et GPT-6 Luna : l’essentiel en un coup d’œil
Les deux modèles appartiennent à la famille GPT-6, mais répondent à des besoins distincts. OpenAI présente Luna comme un modèle efficace pour les tâches bien définies, fréquentes et réalisées à grande échelle. Terra met l’accent sur le raisonnement visuel, la précision dans l’utilisation d’un ordinateur et la qualité naturelle de la rédaction. Il occupe une position intermédiaire entre Luna et Sol.
| Caractéristique | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Date de lancement | 22 septembre 2026 | 26 octobre 2026 |
| ID API | gpt-6-luna |
gpt-6.1-terra |
| Positionnement officiel | Tâches fréquentes, à grande échelle et aux règles claires | Raisonnement visuel, utilisation d’un ordinateur, tâches à plusieurs étapes |
| Contexte / sortie maximale | 1 050 000 / 128 000 tokens | 1 050 000 / 128 000 tokens |
| Intensité de raisonnement | 6 niveaux, de none à max ; medium par défaut | 6 niveaux, de none à max ; medium par défaut |
| Cas d’usage typiques | Classification par étiquettes, tri des e-mails, extraction de champs | Saisie de factures, mise en correspondance d’images de produits, manipulation d’interfaces |
Sur le papier, leurs caractéristiques sont presque identiques : ils acceptent tous deux du texte et des images en entrée et prennent en charge Structured Outputs, Function Calling, Responses API, Batch API, ainsi que des outils comme Web Search, File Search et Computer Use. Les vraies différences se situent à deux niveaux : le prix et les performances sur les tâches complexes.
À noter que le guide de sélection des modèles d’OpenAI ne dit pas « utilisez Luna pour les tâches en masse » ou « choisissez Terra si vous voulez de la précision ». Son conseil : tester les mêmes données réelles avec plusieurs configurations, puis retenir la moins coûteuse qui répond aux exigences de qualité. C’est le principe à garder en tête pour interpréter toutes les données de cet article.
Écart de prix API entre GPT-6.1 Terra et GPT-6 Luna
Voici les tarifs officiels de l’API OpenAI en mode Standard pour les contextes courts, en dollars par million de tokens :
| Poste de coût | GPT-6 Luna | GPT-6.1 Terra | Terra / Luna |
|---|---|---|---|
| Tokens d’entrée | $0.10 | $1.00 | 10 fois |
| Entrées en cache | $0.01 | $0.05 | 5 fois |
| Tokens de sortie | $0.50 | $5.00 | 10 fois |
| Écriture en cache pour 30 minutes | $0.125 | $1.25 | 10 fois |
| Entrée / sortie Batch | Environ $0.05 / $0.25 | Environ $0.50 / $2.50 | 10 fois |
Les tarifs des modes Batch et Flex sont environ deux fois moins élevés que ceux du mode Standard. Ceux du mode Fast sont environ deux fois plus élevés. Deux sources de frais passent facilement inaperçues. Premièrement, lorsqu’une requête dépasse 272 000 tokens en entrée, les entrées et les entrées en cache de toute la requête sont facturées au double, et les sorties à 1,5 fois le tarif habituel. Deuxièmement, des outils comme la recherche sur le Web ou le contrôle d’un ordinateur peuvent entraîner des frais supplémentaires. Les tokens de raisonnement, les nouvelles tentatives et les appels d’agent sur plusieurs tours font aussi varier la consommation réelle.
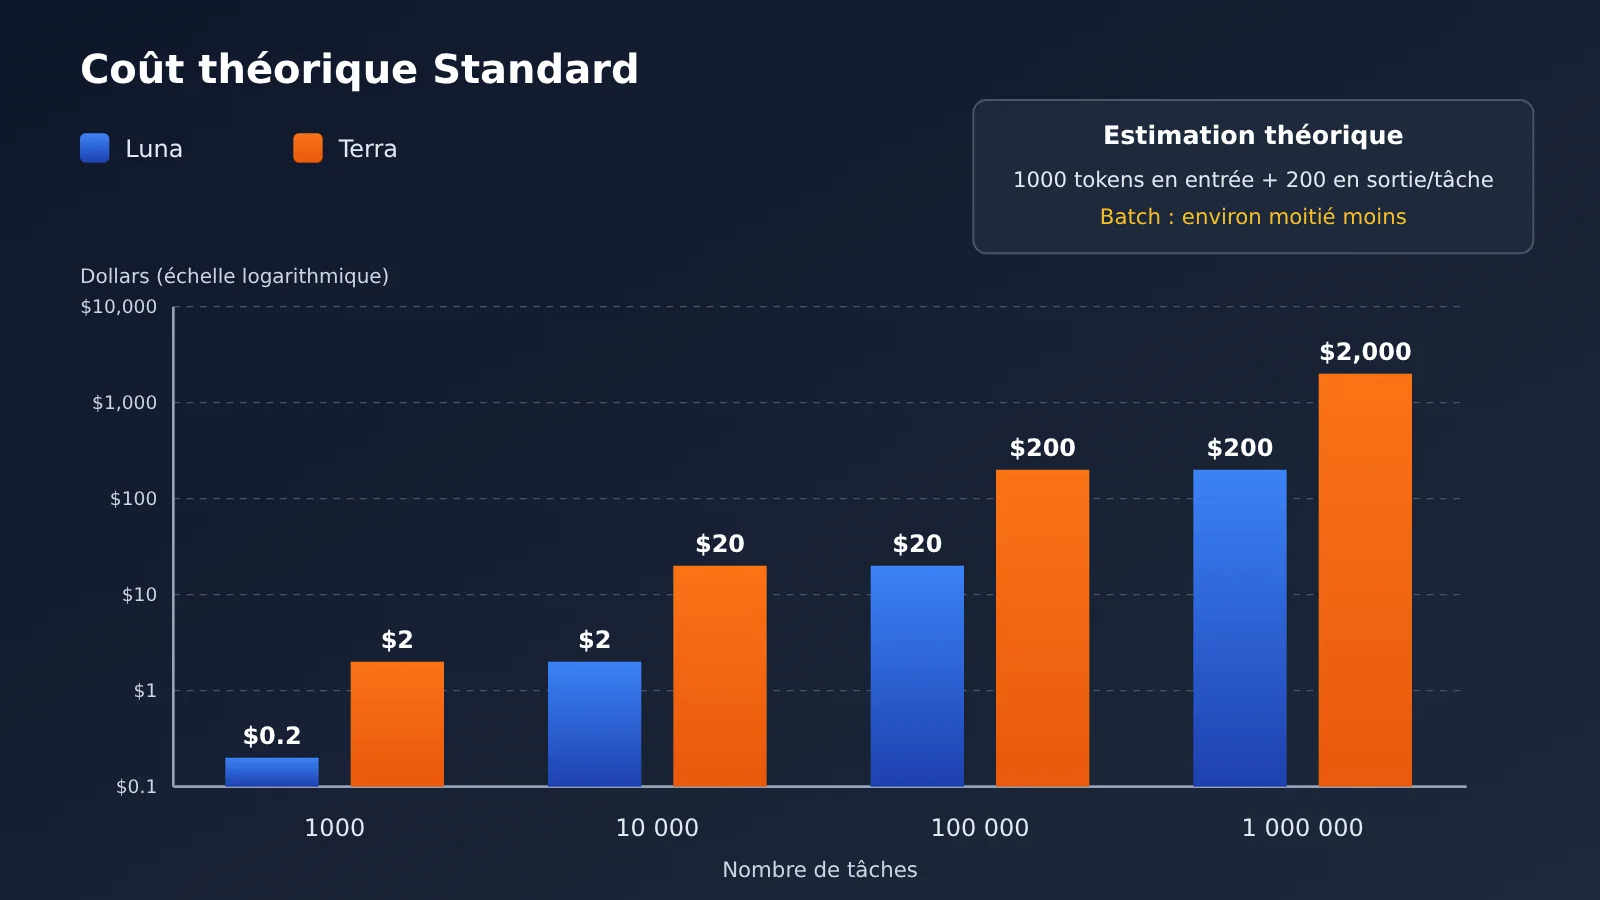
Ainsi, « 10 fois plus cher » désigne le prix unitaire des tokens dans des conditions de facturation identiques, et ne signifie pas que chaque tâche coûte 10 fois plus cher. Prenons un calcul théorique : pour 100 000 enregistrements de 1 000 tokens en entrée et 200 tokens en sortie chacun, sans cache ni nouvelle tentative, le coût en mode Standard serait d’environ $20 avec Luna et $200 avec Terra. En mode Batch, il serait d’environ $10 et $100. Il s’agit uniquement d’estimations fondées sur les tarifs publics, et non de factures relevées lors d’un test.
GPT-6.1 Terra face à GPT-6 Luna : données réelles de 4 séries de tests
Le prix unitaire indique seulement « combien ça coûte ». Il faut maintenant regarder ce qu’on obtient en échange. Les quatre séries de données ci-dessous proviennent d’organismes différents et portent sur des tâches variées. Elles montrent comment l’écart de précision évolue avec la difficulté.
43 questions d’analyse de données de Plotly : 10 fois plus cher pour 2 bonnes réponses de plus
DataAnalyticsBench, développé par des chercheurs de Plotly et de Mila, simule l’entrepôt de données d’un exploitant de parcs éoliens. Il contient environ 20 millions de lignes de données synthétiques. Les deux modèles ont répondu à 43 questions avec les mêmes outils. Voici les résultats :
| Indicateur | GPT-6 Luna | GPT-6.1 Terra |
|---|---|---|
| Bonnes réponses | 38/43 (88,4 %) | 40/43 (93,0 %) |
| Coût total du test | 0,13 $ | 1,31 $ |
| Temps médian par question | 18 secondes | 15 secondes |
| Analyse courante / questions ambiguës / demandes impossibles / qualité des données | Score parfait partout | Score parfait partout |
| Pièges statistiques | 3/5 | 4/5 |
| Détection de schémas cachés | 2/5 | 3/5 |
Les résultats par catégorie sont particulièrement instructifs. Les deux modèles font jeu égal sur l’analyse courante, l’identification des demandes ambiguës, le refus des requêtes impossibles à satisfaire et la détection des problèmes élémentaires de qualité des données. L’écart apparaît seulement dans deux catégories d’analyse approfondie : les pièges statistiques et la détection de schémas cachés. Terra obtient une bonne réponse de plus dans chacune.
D’après les résultats globaux, Terra coûte 1,18 $ de plus pour deux bonnes réponses supplémentaires, soit environ 0,59 $ par bonne réponse nette gagnée. Ce coût marginal est calculé à partir du total du test : ce n’est pas un tarif stable pour corriger une erreur en production. Si la question peut influencer une décision commerciale, 0,59 $ est un prix modeste. S’il s’agit simplement de repérer un schéma sans importance dans un rapport interne, payer 10 fois plus ne se justifie pas forcément.
Autre détail : Terra est plus rapide par question parce que ses réponses sont plus courtes et qu’il nécessite moins d’appels, pas parce qu’il génère plus vite. Il utilise en moyenne environ 4,5 invocations du modèle et produit quelque 1 460 tokens en sortie, à une vitesse d’environ 64 tokens par seconde. Attention toutefois : l’échantillon ne comprend que 43 questions, et Terra a été exécuté via OpenRouter avec la configuration de raisonnement par défaut. On ne peut donc pas en conclure qu’il atteint 93 % de précision dans toutes les analyses de données en entreprise.
DualEntry : un écart de 11,9 points sur 101 tâches comptables
L’Accounting AI Benchmark de DualEntry se rapproche davantage des opérations réelles. Ses 101 tâches couvrent huit catégories : classification des transactions, écritures comptables, comptes fournisseurs, comptes clients, rapprochement bancaire, reporting financier, clôture mensuelle et connaissances comptables. Chaque modèle passe trois fois le test ; une tâche n’est considérée comme réussie que si elle l’est au moins deux fois sur trois.
Luna obtient 66,3 %, Terra 78,2 % et GPT-6.1 Sol, utilisé comme référence, 81,2 %. Dans le détail, Terra réussit 13 tâches sur 13 en classification des transactions, 12 sur 13 en écritures comptables et 10 sur 12 en rapprochement bancaire. En revanche, il n’en réussit que 7 sur 13 pour les comptes fournisseurs, et 7 sur 12 aussi bien pour les comptes clients que pour la clôture mensuelle. DualEntry précise aussi que Terra et Luna sont ex æquo à la dernière place sur les comptes fournisseurs.
Pour l’automatisation à grande échelle, la régularité compte davantage que la précision sur un seul essai. Terra a réussi les trois essais pour 65,3 % des tâches, contre 68,3 % pour Sol. Le résultat de Luna est inférieur, mais le texte original ne donne pas de chiffre précis. Si une même tâche comptable est bien exécutée un jour et mal le lendemain, le coût des vérifications manuelles grimpe vite. Dans ce test, Terra a consacré en moyenne 16,1 secondes et environ 0,042 $ en jetons par tâche, soit environ 12,73 $ pour les trois passages. Le coût correspondant pour Luna n’étant pas clairement indiqué dans le texte original, nous ne l’estimons pas ici.
OSWorld 2.1 et taux d’erreurs factuelles : le plus grand écart se situe dans les tâches complexes
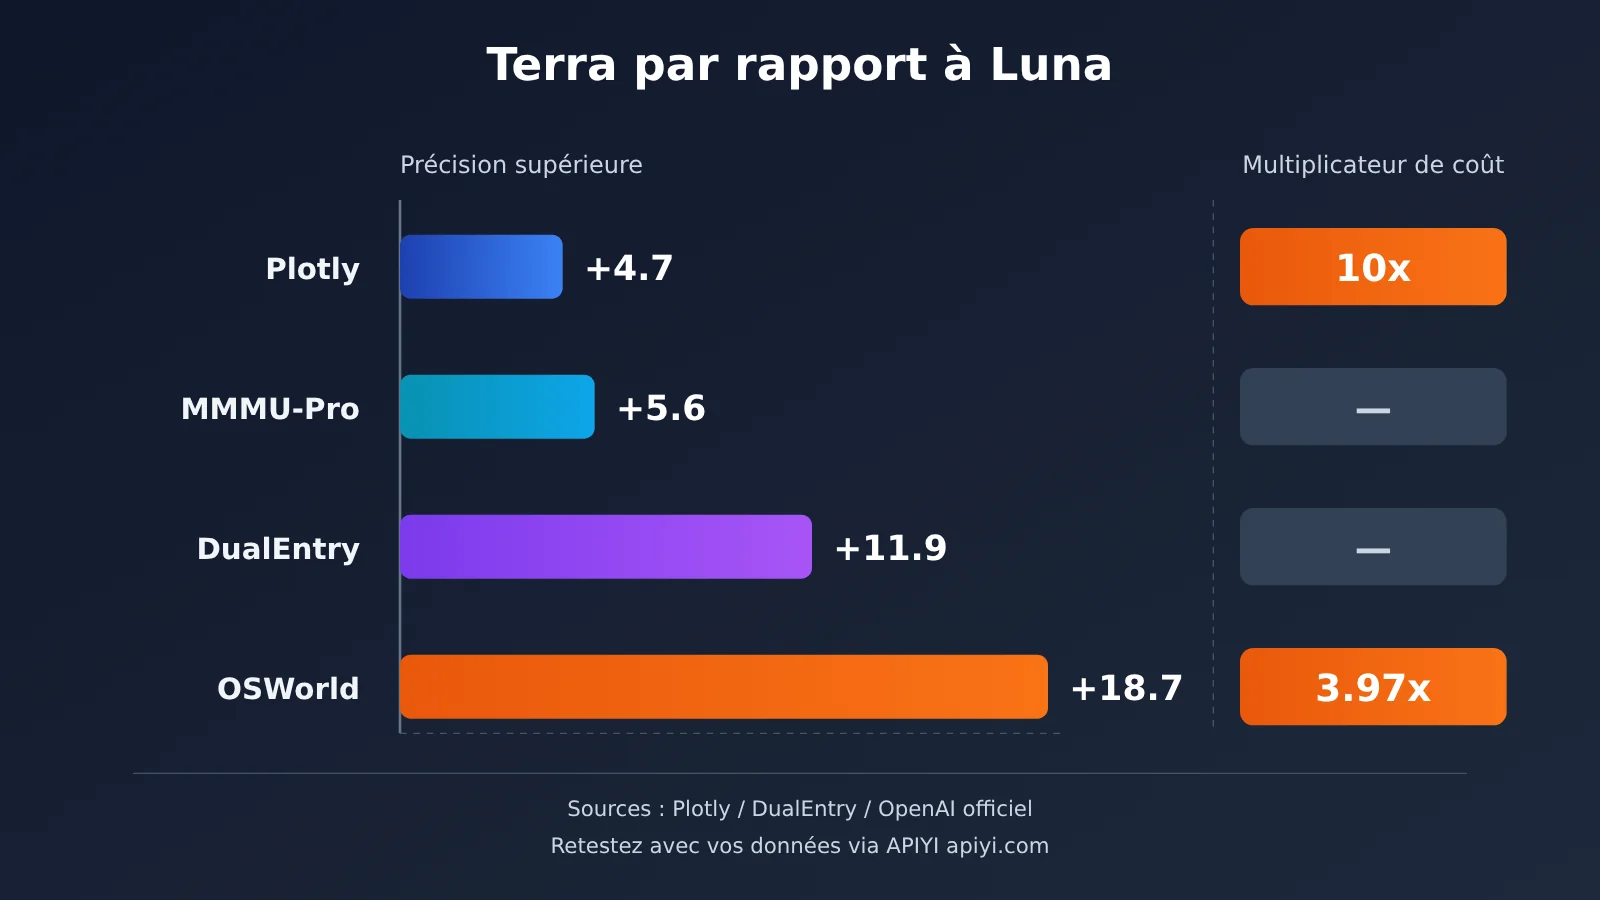
Dans l’annonce de Terra, OpenAI présente OSWorld 2.1, un benchmark qui évalue la capacité d’un modèle à comprendre une interface de bureau, à cliquer sur les bons boutons et à effectuer des opérations en plusieurs étapes. Au niveau de raisonnement maximal, Luna obtient 55,5 % et Terra 74,2 %, soit un écart de 18,7 points de pourcentage. Le coût estimé par tâche est respectivement de 0,30 $ et de 1,19 $ : il est donc environ 3,97 fois plus élevé, et non 10 fois. La raison : les deux modèles ne consomment pas le même nombre de tokens pour accomplir une même tâche.
Les résultats du test d’erreurs factuelles sont encore plus frappants. Sur des questions factuelles difficiles spécialement conçues par OpenAI, les taux d’erreur de Luna aux trois niveaux Low / Medium / Max sont respectivement de 44,3 %, 31,2 % et 18,4 %, contre 16,7 %, 10,1 % et 4,3 % pour Terra. Le taux d’erreur de Terra au niveau Low reste inférieur à celui de Luna au niveau Max. Pour la compréhension visuelle, au niveau de raisonnement maximal du test MMMU-Pro, Luna obtient 79,9 % et Terra 85,5 %.
Toutes ces données proviennent des graphiques officiels d’OpenAI, et non de tests indépendants réalisés par un tiers. Les questions factuelles difficiles sont spécialement conçues pour provoquer des erreurs : elles ne signifient pas que Luna commet 44,3 % d’erreurs dans ses rédactions courantes. De même, les scores OSWorld ne valent que dans les conditions du test.
Indice global d’Artificial Analysis : l’intensité du raisonnement compte aussi
Les évaluations indépendantes d’Artificial Analysis offrent un autre point de vue. Au niveau Max, Luna obtient environ 38 à l’indice d’intelligence globale, contre 48 pour Terra. Les coûts de référence correspondants sont d’environ 0,07 $ et 0,40 $, soit un rapport d’environ 5,7. L’écart est encore plus marqué pour l’indice des agents de programmation : 31 pour Luna, contre 48 pour Terra.
Mais le test de compréhension de documents longs AA-LCR fait figure de contre-exemple : les deux modèles atteignent environ 83 % avec le niveau de raisonnement maximal. Par ailleurs, Terra se situe sur la frontière de Pareto « coût-capacité » parmi les modèles testés par l’organisme aux niveaux Low et Medium, mais n’est pas nécessairement optimal au niveau Max. Autrement dit, pour automatiser des traitements en masse, il faut ajuster non seulement le modèle, mais aussi l’intensité du raisonnement.
Prise en main de l’automatisation par lots avec GPT-6.1 Terra et GPT-6 Luna
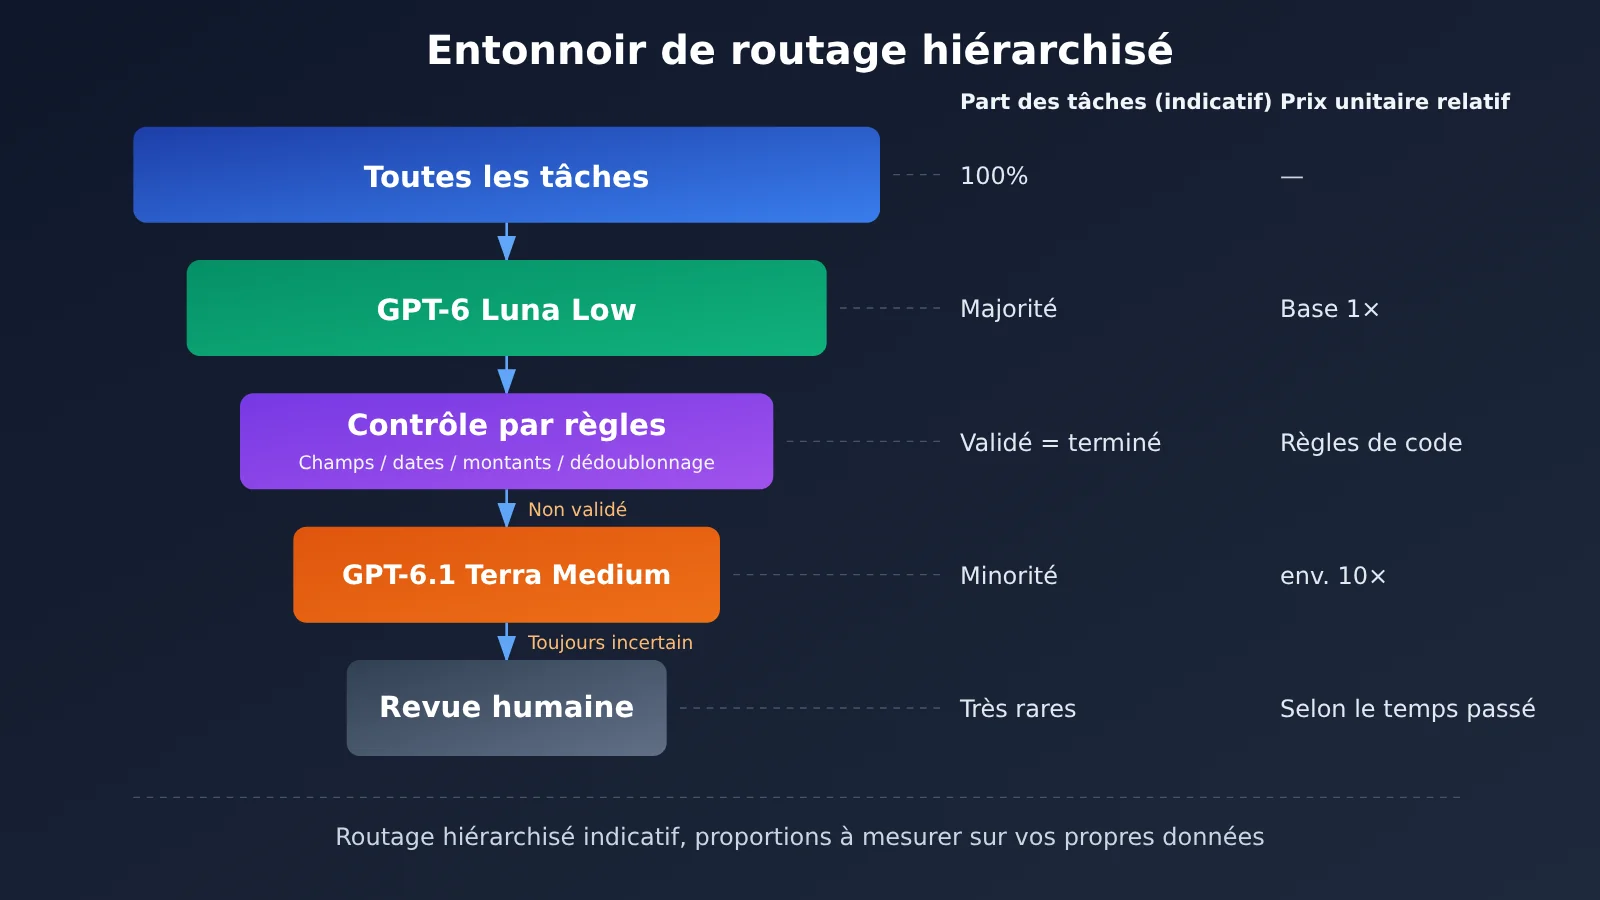
En réunissant les données présentées plus haut, on arrive à une conclusion pratique : confiez à Luna la plupart des tâches dont les règles sont claires, et réservez Terra aux tâches complexes, à haut risque ou qui n’ont pas passé la validation. Voici un exemple minimal exécutable : Luna extrait d’abord les champs d’une facture, puis le programme les vérifie. Si le résultat ne passe pas la validation, il est confié à Terra.
import json, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def extract(model, text, effort="low"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": f"抽取 JSON:amount, tax, total, date\n{text}"}])
    return json.loads(r.choices[0].message.content)

def valid(d):
    return all(k in d for k in ("amount", "tax", "total", "date")) and \
        abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) < 0.01

result = extract("gpt-6-luna", "发票:金额 100.00,税额 6.00,合计 106.00,日期 2026-10-20")
if not valid(result):
    result = extract("gpt-6.1-terra", "...", effort="medium")
print(result)
Voir le code complet du routage à plusieurs niveaux
import json
import re
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

PROMPT = "从以下文本抽取 JSON,字段:amount, tax, total, date(YYYY-MM-DD)。缺失填 null。\n"

def call_model(model: str, text: str, effort: str = "low") -> Optional[dict]:
    try:
        resp = client.chat.completions.create(
            model=model,
            reasoning_effort=effort,
            response_format={"type": "json_object"},
            messages=[{"role": "user", "content": PROMPT + text}],
        )
        return json.loads(resp.choices[0].message.content)
    except Exception as e:
        print(f"[{model}] 调用失败: {e}")
        return None

def rule_check(d: Optional[dict]) -> list:
    """程序化规则校验:结构化输出只保证格式,不保证事实,所以必须二次校验"""
    if not d:
        return ["empty"]
    errors = []
    for k in ("amount", "tax", "total", "date"):
        if d.get(k) is None:
            errors.append(f"missing:{k}")
    if not errors:
        if abs(float(d["amount"]) + float(d["tax"]) - float(d["total"])) > 0.01:
            errors.append("sum_mismatch")
        if not re.match(r"^\d{4}-\d{2}-\d{2}$", str(d["date"])):
            errors.append("bad_date")
    return errors

def route(text: str) -> dict:
    # 第一层:Luna Low 处理全部输入
    d = call_model("gpt-6-luna", text, "low")
    if not rule_check(d):
        return {"data": d, "tier": "luna"}
    # 第二层:未通过校验的升级到 Terra Medium
    d = call_model("gpt-6.1-terra", text, "medium")
    errs = rule_check(d)
    if not errs:
        return {"data": d, "tier": "terra"}
    # 第三层:仍不确定的进入人工审核队列
    return {"data": d, "tier": "human_review", "errors": errs}

if __name__ == "__main__":
    samples = [
        "发票号 A001,金额 100.00 元,税额 6.00 元,价税合计 106.00 元,开票日期 2026-10-20",
        "收据:总计一百零六元整,含税,十月二十日",
    ]
    for s in samples:
        print(route(s))
🚀 Pour commencer rapidement : la recommandation officielle est de tester d’abord les deux modèles avec une même clé API, puis de les essayer sur vos propres échantillons. APIYI apiyi.com propose une interface compatible avec OpenAI : il suffit de changer le paramètre
modelpour passer degpt-6-lunaàgpt-6.1-terra. Les nouveaux utilisateurs disposent d’un crédit d’essai gratuit, pratique pour mener une première comparaison à petite échelle.
La deuxième étape est essentielle dans cette approche. Ne considérez pas une réponse comme correcte simplement parce que Luna affirme en être sûr : le niveau de confiance déclaré par le modèle n’est pas forcément fiable. Privilégiez des règles vérifiables : manque-t-il des champs ? Les dates sont-elles valides ? Les montants correspondent-ils ? Les champs clés sont-ils fidèles au texte d’origine ? Y a-t-il des doublons ?
Analyse de l’impact de GPT-6.1 Terra et de GPT-6 Luna
Impact pour les développeurs : répartir les tâches selon leur type
En tenant compte du positionnement officiel et des tests ci-dessus, voici un point de départ pour choisir un modèle selon les tâches courantes à traiter en masse. Ces recommandations reposent sur des évaluations publiques : elles ne signifient pas que tous ces cas d’usage ont déjà été testés. Avant la mise en production, validez donc votre choix avec vos propres données.
| Cas d’usage | Recommandation initiale | Pourquoi | Plateformes disponibles |
|---|---|---|---|
| Étiqueter 100 000 articles | GPT-6 Luna | Les règles sont claires et les résultats peuvent être vérifiés par échantillonnage ; les deux modèles obtiennent le score maximal en analyse courante sur Plotly | APIYI apiyi.com, OpenAI officiel |
| Saisir des données depuis des captures de factures ou de commandes | GPT-6.1 Terra | Ses capacités visuelles et opérationnelles sont supérieures, mais les montants doivent toujours être vérifiés par programme | APIYI apiyi.com, OpenAI officiel |
| Résumer chaque jour l’actualité de l’IA | Luna pour le premier tri + Terra pour l’analyse approfondie | Luna se charge de la déduplication et de l’étiquetage, Terra évalue l’importance des informations | APIYI, OpenAI officiel |
| Trier les courriels du service client et préparer des brouillons | Principalement Luna | Les demandes à risque élevé, comme les réclamations et les remboursements, sont transmises à un niveau supérieur ou à un agent humain | APIYI, OpenAI officiel |
| Modifier des pages web et du code en masse | Terra ou Sol | Indice des agents de programmation : 48 pour Terra, 31 pour Luna | APIYI, OpenAI officiel |
Un autre point que les développeurs peuvent facilement négliger est le débit autorisé. Dans le palier Build indiqué par OpenAI, Luna est limité à 2 millions de tokens par minute et à 20 millions de tokens dans la file Batch, contre respectivement 1 million et 3 millions pour Terra. Dans le palier Launch, les limites sont de 10 millions et 1 milliard pour Luna, contre 4 millions et 200 millions pour Terra. Pour les tâches en masse de plus de 100 000 éléments, Luna permet donc de placer beaucoup plus de données en file d’attente. Il s’agit toutefois de plafonds autorisés, pas de vitesses de génération, et les limites peuvent varier selon le compte.
Impact sur le secteur : du « prix unitaire » au « coût par résultat conforme »
Le jour du lancement de Terra, deux avis se sont dégagés sur Reddit. Pour certains, Terra occupe une position inconfortable : Luna est déjà suffisamment bon marché, tandis que Sol est plus performant. D’autres soulignent que le taux d’erreurs factuelles de Terra Low est déjà inférieur à celui de Luna Max et qu’il ne faut pas regarder uniquement le prix unitaire. Des utilisateurs de Codex rapportent aussi que Terra, avec une intensité de raisonnement élevée, ne consomme pas nécessairement moins de quota que Sol à intensité moyenne. De leur côté, des utilisateurs de Luna constatent que les corrections à refaire sur des tâches de développement complexes annulent l’avantage de son quota. Il s’agit toutefois de cas individuels. De plus, le quota d’un abonnement Codex et la facturation des tokens API sont deux choses différentes : on ne peut pas s’en servir pour estimer les frais d’API.
Ces retours pointent néanmoins vers une même tendance : pour évaluer l’automatisation à grande échelle, on passe de la question « combien coûte une invocation ? » à « combien coûte chaque résultat conforme ? ». Une formule simple permet de le comprendre :
Coût total = coût des appels API + coût des outils + coût des nouvelles tentatives + coût de la vérification humaine + pertes dues aux erreurs
Luna a un avantage net sur les deux premiers postes, tandis que Terra réduit les trois derniers grâce à son taux d’erreur plus faible. Le choix le plus rentable dépend donc du coût d’une erreur dans votre activité. Les observations de MultiAI sur un petit échantillon vont dans le même sens : lorsque le raisonnement est désactivé, Terra commet des erreurs sur certaines tâches de logique et de calcul, mais ses résultats s’améliorent nettement en mode Medium. Luna se débrouille bien sur les tâches simples, mais commet davantage d’erreurs sur les raisonnements en plusieurs étapes.
Comment mener votre propre test comparatif
Les données publiques ne répondent pas encore à plusieurs questions essentielles : quel est le taux d’erreur des deux modèles sur 100 000 articles réels en chinois à classer ? Quelle est leur stabilité sur la durée ? Combien une approche mixte permet-elle réellement d’économiser ? Les économies sur la vérification humaine peuvent-elles compenser le surcoût de Terra ? Pour le savoir, il faut faire vos propres tests.
Une approche pratique consiste à préparer 200 à 500 exemples issus de vos activités, accompagnés de réponses de référence : par exemple, 100 cas chacun pour la classification simple, l’extraction d’informations clés et l’identification de contenus complexes, puis 50 cas chacun pour la vérification des faits et les opérations impliquant plusieurs étapes et outils. Testez ensuite quatre configurations — Luna Low, Luna Medium, Terra Low et Terra Medium — avec les mêmes entrées, invites, outils et critères d’évaluation. Répétez certaines tâches plusieurs fois pour observer la stabilité des résultats.
Concentrez-vous enfin sur cinq indicateurs : le taux de précision, le coût API pour 1 000 éléments, le temps moyen et le temps au 95e centile (P95), le nombre de vérifications et de reprises manuelles, ainsi que le coût global pour 1 000 résultats conformes. Si vous passez par une plateforme tierce, tenez également compte de ses règles de facturation réelles et vérifiez les conditions de traitement des données et les exigences de conformité.
Questions fréquentes (FAQ)
Q1 : Quelle est la principale différence entre GPT-6.1 Terra et GPT-6 Luna ?
Leurs caractéristiques sont presque identiques : tous deux disposent d’une fenêtre de contexte de 1 050 000 jetons et prennent en charge les mêmes outils. Luna coûte 10 fois moins cher à l’unité et convient aux tâches fréquentes dont les règles sont claires. Terra est nettement plus performant en compréhension visuelle, en manipulation d’ordinateurs, en analyse complexe et en exactitude factuelle. Il convient donc mieux aux tâches à plusieurs étapes où les erreurs coûtent cher.
Q2 : Terra coûte 10 fois plus cher. Sa précision est-elle à peine supérieure ?
Cela dépend du type de tâche. Dans le test d’analyse de données Plotly, son avance n’est que d’environ 4,7 points de pourcentage. Elle atteint 11,9 points pour les tâches comptables DualEntry et 18,7 points pour les opérations sur ordinateur dans OSWorld. De plus, dans OSWorld, le coût par tâche n’est supérieur que d’environ 3,97 fois, et non systématiquement de 10 fois.
Q3 : En réglant l’intensité de raisonnement de Luna sur max, peut-on remplacer Terra ?
Cela peut améliorer certaines performances, mais ne suffit pas à combler l’écart de capacité entre les modèles. Sur les questions factuelles difficiles du test officiel, Luna Max affiche un taux d’erreur de 18,4 %, toujours supérieur aux 16,7 % de Terra Low. De plus, augmenter l’intensité de raisonnement accroît la consommation de jetons et peut faire perdre à Luna son avantage en matière de coût.
Q4 : Comment comparer rapidement les deux modèles via l’API ?
Le plus simple est d’utiliser le même code et de changer le nom du modèle :
1. Rendez-vous sur APIYI, apiyi.com, pour vous inscrire et obtenir une clé API ainsi qu’un crédit de test gratuit
2. Définissez base_url sur `https://api.apiyi.com/v1`
3. Exécutez le même ensemble d’échantillons avec `gpt-6-luna` et `gpt-6.1-terra`, puis relevez la précision et la consommation de jetons
Q5 : Comment réduire davantage les coûts pour les tâches à grande échelle ?
Pour les tâches qui n’exigent pas de réponse en temps réel, privilégiez Batch API : son tarif est environ deux fois moins élevé que celui de Standard et OpenAI prévoit un délai de traitement de 24 heures. Limitez aussi chaque entrée à 272 000 jetons pour éviter la majoration liée aux contextes longs. Sur APIYI, apiyi.com, la facturation à l’usage permet également de commencer par un petit lot pour mesurer la consommation réelle de jetons par tâche avant de passer à plus grande échelle.
Q6 : Quelles sont les limites de ces résultats de test ?
Le test Plotly ne compte que 43 questions et utilise des données synthétiques. Les résultats OSWorld, MMMU-Pro et les taux d’erreur factuelle proviennent d’OpenAI et n’ont pas été vérifiés par des tests indépendants. Les scores MultiAI de 24/24 et 18/18 ne reposent pas sur les mêmes questions et ne peuvent donc pas être comparés directement. Enfin, Structured Outputs garantit uniquement la conformité du format, pas la véracité du contenu des champs. Aucun score de référence ne peut être assimilé à la précision réelle dans votre activité.
GPT-6.1 Terra et GPT-6 Luna : les points clés
- Un prix 10 fois plus élevé : Luna coûte 0,10 $ en entrée et 0,50 $ en sortie, contre 1,00 $ et 5,00 $ pour Terra
- Peu d’écart sur les tâches simples : les deux modèles obtiennent le score maximal en analyse courante avec Plotly et en identification des questions ambiguës
- Un écart important sur les tâches complexes : Terra mène de 11,9 points sur les tâches comptables et de 18,7 points sur les opérations sur ordinateur
- Des différences de précision factuelle : Terra Low affiche un taux d’erreur de 16,7 %, inférieur aux 18,4 % de Luna Max
- L’intensité du raisonnement compte aussi : Terra Low et Medium offrent un meilleur rapport coût-efficacité que le niveau Max
- Le routage par niveaux est le plus rentable : premier tri avec Luna, validation par des règles, recours à Terra si nécessaire, puis vérification humaine
- Testez avant la mise en production : comparez quatre configurations sur APIYI apiyi.com avec 200 à 500 de vos propres échantillons
Conclusion
Pour revenir à la question du titre, le choix entre GPT-6.1 Terra et GPT-6 Luna pour l’automatisation à grande échelle dépend de la difficulté des tâches et du coût des erreurs :
- Tâches aux règles claires et vérifiables automatiquement : Luna est un point de départ économique. Dans les tests Plotly, les deux modèles obtiennent les mêmes résultats en analyse courante.
- Reconnaissance visuelle, opérations en plusieurs étapes, finance et autres tâches à risque élevé : le surcoût de Terra peut se justifier, avec une avance en précision pouvant atteindre 18,7 points de pourcentage.
- Le véritable objectif d’optimisation : ce n’est pas le prix d’un appel API, mais le coût total par résultat conforme, y compris les nouvelles tentatives, les vérifications et les pertes dues aux erreurs.
Pour la plupart des équipes, mieux vaut ne pas choisir exclusivement l’un ou l’autre : laissez Luna traiter la majorité des tâches simples et confiez les plus difficiles à Terra. Commencez par une comparaison à petite échelle avec vos propres échantillons métier, puis définissez la proportion de tâches à envoyer à chaque modèle.
Vous pouvez passer par APIYI apiyi.com pour vérifier rapidement les performances des deux modèles sur vos cas d’usage. Une seule clé permet de passer d’un modèle à l’autre et la facturation à l’usage facilite le calcul précis du coût pour mille tâches.
📚 Références
- OpenAI : Introducing GPT-6.1 Terra : annonce officielle, avec des graphiques sur OSWorld, MMMU-Pro et le taux d’erreurs factuelles
- Lien :
openai.com/index/introducing-gpt-6-1-terra -
À retenir : positionnement officiel de Terra et source des résultats de benchmark
-
OpenAI API Pricing et pages des modèles : tarifs, capacités et limites de débit de Luna et Terra
- Lien :
developers.openai.com/api/docs/pricing -
À retenir : source des tarifs Standard, Batch, Flex et Fast
-
Documentation OpenAI Batch API : coûts et délais de traitement par lots
- Lien :
developers.openai.com/api/docs/guides/batch -
À retenir : réduction des coûts pour les tâches asynchrones à grande échelle
-
Plotly : GPT-6.1 Terra Benchmark Results for Data Analysis : 43 tests d’analyse de données réalisés dans les mêmes conditions
- Lien :
plotly.com/blog/gpt-6-1-terra-plotly-data-analytics-bench -
À retenir : taux de réussite, coûts, durée et résultats par catégorie
-
DualEntry : GPT-6.1 Terra Accounting Benchmark : test portant sur 101 tâches comptables
- Lien :
dualentry.com/blog/gpt-6-1-terra-accounting-benchmark -
À retenir : taux de réussite, catégories de tâches et stabilité sur trois séries de tests
-
Artificial Analysis : évaluation de GPT-6.1 Terra : indice d’intelligence global et rapport performance-coût
- Lien :
artificialanalysis.ai/models/releases/gpt-6-1-terra - À retenir : résultats de tests indépendants selon différents niveaux d’effort de raisonnement
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI. Retrouvez d’autres ressources sur l’intégration des modèles dans le centre de documentation docs.apiyi.com.