Note de l’auteur : cet article s’appuie sur la présentation publique du YC Paper Club Harness Night pour en tirer une méthode d’évaluation de modèles directement applicable, afin d’aider les équipes à déterminer si un écart de score vient du modèle ou du Harness.
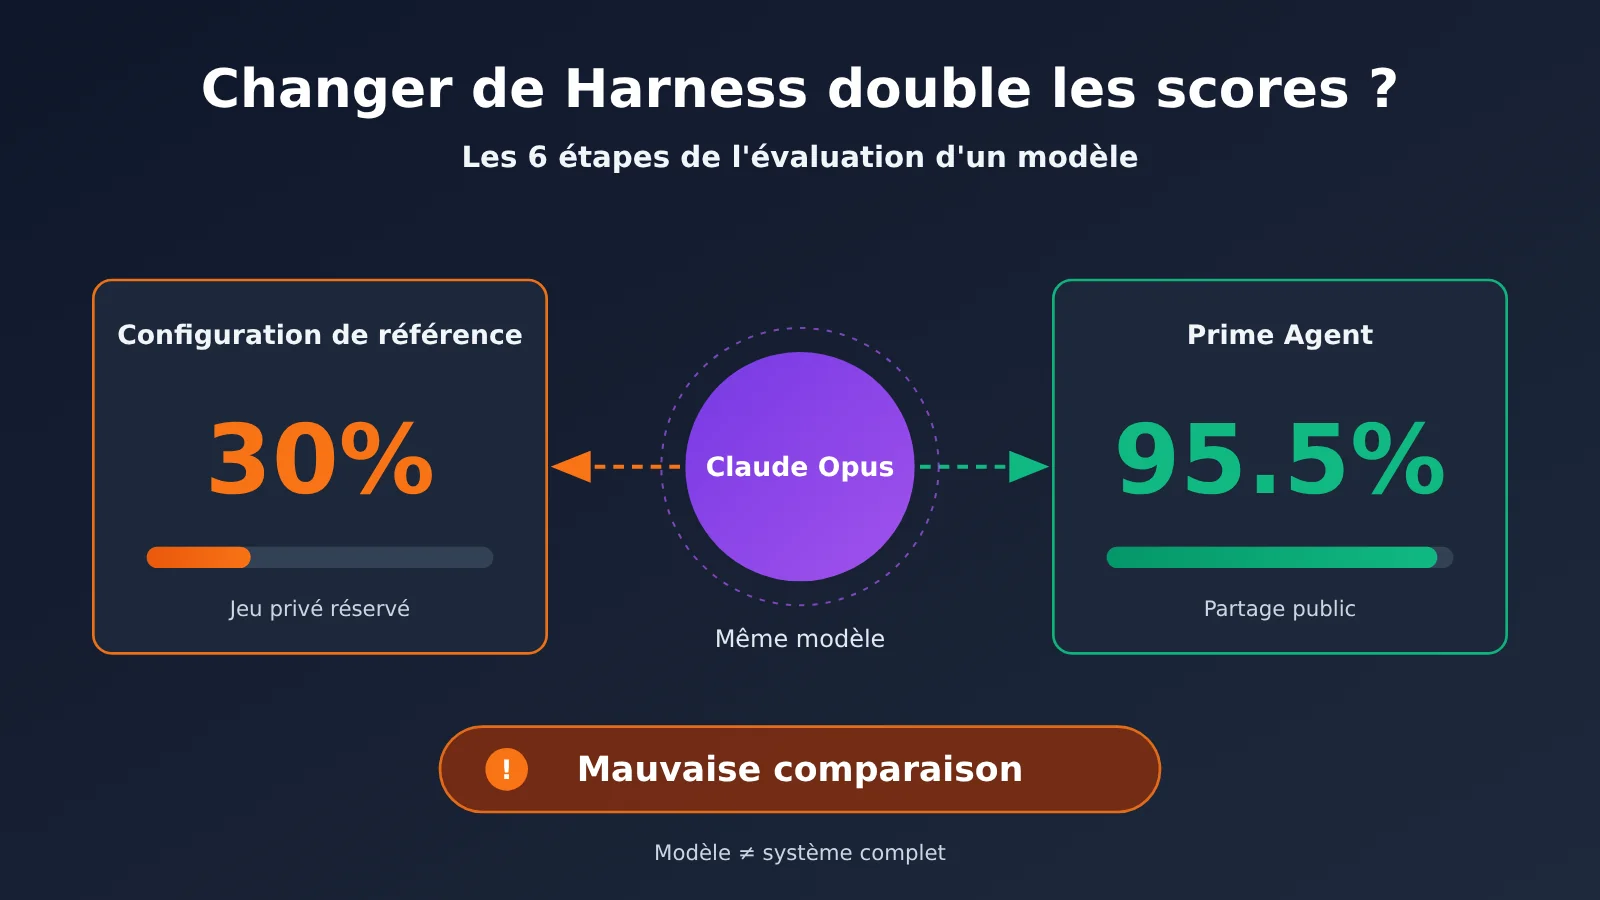
Le même Claude Opus obtient au mieux 30 % sur un jeu de données privé mis de côté ; une fois intégré à Prime Agent, le score annoncé dans la présentation publique grimpe à 95,5 %. Si l’on ne regarde que les classements, on pourrait croire à une transformation radicale du modèle. Mais ces chiffres rappellent d’abord une chose : une évaluation de modèle compare souvent tout un système, pas seulement le modèle.
Cet article n’a pas pour but de vous faire abandonner les classements, ni d’affirmer qu’un Harness peut faire grimper indéfiniment le score de n’importe quel modèle. Aucun test indépendant n’a été refait ici : les résultats cités proviennent tous du contenu de la conférence compilé par InfoQ. L’objectif est de transformer cette expérience en un processus d’évaluation concret.
Ce que vous allez y gagner : à la fin de cet article, vous saurez concevoir en 6 étapes une expérience comparative entre modèle et Harness, identifier l’origine d’un écart de score et aboutir à une conclusion de choix technologique plus fiable.
Changer de Harness et doubler les scores : les points clés de l’évaluation des modèles
Le Harness est une couche système entre le LLM et le monde extérieur, chargée de fournir un état persistant, des outils et de la puissance de calcul. Seth Karten utilise une analogie : un LLM nu ressemble à une machine de Turing, tandis que le Harness ressemble à un ordinateur de von Neumann capable de lire et d’écrire dans une mémoire externe. Quand on évalue un Agent, la capacité de raisonnement du modèle et la puissance d’expression de cette couche système influencent toutes les deux le résultat.
Le tableau ci-dessous rassemble une partie des données publiques liées à ARC-AGI citées dans la présentation. Ces scores proviennent de modèles, de Harness ou de configurations d’évaluation différents : on ne peut pas les utiliser directement comme un classement des modèles.
| Configuration | Score public | Ce qu’il faut garder en tête à la lecture |
|---|---|---|
| Claude Opus, validation sur ensemble privé réservé | Meilleur score 30% | C’est la référence de la présentation, elle ne représente pas toutes les conditions d’exécution |
| Prime Agent + Opus | 95.5% | Les documents ne détaillent pas toutes les différences avec la référence ; mieux vaut ne pas l’attribuer à une seule variable |
| Prime Agent + GPT-5.6 Sol | 78% | Score obtenu après isolation complète du bac à sable |
| Prime Agent + GPT-5.6 Terra | 25.7% | Avec le même Harness, l’écart entre modèles reste net |
| Nvidia AVO | 100% | La présentation ne donne que le résultat ; il faut vérifier la configuration exacte avant de comparer |
La relation entre Harness et évaluation des modèles
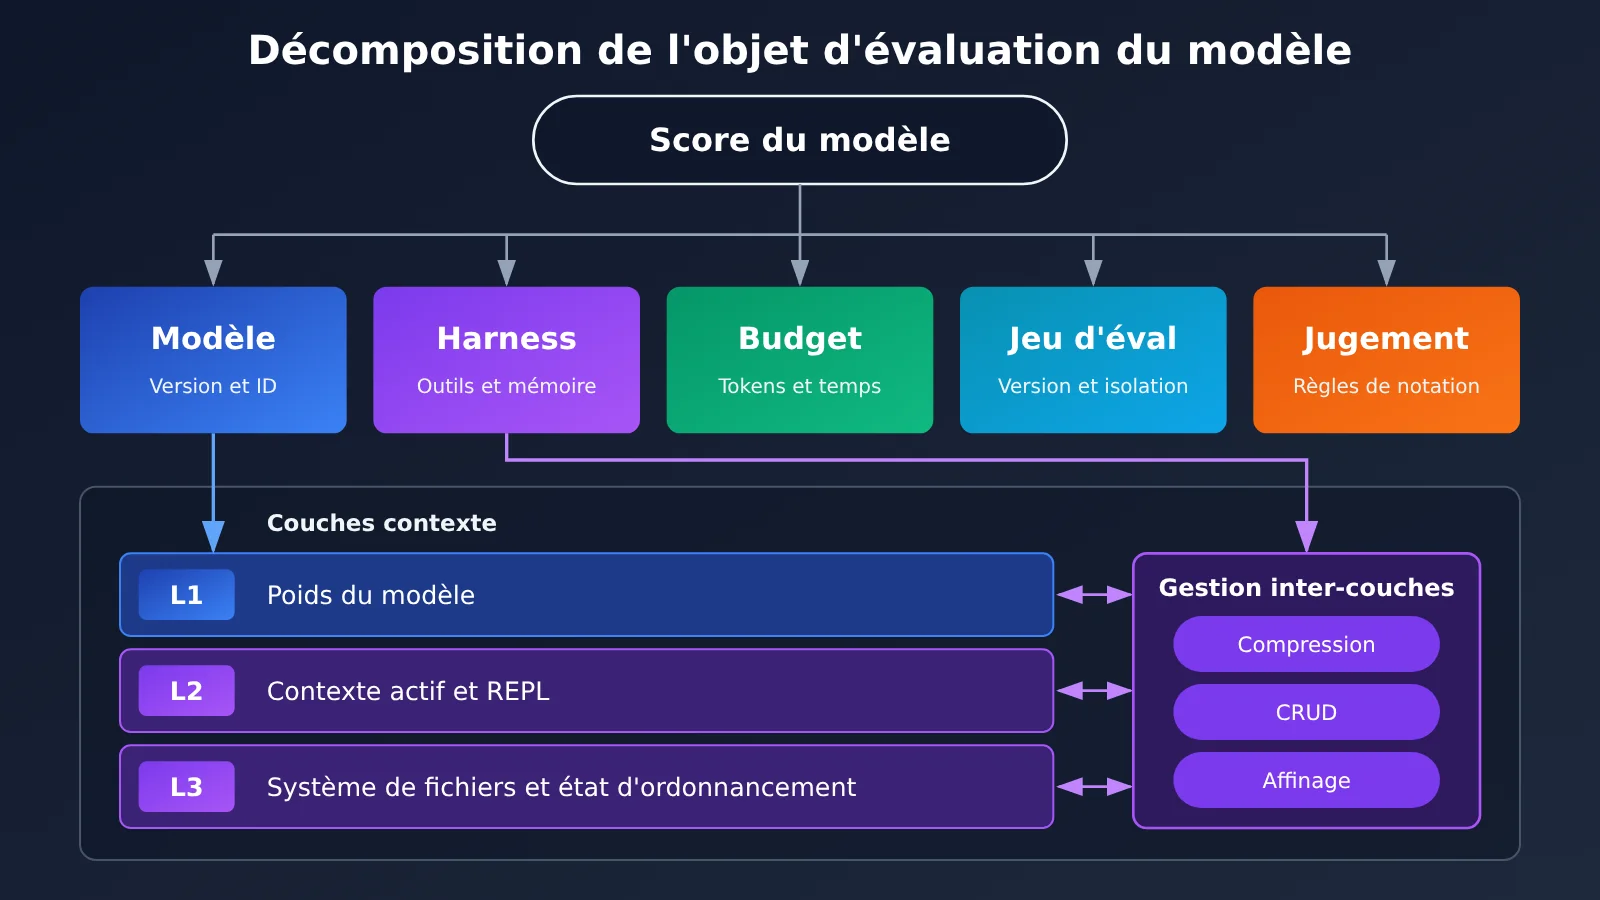
Prime Agent divise le contexte en trois couches : L1 correspond aux poids du modèle, L2 au contexte actif et au REPL, et L3 à l’état d’ordonnancement, comme le système de fichiers. Le Harness effectue entre les couches de la compression, des opérations CRUD et du refinement, un rôle proche d’un cache doublé d’un ramasse-miettes. Autrement dit, avec un même modèle mais un Harness différent, la mémoire et la puissance de calcul disponibles peuvent changer.
Cela ne signifie pas pour autant que le modèle n’a pas d’importance. Prime Agent se distingue sur ARC-AGI, mais sur des évaluations à long terme comme Oolong ou Emulator Bench, il fait surtout jeu égal ou légèrement mieux, et sur les tâches de noyau GPU, c’est globalement équivalent. Le type de tâche détermine dans quelle mesure le Harness peut amplifier les écarts, on ne peut donc pas extrapoler un score à tous les scénarios.
Les 5 variables les plus souvent mal comparées dans l’évaluation des modèles
| Variable | Comparaison erronée fréquente | Ce qu’il faut consigner |
|---|---|---|
| Modèle | Indiquer seulement le nom de la série, sans la version exacte | ID du modèle, journal des appels réels, cas de repli ou de bascule |
| Harness | Prendre la configuration par défaut pour la capacité du modèle | Outils, invite système, sous-Agents, mécanismes de mémoire et de compression |
| Budget | A tourne jusqu’au plateau, B s’arrête plus tôt | Tokens, temps réel, coût, conditions d’arrêt anticipé |
| Jeu d’évaluation | Comparer un score sur jeu public avec un score sur jeu privé | Version du jeu de données, méthode d’isolation, présence ou non de fuite d’information |
| Méthode de jugement | Laisser uniquement le LLM décider si le correctif ou la réponse est un succès | Règles de notation, proportion de contrôle humain, échantillons litigieux |
Conseil pratique : si vous voulez comparer plusieurs modèles dans un même processus d’évaluation, vous pouvez appeler les modèles cités dans cet article via APIYI apiyi.com, afin de réduire les différences d’intégration. APIYI est compatible avec les formats d’API OpenAI et Anthropic ; pour les noms de modèles exacts et les modalités d’accès, référez-vous à la documentation docs.apiyi.com.
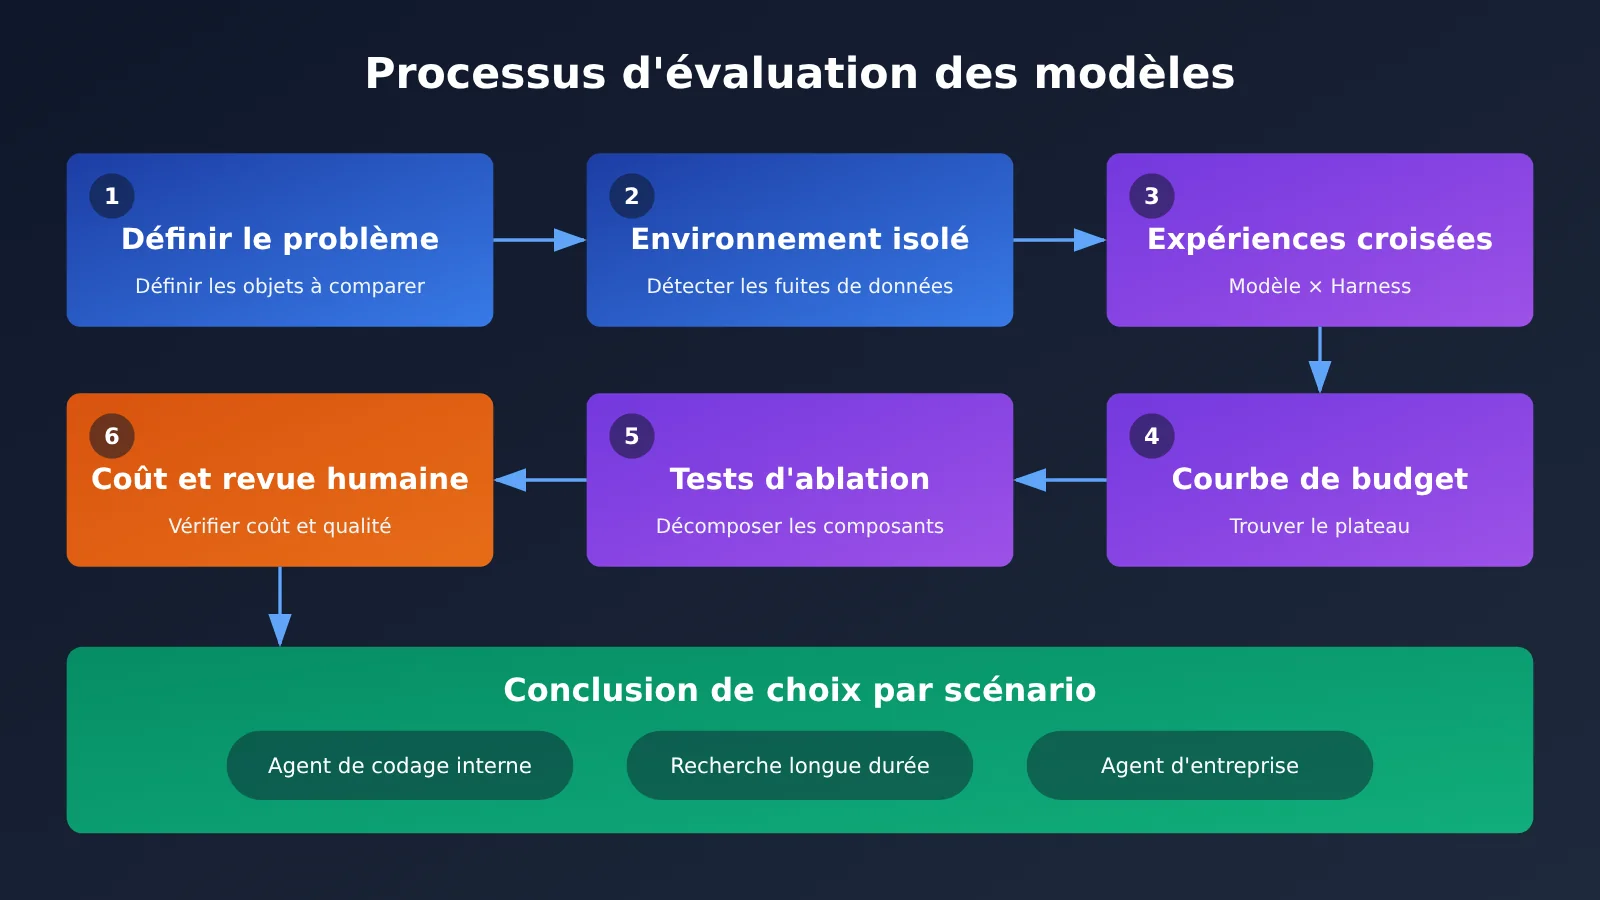
Prise en main rapide de l’évaluation de modèles avec Harness : 6 étapes
Le processus ci-dessous convient à la sélection de modèles, à la mise à niveau d’Agents et aux benchmarks internes. Pas besoin de construire dès le départ une énorme plateforme d’évaluation : commencez par consigner intégralement les variables, puis ajoutez progressivement des tâches et des modèles.
Étape 1 : Définir clairement l’objet de comparaison de l’évaluation
Commencez par formuler la question expérimentale en une phrase, par exemple « dans les mêmes conditions de Harness et de budget, comparer la capacité de deux modèles à réaliser des tâches de codage internes ». Si la question est posée comme « quel Agent est le meilleur », l’objet de comparaison devient la combinaison du modèle et du Harness, et la conclusion ne peut pas non plus être formulée comme « quel modèle est le plus fort ».
Les spécifications d’évaluation doivent au minimum fixer model, l’invite système, la liste d’outils, max_tokens, le nombre maximal de tours et le budget total. Si le Harness permet à l’Agent de choisir de manière autonome son environnement d’exécution, il faut aussi enregistrer le modèle réellement utilisé à chaque étape. La conception de QM permet justement à l’Agent de basculer vers un autre modèle lorsqu’il rencontre un refus ; à ce moment-là, le score final ne correspond plus à un seul modèle.
Étape 2 : isoler l’environnement et les données d’évaluation du Harness
Seth avait un jour glissé l’invite système du classement communautaire dans Prime Agent : au premier lancement, il a obtenu 99,9 %. En examinant les logs, il a compris qu’il trichait. Il a ensuite passé une journée à tout cloisonner dans un bac à sable, et le score de GPT-5.6 Sol est retombé à 78 %. Un score élevé n’est pas nécessairement faux, mais un score anormalement élevé doit toujours conduire à vérifier les logs en premier.
Trois points sont à surveiller lors de ce contrôle : l’Agent peut-il lire les réponses ou les résultats historiques ? L’invite contient-elle des informations propres au jeu d’évaluation ? Les appels d’outils dépassent-ils les permissions prévues ? Pour les tâches qui sortent des benchmarks publics, il faut aussi réserver un jeu d’échantillons de rétention qui ne participe pas au réglage, afin d’éviter que l’invite et le Harness ne fassent de l’overfitting.
Étape 3 : comparer avec une matrice « modèle × Harness »
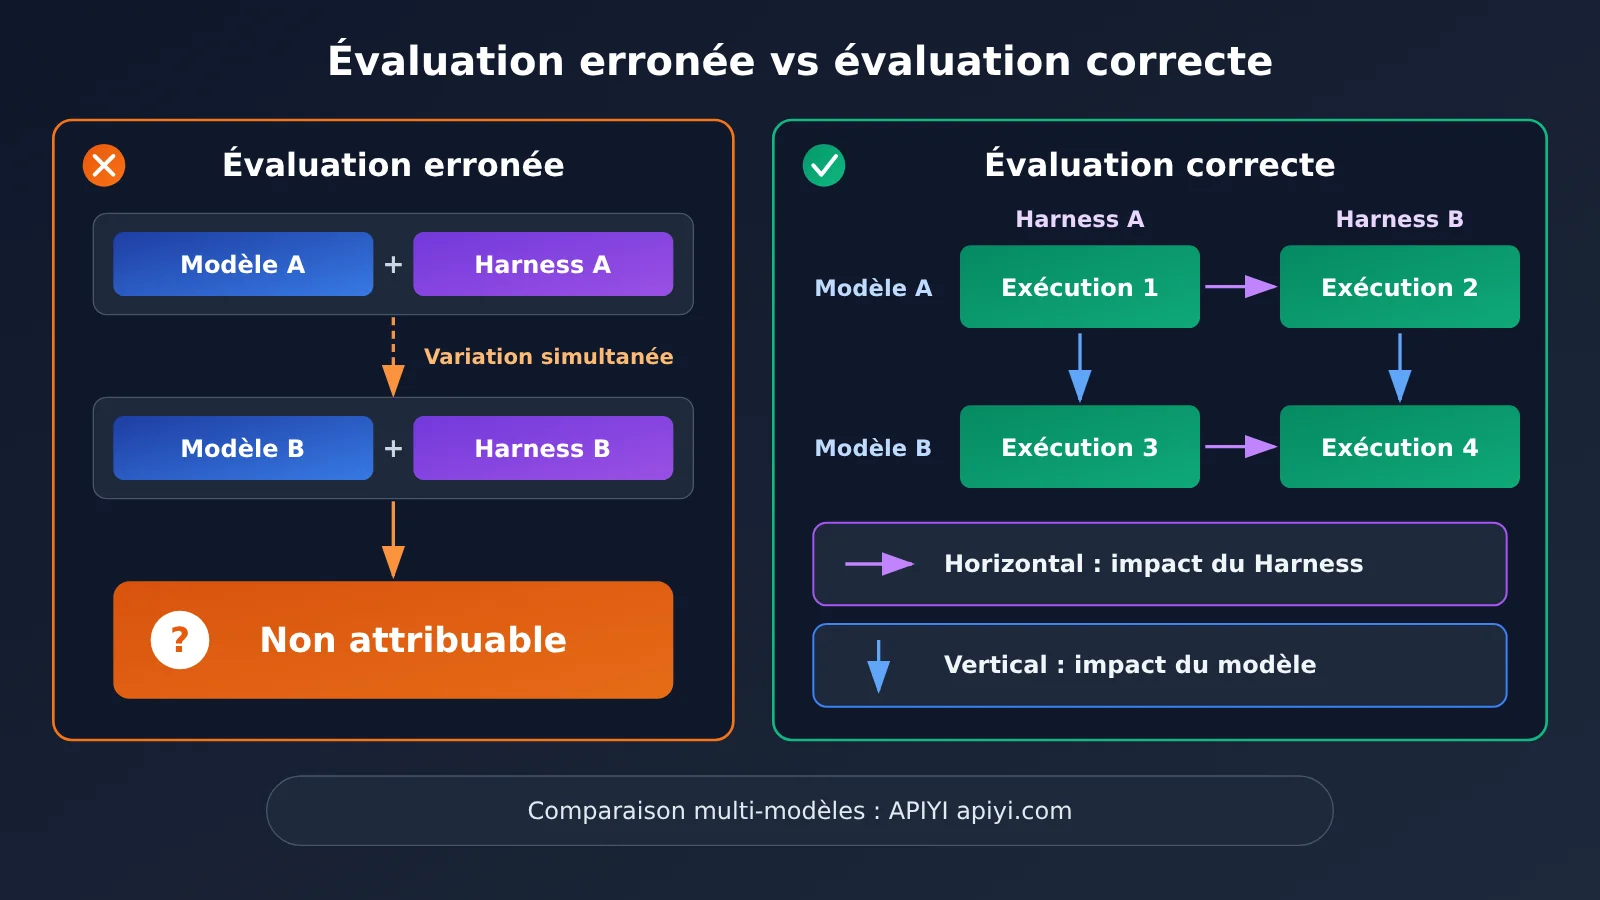
Ne vous contentez pas de lancer « modèle A + Harness A » puis « modèle B + Harness B » : deux variables changent en même temps, impossible d’attribuer l’effet. La solution minimale est une matrice 2 × 2 : deux modèles exécutés chacun dans les deux Harness, avec un jeu de tâches et un budget identiques.
| Résultat de la matrice | Explication la plus probable | Action suivante |
|---|---|---|
| Le changement de modèle produit un écart net, le changement de Harness peu | La tâche actuelle dépend surtout des capacités du modèle | Prioriser la sélection du modèle |
| Le changement de Harness produit un écart net, le changement de modèle peu | Les capacités du système sont le principal goulot d’étranglement | Prioriser l’amélioration des outils et de la gestion du contexte |
| Les deux se croisent nettement | Il existe une relation d’adéquation entre modèle et Harness | Choisir par combinaison, sans écrire de classement unique |
| Aucun des deux ne change nettement | Tâche trop simple, trop difficile, ou notation peu sensible | Reconcevoir le jeu d’évaluation et les métriques |
Conseil pour les expériences contrôlées : une expérience matricielle impose de changer souvent de modèle. Vous pouvez passer par APIYI apiyi.com pour appeler différents modèles avec un compte et une configuration d’interface unifiés, et conserver l’ID du modèle dans le journal d’expérience pour faciliter la traçabilité ultérieure.
Étape 4 : Aligner le budget et observer le plateau de performance du modèle
Seth souligne dans sa présentation que si un modèle ne tourne pas assez longtemps, ou s’arrête une fois le budget épuisé tandis qu’un autre continue, non seulement vous ne comparez pas à dépense égale, mais vous masquez aussi les performances réelles. La meilleure approche consiste à définir plusieurs paliers de budget et à observer la courbe du score en fonction des tokens ou du temps.
L’expérience de l’équipe QM illustre aussi l’importance du budget. Ils ont constaté que l’Agent abandonnait souvent trop tôt, et ont donc essayé d’« affûter l’outil » : fixer un budget à l’objectif et interdire l’abandon avant d’avoir atteint un temps réel ou une consommation de tokens donnée. Résultat : les sorties de recherche se sont améliorées. La spécification d’évaluation doit donc non seulement indiquer le plafond de budget, mais aussi préciser s’il existe une exigence d’investissement minimal.
Étape 5 : Réaliser des tests d’ablation sur le Harness
Une fois constaté que le Harness apporte un gain, l’étape suivante consiste à identifier de quelle capacité il provient. Prime Agent met l’accent sur l’expressivité et considère que la compression, le REPL Python, les sous-agents programmatiques, l’accès à l’état et les mécanismes de feedback ne devraient pas être retirés à la légère. Mais dans votre tâche, la contribution réelle de chaque capacité doit encore être testée.
La méthode : désactiver une seule capacité à la fois — par exemple désactiver le REPL, les sous-agents ou la mémoire à long terme — en gardant le reste de la configuration inchangé. Si le score ne change pratiquement pas après désactivation alors que le coût baisse nettement, cette capacité ne mérite peut-être pas d’être conservée pour l’instant. Pour les tâches à forte variance comme la recherche automatisée, il faut répéter les exécutions plusieurs fois, car Seth mentionne aussi qu’il est difficile d’attribuer directement ces tâches au Harness ou au modèle.
Étape 6 : Calculer les coûts et intégrer une revue humaine
Seth mentionne aussi qu’en utilisant Hermes Agent pour ses évaluations, il a rapidement dépensé 5 000 dollars sans constater d’amélioration notable, et a dû interrompre. Cela ne représente pas la limite des capacités de Hermes Agent, mais suffit à montrer que le rapport coût/performance doit figurer dans les conclusions de l’évaluation. Le rapport final recommande de lister à la fois le taux de réussite, le temps de complétion, la consommation de Token et le coût par succès.
Lors du calcul des coûts, ne figez pas les prix en dur dans la description du script d’évaluation. Pour les prix unitaires d’entrée et de sortie des modèles, les tarifs de cache et la base de facturation, référez-vous aux données réelles de la page tarifaire APIYI https://docs.apiyi.com/models, et indiquez la date de consultation dans le rapport.
L’étape de notation doit elle aussi conserver un échantillonnage humain. L’équipe QM a constaté que lorsqu’on demande à un LLM d’évaluer les résultats de correction, il développe un « syndrome du protagoniste » : il ne voit qu’une partie de l’éléphant, pas le système dans son ensemble. Lorsque des processus métier sont impliqués, il faut également tester les frontières des permissions, car l’Agent comprend mal les situations sociales, et des informations privilégiées peuvent fuiter dans des contextes où elles ne devraient pas apparaître.
Comment mettre en œuvre une matrice d’évaluation de modèles avec l’API
En pratique, il est recommandé de diviser l’évaluation en trois parties : le jeu de tâches, la configuration d’exécution et l’enregistrement des résultats. Ainsi, lorsque vous changez de modèle ou de Harness, il suffit de modifier un seul élément de configuration, sans réécrire tout le processus.
| Élément de configuration | Contenu recommandé à consigner | Remarques |
|---|---|---|
| Format d’interface | Compatible OpenAI ou format Anthropic | Les appels d’outils et la structure des messages peuvent différer selon le format ; à vérifier séparément |
| Adresse d’accès et clé | base_url, nom de la variable d’environnement |
L’adresse fait foi selon la documentation docs.apiyi.com ; ne pas inclure la clé dans le rapport d’évaluation |
| Paramètres d’exécution | model, max_tokens, nombre max de tours, nombre de répétitions |
Garantir la reproductibilité de chaque expérience |
| Base de calcul des coûts | Entrées, sorties, cache et date de consultation | Se baser sur les données réelles de la page tarifaire APIYI docs.apiyi.com/models |
| Résultats d’exécution | Score, cause d’échec, Token, durée, journaux d’appels | Pour analyser le plateau et le rapport coût/performance |
Si votre Harness prend en charge les deux formats d’interface, il est conseillé de réaliser d’abord une comparaison de formats avec le même modèle. Cela permet de confirmer que la conversion des messages, la définition des outils et le retour en streaming n’influencent pas les résultats, et d’éviter de confondre un problème d’intégration avec une différence de capacité du modèle.
Conseil d’intégration : APIYI fournit les appels API des modèles mentionnés dans cet article, compatibles avec les formats d’interface OpenAI et Anthropic. Avant de commencer l’expérience, vérifiez les modèles actuellement disponibles et la méthode d’appel sur docs.apiyi.com, puis inscrivez l’ID du modèle dans la spécification d’évaluation.
FAQ – Questions fréquentes
Q1 : Qu’est-ce qu’un Harness dans l’évaluation de modèles ?
Le Harness est la couche système qui relie le modèle au monde extérieur. Il comprend généralement le contrôle de boucle, la gestion du contexte, les outils, les sous-agents, la mémoire et l’accès à l’état. C’est lui qui détermine ce que le modèle peut voir, ce qu’il peut appeler, et combien de temps il peut fonctionner.
Q2 : Un score Harness plus élevé signifie-t-il que le modèle est devenu plus performant ?
Non. À poids constants, une amélioration du score indique plus probablement que le système libère davantage de capacités, ou que la configuration convient mieux à cette tâche. Si le Harness, le budget et le modèle changent en même temps, impossible d’attribuer la progression à un seul facteur — il peut aussi y avoir une fuite dans l’environnement d’évaluation.
Q3 : Quand faut-il refaire une évaluation de modèle ?
Il faut réévaluer dès que la version du modèle, l’invite système, les permissions des outils, la stratégie de compression ou les tâches métier changent. Le domaine des Harness évolue très vite : les données de cet article proviennent d’une synthèse publiée par InfoQ en novembre 2026, et les résultats pourraient donc évoluer par la suite.
Q4 : À quels scénarios cette méthode d’évaluation convient-elle ?
Elle convient principalement aux cas suivants :
– **Choix d’un agent de codage interne** : comparer le taux de réussite des combinaisons modèle + Harness.
– **Tâches de recherche longue durée** : observer le plateau et la variance des résultats lorsque le budget augmente.
– **Validation avant mise en production d’un agent d’entreprise** : tester en même temps la qualité, le coût et les limites de permissions.
Q5 : Comment intégrer rapidement plusieurs modèles pour comparer les Harness ?
Commencez par définir la tâche d’évaluation et la liste des modèles, puis passez par APIYI apiyi.com. La plateforme fournit l’accès API aux modèles cités dans cet article, avec une compatibilité avec les formats d’interface OpenAI et Anthropic. Pour les identifiants de modèles et les méthodes de configuration, consultez la documentation docs.apiyi.com, et gardez les autres variables inchangées pendant l’expérience.
Q6 : Comment rédiger les prix des modèles dans un rapport d’évaluation ?
Mieux vaut ne citer que des données tarifaires vérifiées, en précisant la date de consultation. Les prix d’entrée et de sortie, les tarifs de cache et les modalités de facturation doivent correspondre aux données réelles de la page tarifaire APIYI https://docs.apiyi.com/models, sans reprendre d’anciens tableaux ni des valeurs estimées.
Q7 : Quelles sont les limites de cette méthode d’évaluation Harness ?
Les expériences matricielles, les exécutions répétées et la relecture humaine augmentent le temps et le coût. La variance des tâches de longue durée peut aussi être élevée : même en contrôlant les principales variables, l’attribution précise reste difficile. Cette méthode sert donc plutôt à éclairer la décision ; il ne faut pas considérer un résultat isolé comme un classement absolu.
Points clés de l’évaluation des modèles avec Harness
- Définir d’abord l’objet de la comparaison : distinguer clairement si l’on compare les modèles eux-mêmes ou la combinaison modèle + Harness.
- Face à un score anormalement élevé, vérifier d’abord les journaux : dans 99,9 % des cas, un environnement isolé est un prérequis à l’évaluation.
- Isoler les variables avec une matrice : connecter plusieurs modèles via APIYI, puis réaliser une comparaison modèle × Harness.
- Aligner les budgets : observer la courbe à plusieurs niveaux de budget pour identifier le véritable plateau.
- Localiser la contribution par ablation : désactiver une capacité à la fois pour confirmer d’où vient l’amélioration.
- Vérifier les données de coût : les prix et les modalités de facturation font foi sur la page tarifaire d’APIYI.
- Conserver le jugement humain : l’évaluation par LLM peut être partiale, et les risques liés aux permissions nécessitent des tests dédiés.
Conclusion
« Changer de Harness et voir les scores doubler » mérite attention, mais cela ne doit pas être interprété simplement comme « les modèles ne comptent pas ». Les données partagées montrent à la fois l’effet amplificateur du Harness et le fait qu’il subsiste des écarts notables entre différents modèles et tâches ; des conclusions fiables doivent reposer sur des expériences contrôlées.
Pour passer à la pratique, retenez en priorité trois points :
- Définir clairement l’objet de l’évaluation : consigner le modèle, le Harness, le budget, le jeu d’évaluation et la méthode de jugement.
- Concevoir des expériences permettant l’attribution : utiliser des expériences matricielles et des tests d’ablation pour isoler les variables, et isoler l’environnement d’évaluation.
- Ancrer les conclusions dans le contexte : examiner simultanément le plateau, le rapport coût/performance, les résultats de la relecture humaine et les risques liés aux permissions.
Si vous souhaitez valider votre propre combinaison de modèles, vous pouvez accéder aux modèles présentés dans cet article via APIYI apiyi.com, puis terminer la configuration en suivant la documentation docs.apiyi.com. Pour les calculs de coûts, consultez https://docs.apiyi.com/models afin d’obtenir les données tarifaires actuelles.
📚 Ressources
- InfoQ : Le même modèle passe de 30 à 95 points — ce qui fait la différence n’est pas le modèle, c’est le Harness
- Lien :
infoq.cn/article/C1C1DThg8z1Dy0rZAmLB -
Description : les scores, les cas d’usage et les points de vue de conception cités dans cet article proviennent tous de cet article de synthèse.
-
Vidéo de la présentation YC Paper Club Harness Night
- Lien :
youtube.com/watch?v=n9xKblqyQ28 -
Description : permet de retrouver le contexte complet des trois interventions : Prime Agent, OpenJarvis et QM.
-
Centre de documentation APIYI
- Lien :
docs.apiyi.com -
Description : pour vérifier les modèles disponibles, le format des interfaces et la configuration d’intégration.
-
Page des tarifs des modèles APIYI
- Lien :
docs.apiyi.com/models - Description : le prix unitaire des modèles, le prix du cache et les modalités de facturation se basent sur les données réelles de cette page.
Auteur : équipe technique APIYI
Échanges techniques : pour découvrir comment intégrer les modèles, rendez-vous sur le site officiel d’APIYI, apiyi.com. Vous trouverez davantage de ressources dans le centre de documentation docs.apiyi.com.