작성자 주: Google DeepMind가 공개한 10개 교차 모델 평가를 바탕으로 Gemini 4 Hydrogen, GPT-6.1 Terra, Claude Sonnet 5.5가 프로그래밍, Agent 자동화, 컴퓨터 조작에서 보이는 강점과 약점을 해석하고, 작업별 선택 가이드를 제시합니다.
한 줄 요약: Google이 공개한 교차 모델 평가에 따르면, Gemini 4 Hydrogen과 Claude Sonnet 5.5는 서로 다른 프로그래밍 및 Agent 작업에서 각자 우위를 가지며, GPT-6.1 Terra는 비용과 시각 조작 포지셔닝에서 강점을 보입니다. 실제 선택은 테스트 조건, 작업 유형, 비용을 함께 고려해야 합니다.
To know: 이 글을 읽기 전에 알아야 할 5가지 용어
- Harness: 모델 입력, 도구 실행, 작업 채점을 조직하는 테스트 프레임워크입니다. 같은 모델이라도 Harness를 바꾸면 성적이 확연히 달라질 수 있습니다.
- 벤치마크 버전: 특정 평가의 데이터, 작업, 규칙 버전입니다. 예를 들어 Terminal-Bench 4.0과 4.1은 서로 다른 버전이며, 성적을 별도로 해석해야 합니다.
- Agent: 모델과 도구 실행 환경이 함께 다단계 작업을 완료하는 시스템입니다. 성적은 ‘모델 + 도구 체인’의 전체 성능을 반영합니다.
- Token: 모델이 텍스트 등 정보를 처리하는 계량 단위입니다. API 가격은 보통 백만 Token당 청구됩니다.
- API: 프로그램이 서비스를 호출하는 인터페이스입니다. 개발자는 이를 통해 모델을 자신의 애플리케이션이나 Agent에 연결합니다.
2026년 11월 12일, Google이 Gemini 4 Hydrogen을 정식 출시하며, 공식 모델 카드에서 GPT-6.1 Terra, Claude Sonnet 5.5와 같은 평가 표에 함께 올렸습니다. 이 표는 프로그래밍, Agent 자동화, 컴퓨터 조작, 멀티모달 지식 작업을 아우르며, 현재 세 모델에 대한 가장 집중적인 공개 횡적 데이터입니다.
이것은 ‘다들 장단점이 있다’는 식의 절충 분석이 아닙니다. 각 테스트가 무엇을 측정하는지, 어떤 조건에서 실행되었는지를 항목별로 분해한 뒤, 프로그래밍, Agent, 컴퓨터 조작 세 영역별로 결론을 제시하고, 마지막에 바로 적용 가능한 선택 매트릭스를 제공합니다.
핵심 가치: 이 글을 읽고 나면 Gemini 4 Hydrogen이 어떤 작업에서 앞서고, 어떤 작업에서 Sonnet 5.5에 뒤지는지, 그리고 Terra가 팀 워크플로우의 어느 위치에 적합한지 명확히 알게 됩니다.
왜 Gemini 4 Hydrogen을 Terra, Sonnet 5.5와 함께 비교할까요
세 모델은 출시 간격이 두 달도 채 되지 않고, 겨냥하는 지점도 크게 겹쳐요. 어느 하나도 각 회사의 가장 무거운 플래그십 추론 모델이 아니라, 개발자와 에이전트 실행, 고빈도 전문 작업을 위한 “주력 실무 모델”이에요. 매일 모델을 대량으로 호출해야 하는 팀이라면, 결국 이 계층의 모델이 비용과 효율을 좌우하죠.
Gemini 4 Hydrogen은 Google DeepMind의 차세대 고효율 모델로, 공식적으로는 일상적인 코딩과 AI 에이전트 실행을 겨냥해요. 단독으로 실행할 수 있고, 멀티모델 시스템에서는 실행자나 검증자 역할을 맡을 수도 있어요. GPT-6.1 Terra는 OpenAI가 2026년 10월 26일에 공개했고, 시각 추론과 컴퓨터 조작, 효율적인 일상 업무에 초점을 맞춰요. Claude Sonnet 5.5는 Anthropic이 2026년 9월 28일에 출시했으며, 공식적으로는 일상 코딩, 버그 수정, 전문 문서 작성, 복잡한 인터페이스 설계를 강조해요.
| 모델 | 제공사 | 출시일 | 공식 포지셔닝 | 표준 API 가격(백만 토큰당, 입력/출력) | 가격 출처 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen | Google DeepMind | 2026-11-12 | 일상 코딩, 다중 도구 호출, 에이전트 실행 | $1.50 / $7.50 | Google AI Studio 가격 페이지, 2026-11-13 확인 |
| GPT-6.1 Terra | OpenAI | 2026-10-26 | 시각 추론, 컴퓨터 조작, 일상 업무 | $1 / $5 | OpenAI 발표 자료, 2026-10-26 |
| Claude Sonnet 5.5 | Anthropic | 2026-09-28 | 일상 코딩, 버그 수정, 전문 문서, 인터페이스 설계 | 참고 자료에서 다루지 않음, 공식 가격 페이지 기준 | Anthropic 공식 자료 |
짚고 넘어갈 점이 있어요. Hydrogen의 사고 토큰은 출력 가격에 포함되기 때문에, 실제 비용을 최종적으로 눈에 보이는 텍스트만으로 가늠할 수는 없어요. 또 Hydrogen의 Batch와 Flex 모드 가격은 $0.75 / $3.75라서 오프라인 배치 작업에 잘 맞아요.
이 글의 수치 비교는 주로 Google DeepMind 2026년 11월 버전 모델 카드와 함께 제공되는 평가 방법론 문서를 바탕으로 해요. 즉, 데이터는 Google이 취합한 것이고, 일부 경쟁 모델의 성적은 각 벤더가 공개한 보고서나 리더보드에서 가져왔어요. 이 점이 결론에 어떤 영향을 주는지는 5절에서 따로 짚어볼게요.
Gemini 4 Hydrogen 프로그래밍 능력 비교: 누가 실제 문제 해결에 더 능할까
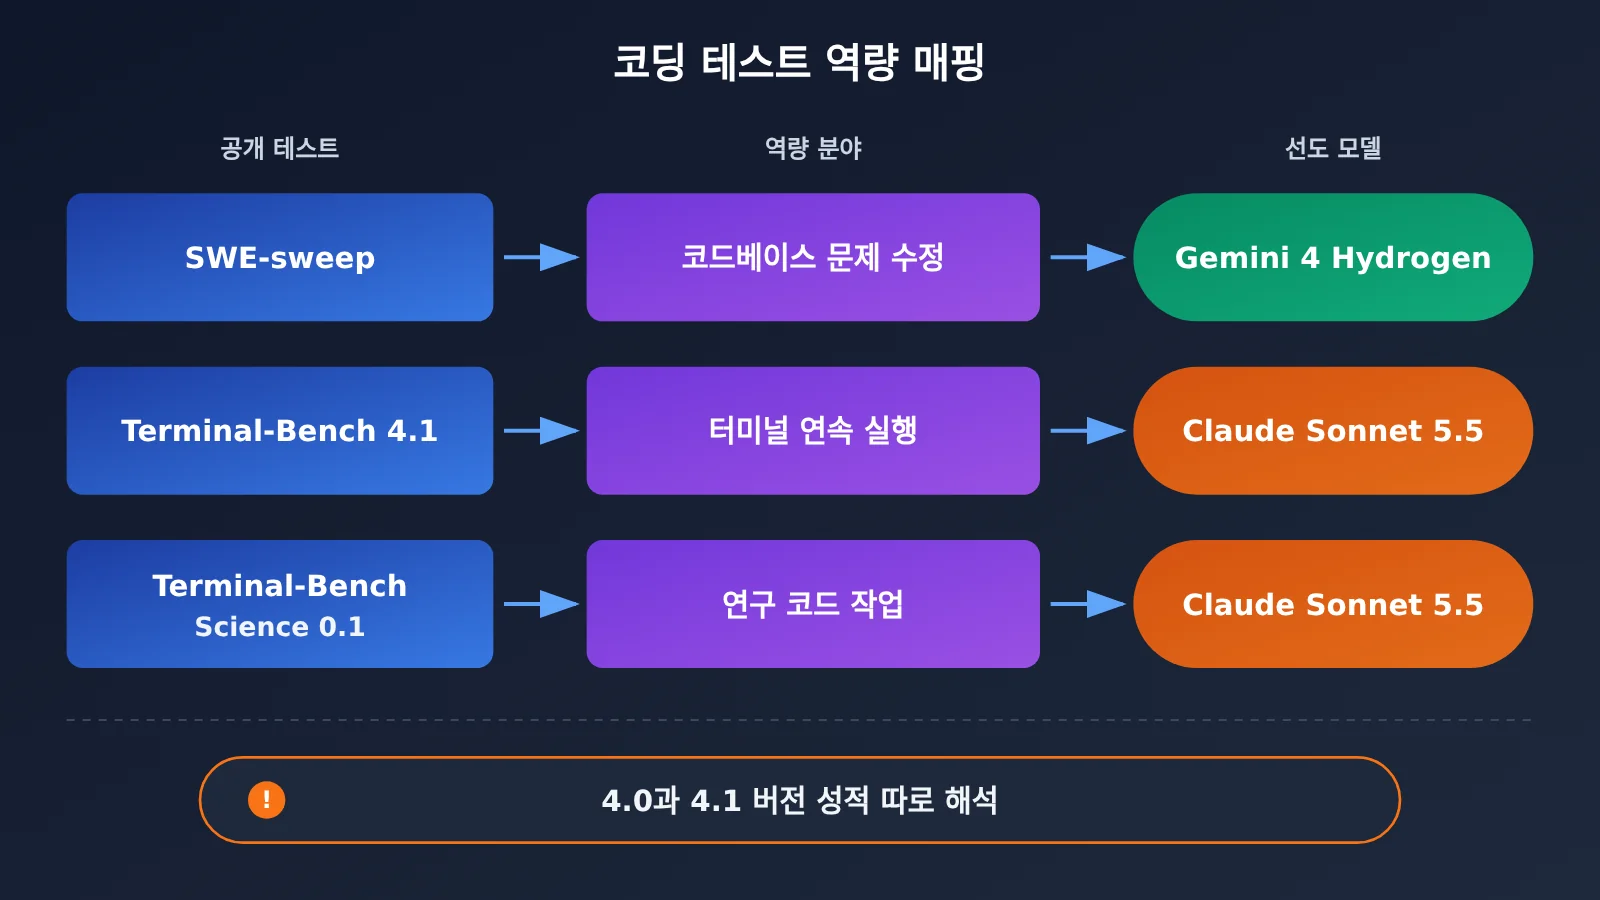
프로그래밍 관련 테스트는 크게 두 가지 능력으로 나눌 수 있어요. 하나는 실제 코드베이스에서 문제를 발견하고 수정하는 능력이고, 다른 하나는 터미널 환경에서 명령을 연속으로 실행하며 엔지니어링 작업을 완료하는 능력이죠. SWE-sweep은 전자에 가깝고, Terminal-Bench 시리즈는 후자에 가깝습니다. Terminal-Bench-Science는 코드로 과학 연구 작업을 수행하는 능력을 평가해요.
| 평가(버전) | 지표 | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | 우위 |
|---|---|---|---|---|---|
| SWE-sweep | 하위 작업 가중 보상 | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 | 평균 보상 | 57.0% | 63.9% | — | Sonnet |
| Terminal-Bench-Science 0.1 | 작업 점수 | 51.4% | 59.9% | 58.3% | Sonnet |
출처: Google DeepMind 《Gemini 4 Hydrogen Model Evaluation》 및 모델 카드, 2026년 11월.
프로그래밍 테스트 결과 해석
SWE-sweep은 절대 점수 자체가 전반적으로 낮아서, 난이도가 아주 높은 테스트라는 걸 알 수 있어요. Hydrogen의 13.5%는 Terra의 두 배가 조금 넘고 Sonnet의 네 배가 넘는 수준으로, 이 항목에서 격차가 가장 뚜렷합니다. 다만 이 항목에서 Hydrogen은 Google 자체의 Antigravity-CLI 1.4.8로 실행했고, 경쟁 모델의 실행 조건이 반드시 동일하다고 볼 수는 없어요. 격차의 일부는 Harness 적응에서 비롯됐을 수 있습니다.
Terminal-Bench 4.1에서는 Sonnet 5.5가 63.9%로 Hydrogen의 57.0%를 앞섰고, Terra는 Google 표에 이 항목 성적이 없어요. Hydrogen은 이 항목에서 mini-swe-agent vision Harness와 High 사고 단계를 사용했고, 작업마다 5회 실행해 평균 보상을 냈습니다. Terminal-Bench-Science 0.1에서는 Sonnet이 여전히 앞서고, Terra가 58.3%로 바짝 뒤따랐으며 Hydrogen은 오히려 3위로 밀렸어요.
프로그래밍 영역 결론: Hydrogen은 SWE-sweep 같은 코드베이스 문제 수정 테스트에서 우위가 뚜렷하고, Sonnet 5.5는 터미널 실행형 작업에서 더 안정적이에요. Terra는 과학 연구 코드 작업에서 Sonnet에 근접한 성과를 냈습니다. 프로그래밍 테스트 전반에서 모든 항목을 앞서는 모델은 없었어요.
벤더가 자체 보고한 Terminal-Bench 4.0 배경 데이터
OpenAI와 Anthropic은 각각 Terminal-Bench 4.0 성적을 공개한 적이 있어요. 4.0과 4.1은 서로 다른 벤치마크 버전이기 때문에 아래 표는 따로 정리했고, 위 표의 4.1 성적과 섞어서 비교하면 안 됩니다.
| 평가(버전) | 모델 | 성적 | 테스트 조건 | 출처 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Claude Sonnet 5.5 | 70.6% | 벤더 자체 측정 | Anthropic 발표 자료, 2026-09-28 |
| Terminal-Bench 4.0 | GPT-6.1 Terra | 50.3% | 최고 추론 설정 | OpenAI 발표 자료, 2026-10-26 |
이 데이터의 가치는 참조 기준을 제공한다는 데 있어요. 각 벤더의 테스트 조건 아래에서 Sonnet 5.5의 터미널 작업 능력이 Terra보다 확실히 높았고, 이는 Google 표에서 Sonnet이 터미널형 테스트에서 앞선 방향과도 일치합니다.
Gemini 4 Hydrogen, 에이전트와 자동화 테스트에서 완전한 작업을 수행할 수 있을까?
에이전트 테스트가 단일 턴 질의응답과 가장 다른 점은, 모델이 스스로 단계를 계획하고 도구를 연속 호출하며, 실패한 뒤에는 전략을 조정하고 마지막에는 결과를 검증해야 한다는 거예요. 이런 테스트는 실제 자동화 워크플로에 더 가깝고, 모델의 ‘실행 규율’을 더 많이 시험해요.
아래 표는 Google 평가에서 에이전트 자동화, 컴퓨터 조작, 멀티모달 지식 작업 전반의 모든 모델 간 성적을 정리한 거예요. 3, 4절에서 이 표를 함께 사용해요.
| 평가(버전) | 능력 분야 | 지표 | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|---|
| Agents’ Last Exam v1.1 | 전문 다단계 에이전트 | 작업 점수 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 워크플로 자동화 | 작업 점수 | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | 장기 시뮬레이션 경영 | 최종 자금 잔액 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 컴퓨터/그래픽 인터페이스 조작 | 작업 성공률 | 77.6% | 83.9% | 74.2% |
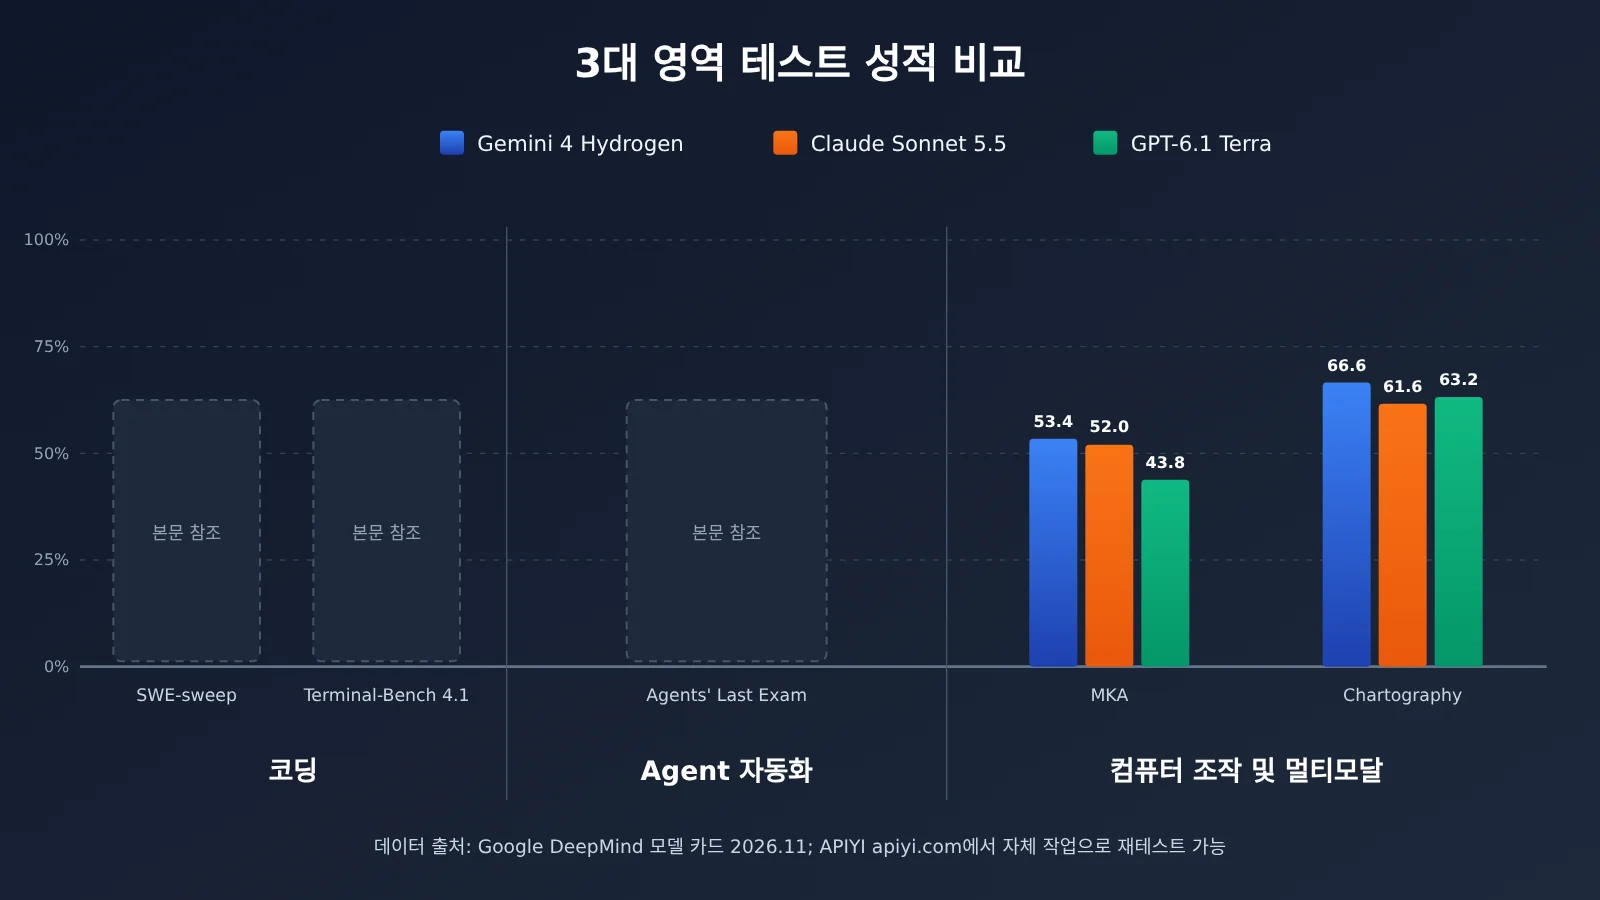
| MKA | 멀티모달 지식 작업 | 작업 점수 | 53.4% | 52.0% | 43.8% |
| Chartography | 차트 이해(도구 없음) | 정확도 | 66.6% | 61.6% | 63.2% |
| HLE-Diamond | 고난도 지식 추론 | 정확도 | 58.8% | 53.3% | 47.3% |
출처: Google DeepMind 모델 카드 및 《Gemini 4 Hydrogen Model Evaluation》, 2026년 11월.
에이전트 및 자동화 성적 해설
Agents’ Last Exam v1.1은 122개 작업과 5시간 시간 창으로 구성돼요. Hydrogen 역시 Antigravity-CLI 1.4.8로 실행해요. Hydrogen이 71.6%로 앞서지만, 주목할 점은 Terra가 69.8%로 바짝 뒤따르며 오히려 Sonnet보다 거의 10퍼센트포인트 높다는 거예요. 이는 전문 다단계 작업에서 Terra가 결코 약하지 않다는 걸 보여줘요.
AutomationBench-AA의 구도는 조금 달라요. Hydrogen 76.1%, Sonnet 71.8%, Terra 60.2%로 Terra가 뚜렷하게 뒤처져요. 비즈니스가 시스템 간 프로세스 자동화를 대량으로 처리하는 쪽이라면 이 항목의 격차는 꼭 눈여겨볼 만해요.
Vending-Bench 2는 장기 시뮬레이션 경영 작업이고, 지표는 정확도가 아니라 최종 자금 잔액이에요. Hydrogen의 $14,549가 꽤 앞서는데, ‘장기 주기 의사결정 안정성’을 보는 보조 관찰로 삼을 수 있어요. 다만 단일 시뮬레이션 환경이라 모든 장기 작업에 곧바로 일반화하기는 어려워요.
에이전트 분야 결론: Google이 제시한 에이전트 및 자동화 테스트에서 Hydrogen은 전부 앞서요. Terra는 전문 다단계 작업에서는 Hydrogen에 가깝지만 프로세스 자동화에서는 뒤처지고, Sonnet은 중간 위치에 있어요.
🚀 빠른 시작: 에이전트 성적은 하네스와 도구 정의에 크게 좌우되므로 공개 점수는 출발점으로만 삼아야 해요. APIYI(apiyi.com)에서 같은 도구 체인과 같은 실제 작업 묶음으로 세 모델을 각각 실행해 보길 권해요. API 키 하나로 전환할 수 있어 내 시나리오에 맞는 비교 데이터를 얻기 쉬워요.
Gemini 4 Hydrogen과 Sonnet 5.5, 컴퓨터 조작과 멀티모달 지식 작업에서 누가 더 강할까
컴퓨터 조작 계열 테스트는 모델이 “화면을 보고, 마우스를 클릭하고, 키보드를 두드리는” 능력을 요구해요. 브라우저 조작이나 오피스 소프트웨어 자동화 같은 장면과 바로 연결되죠. 멀티모달 지식 작업은 복잡한 파일 읽기와 차트 이해를 살펴보는 테스트로, 재무제표 분석이나 연구 보고서 정리 같은 일에 대응해요.
OSWorld-2.1: Sonnet 5.5가 앞서는 GUI 조작
OSWorld 2.1은 Google 평가에서 82개의 오프라인 작업을 사용하고, 해상도는 1080p, 최대 500스텝이에요. 모델은 스크린샷으로 화면을 관찰하고 PyAutoGUI로 동작을 실행해요. Sonnet 5.5가 83.9%로 앞섰고, Hydrogen이 77.6%, Terra가 74.2%를 기록했어요.
여기서 꼭 짚고 넘어가야 할 기준 문제가 있어요. Anthropic이 자체 공개한 Sonnet 5.5의 OSWorld 2.1 일부 테스트 성적은 80.1%인데, Google 비교표는 83.9%를 채택했어요. 후자는 Google이 지정한 조건에서 테스트한 뒤 여러 실행 중 가장 높은 결과를 취한 값이에요. 즉 같은 이름의 테스트라도 벤더에 따라 다른 점수가 나올 수 있으니, 비교할 때는 반드시 하나의 출처로 통일해야 해요.
MKA와 Chartography: Hydrogen이 소폭 앞서
MKA 멀티모달 지식 작업에서는 Hydrogen 53.4%와 Sonnet 52.0%가 매우 근접했고, Terra는 43.8%로 약 10%포인트 뒤졌어요. Chartography는 도구를 사용하지 않는 조건에서 차트 이해를 테스트했는데, Hydrogen이 66.6%로 앞섰어요. 흥미로운 건 Terra가 63.2%로 2위를 차지하며 Sonnet의 61.6%보다 높다는 점인데, OpenAI가 Terra를 ‘시각 추론’ 중심으로 포지셔닝한 것과 맞아떨어져요.
컴퓨터 조작과 멀티모달 결론: GUI 조작은 Sonnet 5.5를 우선 보세요. 복잡한 파일 읽기와 멀티모달 지식 통합에서는 Hydrogen과 Sonnet이 비슷하고 Hydrogen이 약간 우세해요. 순수 차트 이해에서는 Hydrogen이 앞서고 Terra도 경쟁력이 있어요.
Gemini 4 Hydrogen 공개 평가 데이터를 올바르게 읽는 방법
공개 평가에서 가장 쉽게 오해하는 부분은 하나의 표를 “같은 시험장, 같은 규칙”에서 나온 성적표로 받아들이는 거예요. 실제로 Google의 평가 방법 문서는 몇 가지 핵심 전제를 설명하고 있어요.
- 사고 등급: Hydrogen은 보통 최고 사고 설정으로 테스트하지만, 일부 항목에는 별도 규정이 있어요. 예를 들어 Terminal-Bench 4.1은 High 등급을 사용해요.
- 실행 Harness: SWE-sweep과 Agents’ Last Exam은 Antigravity-CLI 1.4.8을 사용하고, Terminal-Bench 4.1은 mini-swe-agent vision Harness를, OSWorld 2.1은 스크린샷과 PyAutoGUI를 사용해요.
- 테스트 횟수: Terminal-Bench 4.1은 각 작업을 5회 실행해 평균 보상을 사용하지만, OSWorld의 경쟁 모델 점수는 여러 번 실행한 결과 중 최고값을 사용했어요. 두 통계 방식 자체가 다르죠.
- 점수 출처: 경쟁 모델 결과는 주로 각 벤더의 공개 보고서와 리더보드에서 가져왔으며, 모든 모델이 같은 팀에 의해 일관되게 실행된 것은 아니에요.
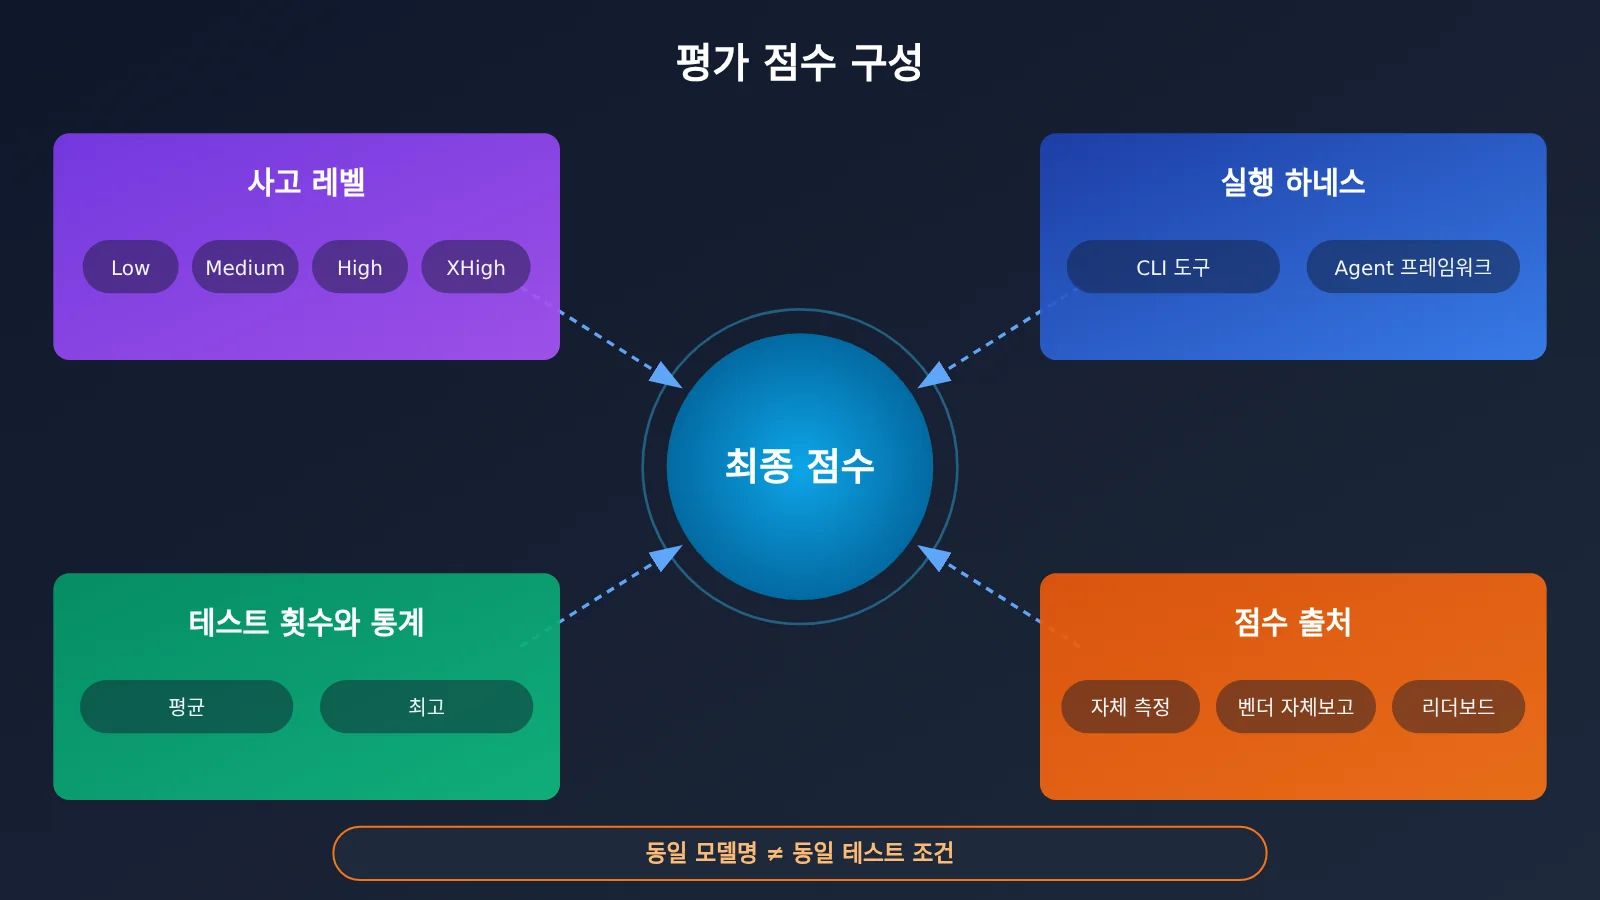
사고 등급의 영향은 특히 커요. Artificial Analysis는 11월 12일 Hydrogen의 네 등급을 독립 평가했는데, 지능 지수는 Low 27, Medium 41, High(기본값) 51, XHigh 54였어요. 해당 표준화 평가 작업의 평균 비용은 $0.29에서 $3.16까지 다양했고요. 이는 기준 작업 결과일 뿐, 일반 사용자가 매번 호출할 때 드는 실제 비용은 아니지만, 같은 모델이라도 등급에 따라 차이가 크다는 점을 충분히 보여줘요. XHigh는 High보다 3점밖에 높지 않은데 비용은 눈에 띄게 올라가요.
따라서 이 글의 점수를 읽을 때는 두 가지를 기억해 주세요. 첫째, 결론은 여기에 제시된 공개 테스트에만 해당해요. 둘째, Google 표와 OpenAI 자체 보고, Anthropic 자체 보고에서 각각 가장 유리한 데이터만 골라 하나의 “종합 순위”로 이어 붙이면 안 돼요.
Gemini 4 Hydrogen 빠르게 시작하기: 같은 코드로 세 모델 비교하기
가장 신뢰할 수 있는 모델 선택 방법은, 여러분의 실제 작업으로 세 모델을 모두 한 번씩 돌려보는 거예요. 아래 예시는 OpenAI 호환 인터페이스를 사용하며, model 파라미터만 바꾸면 모델을 전환할 수 있어요.
아주 간단한 예시
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "找出这段 Python 代码中的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
전체 구현 코드 보기: 세 모델 동일 문제 비교 스크립트
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 모델 ID는 플랫폼 모델 목록을 기준으로 하며, gemini-4-hydrogen은 Google 공식 ID예요
MODELS = [
    "gemini-4-hydrogen",
    "gpt-6.1-terra",       # 예시 ID이니 콘솔에서 확인하세요
    "claude-sonnet-5.5",   # 예시 ID이니 콘솔에서 확인하세요
]

def compare(prompt: str, system: str = "你是资深工程师,只修改必要代码"):
    results = []
    for model in MODELS:
        start = time.time()
        try:
            resp = client.chat.completions.create(
                model=model,
                messages=[
                    {"role": "system", "content": system},
                    {"role": "user", "content": prompt},
                ],
            )
            usage = resp.usage
            results.append({
                "model": model,
                "seconds": round(time.time() - start, 1),
                "prompt_tokens": usage.prompt_tokens if usage else None,
                "completion_tokens": usage.completion_tokens if usage else None,
                "answer": resp.choices[0].message.content[:300],
            })
        except Exception as e:
            results.append({"model": model, "error": str(e)})
    return results

if __name__ == "__main__":
    for r in compare("修复:函数在空列表输入时抛出 IndexError ..."):
        print(r)
Hydrogen으로 마이그레이션할 때는 몇 가지 짚고 넘어갈 점이 있어요. 사용자 지정 temperature, top_p, top_k는 무시되고, thinking_budget과 MINIMAL은 지원되지 않아요. 기본 사고 단계는 High이며, 다중 턴 도구 호출에서는 thought signature를 올바르게 돌려줘야 해요. 만약 기존 Agent가 낮은 temperature로 출력을 제어하고 있었다면, 구조화된 출력이나 더 명확한 지시문으로 제약을 걸어야 해요.
제안: 먼저 10~20개의 실제 티켓이나 작업을 평가 세트로 삼아, APIYI(apiyi.com)에서 세 모델을 각각 호출하고 성공률, 소요 시간, 출력 토큰 수를 함께 기록해 보세요. 신규 사용자에게는 무료 테스트 크레딧이 있으니, 정식 구매 전에 소규모 검증을 마칠 수 있어요.
Gemini 4 Hydrogen, Terra, Sonnet 5.5 시나리오 추천과 선택 매트릭스
Gemini 4 Hydrogen을 선택할 시나리오
- 코드베이스 문제 해결과 의존성 업그레이드: SWE-sweep에서 우위 폭이 가장 크고, 공식적으로 정밀 편집을 중점 개선했어요.
- 다단계 Agent와 워크플로 자동화: Agents’ Last Exam, AutomationBench-AA, Vending-Bench 2에서 모두 앞서요.
- 복잡한 문서와 차트 분석: MKA, Chartography에서 앞서며 PDF, Office 문서 등 다양한 형식 입력을 지원해요.
Claude Sonnet 5.5를 선택할 시나리오
- 터미널 집약형 엔지니어링 작업: Terminal-Bench 4.1과 Terminal-Bench-Science 0.1에서 모두 앞서요.
- 데스크톱 및 GUI 조작: OSWorld-2.1에서 Google 표 기준 최고 점수예요.
- 전문 문서와 인터페이스 디자인: Anthropic이 공식적으로 강조하는 방향이에요.
GPT-6.1 Terra를 선택할 시나리오
- 비용에 민감한 대량 작업: 표준가 $1 / $5로, 세 모델의 알려진 가격 중 가장 낮아요.
- 시각 추론과 일상 자동화: Chartography에서 2위, Agents’ Last Exam은 Hydrogen에 근접해요.
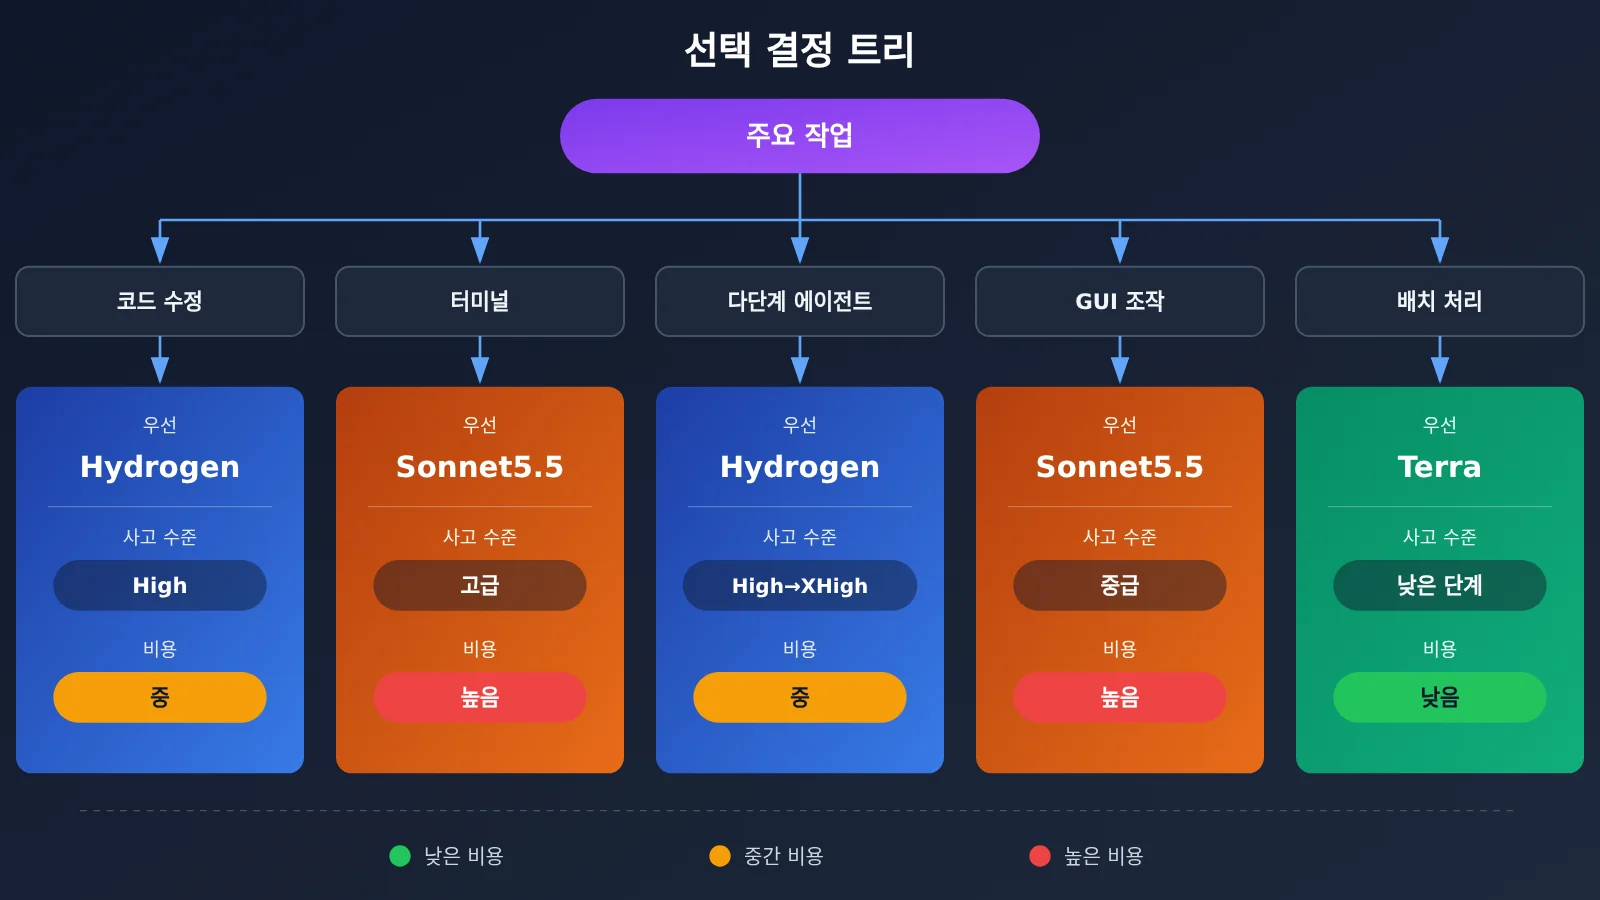
| 작업 유형 | 1순위 | 대안 | 비용 민감도 | 실행 방식 제안 | 접속 채널 |
|---|---|---|---|---|---|
| 코드베이스 유지보수, Bug 수정 | Hydrogen | Sonnet 5.5 | 중 | Hydrogen이 코드를 수정하고 Sonnet이 터미널 검증 | APIYI apiyi.com 통합 인터페이스 |
| 터미널 운영, 연구 코드 | Sonnet 5.5 | Terra | 중 | 단일 모델 장기 세션 | 동일 |
| 다단계 Agent 워크플로 | Hydrogen | Terra | 중 | High 단계에서 시작, 실패 시 XHigh로 상향 | 동일 |
| 데스크톱/브라우저 GUI 조작 | Sonnet 5.5 | Hydrogen | 낮음 | 스크린샷 관찰 + 조작 도구 | 동일 |
| 차트와 문서 읽기 | Hydrogen | Terra | 중 | 도구 없이 또는 검색 증강 | 동일 |
| 대량 일상 자동화 | Terra | Hydrogen(Batch) | 높음 | 배치 비동기 처리 | 동일 |
💡 선택 제안: 팀에 프로그래밍과 GUI 자동화 요구가 동시에 있다면 굳이 한 모델만 고집할 필요가 없어요. Google Antigravity Orchestrator의 접근처럼 단계별로 역할을 나누는 걸 참고해 보세요. APIYI apiyi.com을 통해 같은 Key로 여러 모델을 호출할 수 있고, 라우팅 전환은 파라미터 하나만 바꾸면 돼요.
자주 묻는 질문 FAQ
Q1: Gemini 4 Hydrogen은 무엇인가요?
Gemini 4 Hydrogen은 Google DeepMind가 2026년 11월 12일에 공개한 고효율 모델로, API 모델 ID는 `gemini-4-hydrogen`이며 일상적인 코딩과 Agent 실행을主要 용도로 합니다. 1,048,576 토큰의 통합 컨텍스트 윈도우를 지원하고, Low·Medium·High·XHigh 네 단계의 사고(thinking) 수준을 제공하며 기본값은 High예요.
Q2: Gemini 4 Hydrogen과 Claude Sonnet 5.5 중 코딩은 누가 더 강한가요?
작업 유형에 따라 달라요. Hydrogen은 SWE-sweep 코드베이스 수정 테스트에서 상당히 앞서고, Sonnet 5.5는 Terminal-Bench 4.1과 Terminal-Bench-Science 0.1 같은 터미널 실행 계열 테스트에서 앞섭니다. 일상적인 코드 수정은 Hydrogen, 터미널 집약형 엔지니어링은 Sonnet 쪽이 유리해요.
Q3: GPT-6.1 Terra는 1위를 하나도 차지하지 못했는데, 그래도 쓸 만한가요?
고려할 만해요. Google이 공개한 3자 동일 표 비교 결과에서 Terra는 확실히 단일 항목 최고점이 없지만, Agents’ Last Exam에서는 Hydrogen에 근접했고 Chartography에서 2위를 기록했으며, 표준 API 가격이 가장 낮아요. 비용에 민감하고 시각 조작과 일반 자동화 위주인 상황에서는 중요한 후보예요.
Q4: Sonnet 5.5의 OSWorld 점수가 80.1%와 83.9% 두 가지로 나오는 이유는 무엇인가요?
80.1%는 Anthropic이 직접 공개한 일부 테스트 점수이고, 83.9%는 Google이 지정된 조건에서 테스트해 여러 번 실행한 결과 중 최댓값이에요. 두 수치는 테스트 조건이 다르므로 비교할 때는 반드시 하나의 출처를 고정해서 써야 하고, 섞어 쓰면 안 돼요.
Q5: API로 이 세 모델을 빠르게 비교하려면 어떻게 해야 하나요?
여러 모델을 지원하는 API 집계 플랫폼을 쓰는 걸 권장해요:
1. APIYI apiyi.com에 접속해 계정을 등록하고 API 키를 발급받으세요;
2. 콘솔의 모델 목록에서 세 모델의 사용 가능한 ID를 확인하세요;
3. 본문 코드의 base_url을 `https://api.apiyi.com/v1`로 설정하고, 같은 작업 묶음을 각 모델에 호출해 보세요.
APIYI는 OpenAI 호환 인터페이스를 제공하고 사용량 기반으로 과금하므로, 하나의 스크립트 안에서 가로 비교를 마무리하기 편해요.
Q6: Gemini 4 Hydrogen에 알려진 제약은 무엇인가요?
공식 모델 카드에서는 다음과 같이 밝히고 있어요: 여전히 환각(hallucination)이 발생할 수 있고, 높은 사고 단계에서는 소요 시간과 비용이 눈에 띄게 증가하며, 지식 컷오프는 2026년 3월이에요. 부당 거부(refusal) 지표는 3.8 Flash 대비 5.57%포인트 악화되었고, 전체 안전 보고서는 검증 시점 기준 아직 공개되지 않았어요. 또한 일부 개발자들은 특정 Agent 작업에서 과도한 실행(over-execution)이 나타난다고 피드백했어요. 게다가 토큰당 표준 가격은 3.8 Flash의 현재 가격 두 배이므로, 대량 작업에는 Batch 모드를 고려해 볼 수 있어요.
Gemini 4 Hydrogen 비교 핵심 요약 Key Takeaways
- 프로그래밍에 전능한 챔피언은 없어요: Hydrogen은 코드베이스 수리에 강하고, Sonnet 5.5는 터미널 실행 작업에 강해요.
- Agent 자동화는 Hydrogen이 우세: Google이 제시한 Agent 및 자동화 테스트에서 Hydrogen이 모두 최고예요.
- GUI 조작은 Sonnet 5.5: OSWorld-2.1에서 Sonnet이 83.9%로 앞서는데, 측정 기준 차이는 유의해야 해요.
- Terra는 비용과 시각 성능에서 승리: 표준 가격이 가장 낮고, 차트 이해와 전문 Agent 작업에서도 크게 뒤지지 않아요.
- 버전과 출처는 섞어서 비교하면 안 돼요: Terminal-Bench 4.0과 4.1, 그리고 벤더 자체 보고와 Google 자체 측정은 분리해야 해요.
- 사고 단계(Thinking level)의 영향이 커요: Hydrogen High와 XHigh의 지능 지수 차이는 3점에 불과한데, 비용은 확실히 올라가요.
- 자체 과제로 재측정하는 게 기준: APIYI apiyi.com에서 하나의 Key로 세 모델을 횡으로 테스트해 볼 수 있어요.
요약
Gemini 4 Hydrogen, GPT-6.1 Terra, Claude Sonnet 5.5 비교의 핵심 요약은 이래요.
- 프로그래밍 영역: Hydrogen은 SWE-sweep에서 앞서고, Sonnet 5.5는 두 가지 터미널 계열 테스트에서 앞서며, Terra는 연구용 코드 작업에서 Sonnet에 근접해요.
- Agent 영역: Hydrogen은 다단계 Agent, 프로세스 자동화, 장기 시뮬레이션 경영에서 모두 앞서고, Terra는 전문 작업에서 바짝 뒤따라요.
- 컴퓨터 조작과 멀티모달: Sonnet 5.5가 그래픽 인터페이스 조작을 주도하고, Hydrogen은 멀티모달 지식 작업과 차트 이해에서 소폭 앞서요.
공개 평가는 “특정 조건에서 누가 더 강한지”를 알려줄 뿐, “내 업무에서 누가 더 적합한지”를 알려주지는 않아요. 그래서 실용적인 방법은 위의 모델 선택 매트릭스로 후보 한두 개를 추리고, 자체 실제 과제와 고정된 사고 단계, 도구 체인으로 소규모 재측정을 하는 거예요.
APIYI apiyi.com을 통해 효과를 빠르게 검증해 보시길 추천해요. 플랫폼은 무료 테스트 크레딧과 다중 모델 통합 인터페이스를 제공하므로, 팀이 정식 출시 전에 횡적 평가를 마무리하기에 적합해요.
📚 참고 자료
- Google 공식 블로그 – Introducing Gemini 4 Hydrogen: 출시 공지 및 파트너 사례
- 링크:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
설명: 공식 포지셔닝, 역량 범위 및 초기 테스트 데이터
-
Google DeepMind 모델 카드: 교차 모델 평가 비교표
- 링크:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
설명: 이 글의 주요 정량 데이터 출처예요
-
Google DeepMind 모델 평가 PDF: 테스트 실행 조건 상세 설명
- 링크:
storage.googleapis.com/deepmind-media/gemini/gemini_4_hydrogen_model_evaluation.pdf -
설명: 하네스(Harness), 사고 단계 설정, 실행 횟수 및 Vending-Bench 2 등 보충 성적
-
Google Cloud 기술 문서: Hydrogen 사양 및 마이그레이션 안내
- 링크:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
설명: 컨텍스트 제한, 파라미터 동작 및 호환성 주의 사항
-
Google AI Studio 가격 페이지: 공식 API 가격
- 링크:
aistudio.google.com/docs/pricing -
설명: Standard, Batch, Flex, Priority 각 모드별 가격
-
OpenAI – Introducing GPT-6.1 Terra: Terra 출시 자료
- 링크:
openai.com/index/introducing-gpt-6-1-terra/ -
설명: Terminal-Bench 4.0 자체 보고 성적 및 API 가격
-
Anthropic – Introducing Claude Sonnet 5.5: Sonnet 5.5 출시 자료
- 링크:
anthropic.com/claude-sonnet-5-5 -
설명: Terminal-Bench 4.0 및 OSWorld 2.1 자체 보고 성적
-
Artificial Analysis – Gemini 4 Hydrogen: 4단계 사고 모드 독립 평가
- 링크:
artificialanalysis.ai/models/gemini-4-hydrogen - 설명: Intelligence Index v5.0.1 각 단계별 지수, 소요 시간 및 비용
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 홈페이지에서 저희에게 연락 주세요. 더 많은 모델 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요