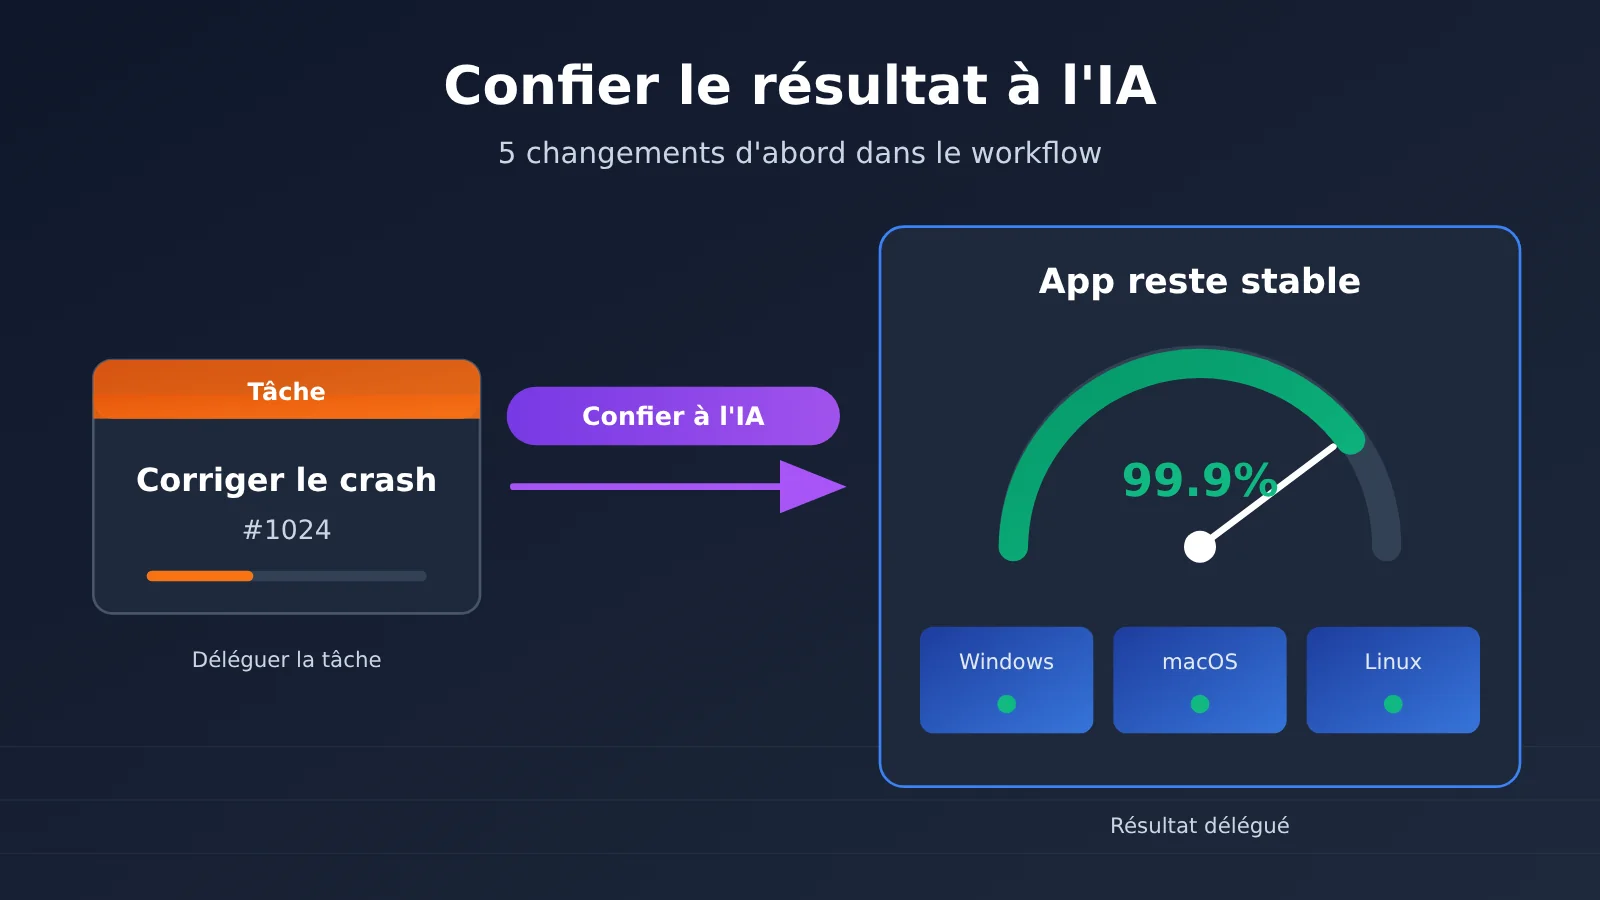
Note de l’auteur : de « corriger un crash » à « faire en sorte que l’application ne plante plus », cet article décompose les 5 transformations que le flux de travail doit impérativement accomplir avant de confier le résultat à l’IA, et propose une démarche concrète, sans écrire une ligne de code.
Beaucoup d’équipes utilisent déjà l’IA tous les jours pour rédiger des e-mails, retoucher des textes ou fabriquer des présentations, mais elles sentent bien que sa valeur ne s’arrête pas là. Le problème ne vient généralement pas du modèle, mais de ce qu’on lui confie : c’est trop petit. On confie une tâche, pas un résultat. Cet article s’appuie sur les pratiques partagées récemment par Felix Rieseberg, développeur chez Claude, pour présenter une méthode de refonte du flux de travail : passer de « déléguer une tâche » à « déléguer un résultat ».
Ce n’est pas un énième recueil d’astuces de rédaction d’invites. Même parfaitement rédigée, une invite ne permettra pas à l’IA d’aller bien loin si elle n’a pas accès aux données, ne peut pas toucher à l’environnement et ne dispose d’aucune validation externe : elle tournera en rond dans le petit cadre que vous lui avez délimité. Ce qu’il faut changer en premier, c’est le flux de travail lui-même.
L’essentiel : à la fin de cet article, vous saurez quels types de travaux méritent de « confier le résultat à l’IA », et quelles 5 conditions de base il faut d’abord réunir avant de déléguer, pour que l’IA puisse tourner de façon autonome sur la durée.
Les points clés : confier une tâche à l’IA vs. confier le résultat à l’IA
Felix Rieseberg décompose « l’ambition » dans l’usage de l’IA en quatre dimensions : la vitesse, la hauteur, la profondeur et l’étendue. La « vitesse » est l’usage le plus mature, tandis que « confier le résultat à l’IA » correspond principalement à la dimension de la « hauteur ». La profondeur et l’étendue déterminent le plafond de qualité du résultat.
| Dimension | Signification | Pratique typique | Exigences pour le workflow |
|---|---|---|---|
| Vitesse | Accomplir le même travail en moins de temps | Faire écrire du code, de la documentation plus vite à l’IA | Faibles, les processus existants suffisent |
| Hauteur | Se concentrer sur le résultat final plutôt que sur la tâche immédiate | Passer de « corriger ce bug » à « faire en sorte que l’application ne plante pas » | Élevées, nécessite un accès aux données et un environnement de validation |
| Profondeur | Penser comme un expert de premier plan du domaine | Remplacer les tableaux Markdown par des bases de données et des modèles statistiques | Moyennes à élevées, nécessite des données brutes et des outils spécialisés |
| Étendue | Emprunter les méthodes d’autres domaines | Introduire les méthodologies de journalistes, d’éditeurs, d’investisseurs à découvert | Moyennes, nécessite plusieurs sessions ou des sous-agents |
Pourquoi confier le résultat à l’IA est d’abord un problème de workflow
Quand vous confiez une tâche à un modèle, il exécute en réalité « la méthode que vous estimez actuellement la plus susceptible d’atteindre l’objectif ». Autrement dit, la tâche contient déjà votre jugement, et le modèle n’est que l’exécutant. Pour monter d’un cran, il faut se demander : que veux-je vraiment qu’il se passe ensuite ? Derrière cet objectif immédiat, quel objectif plus vaste se cache ?
L’article original donne un exemple très concret. Au début, l’auteur demandait à Claude de corriger un à un des problèmes de plantage bien précis, puis il lui a carrément confié la responsabilité de « maintenir l’application stable, sans plantage ». Mais cette étape ne se fait pas en changeant une phrase d’invite : il a d’abord fallu s’assurer que Claude puisse accéder facilement aux rapports de plantage, savoir à quel commit Git correspond chaque version de l’application, et pouvoir utiliser des machines Windows, macOS et Linux. C’est à ce prix qu’il peut reproduire les problèmes de façon autonome et vérifier si le correctif est efficace.
C’est là le jugement central de cet article : confier le résultat à l’IA suppose que l’IA dispose des entrées, de la capacité d’agir et des moyens de validation nécessaires à la boucle fermée. S’il manque un seul maillon, la délégation de résultat dégénère en délégation de tâche, et vous revenez à lui assigner des tâches sans arrêt.
Les trois paliers pour confier le résultat à l’IA : l’exemple de la revue trimestrielle
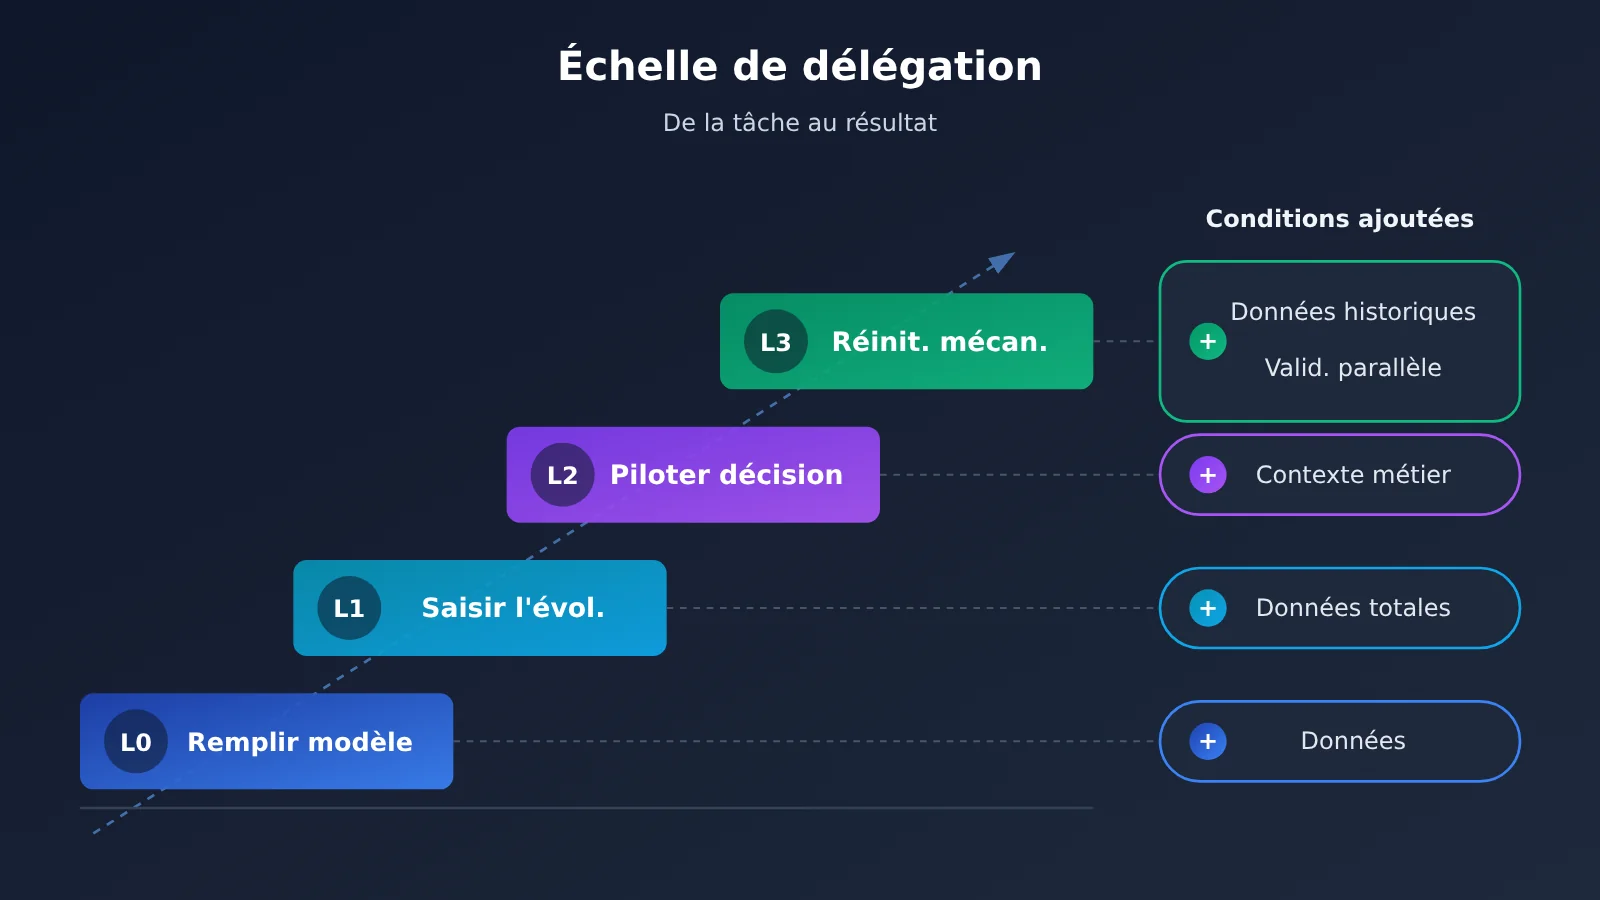
L’article original prend une tâche de bureau « un peu ennuyeuse » comme démonstration : créer les diapositives de revue trimestrielle (QBR) d’une entreprise fictive, Acme. Une même chose peut se décliner en plusieurs niveaux, du plus bas au plus haut.
| Niveau | Ce que vous confiez à l’IA | Formulation typique | Ce dont l’IA a besoin |
|---|---|---|---|
| L0 Tâche | Remplir des chiffres dans un modèle | « Transforme ces données en diapositives » | Un jeu de données déjà préparé |
| L1 Compréhension | Comprendre ce qui s’est passé | « Dis-moi ce qui a changé ce trimestre, pourquoi, et ce qu’il faut faire » | Des données métier aussi complètes que possible |
| L2 Décision | Faire avancer la réunion vers une décision | « Identifie les trois décisions les plus urgentes et liste les arguments pour et contre » | Les données, plus le contexte métier et les contraintes |
| L3 Mécanisme | Repenser la revue elle-même | « Conçois une meilleure méthode que les diapositives trimestrielles, prouve avec les données historiques qu’elle détecte les problèmes plus tôt, et fais-la tourner en parallèle du processus actuel pendant un trimestre » | Données historiques, environnement d’exécution, validation comparative |
Au niveau L3, ce que vous confiez n’est plus « un jeu de diapositives », mais le résultat lui-même : « permettre à la direction de détecter les problèmes plus tôt et d’allouer les budgets et les effectifs au bon endroit ». L’article donne un signal de diagnostic très utile : si ce que vous êtes en train de produire doit encore faire l’objet d’une réunion pour être discuté, il y a de bonnes chances qu’il vaille la peine de remonter l’objectif d’un cran.
5 choses à changer dans le workflow avant de confier les résultats à l’IA
En combinant les deux cas présentés dans l’article — la gestion des crashs et la rétrospective trimestrielle —, on peut identifier 5 éléments d’infrastructure à modifier en priorité. Le tableau ci-dessous met les deux cas côte à côte pour vous aider à les transposer à votre propre activité.
| Axe de transformation | Cas de gestion des crashs | Cas de rétrospective trimestrielle | Question d’auto-évaluation |
|---|---|---|---|
| 1. Canal de données brutes | Accès direct aux rapports de crash | Accès aux journaux métier et aux données utilisateur d’origine | L’IA reçoit-elle des documents bruts ou des résumés de seconde main ? |
| 2. Traçabilité des correspondances | Le numéro de version correspond à un commit Git | La définition des indicateurs correspond à la source de données | L’IA peut-elle remonter du symptôme à la cause ? |
| 3. Environnement manipulable | Machines de test pour les trois grands systèmes d’exploitation | Possibilité d’installer des logiciels, d’exécuter des bases de données et des modèles statistiques | L’IA peut-elle reproduire et expérimenter par elle-même ? |
| 4. Évaluation externe | Après correction, plus de crash en pratique | Validation du pouvoir prédictif sur des données que le modèle n’a jamais vues | Le résultat est-il prouvé par autre chose que l’IA ? |
| 5. Parallélisation et retour arrière | La correction est d’abord validée en environnement de test | Le nouveau mécanisme tourne en parallèle de l’ancien processus pendant un trimestre | En cas d’échec, peut-on revenir en arrière sans perte ? |
Transformation n° 1 : ouvrir le canal des données brutes pour confier les résultats à l’IA
Dans la partie consacrée à la « profondeur », l’article original insiste à plusieurs reprises : les professionnels de premier plan partent des matériaux les plus bruts, et non d’informations déjà triées et retravaillées. Dans le monde de l’entreprise, beaucoup de « faits établis » ne sont en réalité que des approximations grossières de la réalité. Si vous ne donnez à l’IA qu’un tableau de synthèse préparé par quelqu’un d’autre, elle ne pourra raisonner qu’à partir de cette approximation.
Concrètement, on peut d’abord dresser une « liste des données lisibles par l’IA » : journaux (logs), tickets, rapports de crash, comptes en lecture seule sur la base de données, documents historiques, etc. L’article mentionne qu’il est possible, via un connecteur MCP ou par d’autres moyens, de donner au modèle l’accès aux données concernées. De nombreux outils proposent déjà ce type de capacité ; en choisir un et l’utiliser est bien plus fiable que de coller sans cesse des éléments à la main.
Transformation n° 2 : établir une correspondance traçable du symptôme vers la cause
Dans le cas du crash, le fait de savoir « à quel commit Git correspond chaque version de l’application » peut ressembler à un détail, mais c’est ce qui détermine si l’IA peut, à partir d’un rapport de crash, remonter jusqu’à la modification de code précise. Sans cette correspondance, l’IA ne peut que deviner — et si elle se trompe, il faut encore intervenir manuellement.
Transposé au contexte métier, cela signifie que la définition des indicateurs doit pouvoir être rattachée à sa source de données. Par exemple, il faut être transparent vis-à-vis de l’IA sur la fenêtre temporelle et le type d’utilisateurs retenus pour calculer le « taux d’attrition ». Plus la correspondance est claire, moins l’IA risque de dévier lorsqu’elle travaille à un niveau d’abstraction plus élevé.
Transformation 3 : donner à l’IA un ordinateur sur lequel elle peut réellement agir
L’article original le dit sans détour : toutes les approches précédentes reposent sur un même prérequis — le modèle doit pouvoir utiliser un ordinateur, installer des logiciels et récupérer toutes sortes de données pertinentes. Quand Claude s’apprête à traiter une analyse avec un simple tableau Markdown, insistez pour qu’il passe par une base de données et des modèles statistiques. Car « faire en sorte que le modèle se comporte comme un expert » ne change souvent que le vocabulaire, pas la méthode de travail.
Pour les équipes d’ingénierie, cette étape implique un environnement sandbox, des machines de test et une isolation des droits. Pour les équipes métier, elle implique un espace de travail où elles peuvent exécuter des outils d’analyse. Côté droits, appliquez le principe du moindre privilège : commencez en lecture seule, puis ouvrez progressivement l’écriture une fois la fiabilité vérifiée.
Transformation 4 : s’en tenir à une évaluation externe, sans laisser l’IA se noter elle-même
La recommandation de l’auteur du texte source est très claire : au moins à la date d’octobre 2026, il conseille fortement de conserver une validation externe, idéalement avec des outils que le modèle peut exécuter lui-même et qui lui donnent immédiatement un retour. Les cas de test, les résultats de reproduction réels et les jeux de données de validation mis de côté sont plus fiables qu’une « note que le modèle s’attribue lui-même ».
Dans la version poussée de la revue trimestrielle, l’article original demande à Claude de construire une simulation du comportement client à partir des journaux, d’identifier les signaux qui annoncent le plus tôt une perte de clientèle, puis de prouver, à l’aide de données que le modèle n’a jamais vues, que ce signal a réellement un pouvoir prédictif. C’est la forme canonique de l’évaluation externe : la conclusion doit résister à une vérification menée en dehors du modèle.
Transformation n°5 : concevoir une phase de fonctionnement en parallèle et des conditions de sortie
La délégation de niveau L3 comporte une action clé : faire tourner le nouveau mécanisme en parallèle des processus existants pendant un trimestre. Ce n’est pas seulement une mesure de prudence, c’est aussi une forme d’évaluation externe : pour savoir si le nouveau mécanisme détecte réellement les problèmes plus tôt, on peut le comparer au processus précédent sur la même période.
Il faut aussi regarder les limites en face. Le texte original l’avoue franchement : en 2026, une simple phrase comme « Claude, va gagner de l’argent » ne fonctionnera pas encore pour la plupart des entreprises. Chaque délégation de résultat doit donc préciser clairement les périmètres, les points de contrôle et les modalités de repli, plutôt que de tout transférer d’un seul coup.
Débuter rapidement avec la remise des résultats à l’IA : un processus de délégation sans code
La procédure ci-dessous ne dépend d’aucune programmation et peut être appliquée telle quelle par les équipes produit, opérations, analyse et ingénierie.
Étape 1 : déterminer si ce travail mérite de confier le résultat à l’IA
Commencez par filtrer avec trois questions : ce travail nécessitera-t-il encore une réunion de discussion ensuite ? A-t-il un résultat final clair, et pas seulement une production créative ? Se répète-t-il périodiquement ? Le texte source indique que relever le niveau d’objectif est surtout utile lorsqu’on vise un résultat final, et s’applique moins bien aux travaux de création. Si vous répondez « oui » à deux des trois questions, cela vaut la peine d’essayer.
Étape 2 : remplir une fiche de délégation du résultat
Plutôt que d’écrire une longue invite, il vaut mieux découper la délégation en champs fixes. La structure de fiche ci-dessous peut être réutilisée directement.
| Champ | Contenu à renseigner | Exemple (gestion des plantages) |
|---|---|---|
| Résultat final | Ce que vous voulez vraiment qu’il se produise | L’application reste stable sur les trois grandes plateformes |
| Objectif derrière le résultat | L’intention d’un niveau supérieur | Réduire la perte d’utilisateurs due aux plantages |
| Données disponibles | Liste des documents bruts et mode d’obtention | Rapports de plantage, correspondance entre versions et commits |
| Environnement disponible | Les machines et outils que l’IA peut utiliser | Machines de test Windows, macOS, Linux |
| Validation externe | Qui ou quoi prouve que le résultat est correct | Pouvoir reproduire de façon stable et vérifier l’efficacité du correctif |
| Limites et retour arrière | Les lignes à ne pas franchir et le plan en cas d’échec | Modifier uniquement la branche de test, fusion manuelle |
| Objectif défi | Un niveau d’exigence élevé qui semble déraisonnable | Exemple du texte source : faire passer le temps de chargement de 10 secondes à 200 millisecondes |
La colonne « objectif défi » vient d’une recommandation approfondie du texte source : fixez un objectif qui paraît déraisonnable et dites au modèle qu’il est parfaitement raisonnable. Si le modèle estime que c’est impossible, réaffirmez que le problème peut être résolu et qu’il lui suffit de continuer à travailler. La conclusion de Locke et Latham, après avoir passé en revue 35 ans de recherches sur la fixation d’objectifs, va dans le même sens : des objectifs précis et ambitieux sont préférables à un vague « faites de votre mieux ».
Troisième étape : réécrire votre commande avec les « quatre questions de profondeur »
L’auteur d’origine a partagé une approche d’invite qu’il utilise souvent : avant de réécrire la tâche, on demande d’abord au modèle de répondre à quatre questions. On peut le formuler ainsi avec ses propres mots :
Je veux rendre cette tâche plus profonde, pas plus volumineuse. Avant de commencer, répondez d’abord : 1. Quelles actions les meilleurs professionnels de ce domaine feraient-ils que je n’ai pas demandées ? 2. Par quels documents les plus bruts commenceraient-ils ? 3. Quelles méthodes et quels outils utilisent-ils concrètement ? 4. En dehors de votre jugement et du mien, qu’est-ce qui pourrait prouver que le résultat est correct ? Réécrivez ensuite ma commande sur cette base.
Ces quatre questions correspondent aux axes de refonte évoqués plus haut : données brutes, outils professionnels, évaluation externe. Les lacunes que le modèle révèle en répondant sont souvent exactement le chaînon qu’il vous reste à combler dans votre flux de travail.
Quatrième étape : choisir le mode d’accès au modèle
Une commande de résultat s’exécute généralement sur la durée, en plusieurs tours : la stabilité de l’accès au modèle et le coût d’un changement influencent directement la mise en production. APIYI propose l’appel API des modèles Claude abordés dans cet article ainsi que d’autres modèles majeurs, et reste compatible avec les deux formats d’interface OpenAI et Anthropic. Les SDK ou frameworks d’Agent existants peuvent généralement être connectés en remplaçant simplement base_url et la clé API ; les adresses et paramètres précis sont à vérifier dans la documentation APIYI docs.apiyi.com.
| Besoin d’accès | Mode recommandé | Explication | Plateforme disponible |
|---|---|---|---|
| Projet utilisant déjà le SDK OpenAI | Format compatible OpenAI | Modifier base_url et la clé API |
APIYI apiyi.com, API officielle |
| Utiliser les capacités natives de Claude | Format compatible Anthropic | Conserver la structure de messages Anthropic | APIYI apiyi.com, API officielle |
| Vérification comparative multi-modèles | Changer le nom du modèle via une interface unifiée | Comparer différents modèles dans un même flux de travail | APIYI apiyi.com |
| Estimation des coûts | Consulter la page des tarifs | Les prix unitaires d’entrée, de sortie et de cache font foi sur la page des tarifs | Page des tarifs : https://docs.apiyi.com/models |
🚀 Conseil de démarrage : une commande de résultat doit souvent d’abord être validée en boucle fermée sur un petit périmètre, avant d’être élargie progressivement. Nous vous suggérons de commencer par APIYI apiyi.com en connectant un ou deux modèles via une interface unifiée pour des tests comparatifs. Concernant les tarifs des modèles, les modalités de facturation, les prix unitaires d’entrée et de sortie ainsi que les prix du cache, cet article ne donne aucun chiffre précis : référez-vous toujours aux données réelles de la page des tarifs APIYI https://docs.apiyi.com/models.
Élargir la portée de la délégation par le résultat à l’IA : réunir une équipe virtuelle
Quand la hauteur et la profondeur sont au rendez-vous, c’est l’étendue qui détermine si le résultat peut vraiment surprendre. L’article original recommande deux méthodes, que vous pouvez intégrer directement dans le brief de délégation par le résultat.
La première consiste à remplacer les noms par des verbes, une idée tirée de L’Art de l’innovation. Un bilan trimestriel n’est pas « un jeu de diapositives », mais « convaincre en 30 minutes un groupe de personnes très occupées d’une explication causale, et les amener à décider malgré l’incertitude ». En décrivant le travail par des actions, vous et l’IA voyez plus facilement quels domaines peuvent apporter un angle unique.
La seconde consiste à réunir votre équipe. Imaginez que ce bilan doive être absolument exceptionnel : qui iriez-vous chercher ? La réponse de l’article : des analystes, des journalistes et des éditeurs, et si nécessaire un motion designer et un designer sonore, ainsi qu’une « red team » composée d’investisseurs à la baisse et de comptables judiciaires. Avec les sessions multiples ou les sous-agents, ce n’est plus un luxe aujourd’hui.
Attention toutefois au piège du jeu de rôle : la conversation devient de plus en plus sophistiquée, mais le résultat ne s’améliore pas. Le rappel de l’article est clair : ne demandez pas au modèle d’imiter le ton d’un investisseur à la baisse, mais de reprendre les méthodes qu’il utilise réellement lorsqu’il étudie une cible.
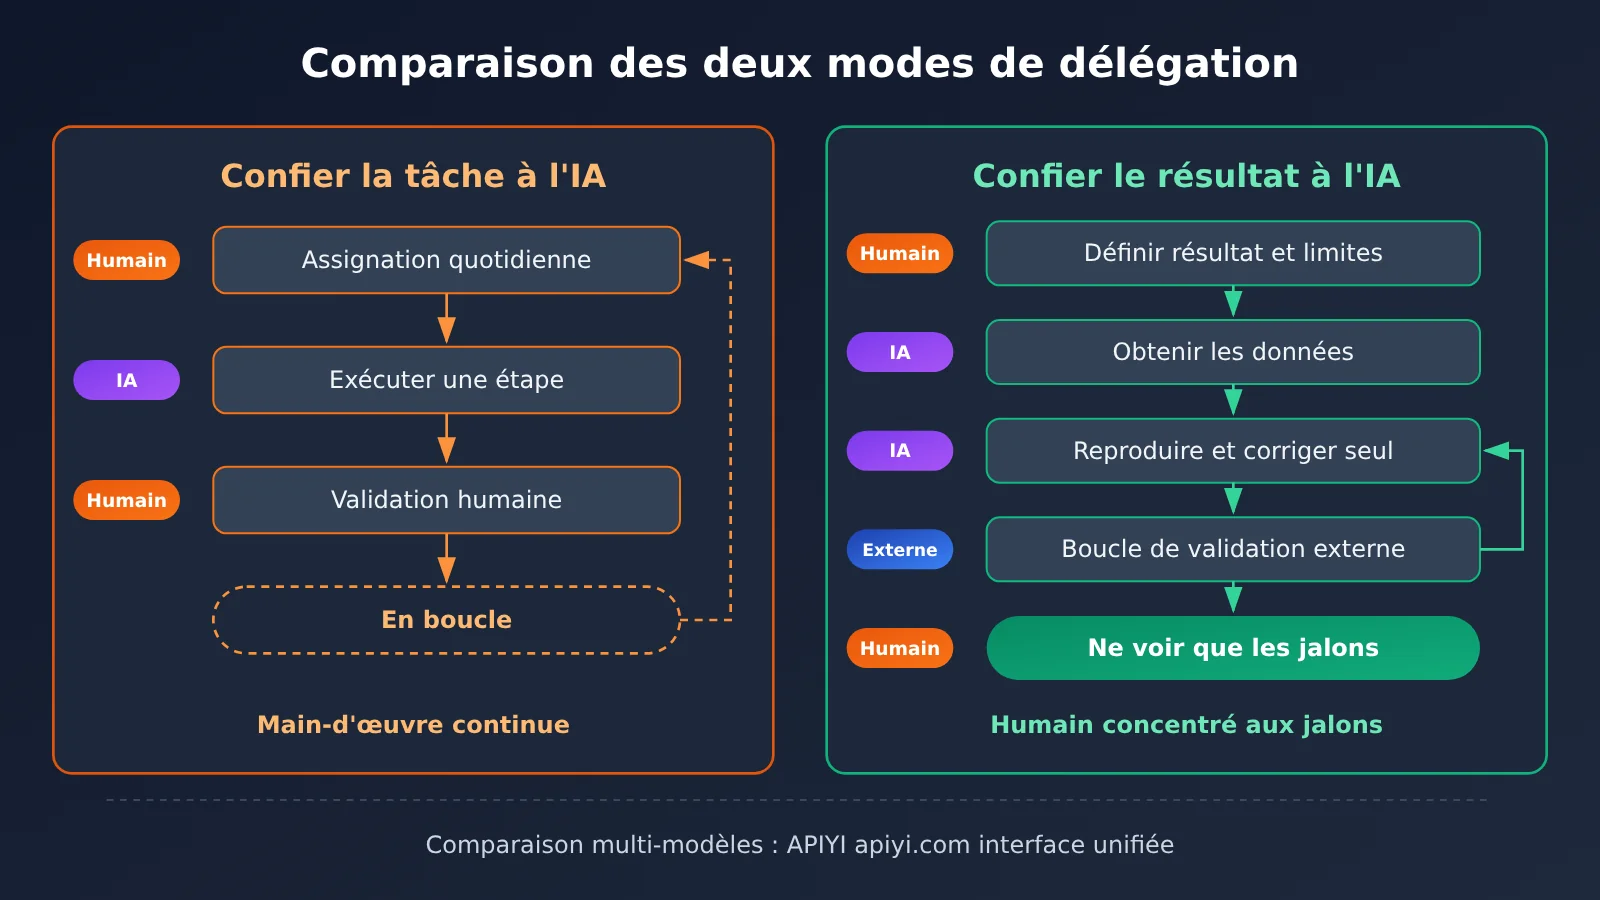
L’image ci-dessus compare la structure de l’effort humain dans les deux modes de délégation. Si vous voulez vérifier les écarts de stabilité entre différents modèles dans un scénario de délégation par le résultat, vous pouvez passer d’un modèle à l’autre dans le même workflow via l’interface unifiée APIYI apiyi.com, afin de réduire le travail d’intégration répétitif.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que « confier le résultat à l’IA » ?
Cela veut dire qu’on ne confie plus à l’IA une tâche ponctuelle et précise, mais un résultat final accompagné des conditions nécessaires : c’est elle qui décompose le travail, l’exécute et le vérifie. Par exemple, on passe de « corrige ce crash » à « fais en sorte que l’application reste stable et ne plante plus ». L’humain se contente de définir l’objectif, les limites et les points de contrôle.
Q2 : Quelle différence entre confier le résultat à l’IA et une automatisation classique par agent IA ?
L’automatisation enchaîne en général des étapes fixes, dont la conception reste humaine. Confier le résultat à l’IA, c’est aussi déléguer le choix de la méthode : l’IA peut redessiner le processus lui-même, par exemple repenser tout le mécanisme de bilan trimestriel. La première optimise l’efficacité d’exécution, la seconde élève le niveau d’abstraction du travail.
Q3 : Les modèles actuels peuvent-ils vraiment assumer une délégation de résultat ?
En partie, oui. L’auteur de l’article initial observe que plus le modèle est puissant, plus il est capable de travailler à un niveau d’abstraction élevé, et que l’on commence justement à trouver, dans cette dimension, des processus qui tournent sur la durée sans intervention continue. Mais il reconnaît aussi qu’en 2026, un objectif aussi ouvert que « va gagner de l’argent » ne fonctionnera toujours pas pour la plupart des entreprises : il faut l’assortir de limites et d’une validation externe.
Q4 : Quels types de travail se prêtent le mieux à une délégation de résultat à l’IA ?
Surtout les cas suivants :
– **Gestion de la stabilité** : la boucle fermée surveillance des crashs, reproduction, vérification du correctif
– **Analyse d’activité** : passer du bilan trimestriel à une alerte précoce continue des problèmes
– **Étude de l’attrition des utilisateurs** : chercher dans les journaux bruts les tout premiers signaux de départ, puis vérifier leur pouvoir prédictif
– Signal pour décider : si le livrable doit encore donner lieu à une réunion de discussion, cela vaut généralement la peine de remonter d’un niveau d’abstraction
Q5 : Comment monter rapidement un workflow de délégation de résultat via une API ?
Je conseille de commencer par valider la boucle minimale avec une interface unifiée :
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API
2. Consulter la documentation APIYI docs.apiyi.com et configurer `base_url` au format compatible OpenAI ou Anthropic
3. Définir un objectif à petite échelle avec le cahier des charges de délégation de résultat présenté dans cet article, et le brancher sur une source de données
4. Ajouter une validation externe, puis élargir le périmètre après un cycle complet
Q6 : Comment estimer le coût d’une délégation de résultat qui tourne longtemps ?
Une délégation de résultat génère beaucoup d’appels multi-tours. Mieux vaut d’abord enregistrer la consommation réelle de tokens sur un périmètre restreint, puis extrapoler à partir du prix unitaire. Pour le prix unitaire, la base de facturation et le tarif du cache, référez-vous aux données réelles de la page tarifs d’APIYI : https://docs.apiyi.com/models ; cet article ne donne aucun chiffre précis. Pour les contextes longs réutilisés, regardez les explications de facturation du cache sur la page tarifs.
Q7 : Quels sont les risques connus d’une délégation de résultat à l’IA ?
Il y en a trois principaux : d’abord, l’auto-évaluation du modèle n’est pas fiable, il faut absolument une évaluation externe ; ensuite, l’extension en largeur tourne vite au jeu de rôle, avec des livrables clinquants mais inutiles ; enfin, des permissions trop larges créent un risque opérationnel. Le conseil : commencer en lecture seule, ouvrir progressivement l’écriture, et prévoir pour chaque délégation une période de fonctionnement en parallèle et un plan de repli.
Remettre le résultat à l’IA plutôt que la tâche — points clés (Key Takeaways)
- La tâche contient votre jugement : c’est en livrant le résultat que vous permettez à l’IA de choisir une meilleure approche que la vôtre
- Une réunion est un signal de niveau : si le livrable doit encore être discuté en réunion, cela vaut le coup de remonter l’objectif d’un cran
- Les trois piliers de la boucle fermée : données brutes, environnement manipulable, validation externe — les trois sont indispensables
- La profondeur passe par les outils métier : tenez bon sur les bases de données et les modèles statistiques, pas sur des tableaux Markdown
- L’ampleur passe par l’emprunt de méthodes : empruntez les vraies méthodes d’autres domaines, pas seulement le ton
- Exécuter en parallèle réduit le risque : faites tourner le nouveau dispositif un cycle en parallèle de l’ancien processus avant de basculer
- Accès et facturation : branchement via l’interface unifiée APIYI, tarifs sur docs.apiyi.com/models
Conclusion
Les points clés de « Confier la tâche à l’IA, mieux vaut lui confier le résultat » :
- D’abord élever la hauteur : clarifier le résultat réellement souhaité derrière la tâche immédiate, et progresser du L0 (remplir un modèle) au L3 (réinventer le mécanisme)
- Ensuite revoir le flux de travail : ouvrir l’accès aux données brutes, établir une traçabilité, offrir un environnement manipulable, s’en tenir à une évaluation externe, concevoir le parallélisme et la sortie
- Enfin étendre profondeur et ampleur : compléter les méthodes métier avec les quatre questions de profondeur, et injecter des perspectives inter-domaines via une équipe virtuelle
Conseil : commencez par un petit scénario récurrent qui nécessite une réunion, déroulez un cycle complet avec la « spécification de délégation par le résultat », puis décidez s’il faut élargir le périmètre. Côté accès aux modèles, APIYI (apiyi.com) permet de valider rapidement les effets : il propose des appels API aux principaux modèles comme Claude, compatibles avec les formats d’interface OpenAI et Anthropic. Les détails d’intégration sont dans la documentation docs.apiyi.com, et les tarifs font foi sur https://docs.apiyi.com/models.
📚 Références
- Comment voir plus grand : guide pratique pour les utilisateurs d’IA : traduction chinoise d’InfoQ
- Lien :
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Description : source des idées centrales de cet article et des cas de gestion des plantages et de rétrospectives trimestrielles
-
How to be more ambitious: A tutorial for humans with models : texte original en anglais de Felix Rieseberg
- Lien :
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Description : présentation complète des quatre dimensions : vitesse, hauteur, profondeur et étendue
-
Centre de documentation APIYI : formats d’API et instructions d’intégration
- Lien :
docs.apiyi.com -
Description : modes de configuration des formats compatibles OpenAI et Anthropic
-
Page des tarifs des modèles APIYI : prix unitaires des modèles et base de facturation
- Lien :
docs.apiyi.com/models - Description : les tarifs d’entrée, de sortie et de cache indiqués sur cette page font foi
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI pour partager votre expérience de mise en œuvre des résultats confiés. Pour plus de ressources, consultez le centre de documentation docs.apiyi.com