Résumé : dans les appels multi-tours à Responses API avec GPT-6.2, réécrire les entrées initiales peut réduire les succès de cache et empêcher certains éléments de raisonnement d’être réutilisés. Les développeurs peuvent plutôt adopter une structure de contexte en ajout seul, puis utiliser des journaux d’usage appariés pour repérer l’écart de coût.
Commençons par la conclusion. Quand une facture augmente, il y a souvent plus d’une explication, et les causes peuvent se cumuler à deux endroits : d’une part, après modification du préfixe d’entrée, les lectures du cache diminuent, et les entrées auparavant facturées au tarif du cache passent au tarif d’entrée normal ; d’autre part, à cause d’un prefix_mismatch, GPT-6.2 a écarté certains éléments de raisonnement précoces ; le modèle doit donc raisonner à nouveau, ce qui peut entraîner un coût de raisonnement supplémentaire. La présence de ces deux postes, et leur part respective, dépend de la version du modèle, de l’endroit où la modification a lieu et du usage réel. L’exemple de calcul ci-dessous sert uniquement à illustrer la méthode de ventilation des coûts ; il ne correspond à aucune facture réelle. Si vous passez par APIYI (apiyi.com), je vous suggère de bâtir un groupe témoin à partir de l’historique d’input que vous gérez vous-même, puis de faire vos vérifications dans les journaux de consommation.
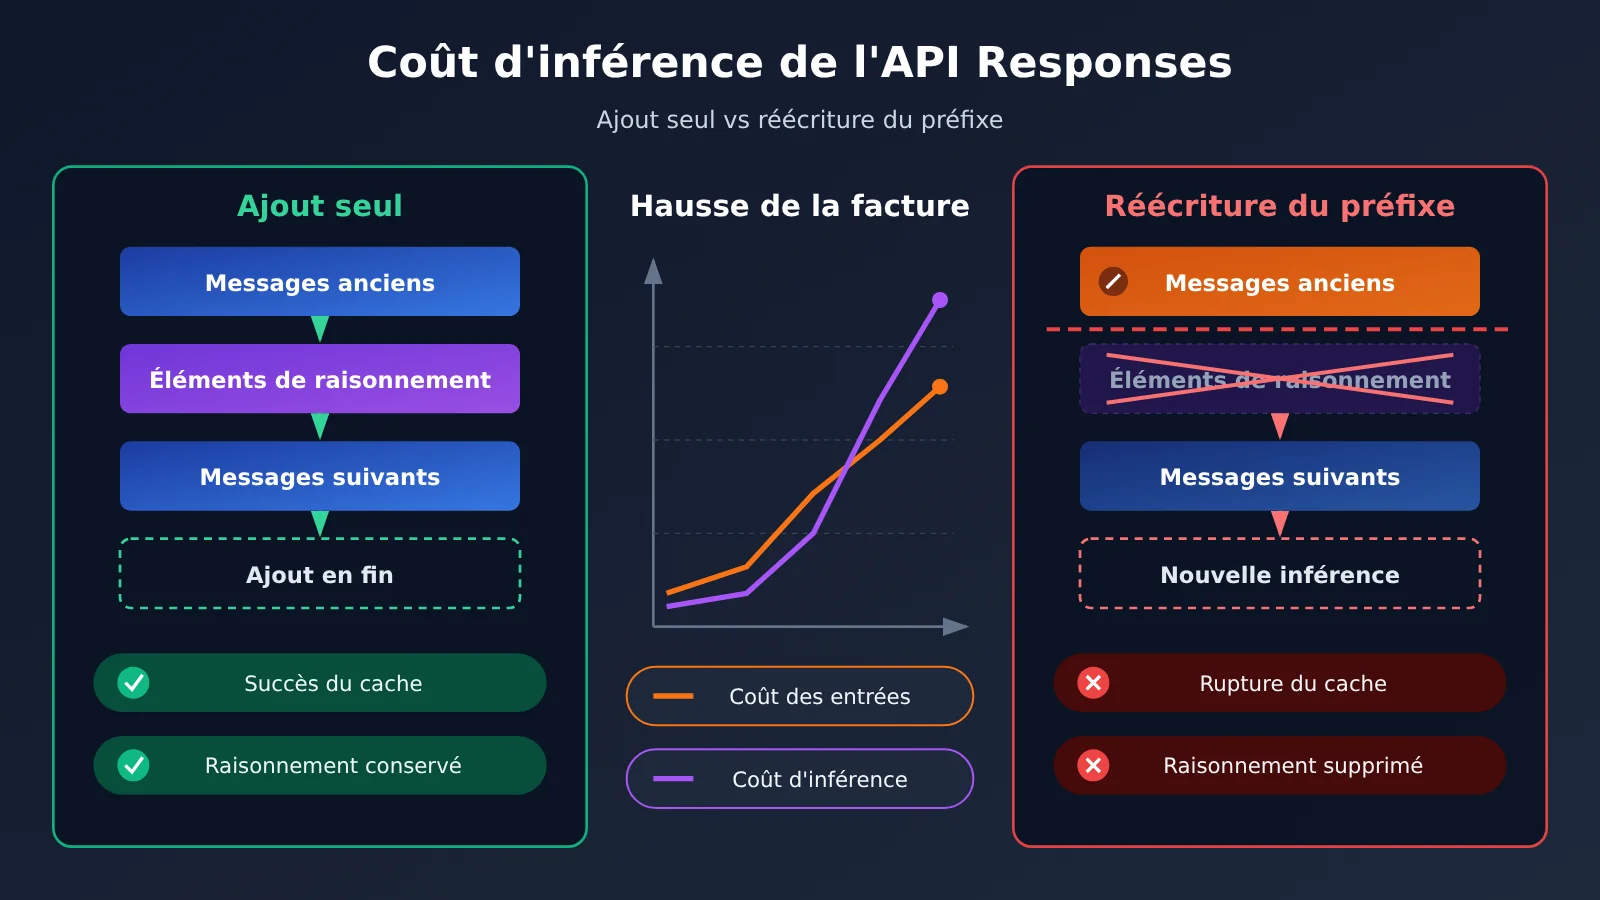
Carte des connaissances sur les coûts d’inférence de l’API Responses d’OpenAI
Le tableau ci-dessous présente les quatre sections de l’article, leurs relations et l’ordre de lecture. La section 1 explique d’où viennent les coûts, la section 2 indique quelles opérations les déclenchent, la section 3 propose une méthode de mesure, et la section 4 convertit les chiffres obtenus en montants, puis donne un plan de modification.
| N° | Question traitée | Ce que cela apporte pour la suite | Ce que vous saurez faire après lecture |
|---|---|---|---|
| 1 | Où les coûts augmentent | Deux axes d’observation : lecture du cache, sortie nouvellement ajoutée | Comprendre la signification des champs concernés dans usage |
| 2 | Quelles actions d’édition déclenchent le problème | Liste des emplacements de code à examiner | Savoir si votre façon de maintenir le contexte présente un risque |
| 3 | Comment isoler la variation | Un ensemble de paires de données comparables | Confirmer par une expérience contrôlée si le problème existe |
| 4 | Combien coûte l’écart et comment corriger | Formule de décomposition de la facture et trois modifications | Estimer l’écart et vérifier la facturation réelle à l’aide de l’ID de requête |
Si vous avez déjà confirmé qu’une réécriture du préfixe est en cours, vous pouvez commencer directement à la section 3. Les sections 1 et 2 peuvent servir de référence pour le diagnostic.
À savoir : terminologie liée au coût d’inférence de Responses API
| Terme | Explication concise |
|---|---|
| Responses API | Interface d’OpenAI pour traiter de manière unifiée les réponses du modèle, le raisonnement et les appels d’outils |
| Préfixe d’entrée | Contenu d’entrée précoce et configuration conservant le même ordre au début des requêtes à plusieurs tours |
| Correspondance de cache | La requête réutilise des tokens d’entrée déjà traités ; cette partie est facturée au prix de lecture du cache |
| Élément de raisonnement | Un type d’élément structuré dans la réponse d’un modèle de raisonnement, réutilisable dans des requêtes ultérieures compatibles |
prefix_mismatch |
Valeur de motif dans les diagnostics liés à GPT-6.2 : un préfixe antérieur a été modifié, ce qui entraîne la suppression des éléments de raisonnement |
| Ajout seul | Mode de maintenance de l’historique qui conserve le contenu et l’ordre existants et n’ajoute les événements suivants qu’à la fin |
reasoning_tokens |
Sous-post de raisonnement dans l’usage de sortie, utilisé pour observer la consommation de raisonnement |
x-request-id |
Identifiant de requête présent dans l’en-tête de réponse, pour associer la réponse côté client aux journaux du fournisseur |
1. Pourquoi le coût d’inférence de Responses API augmente à deux endroits
1.1 Première piste : moins de lectures en cache
D’après la documentation OpenAI « Prompt caching », le cache de prompt commence à correspondre à partir du début de la requête. Il suffit qu’un segment précoce soit réécrit pour que toute la partie située après le point de modification ne puisse plus être facturée au prix de lecture du cache, mais au prix d’entrée normale. Prenons l’exemple du tarif courte contexte de gpt-6.2-sol dans la grille tarifaire APIYI : l’entrée normale est à 2 dollars par million de tokens, la lecture du cache à 0,10 dollar, soit un rapport de 20 entre les deux.
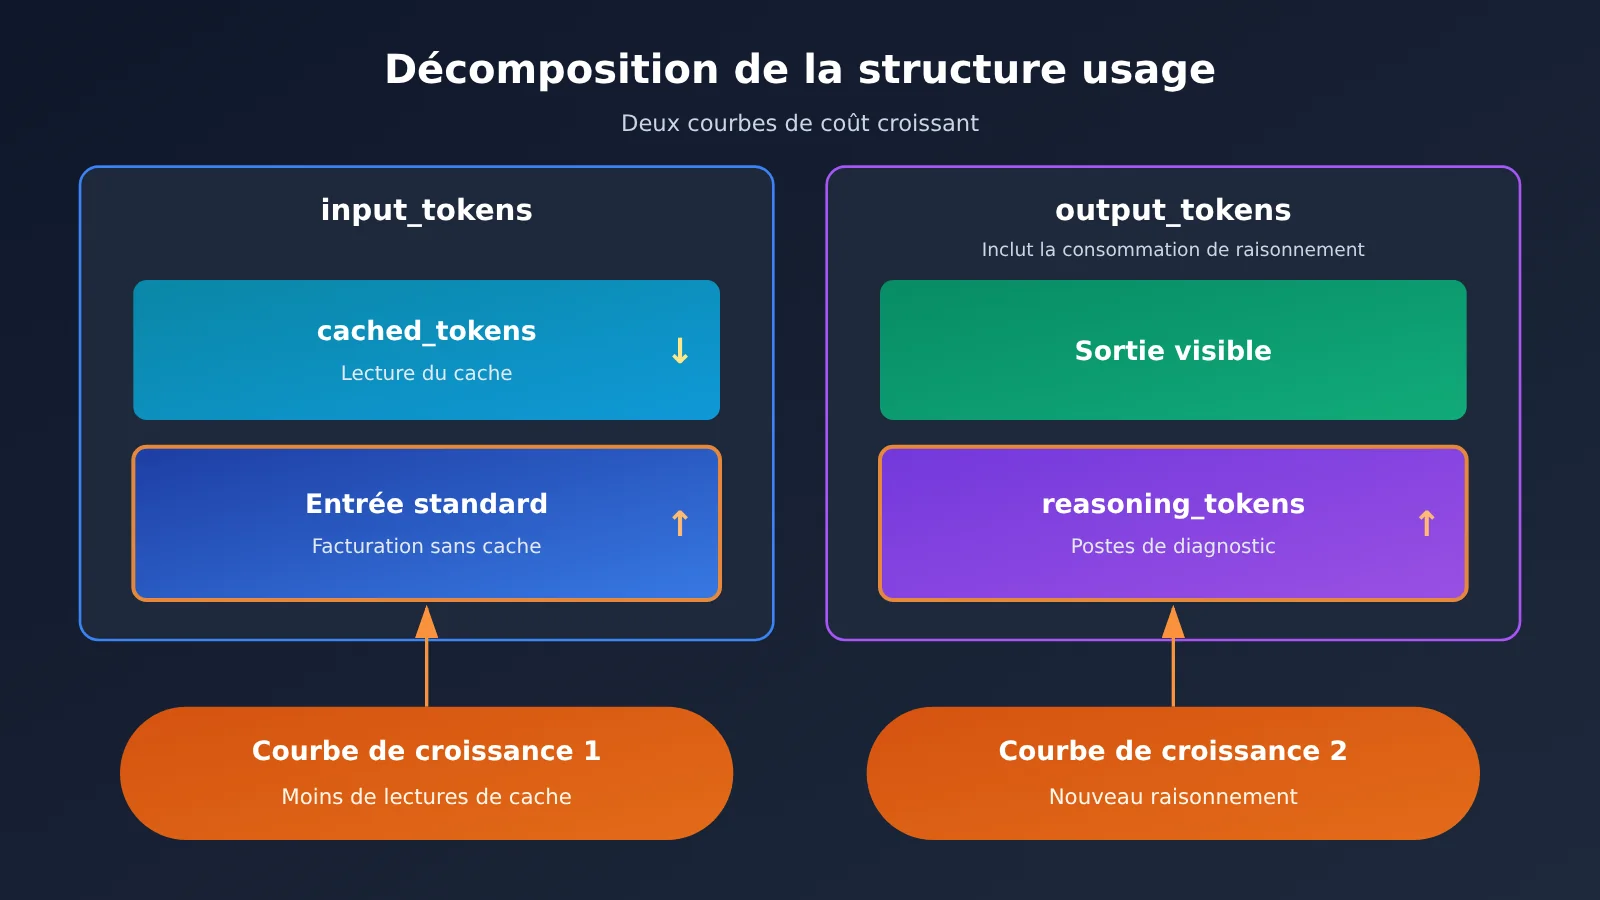
Cette variation de coût a un champ correspondant dans usage : le total input_tokens peut rester globalement identique, mais la part de cached_tokens diminue. En ne regardant que le volume total d’entrée, on ne repère pas le problème ; il faut enregistrer séparément la quantité lue depuis le cache.
1.2 Deuxième piste : de nouvelles sorties après la perte de réutilisabilité des éléments de raisonnement
Dans son changelog API du 17/11/2026, OpenAI a signalé comme comportement valable à partir de GPT-6.2 le fait que « modifier l’historique antérieur entraîne la suppression des éléments de raisonnement au motif de prefix_mismatch ». Une fois ces éléments retirés, le modèle ne voit plus le raisonnement précédent lors des tours suivants et peut devoir raisonner à nouveau, ce qui peut engendrer un coût de raisonnement supplémentaire.
Cette piste se reflète côté sortie : reasoning_tokens et le total de sortie augmentent. Elle peut se produire en même temps qu’une baisse des lectures en cache, mais dans usage ce sont deux champs distincts qu’il faut observer séparément lors du diagnostic.
1.3 Relation d’inclusion entre output_tokens et reasoning_tokens
D’après la documentation OpenAI « Counting tokens », output_tokens inclut déjà la consommation de raisonnement ; output_tokens_details.reasoning_tokens n’en est qu’un sous-post de diagnostic. Pour calculer le coût, il suffit de multiplier output_tokens par le prix unitaire de sortie. Si vous ajoutez en plus reasoning_tokens séparément, vous le comptez deux fois.
2. Quelles modifications du préfixe déclenchent une augmentation des coûts de raisonnement
2.1 Opérations courantes qui déclenchent prefix_mismatch
D’après la documentation OpenAI « Keep the prefix unchanged » et « Reasoning models », les opérations suivantes reviennent à modifier le préfixe et peuvent, sur GPT-6.2, entraîner la suppression d’éléments de raisonnement :
| Opération | Scénario de code typique | Risque |
|---|---|---|
| Réécrire d’anciens messages | Corriger après coup la formulation du deuxième tour de l’utilisateur, ou ajouter un horodatage à un ancien message | Modification du préfixe |
| Réécrire d’anciens résultats d’outil | Pour économiser des tokens, raccourcir le JSON renvoyé par un outil plus tôt | Modification du préfixe (raccourcir compte aussi comme une modification) |
| Insérer du contenu avant l’élément de raisonnement concerné | Insérer au milieu de l’historique des documents nouvellement récupérés | Modification du préfixe |
| Supprimer un élément entier sans modifier le reste | Supprimer un ancien message complet | Ne déclenche pas ce motif de suppression, mais le volume de cache touché peut encore changer |
| Ajouter après l’élément de raisonnement | Ajouter de nouveaux messages dans l’ordre chronologique | Ne déclenche pas ce motif de suppression |
« Raccourcir d’anciennes sorties d’outil » peut sembler faire économiser des tokens, mais cela revient à modifier le préfixe. Seule la suppression d’un élément complet, sans modifier les autres, évite de déclencher prefix_mismatch. Même dans ce cas, le point de départ de la correspondance dans le cache peut changer ; le volume de lecture du cache doit donc être mesuré en conditions réelles.
2.2 Différences entre changement de version, de niveau et de famille de modèles
Ces différents types de changements doivent être évalués séparément :
- Différences de version : OpenAI précise que la suppression d’éléments de raisonnement pour cause de
prefix_mismatchest un comportement qui commence avec GPT-6.2. GPT-6.1 Sol prend en chargereasoning.context: all_turns, ce qui permet de restituer des raisonnements antérieurs lorsque l’historique compatible est disponible. Lors d’une migration de 6.1 vers 6.2, la méthode existante de maintenance du contexte doit être vérifiée à nouveau. - Niveaux de raisonnement : les deux générations de Sol proposent cinq niveaux —
low,medium,high,xhighetmax— et 6.2 Sol refusenone. La pratique décrite dans un article tiers d’OrcaRouter consiste à ne pas modifier directementreasoning.effortentre deux requêtes, mais à ajouter un élémentconfiguration_updatedansinput. Cet article indique aussi que les historiques contenant ce type d’élément sont automatiquement tronqués et rejetés par/responses/compact. Avant d’adopter cette approche, référez-vous à la documentation officielle d’OpenAI. - Changement de famille de modèles et rétrogradation : selon OpenAI, changer de famille de modèles ou passer à un modèle moins capable peut aussi supprimer des éléments de raisonnement existants. Il s’agit d’une cause différente de
prefix_mismatch; les statistiques doivent donc les classer séparément.
2.3 Position et facturation des instructions de premier niveau dans GPT-6.2
Dans « Using GPT-6.2 », OpenAI indique que les instructions de premier niveau de GPT-6.2 sont ajoutées après input et facturées comme des entrées non mises en cache. Elles conviennent donc aux invites développeur temporaires du tour courant, mais pas aux longues consignes système qui restent inchangées sur la durée.
Les instructions destinées à être réutilisées sur la durée doivent être placées dans input comme premier message developer, afin d’être mises en cache. Pour ajuster des instructions de long terme, ajoutez un nouveau message developer à la fin de l’historique, plutôt que de modifier le premier message après coup.
3. Isoler les variations de coût de raisonnement de l’API Responses avec des requêtes de contrôle
3.1 Conception du groupe de contrôle
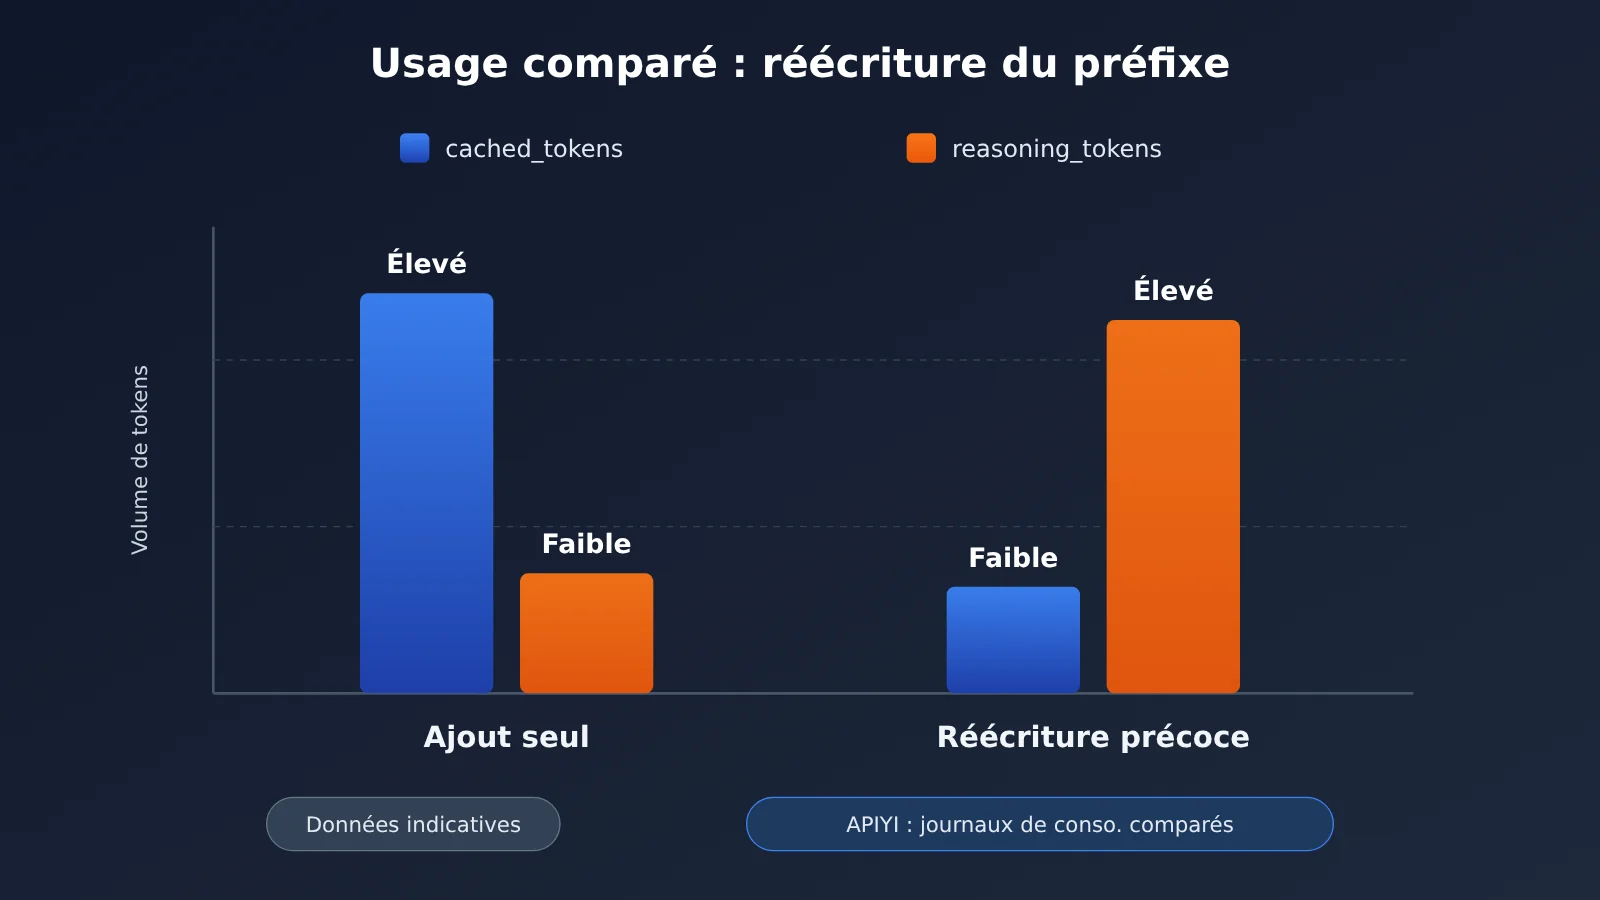
On fixe le modèle, le niveau de raisonnement, la définition des outils et le volume d’entrée, en ne changeant qu’une seule variable : la méthode de maintenance de l’historique. Le groupe A ajoute uniquement, tandis que le groupe B réécrit un élément dès les premiers tours. Les deux groupes exécutent plusieurs tours chacun, avec le même ensemble de tâches.
Chaque requête est enregistrée de manière uniforme selon le tableau ci-dessous. La qualité des tâches doit être notée manuellement ou par un script d’évaluation, car une baisse de coût ne doit pas se faire au détriment des résultats.
| Champ | Source | Utilisation |
|---|---|---|
| Groupe | Personnalisé | Distinguer le groupe ajout seul du groupe réécriture |
cached_tokens |
usage.input_tokens_details |
Observer le premier indicateur |
reasoning_tokens |
usage.output_tokens_details |
Observer le deuxième indicateur |
output_tokens |
usage |
Calculer le coût de sortie |
| Latence | Chronométrage côté client | Une hausse du raisonnement s’accompagne généralement d’une durée plus longue |
| Qualité des tâches | Notation manuelle ou par évaluation | Exclure les cas où l’on sacrifie la qualité au profit du coût |
x-request-id |
En-têtes de réponse | Rapprochement |
3.2 Exemple d’appel en ajout seul
Le code ci-dessous gère lui-même l’historique input, en ajoutant uniquement à la fin à chaque tour, tout en consignant l’usage et l’ID de requête dans le journal :
import json, time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODEL = "gpt-6.2-sol"
EFFORT = "medium"  # fixé pour toute la session, jamais modifié entre les tours

# Préfixe stable : les instructions réutilisables vont dans le premier élément d'input, puis ne changent plus
history = [{"role": "developer", "content": "Tu es un assistant de revue de code, réponds de façon concise."}]

def ask(user_text, variant="append_only", log_path="usage_log.jsonl"):
    history.append({"role": "user", "content": user_text})
    t0 = time.time()
    raw = client.responses.with_raw_response.create(
        model=MODEL,
        reasoning={"effort": EFFORT},
        input=history,
        store=False,
        include=["reasoning.encrypted_content"],  # vérifier d'abord si le groupe cible le renvoie
    )
    resp = raw.parse()
    latency = round(time.time() - t0, 2)

    # Ajout seul : la sortie de ce tour (éléments de raisonnement inclus) est replacée telle quelle à la fin de l'historique
    history.extend(item.model_dump(exclude_none=True) for item in resp.output)

    u = resp.usage
    record = {
        "variant": variant,
        "model": MODEL,
        "effort": EFFORT,
        "request_id": raw.headers.get("x-request-id"),
        "response_id": resp.id,
        "input_tokens": u.input_tokens,
        "cached_tokens": getattr(u.input_tokens_details, "cached_tokens", 0),
        "output_tokens": u.output_tokens,
        "reasoning_tokens": getattr(u.output_tokens_details, "reasoning_tokens", 0),
        "latency_s": latency,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.output_text
Pour le groupe réécriture, on réutilise la même fonction : avant le N-ième tour, on modifie le contenu de history[1] et on passe variant à "early_rewrite", tous les autres paramètres restant inchangés.
🚀 Démarrage rapide : pour constituer le groupe de comparaison, vous pouvez basculer entre
gpt-6.1-soletgpt-6.2-solavec la même clé API via APIYI apiyi.com. Avec une structure de journal identique, vous pourrez comparer l’impact des différences de version sur le cache et l’usage du raisonnement.
3.3 Diagnostic auxiliaire via la connexion directe officielle
Lors d’une connexion directe à OpenAI, vous pouvez définir prompt_cache_options.comparison_response_id sur l’ID d’une réponse précédente, puis lire le motif du diagnostic renvoyé et le nombre de tokens mis en cache. Le champ input_transformations de la réponse indique quels éléments de raisonnement ont été supprimés et pour quelle raison ; prefix_mismatch peut être associé par ID à un élément de raisonnement présent dans la sortie de l’ancienne réponse.
# Uniquement pour la connexion directe officielle à OpenAI
resp = openai_client.responses.create(
    model="gpt-6.2-sol",
    input=history,
    extra_body={"prompt_cache_options": {"comparison_response_id": prev_response_id}},
)
print(getattr(resp, "input_transformations", None))
Ce diagnostic présente deux limites : il signale, au mieux, uniquement le premier écart, et il ne permet pas de confirmer si le modèle a réellement réutilisé le raisonnement conservé. Il peut vous dire « un élément de raisonnement a été supprimé », mais pas « combien cela a coûté en plus » ; le coût doit toujours être évalué à partir des consommations appariées de la section 3.1.
3.4 Points d’attention lors d’un appel via APIYI
La connexion directe à OpenAI permet de reprendre l’état d’une session avec previous_response_id. Le guide d’appel natif de l’API Responses d’APIYI (docs.apiyi.com) indique dans son corps de texte que ce chaînage ne fonctionne pas, mais la FAQ de la même page mentionne un test du 2026-09-02 où il fonctionnait. Les deux affirmations étant contradictoires, la base la plus prudente consiste à gérer vous-même l’historique input, comme décrit à la section 3.2.
La reprise d’état, le renvoi des éléments de raisonnement chiffrés et les champs de diagnostic ci-dessus peuvent se comporter différemment selon le groupe de tokens ; il faut donc les vérifier séparément sur le groupe cible. Si les champs de diagnostic ne sont pas disponibles, les journaux de consommation appariés restent un bon critère d’évaluation.
4. Décomposer les coûts d’inférence de l’API Responses en chiffres et concrétiser la refonte
4.1 Tarifs retenus pour l’estimation
Voici les tarifs par défaut pour contexte court figurant dans le tableau général des prix d’APIYI apiyi.com (mis à jour le 20/11/2026 à 15h17, heure de Pékin, en dollars par million de tokens). La facturation réelle dépend aussi du groupe de tokens auquel appartient le modèle et du coût de recharge : il faut vérifier ces deux points séparément.
| ID de modèle APIYI | Entrée standard | Lecture cache | Sortie |
|---|---|---|---|
gpt-6.2-sol, gpt-6.1-sol |
$2 | $0.10 | $10 |
gpt-6-sol |
$2 | $0.20 | $10 |
gpt-6.2-astra |
$8 | $0.40 | $40 |
Les contextes longs se calculent à part. Pour gpt-6.2-sol, dès que l’entrée dépasse 272 000 tokens, le prix d’entrée affiché actuellement dans le tableau général d’APIYI est de $3, tandis que la page officielle OpenAI des modèles Standard indique $4 ; pour gpt-6.1-sol, le prix d’entrée en contexte long est de $4 des deux côtés. Pour les prix de lecture cache et de sortie des paliers de contexte long, référez-vous aux règles de facturation en temps réel de votre canal.
4.2 Exemple de ventilation des coûts pour deux requêtes
Hypothèses : contexte court, tarification par défaut d’APIYI Sol, les deux requêtes ont une entrée de 12 000 tokens, sans écriture de cache facturée séparément, ni frais d’outils. Tous les chiffres ci-dessous sont hypothétiques et ne proviennent pas de données mesurées.
| Élément | Préfixe conservé | Préfixe réécrit |
|---|---|---|
| Lecture du cache | 9 000 × $0.10/M = $0.0009 | 3 000 × $0.10/M = $0.0003 |
| Entrée normale | 3 000 × $2/M = $0.0060 | 9 000 × $2/M = $0.0180 |
| Sortie totale | 1 000 × $10/M = $0.0100 | 1 600 × $10/M = $0.0160 |
| Total | $0.0169 | $0.0343 |
La différence entre les deux est de $0.0174, décomposable en deux parties : $0.0114 provient du passage de 6 000 tokens d’entrée du tarif cache au tarif d’entrée normale, soit 6 000 × ($2 − $0.10) / 1 000 000 ; $0.0060 provient des 600 tokens de sortie totale supplémentaires. Ces deux parties correspondent aux deux lignes de la section 1. La différence réelle doit être calculée à partir de vos propres données usage. S’il existe une écriture de cache facturée séparément, il faut calculer séparément selon les trois catégories mutuellement exclusives : entrée normale, lecture du cache et écriture de cache.
4.3 Rapprochement par ID de requête
Après l’estimation, vérifiez la facturation réelle. Dans le journal de consommation d’APIYI apiyi.com, retrouvez avec le x-request-id de l’en-tête de réponse l’enregistrement type=2 correspondant, puis convertissez avec quota ÷ 500,000 pour obtenir le montant réellement facturé en dollars. Notez en même temps le modèle, le groupe de jetons, la plage horaire de l’appel, ainsi que la consommation d’entrée et de sortie de cette requête.
Pour l’instant, APIYI ne publie pas encore de facture comparative par préfixe, à groupe et à tâche identiques. Pour évaluer l’effet des modifications, appuyez-vous donc sur vos propres journaux de requêtes appariés et sur vos relevés de facturation.
💰 Conseil de rapprochement : associez une à une les
request_iddu journal de la section 3.2 avec le journal de consommation, pour obtenir trois colonnes « champs de consommation → montant estimé → facturation réelle ». La colonne où apparaît un écart indique à quelle étape se situe le problème.
4.4 Les trois modifications
- Figer la définition des outils et stabiliser les instructions : gardez l’ordre d’origine des définitions d’outils, sans les modifier en cours de session ; placez les instructions durables dans le premier message developer de
input. Pour les invites temporaires du tour en cours, vous pouvez utiliser le champinstructionsde premier niveau de GPT-6.2, mais en acceptant qu’elles soient facturées comme entrée non mise en cache. - Ajouter le contexte dans l’ordre : les nouveaux messages, les nouveaux résultats d’outils et les nouvelles ressources récupérées s’ajoutent à la fin. S’il faut vraiment alléger, supprimez des éléments entiers plutôt que d’en réécrire le contenu.
- Tester séparément le long contexte et la migration de version : au-delà de 272 000 jetons d’entrée, le long contexte relève d’un autre palier tarifaire ; créez donc un groupe de contrôle distinct. Pour passer de
gpt-6.1-solàgpt-6.2-sol, ou pour changer de palier ou de famille de modèles, validez d’abord avec la méthode de comparaison de la section 3, puis déployez à grande échelle.
Une fois ces modifications en place, voici comment vérifier le résultat : relancez les deux groupes de comparaison sur le même ensemble de tâches. Si la part de cached_tokens du groupe « ajout uniquement » reste stable, si reasoning_tokens ne grimpe pas anormalement et si la facturation réelle, vérifiée par ID de requête, correspond à l’estimation, c’est que cette part des coûts est désormais sous contrôle.
Références
- OpenAI « Keep the prefix unchanged » : préservation du préfixe et diagnostic
prefix_mismatch- Lien :
developers.openai.com/api/docs/guides/keep-prefix-unchanged
- Lien :
- OpenAI « Reasoning models » : réutilisation des éléments de raisonnement et exceptions à la suppression de l’élément entier
- Lien :
developers.openai.com/api/docs/guides/reasoning
- Lien :
- OpenAI « Prompt caching » et « Counting tokens » : règles de correspondance du cache et champs d’utilisation
- Lien :
developers.openai.com/api/docs/guides/prompt-caching
- Lien :
- Journal des modifications de l’API OpenAI (entrée GPT-6.2, 2026-11-17)
- Lien :
developers.openai.com/api/docs/changelog
- Lien :
- OrcaRouter « GPT-6.2 Preserved Reasoning » : la pratique de réécriture en ajout seul, telle que documentée par un tiers
- Lien :
orcarouter.ai/blog/gpt-6-2-preserved-reasoning
- Lien :
- APIYI « Tableau récapitulatif des prix des modèles »
- Lien :
docs.apiyi.com/models
- Lien :
- APIYI « API de consultation des logs »
- Lien :
docs.apiyi.com/api-capabilities/log-query
- Lien :
- APIYI « Guide d’appel natif de l’API OpenAI Responses »
- Lien :
docs.apiyi.com/api-capabilities/openai/native
- Lien :
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com