Note de l’auteur : à partir des données mesurées sur Kimi K3, dont les poids sont déjà disponibles en open source, nous estimons les exigences matérielles, le coût mensuel, le coût par token et le seuil de rentabilité d’un déploiement local de K3.1 Pro. De quoi vous aider à décider s’il vaut mieux louer, acheter ou utiliser directement l’API.
Commençons par la conclusion : Kimi K3.1 Pro devrait bientôt être disponible en open source, mais son déploiement local n’est pas adapté aux particuliers. L’éditeur indique que les poids complets seront publiés avant le 4 novembre. Le modèle est présenté comme un modèle à poids ouverts de classe 3 T. Au 26 octobre 2026, les poids de K3.1 Pro ne sont pas encore disponibles. Tous les chiffres de cet article concernant le matériel et la mémoire vidéo sont estimés à partir des mesures réalisées sur Kimi K3, déjà disponible en open source. Il faudra les vérifier après la publication des poids.
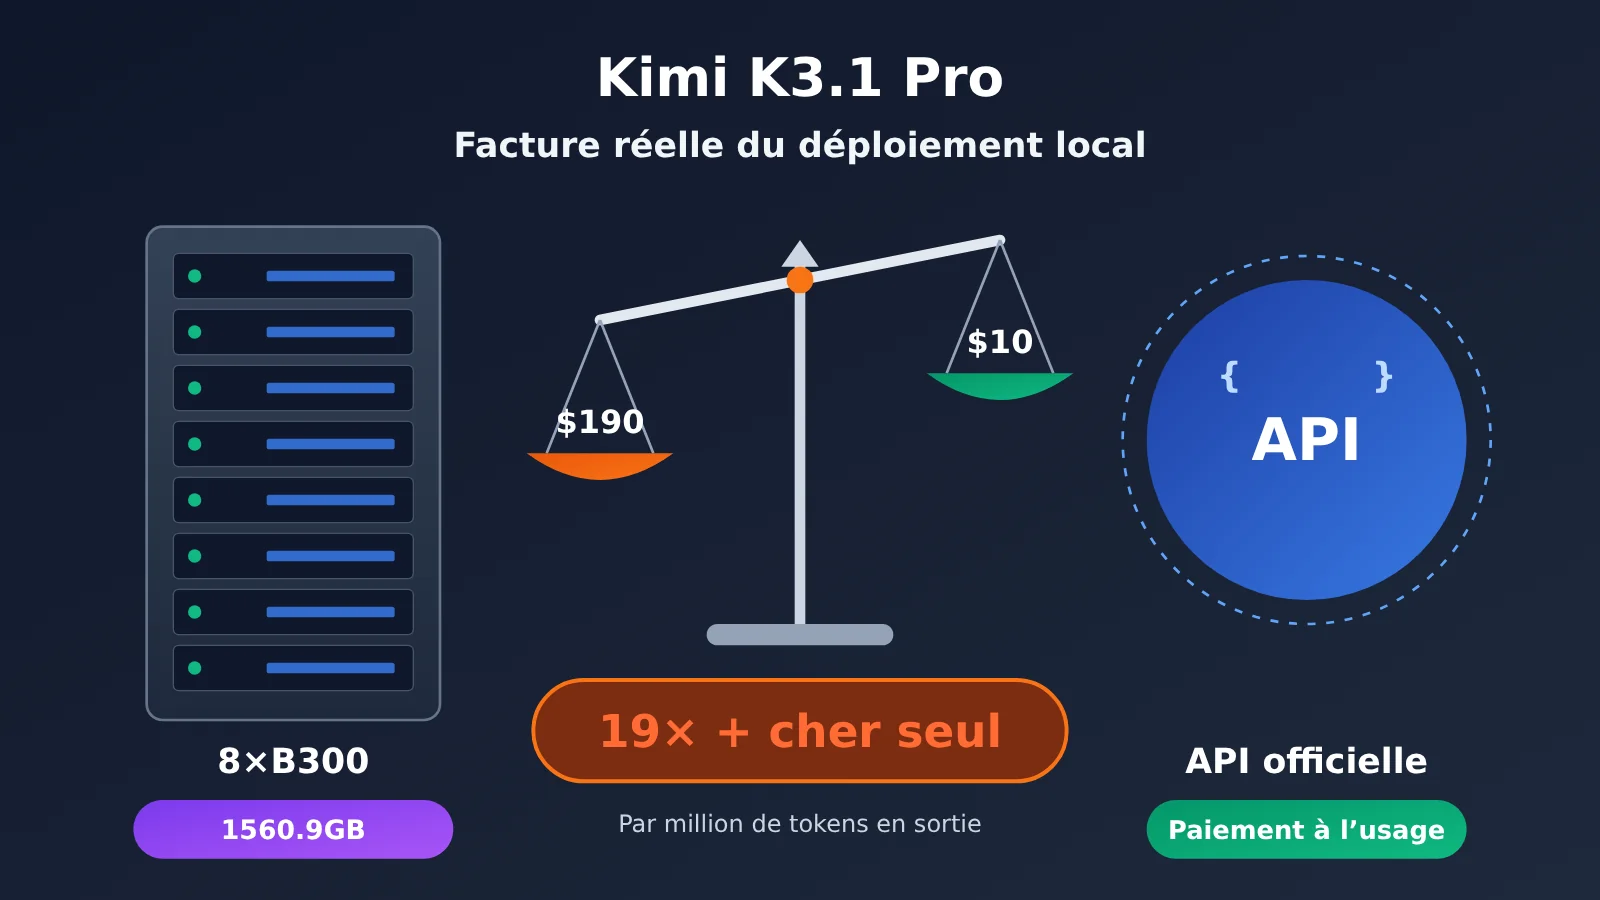
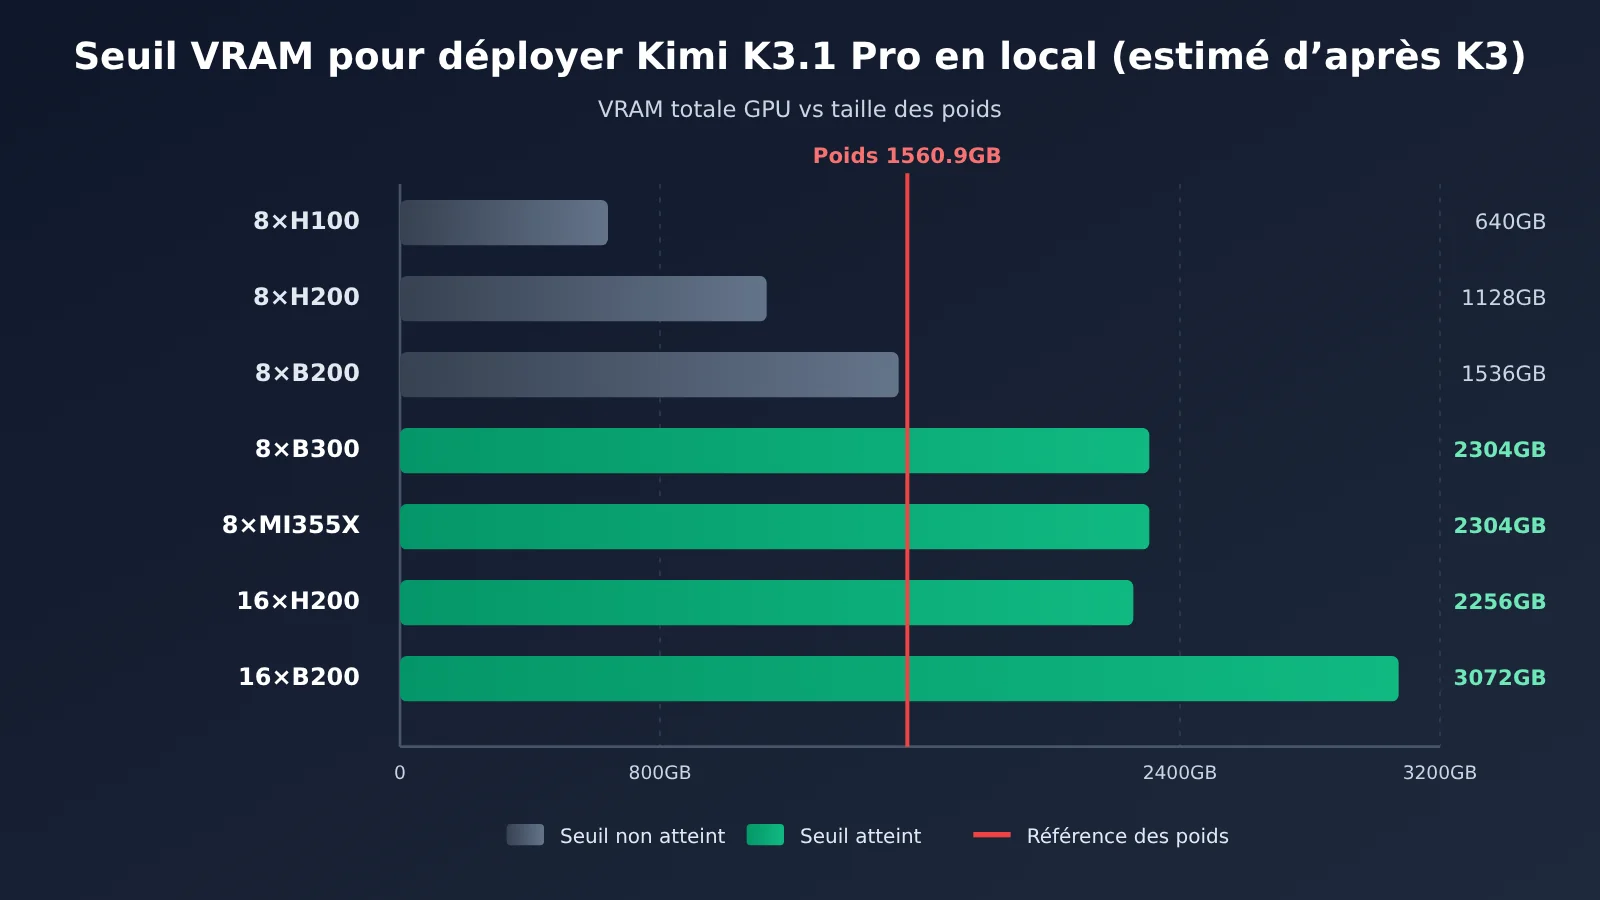
D’après les mesures effectuées sur K3, les poids à eux seuls représentent 1 560,9 Go. Huit B300 suffisent tout juste à les héberger, tandis que huit H200 manquent d’environ 400 Go. Si vous utilisez une machine équipée de 8×B300 uniquement pour vous-même, chaque million de tokens générés vous revient à environ 190,00 $, soit 19 fois le tarif de l’API officielle (10,00 $).
Le but de cet article n’est pas de vous décourager, mais de vous aider à décider s’il faut héberger le modèle vous-même. Chaque chiffre indique clairement s’il provient d’une source officielle, d’une mesure tierce ou d’une estimation de notre part : vous pourrez ainsi appliquer directement ces calculs à votre propre volume d’activité.
L’essentiel : après cette lecture, vous saurez calculer le coût réel d’un déploiement de Kimi K3.1 Pro et déterminer, à l’aide de la liste de vérification, s’il vaut mieux louer une machine, en acheter une ou utiliser directement l’API.
Points clés du déploiement local de Kimi K3.1 Pro
| Point clé | Conclusion | Niveau de preuve |
|---|---|---|
| État des poids | Pas encore publiés ; selon l’annonce officielle, leur publication est prévue avant le 4 novembre | Source officielle |
| Taille des poids | Les poids de K3 occupent 1 560,9 Go ; K3.1 Pro reprend la même architecture | Mesures indépendantes (K3) |
| Configuration minimale sur une seule machine | 8×B300 / 8×GB300 / 8×MI355X | Configurations recommandées par les frameworks d’inférence et tests réels |
| Coût unitaire en auto-hébergement | Environ 190,00 $ par million de tokens générés | Facture issue d’un test indépendant |
| Condition pour égaler l’API | Maintenir durablement un débit supérieur à 1 500 tok/s | Estimation de cet article |
Comment interpréter les différents niveaux de preuve pour le déploiement local de Kimi K3.1 Pro
Cet article distingue trois niveaux de preuve. Source officielle désigne les déclarations de Moonshot sur le blog de kimi.ai, dans la documentation de platform.kimi.ai et sur la fiche du modèle sur Hugging Face. Mesures indépendantes désigne les données de tests publiées par AWS, GPUStack, OpenZeka, des utilisateurs de Modal et d’autres sources ; les sources et les dates sont indiquées dans l’article. Enfin, estimation de cet article correspond à nos calculs fondés sur les prix publics et les débits observés. Les formules et les hypothèses sont précisées ; ces chiffres ne sont pas des données officielles.
Les projections s’appuient également sur une information officielle : K3.1 Pro est une version de Kimi K3 ayant fait l’objet d’un post-entraînement (« post-trained version of Kimi K3 »). Elle reprend la même architecture, mais bénéficie de davantage de calcul pour le post-entraînement par apprentissage par renforcement. Le nombre de paramètres, les formats de quantification et la taille des poids de K3 constituent donc des références raisonnables pour estimer les besoins minimaux au déploiement de K3.1 Pro.
Seuil matériel pour déployer Kimi K3.1 Pro localement : pourquoi il faut au moins 8 B300
【Source officielle】La fiche du modèle K3 indique : 2,8 T de paramètres au total, dont 104 B activés, répartis sur 93 couches ; 896 experts routés, dont 16 sélectionnés pour chaque token, auxquels s’ajoutent 2 experts partagés ; une fenêtre de contexte de 1 048 576 tokens. Les poids utilisent le format MXFP4 et les activations le format MXFP8. L’entraînement avec prise en compte de la quantification a été appliqué dès la phase de SFT.
【Mesures indépendantes】Une personne a comptabilisé les fichiers du dépôt Hugging Face : les 96 fragments safetensors totalisent 1 560 936 091 448 octets, soit environ 1 560,9 Go. Ce volume dépasse la valeur théorique de « 2,8 T × 0,5 octet = 1 400 Go », car certaines parties répertoriées dans la liste d’autorisation du fichier config — les couches d’attention, les experts partagés, lm_head et la tour visuelle, entre autres — sont conservées en haute précision. La recette vLLM indique un besoin minimal de 1 680 Go de mémoire GPU et précise qu’il faut au moins 8×GB300. Pour une charge de production réelle, plusieurs nœuds sont nécessaires.
| Configuration | Mémoire GPU totale | Peut fonctionner ? | Remarques |
|---|---|---|---|
| 8×H100 80 Go | 640 Go | Non | Les poids occupent 2,4 fois la mémoire disponible |
| 32×H100 | 2,56 To | À peine | SGLang propose une recette, mais Hopper ne prend pas en charge nativement MXFP4 ; une déquantification à l’exécution est nécessaire |
| 8×H200 141 Go | 1,13 To | Non | Il manque environ 400 Go : c’est l’option qui passe le moins loin |
| 16×H200 (deux machines) | 2,26 To | Oui | Déquantification également nécessaire |
| 8×B200 180 Go | 1,44 To | Non | Il manque environ 120 Go |
| 16×B200 / GB200 | 2,88 To | Oui | Configuration de référence Blackwell |
| 8×B300 / GB300 | 2,30 To | Oui | Configuration officielle par défaut ; tout tient de justesse sur une seule machine |
| 8×MI355X | 2,30 To | Oui | Validation AMD dès le premier jour |
| Une carte / RTX 4090 / Mac avec 512 Go | — | Non | Il faudrait 75 RTX 4090 pour stocker les poids |
Le cache KV n’est pas le goulot d’étranglement. K3 ne compte que 24 couches Gated MLA, qui nécessitent environ 27 Kio par token ; les 69 autres couches KDA n’ont besoin que d’un état fixe par séquence. Selon les calculs d’un tiers, le cache KV d’un utilisateur atteint environ 29,5 Go avec un contexte d’un million de tokens, et 0,7 Go avec un contexte de 8 000 tokens. Le véritable obstacle, ce sont les 1,56 To de poids du modèle.
Si vous souhaitez malgré tout déployer le modèle, voici les exigences côté frameworks (issues des recettes vLLM et du cookbook SGLang pour K3) :
- Image vLLM :
vllm/vllm-openai:kimi-k3. Elle n’existe qu’en version CUDA 13 ; il faut un pilote r580 ou ultérieur et vLLM ≥ 0.27.0. - Stratégies de parallélisme : TP / TEP nécessitent au moins 8 cartes ; DEP, au moins 16 cartes. Le cache KV distribué est indiqué comme non pris en charge sur tous les matériels répertoriés.
- Planification des nœuds avec SGLang : 1 nœud de 8 cartes pour B300 ; 2 nœuds de 8 cartes pour B200 et H200.
- Selon les propos de Moonshot pour août 2026, rapportés par un tiers, un supernœud doté d’au moins 64 accélérateurs est recommandé pour la production.
Coût réel du déploiement local de Kimi K3.1 Pro : quatre options mensuelles
Voici une estimation du coût mensuel pour faire fonctionner en continu une machine équipée de 8×B300. Le taux de change retenu est de 1 dollar = 7,25 yuans. Les prix proviennent de trois sources : les tarifs à l’usage relevés par ComputeUnion les 24 et 25 octobre 2026, des factures réelles d’utilisateurs de Modal et le compte rendu de l’étude sur le secteur de la location de puissance de calcul, relayé par Sina Finance le 20 mai 2026.
⚠️ Les prix de location et d’achat de systèmes complets en Chine (par exemple, environ 80 000 yuans par mois pour un H200, 160 000 à 190 000 yuans par mois pour un B300 loué sur cinq ans, ou 6,8 à 7 millions de yuans pour un B300 disponible immédiatement) proviennent d’une étude sectorielle, et non de tarifs publiés par les fabricants. Ils donnent uniquement un ordre de grandeur. Les offres portent généralement sur des systèmes complets à huit cartes et exigent un engagement minimal d’un an.
| Option | Base de calcul | Coût mensuel | Remarques |
|---|---|---|---|
| Location à l’usage à l’étranger (24 h/24, 7 j/7) | Système complet B300 : 342 à 464 yuans par heure × 730 heures | Environ 249 800 à 338 700 yuans (34 500 à 46 700 dollars) | Tarifs tiers et estimation de cet article |
| Mesure réelle sur Modal (24 h/24, 7 j/7) | 56,79 $/heure × 730 heures | 41 457,00 $, soit environ 300 600 yuans | Facture réelle d’un tiers |
| Location d’un système complet en Chine sur cinq ans | Estimation issue de l’étude sectorielle | 160 000 à 190 000 yuans | Tarifs non publics, engagement minimal d’un an |
| Achat + électricité | Achat à 6,8–7 millions de yuans, amorti linéairement sur 3 ans, plus environ 8 800 yuans d’électricité | Environ 198 000 à 203 000 yuans | Hors personnel d’exploitation, pièces de rechange, emplacement et bande passante |
| Arrêt après seulement 4 heures de fonctionnement par jour | Location à l’usage à l’étranger | Environ 26 000 à 30 000 yuans | Chaque redémarrage entraîne un démarrage à froid d’environ 27 minutes |
Le coût de l’électricité est estimé selon les hypothèses de cet article : charge de 13,2 kW, PUE de 1,3 et tarif de 0,7 yuan/kWh, soit environ 12 yuans par heure. L’achat semble être l’option la moins chère, mais le tableau ne tient pas compte du coût du personnel d’exploitation — qui représente justement la principale dépense cachée des petites équipes.
« Faire tourner le système 4 heures par jour, puis l’arrêter » semble économique, mais c’est difficile à mettre en pratique. Les mesures réelles sur Modal indiquent un démarrage à froid d’environ 27 minutes : il faut charger 1,56 To de poids, effectuer la compilation JIT et capturer 51 graphes CUDA. Pour une tâche de courte durée, le temps d’attente peut dépasser celui de l’inférence.
Coût unitaire de Kimi K3.1 Pro : le débit détermine combien de fois votre solution coûte plus cher que l’API
L’abonnement mensuel ne représente que la facture apparente. Pour savoir si la solution est rentable, il faut regarder le coût unitaire par million de tokens. La formule utilisée ici est la suivante : coût par million de tokens générés = coût de la machine par heure ÷ nombre de tokens générés par heure (en millions). Le numérateur est fixé à 56,79 $/h, d’après les mesures de Modal.
【Mesures indépendantes】Voici plusieurs résultats de débit obtenus avec 8 GPU B300 :
- Modal, une seule machine (TP8, MXFP4 natif) : 92 tok/s en régime stable, TTFT de 0,92 à 1,02 seconde
- OpenZeka (DGX B300, TP8, vLLM) : 105,7 tok/s avec 1 requête simultanée, 32,45 tok/s par utilisateur avec 64 requêtes simultanées. Capacité estimée : 150 personnes pour du chat ou 50 personnes pour des agents
- Exemple officiel d’AWS (29 juillet 2026, p6-b300.48xlarge) : 516 tok/s avec 8 requêtes simultanées, débit total de 4 634 tok/s en forte concurrence
- GPUStack (30 juillet 2026) : avec une entrée de 64K et 10 requêtes simultanées, vLLM atteint un temps de bout en bout de 100,5 secondes ; le débit agrégé de préremplissage est d’environ 19 000 à 23 000 tok/s
| Débit de sortie stable | Sortie par heure | Coût par million de tokens générés | Comparaison avec l’API officielle à 10,00 $ |
|---|---|---|---|
| 92 tok/s (une seule requête à pleine capacité) | 0,33 M | 171,50 $ (190,00 $ selon le calcul de l’auteur d’origine) | environ 17 à 19 fois plus |
| 500 tok/s | 1,80 M | 31,50 $ | environ 3 fois plus |
| 1 000 tok/s | 3,60 M | 15,80 $ | environ 1,6 fois plus |
| 1 500 tok/s | 5,40 M | 10,50 $ | à peu près au même prix |
| 3 000 tok/s | 10,80 M | 5,30 $ | environ deux fois moins cher |
| 4 634 tok/s (pic mesuré par AWS) | 16,68 M | 3,40 $ | environ trois fois moins cher |
Pour une personne ou quelques utilisateurs, vous vous situez en pratique sur la première ligne. Si le niveau de concurrence reste faible, la machine tourne en grande partie à vide. Le coût atteint alors environ 190,00 $ par million de tokens générés : c’est l’origine du « 19 fois plus cher » annoncé dans le titre. L’hébergement en propre ne peut rivaliser avec l’API en coût unitaire que si votre activité maintient durablement un débit supérieur à 1 500 tok/s.
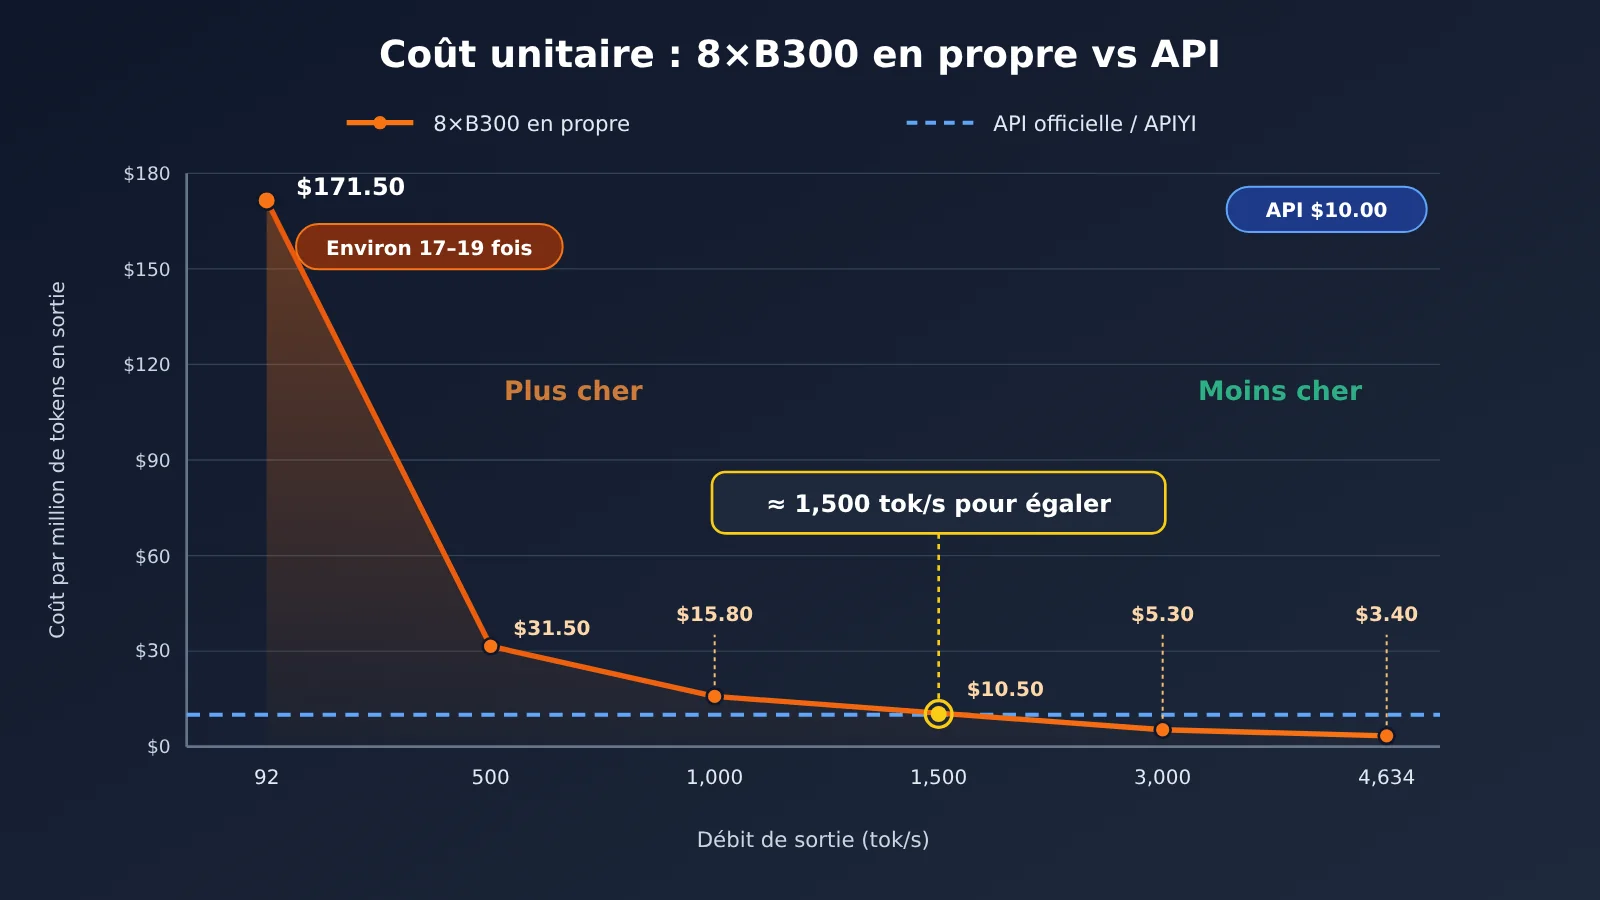
💡 À noter pour la comparaison : le graphique prend comme référence le tarif officiel de 10,00 $ par million de tokens générés. Le tarif de sortie de kimi-k3.1-pro sur APIYI apiyi.com est identique au tarif officiel et peut donc servir directement de référence.
Seuil de rentabilité du déploiement local de Kimi K3.1 Pro : combien de tokens faut-il utiliser par mois ?
Autre façon de voir les choses : combien de tokens faut-il utiliser par mois pour que l’auto-hébergement soit aussi avantageux que l’API ? Voici les hypothèses retenues pour cette estimation : comparaison avec le tarif de l’API officielle, à 2,00 $ pour les tokens d’entrée et 10,00 $ pour les tokens de sortie ; ratio de 5:1 entre entrée et sortie, courant dans les scénarios avec des agents ; aucune prise en compte des accès au cache.
| Solution d’auto-hébergement | Coût mensuel | Tokens d’entrée nécessaires par mois | Tokens de sortie nécessaires par mois |
|---|---|---|---|
| À l’étranger, à l’usage, 24 h/24 et 7 j/7 | 41 457,00 $ | Environ 10,4 milliards | Environ 2,07 milliards |
| En Chine, machine complète sur cinq ans | 190 000 yuans | Environ 6,55 milliards | Environ 1,31 milliard |
| Achat (amortissement + électricité) | 203 000 yuans | Environ 6,98 milliards | Environ 1,4 milliard |
À quoi correspondent plus d’un milliard de tokens de sortie par mois ? Selon les estimations d’OpenZeka, une machine équipée de 8 × B300 peut prendre en charge 50 utilisateurs avec des agents exécutés en parallèle. Une petite équipe de moins de dix personnes est loin d’atteindre ce volume.
Il y a aussi une variable qu’on oublie facilement : le cache. Le tarif officiel des tokens issus du cache n’est que de 0,20 $ par million. Or, dans les scénarios avec des agents et des documents longs, le taux d’accès au cache est généralement élevé. Plus la part du cache augmente, moins l’API coûte cher, et plus le seuil de rentabilité de l’auto-hébergement s’éloigne.
Dans quels cas vaut-il mieux héberger soi-même Kimi K3.1 Pro ?
L’hébergement autonome n’est pas à exclure, mais il faut avoir une raison précise. Dans les cas suivants, c’est un choix judicieux :
- La conformité ou le fonctionnement hors ligne sont indispensables : les données ne peuvent pas quitter le réseau interne ou doivent être isolées physiquement. Même une API très abordable ne conviendra pas. Cela dit, l’API officielle prend déjà en charge la conservation zéro des données (ZDR) : vérifiez d’abord si cette option répond à vos exigences de conformité.
- Vous voulez faire du fine-tuning et de la distillation : si vous souhaitez poursuivre l’entraînement de K3.1 Pro pour un domaine particulier ou le distiller en un petit modèle de 30 à 120 milliards de paramètres, vous devez disposer des poids complets.
- Vous avez des GPU inutilisés et une équipe dédiée à l’exploitation : vous disposez déjà de 8×B300, de 8×MI355X ou de deux H200 qui ne servent pas, et un ingénieur maîtrisant vLLM ou SGLang peut s’occuper de la maintenance. C’est à cette condition que le coût marginal peut être faible.
- Votre volume d’activité le justifie réellement : vous pouvez maintenir durablement un débit supérieur à 1 500 tok/s et générer au moins un milliard de tokens en sortie par mois.
Pensez aussi à vérifier les conditions de licence en amont. K3 est régi par la Kimi K3 License. D’après des résumés publiés par des tiers, une autorisation distincte est nécessaire lorsque le chiffre d’affaires annuel des services de modèles fournis à des tiers dépasse 20 millions de dollars. Pour K3.1 Pro, il faudra attendre la publication des poids et consulter le fichier LICENSE du dépôt Hugging Face ; pour l’instant, impossible de se prononcer au nom de l’éditeur officiel.
Dans quels cas il ne faut surtout pas déployer Kimi K3.1 Pro soi-même
Avec les motivations suivantes, le déploiement en propre risque fort de ne pas être rentable :
- Pour faire des économies : à moins de dépasser durablement 1 500 tok/s de débit, le coût unitaire sera supérieur à celui de l’API. Pour un usage personnel, il est environ 19 fois plus élevé.
- Pour exécuter de longues tâches tout en démarrant et en arrêtant l’instance à la demande : le démarrage à froid prend environ 27 minutes. Une solution avec démarrage et arrêt à la demande est donc pratiquement irréalisable.
- Pour un usage personnel ou par une petite équipe : vous n’exploiterez pas toute la capacité de traitement en parallèle. Autrement dit, vous paierez 56,79 $ par heure pour une vitesse de 92 tok/s.
- Pour faire tenir le modèle sur une seule machine grâce à la quantification : aucune des solutions proposées par la communauté ne convient à un usage en production. La version 1-bit d’Unsloth (UD-IQ1_S, 594 Go) atteint environ 9 tok/s sur 8×A100, soit 620,00 $ par million de tokens générés — 3,3 fois plus cher que la version complète. Le taux de concordance top-1 entre le modèle 1-bit et le modèle complet est d’environ 79 %.
kimi-k3-in-cfait tourner les poids complets avec 8,24 Go de mémoire, mais à une vitesse de 10 à 32 secondes par token : cela reste une démonstration technique.
La forme vraiment adaptée à une exécution locale sera une version distillée, si la communauté en propose une par la suite. D’ici là, pour les particuliers et les petites équipes, l’API reste la solution la plus simple.
Prise en main rapide de Kimi K3.1 Pro : commencez par tester vos usages avec l’API
Avant de décider d’héberger le modèle vous-même, nous vous recommandons vivement de tester l’API pendant un mois sur de vrais usages. Vous pourrez ainsi mesurer les proportions réelles de tokens en entrée, en sortie et issus du cache, puis reprendre le tableau de rentabilité ci-dessus pour faire vos calculs. APIYI apiyi.com propose kimi-k3.1-pro au même tarif que l’API officielle : 2,00 $ en entrée / 10,00 $ en sortie / 0,20 $ pour la lecture du cache (en dollars par million de tokens). Référez-vous à la liste des modèles de la plateforme pour connaître les modèles et tarifs disponibles.
Points clés pour l’intégration (interface compatible avec OpenAI) :
- Inscrivez-vous sur APIYI apiyi.com et créez une clé API. Les nouveaux utilisateurs bénéficient d’un crédit de test gratuit.
- Définissez
base_urldu SDK surhttps://api.apiyi.com/v1. - Indiquez
kimi-k3.1-procomme ID de modèle. Si la vitesse est une priorité, vous pouvez choisirkimi-k3.1-pro-highspeed(4,00 $ en entrée / 20,00 $ en sortie). - Paramètre d’intensité du raisonnement :
reasoning_effortacceptelow,highoumax. La valeur par défaut officielle estmax. Les évaluations officielles utilisenttemperature = 1.0ettop_p = 0.95. - Pour les conversations à plusieurs tours et les appels d’outils, renvoyez à l’identique les messages de l’assistant contenant
reasoning_content; sinon, le contexte risque d’être incorrect. - Préparez un script de suivi qui enregistre chaque jour
prompt_tokens,completion_tokenset le volume de tokens issus du cache. Ces données vous aideront à décider plus tard si vous devez héberger le modèle vous-même.
| Modèle | Entrée | Sortie | Lecture du cache | Plateformes disponibles |
|---|---|---|---|---|
| kimi-k3.1-pro | 2,00 $ | 10,00 $ | 0,20 $ | APIYI apiyi.com, API officielle de Kimi |
| kimi-k3.1-pro-highspeed | 4,00 $ | 20,00 $ | 0,20 $ | APIYI, API officielle de Kimi |
| kimi-k3 | 3,00 $ | 15,00 $ | 0,30 $ | APIYI |
🚀 Pour commencer rapidement : si votre projet est encore en phase de validation, nous vous recommandons de passer par APIYI apiyi.com. Avec une seule clé, vous pourrez tester kimi-k3.1-pro et d’autres modèles populaires. Vérifiez d’abord que K3.1 Pro est bien le meilleur choix pour vos tâches avant d’envisager de l’héberger vous-même.
FAQ sur le déploiement local de Kimi K3.1 Pro
Q1 : Peut-on déjà télécharger les poids de Kimi K3.1 Pro ?
Pas encore. L’annonce officielle indique : « The full model weights will be released by Nov 4 », autrement dit, leur publication est prévue avant le 4 novembre 2026. Tous les chiffres concernant le matériel dans cet article sont estimés à partir de K3, dont les poids sont déjà disponibles en open source. Une fois les poids publiés, vérifiez à nouveau ces estimations en fonction de la taille réelle des fichiers.
Q2 : Pourquoi 8 H200 ne suffisent-elles pas pour exécuter Kimi K3.1 Pro ?
Les 8 H200 offrent au total 1,13 To de mémoire vidéo, contre 1 560,9 Go mesurés pour les poids de K3, soit un écart d’environ 400 Go. De plus, Hopper ne prend pas en charge nativement le format MXFP4. Même avec deux machines équipées chacune de 16 H200, il faudrait déquantifier les poids à l’exécution, ce qui limiterait les performances.
Q3 : Comment le chiffre « 19 fois plus cher » a-t-il été calculé ?
Ce chiffre vient d’un test réalisé par un tiers : Modal facture 56,79 $ par heure pour 8 B300. Avec un débit stable d’environ 92 tok/s pour une seule requête, le coût revient à environ 190 $ par million de tokens générés. Divisé par le tarif officiel de l’API, soit 10 $ en sortie, cela donne 19 fois plus cher. Le calcul strictement basé sur 92 tok/s donne 171,50 $ ; la méthode de l’auteur d’origine prend aussi en compte les pertes constatées en conditions réelles.
Q4 : Une petite équipe peut-elle déployer Kimi K3.1 Pro elle-même pour réduire les coûts ?
En pratique, non. L’achat du matériel revient à environ 200 000 yuans par mois, sans compter le coût du personnel. La quantification pour faire tenir le modèle sur une seule machine revient même plus cher, pour des résultats moins bons. Pour une petite équipe, le plus réaliste est d’utiliser une API à la demande, par exemple en appelant kimi-k3.1-pro via APIYI (apiyi.com) : vous ne payez que ce que vous utilisez, et les tokens servis depuis le cache ne coûtent que 0,20 $ par million.
Q5 : Comment appeler rapidement Kimi K3.1 Pro via une API ?
Inscrivez-vous sur APIYI (apiyi.com) pour obtenir une clé API, définissez `base_url` sur `https://api.apiyi.com/v1` et indiquez `kimi-k3.1-pro` comme modèle. Votre code existant utilisant le SDK OpenAI ne devrait presque pas nécessiter de modifications. Pour les conversations à plusieurs tours, veillez à renvoyer `reasoning_content`.
Q6 : Quelles sont les limites connues du déploiement local de Kimi K3.1 Pro ?
Il y en a principalement trois. Premièrement, le démarrage à froid prend environ 27 minutes, ce qui ne convient pas à une mise à l’échelle flexible. Deuxièmement, l’image vLLM n’existe qu’en version CUDA 13 : il faut donc un pilote r580 ou ultérieur, et les anciens clusters doivent être mis à niveau au préalable. Troisièmement, le cache KV distribué n’est pris en charge sur aucun des matériels répertoriés, ce qui limite l’extension sur plusieurs machines.
Q7 : Quand le déploiement local deviendra-t-il une option réaliste ?
Il faudra attendre que la communauté propose des versions distillées de 30 à 120 milliards de paramètres. Ce sera le format adapté à une exécution locale par des particuliers et de petites équipes. À court terme, les modèles complets de l’ordre de 3 000 milliards de paramètres resteront réservés aux infrastructures de centres de données.
Points clés sur le déploiement local de Kimi K3.1 Pro
- Les poids ne sont pas encore publiés : leur publication officielle est annoncée avant le 4 novembre. Tous les chiffres disponibles sont des estimations extrapolées à partir de K3.
- Configuration matérielle minimale : les poids occupent 1 560,9 Go. Il faut au moins une machine équipée de 8×B300, GB300 ou MI355X.
- Coût mensuel : comptez environ 160 000 à 340 000 yuans par mois pour une machine qui tourne 24 h/24 et 7 j/7, selon l’option choisie.
- Coût par unité : en autohébergement, environ 190,00 $ par million de tokens de sortie, soit 19 fois le tarif de l’API officielle.
- Conditions de rentabilité : un débit soutenu supérieur à 1 500 tok/s et un volume mensuel de sortie de l’ordre du milliard de tokens.
- Pour vous lancer : commencez par appeler kimi-k3.1-pro via APIYI, à l’adresse apiyi.com, pour traiter de vrais cas d’usage. Les données recueillies vous aideront à décider si l’autohébergement est pertinent.
Liste de vérification pour choisir comment déployer Kimi K3.1 Pro
Répondez aux cinq questions ci-dessous pour déterminer s’il vaut mieux louer une machine, en acheter une ou utiliser l’API :
- La conformité interdit-elle de faire sortir les données de votre réseau interne, et la ZDR officielle ne répond-elle pas à vos exigences ? — Non : utilisez directement l’API.
- Avez-vous besoin des poids pour effectuer un fine-tuning ou une distillation ? — Oui : envisagez de louer une machine à la demande pour une courte durée, puis arrêtez-la une fois le travail terminé.
- Votre volume mensuel de tokens de sortie dépasse-t-il régulièrement 1,3 milliard ? — Non : l’autohébergement sera forcément plus coûteux que l’API.
- Disposez-vous déjà d’une machine inutilisée de classe 8×B300 ou MI355X, ainsi que d’une équipe dédiée aux opérations ? — Oui : l’autohébergement peut être envisagé. Sinon, n’achetez pas une machine spécialement pour cet usage.
- Votre activité exige-t-elle de pouvoir démarrer et arrêter le service à tout moment, et d’adapter les ressources à la demande ? — Oui : avec un démarrage à froid de 27 minutes, l’autohébergement ne conviendra pas. Choisissez l’API.
Conclusion
Les principales conclusions sur le déploiement local de Kimi K3.1 Pro :
- Un seuil d’entrée élevé : d’après les estimations basées sur K3, les poids représentent environ 1,56 To ; il faut au minimum 8 GPU B300 pour les charger.
- Un coût élevé pour un usage individuel : environ 190,00 $ par million de tokens générés sur une seule machine, soit 19 fois le prix de l’API.
- L’auto-hébergement ne devient rentable qu’à grande échelle : il faut un débit soutenu supérieur à 1 500 tok/s et un volume mensuel d’environ un milliard de tokens générés pour envisager de déployer sa propre infrastructure.
Pour la plupart des développeurs et des petites équipes en Chine, mieux vaut commencer par faire tourner son produit via une API et mesurer les volumes d’utilisation avant de décider si l’auto-hébergement en vaut la peine. Pour appeler Kimi K3.1 Pro, nous recommandons APIYI, sur apiyi.com : les prix sont identiques à ceux de l’offre officielle, les nouveaux utilisateurs bénéficient d’un quota gratuit et une seule clé API permet aussi de comparer facilement d’autres grands modèles de langage courants.
📚 Références
- Article officiel de lancement de Kimi K3.1 Pro : date de publication des poids et positionnement du modèle
- Lien :
kimi.ai/blog/kimi-k3-1-pro -
Remarque : article officiel confirmant que les poids seront publiés avant le 4 novembre
-
Tarifs officiels de l’API Kimi : prix des entrées, des sorties et du cache pour K3.1 Pro
- Lien :
platform.kimi.ai/docs/pricing/chat -
Remarque : source des tarifs de l’API utilisés comme référence dans cet article
-
Fiche du modèle Kimi K3 : architecture, quantification et licence
- Lien :
huggingface.co/moonshotai/Kimi-K3 -
Remarque : 2,8 T de paramètres au total, quantification MXFP4 et licence Kimi K3
-
Recette vLLM pour Kimi K3 : mémoire GPU minimale et exigences de déploiement
- Lien :
recipes.vllm.ai/moonshotai/Kimi-K3 -
Remarque : au moins 8 GPU GB300, pour une mémoire GPU minimale de 1 680 Go
-
Test d’inférence sur 8 GPU B300 par AWS : mesures de débit
- Lien :
github.com/aws-samples/sample-llm-inference-on-eks -
Remarque : débit total de 4 634 tok/s en situation de forte concurrence
-
Test de GPUStack sur 8 GPU B300 : comparaison entre vLLM et SGLang avec de longs contextes
- Lien :
cnblogs.com/gpustack/p/22073008 - Remarque : temps de traitement de bout en bout avec des entrées de 64K et 200K
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site d’APIYI. Pour consulter davantage de ressources sur l’intégration de modèles, rendez-vous dans le centre de documentation sur docs.apiyi.com