Note de l’auteur : comparer Qwen4-Max et Kimi K3.1 Pro sur cinq dimensions — ouverture des poids, tâches terminal, livraison de tâches longues, vision et vidéo, et coût par million de tokens — et expliquer pourquoi les scores officiels Terminal-Bench des deux éditeurs ne concordent pas.
Le verdict d’abord : si vous avez besoin des poids pour du fine-tuning, de la quantification ou un déploiement privé, choisissez Kimi K3.1 Pro. Si vous préférez une API hébergée, que la vision, la vidéo et la livraison de tâches longues comptent pour vous, et que vous voulez réduire au minimum le coût par million de tokens, choisissez Qwen4-Max. Si votre charge principale consiste en des agents en ligne de commande dans un terminal, Kimi K3.1 Pro conserve pour l’instant un avantage net.
Il ne s’agit pas d’une analyse de compromis où « chacun a ses points forts ». Tous les chiffres ci-dessous sont sourcés : ceux de Qwen proviennent du blog officiel d’Alibaba et des comparaisons sur une même figure publiées par l’éditeur lui-même, ceux de Kimi viennent de la documentation officielle de Moonshot, et les données tierces d’un instantané du classement public de l’arena (2026-11-14). Pourquoi les résultats auto-déclarés d’un même benchmark ne concordent pas entre les deux, nous y consacrons une section à part.
Ce que vous en retirerez : après lecture, vous aurez une ligne de partage claire pour votre choix, et vous saurez comment convertir les deux avantages — « moins cher » et « poids disponibles » — sur vos propres tâches.
Différences clés entre Qwen4-Max et Kimi K3.1 Pro
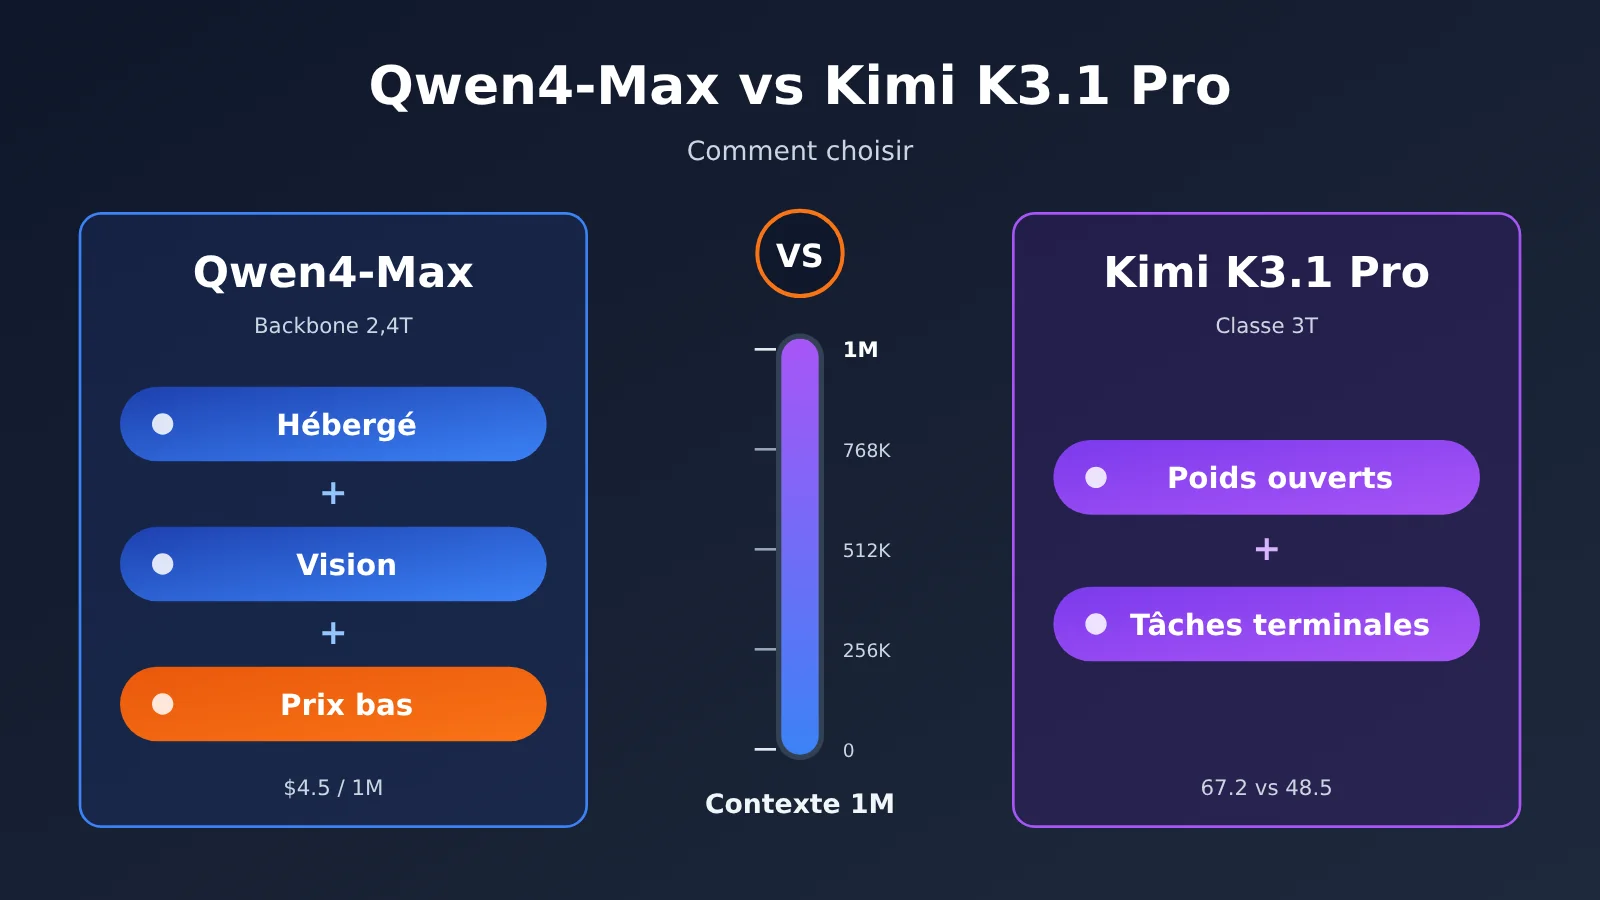
Les deux modèles sont des flagships chinois du second semestre 2026, avec une fenêtre de contexte de l’ordre de 1 M. Les paramètres affichés sont proches, mais leurs positionnements diffèrent nettement. Qwen4-Max repose sur un backbone de 2,4 T, 71 B de paramètres actifs, plus un embedding N-gram de 328 B, avec un support natif de la vision, une sortie maximale de 393 K et une chaîne de pensée maximale de 262 K ; la valeur par défaut de reasoning_effort est high. Kimi K3.1 Pro est le premier modèle de la série K3.1. Il appartient à la classe 3 T et l’éditeur le présente comme le modèle à poids ouverts de classe 3 T le plus capable, avec un contexte de 1,048,576 token.
| Critère de comparaison | Qwen4-Max | Kimi K3.1 Pro | Avantage |
|---|---|---|---|
| Échelle | Backbone 2,4 T / 71 B actifs + embedding N-gram de 328 B | Classe 3 T | — |
| Poids | Les documents publics ne mentionnent qu’une API hébergée QwenCloud | Poids ouverts | Kimi |
| Contexte | 1 M, sortie max 393 K | 1,048,576 token | Égalité |
| Tâches en terminal (même graphique Alibaba) | 48.5 | 67.2 | Kimi |
| Tâches longues et livraison sectorielle | En tête sur plusieurs critères | AutomationBench légèrement supérieur | Qwen4 |
| Vision et vidéo | Vision native, en tête sur les métriques graphiques et vidéo | Métriques en retrait | Qwen4 |
| Prix pour 1 M de tokens en sortie | $4.5 | $10 | Qwen4 |
En une phrase : l’atout de Kimi, c’est de « pouvoir être modifié » et de « faire tourner des agents en terminal » ; celui de Qwen4, c’est « un large éventail de livrables » et « un coût plus bas ». Nous détaillons ci-dessous ces cinq dimensions.
Kimi K3.1 Pro et Qwen4-Max : peut-on modifier les poids ?
C’est la ligne de démarcation la plus nette entre les deux. Kimi K3.1 Pro est un modèle à poids ouverts : une équipe peut le rapatrier sur son propre cluster pour faire du fine-tuning métier, de la quantification-compression, de la distillation, ou encore le déployer hors ligne dans un environnement à exigences de conformité strictes. Pour une équipe qui a besoin de « toucher au modèle lui-même », il n’existe aucune alternative : aucun score de benchmark, aussi élevé soit-il, ne compense cet avantage.
Pour Qwen4-Max, les informations publiques actuelles mentionnent uniquement une mise à disposition via QwenCloud sous forme d’API managée ; les sources disponibles ne parlent pas de poids ouverts. L’avantage du managé : pas besoin de gérer les cartes graphiques, le framework d’inférence ni l’autoscaling. Le revers : on ne peut adapter le modèle à son métier qu’à travers les invites, le contexte et les appels d’outils. Précisons une chose : des poids ouverts ne signifient pas automatiquement plus de sécurité ; celle-ci dépend toujours de votre déploiement, de votre contrôle d’accès et de vos procédures d’audit.
Comment transposer cela : si vous vous contentez d’« appeler le modèle », l’ouverture des poids ne vaut quasiment rien pour vous. Si vous voulez clairement faire du fine-tuning ou du déploiement privé, Kimi est la seule option de cette comparaison, et les dimensions suivantes servent uniquement à vérifier s’il est « suffisant » pour votre usage.
Qwen4-Max face à Kimi K3.1 Pro : qui domine sur les tâches en terminal ?
Les tâches en terminal désignent les situations où le modèle lit et écrit des fichiers dans un environnement en ligne de commande, exécute des commandes et corrige ses erreurs au fil des itérations : c’est le scénario le plus proche du travail réel pour un agent de codage. Sur ce point, Kimi K3.1 Pro est nettement plus fort : dans la comparaison sur un même graphique publiée par Alibaba, Qwen4-Max obtient 48.5 sur Terminal-Bench 4.0, contre 67.2 pour Kimi K3.1, soit 18.7 points d’écart — c’est l’écart le plus important de toute la figure pour Qwen4.
Pourquoi les chiffres de Terminal-Bench diffèrent selon les sources
Un détail facile à manquer : un même Kimi K3.1 Pro n’affiche pas le même score sur Terminal-Bench 4.0 dans les documents officiels des deux camps.
| Source | Kimi K3.1 Pro | Autres références |
|---|---|---|
| Documentation officielle Moonshot | 65.7 % | Claude Opus 5.5 à 66.4 %, GPT-6 Astra à 58.2 % |
| Comparaison sur un même graphique publiée par Qwen | 67.2 | Qwen4-Max à 48.5 |
Kimi annonce 65.7 %, Alibaba affiche 67.2 pour Kimi sur son graphique : 1.5 point d’écart. Cette différence vient du harness d’évaluation (framework d’agent, définition des outils, stratégies de timeout et de retry), du réglage du reasoning effort et de la version du jeu de tâches. Il ne faut pas y voir une falsification d’un camp ou de l’autre, ni fusionner les deux chiffres en un seul « score de Kimi aux tâches en terminal » qu’on citerait ensuite. De même, les 66.4 % de Claude Opus 5.5 dans la documentation Moonshot deviendraient un autre chiffre dans le cadre d’évaluation d’Alibaba : composer un classement en mélangeant les documents n’a aucun sens.
La bonne façon de lire ces chiffres : ne comparer les positions relatives qu’à l’intérieur d’un même graphique et d’un même harness. Dans le référentiel Moonshot, Kimi est légèrement derrière Opus 5.5 et nettement devant GPT-6 Astra ; dans celui d’Alibaba, Kimi devance largement Qwen4-Max. Les deux conclusions sont valables et vont dans le même sens : les capacités de Kimi K3.1 Pro en terminal le placent dans le premier peloton.
🎯 Conseil technique : les scores de benchmark varient selon le harness et l’effort. La méthode la plus fiable consiste à faire tourner un tour avec votre propre framework d’agent et de vraies tâches. Via APIYI (apiyi.com), vous pouvez appeler
kimi-k3.1-proet d’autres modèles avec la même clé API : gardez le framework inchangé et ne changez que le paramètremodel, c’est à cette condition que la comparaison aura du sens.
Autre point connexe : les indicateurs restants sur les tâches de code. Sur le graphique d’Alibaba, DeepSWE v1.1 donne un quasi-match nul entre les deux (75.7 contre 75.5), et sur ProgramBench Qwen4-Max devance de 6.5 points (31.5 contre 25.0). La documentation officielle de Moonshot indique par ailleurs 61.2 % sur Kimi Code Bench 3.0 Long-horizon, une nette progression par rapport aux 55.95 % de la génération K3 précédente. Formulé correctement : Kimi excelle dans l’interaction en terminal, tandis que Qwen4 ne se laisse pas distancer sur une partie des tâches de codage hors terminal.
Qwen4-Max vs Kimi K3.1 Pro : tâches longues et livraison métier
Si votre agent est chargé de « livrer un travail de bout en bout » — rédiger un rapport, dérouler un processus métier, traiter une problématique d’un domaine spécialisé — Qwen4-Max s’en sort mieux dans la comparaison publiée par Alibaba. Le tableau ci-dessous reprend les indicateurs liés aux tâches longues et aux scénarios métier dans la comparaison auto-déclarée par Qwen.
| Benchmark (auto-déclaré par Qwen, même base de comparaison) | Qwen4-Max | Kimi K3.1 | Écart |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 en tête de 7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 en tête de 6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 en tête de 9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 en tête de 12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 en tête de 3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi en tête de 0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 en tête de 4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 en tête de 2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | Quasiment à égalité |
La tendance est limpide : Qwen4-Max domine dans la plupart des tâches professionnelles, des livrables d’agents et des domaines spécialisés comme la biomédecine, avec des écarts de 3 à 10 points ; Kimi ne devance Qwen4 que de 0.8 point sur AutomationBench-AA, et les deux modèles font jeu égal sur HLE. À garder en tête : il s’agit du cadre d’évaluation côté Alibaba, et les chiffres de Kimi sous son propre harness pourraient être différents.
Les 393K de sortie maximale et les 262K de chaîne de pensée maximale de Qwen4-Max sont également très utiles pour les tâches longues. Concrètement, un seul appel permet de générer un rapport ou un fichier de code très long, sans devoir sans cesse découper et recoller — ce qui réduit les points de friction dans l’orchestration des agents.
Capacités visuelles et vidéo de Qwen4-Max et Kimi K3.1 Pro
Qwen4-Max prend nativement en charge les entrées visuelles, ce que montre également le graphique comparatif d’Alibaba : sur le benchmark de compréhension de graphiques Chartography, Qwen4 obtient 54,2 et Kimi 50,0 ; sur le benchmark de compréhension vidéo Video-Index, Qwen4 obtient 68,1 et Kimi 63,2, soit une avance de 4,2 et 4,9 points respectivement.
Pour les activités qui doivent lire des captures d’écran, analyser des rapports et des graphiques, comprendre des enregistrements d’écran de produits ou faire de l’analyse de contenu vidéo, Qwen4-Max est le choix le plus simple. Kimi obtient aussi des scores sur ces deux volets, mais si la vision constitue votre charge principale, l’écart risque de se creuser à mesure que les volumes augmentent.
Pour la génération front-end, on peut regarder les données de tiers. Dans l’instantané du classement public Arena du 14 novembre 2026, pour Code Arena WebDev, Qwen4-Max (xHigh) se classe 6e avec 1 750 points, mais reste marqué « Preliminary », avec 1 814 votes ; Kimi K3.1 Pro (Max) se classe 13e avec 1 686 points et 5 215 votes, et n’est plus en « preliminary ». Qwen4 a un meilleur score, mais avec un échantillon plus restreint ; son classement pourrait donc encore bouger par la suite.
Comment calculer les coûts : Qwen4-Max face à Kimi K3.1 Pro
Prix catalogue officiels (pour 1M tokens, relevés au 2026-11-16)
| Élément de facturation | Qwen4-Max (QwenCloud) | Kimi K3.1 Pro (Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| Entrée | $1.5 | $2 | $4 |
| Sortie | $4.5 | $10 | $20 |
| Lecture de cache / accès au cache | $0.075 | $0.20 | $0.20 |
| Écriture de cache 5 minutes | $1.875 | $2 | — |
| Écriture de cache 1 heure | $3 | $4 | — |
Aux prix catalogue, le prix d’entrée de Qwen4-Max représente 75 % de celui de Kimi, le prix de sortie 45 %, et la lecture de cache seulement 37.5 %. Sur une charge typique d’agent « 100 M tokens d’entrée + 10 M tokens de sortie », Qwen4-Max revient à environ $195, contre environ $300 pour Kimi K3.1 Pro. Kimi propose aussi un mode Batch, facturé à 60 % du prix standard, adapté aux tâches batch hors ligne ; la version Highspeed double le prix, pour une vitesse environ 2 à 3 fois supérieure.
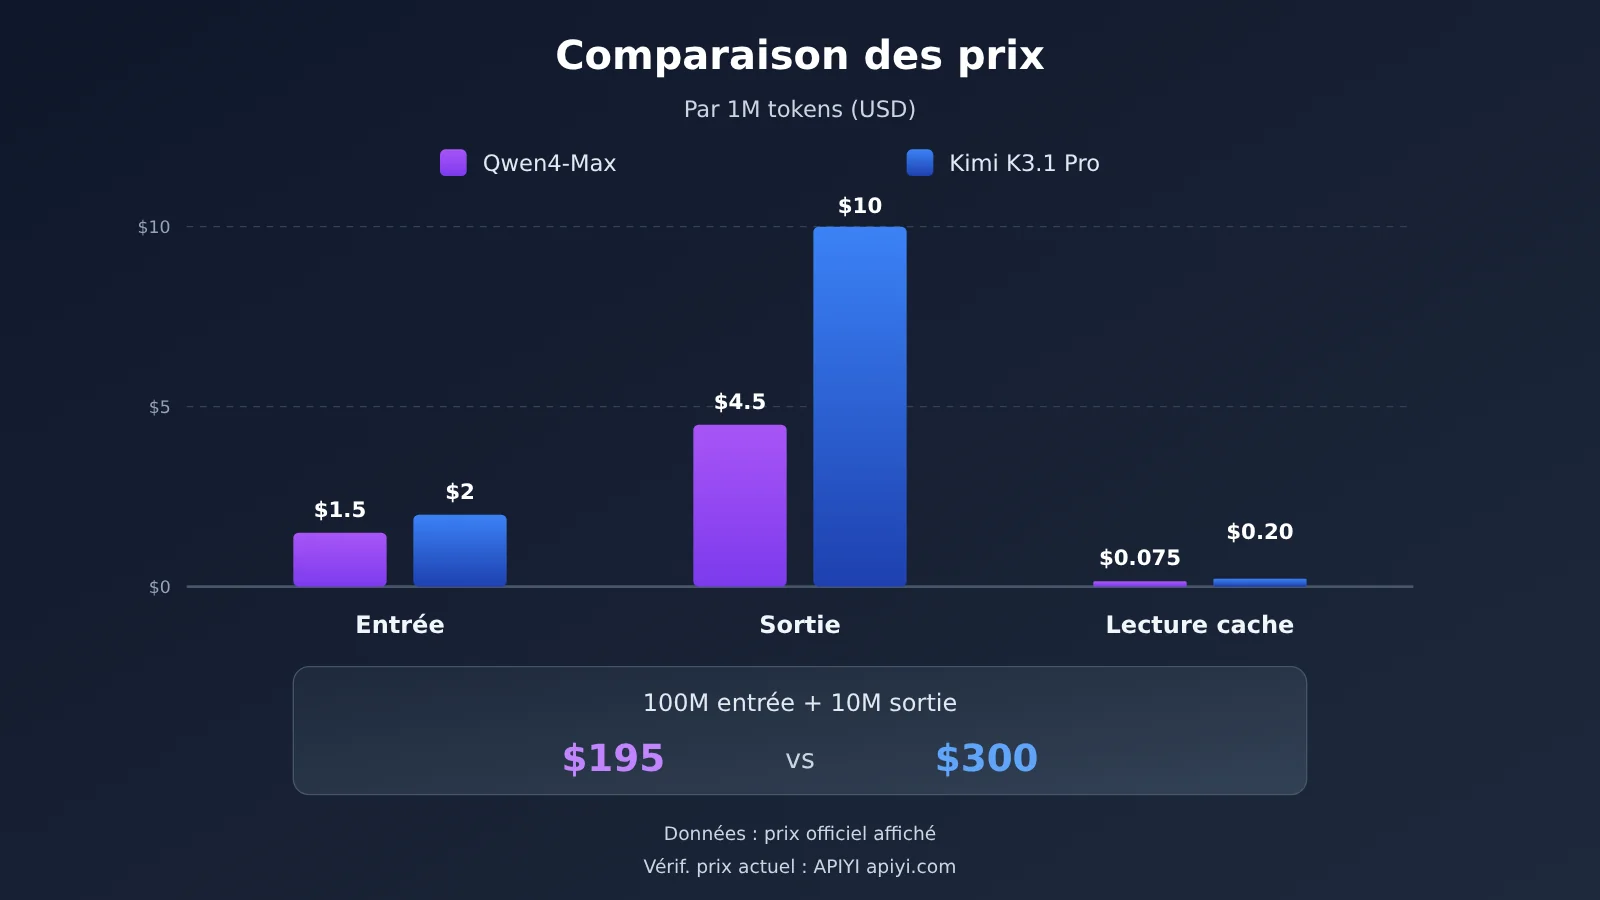
Un token moins cher ne veut pas dire une tâche moins chère
C’est le point le plus contre-intuitif côté coûts. L’instantané d’arena montre que le coût par tâche de Qwen4-Max (xHigh) est de $4.18, contre seulement $0.89 pour Kimi K3.1 Pro (Max). Qwen4 est moins cher au token, mais plusieurs fois plus cher par tâche : à un niveau d’effort élevé, le modèle génère beaucoup de tokens de chaîne de pensée, avec un volume de sortie bien supérieur à celui de Kimi.
Il faut donc, pour calculer le coût réel, regarder « prix × consommation réelle de tokens ». Par défaut, reasoning_effort de Qwen4-Max est réglé sur high. Si la tâche ne demande pas de raisonnement approfondi, il faut baisser volontairement l’effort pour transformer l’avantage du prix unitaire en avantage sur le coût total.
Prix actuels APIYI (2026-11-16)
| ID du modèle | Entrée | Sortie | Lecture de cache | Statut |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | Disponible |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | Disponible |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Disponible |
qwen4-max |
— | — | — | Pas encore disponible ; nous l’ajouterons dès que possible |
Les prix ci-dessus sont pour 1M tokens. qwen4-max n’apparaît pas encore dans la liste des modèles d’APIYI ; nous ajouterons ce modèle dès que possible. En attendant, vous pouvez utiliser qwen3.8-max pour préparer votre chaîne d’appels. Tous les noms de modèles et les prix sont ceux de la liste des modèles sur la plateforme APIYI apiyi.com. Avant de changer de modèle, nous vous conseillons de vérifier le modèle, de comparer les prix, puis de confirmer le protocole d’appel.
Comment appeler Kimi K3.1 Pro et la série Qwen via APIYI
APIYI propose une interface compatible OpenAI. Trois modifications suffisent pour l’intégrer, sans changer de SDK :
- Définissez le
base_urldu client surhttps://api.apiyi.com/v1, le chemin de requête étant/chat/completions; - Renseignez la clé API obtenue dans la console APIYI ;
- Définissez le paramètre
modelsurkimi-k3.1-pro,kimi-k3.1-pro-highspeedouqwen3.8-max; dès queqwen4-maxsera disponible, il suffira de remplacer le nom du modèle.
Pour une comparaison A/B, je vous conseille de figer l’invite, la définition des outils et le niveau d’effort, de ne changer que le champ model, puis de consigner à chaque appel le nombre de tokens d’entrée, de sortie et en cache. Vous pourrez ainsi reproduire le phénomène décrit plus haut — « le harness modifie le score » — et calculer le coût réel par tâche de chacun des deux modèles dans votre activité.
🚀 Démarrage rapide : après inscription sur APIYI apiyi.com, les nouveaux utilisateurs disposent d’un quota d’essai gratuit. Ils peuvent utiliser la même clé pour basculer entre Kimi et la série Qwen, valider d’abord les résultats avec un petit volume de trafic, puis choisir le modèle principal pour la production.
Recommandations de scénarios pour Qwen4-Max et Kimi K3.1 Pro
Quand choisir Kimi K3.1 Pro
- Auto-hébergement et fine-tuning : vous avez besoin de poids ouverts pour affiner le modèle sur un domaine, le quantifier ou le déployer hors ligne ;
- Agent de codage en terminal : la charge principale consiste en des cycles de lecture, d’écriture, d’exécution et de correction en ligne de commande ;
- Traitement par lots hors ligne : les résultats asynchrones vous conviennent, et l’offre Batch à 40 % de réduction permet de réduire les coûts ;
- Interactions à faible latence : si la vitesse compte, optez pour la version Highspeed et payez un tarif plus élevé pour gagner un facteur 2 à 3 en rapidité.
Quand choisir Qwen4-Max
- Service hébergé avant tout : vous ne voulez pas maintenir un cluster d’inférence et avez juste besoin d’une API stable ;
- Vision et vidéo : la compréhension de captures d’écran, l’analyse de graphiques et l’analyse vidéo constituent les entrées principales ;
- Livraison de tâches longues : génération de rapports, agents de processus métier, questions-réponses spécialisées en santé et biologie, etc. ;
- Sensibilité au coût par token : à condition de bien maîtriser le niveau d’effort, c’est le coût par million de tokens le plus bas.
Qwen4-Max face à Kimi K3.1 Pro : conseils de décision
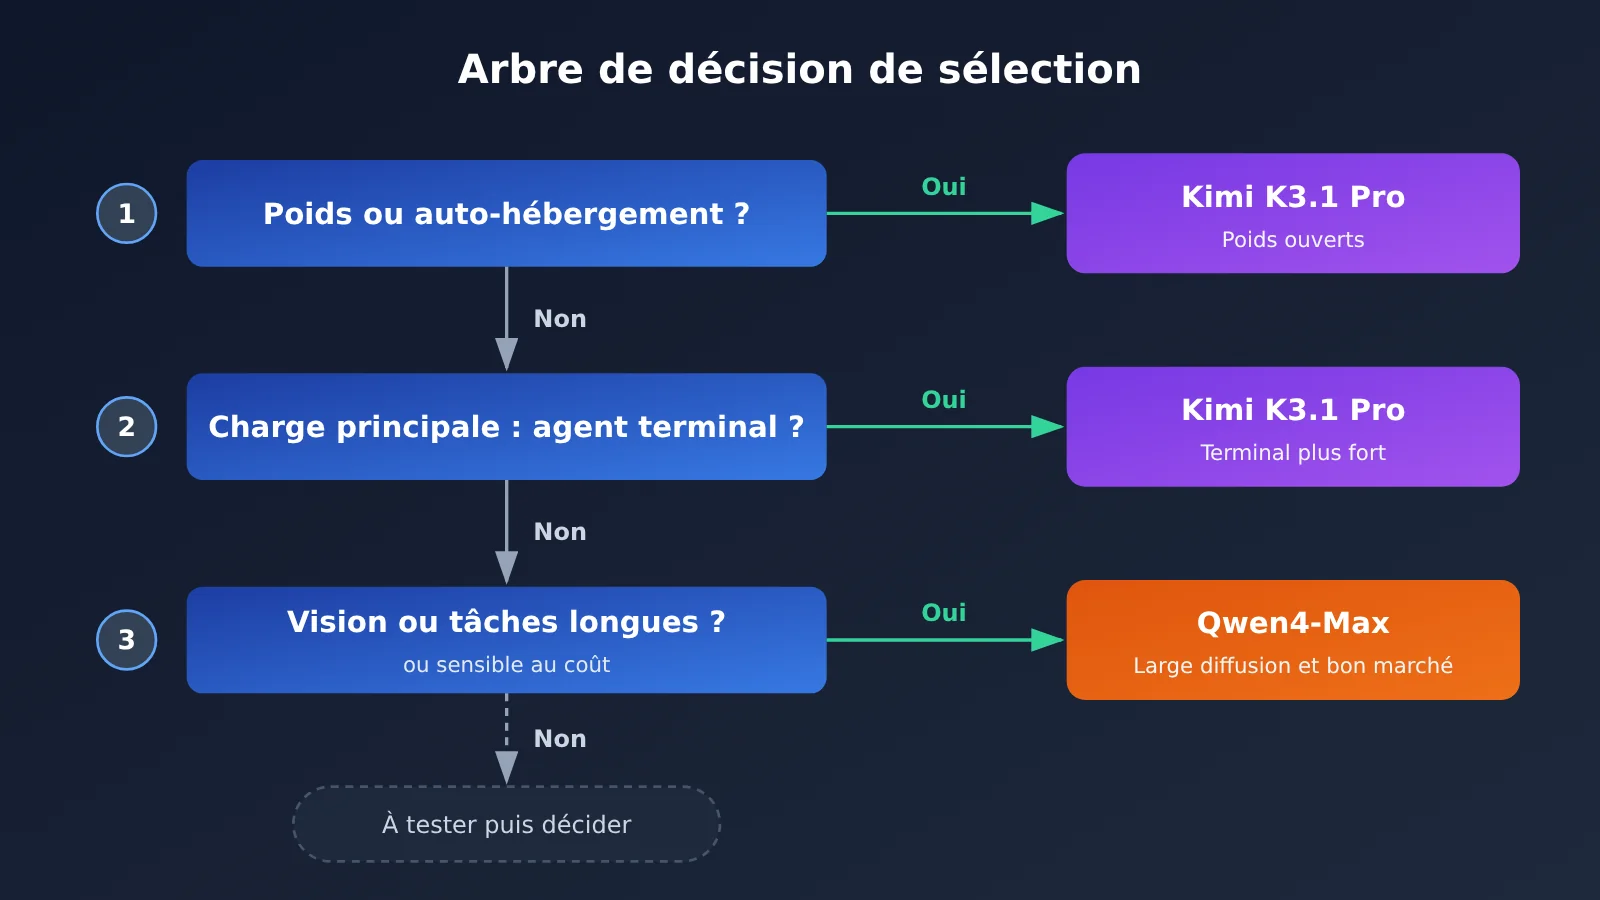
Résumons les cinq dimensions en trois questions. Premièrement, faut-il absolument récupérer les poids ? Si oui, choisissez directement Kimi K3.1 Pro. Deuxièmement, votre charge principale est-elle un agent en ligne de commande ? Si oui, Kimi est plus stable. Troisièmement, si aucune des deux réponses ci-dessus ne s’applique, alors Qwen4-Max garde l’avantage sur la vision, la livraison de tâches longues et le prix unitaire.
L’usage mixte est aussi une pratique courante : confier l’exécution en terminal à Kimi K3.1 Pro, et la compréhension visuelle plus la livraison de rapports à la série Qwen. Cette orchestration suppose que les deux modèles passent par le même jeu d’interfaces ; une passerelle unifiée permet d’économiser pas mal de travail d’adaptation.
💡 Conseil de sélection : le choix dépend en fin de compte de la répartition de vos tâches. Nous vous recommandons de lancer une comparaison sur de vraies tâches via APIYI apiyi.com, en enregistrant les taux de réussite et la consommation de tokens des deux côtés avec le même base_url, avant de désigner le modèle principal.
FAQ — questions fréquentes
Q1 : Quelle est la plus grande différence entre Qwen4-Max et Kimi K3.1 Pro ?
Kimi K3.1 Pro est un modèle à poids ouverts de niveau 3T, que l’on peut déployer et affiner soi-même ; Qwen4-Max est proposé sous forme d’API hébergée, avec une vision native et un prix affiché plus bas. Le premier excelle sur les tâches en terminal, le second sur la vision et la livraison de tâches longues.
Q2 : Le Terminal-Bench de Kimi K3.1 Pro, c’est 65,7 ou 67,2 ?
Les deux sont exacts, mais les mesures ne portent pas sur la même chose. 65,7 % vient de la documentation officielle de Moonshot, 67,2 vient de la comparaison sur la même figure publiée par Qwen lui-même ; l’écart tient au harness, à l’effort et à la version du jeu de questions. Au moment de citer, il faut indiquer la source, ne pas mélanger les chiffres et ne pas recoller des classements issus de documents différents.
Q3 : Les deux modèles ont-ils la même longueur de contexte ?
Globalement oui. Kimi K3.1 Pro est à 1 048 576 tokens, Qwen4-Max à 1M. Qwen4-Max publie en plus une sortie maximale de 393K et une chaîne de pensée maximale de 262K, ce qui est plus confortable pour une longue sortie en une seule fois.
Q4 : Pourquoi Qwen4-Max a-t-il un prix unitaire plus bas mais un coût par tâche plus élevé sur l’arena ?
Dans l’instantané de l’arena, Qwen4-Max utilise le palier xHigh, la consommation de tokens pour la chaîne de pensée est importante, et le coût par tâche atteint 4,18 $, contre 0,89 $ pour Kimi K3.1 Pro (Max). Le coût réel, c’est le prix unitaire multiplié par la consommation de tokens : il faut réduire `reasoning_effort` pour concrétiser l’avantage du prix unitaire.
Q5 : Peut-on déjà appeler Qwen4-Max via APIYI ?
`qwen4-max` n’est pas encore disponible, nous le mettrons en ligne dès que possible. Pour l’instant, vous pouvez appeler `kimi-k3.1-pro`, `kimi-k3.1-pro-highspeed` et `qwen3.8-max` sur APIYI apiyi.com, avec le base_url `https://api.apiyi.com/v1` ; les modèles et les prix sont ceux de la liste des modèles de la plateforme.
Q6 : Quels sont les défauts connus de chacun des deux modèles ?
Qwen4-Max est nettement distancé sur les tâches en terminal (48,5 contre 67,2 sur la même figure d’Alibaba), son classement arena reste en statut Preliminary, et son effort élevé par défaut peut faire grimper le coût par tâche. Kimi K3.1 Pro a un prix de sortie plus de deux fois supérieur à celui de Qwen4, et il est en retrait sur la vision, la vidéo et la plupart des indicateurs de livraison sectoriels.
Qwen4-Max face à Kimi K3.1 Pro : points clés à retenir
- Les poids sont un critère décisif : pour le fine-tuning ou un déploiement privé, seul Kimi K3.1 Pro est disponible.
- Tâches en terminal : Kimi est devant : sur le graphique d’Alibaba, Kimi devance Qwen4-Max de 18,7 points.
- Les scores dépendent du protocole : 65,7 et 67,2 viennent de harness différents et ne doivent pas être mélangés.
- Livraison et vision : Qwen4 est devant : en tête sur plusieurs benchmarks, notamment JobBench, APEX-Agents et Video-Index.
- Tarif unitaire plus bas pour Qwen4 : le prix de sortie n’est que de 45 % de celui de Kimi, mais il faut maîtriser le paramètre effort.
- Pour commencer : sur APIYI, utilisez la même clé API pour basculer entre
kimi-k3.1-proet la série Qwen et comparer.
En résumé
Les conclusions clés de la comparaison Qwen4-Max / Kimi K3.1 Pro :
- Peut-on modifier le modèle : les poids ouverts sont l’avantage exclusif de Kimi K3.1 Pro ;
- Terminal et livraison : Kimi brille dans les agents en ligne de commande, Qwen4-Max dans la livraison de tâches longues, la vision et la vidéo ;
- Coût : Qwen4-Max est le moins cher par million de tokens, mais la facture réelle dépend des tokens consommés à cause de l’effort.
Les scores de référence ne donnent qu’une direction ; la réponse finale doit venir de vos propres tâches. Je vous recommande de passer par APIYI apiyi.com avec une interface unifiée pour lancer une petite comparaison à faible trafic. Une fois qwen4-max disponible, vous pourrez aussi remplacer le modèle sans friction et continuer à vérifier.
📚 Références
- Blog officiel de Qwen4-Max : spécifications du modèle, fenêtre de contexte et tarification QwenCloud
- Lien :
qwen.ai/blog?id=qwen4-max -
Description : contient les données comparatives sur une même image, telles que déclarées par Qwen lui-même
-
Prise en main rapide de Kimi K3.1 Pro : documentation officielle de Moonshot
- Lien :
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md -
Description : contient les scores officiels de Terminal-Bench 4.0 et de Kimi Code Bench 3.0, communiqués par Moonshot
-
Tarification des modèles conversationnels Kimi : page tarifaire officielle de Moonshot
- Lien :
platform.kimi.ai/docs/pricing/chat.md -
Description : règles de facturation des versions Standard, Highspeed et Batch
-
Arena Code Arena WebDev : capture du classement public, 2026-11-14
- Lien :
arena.ai - Description : classement établi par les votes de tiers et coût par tâche
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour davantage de ressources, consultez le centre de documentation docs.apiyi.com