Note de l’auteur : lorsqu’une session WebRTC de GPT-Live-1.1 passe en veille, le tarif de la voix tombe de 0,05 $US par minute à 0,02 $US par minute. Cet article explique comment configurer cela, comment vérifier la facturation et combien un appel peut réellement faire économiser.
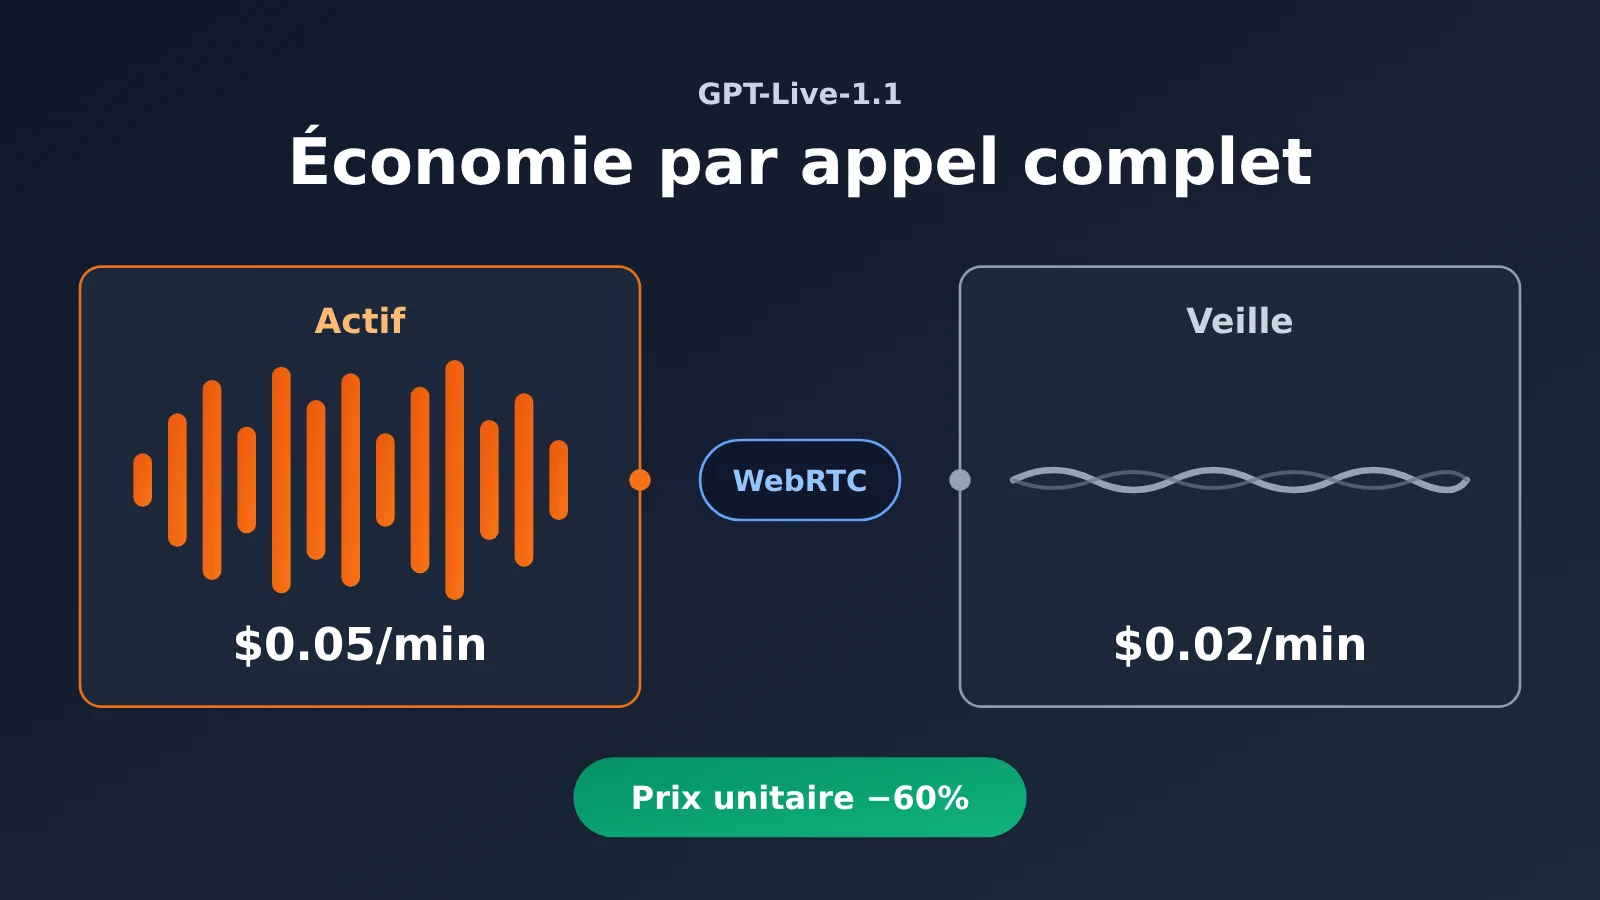
Résumé en une phrase : pour une session WebRTC de GPT-Live-1.1 qui remplit les conditions et passe en veille, le tarif de la voix descend de 0,05 $US par minute à 0,02 $US par minute. L’économie réelle dépend de la répartition entre temps actif et temps en veille, ainsi que de la consommation des modèles backend et des outils.
La conclusion a des conditions. Le tarif de veille de 0,02 $US par minute n’est disponible que dans les sessions WebRTC configurées pour la veille et dont l’inférence est suspendue. Dans ces conditions, le pourcentage d’économie est à peu près égal à « part du temps passé en veille × 60 % ». Si la conversation reste active en permanence, ou si la connexion principale passe par WebSocket ou SIP, cette baisse de prix ne s’applique pratiquement jamais. Par ailleurs, l’inférence backend et les appels d’outils sont facturés séparément ; sur les appels longs, cette part est souvent plus élevée que le coût de la voix.
Ce n’est pas une brève qui se contente de reprendre une grille tarifaire. La suite détaille les conditions de facturation et les champs de configuration à partir de la documentation officielle d’OpenAI, et propose une méthode de calcul permettant de rapprocher les montants facturés. Les exemples de scénarios présentés ici sont hypothétiques : ils servent à illustrer le calcul et ne reflètent pas une facture réelle.
Terminologie liée à la veille de GPT-Live-1.1 sur WebRTC (To Know)
Commençons par unifier quelques termes : la facturation et la configuration présentées ensuite s’appuient sur ces définitions.
- WebRTC : un ensemble de techniques de communication qui transporte en temps réel des médias comme l’audio entre un navigateur et des appareils. C’est aussi le seul mode de transport applicable à la veille native de GPT-Live.
- WebSocket : une connexion bidirectionnelle persistante. Une application peut l’utiliser pour transmettre de l’audio, des événements de session ou des messages de contrôle sideband.
- SIP : le protocole d’établissement et de contrôle de session couramment utilisé dans les réseaux téléphoniques ; l’accès téléphonique de GPT-Live passe par cette voie.
- Veille (standby) : dans cet article, désigne précisément l’état de facturation dans lequel une session WebRTC remplissant les conditions reste connectée mais arrête l’inférence.
- Temps actif : la phase facturée au tarif actif, qui peut inclure la période de silence précédant le déclenchement des conditions de mise en pause.
- Réveil vocal : le moment où le service détecte que quelqu’un parle et démarre ou reprend l’inférence.
- Seuil d’inactivité : la durée sans parole au bout de laquelle la session passe en veille ; cette valeur est configurable.
- Connexion sideband : une connexion distincte de la connexion vocale principale, utilisée pour le contrôle côté serveur et la surveillance des événements ; sa forme la plus courante est le WebSocket sideband.
Points clés du mode veille WebRTC de GPT-Live-1.1
| Point clé | Explication | Valeur pour les développeurs |
|---|---|---|
| Deux niveaux de tarif | Actif à $0.05/minute, veille WebRTC éligible à $0.02/minute (OpenAI Pricing) | Le tarif unitaire chute de 60 % pendant les moments calmes |
| Facturation à la seconde | Les deux tarifs sont décomptés à la seconde, sans arrondi à la minute entière | Même les courtes pauses comptent dans les économies |
| WebRTC uniquement | La veille à bas prix nativement disponible ne s’applique qu’aux sessions WebRTC configurées pour la veille, avec inférence mise en pause | Le coût entre en jeu dès le choix du mode de transport |
| Backend facturé à part | La consommation des modèles backend et des outils est facturée séparément | La veille n’optimise qu’une seule ligne de la facture |
| Latence du premier tour | Après un réveil depuis la veille, la première réponse à un court message vocal peut être plus lente | Il faut arbitrer entre coût et expérience |
Comprendre, via la grille tarifaire, le dénominateur des 60 % de veille de GPT-Live-1.1
Commençons par les dates de référence. Le changelog de l’API OpenAI date cette mise à jour du 2026-11-19, tandis que la page d’annonce de la communauté des développeurs OpenAI affiche 2026-11-20. Cet écart d’un jour tient très probablement à une différence de fuseau horaire de référence ; dans cet article, chaque date est accompagnée de sa source. D’après la page OpenAI Pricing, la voix active des deux modèles GPT-Live est facturée $0.05/minute, la veille WebRTC éligible $0.02/minute, le tout à la seconde, avec la consommation des modèles backend et des outils facturée à part.
Le « −60 % » est souvent mal lu comme « 60 % d’économie sur tout l’appel ». Le dénominateur de ces 60 %, c’est le tarif unitaire actif : (0.05 − 0.02) ÷ 0.05 = 60 %. Ce chiffre ne décrit que la baisse du tarif unitaire par minute une fois la veille enclenchée. Pour obtenir le taux d’économie sur l’ensemble de l’appel, il faut encore le multiplier par la part de temps passé en veille.
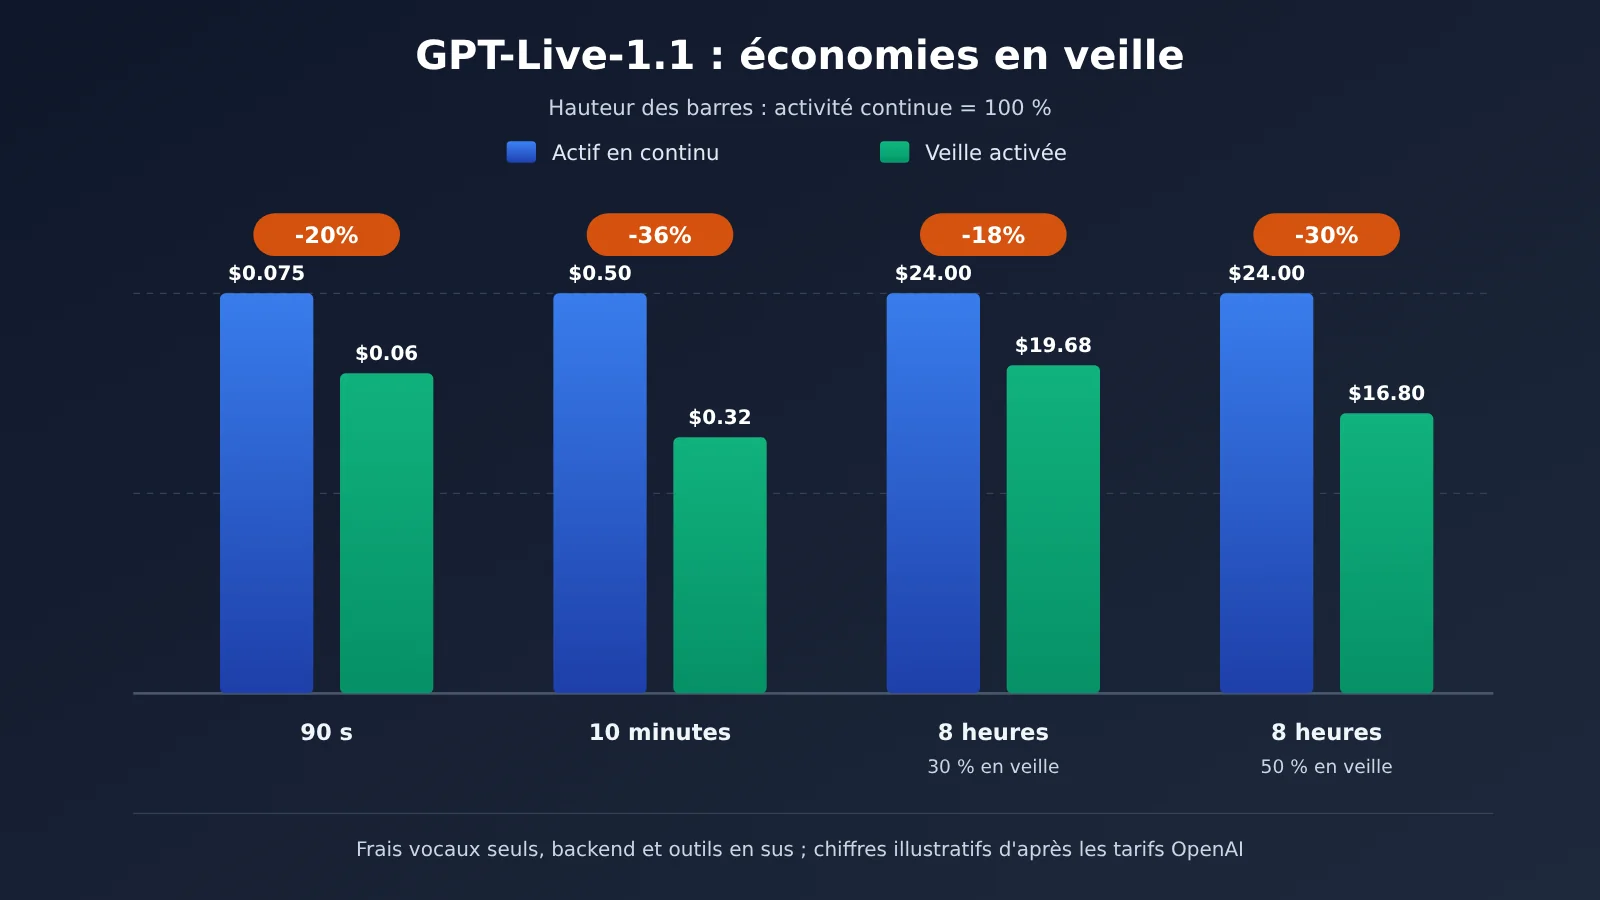
Voici un exemple hypothétique. Sur une session de 10 minutes, avec 4 minutes actives et 6 minutes en veille dans la durée facturée, les frais de voix s’élèvent à 4×0.05 + 6×0.02 = $0.32. Les mêmes 10 minutes entièrement actives coûtent $0.50. En comparant les deux, les frais de voix baissent de 36 %, ce qui correspond exactement à 60 % × 60 % de part de veille.
| Poste de facturation | Tarif unitaire (prix officiel OpenAI) | Granularité de facturation | Impacté par la veille ? |
|---|---|---|---|
| Voix active | $0.05/minute | À la seconde | Oui, partiellement remplacé par la veille |
| Voix en veille WebRTC | $0.02/minute | À la seconde | Uniquement les WebRTC éligibles |
| Tokens du modèle backend | Selon le tarif du modèle choisi | Au token | Non |
| Appels d’outils | Selon le tarif de l’outil | Par appel ou au volume | Non |
Comment configurer la veille WebRTC de GPT-Live-1.1 : de la configuration de session à la vérification de facturation
D’après le document d’OpenAI « Managing GPT-Live sessions », les options de configuration de la veille WebRTC ne sont pas nombreuses, mais chacune influence directement la façon dont les phases de facturation sont découpées.
| Champ / événement | Valeur ou signification | Points de configuration |
|---|---|---|
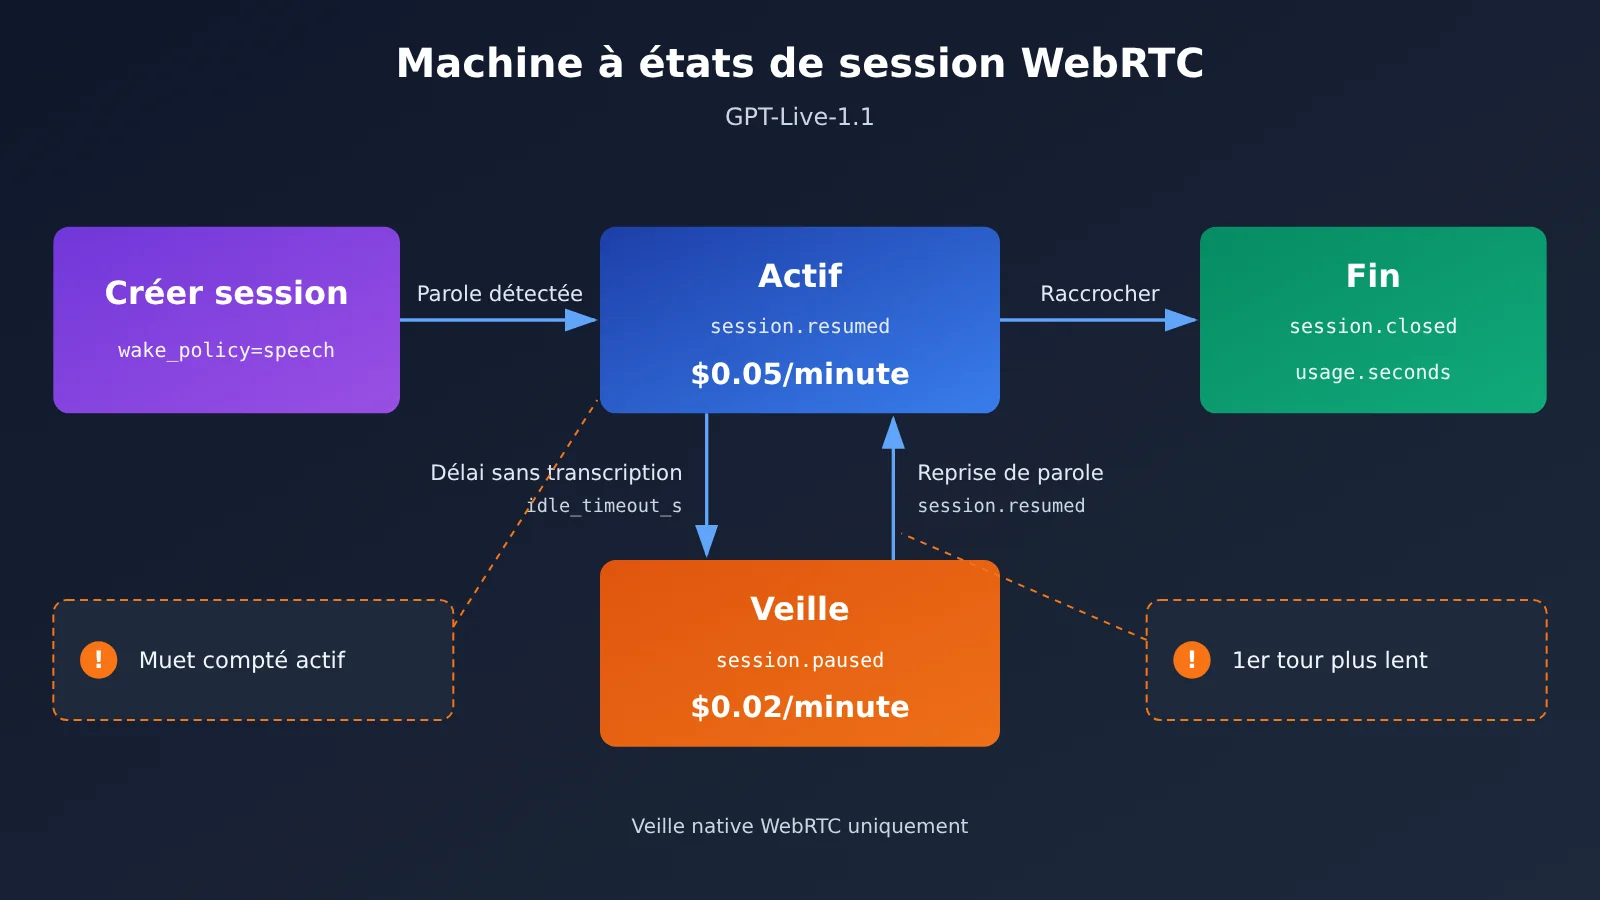
session.wake_policy.type |
défini sur "speech" |
La session attend de détecter la parole pour démarrer l’inférence, elle ne lance pas l’inférence dès la connexion |
session.idle_timeout_s |
entier de 5 à 60 (secondes) | Si non défini, l’inférence reste active en permanence après le premier réveil |
session.wake_policy.vad_threshold |
0–1, 0,5 par défaut (synthèse du document par le tiers OrcaRouter) | À augmenter en environnement bruyant ou en cas de faux réveils fréquents |
session.paused |
L’inférence se met en pause après le délai d’inactivité | Enregistré comme début de veille |
session.resumed |
Inférence prête à reprendre, déclenché aussi au premier réveil | Enregistré comme début d’activité |
session.closed |
Fin de session, inclut le usage.seconds final |
Sert à vérifier la facture |
Les 4 étapes de configuration de la veille GPT-Live-1.1
- Activer le réveil vocal à la création de la session WebRTC : définir
session.wake_policy.type = "speech". - Définir le seuil d’inactivité :
session.idle_timeout_sprend un entier de 5 à 60. Plus le seuil est court, plus la veille démarre tôt, mais une pause un peu longue de l’utilisateur peut déclencher la mise en pause. - Maintenir la piste micro active : pendant la veille, la piste micro doit rester active pour que le service puisse détecter la parole et réveiller la session. La connexion et l’ID de session restent inchangés, et l’historique de conversation est conservé lors de la reprise.
- Écouter les événements et enregistrer les horodatages : se baser sur
session.pausedetsession.resumedpour savoir dans quelle phase se trouve le serveur.
Voici un exemple de configuration de session. Les chemins de champs proviennent de la documentation officielle ; pour la structure complète de la requête, référez-vous à « Create session » d’OpenAI :
{
  "session": {
    "wake_policy": {
      "type": "speech",
      "vad_threshold": 0.5
    },
    "idle_timeout_s": 15
  }
}
Quels temps de silence restent facturés au tarif actif
Trois types de « silence » sont particulièrement faciles à mal calculer :
- La période de silence avant le timeout : entre la fin de la dernière phrase et l’expiration de
idle_timeout_s, la session continue d’être facturée comme active. Avec un seuil fixé à 30 secondes, chaque pause représente au moins 30 secondes au tarif actif. - Le micro coupé : si l’utilisateur appuie sur mute côté client, la session ne passe pas en veille pour autant, elle reste active.
- L’attente du retour du backend : le temps pendant lequel l’inférence n’est pas mise en pause et attend le résultat du modèle backend ou d’un outil est également facturé en phase active.
Il y a aussi des frais d’initialisation. D’après la synthèse faite par OrcaRouter de la documentation officielle, lorsqu’on crée une session WebRTC avec POST /v1/live/sessions, 15 secondes de durée vocale sont facturées d’avance, puis déduites des frais de durée une fois la session lancée. Pour les applications qui créent souvent des sessions à titre exploratoire, c’est un coût bien réel — en pratique, référez-vous à OpenAI Pricing.
Vérifier la facture à partir des horodatages d’événements
L’idée, c’est d’estimer la durée de chaque phase à partir des horodatages d’événements, puis de comparer avec le usage.seconds final présent dans session.closed et avec la facture réelle. Voici un exemple d’enregistreur d’événements. Le canal par lequel arrivent les événements (canal de données WebRTC ou connexion en parallèle) est à vérifier dans la documentation officielle :
const timeline = [];
function onServerEvent(evt) {
  if (["session.resumed", "session.paused", "session.closed"].includes(evt.type)) {
    timeline.push({ type: evt.type, t: Date.now() / 1000 });
  }
  if (evt.type === "session.closed") {
    console.log("usage.seconds =", evt.usage?.seconds, timeline);
  }
}
Pour les tests, il faut faire tourner le même script, le même backend et le même enregistrement une fois avec « veille activée » et une fois avec « veille désactivée », en notant en plus le moment où revient le premier segment audio, afin de quantifier le coût de latence du premier tour après le réveil.
Un rappel au niveau du workflow, aussi. CellCog a publié une série de tests comparatifs à configuration identique : d’abord 560 réunions scriptées, puis 120 réunions de re-test. Le script original posait les questions tôt ; l’ancienne version confiait 134 questions sur 160 au backend, la 1.1 en confiait 91, soit environ 84 % contre 57 %. Dans le re-test, où la première question arrive après la 10e seconde, les deux versions arrivent à 48/60 (80 %). Cela ne reflète la délégation que d’une seule équipe, sur des réunions courtes et avec des invites spécifiques, et le coût de la veille n’a pas été mesuré — mais cela montre une chose : le nombre de délégations au backend varie selon le script, alors que les frais du backend ne sont pas affectés par la veille.
Limites de mise en œuvre de la mise en veille de GPT-Live-1.1 sur WebSocket et SIP
OpenAI prend en charge trois types de connexions Live : WebRTC, WebSocket et téléphonie SIP, mais la mise en veille native à bas coût ne s’applique qu’au WebRTC. Il faut bien distinguer deux choses : une session WebRTC ou SIP peut avoir en plus une connexion WebSocket parallèle dédiée au contrôle et à la supervision, ce qui n’a rien à voir avec le fait de « faire transiter l’audio principal par WebSocket ». Même si la connexion principale WebRTC est accompagnée d’un WebSocket parallèle, la mise en veille reste utilisable.
| Transport de l’audio principal | Mise en veille native à 0,02 $ | Traitement de l’inactivité recommandé par OpenAI | Points d’attention sur le coût |
|---|---|---|---|
| WebRTC | ✅ applicable si les conditions sont remplies | wake_policy + idle_timeout_s | La période calme avant le dépassement du délai est facturée comme active |
| WebRTC + WebSocket parallèle | ✅ applicable à la connexion principale | Le canal parallèle ne gère que le contrôle et les événements | Le canal parallèle ne change pas la phase de facturation |
| WebSocket principal | ❌ aucun élément probant | Détection de l’inactivité côté application, puis fermeture et reconstruction | La reconstruction de session entraîne un coût d’initialisation |
| Téléphonie SIP | ❌ aucun élément probant | Vérifier d’abord l’impact de la fermeture de session sur les appels entrants | Pendant la durée de l’appel maintenu, la facturation se fait comme en mode actif |
Approche avec un WebSocket principal : gérez l’état d’inactivité côté application, en suivant les entrées et sorties audio, l’état de lecture et les tâches restant à accomplir côté backend. Ce n’est qu’après une longue période de silence, et lorsque la déconnexion est autorisée, que vous appelez session.close puis attendez session.closed. Lorsque l’utilisateur revient, vous reconstruisez la session : vous pouvez soit effectuer un fork de l’ancienne session dont l’enregistrement est autorisé et déjà terminé, soit restaurer le contexte à partir de l’état textuel sauvegardé par votre propre application. Si le réveil vocal local est activé, mettez en cache les premières secondes d’audio pour éviter de perdre des mots pendant l’établissement de la connexion.
Approche avec SIP : fermer la session peut affecter la connexion d’appel entrant elle-même, donc « raccrocher puis se reconnecter » ne peut pas être considéré comme une mise en veille sur place. Si l’appel téléphonique doit être maintenu, c’est à l’application ou au système téléphonique de gérer le flux d’attente, et il faut intégrer les frais de voix active d’OpenAI dans le budget. Une autre solution consiste à construire soi-même un pont média, afin d’utiliser et de valider réellement la mise en veille WebRTC du côté d’OpenAI. Tout ce qui précède relève des limites de mise en œuvre au niveau du transport et de l’état de session, et rien n’indique qu’un transport non-WebRTC puisse bénéficier du tarif de mise en veille à 0,02 $.
Combien un appel complet permet-il d’économiser : prise en main rapide du coût de veille de GPT-Live-1.1
Estimation de coût ultra-simple
La fonction ci-dessous traduit en code le principe « économie = part de veille × 60 % » ; les entrées sont exprimées en secondes :
ACTIVE, STANDBY = 0.05, 0.02  # Tarif officiel OpenAI, USD/minute

def voice_cost(active_s: float, standby_s: float) -> tuple[float, float]:
    with_standby = active_s / 60 * ACTIVE + standby_s / 60 * STANDBY
    all_active = (active_s + standby_s) / 60 * ACTIVE
    return round(with_standby, 4), round(1 - with_standby / all_active, 4)

print(voice_cost(240, 360))      # 10 minutes : 4 minutes actives + 6 minutes en veille
print(voice_cost(60, 30))        # 90 secondes : 60 secondes actives + 30 secondes en veille
| Hypothèse de scénario | Actif / veille | Frais vocaux avec veille | Frais vocaux en tout actif | Baisse des frais vocaux |
|---|---|---|---|---|
| Exemple officiel (repris par OrcaRouter) | 60 secondes / 30 secondes | $0.06 | $0.075 | 20 % |
| Consultation de 10 minutes (hypothèse de cet article) | 4 minutes / 6 minutes | $0.32 | $0.50 | 36 % |
| 8 heures de service, 30 % en veille (calcul OrcaRouter) | 5,6 heures / 2,4 heures | $19.68 | $24.00 | 18 % |
| 8 heures de service, 50 % en veille (calcul OrcaRouter) | 4 heures / 4 heures | $16.80 | $24.00 | 30 % |
Le tableau ne compte que les frais vocaux. Dans un déploiement réel, les coûts des modèles backend et des outils constituent souvent le poste le plus important de la facture. L’article d’OrcaRouter indique que la documentation OpenAI recommande de commencer avec gpt-6-luna, puis de passer à gpt-6-sol pour les tâches backend complexes ; les deux sont facturés au tarif standard par token. Lors d’un appel long, les frais backend peuvent tout à fait dépasser les frais vocaux.
💡 Conseil de calcul : les valeurs du tableau sont des hypothèses calculées à partir des tarifs officiels ; pour la facture réelle, fiez-vous à
usage.secondset à la facturation de la plateforme. Si vous évaluez en parallèle d’autres solutions de voix en temps réel, vous pouvez utiliser le quota d’essai gratuit d’APIYI apiyi.com pour comparer, avec le même script de dialogue, les modèles Realtime facturés au token.
Choisir séparément la couche vocale, le modèle backend et le point d’entrée API de GPT-Live-1.1
À la date de consultation (2026-11-20), l’interface de session dédiée et la tarification à la minute de GPT-Live-1.1 proviennent toutes deux de la source officielle OpenAI. D’après le récapitulatif du tiers OrcaRouter, GPT-Live ne peut être intégré que via le point de terminaison Live sessions ; il ne prend pas en charge d’autres points de terminaison tels que Chat Completions, Responses ou Realtime.
Du côté d’APIYI, le registre public des modèles (généré le 2026-11-20 à 15:17, UTC+8, avec 289 entrées) ne contient ni gpt-live-1 ni gpt-live-1.1, et les archives dynamiques ne comportent aucune annonce de mise en ligne correspondante. Par conséquent, on ne peut pas considérer pour l’instant qu’APIYI propose déjà la série GPT-Live, /v1/live/sessions ou une facturation à la minute. Et on ne peut pas non plus déduire, du seul fait qu’APIYI est compatible avec les interfaces OpenAI, qu’il prend en charge ce type de session vocale dédiée.
Les options de voix en temps réel déjà publiées par APIYI relèvent d’un produit Realtime distinct :
| Option | Mode d’accès | Mode de facturation | Veille / WebRTC / SIP | Plateforme disponible |
|---|---|---|---|---|
| GPT-Live-1.1 | /v1/live/sessions, WebRTC / WebSocket / SIP |
Actif $0.05, veille $0.02 par minute, backend en sus | WebRTC prend en charge la veille native | OpenAI officiel |
| gpt-realtime-2.1 | /v1/realtime WebSocket |
Entrée/sortie audio $32/$64 par million de tokens audio | WebRTC et SIP non disponibles | APIYI apiyi.com |
| gpt-realtime-2.1-mini | /v1/realtime WebSocket |
Entrée/sortie audio $10/$20 par million de tokens audio | WebRTC et SIP non disponibles | APIYI |
Les tarifs Realtime d’APIYI proviennent de sa documentation (la page mentionne une vérification au 2026-09-14) ; la facturation se fait selon les tokens de texte, d’audio et d’image, et ne peut pas être convertie directement en facturation à la minute de GPT-Live.
Exemple de connexion minimaliste avec APIYI Realtime
import os, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Interface unifiée APIYI
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1"

async def main():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        print(await ws.recv())  # Affiche le premier événement côté serveur

asyncio.run(main())
Voir le code complet : fermeture pour inactivité côté application sur le WebSocket principal
import os, time, asyncio, websockets

BASE_URL = "https://api.apiyi.com/v1"  # Point d'entrée APIYI Realtime
WS_URL = BASE_URL.replace("https://", "wss://") + "/realtime?model=gpt-realtime-2.1-mini"
IDLE_LIMIT_S = 45          # Seuil d'inactivité côté application, ajustable selon les besoins métier
pending_backend_tasks = 0  # Suivi côté application : nombre de tâches backend non terminées
is_playing = False         # Suivi côté application : lecture audio en cours ou non

async def run_session():
    headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}
    last_activity = time.monotonic()
    async with websockets.connect(WS_URL, additional_headers=headers) as ws:
        async def reader():
            nonlocal last_activity
            async for _ in ws:
                last_activity = time.monotonic()  # Tout événement serveur compte comme une activité

        task = asyncio.create_task(reader())
        while True:
            await asyncio.sleep(1)
            idle = time.monotonic() - last_activity
            busy = pending_backend_tasks > 0 or is_playing
            if idle > IDLE_LIMIT_S and not busy:
                print(f"空闲 {idle:.0f}s,主动关闭,用户回来后再重建")
                await ws.close()
                break
        task.cancel()

asyncio.run(run_session())
Le format des événements et les paramètres de requête suivent la documentation APIYI « Realtime – voix en temps réel (WebSocket) ». Cette façon de fermer puis de reconstruire la connexion ne fait qu’éliminer les connexions inactives au niveau applicatif ; elle ne correspond à aucun tarif officiel de mise en veille à bas prix.
🚀 Conseil d’intégration : pour les scénarios WebRTC nécessitant le mode veille natif de GPT-Live, connectez-vous pour l’instant directement à OpenAI. Si vous voulez monter rapidement un prototype de voix en temps réel avec WebSocket tout en gérant plusieurs modèles de façon unifiée, commencez par valider le flux de bout en bout avec
gpt-realtime-2.1-minisur APIYI apiyi.com, puis choisissez la solution de production en fonction des coûts.
FAQ — questions fréquentes
Q1 : Qu’est-ce que la mise en veille WebRTC de GPT-Live-1.1 ?
C’est un état de facturation propre aux sessions WebRTC : une fois le réveil vocal et le seuil d’inactivité configurés, la session cesse de faire de l’inférence pendant les périodes sans parole, mais la connexion reste ouverte et est facturée à 0,02 $/minute. Dès que quelqu’un reparle, l’inférence reprend en conservant l’historique de conversation existant.
Q2 : La baisse de 60 % signifie-t-elle que l’ensemble d’un appel coûte 60 % moins cher ?
Non. Les 60 % correspondent à la baisse du tarif de veille par rapport au tarif actif. La réduction du coût vocal sur l’ensemble d’un appel est égale à la proportion de temps en veille multipliée par 60 % : avec une moitié du temps en veille, on économise environ 30 % sur les frais vocaux. Les coûts backend et outils ne sont pas concernés.
Q3 : Quand GPT-Live-1.1 est-il arrivé sur l’API ?
L’entrée du journal des modifications de l’API OpenAI est datée du 2026-11-19, tandis que la page d’annonce de la communauté des développeurs OpenAI affiche le 2026-11-20 ; l’écart provient probablement d’un décalage de fuseau horaire. GPT-Live-1 était déjà en disponibilité générale depuis le 2026-09-10 (selon la synthèse d’OrcaRouter).
Q4 : Dans quels cas la veille est-elle la plus rentable ?
– **File d’attente au support client** : le client reste connecté mais ne parle pas pendant de longues périodes.
– **Assistant embarqué ou de bureau** : connexion permanente, réveil occasionnel.
– **Postes de veille de longue durée** : plus la part de veille est élevée, plus on économise.
Pour les sessions courtes et à fort trafic conversationnel, la part de veille est faible et il faut en plus assumer le ralentissement du premier tour après réveil : le gain reste limité.
Q5 : Peut-on appeler GPT-Live-1.1 via APIYI ?
Au 2026-11-20, le registre public de modèles d’APIYI ne contient pas la série GPT-Live, et aucune annonce de mise en ligne n’a été publiée. Si vous avez besoin de voix en temps réel, vous pouvez utiliser `gpt-realtime-2.1` / `gpt-realtime-2.1-mini`, déjà publics sur APIYI apiyi.com, accessibles via le WebSocket `/v1/realtime` et facturés au token audio. Les nouveaux utilisateurs disposent d’un quota d’essai gratuit pour valider le fonctionnement.
Q6 : Quelles sont les limites connues de la veille GPT-Live-1.1 ?
– Applicable uniquement à WebRTC ; les connexions principales WebSocket et SIP n’ont aucun fondement pour le tarif à 0,02 $.
– La période de silence avant expiration, la coupure du microphone et les temps d’attente backend sont tous facturés au tarif actif.
– Après réveil, la première réponse à un court énoncé vocal peut être plus lente.
– On manque actuellement de données tierces sur le réveil en veille et la vérification des factures ; les scores du classement Artificial Analysis ne concernent que GPT-Live-1 et ne peuvent pas être transposés à la 1.1.
Points clés du mode veille WebRTC de GPT-Live-1.1
- Tarif : $0.05/minute en mode actif, $0.02/minute en veille WebRTC éligible, tous deux facturés à la seconde.
- Algorithme : la baisse du coût vocal sur l’ensemble de l’appel est égale à la part de veille multipliée par 60 %, et non un 60 % fixe.
- Configuration :
wake_policy.type="speech"accompagné d’unidle_timeout_sde 5 à 60 secondes, la piste microphone restant active. - Vérification : utilisez les horodatages paused/resumed pour estimer la durée des phases, puis comparez
usage.secondsavec la facture. - Limites : WebSocket et SIP ne peuvent être recréés qu’après une fermeture côté application, et ne comptent pas comme une veille à bas coût.
- Accès : GPT-Live nécessite une connexion directe à OpenAI ; pour la voix en temps réel via WebSocket, vous pouvez tester les modèles Realtime sur APIYI apiyi.com.
En résumé
Les points clés du mode veille WebRTC de GPT-Live-1.1 :
- Une réduction sous conditions : seules les sessions WebRTC configurées en veille et dont l’inférence est mise en pause sont facturées à $0.02/minute.
- L’économie dépend de la part de veille : sur 10 minutes avec 6 minutes en veille, le coût vocal passe de $0.50 à $0.32, soit environ 36 % d’économie.
- Voir la facture dans son ensemble : les modèles backend et les outils sont facturés séparément ; la veille n’optimise qu’une seule de ces lignes.
Nous vous conseillons de commencer par un test A/B avec le même script, en activant puis en désactivant la veille, en notant les horodatages des événements et la latence du premier tour, avant de fixer le seuil d’inactivité. Si vous comparez encore différentes solutions de voix en temps réel, nous vous recommandons de faire d’abord tourner un prototype Realtime via APIYI apiyi.com, puis de comparer coûts et expérience avec les crédits gratuits.
📚 Références
-
OpenAI API Pricing : tarifs GPT-Live pour les sessions actives et en veille
- Lien :
developers.openai.com/api/docs/pricing - Précision : source officielle des tarifs à $0.05 et $0.02
- Lien :
-
OpenAI Managing GPT-Live sessions : configuration de la veille et description des événements
- Lien :
developers.openai.com/api/docs/guides/live-conversations - Précision : wake_policy, idle_timeout_s et limites de transport
- Lien :
-
OpenAI API Changelog : entrée de mise à jour GPT-Live-1.1
- Lien :
developers.openai.com/api/docs/changelog - Précision : date de l’entrée : 2026-11-19
- Lien :
-
Essai comparatif CellCog : GPT-Live-1.1 vs GPT-Live-1
- Lien :
cellcog.ai/blog/gpt-live-1-1-vs-gpt-live-1/ - Précision : données de délégation pour 680 réunions scriptées, hors coût de veille
- Lien :
-
Analyse de l’annonce OrcaRouter : facturation de la veille pour GPT-Live-1.1
- Lien :
orcarouter.ai/blog/gpt-live-1-1-api-release-standby-pricing - Précision : reprise des exemples de calcul officiels et estimation pour un poste de 8 heures
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour les détails de l’intégration Realtime, consultez le centre de documentation docs.apiyi.com