Note de l’auteur : de quoi se compose le prix de GPT-6.1 Terra, comment fonctionnent les paliers de contexte long et combien le cache permet-il d’économiser ? Voici les tarifs officiels et trois exemples de calcul pour y voir clair.
Lancé le 26 octobre 2026, GPT-6.1 Terra mise sur la rapidité et les économies. Beaucoup de gens ne retiennent qu’une chose en découvrant la grille tarifaire : « entrée à 1 $ ». Puis la facture ne correspond pas à leurs calculs. La raison ? Le prix de Terra combine quatre postes de facturation, deux paliers de contexte et trois modes de traitement.
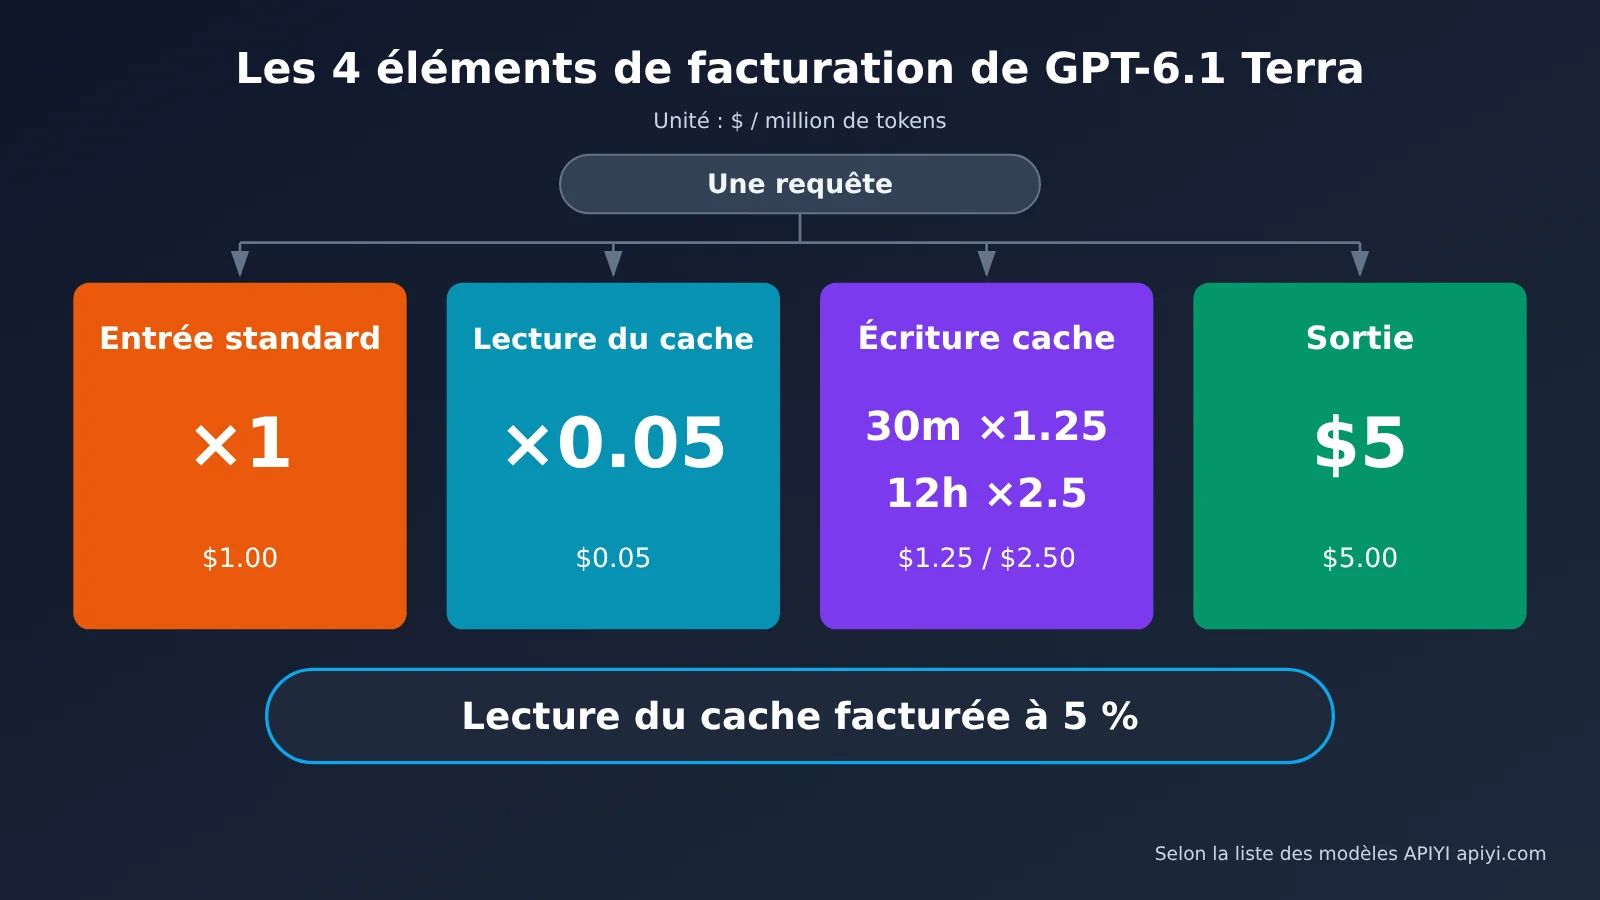
Voici la structure tarifaire de Terra en bref. Chaque requête est facturée selon quatre postes : l’entrée standard, la sortie, la lecture du cache et l’écriture dans le cache. Cette dernière propose deux durées de conservation : 30 minutes et 12 heures. Lorsque l’entrée d’une requête dépasse 272K tokens, l’ensemble de la requête passe au deuxième palier. Trois modes de traitement sont également proposés : Batch et Flex offrent une réduction de 50 %, tandis que Fast est facturé au double du tarif standard.
Sources : les tarifs officiels proviennent de la page du modèle et de la page des tarifs d’OpenAI. Les données communiquées par le fournisseur sont tirées du billet de lancement du 26 octobre 2026. Les données tierces proviennent d’Artificial Analysis et ont été relevées le 27 octobre 2026.
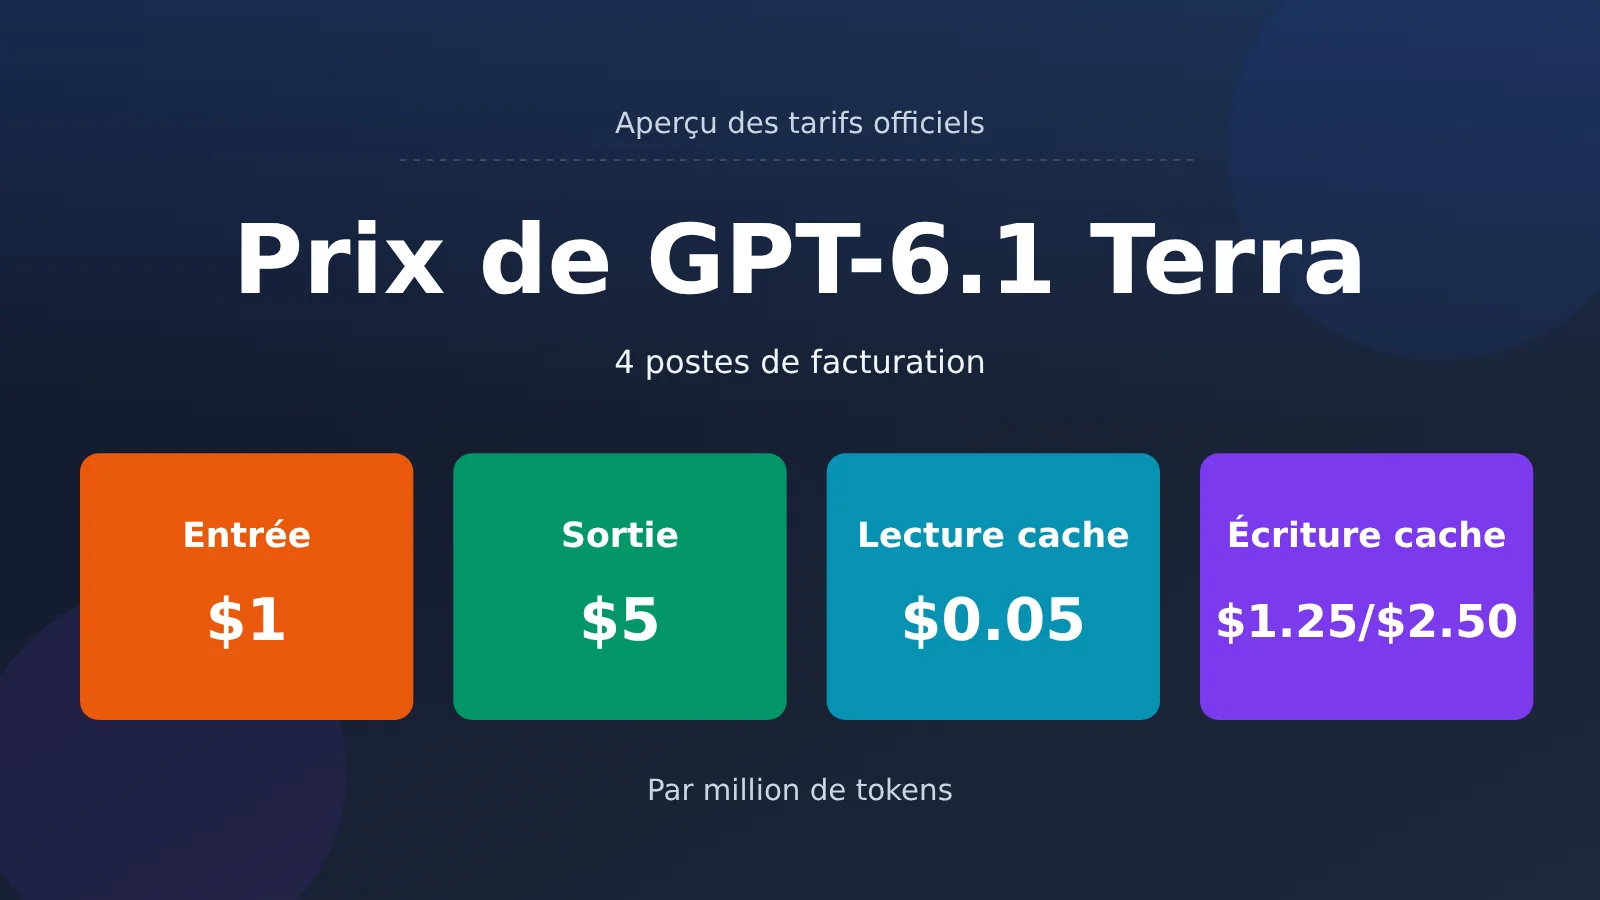
Les tarifs de GPT-6.1 Terra en bref
Commençons par le modèle. Son ID est gpt-6.1-terra et il n’existe qu’un seul snapshot. Sa fenêtre de contexte est de 1 050 000 tokens, avec un maximum de 922 000 tokens en entrée et de 128 000 en sortie par requête. Sa base de connaissances s’arrête au 1er juin 2026. Il accepte du texte et des images en entrée, mais ne produit que du texte. Il ne prend pas en charge l’audio ni la vidéo.
Le tarif standard s’applique aux requêtes dont l’entrée ne dépasse pas 272K tokens. Tous les prix sont indiqués par million de tokens :
| Poste de facturation | Tarif standard (≤272K) | Description |
|---|---|---|
| Entrée | $1.00 | Entrée non trouvée dans le cache |
| Sortie | $5.00 | Inclut les tokens produits par le raisonnement |
| Lecture du cache | $0.05 | 0,05 fois le tarif d’entrée |
| Écriture dans le cache (30 minutes) | $1.25 | 1,25 fois le tarif d’entrée |
| Écriture dans le cache (12 heures) | $2.50 | 2,5 fois le tarif d’entrée |
Détails de facturation du cache GPT-6.1 Terra
La lecture du cache ne coûte que 5 % du tarif d’entrée. Pour la plupart des modèles de la même génération, ce coefficient est de 0,1 : c’est sur ce poste que Terra affiche la plus forte baisse par rapport à la génération précédente.
Le tarif d’écriture dans le cache est un prix total, et non un supplément ajouté au tarif d’entrée. Les tokens écrits dans le cache sont facturés directement à $1.25 ou $2.50, sans être facturés une seconde fois à $1.00. Quelques règles d’utilisation sont aussi à connaître :
- Le préfixe minimal pouvant être mis en cache est de 1 024 tokens. En dessous, il n’est pas mis en cache.
- La durée de conservation de 12 heures peut uniquement être définie dans la Responses API, via
prompt_cache_options.ttl. - Si
ttlreçoit une valeur non valide, l’API renvoie400 invalid_request_error.
Prix du contexte long de GPT-6.1 Terra : le seuil de 272K
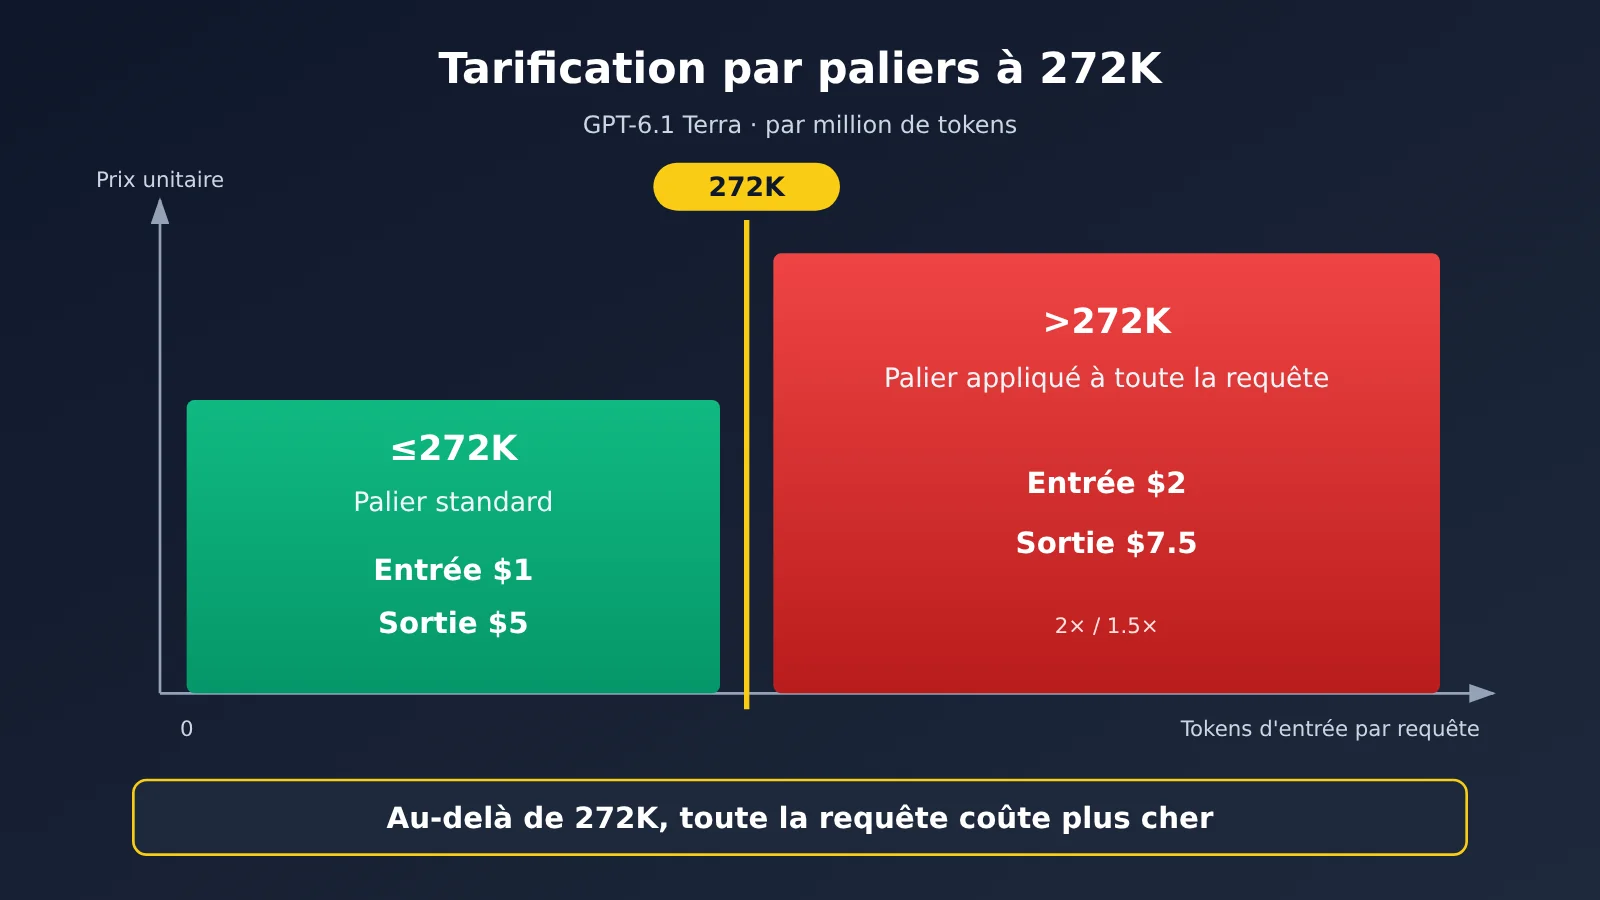
C’est la règle qui risque le plus de vous surprendre. Si l’entrée d’une requête dépasse 272K tokens, toute la requête passe au deuxième palier : les prix de l’entrée et du cache doublent, et celui de la sortie est multiplié par 1,5. Les nouveaux tarifs s’appliquent à tous les tokens de la requête, pas seulement à ceux qui dépassent le seuil.
| Poste de facturation | ≤272K | >272K (toute la requête) | Multiplicateur |
|---|---|---|---|
| Entrée | $1.00 | $2.00 | 2× |
| Sortie | $5.00 | $7.50 | 1,5× |
| Lecture du cache | $0.05 | $0.10 | 2× |
| Écriture dans le cache, 30 minutes | $1.25 | $2.50 | 2× |
| Écriture dans le cache, 12 heures | $2.50 | $5.00 | 2× |
Autres tarifs de GPT-6.1 Terra
| Mode | Règle de tarification | Cas d’utilisation |
|---|---|---|
| Batch / Flex | 50 % du tarif standard : entrée $0.50, sortie $2.50, lecture du cache $0.025, écriture dans le cache $0.625 (30 min) / $1.25 (12 h) | Traitement par lots hors ligne, tâches peu sensibles à la latence |
| Fast | 2 fois le tarif standard : entrée $2.00, sortie $10.00 | Applications en ligne sensibles à la latence |
| Ultrafast | Non pris en charge par Terra ; disponible uniquement pour gpt-6-astra et gpt-6.1-sol | — |
| Traitement régional / FedRAMP | Majoration de 10 %, applicable aux modèles publiés après le 2026-03-05 | Résidence des données, conformité |
Nous n’avons pas trouvé de tarifs précis pour le cache en mode Fast sur la page officielle consultée : ils sont donc considérés ici comme « non divulgués officiellement ». À noter aussi que Priority processing a été renommé Fast mode le 2026-07-30 : gardez cette correspondance en tête si vous consultez d’anciennes documentations.
Comparaison des prix de GPT-6.1 Terra : modèles de la même génération et de la génération précédente
| Modèle | Entrée | Sortie | Lecture du cache | Écriture du cache 30 min | Liste des modèles APIYI apiyi.com (2026-10-27) |
|---|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | $12.50 | Disponible |
| gpt-6.1-sol | $2.00 | $10.00 | $0.10 | $2.50 | Disponible |
| gpt-6.1-terra | $1.00 | $5.00 | $0.05 | $1.25 | Disponible |
| gpt-6-sol | $2.00 | $10.00 | $0.20 | $2.50 | Disponible |
| gpt-6-luna | $0.10 | $0.50 | $0.01 | $0.125 | Disponible |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | $2.50 | Disponible |
Par rapport à GPT-5.6 Terra, le prix d’entrée de Terra a baissé de 50 %, celui de la sortie d’environ 58 % et celui de la lecture du cache de 75 %. Selon le blog officiel, son tarif API standard est 50 % moins élevé que ceux de GPT-5.6 Terra et de GPT-6.1 Sol.
Prix de GPT-6.1 Terra : trois exemples de calcul
Tous les calculs ci-dessous utilisent le tarif par million de tokens : nombre de tokens × tarif ÷ 1 000 000.
Exemple 1 : saisie de factures en lot
Supposons que chaque requête contient 2 000 tokens en entrée (dont une image de facture), produit 300 tokens en sortie et que le modèle est invoqué 5 000 fois par jour.
Sans accès au cache :
- Entrée : 2 000 × $1 ÷ 1M = $0.0020
- Sortie : 300 × $5 ÷ 1M = $0.0015
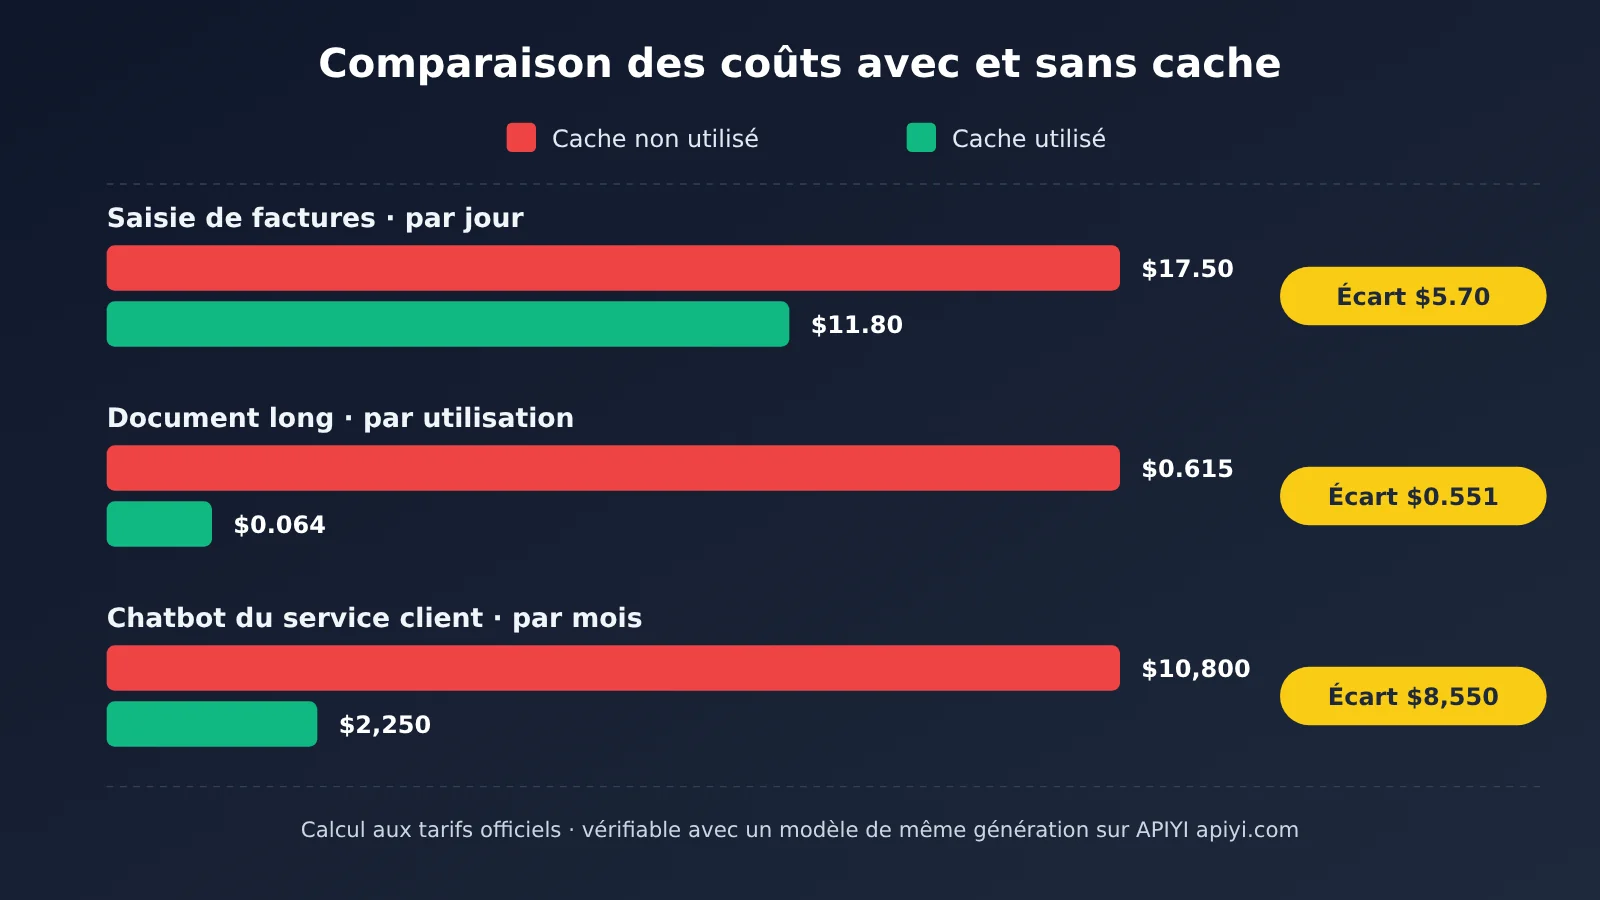
- Total par requête : $0.0035 ; pour 5 000 requêtes par jour : 5 000 × $0.0035 = $17.50
Avec accès au cache : supposons que les instructions système fixes et les descriptions des champs représentent 1 200 tokens lus depuis le cache (au-delà du seuil de 1 024 tokens). Les 800 tokens restants correspondent aux contenus variables, comme l’image.
- Lecture du cache : 1 200 × $0.05 ÷ 1M = $0.00006
- Entrée standard : 800 × $1 ÷ 1M = $0.0008
- Sortie : $0.0015
- Total par requête : $0.00236, soit $11.80 par jour : une économie quotidienne de $5.70 par rapport à une utilisation sans cache
Après expiration du cache, une nouvelle écriture est nécessaire. Pour une durée de conservation de 30 minutes, son coût est de 1 200 × $1.25 ÷ 1M = $0.0015, ce qui est négligeable rapporté aux 5 000 requêtes quotidiennes. La saisie de factures n’exige généralement pas de réponse en temps réel. Avec Batch, le coût par requête sans accès au cache est de 2 000 × $0.5 ÷ 1M + 300 × $2.5 ÷ 1M = $0.00175, soit $8.75 par jour.
Exemple 2 : analyse d’un long document (palier > 272K)
Supposons une requête de 300 000 tokens en entrée et de 2 000 tokens en sortie. L’entrée dépassant 272K, toute la requête est facturée au tarif du deuxième palier.
Sans accès au cache :
- Entrée : 300 000 × $2 ÷ 1M = $0.60
- Sortie : 2 000 × $7.5 ÷ 1M = $0.015
- Coût par requête : $0.615
Avec accès au cache : vous posez plusieurs questions sur un même document. Supposons que les 290 000 tokens du préfixe contenant le document soient en cache et que la nouvelle question représente 10 000 tokens.
- Lecture du cache : 290 000 × $0.10 ÷ 1M = $0.029
- Entrée standard : 10 000 × $2 ÷ 1M = $0.020
- Sortie : $0.015
- Coût par requête : $0.064, soit $0.551 de moins que sans accès au cache
La première requête doit écrire le document dans le cache. Avec une durée de conservation de 30 minutes, elle coûte 290 000 × $2.5 ÷ 1M + $0.02 + $0.015 = $0.76. Il suffit ensuite de poser une question sur le même document : le total des deux requêtes atteint $0.824, ce qui est déjà moins cher que les $1.23 de deux requêtes sans cache.
Il existe un moyen encore plus direct de réduire les coûts : ramener l’entrée à 272K tokens ou moins. Avec 270 000 tokens en entrée et 2 000 en sortie, le coût est de 270 000 × $1 ÷ 1M + 2 000 × $5 ÷ 1M = $0.28, soit moins de la moitié du coût au deuxième palier.
Exemple 3 : un chatbot de service client avec un taux élevé de réutilisation du cache
Supposons que chaque échange utilise 50 000 tokens en entrée, dont 45 000 récupérés depuis le cache, et 800 tokens en sortie, pour 200 000 échanges par mois.
Sans utilisation du cache :
- Entrée : 50 000 × 1 $ ÷ 1 M = 0,05 $ ; sortie : 800 × 5 $ ÷ 1 M = 0,004 $
- 0,054 $ par échange, soit 200 000 × 0,054 $ = 10 800 $ par mois
Avec utilisation du cache :
- Lecture du cache : 45 000 × 0,05 $ ÷ 1 M = 0,00225 $
- Entrée normale : 5 000 × 1 $ ÷ 1 M = 0,005 $
- Sortie : 0,004 $
- 0,01125 $ par échange, soit 2 250 $ par mois, une économie mensuelle de 8 550 $ par rapport à une utilisation sans cache
Si la lecture du cache était facturée à 0,1 fois le tarif d’entrée, comme pour la plupart des modèles de la même génération, le coût serait de 0,0135 $ par échange, soit 2 700 $ par mois. Dans ce scénario, le tarif de Terra à 0,05 fois le tarif d’entrée permet donc d’économiser 450 $ de plus par mois. Ces calculs ne tiennent pas compte de l’amortissement du coût d’écriture dans le cache.
Coût par tâche de GPT-6.1 Terra : données d’un tiers
Les données suivantes proviennent d’Artificial Analysis (collectées le 27 octobre 2026). Il s’agit d’une évaluation tierce, qui ne correspond pas nécessairement à vos coûts réels. La répartition des tokens dans les tâches évaluées diffère de celle de vos requêtes. Pour obtenir une estimation plus précise, appliquez les tarifs officiels à votre propre répartition des tokens.
| Modèle | Intelligence Index | Coût par tâche | Vitesse de sortie |
|---|---|---|---|
| GPT-6.1 Terra (max) | 48 | 0,40 $ | 91 t/s |
| GPT-6.1 Sol | 52 | 0,72 $ | 69,4 t/s |
| GPT-5.6 Terra | 42 | 1,40 $ | 135,4 t/s |
| GPT-6 Astra | 53 | 3,26 $ | 67,8 t/s |
| Claude Opus 5.5 (Max) | 58 | 5,98 $ | — |
Selon ces données, l’indice de Terra est inférieur de 5 points à celui d’Astra, pour un coût par tâche environ 8 fois inférieur à celui d’Astra et 15 fois inférieur à celui d’Opus 5.5.
Le blog officiel présente aussi quelques comparaisons de coûts. Ces chiffres sont fournis par le fabricant et n’ont pas été reproduits de manière indépendante :
- Sur Agents’ Last Exam, le niveau medium obtient un score supérieur de 15 points de pourcentage à celui de GPT-5.6 Terra, pour environ un tiers de son coût.
- Au niveau max, l’efficacité par token est plus de 3 fois supérieure à celle de Claude Opus 5.5, pour un coût par tâche environ 9 fois inférieur.
Prise en main rapide de GPT-6.1 Terra : étapes d’intégration
Au 27 octobre 2026, gpt-6.1-terra est directement accessible sur APIYI apiyi.com : 1 $ en entrée, 5 $ en sortie, 0,05 $ pour la lecture du cache et 1,25 $ pour son écriture, par million de tokens. Sur la plateforme, ces tarifs correspondent à un multiplicateur de modèle de 0,5 et à un multiplicateur de complétion de 5. Ils correspondent point par point à la tranche ≤272K du site officiel. Les modèles de la même génération, gpt-6.1-sol et gpt-6-astra, ainsi que ceux de la génération précédente, gpt-5.6-terra, gpt-6-sol et gpt-6-luna, sont également disponibles. Consultez la liste des modèles de la plateforme pour connaître les modèles et tarifs en vigueur. Pour les tranches à contexte long, le montant final facturé est celui indiqué dans la console.
L’intégration ne nécessite que quatre étapes :
- Créez un compte sur APIYI apiyi.com, puis générez une clé API.
- Dans un SDK compatible avec OpenAI, définissez
base_urlsurhttps://api.apiyi.com/v1et renseignez votre clé dansapi_key. - Avant l’invocation, consultez la liste des modèles en temps réel sur
api.apiyi.com/api/pricing, vérifiez les tarifs unitaires et les groupes disponibles pourgpt-6.1-terra, puis renseignez cet identifiant dans le champmodel. - Réglez
reasoning.effortselon les besoins de votre tâche. Les valeurs possibles sontnone / low / medium / high / xhigh / max; la valeur par défaut estmedium. - Si vous avez besoin d’un cache de 12 heures, utilisez plutôt l’API Responses et configurez
prompt_cache_options.ttl. - Avant la mise en production, vérifiez le nombre de tokens servis depuis le cache dans les statistiques d’utilisation renvoyées, puis appliquez les formules de cet article pour estimer le coût.
🚀 Pour commencer rapidement : consultez la liste des modèles de la plateforme pour connaître les modèles et tarifs en vigueur. Les nouveaux comptes bénéficient d’un crédit d’essai de 0,05 $. Sur APIYI apiyi.com, définissez
modelsurgpt-6.1-terrapour tester la chaîne d’invocation et le fonctionnement du cache. Pour comparer les prix, il suffit ensuite de passer àgpt-6.1-sol.
Questions fréquentes (FAQ)
Q1 : Comment résumer le prix de GPT-6.1 Terra en une phrase ?
Pour le tarif standard (entrée par requête ≤ 272K), les prix par million de tokens sont de 1 $ en entrée, 5 $ en sortie, 0,05 $ en lecture de cache, 1,25 $ en écriture de cache pour 30 minutes et 2,50 $ pour 12 heures.
Q2 : Au-delà de 272K, seul le surplus coûte-t-il plus cher ?
Non. Dès que l’entrée d’une requête dépasse 272K, toute la requête passe au deuxième tarif : les prix de l’entrée et du cache doublent, et celui de la sortie est multiplié par 1,5.
Q3 : Comment choisir entre Batch et Fast ?
Pour les tâches hors ligne, choisissez Batch ou Flex : tous les postes de facturation sont à moitié prix. Pour les tâches sensibles à la latence, Fast est une option, mais coûte deux fois plus cher. Terra ne prend pas en charge Ultrafast.
Q4 : L’écriture en cache entraîne-t-elle des frais supplémentaires ?
Le prix de l’écriture en cache est un prix total, pas un supplément. Les tokens écrits sont facturés à 1,25 ou 2,5 fois le prix d’entrée, sans être facturés une seconde fois au tarif d’entrée standard. Il suffit généralement de réutiliser une fois le même préfixe pour rentabiliser le cache.
Q5 : Peut-on utiliser Terra sur APIYI ?
Oui. Depuis le 27 octobre 2026, `gpt-6.1-terra` est disponible sur APIYI, apiyi.com. Les quatre postes de facturation correspondent à ceux du tarif officiel pour les entrées ≤ 272K. Consultez la liste des modèles de la plateforme pour connaître les modèles et les prix en vigueur.
Q6 : Peut-on utiliser directement le coût par tâche publié par un tiers pour établir un budget ?
Ce n’est pas conseillé. Ce coût correspond à des tâches d’évaluation, dont la répartition des tokens diffère de celle de votre activité. Le plus sûr est de mesurer la répartition des tokens avec de vraies requêtes sur APIYI, apiyi.com, puis de calculer le coût à partir des tarifs officiels.
Prix de GPT-6.1 Terra : points clés
- Quatre types de facturation : entrée à 1 $, sortie à 5 $, lecture du cache à 0,05 $, et écriture du cache à deux tarifs : 1,25 $ ou 2,50 $.
- 272K est le seuil à surveiller : au-delà, le nouveau tarif s’applique à toute la requête. Le prix de l’entrée double et celui de la sortie est multiplié par 1,5.
- Le cache offre les plus grandes économies : dans un scénario de service client, le coût mensuel passe de 10 800 $ à 2 250 $.
- Batch et Flex coûtent moitié prix, Fast coûte le double. Terra ne prend pas en charge Ultrafast.
- Les coûts par tâche publiés par des tiers sont indicatifs : pour établir votre budget, mieux vaut faire vos propres calculs à partir des tarifs officiels.
- Accès via la plateforme : sur APIYI apiyi.com, définissez le champ
modelsurgpt-6.1-terrapour invoquer le modèle. Consultez la liste des modèles de la plateforme pour connaître les modèles et tarifs disponibles.
Conclusion
La facture de Terra dépend surtout de trois choses : le dépassement ou non du seuil de 272K en entrée, le taux de lecture du cache et le choix éventuel de Batch ou de Fast. Selon ces paramètres, le coût d’un même volume d’activité peut varier du simple à plusieurs fois.
Commencez par mesurer la répartition des tokens sur vos requêtes réelles, puis calculez chaque poste à l’aide des formules présentées dans cet article. Vous pouvez lancer ces requêtes avec gpt-6.1-terra directement sur APIYI apiyi.com, puis comparer les coûts avec gpt-6.1-sol, de la même génération.
📚 Références
- Page du modèle OpenAI GPT-6.1 Terra : spécifications et paramètres de contexte
- Lien :
platform.openai.com/docs/models/gpt-6.1-terra - Contenu : contexte, modalités d’entrée et de sortie, niveaux de raisonnement
- Page des tarifs OpenAI : tarifs standard, contexte long, Batch/Flex/Fast
- Lien :
platform.openai.com/docs/pricing - Contenu : informations officielles sur tous les éléments facturables
- Guide OpenAI Prompt Caching : règles de mise en cache
- Lien :
platform.openai.com/docs/guides/prompt-caching - Contenu : préfixe minimal, réglage du TTL et facturation de l’écriture
- Article de lancement de GPT-6.1 Terra : données de coûts communiquées par le fournisseur
- Lien :
openai.com/index/introducing-gpt-6-1-terra - Contenu : publié le 26 octobre 2026 ; données non reproduites de manière indépendante
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com. Pour en savoir plus, consultez le centre de documentation sur docs.apiyi.com.