Note de l’auteur : à partir d’une tâche de développement logiciel confiée à un agent et exécutée en 30 minutes, nous détaillons les coûts des appels successifs : entrée standard, écriture et lecture du cache, sortie et échanges avec les outils. Nous comparons la facturation du cache chez trois fournisseurs et montrons, avec un exemple de 12 appels, dans quelles conditions le cache permet réellement de faire des économies.
Le 9 novembre 2026, Google Cloud a dévoilé deux systèmes TPU de huitième génération, TPU 8tx et TPU 8i Max, et a également publié en open source TPU Sync, un outil de transfert de KV Cache. Le sujet du « mur de la mémoire à l’ère des agents » revient sur le devant de la scène. Beaucoup de développeurs se posent naturellement la question : si le KV Cache sous-jacent devient de plus en plus rapide, ma facture d’API pour les agents va-t-elle baisser ?
Ce que vous allez y gagner : à la fin de cet article, vous disposerez d’une formule complète pour calculer le coût d’un agent, d’un comparatif de la facturation du cache chez trois fournisseurs et d’une liste d’optimisations que vous pourrez mettre en œuvre dès maintenant.
Coût des appels API en plusieurs tours d’un Agent : l’essentiel
| Élément | Détails |
|---|---|
| Événement de fond | Le 9 novembre 2026, Google a lancé TPU 8tx, TPU 8i Max et TPU Sync, en se concentrant sur les limites de mémoire et de cache KV des Agents |
| Question des développeurs | Les optimisations de bas niveau peuvent-elles faire baisser la facture des appels API d’un Agent ? |
| Conclusion principale | La facture dépend des entrées standard, des écritures et lectures du cache, des tokens de sortie, du nombre d’appels et des coûts des outils |
| Variables clés | La stabilité du préfixe, la capacité du TTL du cache à couvrir l’attente des outils et la maîtrise de l’historique du contexte |
| Scénarios concernés | Les appels en plusieurs tours, notamment pour les Agents de programmation, les Agents traitant de longs documents et les collaborations entre plusieurs Agents |
À quoi ressemble une tâche de 30 minutes avec un Agent en plusieurs tours ?
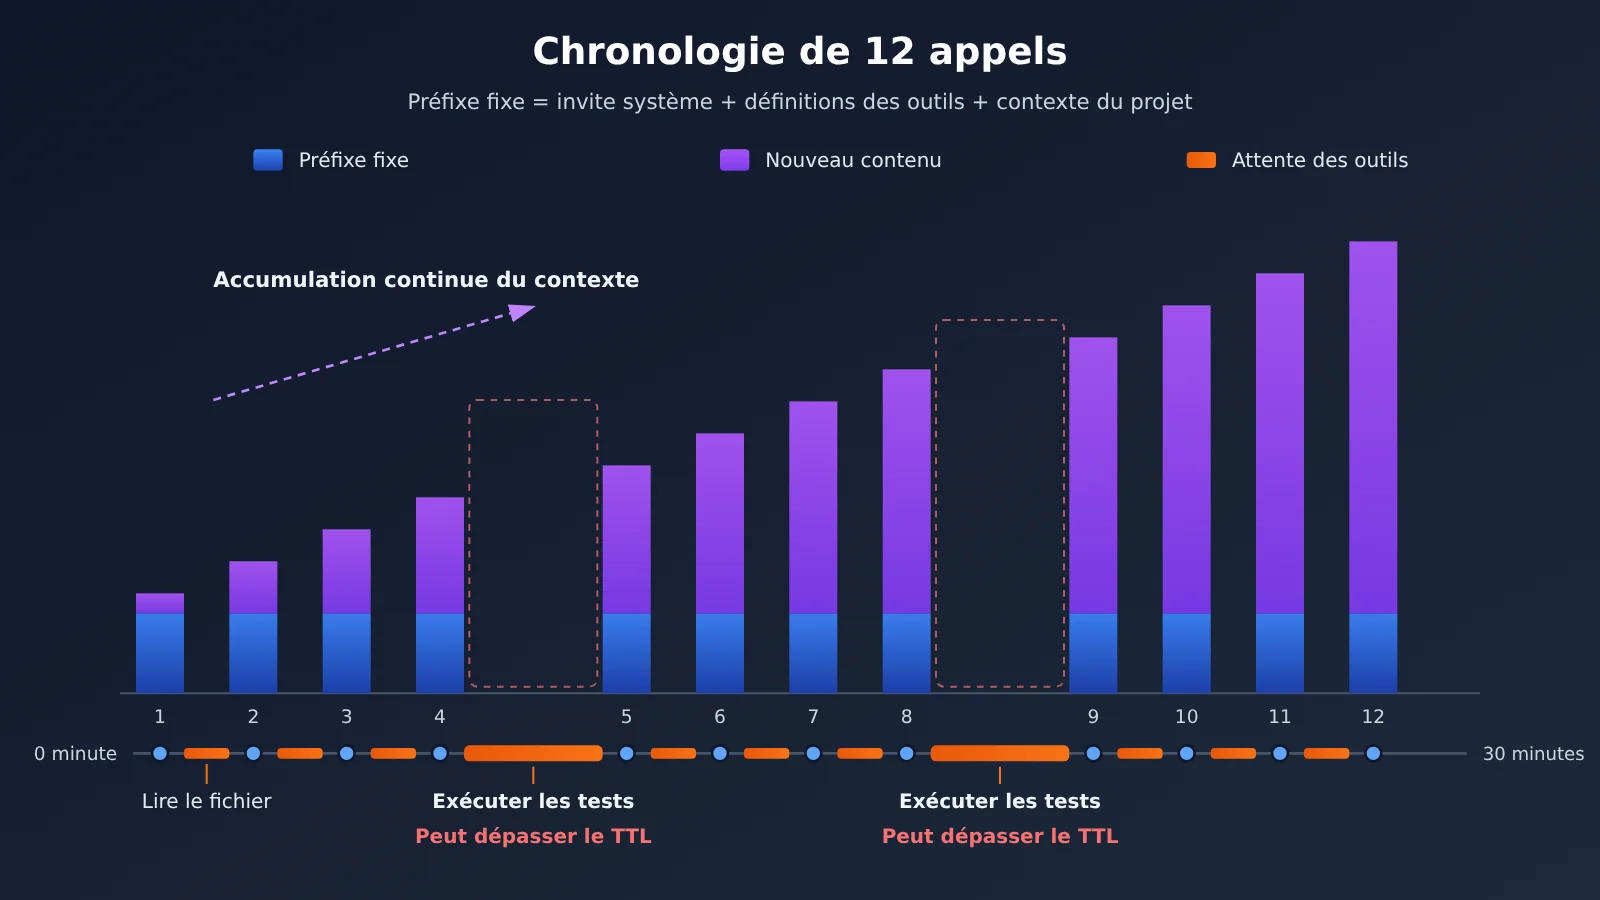
Imaginez qu’un Agent de développement logiciel reçoive une demande : corriger l’échec des tests d’un module. Il commence par examiner la structure du projet et le code source concerné, puis propose un plan de modification. Il utilise ensuite des outils pour modifier des fichiers et lancer les tests, attend les résultats et poursuit son raisonnement à partir des erreurs rencontrées. En 30 minutes, ce cycle « raisonnement – outil – attente – raisonnement » peut se répéter une dizaine de fois.
Le problème, c’est que les API des grands modèles de langage sont, par nature, sans état. À chaque requête, l’Agent doit renvoyer au modèle l’invite système, les définitions des outils, le contexte du projet, ainsi que les échanges précédents et les résultats des outils. La 12ᵉ requête contient souvent presque tout l’historique des 11 tours précédents : c’est ce qui entraîne la « répétition du calcul du contexte ».
De quoi se compose le coût des appels API multiples d’un agent ?
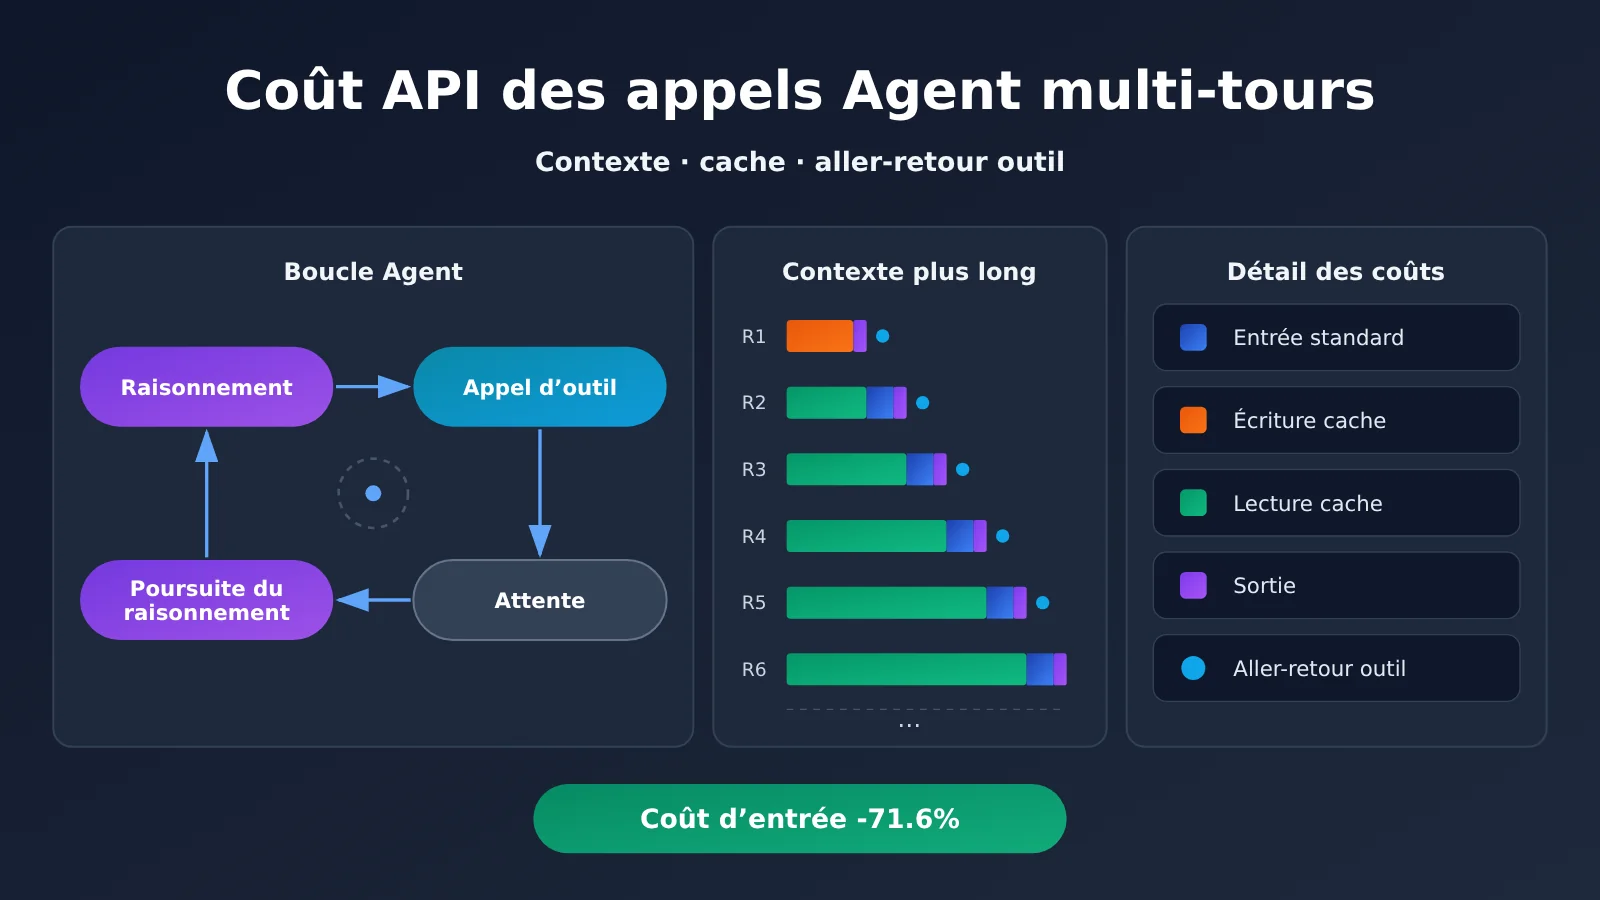
Si l’on décompose une tâche d’agent, son coût comprend au moins cinq catégories. Les quatre premières correspondent aux frais liés aux tokens du modèle. La cinquième concerne des services externes au modèle, mais elle est souvent négligée.
| Poste de coût | Signification | Mode de facturation |
|---|---|---|
| Entrée standard | Tokens d’entrée non mis en cache, facturés au tarif standard | Tarif standard des entrées |
| Écriture du cache | Partie des entrées utilisée pour créer un cache réutilisable | Certains fournisseurs et modèles appliquent un tarif supérieur à celui des entrées standard |
| Lecture du cache | Entrées qui correspondent à un cache existant | Généralement bien moins chère que les entrées standard |
| Tokens de sortie | Contenu généré par le modèle, y compris les paramètres des appels d’outils | Généralement le poste le plus cher ; le cache ne permet pas de le réduire |
| Outils et exécutions externes | Recherche, exécution de code, bases de données et autres services externes | Facturés selon les tarifs de chaque service ; ils augmentent aussi le nombre d’appels au modèle |
On peut donc écrire la formule du coût d’une tâche :
Coût total de la tâche = Σ (entrées standard × tarif des entrées + écritures du cache × tarif des écritures + lectures du cache × tarif des lectures + sorties × tarif des sorties) + frais des outils et des exécutions externes
Dans cette formule, Σ correspond à la somme des coûts de chaque appel au modèle effectué au cours de la tâche. Le nombre d’appels est donc un multiplicateur : plus les allers-retours avec les outils sont nombreux, plus les appels au modèle se multiplient et plus le préfixe fixe est facturé souvent. Les appels aux outils ne coûtent pas seulement le prix des outils : ils décomposent aussi une étape de raisonnement en plusieurs appels, chacun devant transmettre à nouveau le contexte.
Différences entre KV Cache, Prompt Cache et compression du contexte lors des appels successifs d’un agent
Quand on parle du coût des agents, trois notions sont souvent confondues. Elles relèvent de niveaux différents et n’ont pas du tout le même effet sur la facture.
| Technologie | Niveau concerné | Signification concrète | Effet pour les utilisateurs de l’API |
|---|---|---|---|
| KV Cache | Bas niveau de l’inférence du modèle | Conserve les états Key/Value des calculs d’attention pour éviter de recalculer les tokens déjà traités | L’utilisateur ne le contrôle pas directement ; il influe sur les coûts et la latence du fournisseur |
| Prompt Cache | Couche de service de l’API | Le fournisseur réutilise les préfixes de prompt répétés et facture séparément l’écriture et la lecture du cache | Son effet apparaît directement dans les champs correspondants de la facture |
| Compression du contexte | Couche applicative | Résume, filtre ou tronque le contenu historique avant de l’envoyer | Réduit le nombre de tokens transmis, mais peut entraîner une perte de détails |
À noter : la documentation officielle d’OpenAI précise que le Prompt Cache conserve en réalité des tenseurs KV, et non le texte brut des tokens. On peut donc voir le Prompt Caching comme une mise en service et une facturation de la réutilisation des états KV sous-jacents. Il n’est pas sans rapport avec le KV Cache, mais, du point de vue de l’utilisateur, seules les règles de facturation sont visibles.
La compression du contexte est une autre approche. Elle modifie ce que les requêtes suivantes « emportent » avec elles, et non la manière dont le contenu est réutilisé. Plus la compression est poussée, moins il y a de tokens, mais plus l’agent risque d’oublier des détails importants.
Pourquoi les optimisations de bas niveau des appels successifs d’un agent ne font-elles pas forcément baisser la facture ?
Le TPU 8i Max récemment annoncé par Google double la bande passante HBM et la SRAM intégrée à la puce. Lors de tests internes sur la plateforme Ironwood, TPU Sync a réduit de plus de 90 % la latence de transfert du KV Cache. De son côté, Agent Compute Engine met les sessions en pause quand un agent est inactif et déplace sa mémoire de travail hors de la puce. Ces optimisations améliorent l’utilisation des ressources du fournisseur et la latence d’inférence — notamment le TTFT — et peuvent se traduire, pour l’utilisateur, par des réponses plus rapides.
Mais les prix des API relèvent de la politique commerciale du fournisseur, et la facture reste calculée en tokens. Les gains d’efficacité matérielle peuvent influer sur les prix à long terme, mais rien ne garantit qu’ils soient répercutés automatiquement ni proportionnellement. Par ailleurs, au 2026-11-10, TPU 8tx et TPU 8i Max sont toujours indiqués comme « bientôt disponibles » ; leurs prix n’ont pas encore été annoncés. Pour les développeurs, le levier immédiatement accessible est la structure de leurs tokens, pas le matériel en amont.
Coût des appels API en plusieurs tours avec un agent : comparaison de la facturation du cache chez trois fournisseurs
Les trois principaux fournisseurs proposent tous un mécanisme de cache, mais les conditions d’activation, les TTL et les règles de facturation varient sensiblement. Le tableau ci-dessous est établi à partir de leur documentation officielle ; référez-vous aux indications propres au modèle et à l’interface utilisés.
| Fournisseur | Mécanisme de cache | Options de TTL | Facturation de l’écriture | Facturation de la lecture | Plateformes disponibles |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, avec mise en cache automatique des préfixes pour certains modèles | 30 minutes par défaut pour certains nouveaux modèles ; certains modèles proposent aussi 12 heures | Pour les modèles et interfaces prenant en charge les options correspondantes : 1,25 fois le tarif d’une entrée standard pour 30 minutes, et 2,5 fois pour 12 heures ; d’autres modes de cache peuvent ne pas facturer l’écriture séparément | Généralement 0,1 fois le tarif d’une entrée standard ; moins pour certains modèles | API officielle, APIYI apiyi.com |
| Anthropic | Prompt Caching | 5 minutes par défaut, extensibles jusqu’à 1 heure | 1,25 fois le tarif d’une entrée standard pour 5 minutes, et 2 fois pour 1 heure | Varie selon le modèle | API officielle, APIYI apiyi.com |
| Google Gemini | Context Caching, avec cache implicite et explicite | Le TTL du cache explicite peut être défini | Le cache explicite entraîne des frais supplémentaires calculés en fonction du nombre de jetons mis en cache et de la durée de stockage | Une correspondance dans le cache réduit les frais liés aux entrées répétées | API officielle, APIYI apiyi.com |
Prenons comme exemple les tarifs officiels de Claude Sonnet 5.5 : 2,00 $ par million de jetons pour les entrées standard, 2,50 $ pour l’écriture dans le cache de 5 minutes, 4,00 $ pour celle dans le cache d’une heure, et 0,10 $ pour la lecture du cache. La lecture du cache ne coûte que 5 % du tarif d’une entrée standard, ce qui explique pourquoi la mise en cache des préfixes répétés peut réduire considérablement les coûts.
À noter : OpenAI précise dans sa documentation officielle qu’une correspondance dans le cache n’est pas garantie à chaque appel. De son côté, le cache explicite de Gemini ne correspond pas à un « stockage gratuit » : la durée de stockage est elle-même facturée. Le cache permet donc de bénéficier d’une réduction sous certaines conditions, mais celle-ci ne s’applique pas automatiquement.
🎯 Conseil technique : les capacités de cache, les règles de facturation et les champs renvoyés varient d’un modèle en amont à l’autre. Une passerelle unifiée n’accorde donc pas automatiquement les mêmes réductions à tous les modèles. Nous vous conseillons de tester les modèles envisagés avec le même code compatible avec l’API OpenAI via APIYI apiyi.com, puis de vous fier aux champs
usageréellement renvoyés et à la facture.
Coût réel du cache lors de plusieurs appels d’un agent : exemple sur 12 appels
Reprenons la tâche de développement de 30 minutes évoquée précédemment et construisons un exemple avec les tarifs officiels de Claude Sonnet 5.5. Voici les hypothèses :
- La tâche nécessite 12 appels au modèle, avec 22 000 tokens en entrée à chaque appel ;
- 20 000 tokens sont répétés : invite système, définition des outils et contexte du projet ;
- Chaque appel ajoute 2 000 nouveaux tokens ;
- Le cache a une durée de vie d’une heure et les requêtes suivantes réutilisent toutes le cache avec succès.
Sans cache : 12 × 22 000 × $2 / 1 000 000 = $0.528.
Avec un cache d’une heure : l’écriture initiale de 20 000 tokens coûte $0.080, les 2 000 tokens initiaux en entrée standard coûtent $0.004, les lectures suivantes du cache (11 fois) coûtent $0.022 et les nouveaux tokens en entrée des 11 appels suivants coûtent $0.044. Total : $0.150, soit une économie d’environ 71.6 % sur les coûts d’entrée.
Cet exemple ne prend en compte que les tokens en entrée, et exclut les tokens en sortie, les appels d’outils et les coûts des services externes. Dans un véritable agent, l’historique s’allonge à chaque tour, mais la conclusion reste la même : le contexte répété est le principal poste de coûts susceptible d’augmenter lors des appels successifs d’un agent.
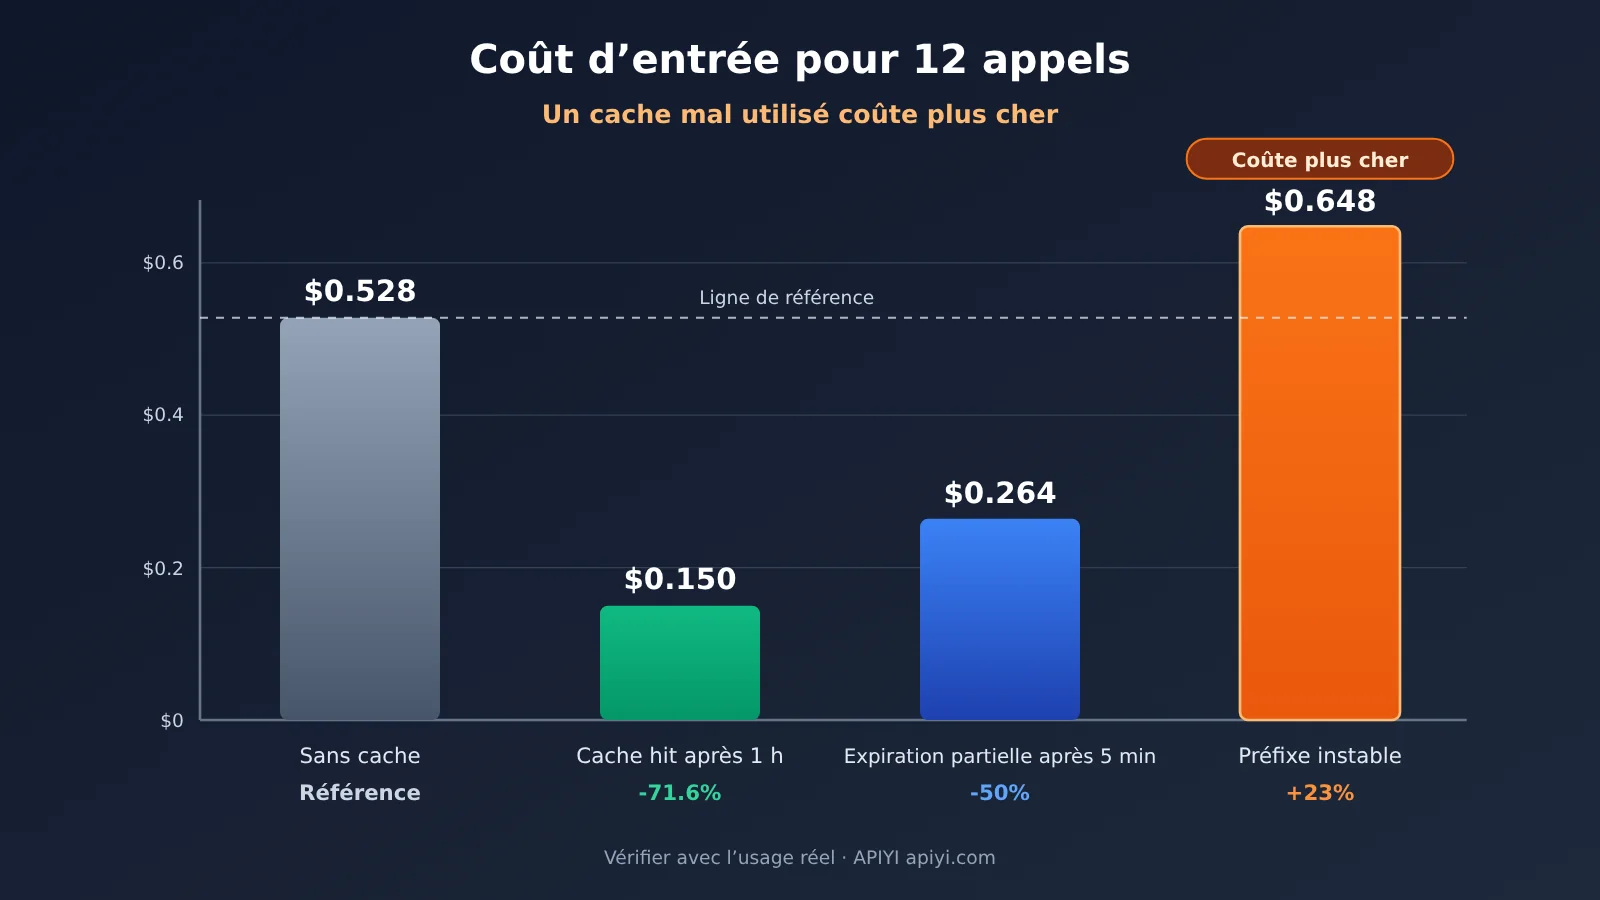
Effet de l’expiration du cache, des variations de préfixe et du TTL sur les coûts d’un agent
Le scénario ci-dessus est idéal. En conservant les mêmes tarifs, examinons maintenant trois cas courants où les choses ne se passent pas comme prévu (les scénarios ci-dessous sont des exemples calculés pour cet article à partir des tarifs officiels).
| Scénario | Hypothèse | Coût des tokens en entrée | Par rapport à l’absence de cache |
|---|---|---|---|
| Sans cache | Les 12 appels sont facturés au tarif d’entrée standard | $0.528 | Référence |
| Cache d’une heure, réutilisation complète | 1 écriture, 11 lectures | $0.150 | Économie d’environ 71.6 % |
| Cache de 5 minutes, réutilisation complète | Tarif d’écriture de $2.50, 11 lectures | $0.120 | Économie d’environ 77.3 % |
| Cache de 5 minutes, expiration partielle | Le délai d’attente des outils entraîne 4 écritures et 8 lectures au total | $0.264 | Économie d’environ 50 % |
| Préfixe instable | Le préfixe change à chaque fois ; les 12 appels sont facturés comme des écritures dans le cache de 5 minutes | $0.648 | Environ 23 % de plus |
Voici quelques points à prendre en compte pour orienter vos décisions :
- Le TTL doit couvrir l’attente des outils : l’écriture dans un cache de 5 minutes coûte moins cher, mais si l’exécution d’un test ou une confirmation manuelle prend plus de 5 minutes, le cache expire et doit être recréé. Les économies diminuent alors nettement.
- La stabilité du préfixe compte plus que le TTL : placer un horodatage ou un ID aléatoire au début de l’invite empêche chaque nouvelle requête de réutiliser le cache. Lorsque le mode choisi facture un supplément pour les écritures, le cache peut même faire grimper la facture.
- Un TTL plus long n’est pas toujours préférable : le tarif d’écriture pour une heure est 1,6 fois plus élevé que celui pour 5 minutes. Ce choix n’est avantageux que si l’intervalle entre les appels risque effectivement de dépasser 5 minutes.
Comment réduire le coût des API lors des appels successifs d’un agent
Exemple minimal : suivre les cache hits de chaque appel
La première étape pour optimiser les coûts consiste à les rendre visibles. Le code ci-dessous envoie une requête via une interface compatible avec OpenAI et affiche les champs liés au cache dans usage :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="your-model-name",  # Remplacez par le modèle à tester
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
Voir l’implémentation complète : préfixe stable et suivi du coût par tâche
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Préfixe fixe : placez les instructions système, les définitions des outils et le contexte commun du projet au début, et gardez-les strictement identiques
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # Prix unitaire : dollars / million de tokens, à renseigner selon le tarif officiel du modèle utilisé
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # Ajoutez uniquement le nouveau message, sans réorganiser l’historique ; placez les informations dynamiques (horodatages, etc.) à la fin
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
Notez que l’estimation ci-dessus ne tient compte que de la lecture à tarif réduit. Si le modèle utilisé facture séparément l’écriture dans le cache, ajoutez ce poste en fonction des champs renvoyés. Les noms et la signification des champs usage peuvent varier d’un modèle à l’autre : fiez-vous aux données réellement renvoyées.
🚀 Pour démarrer rapidement : nous vous recommandons d’utiliser d’abord le crédit de test gratuit sur APIYI, apiyi.com, pour exécuter le script de suivi ci-dessus. Vous pourrez comparer le taux de cache hit et le coût par tâche pour un même travail selon les modèles, puis choisir le modèle et le TTL adaptés à votre environnement de production.
Cinq actions pour réduire le coût des appels Agent en plusieurs tours
- Stabiliser le préfixe de l’invite : placez les instructions système, les définitions des outils et les ressources de référence communes au début, puis les horodatages et les informations dynamiques de l’utilisateur à la fin. Évitez aussi de modifier sans raison l’ordre des définitions d’outils et leurs champs.
- Choisir un TTL adapté : privilégiez un TTL court pour les tâches avec des appels fréquents et rapprochés. Pour les Agents qui passent par de longues phases de test, de compilation ou d’approbation humaine, vérifiez si le surcoût d’écriture lié à un TTL plus long est compensé par les réécritures évitées.
- Maîtriser l’historique du contexte : ajoutez les éléments à la suite sans les réorganiser, afin de ne pas invalider le préfixe mis en cache. Résumez les sorties d’outils trop longues en conservant les conclusions essentielles, l’état de la tâche et les éléments de preuve nécessaires.
- Limiter les appels au modèle inutiles : regroupez en un seul appel les outils qui peuvent être exécutés en lot. Confiez les étapes déterministes au code plutôt qu’au modèle, afin de réduire le nombre d’allers-retours à la source.
- Suivre les indicateurs réels : pour chaque tâche, consignez les entrées ordinaires, les écritures dans le cache, les lectures du cache, les jetons de sortie, le taux de succès du cache, le TTFT et le coût total. Évaluez le coût à l’échelle de la tâche plutôt que celui d’une requête isolée.
Analyse de l’impact des appels API Agent en plusieurs tours sur les coûts
Impact sur les développeurs
- Le modèle de coûts doit passer de la « requête isolée » à la « tâche complète » : pour un Agent, les frais dépendent de toute la chaîne d’appels. Se fier uniquement au prix unitaire conduit à largement sous-estimer la facture réelle.
- L’ingénierie des invites doit aussi tenir compte de la facturation : la stabilité du préfixe détermine directement si le cache peut être utilisé. La conception de la structure des invites fait donc partie de l’optimisation des coûts.
- Le choix entre plusieurs modèles doit s’appuyer sur des tests réels : les taux de remise du cache, les TTL et les surcoûts d’écriture varient d’un modèle à l’autre. À tâche identique, le coût peut beaucoup changer selon le modèle choisi.
Impact sur le secteur
- La concurrence dans les infrastructures se concentre sur les charges de travail Agent : Google met l’accent sur la bande passante mémoire, le transfert du cache KV et la suspension puis la reprise des Agents. Cela montre que les échanges en plusieurs tours et les longs contextes sont devenus des charges de travail courantes.
- Les utilisateurs bénéficient d’abord d’une réduction de la latence : les optimisations de bas niveau améliorent en premier lieu le TTFT et le débit. Une éventuelle baisse du prix des jetons dépend de la stratégie tarifaire du fournisseur ; mieux vaut donc ne pas l’intégrer trop tôt au budget.
FAQ : questions fréquentes
Q1 : Pourquoi les coûts API des appels successifs d’un agent sont-ils plus élevés que prévu ?
Parce que l’API est sans état : à chaque appel, il faut renvoyer l’invite système, les définitions des outils et l’historique du contexte. Plus les appels sont nombreux, plus ces éléments fixes sont facturés à répétition. Les allers-retours avec les outils augmentent aussi le nombre d’appels.
Q2 : KV Cache et Prompt Cache, est-ce la même chose ?
Pas tout à fait. Le KV Cache réutilise des états au niveau de l’inférence du modèle. Le Prompt Cache correspond à la mise en cache, au niveau de l’API par le fournisseur, des préfixes réutilisables et à leur facturation. La documentation d’OpenAI précise que les données conservées sont les tenseurs KV. En tant qu’utilisateur, vous ne pouvez constater le Prompt Cache qu’à travers les règles de facturation ; vous ne pouvez pas contrôler directement le KV Cache.
Q3 : Les prix des API vont-ils baisser dès la sortie des nouveaux TPU de Google ?
Rien ne permet de l’affirmer. Au 10 novembre 2026, les TPU 8tx et TPU 8i Max sont toujours indiqués comme « Coming soon » et leurs prix n’ont pas été annoncés. Les optimisations matérielles améliorent surtout l’utilisation des ressources et la latence chez les fournisseurs. Leur éventuelle répercussion sur le prix des jetons dépend de la politique tarifaire de chaque fournisseur.
Q4 : La mise en cache permet-elle toujours de faire des économies ?
Pas forcément. Si le préfixe change à chaque appel et que le cache ne peut pas être utilisé, et que le mode choisi facture en plus l’écriture dans le cache, le coût peut dépasser celui d’une utilisation sans cache. Si l’attente liée aux outils dépasse le TTL, les réécritures fréquentes réduisent aussi les économies.
Q5 : Comment comparer rapidement l’efficacité du cache entre différents modèles ?
Nous vous conseillons d’exécuter le même processus sur plusieurs modèles pour une même tâche d’agent, puis de relever le taux d’accès au cache et le coût total par tâche. Avec APIYI, sur apiyi.com, vous pouvez appeler des modèles OpenAI, Claude, Gemini et d’autres à l’aide d’une seule clé API. Il suffit de changer le paramètre model pour les comparer.
Q6 : Quels sont les risques de la compression du contexte ?
La compression modifie le contenu transmis dans les requêtes suivantes. Elle peut faire perdre des détails importants, amener l’agent à répéter ses erreurs et, au final, augmenter le nombre d’appels. De plus, si le contenu compressé est régénéré à chaque tour, le préfixe mis en cache est perturbé. Il faut donc concevoir la compression en tenant compte de la stratégie de cache.
Q7 : Lorsqu’on utilise une passerelle unifiée, les avantages tarifaires du cache sont-ils les mêmes pour tous les modèles ?
Non. Les capacités de mise en cache, les règles de facturation et les champs renvoyés dépendent du modèle en amont. Lors de vos tests sur APIYI, sur apiyi.com, vérifiez séparément les champs liés au cache et les frais réellement débités pour chaque modèle avant de les intégrer à votre budget.
Points clés sur le coût des appels API en plusieurs tours d’un Agent
- L’unité de coût est la tâche : la facture d’un Agent cumule toute la chaîne d’appels, et non une seule requête.
- La répétition du contexte pèse lourd : dans l’exemple de 12 appels, un cache d’une heure réduit d’environ 71,6 % les frais d’entrée.
- La réduction liée au cache est conditionnelle : si le préfixe est instable ou si le TTL est trop court, les économies diminuent, voire les coûts augmentent.
- Les règles de facturation varient selon les fournisseurs : les multiplicateurs à l’écriture, les réductions à la lecture et les frais de stockage sont à vérifier pour chaque modèle.
- Optimiser le matériel ne fait pas forcément baisser la facture : les optimisations du KV Cache en amont réduisent d’abord la latence ; le prix dépend de la tarification du fournisseur.
- Mesurez avant d’optimiser : avec l’interface unifiée d’APIYI, apiyi.com, mesurez le taux de succès du cache et le coût des tâches pour chaque modèle.
Conclusion
Le coût des appels API d’un Agent en plusieurs tours dépend de trois facteurs indissociables : le recalcul répété du contexte, les succès du cache et les allers-retours avec les outils.
- Le recalcul répété du contexte détermine le coût de base : plus il y a d’appels, plus les répétitions sont nombreuses.
- Les succès du cache déterminent la réduction appliquée aux éléments répétés ; la stabilité du préfixe et le TTL sont essentiels.
- Les allers-retours avec les outils entraînent des frais externes et augmentent le nombre d’invocations du modèle.
Les investissements de Google dans le KV Cache et les limites liées à la mémoire au niveau de l’infrastructure accélèrent l’exécution des Agents. Mais, à court terme, les développeurs peuvent surtout agir sur la structure de leurs Tokens. Nous vous conseillons de travailler sur cinq axes : stabiliser les préfixes, choisir un TTL adapté, raccourcir l’historique, réduire le nombre d’appels et suivre les coûts à l’échelle des tâches. Vous pouvez ensuite vérifier l’effet de chaque optimisation avec des données réelles via l’interface unifiée d’APIYI, apiyi.com.
📚 Références
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max : annonce du lancement des nouveaux systèmes TPU de huitième génération
- Lien :
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
À lire pour comprendre le mur mémoire des agents et le contexte du KV Cache
-
Google Cloud Blog – Introducing TPU Sync : bibliothèque open source pour le transfert du KV Cache et des poids
- Lien :
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
À lire pour découvrir les optimisations du transfert du KV Cache à bas niveau et les méthodes de test
-
Documentation de l’API OpenAI – Prompt Caching : mécanisme de cache et bonnes pratiques
- Lien :
platform.openai.com/docs/guides/prompt-caching -
À lire pour connaître les règles de mise en cache des préfixes, la durée de conservation et les recommandations de suivi
-
Documentation d’Anthropic – Prompt Caching : TTL du cache et tarification
- Lien :
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
À lire pour connaître les tarifs d’écriture et de lecture des caches de 5 minutes et d’une heure
-
Google AI for Developers – Context Caching : mise en cache implicite et explicite dans Gemini
- Lien :
ai.google.dev/gemini-api/docs/caching - À lire pour en savoir plus sur le TTL du cache explicite et les frais de stockage
Auteur : équipe technique d’APIYI
Échanges techniques : rendez-vous sur la page d’accueil d’APIYI, apiyi.com, pour nous contacter. Vous trouverez d’autres ressources d’intégration dans le centre de documentation, à l’adresse docs.apiyi.com.