Anthropic a révélé une expérience interne lors de la sortie de Claude Fable 5.2, le 9 novembre 2026 : à partir d’un dossier vide, Fable 5.2 a coordonné plus de 1 000 sous-agents pendant 8 jours d’affilée pour créer un prototype de système d’exploitation capable de démarrer sur un ordinateur portable.
L’essentiel : à la fin de cet article, vous saurez quelles sont les différentes composantes du coût d’un flux de travail multi-agent avec Claude Fable 5.2, quelles règles de facturation sont faciles à mal interpréter et comment maîtriser le coût total en choisissant les modèles et en gérant les appels.
Expérience de système d’exploitation avec Claude Fable 5.2 : pourquoi le coût de 1 000 Agents reste inconnu
Commençons par les informations essentielles déjà communiquées officiellement. Cette expérience ne met pas seulement en évidence la capacité du modèle à écrire du code : elle montre aussi qu’il peut organiser un projet logiciel de grande ampleur, coordonner de nombreux agents intelligents, maintenir le projet sur la durée et vérifier le code en continu.
| Informations | Détails |
|---|---|
| Date de sortie | 9 novembre 2026 |
| Éditeur | Anthropic |
| Point de départ de l’expérience | Un dossier vide, avec pour mission de concevoir et de réaliser un prototype de système d’exploitation |
| Nombre d’agents | Plus de 1 000 sous-agents |
| Durée d’exécution | 8 jours d’affilée, avec écriture, tests, révision et modification du code en continu |
| Résultat final | Un prototype de système d’exploitation capable de démarrer sur un véritable ordinateur portable, avec un noyau, des pilotes de disque, de clavier et de réseau, un système de stockage de fichiers, un environnement fenêtré, une interface de connexion, un programme d’installation et des fonctionnalités Claude intégrées |
| Informations non publiées | Consommation totale de Tokens, coût total de l’expérience, répartition des rôles entre les agents, protocole de communication, quantité de code, etc. |
Il faut toutefois préciser que le fait qu’Anthropic parle d’un prototype de système d’exploitation fonctionnel ne signifie pas qu’il s’agit déjà d’un système commercial abouti. De plus, Anthropic n’a pas publié la facture réelle de cette expérience : tout chiffre avancé sur le coût de ce système d’exploitation ne peut donc être qu’une estimation.
Combien de couches d’appels API une équipe d’agents génère-t-elle ?
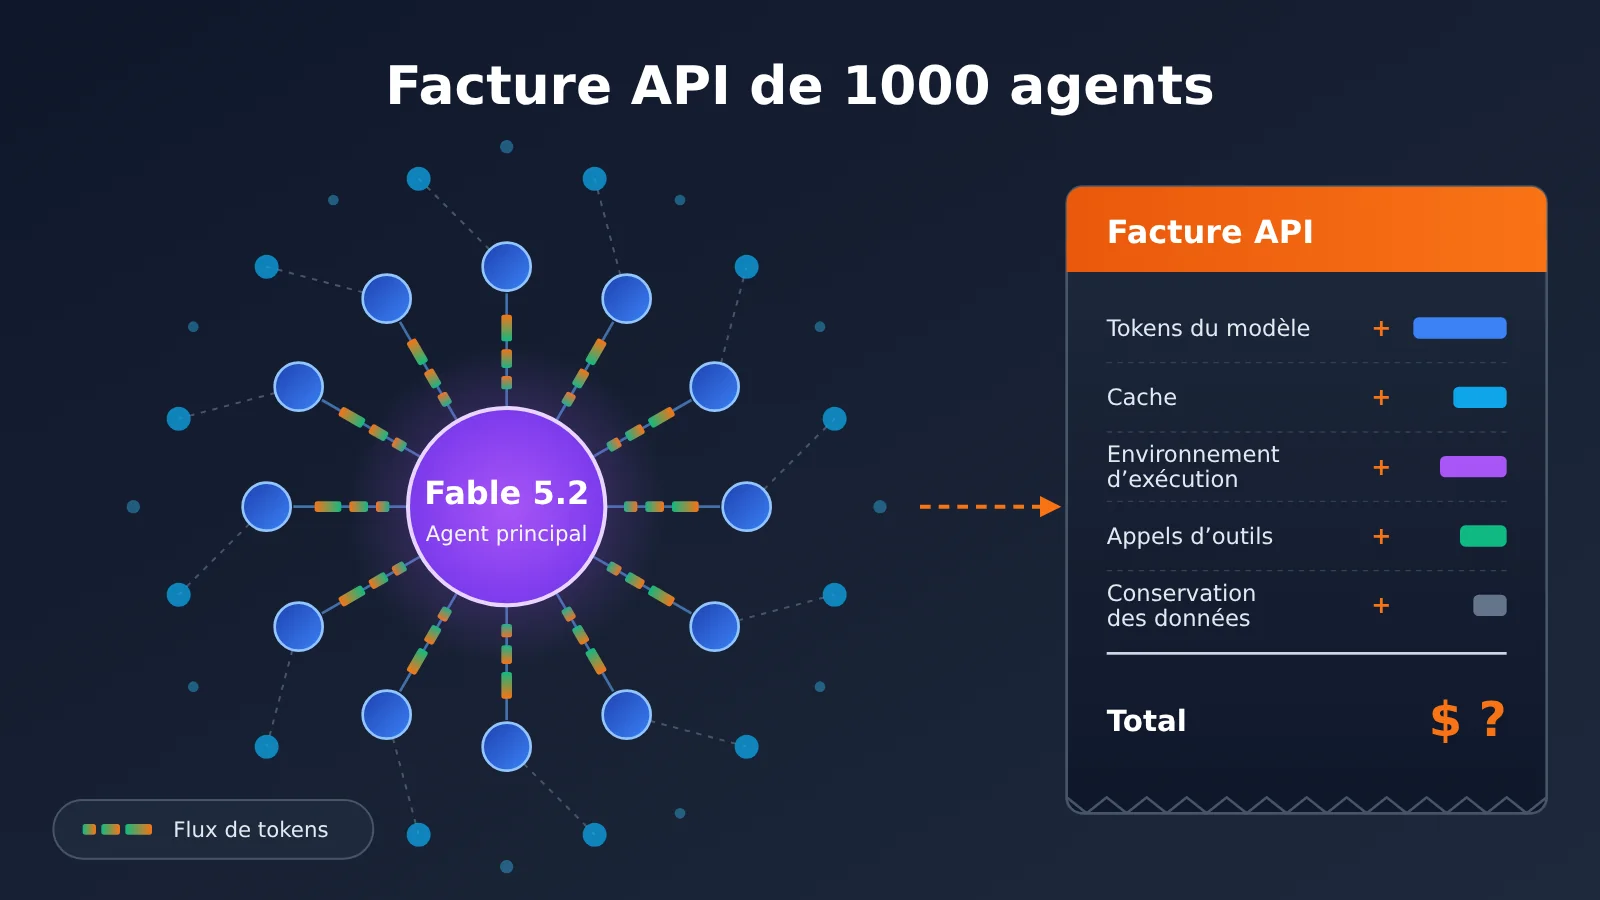
Même sans connaître la facture réelle, on peut comprendre la pression exercée sur les coûts en examinant la structure du travail multi-agent. Un agent principal doit comprendre l’objectif, découper les tâches, les confier aux sous-agents, puis recueillir leurs résultats, les synthétiser et les vérifier. Chaque sous-agent doit à son tour prendre connaissance du contexte du projet, des instructions relatives aux outils et du code pertinent, avant de mener son propre raisonnement et de produire un résultat.
Ainsi, derrière une tâche qui semble n’en former qu’une seule se cachent plusieurs couches d’appels au modèle : appels de planification, d’exécution, de transmission des résultats et de vérification, auxquels s’ajoutent les nouveaux appels en cas d’échec. Lorsque le nombre d’agents augmente et que l’exécution se prolonge sur plusieurs jours, les coûts en Tokens, les appels simultanés et la durée d’exécution deviennent autant de variables qui pèsent sur la facture.
Prix de l’API Claude Fable 5.2 : le point de départ pour évaluer les coûts multi-agents
Pour évaluer les coûts d’un système multi-agents, il faut commencer par le prix unitaire. Les tarifs ci-dessous sont les prix publics d’Anthropic, en dollars par million de tokens (MTok).
| Modèle | Prix des entrées | Prix des sorties | Usage recommandé |
|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | Tâches complexes, ouvertes et de longue durée |
| Claude Opus 5.5 | $4 | $20 | Point de départ recommandé par défaut pour la plupart des tâches de programmation et de travail intellectuel |
| Claude Sonnet 5.5 | $2 | $10 | Sous-tâches de difficulté moyenne et traitement de documents |
| Claude Haiku 5.5 | $0.10 | $0.50 | Sous-tâches simples et fréquentes (jusqu’à 100K tokens en entrée) |
Lorsque les entrées de Haiku 5.5 dépassent 100K tokens, le tarif passe à $0.50/MTok en entrée et $2.50/MTok en sortie. Fable 5.1 coûtait auparavant $10 en entrée et $50 en sortie : le tarif standard par token de Fable 5.2 a donc baissé de 20 %.
💡 Conseil pour choisir : les différents modèles ne sont pas interchangeables à capacités égales. Le choix dépend de la difficulté de la tâche et du niveau de qualité attendu. Avec APIYI apiyi.com, vous pouvez comparer les résultats et la consommation de tokens de plusieurs modèles Claude à l’aide de la même interface compatible avec OpenAI, puis répartir les sous-tâches entre les modèles les mieux adaptés (les modèles disponibles sont ceux qui figurent dans la liste de la plateforme).
Caractéristiques de Claude Fable 5.2 et Fast Mode
L’API Model ID de Fable 5.2 est claude-fable-5-2. Le modèle dispose d’une fenêtre de contexte de 1M tokens et peut générer jusqu’à 128K tokens. Ses connaissances s’arrêtent en juin 2026. Adaptive Thinking est toujours activé. Le niveau d’effort est réglé sur High par défaut, avec les options Low, Medium, High, Xhigh et Max. Ce niveau ne règle pas le style de réponse : il influe directement sur la profondeur de réflexion, le temps d’exécution et la consommation de tokens.
| Élément facturé | Prix (USD/MTok) | Description |
|---|---|---|
| Entrées / sorties standard | $8 / $40 | Mode standard |
| Entrées / sorties en Fast Mode | $16 / $80 | Tarif doublé, vitesse de génération jusqu’à 2,5 fois supérieure à celle du mode standard |
| Entrées / sorties avec l’API Batch | $4 / $20 | Remise de 50 % pour les requêtes asynchrones par lots ; incompatible avec Fast Mode |
| Écriture dans le cache pendant 5 minutes | $10 | Enregistre un préfixe d’entrée pour le réutiliser ultérieurement |
| Écriture dans le cache pendant 1 heure | $16 | Durée de validité plus longue |
| Lecture du cache | $0.20 | Seulement 2,5 % du prix des entrées standard |
Ce tableau met en évidence un point essentiel : le modèle le plus puissant n’a pas besoin de prendre en charge chaque sous-tâche. Utiliser Fable 5.2 pour mettre en forme des données ou effectuer une classification simple, par exemple, revient à payer 4 fois le tarif de Sonnet 5.5 et 80 fois celui de Haiku 5.5, sans réel bénéfice lié à ses capacités de raisonnement supplémentaires.
Comment les coûts s’accumulent dans un système multi-agents : analyse du workflow Claude Fable 5.2
Dans un système multi-agents, l’agent principal planifie et synthétise les résultats, tandis que les agents secondaires se chargent de tâches précises. Le travail semble réparti, mais les tokens ne disparaissent pas pour autant : leur consommation peut même augmenter à plusieurs étapes.
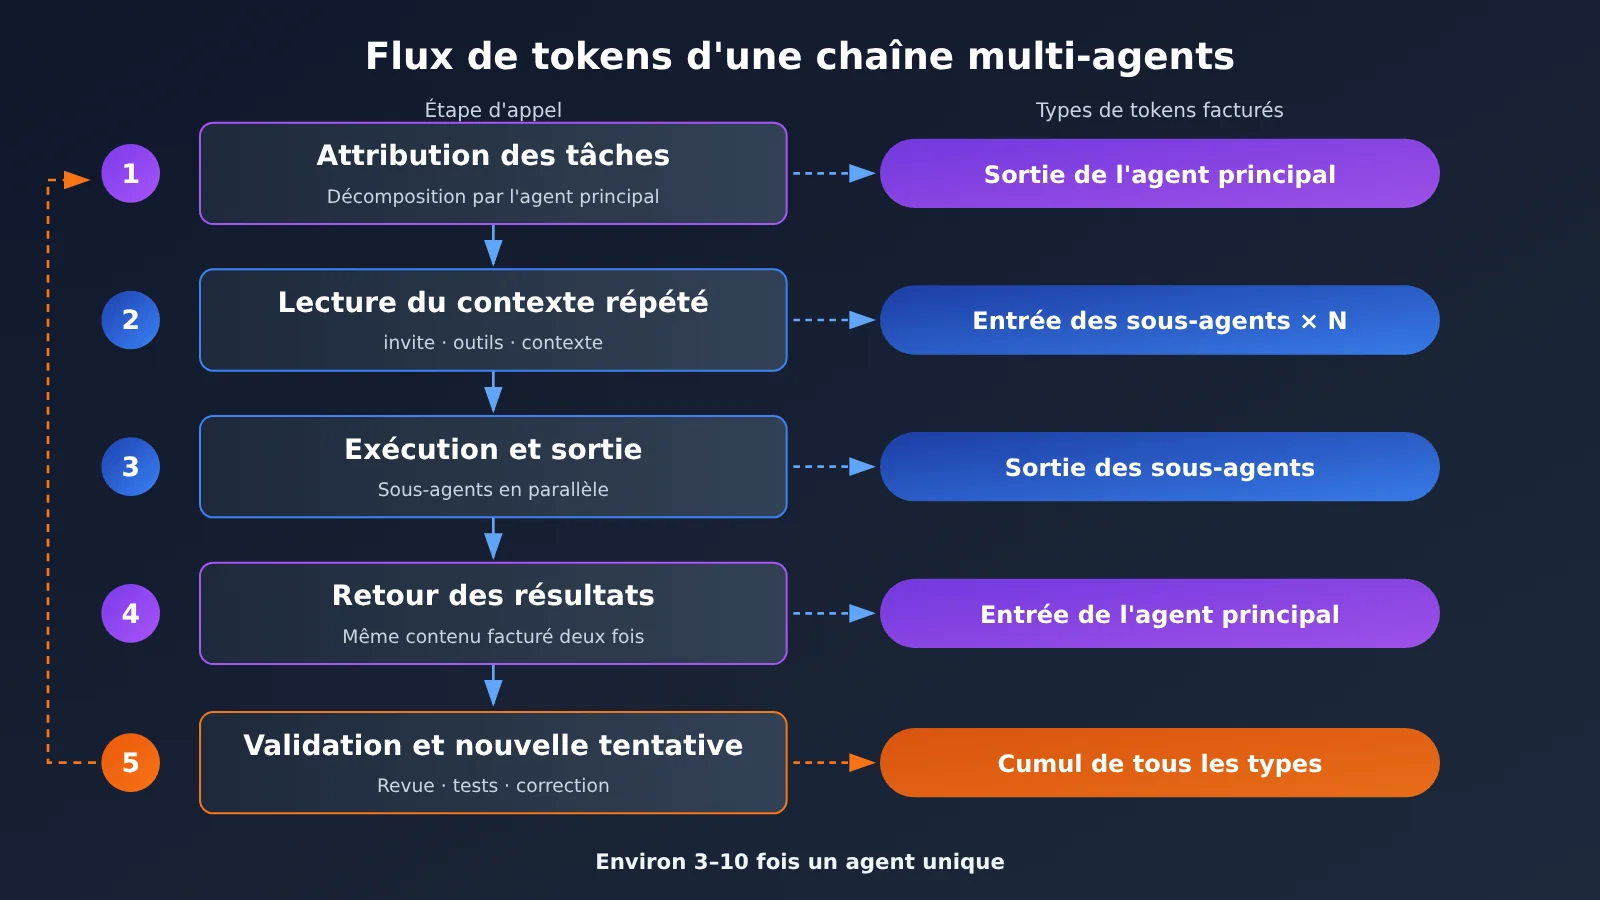
- Répartition des tâches : les descriptions de tâches générées par l’agent principal sont des tokens de sortie, facturés au tarif du modèle utilisé par cet agent.
- Contexte répété : chaque agent secondaire doit relire le prompt système, les descriptions des outils et le contexte du projet. Le même contenu est donc facturé plusieurs fois.
- Retour des résultats : la sortie d’un agent secondaire devient l’entrée de l’agent principal. Autrement dit, le même contenu est facturé deux fois.
- Plusieurs cycles de validation : après l’examen et les tests, si un problème est détecté, une correction est demandée. Chaque cycle correspond à une nouvelle invocation.
- Nouvelles tentatives après un échec : si un appel échoue ou si le résultat n’est pas satisfaisant, la tâche est relancée et la consommation de tokens s’ajoute directement à la précédente.
Le guide d’ingénierie multi-agents d’Anthropic publié en 2026 indique que, pour une même tâche, les systèmes multi-agents consomment généralement 3 à 10 fois plus de tokens qu’un système à agent unique. Il s’agit d’une fourchette typique pour des tâches identiques, pas d’un multiplicateur fixe. À titre d’exemple purement illustratif, si une tâche avec un seul agent coûte 1,60 $, une consommation multipliée par 3 reviendrait à 4,80 $, et une consommation multipliée par 10 à 16 $, avec les mêmes modèles et le même rapport entre tokens d’entrée et de sortie.
Cela explique pourquoi l’exécution en parallèle ne réduit pas nécessairement le coût total. Elle raccourcit le temps écoulé, mais ne diminue pas le nombre de tokens consommés par les agents, et les coûts de coordination s’y ajoutent. Ce qu’il faut réellement maîtriser, ce n’est pas le nombre d’agents en soi, mais la consommation effective de tokens de chacun.
Calcul hypothétique du coût d’un workflow multi-agents avec Claude Fable 5.2
Voici un workflow hypothétique : 1 agent principal Fable 5.2 se charge de la planification et de la synthèse, tandis que 10 sous-agents Sonnet 5.5 traitent chacun des tâches de recherche indépendantes. Tous les volumes de tokens sont hypothétiques. Ils ne correspondent pas à une facture réelle de l’expérience sur le système d’exploitation d’Anthropic et ne constituent pas un test comparatif de modèles sur des tâches de qualité équivalente.
Agent principal (Fable 5.2) : supposons 100,000 tokens en entrée et 10,000 tokens en sortie.
- Entrée : 100,000 × $8 / 1,000,000 = $0.80
- Sortie : 10,000 × $40 / 1,000,000 = $0.40
- Sous-total : $1.20
10 sous-agents (Sonnet 5.5) : supposons que chacun traite 100,000 tokens en entrée et 20,000 tokens en sortie, soit un total de 1,000,000 tokens en entrée et 200,000 tokens en sortie.
- Entrée : 1,000,000 × $2 / 1,000,000 = $2.00
- Sortie : 200,000 × $10 / 1,000,000 = $2.00
- Sous-total : $4.00
| Composant | Coût des entrées | Coût des sorties | Total |
|---|---|---|---|
| Agent principal Fable 5.2 | $0.80 | $0.40 | $1.20 |
| 10 sous-agents Sonnet 5.5 | $2.00 | $2.00 | $4.00 |
| Total des coûts des tokens | $2.80 | $2.40 | $5.20 |
| Durée d’exécution de la session (en supposant qu’une session reste en cours pendant exactement 8 heures) | — | — | $0.64 |
| Total de l’exemple (hors frais liés aux outils) | — | — | $5.84 |
Comment est facturé le Session Runtime de Managed Agents ?
Avec Claude Managed Agents, la facture comprend une ligne supplémentaire pour le Session Runtime, facturé 0,08 $ par heure et par Session. Seul le temps pendant lequel une Session est à l’état running est facturé. Les périodes d’inactivité, d’attente de confirmation de l’utilisateur et les Sessions terminées ne sont pas facturées. Les tokens des sous-agents sont facturés séparément, selon le tarif de leur modèle.
Les 0,64 $ indiqués dans le tableau correspondent à l’hypothèse d’une Session qui s’exécute exactement 8 heures : 8 × 0,08 $ = 0,64 $. Le Runtime est facturé selon la durée d’exécution de la Session, et non en multipliant le nombre d’agents par un tarif horaire individuel. Si plusieurs Sessions génèrent du temps d’exécution, il faut calculer séparément la durée réelle à l’état running de chacune, puis additionner les montants. Les 0,64 $ ne constituent donc pas un coût fixe pour un système multi-agent.
Comment le cache, Batch et les appels d’outils modifient-ils le coût total ?
D’autres éléments de facturation peuvent faire varier la facture réelle d’un même workflow par rapport aux 5,84 $ estimés :
- Prompt Caching : si le System Prompt et le contexte du projet partagés par les sous-agents sont mis en cache, leur lecture ne coûte que 0,20 $/MTok. En revanche, la première écriture coûte plus cher qu’une entrée standard. Si le cache est trop peu utilisé, l’opération peut ne pas être rentable.
- Batch API : les tokens des requêtes asynchrones par lots peuvent bénéficier d’une réduction de 50 %. Mais Managed Agents repose sur des Sessions interactives avec état et ne peut pas profiter de la remise Batch de l’API Messages. Cette réduction de 50 % ne s’applique pas aux frais de Session.
- Appels d’outils : dans Managed Agents, Web Search coûte 10 $ pour 1 000 utilisations. Les agents qui effectuent beaucoup de recherches doivent faire l’objet d’un calcul distinct.
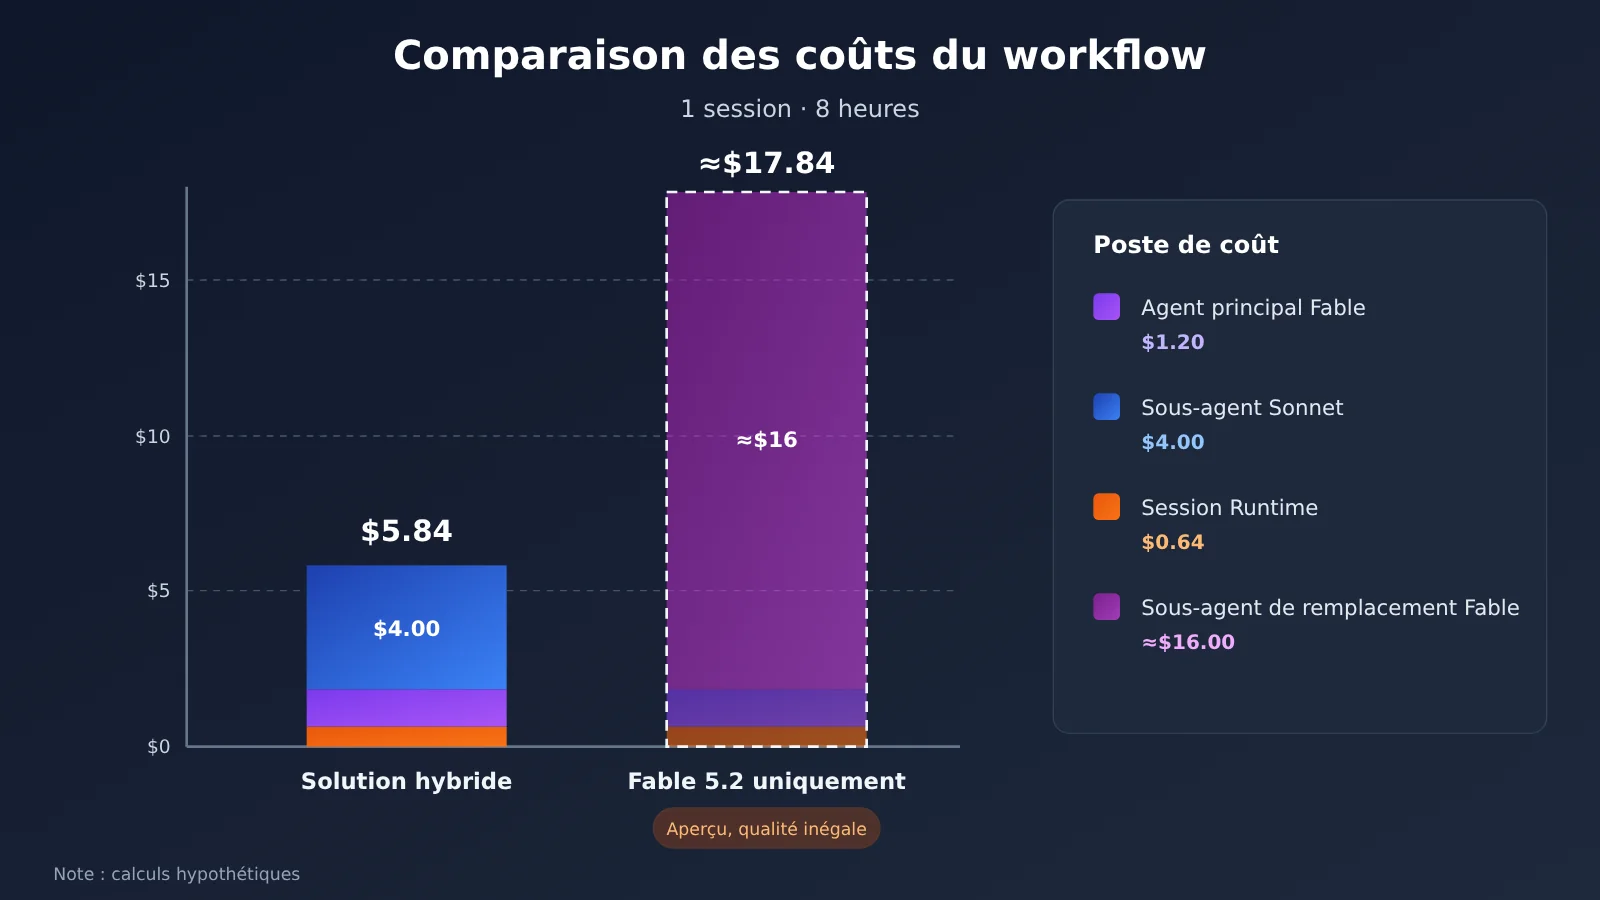
📊 À propos de l’illustration : les données du graphique sont des estimations hypothétiques basées sur les tarifs publics. Pour estimer le coût de votre propre workflow, vous pouvez commencer par effectuer quelques requêtes réelles via APIYI apiyi.com, récupérer le nombre réel de tokens dans le champ
usagede la réponse, puis le reporter dans la grille tarifaire pour faire le calcul.
Comment réduire les coûts d’un système multi-agents avec Claude Fable 5.2
Cet exemple minimal montre comment lire les données d’utilisation dans la réponse et estimer le coût d’un appel à partir de la grille tarifaire. Remplacez le nom du modèle par l’ID réellement disponible sur la plateforme.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="claude-sonnet-model-id",  # Remplacez par l’ID réel indiqué dans la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "总结这段需求文档的要点"}]
)
u = resp.usage
cost = u.prompt_tokens * 2 / 1e6 + u.completion_tokens * 10 / 1e6  # Tarifs affichés de Sonnet 5.5
print(resp.choices[0].message.content, f"估算费用: ${cost:.4f}")
Voir l’implémentation complète : appels par niveau de modèle et suivi du budget
import openai

# Unité : dollars / million de tokens, d’après les tarifs publics d’Anthropic
PRICES = {
    "planner": {"model": "claude-fable-model-id", "in": 8, "out": 40},
    "worker":  {"model": "claude-sonnet-model-id", "in": 2, "out": 10},
    "simple":  {"model": "claude-haiku-model-id", "in": 0.10, "out": 0.50},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

class BudgetTracker:
    def __init__(self, limit_usd: float):
        self.limit = limit_usd
        self.spent = 0.0

    def add(self, tier: str, usage) -> float:
        p = PRICES[tier]
        cost = usage.prompt_tokens * p["in"] / 1e6 + usage.completion_tokens * p["out"] / 1e6
        self.spent += cost
        if self.spent > self.limit:
            raise RuntimeError(f"预算超限:已花费 ${self.spent:.2f}")
        return cost

def run(tier: str, prompt: str, tracker: BudgetTracker) -> str:
    resp = client.chat.completions.create(
        model=PRICES[tier]["model"],
        messages=[{"role": "user", "content": prompt}],
    )
    cost = tracker.add(tier, resp.usage)
    print(f"[{tier}] 本次 ${cost:.4f},累计 ${tracker.spent:.4f}")
    return resp.choices[0].message.content

tracker = BudgetTracker(limit_usd=10.0)
plan = run("planner", "把资料整理任务拆成 3 个独立子任务,每行一个", tracker)
results = [run("worker", f"执行子任务:{t}", tracker) for t in plan.splitlines() if t.strip()]
summary = run("planner", "汇总以下结果:\n" + "\n".join(results), tracker)
print(summary)
🚀 Pour bien démarrer : nous vous recommandons de récupérer d’abord le crédit d’essai gratuit réservé aux nouveaux utilisateurs sur APIYI apiyi.com. Utilisez le script de suivi du budget ci-dessus pour tester le flux minimal « planification — exécution — synthèse », puis augmentez la taille de votre système multi-agents une fois que vous aurez observé la répartition réelle des tokens.
À partir des règles de facturation ci-dessus, le contrôle des coûts peut se résumer en cinq méthodes :
| Méthode | Mise en œuvre | Limites d’application |
|---|---|---|
| Choisir le modèle selon la difficulté | Confier la planification et le raisonnement complexe à Fable 5.2 ou Opus 5.5 | La recommandation officielle est de commencer par Opus 5.5 pour la plupart des tâches |
| Utiliser un modèle moins coûteux pour les sous-tâches simples | Confier la classification, la mise en forme et l’extraction à Sonnet 5.5 ou Haiku 5.5 | Vérifier au préalable que la qualité du modèle moins coûteux est suffisante |
| Activer le Prompt Caching | Mettre en cache les System Prompt partagés, les descriptions des outils et les documents longs | Les économies dépendent du nombre de réutilisations et de la cohérence du contexte |
| Activer le Fast Mode au besoin | Le réserver aux requêtes interactives sensibles à la latence | Le prix double ; ce n’est pas rentable pour les tâches hors ligne |
| Définir un budget et suivre l’utilisation | Suivre la consommation par modèle, agent et tâche, et fixer des limites | Plus tôt le suivi est mis en place, plus vite on peut détecter une consommation anormale |
Il faut aussi préciser les limites de la Batch API : elle convient aux tâches acceptant un traitement asynchrone, comme la classification de grands lots de documents, la génération de contenu hors ligne ou l’analyse de données non temps réel. Elle n’est pas adaptée à toutes les sessions d’agent de longue durée.
Le rôle des passerelles API à l’ère des agents multiples avec Claude Fable 5.2
Le 9 novembre 2026, Vercel a annoncé l’intégration de Claude Fable 5.2 à AI Gateway, sous l’identifiant de modèle anthropic/claude-fable-5.2. C’est un exemple concret pour observer le fonctionnement des passerelles multi-modèles. Le modèle est accessible via AI SDK, OpenAI Chat Completions, OpenAI Responses et Anthropic Messages. Les développeurs peuvent ainsi l’appeler par un point d’entrée unique.
Au niveau du routage, un même modèle peut être sélectionné chez différents fournisseurs, comme Anthropic, AWS Bedrock ou Google Vertex AI, puis classé selon le prix, la latence avant le premier jeton ou le débit. Dans son exemple de secours, Vercel appelle d’abord Fable 5.2 ; si le classificateur de sécurité refuse la requête, le système bascule successivement sur Opus 5.5 puis Sonnet 5.5. La plateforme propose également des rapports d’utilisation, des statistiques de coûts, des budgets pour les clés API, ainsi que des fonctions de nouvelle tentative et de basculement.
Pourquoi les systèmes multi-agents ont-ils davantage besoin de ce type d’infrastructure que de simples conversations ? Dans une conversation, si un appel échoue, l’utilisateur peut le relancer. Mais dans un flux de travail d’agent qui s’exécute pendant plusieurs jours, un seul échec peut bloquer toute la chaîne. Les nouvelles tentatives, elles, font grimper la consommation de jetons. Dans un environnement multi-agents, le choix du modèle, la gestion des appels, le basculement en cas de panne et le suivi des coûts passent du statut de « petit plus » à celui de nécessité.
🎯 Conseil technique : pour les développeurs en Chine, APIYI apiyi.com propose une couche d’accès multi-modèles selon une approche similaire : une seule clé API permet d’appeler les principaux modèles, comme OpenAI, Claude et Gemini. La compatibilité avec l’interface OpenAI réduit les différences entre les fournisseurs, tandis que la facturation à l’usage facilite la répartition des coûts par agent et par tâche.
Conservation des données de Claude Fable 5.2 : les enjeux de conformité pour les applications multi-agents en entreprise
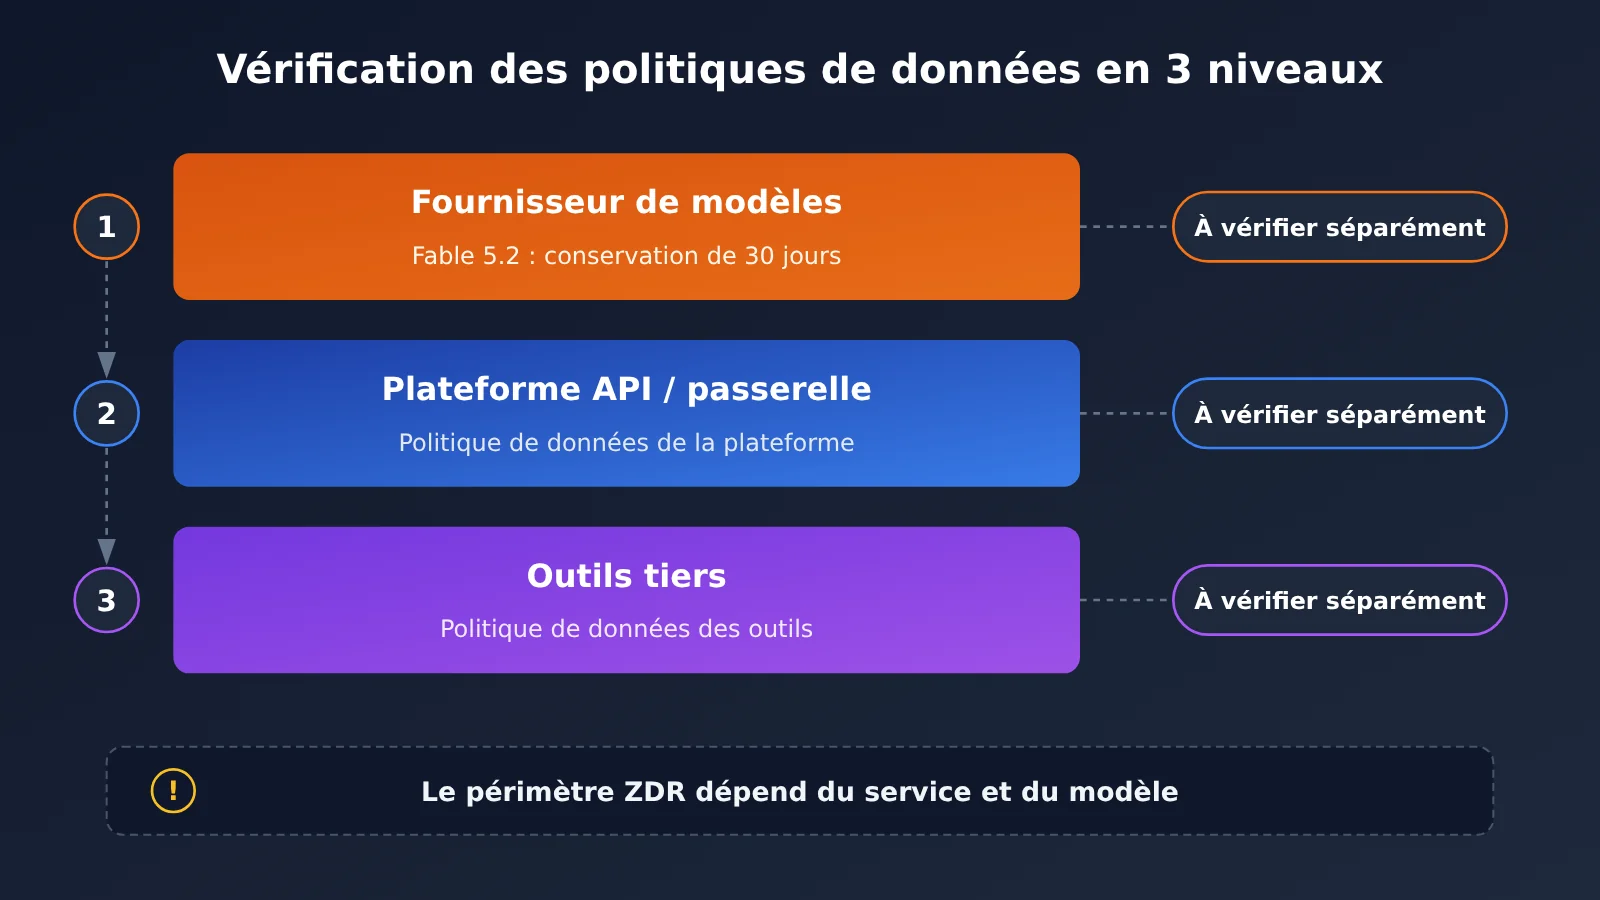
Au-delà des coûts, les entreprises doivent aussi tenir compte de la conformité des données. D’après la documentation officielle d’Anthropic sur la conservation des données, Fable 5.2 est un modèle couvert (« Covered Model ») soumis à une conservation des données de 30 jours. Il ne prend donc pas en charge par défaut la conservation zéro des données (ZDR).
Voici les règles applicables : par défaut, une organisation ne peut pas appeler ce modèle dans le cadre d’un accord ZDR, sauf autorisation explicite d’Anthropic. Les invites et les sorties du modèle sont conservées pendant 30 jours, conformément aux politiques applicables. Les données conservées ne sont pas utilisées pour entraîner les modèles sans autorisation explicite. Les organisations admissibles au ZDR peuvent utiliser ce modèle en activant la conservation des données pendant 30 jours dans un espace de travail spécifique. L’annonce d’intégration de Vercel rappelle également clairement cette exigence.
Un point prête facilement à confusion : les politiques de traitement des données du fournisseur du modèle et celles d’une passerelle API tierce sont distinctes. Même si une plateforme API propose elle-même une option ZDR, cela ne signifie pas que tous les modèles auxquels elle donne accès sont compatibles avec le ZDR. Pour traiter des données métier sensibles, les entreprises doivent vérifier séparément les politiques de traitement des données du fournisseur du modèle, de la plateforme API et des outils tiers, au lieu de comparer uniquement le prix des modèles.
FAQ : questions fréquentes
Q1 : Combien a coûté l’expérience de système d’exploitation avec 1 000 agents de Claude Fable 5.2 ?
Anthropic n’a pas communiqué cette information. L’entreprise n’a pas révélé la consommation totale de tokens, le coût de calcul ni le coût total de l’expérience. Les chiffres précis qui circulent en ligne ne sont pas des données officielles.
Q2 : Les systèmes multi-agents coûtent-ils forcément 3 à 10 fois plus cher qu’un système à agent unique ?
Pas forcément. Il s’agit de la fourchette de comparaison typique donnée par Anthropic pour une même tâche, et non d’un multiplicateur fixe. Le coût réel dépend du degré de répétition du contexte, du nombre de transferts de tâches, du choix des modèles et des résultats de cache.
Q3 : Le Session Runtime est-il facturé pour chaque agent ?
Non. Managed Agents facture la durée pendant laquelle chaque Session est en état `running`, au tarif de 0,08 $ par heure de Session. Les périodes d’inactivité, d’attente de confirmation ou suivant l’arrêt ne sont pas facturées. Pour plusieurs Sessions, calculez séparément la durée d’exécution réelle de chacune, puis additionnez les coûts.
Q4 : La remise de 50 % de l’API Batch s’applique-t-elle à Managed Agents ?
Non. La remise Batch concerne les requêtes asynchrones par lots de l’API Messages. Managed Agents repose sur des Sessions interactives avec état et ne bénéficie pas de cette remise. Par ailleurs, Fast Mode ne peut pas être utilisé en même temps que l’API Batch.
Q5 : Comment tester rapidement le coût réel d’une répartition des tâches entre plusieurs modèles ?
Voici une méthode en trois étapes :
1. Inscrivez-vous sur APIYI, à l’adresse apiyi.com, pour obtenir une clé API et un crédit d’essai gratuit.
2. Dans le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1` et remplacez-le par un ID de modèle disponible sur la plateforme.
3. Lancez de petites tâches avec le script de suivi du budget et notez la répartition réelle des tokens entre les modèles de chaque niveau.
Q6 : Quelles limites faut-il prendre en compte avec Claude Fable 5.2 ?
Premièrement, son prix est élevé : 40 $/MTok en sortie. Il n’est donc pas adapté à la prise en charge de toutes les sous-tâches. Deuxièmement, Fast Mode double le prix. Enfin, une conservation des données de 30 jours est requise ; par défaut, le modèle ne peut pas être appelé dans le cadre d’un dispositif ZDR. Avant de traiter des données sensibles, vérifiez impérativement les exigences de conformité.
Points clés sur les coûts du multi-agent avec Claude Fable 5.2
- Facture non publiée : Anthropic n’a pas révélé le coût réel de son expérience avec 1 000 agents.
- Prix en baisse de 20 % : le tarif standard de Fable 5.2 est de 8 $ par million de tokens en entrée et de 40 $ en sortie.
- Les coûts s’envolent : à tâche identique, un système multi-agent consomme généralement 3 à 10 fois plus de tokens qu’un système mono-agent.
- Runtime facturé par session : 0,08 $ par heure de session, calculés uniquement pendant l’exécution, sans tenir compte du nombre d’agents.
- Les réductions ont leurs limites : la réduction de 50 % de Batch ne s’applique pas à Managed Agents, et les économies liées au cache dépendent du taux de succès.
- Ne négligez pas la conformité : Fable 5.2 impose une conservation des données pendant 30 jours ; l’option ZDR nécessite une autorisation supplémentaire.
- Testez avant de passer à l’échelle : APIYI (apiyi.com) permet de vérifier, via une interface unifiée, la répartition réelle des tokens entre plusieurs modèles.
En résumé
L’expérience de Claude Fable 5.2 avec 1 000 agents fait évoluer la réflexion des développeurs sur les coûts : on ne se demande plus seulement « combien coûte un appel ? », mais « combien coûte l’ensemble du workflow ? ». Voici les points essentiels :
- Les coûts s’additionnent à plusieurs niveaux : agent principal, sous-agents, répétition du contexte, vérification, nouvelles tentatives, Runtime de session et appels aux outils contribuent tous à la facture.
- La répartition des rôles entre les modèles pèse le plus dans le coût : réservez le modèle le plus puissant à la planification et aux raisonnements importants, et confiez les tâches d’exécution à des modèles moins chers.
- Lisez attentivement les règles de facturation : le Runtime est facturé selon la durée d’exécution des sessions, Batch ne couvre pas Managed Agents, et le cache ne devient rentable qu’après un nombre suffisant d’accès réussis.
- La conformité compte autant que le prix : les exigences de conservation des données pendant 30 jours et les restrictions liées à ZDR doivent être prises en compte dès le choix de la solution.
Plus une application multi-agent est complexe, plus elle dépend d’un accès fiable aux modèles, d’un suivi précis de la consommation et d’un mécanisme robuste de basculement en cas de panne. APIYI (apiyi.com) propose une interface unifiée pour tester rapidement différentes répartitions entre modèles. Vous pouvez ainsi établir votre budget à partir de données réelles sur les tokens, puis augmenter progressivement le nombre d’agents.
📚 Références
- Annonce d’Anthropic : Claude Fable 5.2 and Mythos 5.2
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 -
Description : annonce officielle de l’expérience menée avec 1 000 agents et un système d’exploitation
-
Spécifications et tarifs des modèles Claude Platform : Fable 5.2 Overview
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview -
Description : tarifs, fenêtre de contexte, niveau d’effort et autres spécifications
-
Tarifs de Claude Managed Agents : règles de facturation du Session Runtime
- Lien :
platform.claude.com/docs/en/about-claude/pricing -
Description : Runtime, Web Search et tarifs complets de l’API
-
Documentation Prompt Caching : détails sur l’écriture et la lecture du cache
- Lien :
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Description : mise en cache automatique et points de cache explicites
-
Politique de conservation des données de l’API : Covered Model et ZDR
- Lien :
platform.claude.com/docs/en/manage-claude/api-and-data-retention -
Description : référence officielle concernant l’obligation de conservation des données pendant 30 jours
-
Annonce de l’intégration à Vercel AI Gateway : lancement de Fable 5.2
- Lien :
vercel.com/changelog/claude-fable-5-2-now-available-on-ai-gateway - Description : exemples de routage entre plusieurs fournisseurs, de basculement automatique et de gestion des coûts
Auteur : équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI. Pour plus de documentation sur l’intégration, consultez le centre de documentation docs.apiyi.com.