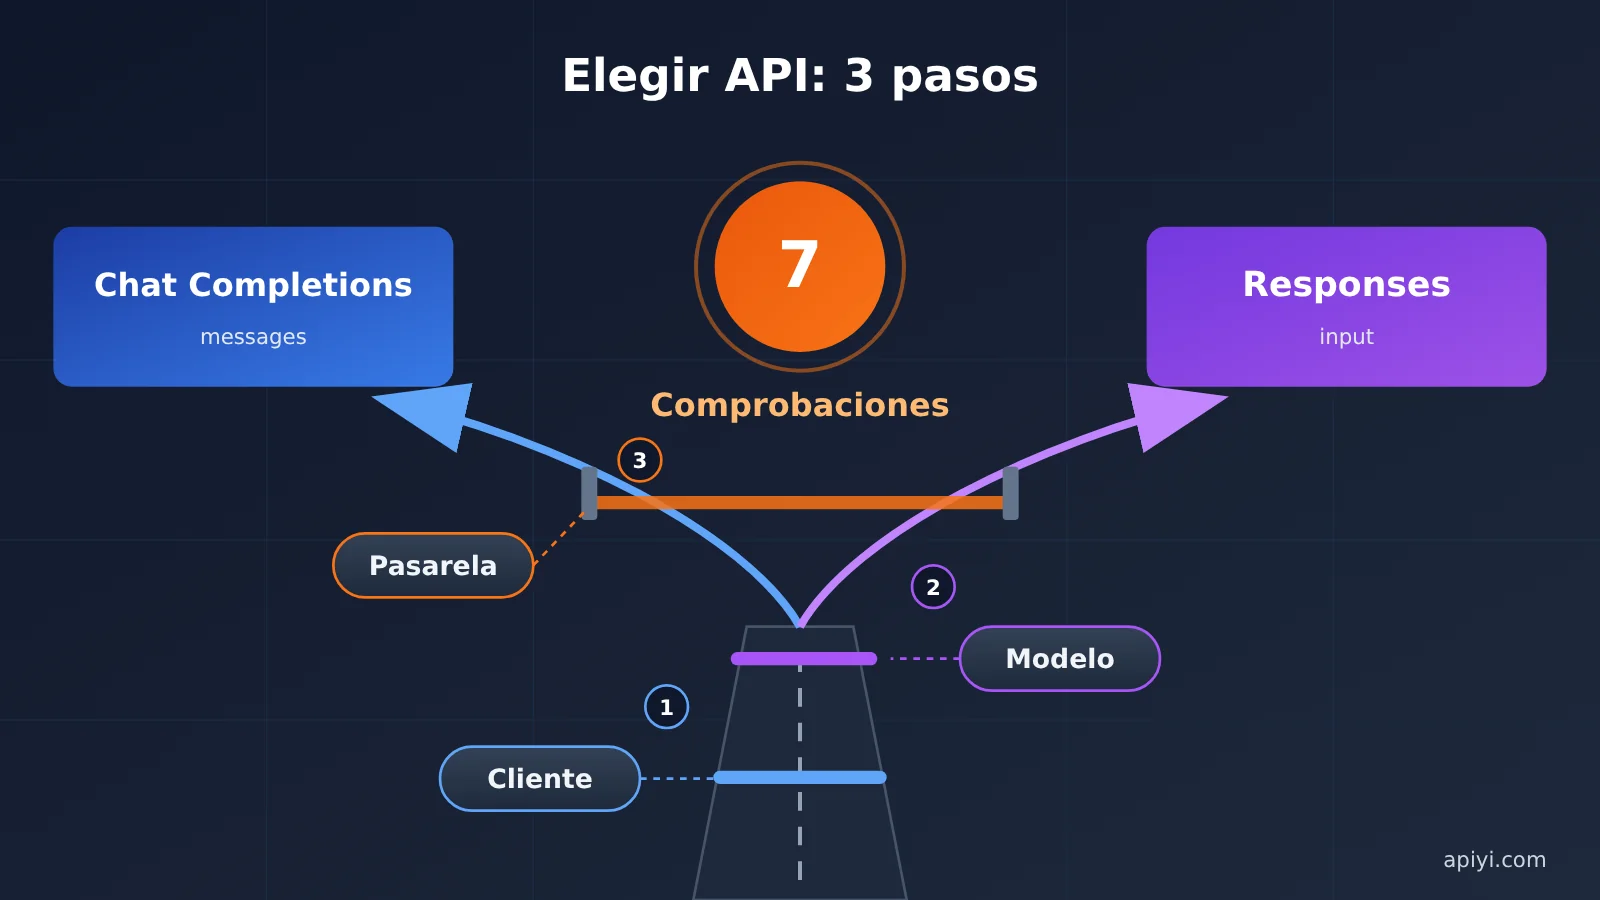
La conclusión primero: elegir entre Responses y Chat Completions no depende de cuál sea la interfaz más reciente, sino de la combinación del cliente, el modelo y el gateway. El cliente determina qué solicitudes puedes enviar; el modelo, qué endpoint ofrece las capacidades que necesitas; y el gateway, si la solicitud puede llegar intacta al proveedor.
Por eso, no fuerces un cambio de interfaz solo para integrar un modelo nuevo. Recuerda esta regla: si el cliente no lo admite, no uses el endpoint por muy nuevo que sea; si el modelo solo admite un endpoint, no intentes encajarlo a la fuerza en otro. Las 7 comprobaciones, la tabla de decisiones por escenario y la lista de reversión que encontrarás a continuación te ayudarán a detectar incompatibilidades en las llamadas a herramientas, los parámetros de razonamiento o los eventos de streaming antes de pasar a producción.
¿Cuál es la diferencia entre Responses y Chat Completions?
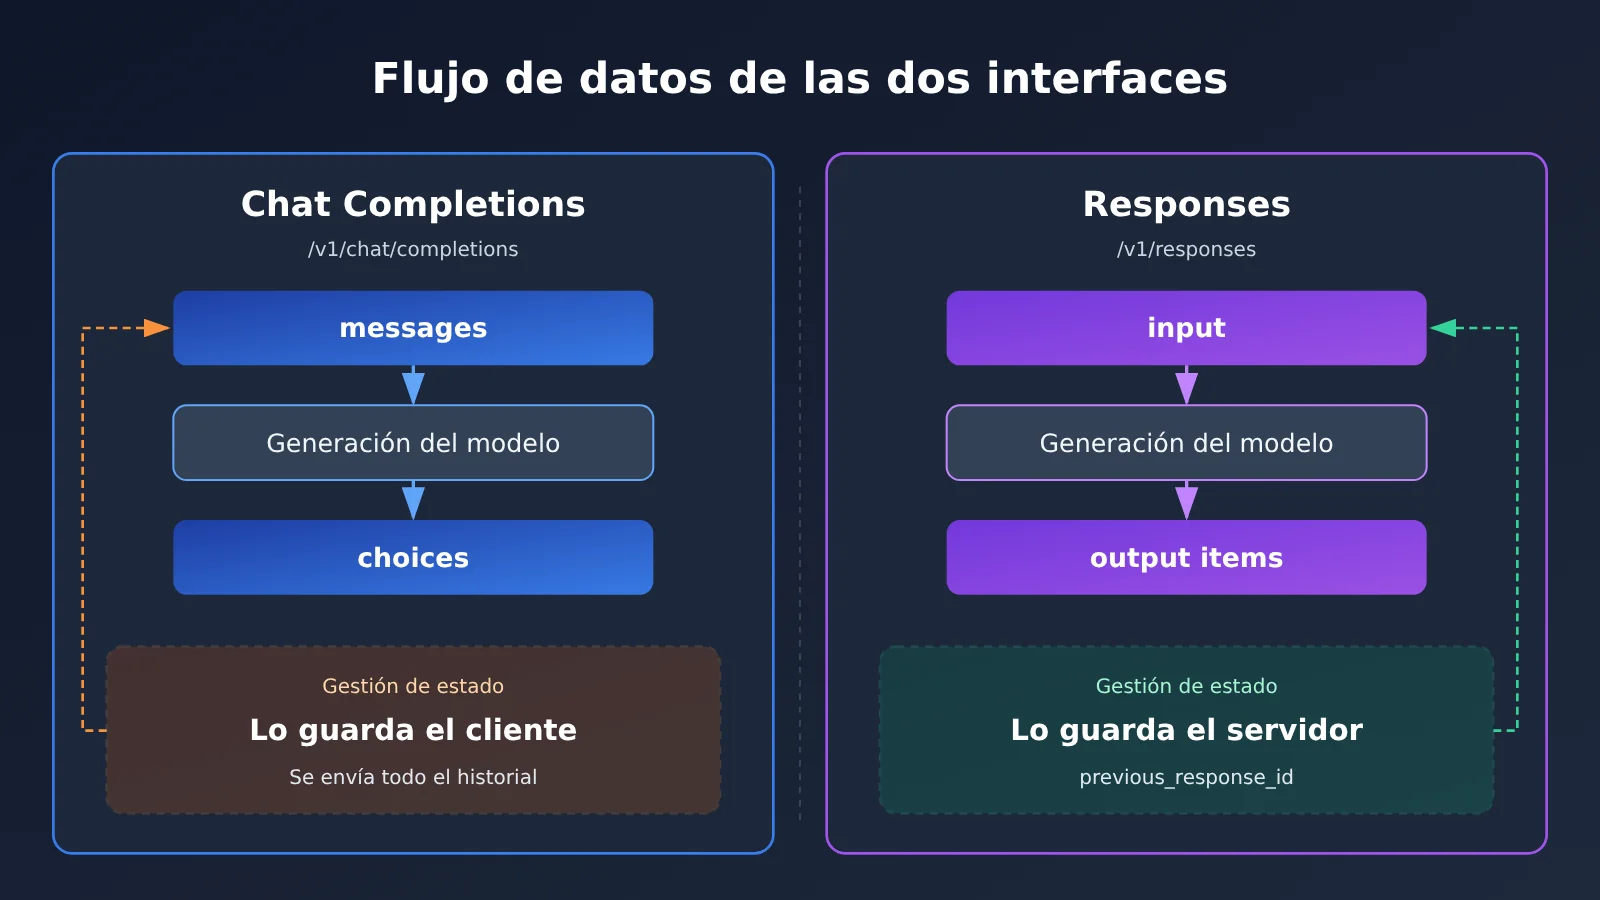
La diferencia principal está en el modelo de datos: Chat Completions gira en torno a un array de mensajes, mientras que Responses gira en torno a un objeto de respuesta.
En Chat Completions, la solicitud se centra en messages. Cada mensaje incluye role y content, y otros campos habituales son temperature, max_tokens, tools y stream. La interfaz no mantiene el estado: quien realiza la llamada gestiona el historial. En la respuesta, message y finish_reason se obtienen de choices, y el consumo se consulta en usage. Es la opción con mayor compatibilidad entre SDK y clientes.
En Responses, la solicitud se centra en input y puede incluir tools, reasoning y previous_response_id. La respuesta contiene el array output, además de output_text, status, id y usage. Algunos modelos de razonamiento nuevos y ciertas funciones de herramientas solo están disponibles en Responses, pero no todos los modelos, SDK, clientes y gateways lo admiten.
| Aspecto | Chat Completions | Responses | Riesgo al migrar |
|---|---|---|---|
| Endpoint y estructura de la solicitud | /v1/chat/completions, usa messages |
/v1/responses, usa input |
La ruta o el cuerpo de la solicitud no coinciden y el código de análisis deja de funcionar |
| Estado en conversaciones de varios turnos | Quien realiza la llamada envía todo el historial | Se puede usar previous_response_id para hacer referencia al turno anterior |
El estado caduca o el contexto deja de ser coherente |
| Parámetros de razonamiento y tokens | max_tokens o max_completion_tokens |
El razonamiento se configura mediante reasoning |
Los parámetros se ignoran o provocan un error |
| Llamadas a herramientas | tools y resultados de herramientas dentro de los mensajes |
Elementos de herramientas en output y sus correspondientes elementos de resultado |
Los ID de llamada no coinciden y el bucle del agente se interrumpe |
| Eventos de streaming | Fragmentos incrementales SSE | Eventos SSE tipados | Finalización prematura o errores al concatenar texto |
| Entrada multimodal | Fragmentos de contenido como image_url |
Elementos de entrada como input_image |
Se rechazan imágenes o archivos |
| Compatibilidad | Amplia cobertura entre clientes y gateways | Depende del cliente, el gateway y el modelo | Se puede configurar la Base URL, pero no acceder al endpoint |
Para elegir, revisa los siguientes puntos en este orden. Si entran en conflicto, prioriza que el cliente y el modelo funcionen correctamente:
- Primero, el cliente: comprueba si admite Chat Completions, Responses o el formato nativo del proveedor.
- Después, el modelo: verifica si el modelo elegido solo está disponible en un endpoint o si depende de herramientas integradas o elementos de razonamiento.
- Luego, el gateway: comprueba si actúa como proxy del endpoint elegido y si permite mapear modelos y registrar solicitudes.
- Por último, el costo: para una misma tarea, comprueba si los costos de tokens, caché y reintentos difieren entre las dos interfaces.
Recomendación de integración: la tabla comparativa te ayuda a identificar riesgos, pero debes comprobar en tu entorno real qué endpoint admite cada modelo. Puedes consultar primero el modelo elegido en la consola de APIYI en apiyi.com y después decidir cómo verificar la integración.
Cómo revisar la capa de solicitudes: comprobaciones 1-3 de la integración con Responses
La conclusión es sencilla: si el endpoint, el estado y los parámetros no están alineados, no vale la pena probar las herramientas ni el streaming.
Comprobación 1: endpoints y estructura de las solicitudes en Responses y Chat Completions
Aquí hay que confirmar que la solicitud llega a la ruta correcta y que tanto el cuerpo como el análisis de la respuesta usan la estructura correspondiente.
- Diferencia: uno usa
/v1/chat/completionsy el otro,/v1/responses. El primero envíamessagesy leechoices; el segundo envíainputy leeoutput. - Error frecuente: cambiar solo la ruta y no el análisis de la respuesta. La solicitud puede haberse completado correctamente, pero el código de la aplicación no encuentra
choices[0].messagey parece que el modelo no devolvió contenido. - Cómo verificarlo: envía una solicitud de texto mínima a cada endpoint y registra el código de estado, los campos de primer nivel de la respuesta y
usage. Si usas la interfaz compatible con OpenAI de APIYI, la Base URL eshttps://api.apiyi.com/v1. Consulta la consola y la documentación para comprobar si el endpoint y el modelo están disponibles. - Cómo elegir: si el modelo admite ambos y tu aplicación solo necesita texto, sigue usando la interfaz actual. Si el modelo solo está disponible en un endpoint, adapta la integración a ese endpoint.
Comprobación 2: gestión del estado en conversaciones de varias vueltas con Chat Completions y Responses
Dónde se guarda el estado determina cómo diagnosticar los problemas y cuánto control tienes sobre el contexto.
- Diferencia: Chat Completions envía el historial completo de
messagesen cada vuelta; Responses permite usarprevious_response_idpara hacer referencia a la respuesta anterior y dejar parte del estado en manos del servidor. - Error frecuente: asumir que enviar menos contenido significa pagar menos. Comprueba en la documentación oficial y en la factura real si el contexto histórico sigue contabilizándose como tokens de entrada. Otro problema es el vencimiento del estado: al reanudar una tarea larga, es posible que un response id antiguo ya no funcione.
- Cómo verificarlo: ejecuta tres vueltas de conversación y comprueba que la tercera pueda hacer referencia a información de la primera. Después, prueba la gestión de errores con un id antiguo y verifica que el error se pueda identificar. Si hay varias rutas de proveedores detrás del gateway, confirma también si el id puede seguir usándose entre solicitudes, según lo que admita el gateway.
- Cómo elegir: si necesitas controlar el contexto por completo y facilitar su auditoría y recorte, enviar todo el historial es más directo. Evalúa Responses cuando las conversaciones largas o los ciclos de Agent puedan beneficiarse realmente del estado gestionado por el servidor.
Comprobación 3: parámetros de razonamiento y tokens al migrar a Responses
El mayor riesgo con los parámetros no suele ser un error explícito, sino que se ignoren silenciosamente: la solicitud se completa, pero la configuración de razonamiento no se aplica.
- Diferencia: en algunos modelos nuevos,
max_completion_tokensha sustituido amax_tokens; el campo antiguo puede ignorarse o provocar un error. El nombre del ajuste de intensidad de razonamiento también cambia según el proveedor y la interfaz; entre las formas habituales están reasoning effort ythinking. - Error frecuente: usar la misma plantilla de parámetros para todos los modelos. Si el cliente o el gateway descarta los campos desconocidos, la respuesta puede parecer normal, aunque la profundidad de razonamiento y el límite de salida no coincidan con los valores configurados.
- Cómo verificarlo: cambia uno por uno el límite de salida y la intensidad de razonamiento, y compara la longitud de las respuestas,
usagey los mensajes de error. Si no hay diferencias, comprueba primero si los parámetros no se están transmitiendo o si el modelo no los admite; después, consulta la documentación oficial y las indicaciones del gateway. - Cómo elegir: mantén una tabla de correspondencias de parámetros por «modelo + endpoint», en lugar de agruparlos de forma general por proveedor. Si tu aplicación depende de la configuración
reasoning, prioriza una ruta de interfaz que permita transmitir ese campo sin modificarlo.
Cómo revisar la capa de capacidades: comprobaciones 4 a 6 de la migración de Chat Completions
La conclusión en esta capa es que ambas interfaces pueden admitir una misma función, pero el código de análisis de respuestas prácticamente no se puede reutilizar sin cambios.
Comprobación 4: llamadas a herramientas en Chat Completions y Responses
Chat Completions admite llamadas a herramientas. Lo que realmente hay que migrar es el esquema de las herramientas, los ID de las llamadas y la forma de devolver los resultados.
- Diferencia: ambas interfaces tienen definiciones de herramientas, pero su estructura es distinta. En Chat Completions, las llamadas suelen aparecer en
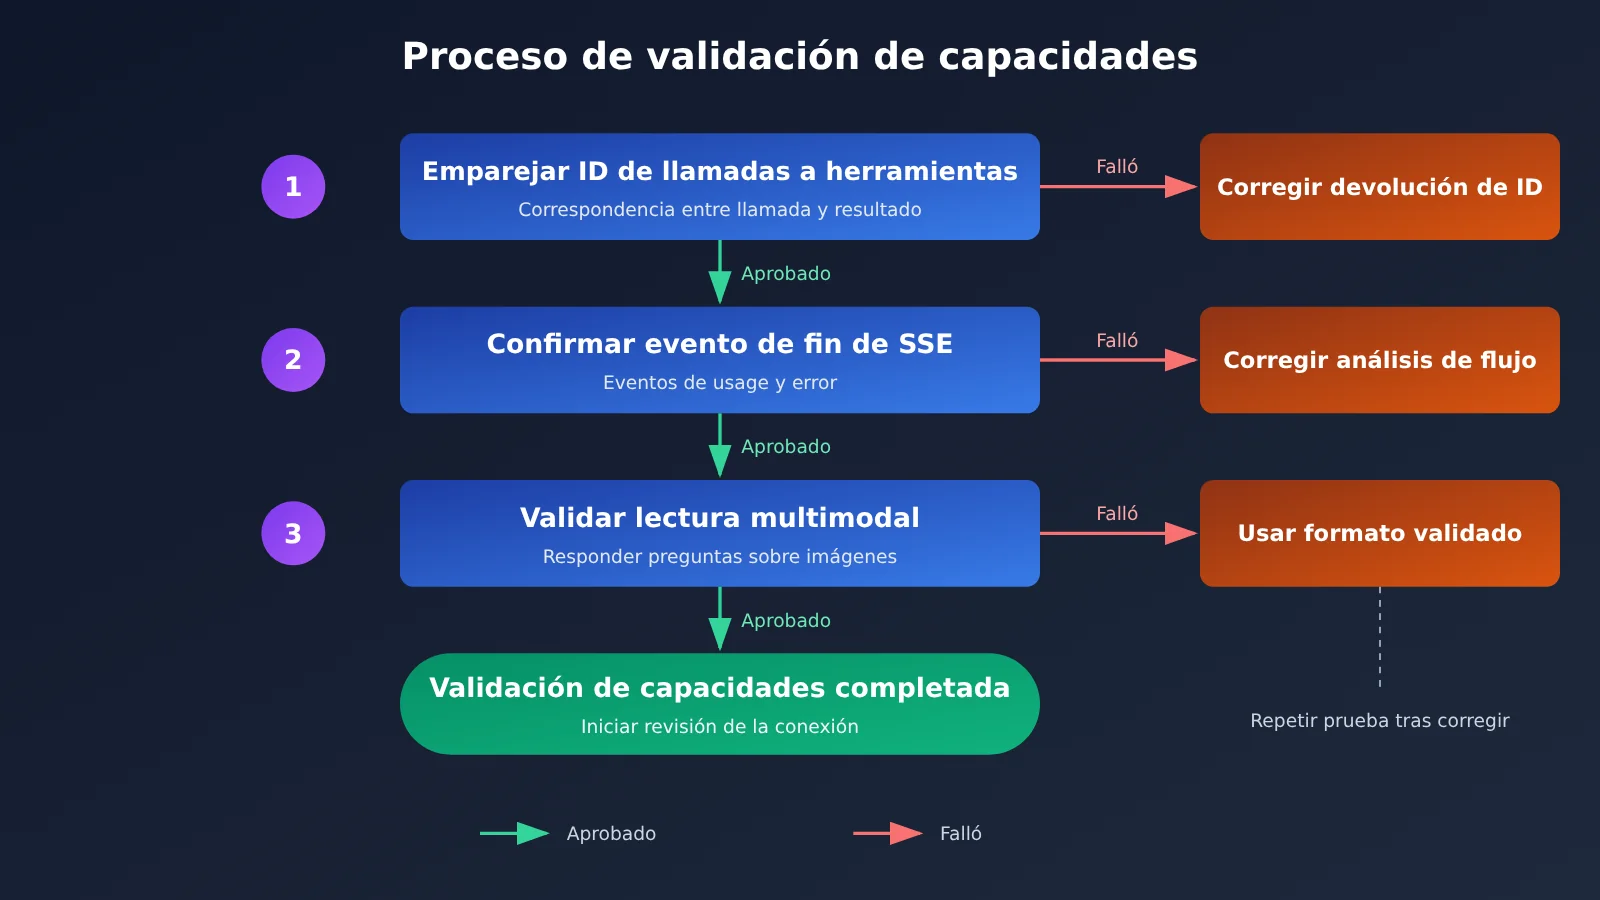
tool_callsdentro del mensaje del asistente; en Responses, se devuelven como elementos deoutputy los resultados también deben enviarse como elementos de entrada correspondientes. Consulta la documentación oficial para conocer los campos concretos. - Errores frecuentes: procesar solo la primera herramienta cuando hay llamadas en paralelo o modificar el ID de la llamada antes de devolverlo. En el siguiente turno, el modelo podría dar un error o continuar razonando con el resultado equivocado; lo segundo es más difícil de detectar.
- Cómo comprobarlo: prepara un caso con una sola herramienta y otro con herramientas en paralelo. Comprueba que cada ID de llamada se devuelva sin cambios y que cada resultado se corresponda con su llamada. Después, fuerza un fallo en una herramienta y confirma que el ciclo del agente pueda cerrarse correctamente.
- Cómo elegir: si tu cadena de herramientas actual es estable y no necesitas herramientas integradas, mantente en Chat Completions. Si las herramientas integradas del modelo que quieres usar solo están disponibles en Responses, migra y reescribe la capa de análisis de respuestas.
Comprobación 5: eventos de streaming en Responses y Chat Completions
En streaming no basta con comprobar que aparece texto: también hay que verificar cómo se gestionan la finalización y los errores.
- Diferencia: ambas interfaces se basan en SSE, pero los tipos de eventos y los marcadores de finalización son diferentes. Chat Completions se centra en fragmentos incrementales; Responses usa distintos tipos de eventos para distinguir el texto, las herramientas y el estado de finalización.
- Errores frecuentes: considerar que la respuesta terminó en cuanto se recibe
data, o concatenar solo los incrementos de texto sin procesar los incrementos de parámetros de herramientas ni los eventos de error. Esto puede truncar la respuesta o dejar incompletos los parámetros de las herramientas. - Cómo comprobarlo: captura el flujo SSE completo en bruto y revisa el orden de los incrementos, el evento de finalización, dónde aparece
usagey qué ocurre si hay un error a mitad de la transmisión. Si la pasarela transforma o almacena en búfer los eventos, repite la captura en el trayecto que pasa por ella. - Cómo elegir: si el analizador de streaming del cliente solo reconoce el formato de Chat Completions, no cambies directamente a Responses. Antes de hacerlo, actualiza el SDK o adapta la capa de análisis.
Comprobación 6: entrada multimodal al integrar Responses
Los campos multimodales dependen tanto de la interfaz como del proveedor: que funcione el texto no significa que también funcionen las imágenes y los archivos.
- Diferencia: los campos de imagen pueden ser
image_url,input_imageo base64. Las formas de enviar archivos y audio también varían según la interfaz y el proveedor. - Errores frecuentes: reutilizar la estructura antigua de los fragmentos de contenido o asumir que se pueden usar tanto URL como base64. Al transformar el formato en la pasarela, también pueden surgir diferencias de tamaño, codificación o tipo de archivo.
- Cómo comprobarlo: envía solicitudes mínimas por separado con una imagen mediante URL, una imagen en base64 y el tipo de archivo que necesitas usar. Confirma que el modelo realmente haya leído el contenido. Pedirle que responda una pregunta que solo pueda contestarse viendo la imagen es más fiable que revisar únicamente el código de estado.
- Cómo elegir: si solo necesitas comprensión de imágenes, prioriza el formato que ya hayas validado con tu cliente actual. Si las capacidades de archivos o audio dependen de un endpoint concreto, guíate por la documentación oficial y lo que admita la pasarela.
Cómo revisar la cadena de conexión: comprobación 7 de compatibilidad con Responses
La conclusión es clara: poder configurar una Base URL no significa que el cliente, el SDK y el gateway sean compatibles con Responses.
Comprobación 7: compatibilidad de Responses con el SDK, el cliente y el gateway
Una solicitud pasa por cuatro capas: cliente, SDK, gateway y modelo. Si cualquiera de ellas no es compatible, no podrás usar la nueva interfaz.
| Capa | Qué hay que confirmar | Error habitual |
|---|---|---|
| Cliente | Si admite el endpoint de destino y si la versión es lo bastante reciente | Creer que admite Responses porque permite configurar una Base URL |
| SDK | Si incluye métodos y tipos de eventos para el endpoint de destino | Creer que puede interpretar el streaming y las herramientas porque la solicitud se envía correctamente |
| Gateway | Si actúa como proxy del endpoint de destino y si hay que activarlo por separado | Creer que cubre todos los endpoints de OpenAI porque es compatible con OpenAI |
| Mapeo de modelos | Si el ID del modelo aparece en la lista y si necesita un mapeo | Creer que el nombre es el mismo en el gateway porque funciona el nombre oficial del modelo |
- Diferencia: Chat Completions tiene la compatibilidad más amplia; la disponibilidad de Responses depende de la combinación de cliente, SDK, gateway y modelo.
- Error frecuente: el cliente construye la ruta como
/chat/completionssin avisar, o el gateway solo actúa como proxy para algunos campos. Si al investigar el problema solo revisas el nombre del modelo, puedes concluir erróneamente que el modelo no tiene la capacidad necesaria. - Cómo verificarlo: primero, prescinde del código de la aplicación y envía una solicitud mínima con una herramienta de prueba de API. Después, envía la misma solicitud desde el cliente y compara la ruta utilizada, el cuerpo de la solicitud y la respuesta.
- Cómo elegir: si alguna capa de la cadena no admite el endpoint de destino, conserva por ahora la interfaz actual o utiliza un formato que esa capa sí admita.
En entornos con varios modelos, conviene que el gateway reduzca al mínimo los cambios necesarios en el cliente. APIYI apiyi.com permite invocar modelos de distintos proveedores, como OpenAI, Claude y Gemini, con una sola clave. Además, es compatible tanto con el estándar de la API de OpenAI como con los formatos nativos de Claude y Gemini. Así, el cliente puede conectarse con el protocolo que admita, sin tener que crear una configuración de conexión para cada modelo.
No escribas el ID del modelo de memoria ni copies directamente los nombres de otras plataformas. Antes de migrar, consulta la lista de modelos en la consola de APIYI apiyi.com para confirmar el ID y los endpoints disponibles. Consulta también la consola y la documentación para conocer los precios y la disponibilidad. Este paso lleva poco tiempo y permite descartar muchos errores de «el modelo no existe» o «el endpoint no es compatible».
Responses o Chat Completions: cómo elegir según el caso
En la mayoría de las tareas sencillas, Chat Completions es suficiente. Conviene pasar a Responses cuando realmente necesites sus nuevas capacidades.
| Caso de uso | Interfaz recomendada | Motivo | Qué más comprobar |
|---|---|---|---|
| Agentes de programación (Claude Code, Codex CLI, Cline, etc.) | Elegir según los formatos que admita el cliente | La implementación del protocolo en el cliente determina las opciones disponibles; la mayoría sigue usando principalmente Chat Completions o Anthropic Messages | Configuración del protocolo en la versión actual, llamadas a herramientas y análisis del streaming |
| Nuevos modelos de razonamiento de OpenAI con herramientas integradas | Priorizar Responses | Algunas capacidades de razonamiento y herramientas solo están disponibles en Responses | Si la pasarela actúa como proxy del endpoint y si las herramientas integradas están disponibles |
| Conversaciones largas o ciclos de agentes | Evaluar Responses | El estado en el servidor puede reducir las transmisiones repetidas | Tiempo de expiración del estado, consistencia y coste real en tokens |
| Llamadas a herramientas personalizadas | Mantener la interfaz estable que ya se use | Chat Completions también admite llamadas a herramientas; el coste de migración está sobre todo en la capa de análisis | Llamadas en paralelo, correspondencia de los ID de llamada y devolución de errores |
| Acceso unificado a varios modelos | Priorizar una pasarela que admita varios formatos | Evita tener que modificar el cliente para cada modelo | Asignación de modelos, registros y diferencias entre los parámetros de cada modelo |
| Preguntas y respuestas de solo lectura o clasificación sencilla | Chat Completions | Ofrece capacidades suficientes, amplia compatibilidad y un coste de adaptación bajo | Si el parámetro de límite de salida es compatible con el modelo elegido |
Para usar esta tabla, primero busca tu caso y después revisa la última columna. Por ejemplo, si el modelo elegido solo ofrece Responses y tu cliente solo admite Chat Completions, no conviene forzar una adaptación de los campos. Es mejor actualizar o cambiar el cliente, o elegir otro modelo disponible por esa vía.
Deja el coste para el final. Responses no tiene por qué ser más barato: los aciertos de caché, el número de reintentos y el consumo real de tokens influyen en el resultado. La comparación solo es significativa si revisas las facturas para una misma tarea.
Recomendación: si tienes varios modelos candidatos, puedes compararlos con el mismo conjunto de indicaciones y casos de uso de herramientas. Con APIYI apiyi.com puedes cambiar de modelo usando la misma clave y aprovechar el crédito de prueba gratuito para nuevos usuarios para hacer una validación a pequeña escala. Así reduces el trabajo inicial de integración y configuración.
Preguntas frecuentes sobre Responses y Chat Completions
La respuesta común a estas preguntas es: revisa primero el flujo real antes de sacar conclusiones.
Q1: ¿Los modelos nuevos solo se pueden usar con Responses?
No necesariamente. Depende del modelo y de la pasarela: algunos modelos nuevos de razonamiento o funciones de herramientas solo están disponibles en Responses, mientras que otros modelos siguen siendo compatibles con Chat Completions. Antes de integrarlos, consulta la documentación oficial y la descripción del modelo en la pasarela.
Q2: ¿Chat Completions todavía permite llamar herramientas?
Sí. Chat Completions admite llamadas a herramientas; la diferencia está en la estructura de los campos, el formato de devolución de resultados y la gestión del estado. Al migrar a Responses, normalmente hay que ajustar el código que procesa las herramientas: no se puede reutilizar directamente.
Q3: ¿Qué hago si la pasarela no admite Responses?
Comprueba primero si el modelo que quieres usar también funciona con Chat Completions o con el formato nativo del proveedor. Si es así, conserva la ruta actual. Si el modelo solo está disponible mediante Responses, tendrás que cambiar a una pasarela que admita ese endpoint o conectarte directamente. Si usas APIYI apiyi.com, puedes consultar en la consola y la documentación qué endpoints admite el modelo.
Q4: ¿Por qué cambió la facturación después de migrar?
Entre las causas habituales están los cambios en la forma de transmitir el contexto, la cantidad de tokens de razonamiento o los aciertos de caché, así como las rondas adicionales por llamadas a herramientas y los reintentos tras errores. Para investigar, compara `usage` para una misma tarea y después revisa el modelo, la cantidad de solicitudes y el consumo de tokens en los registros de uso de APIYI apiyi.com.
Q5: ¿Cuándo debería revertir la migración?
Conviene revertirla si falla el flujo principal, se asignan incorrectamente los resultados de las herramientas, las respuestas en streaming se cortan con frecuencia o la tasa de éxito, la latencia o los costos se desvían claramente de los valores de referencia sin una explicación a corto plazo. Define los criterios de reversión antes de migrar para evitar discusiones improvisadas después de poner los cambios en producción.
Lista de verificación para migrar a Responses y revertir cambios
La conclusión es sencilla: valida en pasos pequeños, conserva la ruta anterior y decide si continuar según la línea base.
Lista de verificación antes y después de migrar a Responses
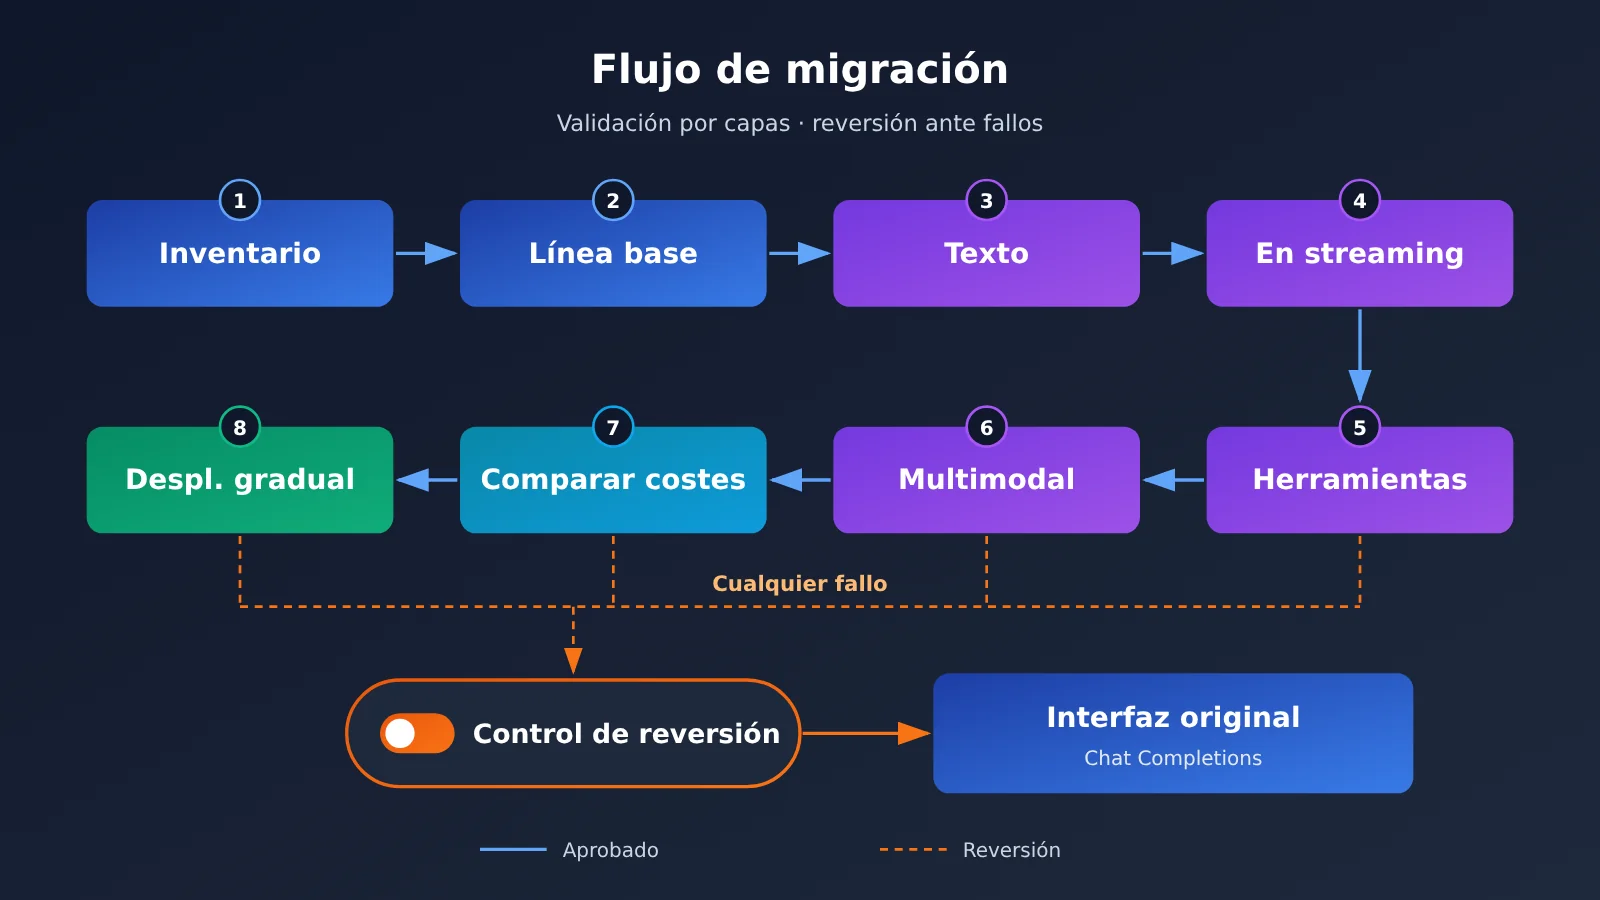
- Inventario de versiones: enumera las versiones del cliente, el SDK y la pasarela, y confirma que admiten el endpoint de destino.
- Confirmar la correspondencia: revisa el endpoint, el ID del modelo y los parámetros de razonamiento y tokens.
- Registrar la línea base: guarda la tasa de éxito, la latencia y el costo en tokens de la interfaz original.
- Conservar la ruta anterior: mantén la configuración y el ID del modelo de la interfaz original. Usa un interruptor o una variable de entorno para cambiar entre interfaces; no lo fijes en el código.
- Validar primero el texto: comprueba que una solicitud mínima de texto funcione y que la respuesta se interprete correctamente.
- Validar después el streaming: comprueba que los fragmentos se ensamblen por completo y que los eventos de finalización y error se gestionen correctamente.
- Validar las herramientas: comprueba que funcionen tanto una sola herramienta como varias en paralelo, y que los ID de llamada se vinculen con los resultados correctos.
- Validar por último la capacidad multimodal: comprueba que el modelo pueda leer correctamente las imágenes, los archivos y demás entradas que realmente se utilicen.
- Explicar la facturación: compara la facturación por tokens y la caché, y asegúrate de poder explicar las diferencias.
- Despliegue gradual con poco tráfico: empieza con una pequeña cantidad de tráfico no crítico y registra las diferencias y los casos de fallo.
Durante la validación de la migración, conviene comparar los resultados de las solicitudes antiguas y nuevas. La consola de APIYI apiyi.com permite consultar el uso y la facturación; puedes revisar los registros para comprobar que los modelos y el consumo de las solicitudes del despliegue gradual sean los esperados. Si detectas alguna anomalía, vuelve a la configuración de la interfaz original y utiliza los casos fallidos para reproducir el problema.
Condiciones para volver a Chat Completions
| Aspecto observado | Acción recomendada | Criterio para revertir |
|---|---|---|
| Fallo en las solicitudes de texto | Pausar el despliegue gradual y revisar el endpoint y la interpretación de la respuesta | Revertir si no se puede corregir a corto plazo |
| El streaming se trunca o no termina | Comparar los eventos SSE originales | Revertir de inmediato si afecta a la salida que recibe el usuario |
| Llamadas a herramientas mal emparejadas | Revisar los ID de llamada y el formato de devolución | Revertir de inmediato si puede provocar acciones incorrectas |
| Los parámetros de razonamiento no surten efecto | Comprobar que se transmitan y que el modelo los admita | Revertir si afecta a la calidad de la salida y no hay una configuración alternativa |
| El costo se desvía de la línea base | Analizar los tokens, la caché y los reintentos | Revertir si supera el umbral definido por el equipo y no se puede explicar |
Responses o Chat Completions: puntos clave
- Orden de elección: primero el cliente, después el modelo, luego la pasarela y, por último, la comparación de costos.
- Límites de capacidad: Responses es adecuado para modelos que dependen de sus funciones exclusivas, pero no todos los modelos lo admiten.
- Llamadas a herramientas: Chat Completions también puede llamar a herramientas; la migración debe centrarse en los campos y en cómo se emparejan las llamadas con sus resultados.
- Orden de validación: primero texto, luego streaming, después herramientas y, por último, capacidad multimodal.
- Requisitos para revertir: no elimines la configuración anterior, registra la línea base con antelación y usa un interruptor para cambiar de interfaz.
Conclusión: la decisión final entre Responses y Chat Completions
Si tu flujo actual con Chat Completions es estable, ofrece las funciones que necesitas y permite conectar el nuevo modelo, no hace falta cambiar de interfaz solo por cambiar. Si el modelo de destino o las herramientas integradas dependen de Responses, sigue las 7 comprobaciones para validar cada nivel. Por último, recuerda: si el cliente no es compatible, no uses la interfaz por muy nueva que sea; si el modelo solo admite un endpoint, no intentes forzarlo a usar otro.
Cuando estés listo para empezar, puedes confirmar primero el ID del modelo y la compatibilidad del endpoint en APIYI apiyi.com, completar la lista con solicitudes mínimas y después decidir si aumentas el tráfico.
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI. Encontrarás más información sobre la integración en el centro de documentación docs.apiyi.com