Nota del autor: La clasificación del Search Index de Artificial Analysis con fecha 2026-11-09 muestra que, con un modelo de respuesta fijo y cambiando solo la configuración de búsqueda, la puntuación global puede pasar de 33 a 83 puntos. Sin embargo, al elegir todavía hay que considerar al mismo tiempo el costo por tarea, el tiempo de ejecución y los límites de la evaluación.
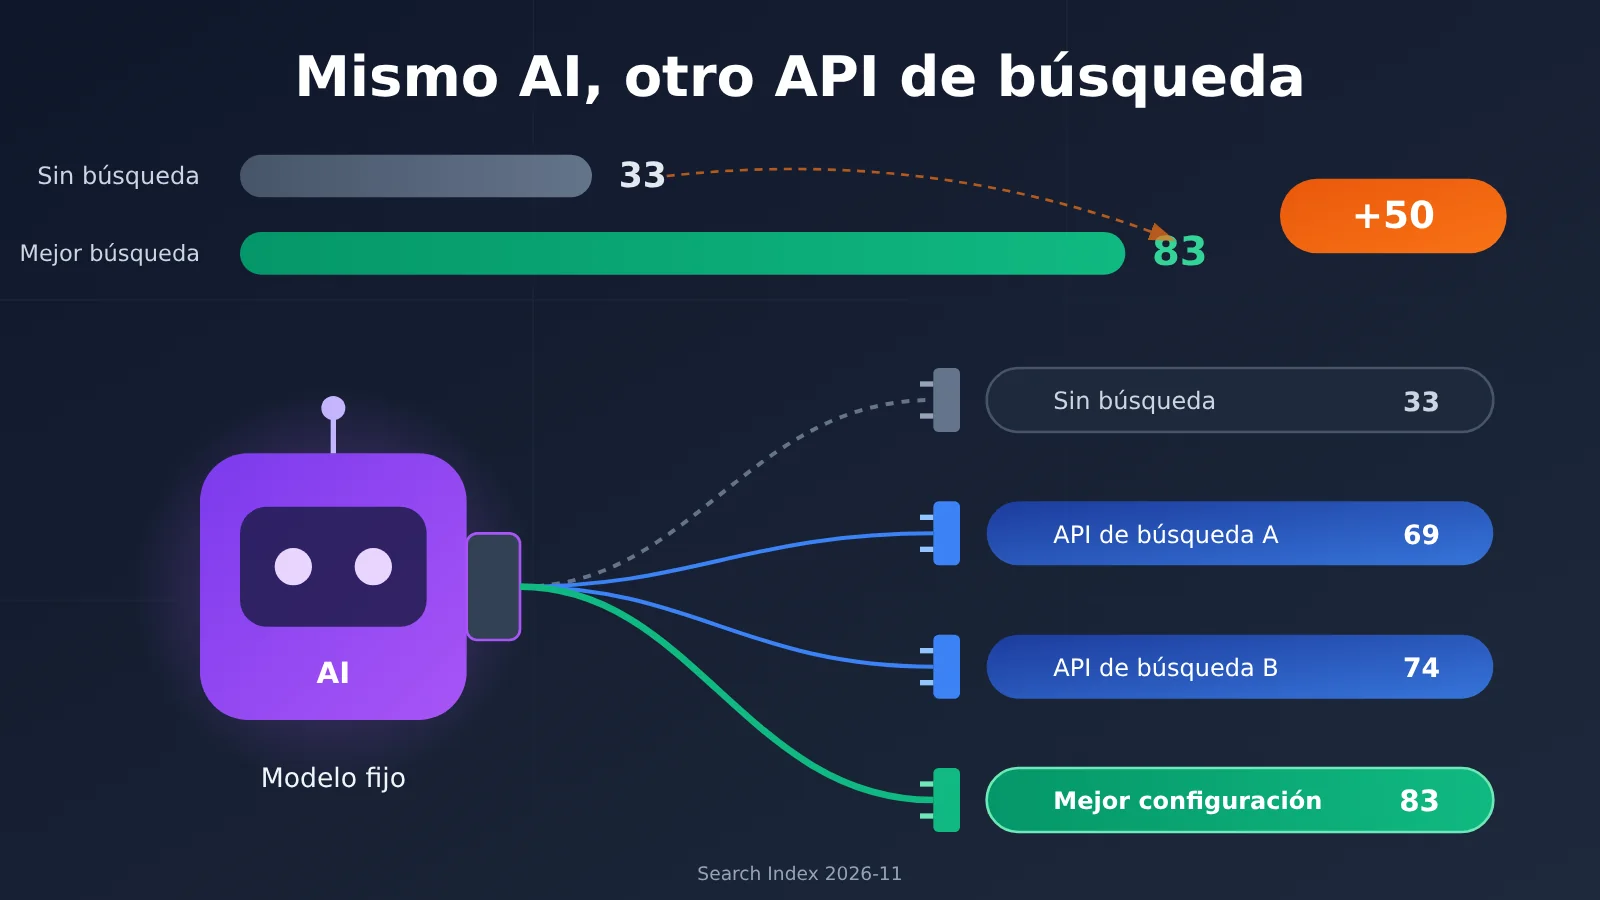
Muchas personas, al crear un agente, primero eligen el modelo y luego conectan de paso una herramienta de búsqueda. Para no pocos equipos, la búsqueda es solo un accesorio del que basta que «tenga conexión a internet». El Search Index que Artificial Analysis actualizó el 9 de noviembre de 2026 ofrece un resultado diferente: el mismo modelo, sin conectar búsqueda, obtiene 33 puntos; con la mejor configuración de API de búsqueda, puede llegar a 83 puntos.
No es otra lista más del tipo «cada cual tiene sus fortalezas». Este artículo desglosa cómo se calculan los 83 puntos y las condiciones de prueba, y compara en conjunto la calidad, el tiempo total de la tarea, el costo de búsqueda y el costo del modelo. Por último, explica por escenario en qué decisiones se puede usar esta clasificación y dónde no conviene aplicarla directamente.
Valor clave: después de leer este artículo, podrás usar clasificaciones públicas para filtrar candidatos de API de búsqueda y luego hacer una segunda comparación según tu propia tarea, evitando decidir solo por la puntuación más alta.
Los términos «to know» antes de entender el ranking de API de búsqueda
Resumen en una frase: Search Index compara el rendimiento del mismo modelo bajo distintas configuraciones de búsqueda, y la diferencia máxima llega a 50 puntos. Pero «más puntos» no significa «lo más adecuado para ti»: también hay que mirar el coste, el tiempo de ejecución y la cobertura de la evaluación.
Antes de leer el ranking, vamos a unificar estos términos:
- Search Index: puntuación global agregada según reglas a partir de un benchmark de recuperación determinado. En este artículo se refiere específicamente al índice de evaluación de API de búsqueda de Artificial Analysis, con un máximo de 100.
- F1: media armónica de precisión y exhaustividad (recall). Cuando la respuesta es «un conjunto de entidades», se usa para medir si responde con precisión y de forma completa.
- Harness: marco de pruebas que organiza la entrada del modelo, la ejecución de herramientas y la puntuación de tareas. El bucle de agente que usa Artificial Analysis se llama Stirrup.
- Search API: interfaz que, a partir de una consulta, devuelve resultados de recuperación como enlaces web, títulos y fragmentos relevantes; por ejemplo Exa, Brave o Perplexity Search API.
- Token: unidad de medida con la que el modelo procesa texto. Cuanto más extensos sean los resultados de búsqueda, más Tokens se envían al modelo y más caro resulta.
¿De verdad una API de búsqueda puede hacer que el mismo AI varíe 50 puntos?
Artificial Analysis lanzó su benchmark de API de búsqueda el 18 de agosto de 2026. Los últimos datos públicos se actualizaron el 9 de noviembre de 2026 y cubren 14 proveedores y 26 productos o configuraciones de Search API. No evalúa modelos, sino el efecto real de un servicio de búsqueda cuando se coloca dentro de un agente.
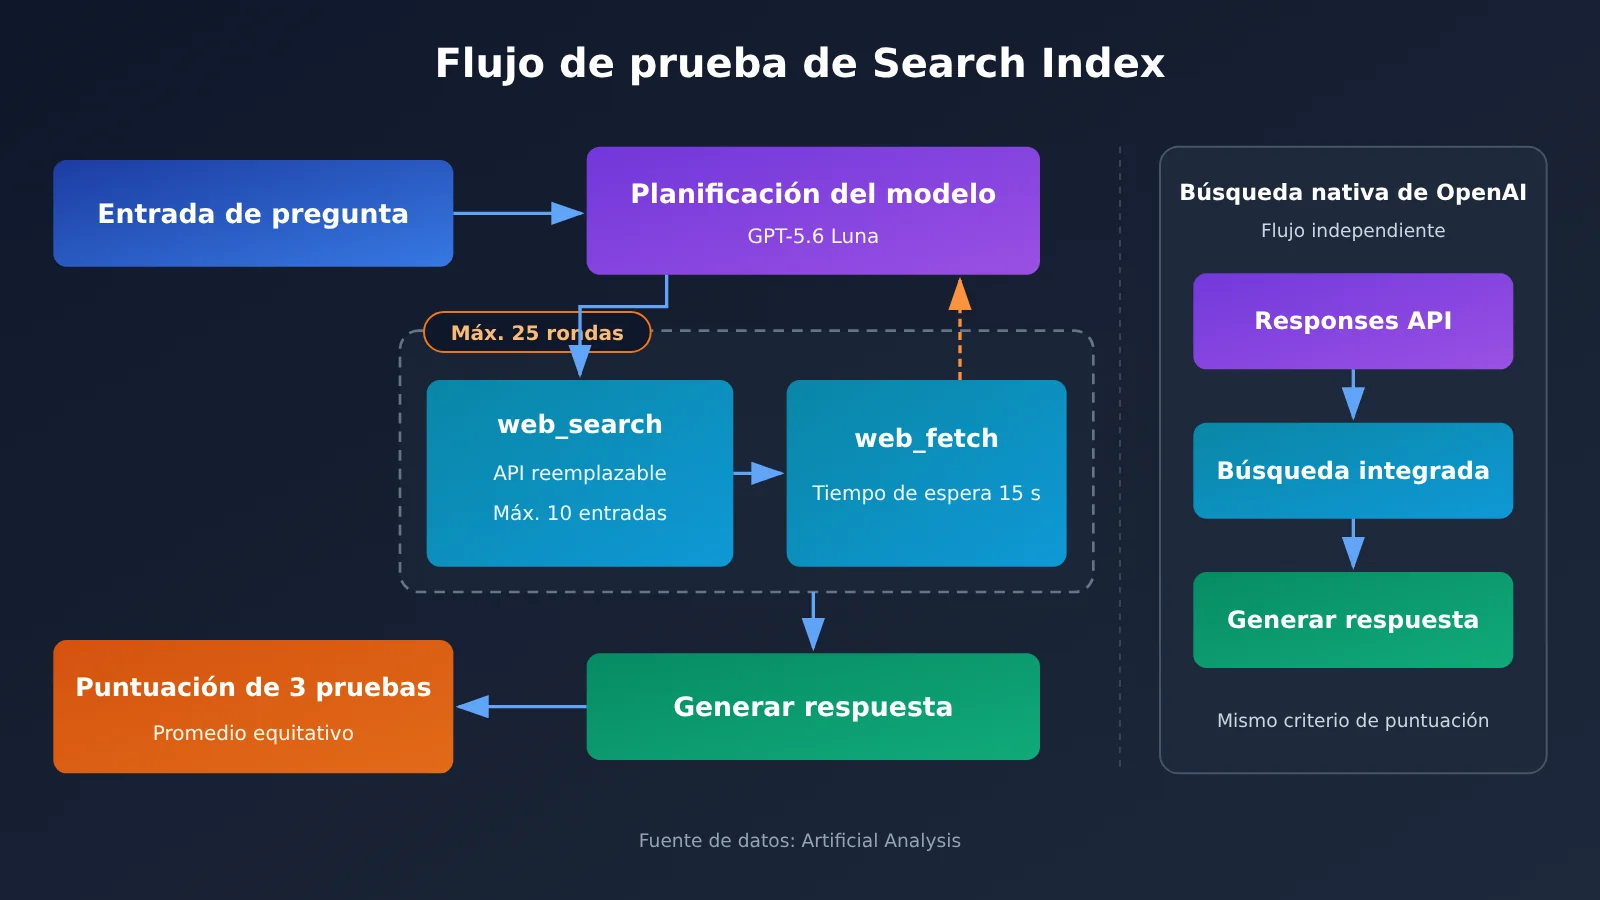
La clave del diseño experimental está en «controlar las variables». El modelo candidato para responder está fijado en GPT-5.6 Luna (medium), y el marco del agente también se mantiene igual: solo se cambia el servicio de búsqueda. En esas condiciones, la línea base sin herramientas de búsqueda obtiene solo 33 puntos, mientras que Keenable Pro, en primera posición, alcanza 83 puntos, 50 puntos de índice de diferencia. Incluso entre configuraciones que sí incorporan búsqueda, la diferencia de 69 puntos de DeepSeek Search Summary a los 83 de Keenable Pro sigue siendo de 14 puntos.
Hay una excepción que conviene explicar aparte: OpenAI Web Search nativo funciona de otra manera. Las demás Search API independientes se ejecutan dentro del bucle externo de agente de Artificial Analysis. OpenAI Web Search, en cambio, usa el flujo de herramientas integrado en Responses API, y es OpenAI quien decide el número de búsquedas y la forma de ejecución. Por eso sus 74 puntos sirven como referencia, pero no pueden considerarse un experimento de «cambiar la API» en condiciones idénticamente comparables.
También hay que tener claro que esos 50 puntos son el efecto de la mejora por búsqueda dentro de un mismo sistema de evaluación. No significan que cualquier persona, con cualquier modelo conectado a búsqueda, vaya a mejorar 50 puntos porcentuales.
¿Cómo se mide realmente la puntuación de 83 del Search Index?
Los tres benchmarks del Search Index y la forma de puntuar
La puntuación global es el promedio con igual peso de tres benchmarks, cada uno aportando un tercio:
| Benchmark | Volumen de tareas | Tipo de tarea | Métrica de evaluación |
|---|---|---|---|
| DeepSearchQA | 900 | Investigación factual compleja, con respuestas que suelen ser conjuntos | F1 del conjunto de respuestas |
| BrowseComp | 200 | Preguntas y respuestas web de dificultad alta | Precisión de la respuesta exacta |
| AA-Omniscience | 600 | Preguntas y respuestas factuales | Precisión en preguntas factuales |
En total suman 1.700 tareas, pero la puntuación global no se calcula juntando las 1.700 preguntas y midiendo el porcentaje de aciertos. Tomemos Keenable Pro como ejemplo: sus tres puntuaciones son 88, 87 y 73, cuya media da aproximadamente 82,67, y tras redondear se muestra como 83. Por eso, una puntuación de 83 no equivale a «un 83 % de respuestas correctas».
Las condiciones de prueba del Search Index
Las configuraciones clave que se hacen públicas en la metodología son estas:
| Elemento del experimento | Configuración real |
|---|---|
| Modelo candidato a responder / modelo evaluador | GPT-5.6 Luna (medium) |
| Máximo de turnos del agente | 25 turnos, sin límite de llamadas a herramientas dentro de cada turno |
| Herramientas disponibles | web_search, web_fetch (lectura independiente de páginas web) |
| Resultados por búsqueda | Como máximo 10 |
| Tiempo de espera al extraer el cuerpo de la página | 15 segundos por página |
| Contenido devuelto al modelo | Respuesta nativa del proveedor del servicio |
| Línea base sin búsqueda | El mismo modelo, sin usar herramientas de búsqueda |
De esta tabla se desprenden dos ideas. Primera: lo que se devuelve al modelo es la «respuesta nativa del proveedor». La longitud de los fragmentos, la forma de resumir y la organización de los destacados acaban entrando en el contexto del modelo, así que la puntuación no refleja solo la calidad del índice de páginas web subyacente, sino también cómo se organiza la información. Segunda: los errores fatales como 429, 5xx o timeouts se reintentan de forma continua hasta que la petición tenga éxito, y esos errores no cuentan en el resultado final. Esto significa que la clasificación mide la calidad «cuando todo funciona», y no sirve para demostrar la disponibilidad ni la tasa de fallos de cada proveedor en un entorno de producción.
Clasificación más reciente del Search Index: ¿qué API de búsqueda da mejores resultados?
En la tabla siguiente, la puntuación de calidad y BrowseComp provienen de la clasificación del 2026-11-09. Los tiempos corresponden a los valores de la clasificación leídos el 2026-11-13 y se refieren al tiempo medio que tarda una tarea de prueba estándar de principio a fin, no a la latencia de red de una sola solicitud a la API de búsqueda.
| Configuración de búsqueda | Puntuación global (11-09) | BrowseComp | Tiempo medio por tarea (11-13) |
|---|---|---|---|
| Keenable Pro | 83 | 87% | 16.6 segundos |
| Keenable Realtime | 82 | 86% | 16.0 segundos |
| Exa Auto + Dynamic Highlights | 80 | 83% | 36.7 segundos |
| Perplexity Search Medium | 80 | 87% | 31.1 segundos |
| Exa Lite + Dynamic Highlights | 79 | 81% | 19.4 segundos |
| Parallel Advanced | 75 | 77% | No incluido en esta actualización de tiempos |
| Brave LLM Context | 75 | 77% | No incluido en esta actualización de tiempos |
| OpenAI Web Search Medium (flujo integrado de Responses) | 74 | 74% | 33.1 segundos |
| DeepSeek Search Summary | 69 | 63% | 22.4 segundos |
| Línea base sin búsqueda | 33 | 17% | — |
Tres diferencias típicas en la clasificación de las API de búsqueda
Misma puntuación, distinta velocidad. Exa Auto y Perplexity Medium obtienen ambos 80 puntos, pero el tiempo total por tarea es de 36.7 segundos y 31.1 segundos, respectivamente. Keenable Pro saca una puntuación más alta y, aun así, tarda solo alrededor de 16.6 segundos. Para un Agent que necesita responder en tiempo real, esta diferencia se nota directamente en la experiencia del usuario.
BrowseComp no siempre acompaña la puntuación global. El BrowseComp de Perplexity Medium llega al 87%, igual que el de Keenable Pro, pero su puntuación global es 3 puntos menor. La diferencia viene principalmente de las otras dos pruebas de referencia. Si tu negocio se parece más a la «búsqueda web de preguntas difíciles», puedes fijarte solo en la columna BrowseComp.
Los distintos modos de un mismo proveedor pueden diferir bastante. Entre Exa Lite y Exa Auto hay solo 1 punto de diferencia, pero el tiempo casi se duplica. Por eso conviene interpretar los resultados según el modo concreto del producto, y no fusionar Exa Lite y Exa Auto en una única «puntuación de Exa».
💡 Nota sobre los datos: las puntuaciones anteriores son resultados de la evaluación de terceros de Artificial Analysis, y los tiempos son tiempos de tareas estándar. Si quieres reproducir una comparación similar con tus propios casos de negocio, puedes usar APIYI apiyi.com para fijar un modelo de respuesta y luego conectar distintas herramientas de búsqueda para hacer pruebas A/B.
¿La API de búsqueda con la puntuación más alta es siempre la más rentable?
Artificial Analysis también publicó el costo estimado por cada 1,000 tareas de referencia, desglosado en costo de búsqueda y costo del modelo (ranking del 2026-11-09, en USD). La columna «costo por punto» la calculó de forma aproximada el editor de este artículo como «costo total ÷ puntuación compuesta»; sirve solo como referencia transversal y no es una métrica oficial.
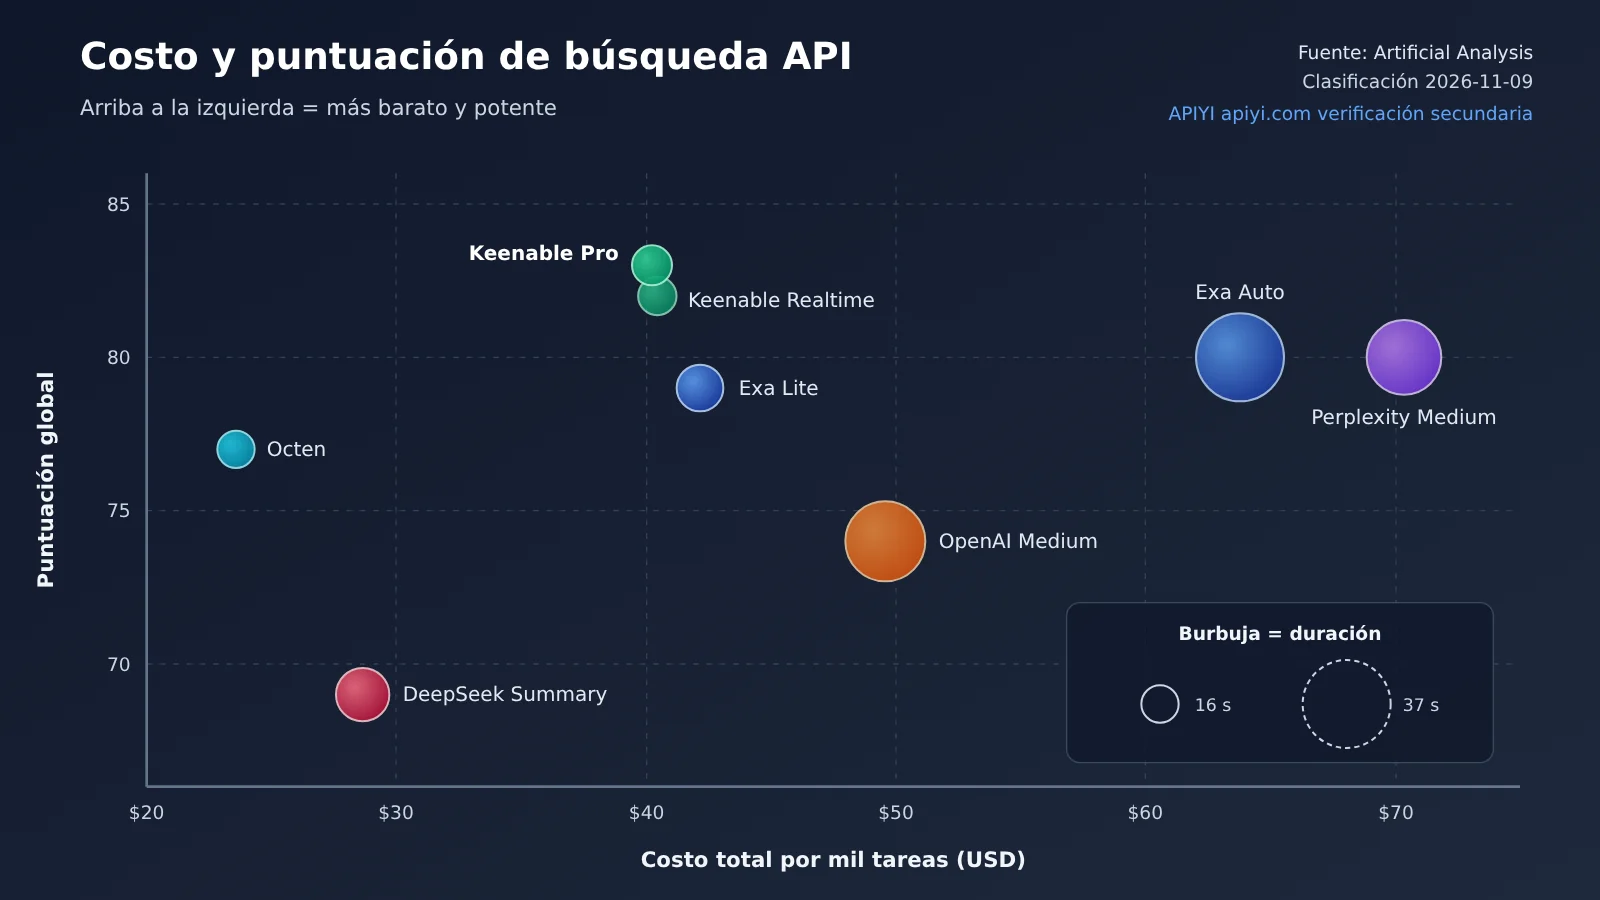
| Configuración de búsqueda | Puntuación de calidad | Costo de búsqueda + costo del modelo | Costo total/1,000 tareas | Costo por punto (derivado por el editor) | Duración de la tarea (11-13) |
|---|---|---|---|---|---|
| Keenable Pro | 83 | 31.87 + 8.35 | $40.22 | Aprox. $0.48 | 16.6 segundos |
| Keenable Realtime | 82 | 31.94 + 8.52 | $40.46 | Aprox. $0.49 | 16.0 segundos |
| Exa Auto + Highlights | 80 | 53.17 + 10.60 | $63.77 | Aprox. $0.80 | 36.7 segundos |
| Perplexity Medium | 80 | 62.30 + 8.04 | $70.34 | Aprox. $0.88 | 31.1 segundos |
| Exa Lite + Highlights | 79 | 31.20 + 10.95 | $42.15 | Aprox. $0.53 | 19.4 segundos |
| Octen Highlights | 77 | 9.07 + 14.50 | $23.57 | Aprox. $0.31 | 15.6 segundos |
| OpenAI Web Search Medium | 74 | 40.19 + 9.40 | $49.59 | Aprox. $0.67 | 33.1 segundos |
| DeepSeek Search Summary | 69 | 8.47 + 20.19 | $28.66 | Aprox. $0.42 | 22.4 segundos |
Tres conclusiones de la tabla de costos de las API de búsqueda
La puntuación más alta no siempre implica el costo más alto. Keenable Pro lidera con 83 puntos, alrededor de $40.22 por cada 1,000 tareas, lo que equivale a unos $0.04 por tarea, un nivel medio dentro de la muestra. Perplexity Medium obtiene 3 puntos menos, pero su costo total es aproximadamente 75% más alto.
Una diferencia de 1 punto puede suponer más del treinta por ciento en costos. Exa Lite + Highlights obtiene 79 puntos y $42.15 por cada 1,000 tareas; Exa Auto + Highlights obtiene 80 puntos y $63.77 por cada 1,000 tareas. El primero es alrededor de 34% más barato y también tarda menos. Según la página oficial de precios de Exa (datos hasta el 2026-11-13), el nivel Lite cuesta $4 por cada 1,000 solicitudes y el nivel Auto cuesta $7 por cada 1,000 solicitudes. La diferencia en los costos de búsqueda dentro de la tabla es coherente con esta estructura de precios.
Un costo de búsqueda bajo puede venir acompañado de un costo de modelo más alto. DeepSeek Search Summary tiene un costo de búsqueda de solo $8.47, pero su costo de modelo llega a $20.19, el más alto de la tabla. Octen tiene el costo total más bajo, pero su costo de modelo también supera al de Keenable, Exa y Perplexity. Si los resultados de búsqueda no son lo bastante útiles, el agente hará más rondas de búsqueda y leerá más páginas, con lo que el consumo de tokens aumentará. Por eso, al calcular costos conviene tomar como unidad el «costo total de completar una tarea», en lugar de mirar únicamente el precio por llamada de la API de búsqueda.
¿Qué decisiones reales puede orientar este ranking de Search Index?
Search Index es una evaluación general de recuperación de hechos, principalmente en inglés; no es un benchmark específico para la internet en chino. A continuación lo relacionamos con escenarios habituales de agentes y señalamos qué casos puedes tomar como referencia directa y cuáles requieren pruebas adicionales.
| Escenario de agente | Indicador más crítico | Valor de referencia del ranking | Candidatos recomendados |
|---|---|---|---|
| Preguntas y respuestas factuales | Precisión, tasa de citas correctas | Alta; se puede consultar directamente AA-Omniscience | Keenable, Exa Lite, Perplexity |
| Investigación compleja con múltiples fuentes | Recuperación multihop, recall de conjuntos | Alta; fijarse sobre todo en DeepSearchQA y BrowseComp | Keenable Pro, Exa Auto, Perplexity Medium |
| Agentes de baja latencia | Tiempo total de la tarea, latencia P95 | Media; el tiempo de tarea solo sirve como referencia | Keenable Realtime, Octen, Exa Lite |
| Recuperación de información en chino | Cobertura de fuentes en chino, accesibilidad de sitios dentro de China | Baja; hay que crear un conjunto de pruebas propio en chino | Añadir Baidu Qianfan, Bocha y Alibaba Cloud Bailian como comparación |
| Recuperación de documentación de programación | Cobertura de documentación oficial, información de versiones | De baja a media; hay que volver a probar con preguntas técnicas reales | Exa, Perplexity, Parallel |
Cómo usar Search Index para una segunda comparación de API de búsqueda
Lo más sensato es usar el ranking público como herramienta de cribado inicial y luego hacer una segunda ronda de comparación con tus propias tareas:
- Según calidad, tiempo y coste total, elige 3–4 configuraciones candidatas del ranking;
- Prepara entre 50 y 100 preguntas de tu propio negocio, que cubran hechos simples, noticias recientes, preguntas multihop, consultas en chino y entre idiomas;
- Fija el mismo modelo de respuesta, el mismo número máximo de rondas y de resultados, y cambia solo la herramienta de búsqueda;
- Registra la precisión, la tasa de citas correctas, el coste total por tarea, la latencia P50/P95, además del número de resultados vacíos y de timeouts;
- Para la estabilidad en producción, haz además una prueba de carga, porque el ranking ya excluye los errores fatales después de reintentos.
Recomendaciones para elegir la API de búsqueda e inicio rápido
🎯 Cómo elegir: si buscas calidad y velocidad en conjunto, empieza probando Keenable Pro/Realtime; si te importa el costo y quieres una calidad cercana a 80 puntos, Exa Lite + Highlights y Octen merecen una prueba seria; y los equipos que ya están metidos de lleno en el ecosistema OpenAI pueden usar directamente el Web Search integrado, pero deben aceptar que su flujo de ejecución no es controlable. A la hora de implementarlo, recomendamos unificar la invocación del modelo de respuesta a través de APIYI apiyi.com y convertir la herramienta de búsqueda en un módulo plug-and-play: así, cuando cambies de API de búsqueda, no tendrás que tocar el código del lado del modelo.
Ejemplo mínimo: el lado del modelo usa una interfaz unificada
El siguiente código fija el modelo de respuesta y declara la herramienta de búsqueda como función; qué Search API concreta la implementa se reemplaza en el código local:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI, el modelo se puede cambiar
)

tools = [{"type": "function", "function": {
    "name": "web_search",
    "description": "Busca en internet y devuelve hasta 10 resultados",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # cambia al modelo que quieres evaluar
    messages=[{"role": "user", "content": "Exa 3.0 是哪天发布的?"}],
    tools=tools,
)
print(resp.choices[0].message)
Ver el código completo: comparar varias APIs de búsqueda en A/B con el mismo modelo
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MODEL = "gpt-4o-mini"   # modelo de respuesta fijo para mantener la variable de control
MAX_TURNS = 25          # mismo límite de turnos que en Search Index

# funciones de adaptación para cada API de búsqueda, implementadas según la documentación oficial
def search_provider_a(query: str) -> list:
    return []  # devuelve [{"title":..., "url":..., "snippet":...}]

def search_provider_b(query: str) -> list:
    return []

TOOLS = [{"type": "function", "function": {
    "name": "web_search",
    "description": "Busca en internet y devuelve hasta 10 resultados",
    "parameters": {"type": "object",
                   "properties": {"query": {"type": "string"}},
                   "required": ["query"]}}}]

def run_task(question: str, search_fn) -> dict:
    messages = [{"role": "user", "content": question}]
    start, searches = time.time(), 0
    for _ in range(MAX_TURNS):
        resp = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        if not msg.tool_calls:
            return {"answer": msg.content, "searches": searches,
                    "seconds": round(time.time() - start, 1)}
        messages.append(msg)
        for call in msg.tool_calls:
            query = json.loads(call.function.arguments)["query"]
            results = search_fn(query)[:10]
            searches += 1
            messages.append({"role": "tool", "tool_call_id": call.id,
                             "content": json.dumps(results, ensure_ascii=False)})
    return {"answer": None, "searches": searches,
            "seconds": round(time.time() - start, 1)}

for name, fn in [("A", search_provider_a), ("B", search_provider_b)]:
    print(name, run_task("Perplexity 何时推出独立 Search API?", fn))
🚀 Inicio rápido: los usuarios nuevos pueden reclamar crédito de prueba gratuito en APIYI apiyi.com, ejecutar primero el script A/B de arriba con unos cuantos casos reales de tu negocio y luego decidir qué API de búsqueda incorporar al plan formal.
Preguntas frecuentes (FAQ)
P1: ¿Qué es Search Index?
Search Index es un índice de evaluación para API de búsqueda presentado por Artificial Analysis. Mantiene fijos el modelo de respuesta y el framework de Agent, y solo cambia el servicio de búsqueda. Mide el rendimiento de búsqueda con el promedio de igual peso de tres benchmarks: DeepSearchQA, BrowseComp y AA-Omniscience, sobre una puntuación máxima de 100.
P2: ¿Una puntuación de 83 significa que la tasa de respuestas correctas es del 83 %?
No. 83 es el promedio de las puntuaciones de los tres benchmarks, y las métricas de los tres tampoco son iguales: DeepSearchQA usa F1, mientras que los otros dos usan precisión. En Keenable Pro, los tres valores son 88, 87 y 73, respectivamente; el promedio es aproximadamente 82.67, que se muestra como 83.
P3: ¿A qué fecha corresponden los datos del ranking?
Las puntuaciones de calidad y los datos de costes provienen de la actualización del ranking del 2026-11-09; los tiempos de finalización de las tareas completas utilizan los valores leídos el 2026-11-13. El ranking se actualiza continuamente, por lo que al citarlo conviene indicar la fecha.
P4: ¿Se puede usar el tiempo indicado en el ranking como la velocidad de respuesta de una API de búsqueda?
No. El tiempo mostrado en la tabla es el tiempo total de finalización de una tarea estándar e incluye varias rondas de búsqueda, lectura de páginas web e inferencia del modelo. La latencia de una única solicitud HTTP debe medirse por separado, y es recomendable registrar tanto P50 como P95.
P5: ¿Cómo comparar rápidamente el rendimiento de distintas API de búsqueda en mi producto?
Mantén fijo un modelo de respuesta y sustituye solo la herramienta de búsqueda. Puedes llamar al modelo mediante APIYI (apiyi.com) usando una interfaz compatible con OpenAI; configura `base_url` como `https://api.apiyi.com/v1` y aplica el script A/B de este artículo. Si también quieres ver cómo cambia el rendimiento de búsqueda al cambiar de modelo, con la misma clave puedes alternar entre OpenAI, Claude, Gemini y otros modelos.
P6: ¿Qué limitaciones tiene Search Index?
Principalmente hay cuatro: no es un benchmark específico para Internet en chino; el flujo de ejecución de la búsqueda nativa de OpenAI difiere del de otras configuraciones; los errores como 429, 5xx y timeouts no se contabilizan en los resultados después de los reintentos, por lo que no reflejan la estabilidad en producción; los costes se estiman a partir de las tareas de evaluación y pueden no coincidir con tu factura real. Para la búsqueda de noticias en chino y documentación técnica de productos chinos, se recomienda crear otro conjunto de pruebas y validarlo junto con modelos chinos a través de APIYI (apiyi.com).
Search Index: Puntos clave para elegir la API de búsqueda
- La búsqueda es una variable independiente: con el mismo modelo se pasa de 33 a 83 puntos; la elección de la API de búsqueda influye directamente en la calidad del agente.
- 83 puntos no es la tasa de acierto: es el promedio equitativo de tres benchmarks, y cada uno usa una forma de puntuar distinta.
- El tiempo se mide sobre la tarea completa: Keenable ronda los 16 s y Exa Auto los 37 s; ninguno de los dos es la latencia de una sola llamada a la API.
- El costo hay que desglosarlo: una tarifa de búsqueda baja puede venir con un costo de modelo alto; conviene comparar el costo total por tarea.
- 1 punto puede suponer un 34 %: Exa Lite y Auto solo difieren en 1 punto, y el primero es cerca de un tercio más barato.
- El ranking solo sirve como filtro inicial: en escenarios como chino o documentación de programación, hace falta una segunda comparación A/B con tus propias tareas.
Resumen
Lo más valioso de este ranking de Search Index es que, con el diseño de «mismo modelo, distintas herramientas de búsqueda», aísla y mide por separado el impacto de la calidad de búsqueda en el agente:
- Calidad: sin búsqueda, 33 puntos; como máximo, 83. Incluso conectando búsqueda en todas las configuraciones, entre una y otra hay unos 14 puntos de diferencia;
- Velocidad: con los mismos 80 puntos, el tiempo de la tarea completa puede variar más de 5 segundos; las configuraciones de puntuación alta también pueden ser rápidas;
- Costo: Keenable Pro tiene la calidad más alta y un costo intermedio; Exa Lite y Octen destacan en eficiencia de costo; el ejemplo de DeepSeek Summary muestra que una tarifa de búsqueda baja no equivale a un costo total bajo.
Se recomienda usar primero el ranking para elegir 3–4 candidatos y luego hacer una prueba A/B con el modelo fijo sobre tu propio conjunto de preguntas. Recomendamos llamar de forma unificada al modelo de respuesta a través de APIYI apiyi.com, convertir la herramienta de búsqueda en un módulo reemplazable y decidir la solución final con los tres datos: calidad, velocidad y costo.
Referencias
- Ranking de Artificial Analysis Search API: datos de puntuación de calidad, coste y tiempo
- Enlace:
artificialanalysis.ai/agents/search-api -
Nota: principal fuente de las puntuaciones, costes y tiempos de este artículo
-
Metodología de evaluación de Artificial Analysis Search API: configuración de las pruebas y reglas de puntuación
- Enlace:
artificialanalysis.ai/methodology/search-api -
Nota: incluye explicaciones sobre modelos, rondas, número de resultados, reglas de reintento, etc.
-
Precios de Exa: tarifas de los niveles Lite, Auto, etc.
- Enlace:
exa.ai/pricing -
Nota: sirve para entender las diferencias de coste de búsqueda entre los distintos modos de Exa en el ranking
-
Anuncio de Exa 3.0: modo Lite y Dynamic Highlights
- Enlace:
exa.ai/blog/exa-3 -
Nota: publicado el 2026-10-19, incluye datos de autoevaluación del proveedor
-
Documentación de OpenAI Web Search: herramienta de búsqueda integrada en la Responses API
- Enlace:
developers.openai.com/api/docs/guides/tools-web-search -
Nota: para entender cómo se ejecuta la búsqueda nativa de OpenAI y sus parámetros
-
Precios de Perplexity Search API: niveles estándar y Fast
- Enlace:
docs.perplexity.ai/docs/getting-started/pricing - Nota: para entender las reglas de facturación por solicitud
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio web de APIYI; para más material de integración, visita el centro de documentación docs.apiyi.com