Nota del autor: Google lanzó Gemini 4 Hydrogen el 12 de noviembre de 2026. Este artículo repasa la tabla comparativa de 10 puntos de la model card oficial, las mejoras frente a Gemini 3.8 Flash, las especificaciones y el precio del nivel estándar, e indica punto por punto el criterio de cada cifra.
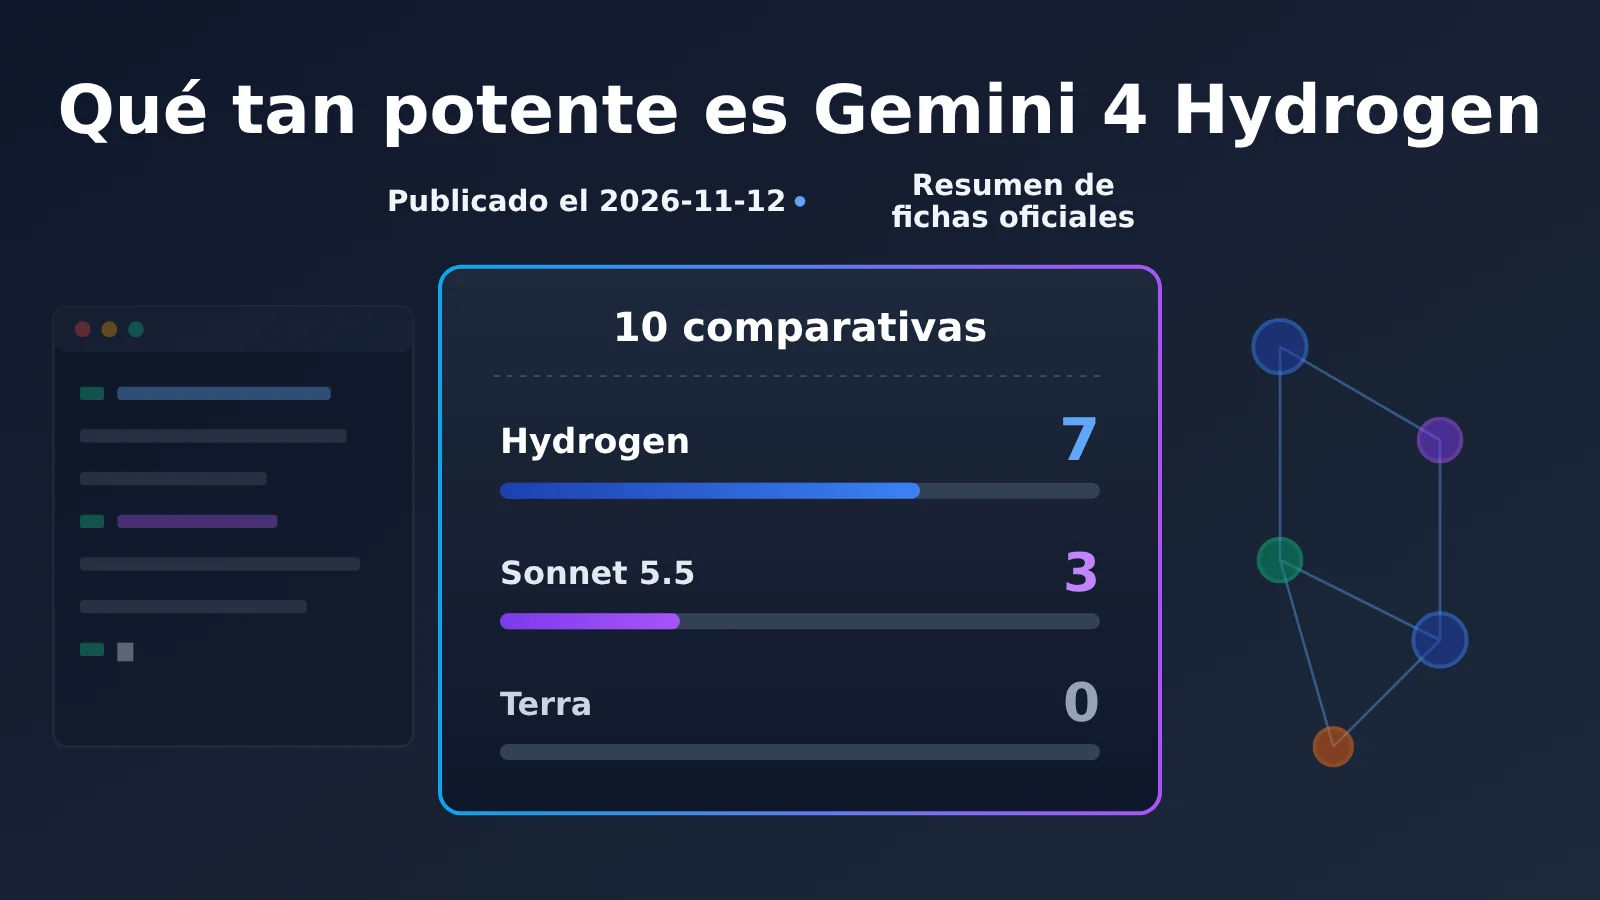
Google lanzó oficialmente Gemini 4 Hydrogen el 12 de noviembre de 2026, con el ID de modelo gemini-4-hydrogen. Su posicionamiento es codificación diaria más rápida y ejecución de todo tipo de agentes, no modelos como Carbon o Argon que se encargan del razonamiento de largo horizonte más difícil. El precio oficial global del nivel estándar es de $1.50 de entrada y $7.50 de salida (por millón de tokens). En la tabla comparativa de 10 puntos de la model card de DeepMind, obtuvo la puntuación más alta en 7 de ellos.
Esto no es un rumor de nombre en clave previo al lanzamiento. El blog de Google, el boletín para desarrolladores y la model card de DeepMind ya están en línea, y el enlace de prueba de AI Studio usa precisamente el ID gemini-4-hydrogen. Cabe aclarar que todas las puntuaciones citadas en este artículo provienen de datos autoinformados oficiales o de la recopilación de la model card oficial, no de resultados de re-pruebas de APIYI.
Valor central: después de leer este artículo, sabrás en qué tareas Gemini 4 Hydrogen lidera y en cuáles va por detrás de Claude Sonnet 5.5, y también sabrás cómo interpretar estas cifras.
Gemini 4 Hydrogen: información clave de un vistazo
Primero, los datos básicos. La información de la siguiente tabla proviene del blog de Google, del boletín para desarrolladores y de la ficha técnica del modelo de DeepMind (publicada en noviembre de 2026); la fecha de verificación es 2026-11-13.
| Dato | Detalle de Gemini 4 Hydrogen |
|---|---|
| Lanzamiento | 2026-11-12; despliegue global desde ese mismo día |
| Responsable | Google / Google DeepMind |
| ID del modelo | gemini-4-hydrogen |
| Origen | La ficha del modelo indica «adaptado de Gemini 4 Carbon», es decir, que se deriva de Carbon |
| Posicionamiento oficial | Codificación cotidiana y ejecución de agentes; puede usarse por sí solo o como motor de ejecución dentro de flujos multimodelo |
| Niveles de pensamiento | Cuatro niveles: low, medium, high (predeterminado) y xhigh |
| Corte de conocimiento | Marzo de 2026; en algunos campos puede ser más antiguo |
| Canales oficiales | Todos los niveles de AI Studio, Gemini API, Android Studio, Gemini for business, Gemini App, Google Search |
Google describe con bastante claridad la división de funciones dentro de la familia Gemini 4: Carbon y Argon se encargan del razonamiento de largo alcance más difícil, mientras que Hydrogen se ocupa de las tareas cotidianas más rápidas. Por eso, no tiene sentido comparar Hydrogen y Carbon como si fueran «versiones nueva y vieja del mismo modelo». Su relación con Carbon se parece más a dos funciones distintas sobre una misma base.
En cuanto a los canales de uso, los usuarios de pago de Google AI Pro / Ultra también pueden usar Hydrogen en Google Antigravity. Sheets se abrirá primero a Pro / Ultra y a las suscripciones empresariales elegibles. AI Studio confirma oficialmente que está disponible en todos los niveles; esta vez no se verificaron los límites concretos del nivel gratuito, así que no entraremos en ese detalle aquí.
Los cuatro niveles de pensamiento de Gemini 4 Hydrogen
Los cuatro niveles de pensamiento son un punto central en el uso de Hydrogen. Según la versión oficial, la calidad, la latencia y el costo aumentan de forma gradual entre niveles, y los desarrolladores pueden pagar solo por la profundidad de razonamiento que necesiten. El nivel predeterminado es high, y esto afecta directamente la factura; lo retomaremos en la sección de precios más adelante.
Tabla comparativa oficial de 10 métricas de Gemini 4 Hydrogen
Esta es la parte más importante del artículo. La model card de DeepMind presenta una tabla comparativa de 10 benchmarks, en la que participan Gemini 4 Hydrogen, Claude Sonnet 5.5 y GPT-6.1 Terra.
| Benchmark | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra | Mejor |
|---|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% | Hydrogen |
| Terminal-Bench 4.1 (ajustado por trampas) | 57.0% | 63.9% | Sin datos | Sonnet |
| Agents’ Last Exam v1.1 | 71.6% | 60.4% | 69.8% | Hydrogen |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% | Hydrogen |
| Vending-Bench 2 (saldo de cuenta, USD) | 14549 | 11165 | 9107 | Hydrogen |
| OSWorld-2.1 (subconjunto offline) | 77.6% | 83.9% | 74.2% | Sonnet |
| MKA (precisión de Climb WSR) | 53.4% | 52.0% | 43.8% | Hydrogen |
| Chartography | 66.6% | 61.6% | 63.2% | Hydrogen |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% | Sonnet |
| HLE-Diamond | 58.8% | 53.3% | 47.3% | Hydrogen |
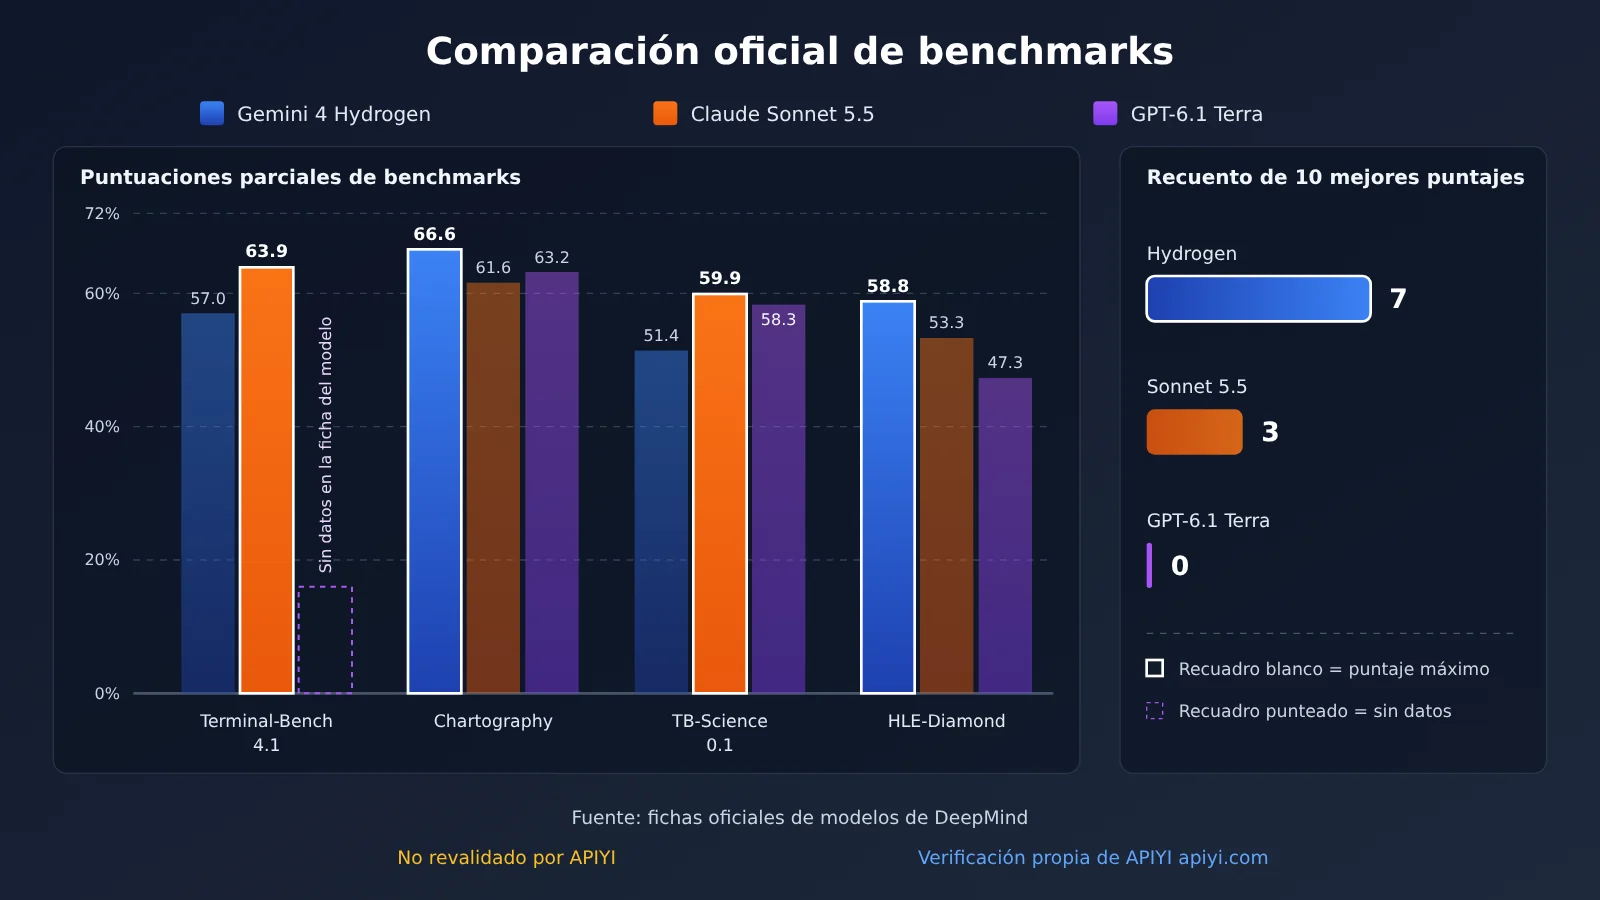
El recuento da: Hydrogen lidera en 7 métricas, Sonnet 5.5 lidera en 3, que son Terminal-Bench 4.1, la operación de computadora OSWorld-2.1 y Terminal-Bench-Science. GPT-6.1 Terra no alcanza el primer puesto en ninguna de las celdas con puntuación.
Aquí hay dos puntos que merecen especial atención. Primero, la columna de Terra en Terminal-Bench 4.1 está vacía, la model card no da ninguna cifra, así que no se puede interpretar como «Terra tiene peor capacidad de terminal». Segundo, «ganar 7 de 10» no equivale a superar en todo; Hydrogen sigue por detrás de Sonnet 5.5 en terminal y operación de computadora, las dos categorías de tareas muy relacionadas con la ejecución de agentes.
Cómo leer esta tabla comparativa de Gemini 4 Hydrogen
La nota metodológica de la model card determina hasta qué punto se puede leer esta tabla. Salvo indicación contraria, las puntuaciones de Hydrogen corresponden al nivel de pensamiento más alto, pass@1, intento único, ejecutado a través de la API de Gemini. Sonnet 5.5 y GPT-6.1 Terra usan por defecto su nivel máximo de pensamiento o razonamiento publicado; cuando no hay resultados públicos se usa el mejor resultado disponible.
En otras palabras, no se trata de una repetición de los tres modelos el mismo día con el mismo conjunto de scripts. El apartado SWE-sweep lo deja especialmente claro: las puntuaciones de los rivales vienen de leaderboards públicos, no de un recuento de Google con el mismo scaffolding. Por eso esta tabla sirve para juzgar la dirección general de fortaleza, pero no para tomar cada diferencia de un punto porcentual como conclusión precisa.
Además, en la tabla Hydrogen aparece con la puntuación del nivel de pensamiento más alto, mientras que su nivel predeterminado es high. Si usas el nivel predeterminado en producción, puede haber diferencia entre el rendimiento real y las cifras de la tabla; vale la pena verificarlo en tus propias tareas.
Mejoras de Gemini 4 Hydrogen frente a Gemini 3.8 Flash
Para los desarrolladores que ya usan Gemini 3.8 Flash, esta sección puede resultar más útil como referencia que la comparación entre modelos. Todas las cifras siguientes son datos reportados por el fabricante.
| Dimensión | Gemini 3.8 Flash | Gemini 4 Hydrogen | Notas |
|---|---|---|---|
| Velocidad de finalización de tareas (high predeterminado) | Referencia | 2,5 veces más rápida | Datos oficiales del fabricante |
| Terminal-Bench 4.1 | 18,2% | 57% | Más del triple |
| Afirmaciones inventadas | Referencia | Reducción de más de 5 veces | Datos oficiales del fabricante |
| Cuando falla una herramienta / la búsqueda no arroja resultados | — | Reorientación más proactiva | Descripción cualitativa oficial |
| Velocidad en las primeras pruebas con socios | Referencia | 2 a 2,8 veces más rápida | Gráficos, SQL y flujos intensivos en datos |
| Uso de tokens en las primeras pruebas con socios | Referencia | Entre 12% y 23% menos | Cifras oficiales citadas de socios; no de un ranking público |
El salto de las tareas de terminal, de 18,2% a 57%, es el cambio más evidente de este lanzamiento. Indica que Hydrogen ha superado un umbral de utilidad en la cuestión de si un modelo pequeño puede ejecutar de verdad tareas de línea de comandos. Dicho esto, si volvemos a la tabla comparativa, ese 57% sigue por debajo del 63,9% de Sonnet 5.5.
Los datos de las primeras pruebas con socios también conviene interpretarlos por separado. Son resultados de socios citados oficialmente, no un ranking público; se centran en gráficos complejos, SQL y flujos intensivos en datos, así que no necesariamente se pueden extrapolar a todos los casos de uso empresariales.
Otras métricas reportadas oficialmente para Gemini 4 Hydrogen
Además de la tabla de 10 métricas, el blog y la tarjeta del modelo enumeran otras cifras, que también son datos aportados por el fabricante:
- Artificial Analysis Intelligence Index: en el nivel high predeterminado es 51, en Argon es 50, y en xhigh llega a 54. Son cifras de AA citadas por Google. Carbon publicó en su momento un 59 en AA Index v5, pero el anuncio no aclara si Hydrogen usa la misma versión del índice, así que no conviene restarlas directamente para compararlas.
- Agent Arena: 5.º puesto en tareas abiertas de agentes.
- Vals Tax Agent Bench: 52,3%; según el fabricante, 1.er puesto en la clasificación general.
- Vals Legal Research Bench: 55,8%; según el fabricante, empató en el 1.er puesto.
- HLE-Diamond: 58,8%; el fabricante afirma que lidera su categoría.
El papel de Gemini 4 Hydrogen en flujos con múltiples modelos
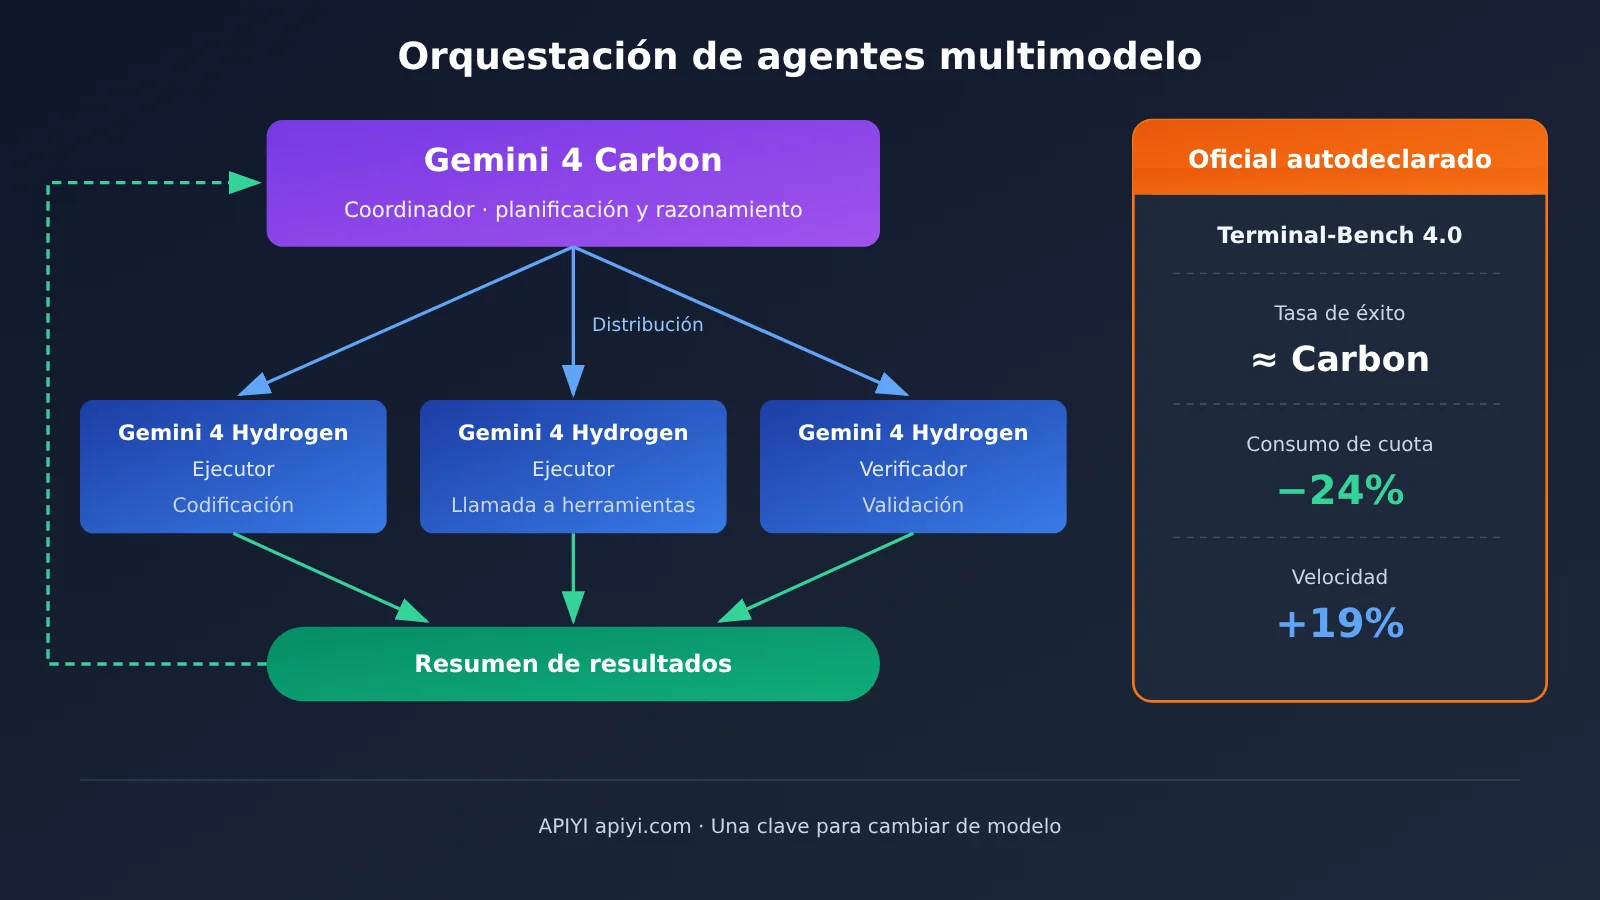
El fabricante también proporcionó datos sobre un uso combinado. En Antigravity Orchestrator, el sistema alterna entre Carbon y Hydrogen; en Terminal-Bench 4.0, la tasa de éxito de las tareas se acerca a la de Carbon en solitario, con un 24% menos de cuota en promedio y un 19% más de velocidad. En el modo paralelo, Carbon actúa como coordinador, mientras que Hydrogen asume el papel de worker o verifier.
Estos datos ilustran bastante bien la intención de Google con Hydrogen: no se trata de sustituir a Carbon, sino de asumir una gran parte de la ejecución concreta y dejar el razonamiento costoso para los pasos que de verdad lo necesitan.
Especificaciones y precios de Gemini 4 Hydrogen
Ventana de contexto: dos versiones entre la model card y el blog
En lo que se refiere a la ventana, las afirmaciones de la model card y del blog no coinciden del todo, así que aquí van las dos versiones una al lado de la otra:
- Model card: ventana de contexto de tokens de entrada-salida combinada de hasta 1M, es decir, entrada y salida combinadas suman como máximo 1 millón de tokens; las llamadas sincrónicas generan por defecto como máximo 64.000 tokens de salida; el long decode en segundo plano puede generar hasta 1 millón de tokens de salida.
- Blog: entrada nativa de 1 millón de tokens, y hasta 1 millón de tokens de salida.
A la hora de desarrollar, conviene presupuestar con el criterio más conservador de «ventana total» que indica la model card, y al mismo tiempo tener en cuenta el límite predeterminado de 64.000 tokens de salida para llamadas sincrónicas. Las salidas muy largas tienen que pasar por el long decode en segundo plano. En cuanto a las modalidades de entrada, Hydrogen admite texto, imágenes, audio y video.
Precios oficiales de la tarifa estándar de Gemini 4 Hydrogen
El blog afirma que todo el precio es una tarifa plana por la ventana completa de 1 millón de tokens. La siguiente tabla procede de la página de precios de Google Cloud (consultada el 2026-11-13); solo se lista la tarifa estándar, en dólares estadounidenses por cada millón de tokens.
| Concepto de facturación | Tarifa estándar global | No global |
|---|---|---|
| Entrada (texto, imagen, video, audio) | $1.50 | $1.65 |
| Lectura de caché | $0.075 | $0.0825 |
| Salida (respuesta más razonamiento) | $7.50 | $8.25 |
| Escritura de caché | Precio de lista $1.875, facturado solo a partir del 2027-01-12 | — |
Hay un detalle fácil de pasar por alto: el precio de salida se calcula sumando respuesta y razonamiento. El nivel de pensamiento predeterminado de Hydrogen es high, así que la factura de salida incluye los tokens de pensamiento. La model card también advierte que los niveles de pensamiento más altos pueden consumir más tokens. Para tareas sencillas, vale la pena considerar bajar a los niveles low o medium para controlar el costo.
Dónde invocar Gemini 4 Hydrogen hoy
En cuanto a los canales oficiales, Google AI Studio y Gemini API ya estaban disponibles ese día. En APIYI, el 2026-11-13 revisamos la tabla general de documentación de docs.apiyi.com/models, la página del modelo y la API de precios en api.apiyi.com/api/pricing; no encontramos gemini-4-hydrogen: la página del modelo devolvía 404 y, al buscar “hydrogen” entre los 282 modelos de ese día en la API de precios, tampoco había resultados. Aún no está listado; lo añadiremos lo antes posible. Los modelos y precios se rigen por la lista de modelos de la plataforma.
Antes de que Hydrogen esté disponible, APIYI apiyi.com ya permite invocar a los dos competidores de la tabla de 10 elementos, así como a Carbon, el “modelo madre” de Hydrogen; conviene preparar primero el flujo de comparación:
| ID del modelo | Entrada | Salida | Lectura de caché | Endpoint | Plataforma disponible |
|---|---|---|---|---|---|
gemini-4-carbon |
$2 | $10 | $0.1 | chat, gemini | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | chat, messages | APIYI |
gpt-6.1-terra |
$1 | $5 | $0.05 | responses (preferido), chat | APIYI |
Una aclaración sobre el precio de Carbon: la documentación de APIYI indica que $2 / $10 es el precio promocional por tiempo limitado de Google, válido hasta 2026-11-30; a partir de 2026-12-01 se ajustará al precio oficial de $4 / $20, con lectura de caché a $0.10.
La integración se hace mediante la interfaz compatible con OpenAI: configura base_url como https://api.apiyi.com/v1 y coloca gemini-4-carbon, claude-sonnet-5-5 o gpt-6.1-terra en el campo del modelo. Cuando Hydrogen esté disponible, solo tendrás que cambiar el campo del modelo por gemini-4-hydrogen para reproducir, con el mismo código, los tipos de tarea incluidos en la tabla de 10 elementos anterior.
🎯 Recomendación técnica: las puntuaciones de los rivales en la ficha oficial del modelo provienen de resultados públicos de cada proveedor y puede que no coincidan con tu escenario de negocio. Te sugerimos comparar primero Sonnet 5.5 y Terra con el mismo lote de tareas reales a través de APIYI apiyi.com; cuando Hydrogen esté disponible, añade una columna más para obtener tu propia tabla de victorias y derrotas.
Análisis de impacto de Gemini 4 Hydrogen
Impacto para los desarrolladores
- La capa de ejecución de agentes suma una opción más: en tareas de agentes como AutomationBench-AA, Agents’ Last Exam y Vending-Bench 2, los resultados oficiales de Hydrogen van por delante, por lo que es adecuado para asumir una gran parte de los pasos de ejecución en un flujo de trabajo.
- Las operaciones de terminal y de computadora aún requieren evaluación: en Terminal-Bench 4.1 y OSWorld-2.1, Sonnet 5.5 lidera. Si tu caso de uso principal es un agente de línea de comandos o la automatización de escritorio, no basta con fijarse en que “gana en 7 pruebas”.
- Vale la pena que los usuarios de 3.8 Flash evalúen migrar: la velocidad, la tasa de éxito en terminal y la tasa de invención muestran mejoras claras según datos autodeclarados por la empresa, pero conviene confirmarlo con tus propios datos.
- El costo depende del nivel de pensamiento: el nivel high predeterminado incluye los tokens de pensamiento en la salida, y la elección de nivel determina directamente la factura.
Impacto en el reparto de roles entre modelos
El lanzamiento de Hydrogen refuerza aún más el uso por capas de “coordinador + ejecutor”. Los datos oficiales de Orchestrator muestran que usar modelos baratos para ejecutar y modelos caros para planificar permite ahorrar cuota con una tasa de éxito parecida. Esto significa que la orquestación multimodelo está pasando de ser una práctica experimental a una práctica recomendada oficialmente por los proveedores, y una capa de integración capaz de alternar entre modelos de varios proveedores de forma unificada será cada vez más importante.
Limitaciones conocidas de Gemini 4 Hydrogen
Sin esquivar los puntos débiles, las limitaciones que recoge la ficha del modelo incluyen:
- Sigue produciendo alucinaciones; puede volverse más lento o agotar el tiempo de espera; los niveles de pensamiento más altos pueden consumir más tokens; el corte de conocimiento es marzo de 2026.
- La evaluación automática de seguridad empeora en dos aspectos frente a 3.8 Flash: el tono de rechazo baja 0,65 puntos porcentuales; la proporción de rechazos cuando no debería rechazar sube 5,57 puntos porcentuales (cuanto más bajo, mejor).
- En seguridad de frontera, no hay un salto material de capacidades respecto a Argon; ni CBRN ni ciberseguridad alcanzan el CCL, pero ya han alcanzado el umbral de alerta. Esto no equivale a “no hay riesgos relacionados”. La empresa afirma que publicará el informe de seguridad completo más adelante.
También hay datos positivos: los comportamientos de agentes fuera de los límites se reducen hasta en un 81%, la evaluación interna de honestidad alcanza el 96,7%, la resistencia a la inyección indirecta de indicaciones de Gray Swan aumenta más de 2,3 veces, y la tasa de rechazos incorrectos en HealthBench Pro es inferior al 0,4%. Estos también son datos autodeclarados por la empresa.
Preguntas frecuentes (FAQ)
P1: ¿Qué modelo es Gemini 4 Hydrogen?
Es un miembro de la familia Gemini 4 que Google lanzó el 2026-11-12, con ID de modelo `gemini-4-hydrogen`. Deriva del Gemini 4 Carbon y está posicionado como un modelo más rápido para programación diaria y ejecución de agentes. El razonamiento de largo alcance más difícil queda a cargo de Carbon y Argon.
P2: ¿Quién es más fuerte, Gemini 4 Hydrogen o Claude Sonnet 5.5?
Según la tabla de 10 ítems de la ficha oficial del modelo, Hydrogen gana 7 ítems y Sonnet 5.5 gana 3; las ventajas de Sonnet se concentran en tareas de terminal, operación de computadora y terminal científico. Las puntuaciones del rival corresponden a los resultados de máximo nivel de pensamiento publicados por cada fabricante, no a una nueva ejecución con el mismo conjunto de scripts. Se recomienda usar APIYI apiyi.com para hacer pruebas comparativas con tus propias tareas.
P3: ¿El «gana 7 de 10 ítems» lo midió un tercero?
No. Es el resumen oficial de la ficha del modelo de DeepMind, donde Hydrogen usa el nivel de pensamiento más alto y pass@1 con un solo intento. Tampoco es un resultado de re-test por parte de APIYI, así que debe considerarse como datos autoinformados por el fabricante.
P4: ¿Para qué escenarios es adecuado Gemini 4 Hydrogen?
Los escenarios donde los resultados oficiales son mejores incluyen: flujos de trabajo de automatización de múltiples pasos (AutomationBench-AA), comprensión de gráficos (Chartography), agentes de conocimiento multimodal (MKA), y roles de worker o verifier dentro de flujos multi-modelo. Para agentes de línea de comandos y operación de escritorio, se recomienda evaluar Sonnet 5.5 en paralelo.
P5: ¿Se puede invocar Gemini 4 Hydrogen a través de APIYI ahora?
Hasta el 2026-11-13 aún no está listado; lo listaremos lo antes posible, y el modelo y precio se regirán por la lista de modelos de la plataforma. Actualmente se pueden invocar `gemini-4-carbon`, `claude-sonnet-5-5` y `gpt-6.1-terra` en APIYI apiyi.com, usando `https://api.apiyi.com/v1` como `base_url`, para montar primero el flujo de comparación.
P6: ¿Por qué la salida de Gemini 4 Hydrogen podría costar más de lo esperado?
El precio oficial de salida de $7.50 factura conjuntamente la respuesta y el razonamiento, y el nivel de pensamiento predeterminado es high, por lo que los tokens de pensamiento entran en la factura de salida. Para tareas simples se puede cambiar a los niveles low o medium para controlar el costo.
Puntos clave de Gemini 4 Hydrogen
- Posicionamiento claro: lanzado el 2026-11-12, enfocado en codificación diaria y ejecución de agentes; derivado de Carbon.
- En la tabla oficial de 10 pruebas, gana 7: Sonnet 5.5 gana en 3 (terminal, operación de computadora y terminal científica); Terra no ocupa el primer lugar en ninguna.
- Hay que distinguir la metodología: las puntuaciones son autodeclaradas por el fabricante; las de los competidores se toman de sus resultados públicos con el nivel máximo de razonamiento, no de una nueva ejecución con el mismo script.
- Salto evidente frente a 3.8 Flash: 2.5 veces más rápido; Terminal-Bench 4.1 pasa de 18.2% a 57%.
- Precio del nivel estándar: entrada global $1.50, salida $7.50; la salida incluye tokens de razonamiento.
- Dos versiones sobre la ventana de contexto: la ficha del modelo indica 1 millón en total; el blog indica 1 millón de entrada y hasta 1 millón de salida.
- Estado actual de la invocación: APIYI aún no lo tiene disponible; por ahora puedes usar Carbon, Sonnet y Terra en apiyi.com para montar una comparación.
Resumen
Puntos clave de Gemini 4 Hydrogen:
- Fuerte en ejecución de agentes: gana 7 de 10 pruebas de la tabla oficial y lidera en automatización, examen de agentes, gráficos y HLE-Diamond.
- Débil en terminal y operación de computadora: queda por detrás de Claude Sonnet 5.5 en Terminal-Bench 4.1, OSWorld-2.1 y terminal científica.
- Las cifras deben leerse según su metodología: todas son autodeclaradas por el fabricante o resumidas de la ficha del modelo; las puntuaciones de los competidores provienen de resultados públicos, no de una nueva ejecución en igualdad de condiciones.
Si trabajas con flujos de trabajo de agentes, Hydrogen merece estar en la lista de candidatos, sobre todo como capa de ejecución dentro de flujos multimodelo. La decisión final debería basarse en los resultados de tus propias tareas. Recomendación: usa primero Carbon, Sonnet 5.5 y Terra en APIYI apiyi.com para establecer una línea base; cuando Hydrogen esté disponible, podrás añadirlo directamente a tus pruebas.
📚 Referencias
- Blog de Google: Introducing Gemini 4 Hydrogen: anuncio de lanzamiento y explicación de posicionamiento
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen -
Descripción: posicionamiento oficial, AA Index y mejoras respecto a 3.8 Flash
-
Boletín para desarrolladores de Google: Build with Gemini 4 Hydrogen: información de acceso para desarrolladores
- Enlace:
blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-4-hydrogen -
Descripción: canales disponibles y notas relevantes para desarrolladores
-
Tarjeta de modelo de DeepMind: Gemini 4 Hydrogen: especificaciones, tabla comparativa de 10 puntos y evaluación de seguridad
- Enlace:
deepmind.google/models/model-cards/gemini-4-hydrogen -
Descripción: principal fuente de la tabla de 10 puntos y del apartado de limitaciones de este artículo
-
Explicación de la metodología de evaluación de DeepMind: criterio metodológico de la tabla comparativa
- Enlace:
deepmind.google/models/evals-methodology/gemini-4-hydrogen -
Descripción: niveles de razonamiento, pass@1 y origen de las puntuaciones de los competidores
-
Página de precios de Google Cloud: precios de la tarifa estándar
- Enlace:
cloud.google.com/vertex-ai/generative-ai/pricing - Descripción: precio unitario de la tarifa estándar global y no global, fecha de entrada en vigor de la escritura de caché
Autor: equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal de APIYI; para más material, visita el centro de documentación docs.apiyi.com