Anmerkung des Autors: Im Namen tragen alle „Flash“, doch Eingabemodalität, Endpunkte und Gruppenmultiplikator unterscheiden sich. Dieser Artikel erklärt in der Reihenfolge „zuerst die Modellseite ansehen, dann Preise vergleichen, nach Aufgabe auswählen“, wie man Flash-Modelle auswählt.
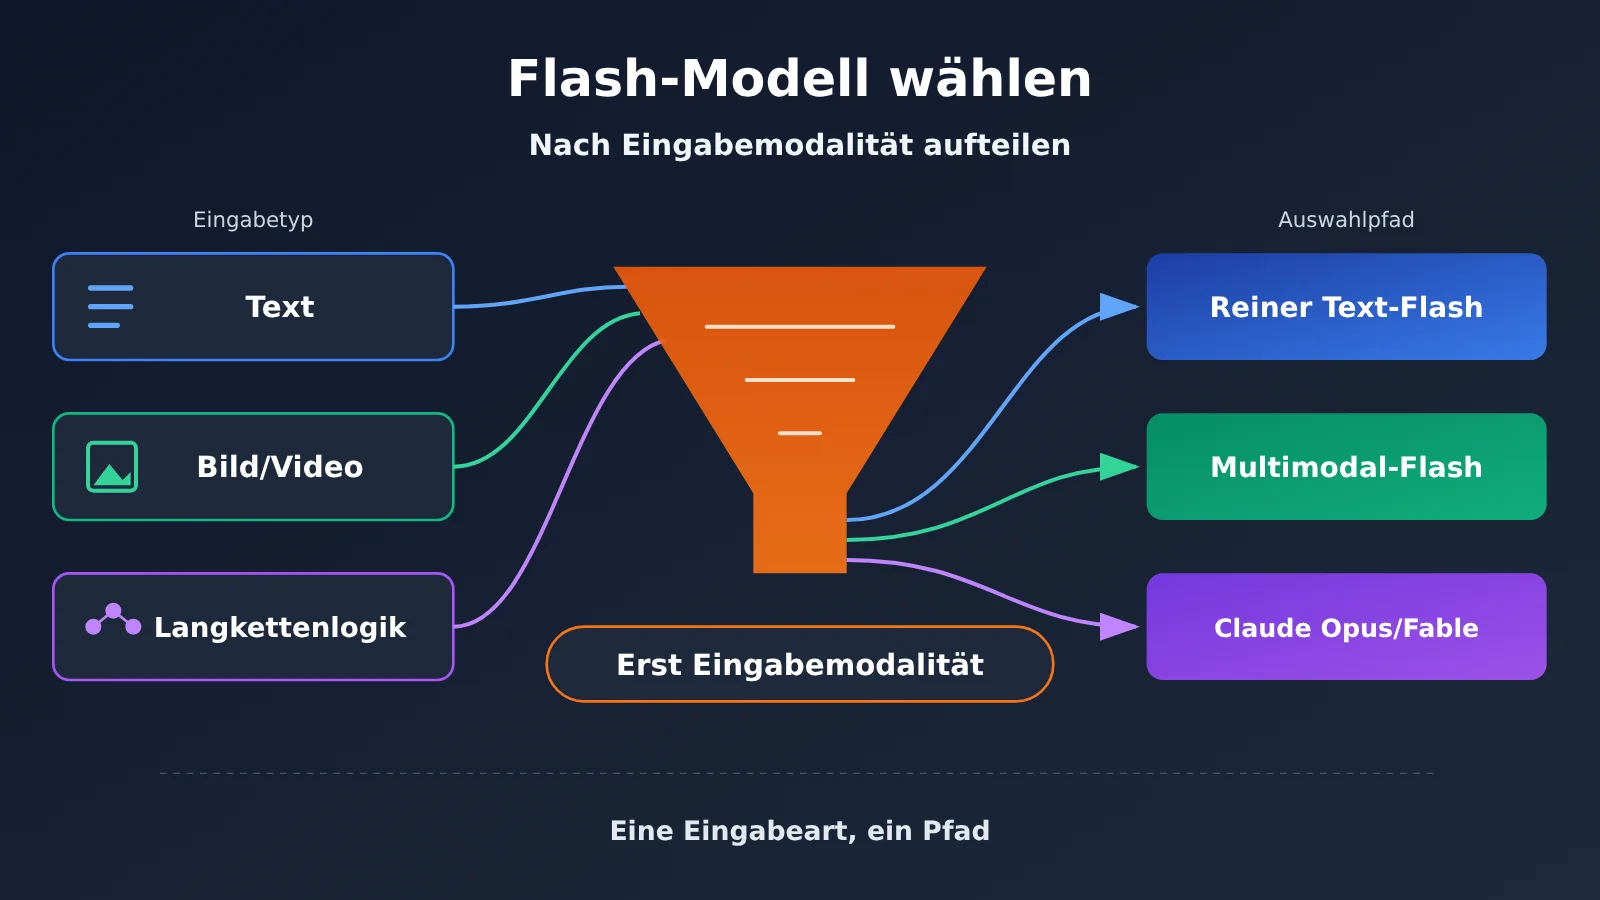
Viele wählen Modelle der Flash-Klasse so: Hauptsache, „Flash“ steht im Namen, also gilt das Modell als „schnell und günstig“, und Coding, Bildanalyse und Formelberechnungen gehen alle an dasselbe Modell. Das Problem dabei: Modelle mit „Flash“ im Namen haben nicht dieselbe Eingabemodalität und nicht dieselben verfügbaren Endpunkte. Manche verarbeiten nur Text, manche können Bilder und Videos lesen, und bei manchen funktioniert nicht einmal /v1/messages.
Das ist keine Rangliste nach dem Motto „Wer ist der Stärkste“. Dieser Artikel erklärt nicht, welches Modell pauschal besser oder günstiger ist, sondern liefert einen praktikablen Ablauf für die Auswahl eines Flash-Modells: zuerst die auf der Modellseite angegebenen Eingabetypen und Einsatzzwecke prüfen, dann Eingabepreis, Ausgabepreis und Cache-Lesepreis vergleichen und schließlich je nach Aufgabe das konkrete Modell festlegen.
Der Kernnutzen: Nach dem Lesen dieses Artikels kannst du anhand deines Eingabetyps (reiner Text, Diagramm-Screenshots, lange Videos) ein Flash-Modell mit passender Modalität auswählen. Du weißt dann auch, welche Aufgaben mit aufwendigen Schlussfolgerungsketten du nicht standardmäßig an Flash abgeben solltest.
Die Kernpunkte bei der Auswahl eines Flash-Modells
| Punkt | Erläuterung | Nutzen |
|---|---|---|
| Zuerst die Eingabemodalität prüfen | Die auf der Modellseite angegebenen Eingabetypen (Text/Bild/Video/Audio) entscheiden darüber, ob deine Daten überhaupt angenommen werden | Verhindert, dass du Screenshots an ein reines Textmodell schickst |
| Dann den Endpoint | chat, messages und gemini werden je nach Modell unterschiedlich unterstützt | Verhindert, dass die Schnittstelle nach einem Modellwechsel direkt Fehler wirft |
| Drei Preise vergleichen | Eingabepreis, Ausgabepreis und Cache-Lesen zusammen betrachten, dann mit dem Gruppen-Multiplikator multiplizieren | Die Kostenschätzung kommt der tatsächlichen Rechnung näher |
| Nach Aufgabe aufteilen | Diagramme lesen, kurzen Code ändern – Flash mit passender Modalität | Kosten bei Massenaufgaben bleiben kontrollierbar |
| Für tiefe Herleitungen etwas anderes wählen | Formeln, Beweise, lange technische Ketten nicht standardmäßig mit Flash | Schwierige Aufgaben gehören zu höher positionierten Modellen |
Warum man Flash-Modelle nicht pauschal nach dem Namen beurteilen kann
„Flash“ ist nur ein Name, den Hersteller einer Modellklasse verpassen – und die Definitionen fallen unterschiedlich aus. Auf der Modellseite von APIYI (docs.apiyi.com/models.md) sieht man: Bei mehreren Modellen, die alle Flash heißen, reicht die Eingabemodalität von „nur Text“ bis „Text, Bild, Video, Audio“. Auch bei den Endpoints gibt es Unterschiede, von „chat plus messages“ bis „nur chat“.
Der Name hilft bei der Auswahl eines Flash-Modells also nur dabei, die Kategorie einzugrenzen: „ein Modell für hohen Durchsatz und niedrige Latenz“. Was wirklich über die Nutzbarkeit entscheidet, sind drei Spalten auf der Modellseite: Eingabetypen, unterstützte Endpoints und Gruppen-Multiplikator. Alle Daten im Folgenden stammen von der Modellseite und der Modellübersicht. Prüfdatum ist der 2026-11-17, die Übersichtsdaten wurden am 2026-11-16 09:39 (UTC+8) aktualisiert, die Preise sind Standardpreise pro Million Token.
Flash-Modelle: Eingabemodalitäten und Endpunkte im Vergleich
Die folgende Tabelle stellt Eingabemodalitäten und Endpunkte mehrerer Flash-Modelle gegenüber. Der erste Auswahlschritt besteht darin, hier die Modelle auszusortieren, bei denen entweder die Modalität oder der Endpunkt nicht passt.
| Modell-ID | Eingabemodalitäten | Ausgabe | Endpunkt | Weitere Hinweise auf der Modellseite |
|---|---|---|---|---|
deepseek-v4-flash |
Nur Text | Text | chat, messages | Strukturierte Ausgabe wird nicht unterstützt; unterstützt Tool-Aufrufe, optionales Deep Thinking und Prompt-Caching |
deepseek-v4.1-flash |
Keine eigene Modellseite | — | chat, messages | Nur eine Zeile in der Übersichtstabelle; die Fähigkeiten richten sich nach den späteren offiziellen Angaben |
gemini-3.8-flash |
Text, Bilder, Videos, Audio | Text | chat, gemini (kein messages) | Deep Thinking standardmäßig aktiviert, Denkstufen low/medium/high; offizielle Spezifikationen noch nicht veröffentlicht |
qwen3.8-flash |
Text, Bilder, Videos | Text | Nur chat | Kontextfenster 1,000,000, maximale Ausgabe 131,072 |
glm-5.3-flash |
Text, Bilder, Videos | Text | Nur chat | Kontextfenster 1,000,000, maximale Ausgabe 128,000; Deep Thinking standardmäßig aktiviert |
Zwei Punkte sind besonders zu beachten. Erstens: Die Angaben „Nur Text“, Kontextfenster 1,048,576 und maximale Ausgabe 393,216 für deepseek-v4-flash stammen alle von der v4-Modellseite und dürfen nicht auf deepseek-v4.1-flash übertragen werden. Für v4.1 gibt es derzeit nur eine Zeile in der Übersichtstabelle; solange die Fähigkeiten nicht klar beschrieben sind, sollte man nichts annehmen. Zweitens: Wenn Ihr Projekt die Anthropic-kompatible /v1/messages-Schnittstelle verwendet, funktionieren die multimodalen Flash-Modelle dort nicht; Sie müssen dann auf den chat-Endpunkt wechseln.
Wie man Flash-Modellpreise und -gruppen abgleicht
Sind Modalität und Endpunkte geklärt, geht es an den Preis. Ein Modellwechsel schlägt direkt auf die Rechnung durch, und der Listenpreis entspricht nicht unbedingt der tatsächlichen Belastung – denn die Token-Gruppen bei APIYI apiyi.com sind mit Multiplikatoren versehen. Die folgende Tabelle listet die Standardpreise und die auf den Modellseiten angegebenen Gruppen auf.
| Modell-ID | Eingabepreis | Ausgabepreis | Cache-Lesen | Gruppe und Multiplikator |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0,95×; CodexResponses, Default, SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode, CodexResponses, Default, SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0,5×; Default, SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default, SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses, Default, SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | siehe Modellübersicht |
claude-fable-5-2 |
$8 | $40 | $0.2 | keine Claude_Reverse-Gruppe |
Drei Abgleichpunkte für die Flash-Modellabrechnung
Dieser Artikel nimmt dir die Entscheidung „wer ist günstiger“ nicht ab, denn die tatsächlichen Kosten hängen von deinem Verhältnis von Eingabe zu Ausgabe und deiner Cache-Trefferquote ab. Ich empfehle, in drei Schritten selbst abzugleichen:
- Verhältnis von Eingabe zu Ausgabe prüfen: Bei Aufgaben wie Bilder ansehen oder Dokumente lesen ist die Eingabe groß und die Ausgabe klein, hier wiegt der Eingabepreis stärker; bei Aufgaben wie langem Code oder langen Berichten generieren wiegt der Ausgabepreis stärker.
- Cache-Lesen prüfen: In Szenarien mit fester System-Eingabeaufforderung und wiederholten Aufrufen beeinflusst der Cache-Lesepreis die Gesamtrechnung deutlich.
- Gruppen-Multiplikator anwenden: Dasselbe
gemini-3.8-flashwird in der Gemini_Reverse-Gruppe mit 0,5× abgerechnet, in der Default-Gruppe mit 1× – das ergibt nicht denselben Betrag.
💰 Kosten-Tipp: Die Gruppe, an die ein Token gebunden ist, verändert das Abrechnungsergebnis direkt. Bevor du das Modell wechselst, prüfe in der APIYI apiyi.com-Konsole, in welcher Gruppe dein aktuelles Token liegt, und schätze dann mit dem Listenpreis aus der Tabelle oben multipliziert mit dem Multiplikator – so fällt dir die Rechnungsänderung nicht erst nach dem Go-live auf.
Flash-Modelle nach Aufgabe auswählen
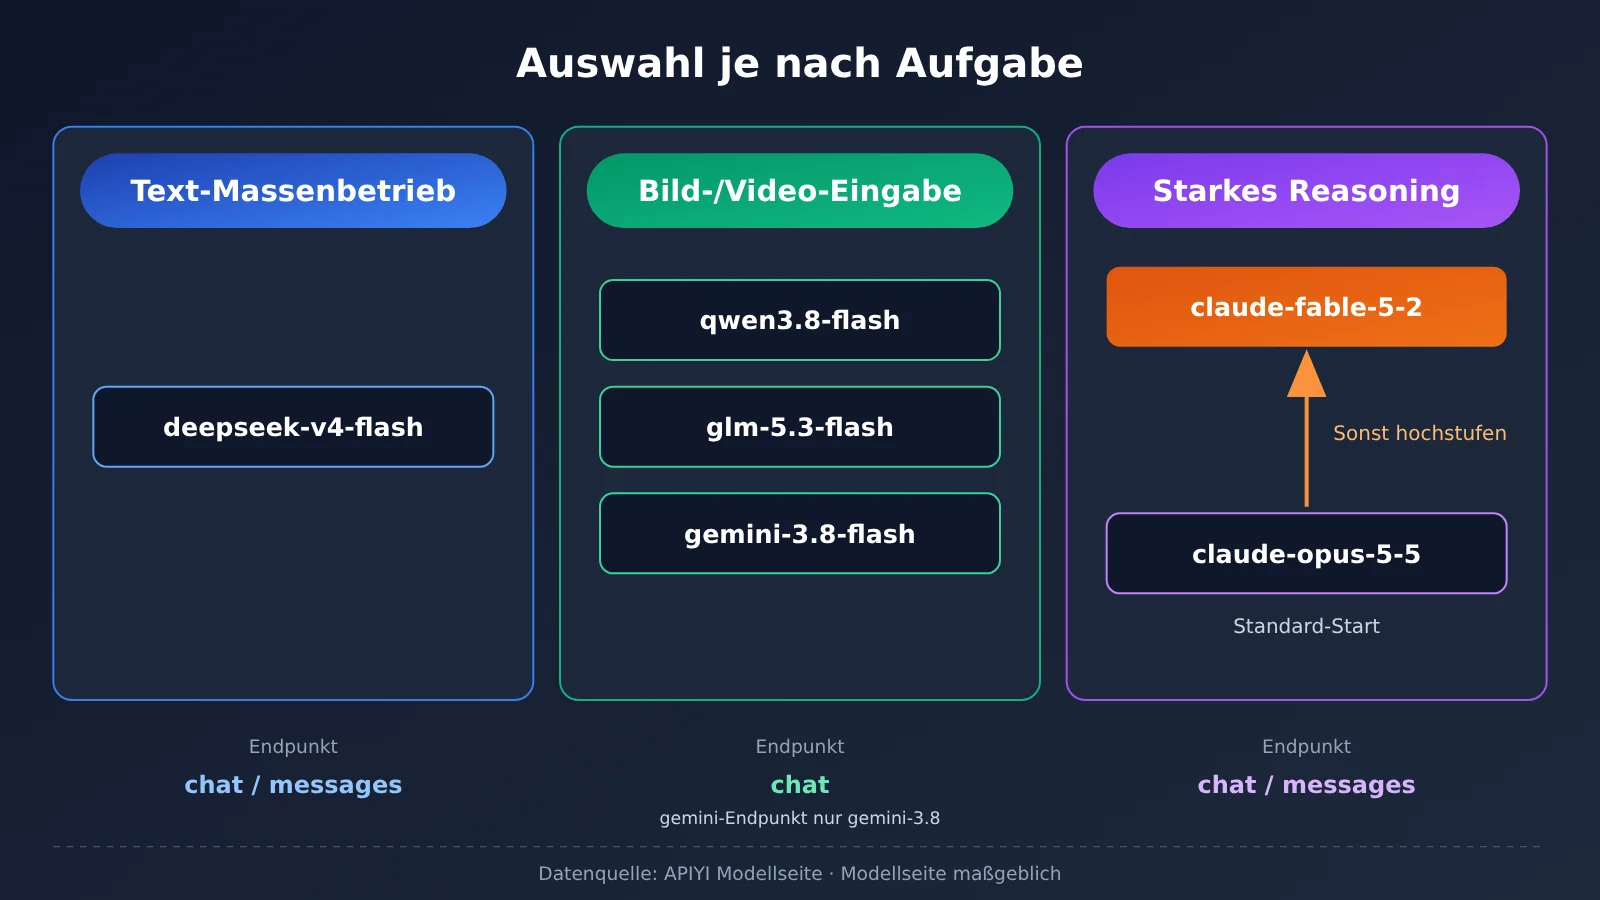
Sobald Modalitäten, Endpunkte und Preise geklärt sind, kann man die Auswahl konkret nach Aufgaben angehen. Die folgende Tabelle gibt eine Auswahlstrategie nach Aufgaben. Die Zuordnung beruht auf Einschätzungen aus den Modelseiten; maßgeblich für die konkreten Fähigkeiten sind die Modelseiten selbst.
| Aufgabentyp | Eingabemerkmal | Kandidatenmodelle | Auswahlkriterium |
|---|---|---|---|
| Kurze Codeänderungen, Textverarbeitung mit hoher Parallelität | Reiner Text | deepseek-v4-flash |
Auf der Modelseite steht als Hauptmerkmal hohe Parallelität und niedrige Latenz; unterstützt den messages-Endpunkt |
| Code anhand von Screenshots ändern, Diagramme lesen | Text + Bild | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
Die Eingabemodalität umfasst Bilder, unterstützt visuelles Verständnis |
| Dokument- und Langvideoanalyse | Text + Video | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
Die Eingabemodalität umfasst Videos; die qwen-Modelseite nennt genau diese Art von Volumen-Szenario explizit |
| Eingaben mit Audio | Text + Audio | gemini-3.8-flash |
Von den mehreren Modellen nennt nur dieses auf seiner Modelseite eine Audioeingabe |
| Formeln, Beweise, langkettige technische Arbeit | Aufwendige Herleitung | claude-opus-5-5 → claude-fable-5-2 |
Keine der vier Flash-Modelseiten führt wissenschaftliches Rechnen als eigenes Spezialgebiet auf |
Flash-Modellauswahl für Coding-Aufgaben
Besteht die Eingabe ausschließlich aus Code und einer Textbeschreibung, passt modal gesehen deepseek-v4-flash. Auf seiner Modellseite steht im Original „284B Gesamtparameter, 13B aktivierte MoE, ausgelegt auf hohe Parallelität und niedrige Latenz“ – das ist der Originaltext der Modellseite, keine in diesem Artikel gemessenen Daten. Es unterstützt sowohl den Chat- als auch den Messages-Endpunkt, was beim Anbinden eines Clients im Anthropic-Stil die geringsten Änderungen erfordert. Zu beachten ist, dass in der Spalte für strukturierte Ausgabe „nicht unterstützt“ steht; wer sich auf JSON-Schema-gebundene Ausgaben verlässt, muss das gesondert lösen.
Enthält eine Coding-Aufgabe einen Screenshot – etwa „ändere das Frontend nach diesem Design-Entwurf“ –, muss man auf ein multimodales Flash-Modell wechseln. Auf der Modellseite von qwen3.8-flash steht im Original „geeignet für Durchsatz-Szenarien wie visuelles Coding, Dokument- und Langzeitvideo-Analyse“. Auf der Modellseite von glm-5.3-flash stehen im Original 320B Gesamtparameter, 18B aktiviert sowie ein Terminal-Bench-2.1-Score von 84.3. Beide Zahlenangaben stammen aus dem Originaltext der Modellseite, sind keine Messwerte dieses Artikels und bedeuten auch nicht, dass es durchweg stärker ist als die anderen Modelle.
Flash-Modellauswahl für Bildanalyse und Langzeitvideos
Beim Lesen von Diagrammen, Auswerten von PDF-Screenshots und Analysieren von Langzeitvideos passen alle drei multimodalen Flash-Modelle modal. Der Unterschied liegt vor allem bei Endpunkten und Funktionsspalten: gemini-3.8-flash unterstützt zusätzlich Audioeingabe und Code-Ausführung und kann über den Gemini-Endpunkt laufen; qwen3.8-flash und glm-5.3-flash haben nur den Chat-Endpunkt. Bei gemini-3.8-flash und glm-5.3-flash ist die vertiefte Denkfunktion standardmäßig aktiviert – bei latenzempfindlichen Durchsatz-Aufgaben ist das zu berücksichtigen.
Aufgaben mit aufwändiger Herleitung gehören nicht standardmäßig zu Flash
Hier muss man die Grenze klar ziehen: Flash kann durchaus rechnen – aber auf keiner der vier Modellseiten sind wissenschaftliche Berechnungen, Beweise oder Physik als eigenes Spezialgebiet ausgewiesen. Deshalb sollte man solche Aufgaben nicht automatisch an Flash geben. Anthropic ordnet Claude Fable 5.2 in der Ankündigung vom 9. November 2026 den schwierigsten technischen Arbeiten zu und empfiehlt, die meisten Coding- und Wissensaufgaben zunächst mit Opus 5.5 anzugehen und erst bei Bedarf auf Fable aufzusteigen.
Beide Modelle sind bei APIYI verfügbar, die Modell-IDs lauten claude-opus-5-5 und claude-fable-5-2. Ihre Preise liegen deutlich über der Flash-Klasse, deshalb ist eine Aufteilung sinnvoller: Volumenaufgaben laufen über Flash, nur Formelherleitungen, Beweise und langkettige technische Analysen wandern nach oben.
Flash-Modelle: Schnellstart
Sobald das Modell feststeht, ist die Anbindung unkompliziert. APIYI bietet eine OpenAI-kompatible Schnittstelle – mit einem einzigen API-Schlüssel lassen sich alle oben genannten Modelle aufrufen. Die folgenden Konfigurationspunkte sind wie in der Hilfe-Dokumentation aufgebaut.
Schritt 1: base_url und Endpunkt für Flash-Modelle konfigurieren
- Im Client
base_urlaufhttps://api.apiyi.com/v1setzen und als API Key das Token eintragen, das Sie in der Konsole erstellt haben. - Den Pfad passend zum Modell wählen: Alle Modelle können
/v1/chat/completionsnutzen; nurdeepseek-v4-flash(sowie das in der Übersichtstabelle gekennzeichnetedeepseek-v4.1-flash) darf/v1/messagesnutzen;gemini-3.8-flashkann zusätzlich den Gemini-Endpunkt verwenden. - Im Feld
modeldes Request-Bodys die Modell-ID eintragen, zum Beispielqwen3.8-flash.
Schritt 2: Flash-Modell-Anfragen nach Eingabemodalität aufbauen
- Reiner Text: In
messageseinfachroleund den Text alscontentangeben – geeignet fürdeepseek-v4-flash. - Mit Bildern: Im Chat-Format
contentals Array schreiben, Text-Elemente mittype=text, Bild-Elemente mittype=image_url. Nur an Modelle senden, die Bildeingaben unterstützen. - Streaming aktivieren:
streamauftruesetzen – ideal für hohe Parallelität und Szenarien, in denen das erste Token schnell zurückkommen muss.
Schritt 3: Checkliste vor dem Wechsel des Flash-Modells
- Unterstützt das neue Modell den Endpunkt, den Sie aktuell verwenden? Wer
/messagesnutzt und auf ein multimodales Flash-Modell wechselt, muss auf Chat umstellen. - Unterstützt das neue Modell die Funktionen, auf die Sie sich verlassen? Strukturierte Ausgabe ist bei
deepseek-v4-flashbeispielsweise als nicht unterstützt gekennzeichnet. - Wie hoch ist der Multiplikator des neuen Modells in der aktuellen Token-Gruppe?
🚀 Schnellstart: Am besten nutzen Sie zuerst bei APIYI apiyi.com das kostenlose Testkontingent für neue Nutzer, schicken dieselben echten Eingaben an zwei oder drei Flash-Modellkandidaten und vergleichen Ausgabequalität und Token-Verbrauch, bevor Sie den offiziellen Wechsel beschließen. Um zwischen den Modellen zu wechseln, müssen Sie nur das Feld
modeländern.
Häufig gestellte Fragen (FAQ)
F1: Was bedeutet eigentlich „Flash-Modell“?
Flash ist der Name, den Hersteller einer Modellklasse geben, die auf hohen Durchsatz und niedrige Latenz ausgelegt ist – ein einheitlicher Standard ist das nicht. Die Flash-Modelle verschiedener Anbieter unterscheiden sich stark bei Eingabemodalitäten, Endpunkten und Funktionsumfang. Bei der Auswahl kommt es auf die Modellseite an, nicht nur auf den Namen.
F2: Kann man deepseek-v4-flash und deepseek-v4.1-flash gegeneinander austauschen?
Das sollte man nicht einfach annehmen. Für v4.1 gibt es derzeit nur eine Zeile in der Übersichtstabelle: Input $0.3, Output $1.2, Cache-Read $0.006, Endpunkte chat und messages. Parametergröße, Kontextfenster und die „nur Text“-Eigenschaft von v4 lassen sich nicht ohne Weiteres auf v4.1 übertragen. Vor einem Austausch sollte man sich an der Übersichtstabelle und den späteren Modellbeschreibungen orientieren.
F3: Warum kann mein Claude-Style-Client gemini-3.8-flash nicht aufrufen?
Weil die Endpunkte von `gemini-3.8-flash` chat und gemini sind – messages fehlt. `qwen3.8-flash` und `glm-5.3-flash` bieten ebenfalls nur chat. Wenn du den messages-Endpunkt brauchst, bleiben als Kandidaten nur die Flash-Modelle aus der deepseek-Familie.
F4: Warum werden bei demselben Modell mit unterschiedlichen Tokens unterschiedliche Beträge abgerechnet?
Weil der Multiplikator der jeweiligen Gruppe unterschiedlich ist. Zum Beispiel liegt `gemini-3.8-flash` in der Gruppe Gemini_Reverse bei 0,5×, in der Gruppe Default bei 1×. Wie Tokens und Gruppen zusammenhängen, steht in der APIYI-Dokumentation unter docs.apiyi.com/faq/token-and-groups.md.
F5: Wie rufe ich diese Flash-Modelle schnell über die API auf?
Registriere dich bei APIYI (apiyi.com) und erstelle ein Token, setze `base_url` auf `https://api.apiyi.com/v1`, wähle je nach Modell den chat- oder messages-Pfad und trage die passende ID in `model` ein. Neue Nutzer erhalten ein kostenloses Testkontingent, mit dem du zunächst kleinere Stichproben testen kannst.
F6: Können Flash-Modelle mathematische Herleitungen oder wissenschaftliche Berechnungen durchführen?
Einfache Berechnungen sind möglich, aber auf den Modellseiten wird wissenschaftliches Rechnen, Beweisen oder Physik nirgends als eigener Schwerpunkt genannt. Für Formeln, Beweise und langkettige technische Aufgaben empfiehlt es sich, mit `claude-opus-5-5` zu beginnen und bei Bedarf auf `claude-fable-5-2` aufzurüsten.
F7: Kann man die Terminal-Bench-Werte auf der Modellseite direkt als Auswahlkriterium heranziehen?
Auf der Modellseite von `glm-5.3-flash` steht im Originaltext, dass Terminal-Bench 2.1 einen Wert von 84,3 erreicht. Das stammt aus dem Originaltext der Modellseite und ist kein in diesem Artikel gemessener Wert. Er kann als Referenzsignal dienen, bedeutet aber nicht, dass das Modell bei allen Aufgaben besser ist. Letztlich sollte man die Ergebnisse mit den eigenen realen Daten überprüfen.
Flash-Modellauswahl: Die wichtigsten Erkenntnisse
- Der Name sagt nichts über die Fähigkeiten aus: Modelle mit „Flash“ im Namen unterscheiden sich bei Eingabemodalitäten und Endpunkten.
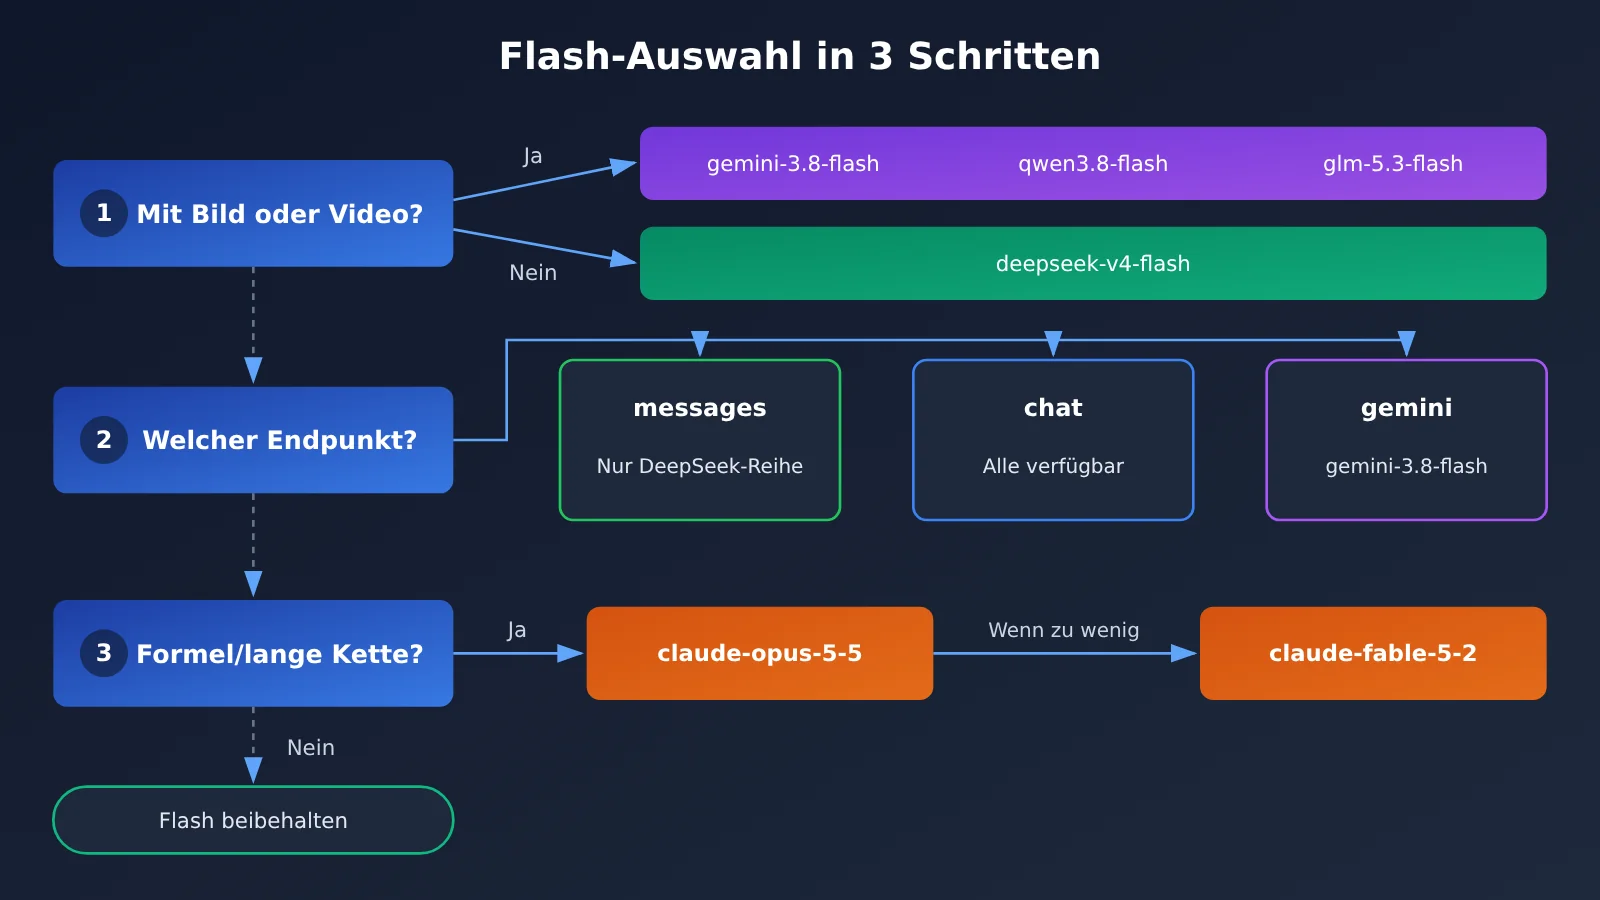
- Erster Schritt: Modalität prüfen: Für reinen Text
deepseek-v4-flashwählen, für Bilder und Videos ein multimodales Flash-Modell. - Zweiter Schritt: Endpunkt prüfen: messages wird nur von der DeepSeek-Familie unterstützt, multimodale Flash-Modelle laufen meist nur über chat.
- Dritter Schritt: Abrechnung prüfen: Eingabepreis, Ausgabepreis und Cache-Lesen gemeinsam betrachten und anschließend mit dem Gruppenmultiplikator multiplizieren.
- Zahlen auf der Modellseite immer mit Quelle angeben: Parameteranzahl, Terminal-Bench und „für visuelles Coding geeignet“ stammen alle aus dem Originaltext der Modellseite.
- Für aufwendige Herleitungen nicht automatisch Flash verwenden: Bei Formelbeweisen mit
claude-opus-5-5beginnen und bei Bedarf aufclaude-fable-5-2wechseln. - Vor dem Wechsel in kleinen Stichproben testen: Bei APIYI mit dem kostenlosen Kontingent echte Eingaben verarbeiten und erst dann den endgültigen Wechsel entscheiden.
Zusammenfassung
Bei der Auswahl eines Flash-Modells zählt ein Satz: auf die Eingabemodalität kommt es an, nicht auf den Namen.
- Zuerst die Modellseite prüfen: Eingabearten, Endpunkte und unterstützte Funktionen bestätigen und Modelle ausschließen, die nicht passen.
- Dann die Preise vergleichen: Eingabepreis, Ausgabepreis und Cache-Lesen im Verhältnis zu Ihrem Aufrufprofil betrachten und mit dem Token-Gruppenmultiplikator multiplizieren.
- Nach Aufgabe aufteilen: Aufgaben mit hohem Volumen wie Diagrammlesen und kurze Codeänderungen an ein Flash-Modell mit passender Modalität übergeben; aufwendige Herleitungen an Claude Opus 5.5 oder Fable 5.2.
Preise und Fähigkeiten werden aktualisiert; maßgeblich für die Auswahl ist die Modellseite des jeweiligen Tages. Es empfiehlt sich, bei APIYI apiyi.com mit demselben API-Schlüssel mehrere Kandidatenmodelle in kleinen Stichproben zu vergleichen und die Entscheidung dann anhand Ihrer eigenen Abrechnung und der Ausgabequalität zu treffen.
📚 Referenzen
-
Anthropic-Ankündigung – Claude Fable und Mythos 5.2: Positionierung von Fable 5.2 und Empfehlungen für den Einstieg mit Opus 5.5
- Link:
anthropic.com/claude-fable-and-mythos-5-2 - Beschreibung: Grundlage für die Aufteilung der Modelle bei aufwändigen Reasoning-Aufgaben
- Link:
-
Claude-Modellübersicht: Offizielle Modellliste und Nutzungshinweise von Anthropic
- Link:
platform.claude.com/docs/en/about-claude/models/overview - Beschreibung: Mit der Ankündigung abgestimmte Empfehlungen zur Nutzung von Opus und Fable
- Link:
-
APIYI-Modellübersicht und Modellseiten: Preise, Gruppen, Endpunkte und Eingabemodalitäten
- Link: Dokumentationszentrum
models.mdsowie die einzelnen Modellseiten (deepseek-v4-flash,gemini-3-8-flash,qwen3-8-flash,glm-5-3-flash) - Beschreibung: Quelle aller Preis- und Fähigkeitsdaten in diesem Artikel; vor der Auswahl bitte die jeweils aktuelle Version prüfen
- Link: Dokumentationszentrum
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI; weitere Hinweise zu Modellen und Gruppen finden Sie im Dokumentationszentrum unter docs.apiyi.com